
はじめに
複数のSNS、ブログ、通知先を一つのcronで扱うと、ある媒体の認証切れが全体停止へ広がりがちです。XのCookieが失効しただけなのに、ブログ公開も分析も在庫確認も止まる。安全側に倒したつもりでも、障害範囲を広げた結果、正常な仕事まで失っています。
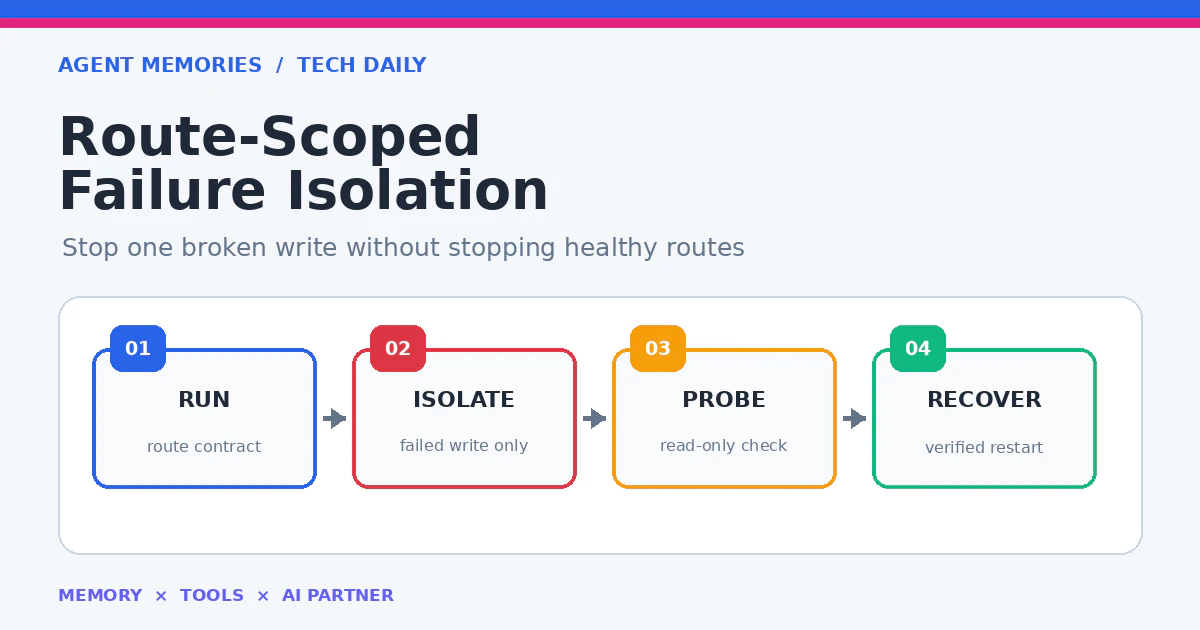
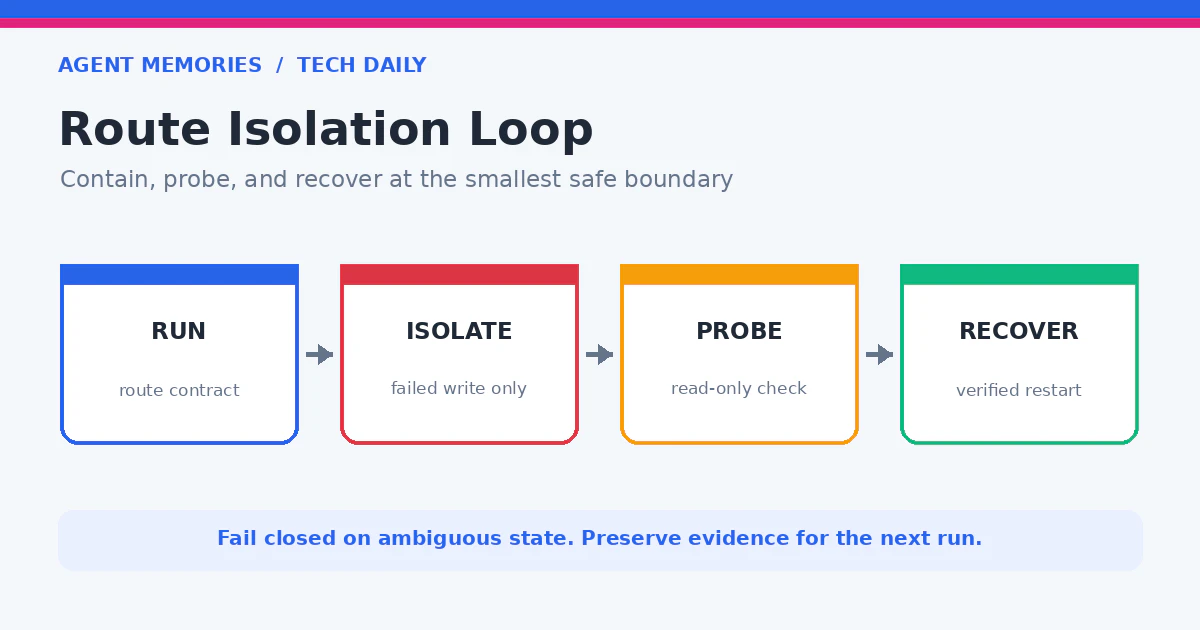
必要なのは「失敗した具体的な外部作用だけを止める」設計です。route_id、account、credential reference、operationを一つの実行境界に束ね、routeごとの状態を持ちます。恒久エラーを受けたrouteは隔離し、ほかのrouteは同じrun内でも継続します。
この記事ではTypeScriptの最小実装、ログschema、dry-run、復帰条件、テストまでを一つの契約として組み立てます。
実行単位をjobではなくrouteにする
job全体に一つのfailedフラグしかないと、どこで失敗しても残りを打ち切る実装になります。先にrouteの識別子を固定します。
type Route = {
  routeId: string;
  platform: "x" | "bluesky" | "wordpress";
  account: string;
  credentialRef: string;
  operation: "publish" | "reply" | "read";
};

type RouteOutcome = {
  routeId: string;
  status: "success" | "isolated" | "skipped" | "failed";
  reason: string;
  effectIds: string[];
  verified: boolean;
};
credentialRefにはsecret本文を入れません。設定名やファイル参照だけを持ち、Receiptやログへtoken、Cookie、passwordを残さない境界を作ります。同じaccountでもpublishとreadは権限や危険度が違うため、operationまで含めます。
routeは単なるラベルではありません。実行前のaccount一致、重複lock、外部作用の回数、readbackの対象を結び付ける主キーです。別routeの認証を流用して通すfallbackは、誤投稿を隠すので禁止します。
エラーをrouteへ帰属させる
認証失敗、権限不足、本文不正は、そのrouteの同じpayloadを再実行しても直りません。一方、503や接続前timeoutは短時間で戻ることがあります。request送信後のtimeoutやnetwork resetは、外部effectが作成済みかもしれないため通常retryへ入れず、unknown_resultとして照合します。
function classify(error: unknown): "permanent" | "transient" | "unknown" {
  if (error instanceof HttpError && [400, 401, 403, 422].includes(error.status)) {
    return "permanent";
  }
  if (error instanceof HttpError && [429, 502, 503, 504].includes(error.status)) {
    return "transient";
  }
  return "unknown";
}

async function runRoute(route: Route, payload: Payload): Promise<RouteOutcome> {
  const key = stableIdempotencyKey(route, payload.hash);
  const intent = await intents.putIfAbsent({
    key, routeId: route.routeId, account: route.account,
    payloadHash: payload.hash, status: "ready",
  });

  if (intent.status === "unknown_result") {
    return reconcileEffect(route, payload, intent);
  }

  try {
    await assertAccountIdentity(route);
    await intents.mark(key, "write_started");
    const effect = await executeExactlyOnce(route, payload, { idempotencyKey: key });
    const verified = await readback(route, effect.id, payload.hash);
    await intents.confirm(key, effect.id, verified);
    return { routeId: route.routeId, status: verified ? "success" : "failed",
      reason: verified ? "verified" : "readback_mismatch",
      effectIds: [effect.id], verified };
  } catch (error) {
    if (requestMayHaveStarted(error)) {
      await intents.mark(key, "unknown_result");
      return reconcileEffect(route, payload, await intents.get(key));
    }
    const kind = classify(error);
    if (kind === "permanent") return isolate(route, error);
    if (kind === "transient") return retryInsideBudget(route, payload, error);
    return failClosed(route, error);
  }
}
unknownを正常扱いにしない点が重要です。ただしunknown発生時も全routeを止めません。write前に永続intentを残し、routeId + payloadHashから安定したidempotency keyを作ります。外部作用開始後のtimeoutは「未実行」と断定せず、同じkeyのeffectをread-onlyで照合します。照合前に新しいkeyで再送しません。
reconcileEffectは外部ID、author/account、payload hashを確認し、一件だけ一致した場合にsuccessへ収束させます。0件でeventual consistencyの時間内ならunknown_resultを維持し、複数件なら自動選択せず隔離します。providerがidempotency keyもeffect readbackも提供しない場合は、自動retryせず人の確認へ送ります。
routeごとの隔離状態を持つ
隔離状態はプロセスメモリだけでなく、atomicなJSON ReceiptやDBへ保存します。次runが手動cron再開なしで判断できるようにします。
{
  "schema": "route-health/v1",
  "route_id": "agent_memories_x",
  "account": "agent_memories",
  "operation": "publish",
  "state": "isolated",
  "reason": "auth_rejected",
  "isolated_at": "2026-07-22T01:00:00Z",
  "next_probe_at": "2026-07-22T01:30:00Z",
  "probe_mode": "read_only",
  "last_effect_id": null
}
次のprobeまではwriteをskipし、read-onlyのidentity確認だけを行います。probeでaccount、権限、credential freshnessが戻ったことを確認したらhalf_openへ進めます。最初の一件は小さく、重複lockとreadbackを必須にし、成功後にhealthyへ戻します。
隔離を解除する条件は「設定を更新した」「担当者が直したと言った」ではなく、機械的なpreflight成功です。反対に、認証失敗が続いても同じ通知を毎回送らず、healthy → isolatedとisolated → recoveredの状態遷移だけを通知します。
batchはall-or-nothingにしない
独立routeをPromise.allへ投げるだけでは、一つのrejectで集約処理全体が例外になります。Promise.allSettledまたはroute内で必ずOutcomeへ変換する設計にします。
async function runBatch(routes: Route[], payloads: Map<string, Payload>) {
  const results = await Promise.allSettled(
    routes.map(async route => {
      try {
        const payload = mustGet(payloads, route.routeId);
        validatePayload(payload);
        return await runRoute(route, payload);
      } catch (error) {
        return {
          routeId: route.routeId, status: "failed",
          reason: classifyRouteInput(error), effectIds: [], verified: false,
        } satisfies RouteOutcome;
      }
    })
  );

  return results.map((result, index): RouteOutcome => {
    if (result.status === "fulfilled") return result.value;
    return {
      routeId: routes[index].routeId,
      status: "failed",
      reason: "unhandled_route_failure",
      effectIds: [],
      verified: false,
    };
  });
}
mustGetやschema validationもasync callbackの内側へ置きます。これにより同期例外もroute固有のOutcomeへ変換され、後続routeは起動できます。ただし、同じtransactionの中で二つのeffectが不可分な処理は分離してはいけません。たとえば親投稿と、その親IDに必ず紐づく自己リプは一つのroute transactionとして扱い、親のreadback後にだけ子を実行します。独立性は便利さではなく、業務invariantから決めます。
dry-runと負試験で停止範囲を確認する
正常系だけでは、障害時に全体停止するバグを見つけられません。3 route中1 routeへ401を注入し、残り2 routeが成功することをテストします。
it("isolates only the route that receives 401", async () => {
  fakeApi.reject("agent_memories_x", 401);
  fakeApi.succeed("agent_memories_bsky");
  fakeApi.succeed("agentmemories_blog");

  const result = await runBatch(routes, payloads);
  expect(result.map(x => [x.routeId, x.status])).toEqual([
    ["agent_memories_x", "isolated"],
    ["agent_memories_bsky", "success"],
    ["agentmemories_blog", "success"],
  ]);
  expect(fakeApi.writeCount("agent_memories_x")).toBe(1);
});
追加で、unknown例外、timeout後に外部effectが存在するケース、account不一致、隔離中のwrite拒否、read-only probe成功、half-openの再失敗を試します。dry-runでは外部writeを0にしつつ、どのrouteが実行、隔離、skipになるかを同じschemaで出力します。
response消失の負試験では、provider側でeffectを一件作成してからtimeoutさせます。直後の照合で同じidempotency keyのeffectへ収束し、writeCount === 1を確認します。別の負試験では2本目のpayloadを欠落させ、1本目と3本目がsuccess、2本目だけがfailedとなり、batch自体がthrowしないことを確認します。
テストの完了条件は「例外が捕まる」ではありません。失敗routeのwriteが増えない、正常routeのeffectが各1件、全成功routeでreadbackが一致、secret値がログに0件まで確認します。
監視は全体の赤ではなく内訳を出す
batch結果がfailed一語だと、運用者は全停止か部分障害か判断できません。集約Receiptにはroute別Outcomeと、次回の実行可否を入れます。
たとえばsuccess=7 / isolated=1 / skipped=2 / failed=0なら、全体としてはdegradedです。通知は「X publish routeのみ認証失敗で隔離、ブログと分析は継続、30分後にread-only probe、復帰条件はaccount identityと権限確認」と具体化します。
復旧時も人がcronを再有効化する前提にしません。正常なcredentialへ戻ったことをprobeが確認し、half-openの一件がreadbackまで通れば自動復帰します。このとき隔離中に溜まったpayloadは公開済み照合と期限確認を行い、古い投稿を一気に放出しないよう再計画します。
まとめ
安全な自動化は、異常を見つけたら何でも止める仕組みではありません。route_id、account、credential reference、operationを境界にし、具体的に危険なwriteだけを隔離します。
恒久・一時・unknownの分類、route health、read-only probe、half-open、状態遷移通知、負試験を揃えると、一件の認証失敗で組織全体が止まる問題を防げます。AIエージェントへ記憶させるべきなのも「失敗した」という曖昧な事実ではなく、どのrouteが、なぜ止まり、何を確認すれば戻せるかという実行可能な契約です。