

はじめに
自動投稿の失敗時にexit 1で止め、Discordへ通知するだけでは復旧ではありません。担当者が認証を直してもcronはdisableのまま、未公開原稿は古くなり、次の時間帯の処理も巻き込まれます。翌朝、誰かが手動実行して初めて戻る仕組みは自動化の途中です。
復旧ループには、公開済み照合、重複防止、安全な再試行、後続処理の継続または繰下げ、復旧通知が必要です。認証失効のようにその場で直せない原因でも、該当writeだけを待機させ、read-only probeを続ければ、有効な認証へ戻った時に自動復帰できます。
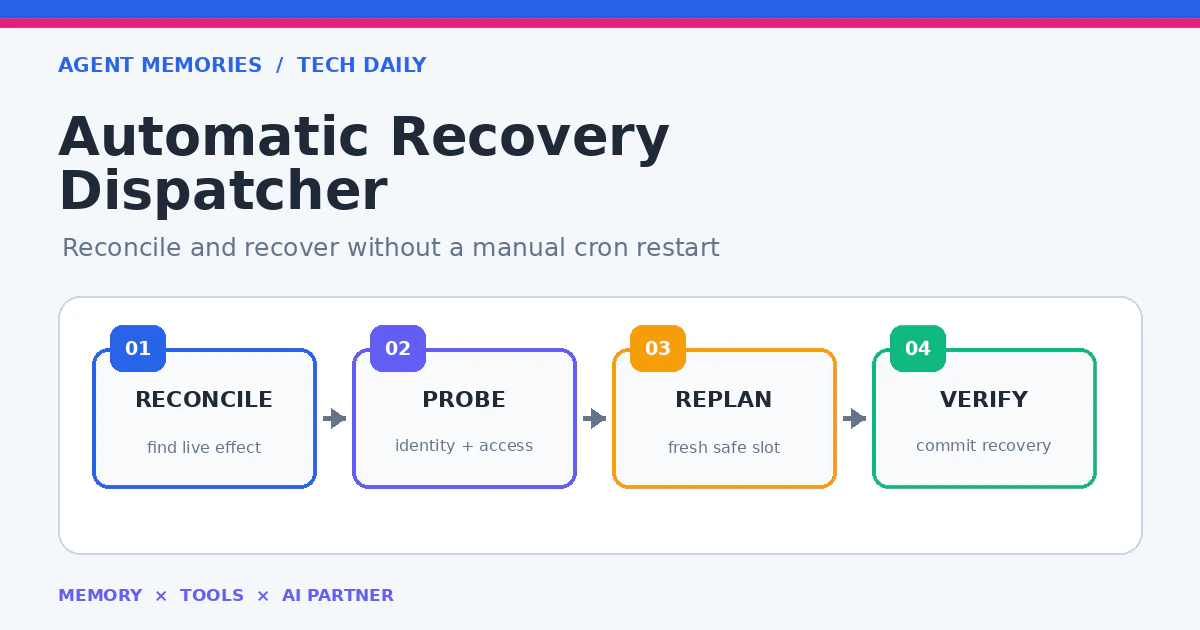
ここではRecovery Dispatcherを通常cronから分離せず、同じ状態機械の一部として実装します。Python例、Receipt schema、dry-run、テストを順に見ます。
停止ではなく状態遷移を記録する
復旧対象を単なる失敗ログにせず、次に何をすべきかを持つrecordへ変換します。
from dataclasses import dataclass
from typing import Literal

RecoveryState = Literal[
    "needs_reconcile", "waiting_probe", "ready_retry",
    "verifying", "recovered", "manual_action"
]

@dataclass(frozen=True)
class RecoveryItem:
    recovery_id: str
    route_id: str
    payload_hash: str
    planned_at: str
    state: RecoveryState
    attempt: int
    next_check_at: str
    external_id: str | None
    reason: str
payload_hashは再試行時に本文が差し替わっていないことを確認する鍵です。external_idがなくても、外部write開始後ならneeds_reconcileから始めます。timeoutを未実行と決めつけて新規writeすると、外部側だけ成功していた場合に二重投稿になります。
RecoveryItemにはsecret本文を含めません。route_idから承認済みのcredential referenceを解決し、実行直前にaccount identityを確認します。
公開済み照合を最初に行う
再試行より先に、予定時刻、author、本文hash、親子関係などで公開済みeffectを探します。見つかれば新しいwriteは不要です。
def reconcile(item, adapter):
    candidates = adapter.list_recent(
        route_id=item.route_id,
        since=item.planned_at,
        read_only=True,
    )
    matches = [x for x in candidates if x.payload_hash == item.payload_hash]
    if len(matches) == 1:
        return transition(item, "verifying", external_id=matches[0].id,
                          reason="existing_effect_found")
    if len(matches) > 1:
        return transition(item, "manual_action", reason="duplicate_effects_found")
    return transition(item, "waiting_probe", reason="effect_not_found")
照合対象が多すぎる場合は、route/account、狭い時刻窓、payload hashで絞ります。単に本文先頭20文字が同じという一致は危険です。外部サービスが本文を正規化する場合は、公開前とreadback後で同じcanonicalize関数を使ってhashを計算します。
既存effectが見つかった時も即recoveredにせず、公開URL、author、本文、画像、親IDをverifyします。必要条件が一つでも欠ければ、成功Receiptを作りません。
probeとwriteを分ける
認証失効中に毎分writeを繰り返すと、account lockやRate Limitを悪化させます。軽量なread-only probeで回復を観測し、writeは状態がready_retryになった時だけ許可します。
def dispatch(item, adapter, now):
    if now < parse_time(item.next_check_at):
        return item
    if item.state == "needs_reconcile":
        return reconcile(item, adapter)
    if item.state == "waiting_probe":
        probe = adapter.probe_identity(item.route_id, read_only=True)
        if not probe.ok:
            return reschedule(item, backoff(item.attempt), probe.reason)
        if probe.account != expected_account(item.route_id):
            return transition(item, "manual_action", reason="account_mismatch")
        return transition(item, "ready_retry", reason="probe_recovered")
    if item.state == "ready_retry":
        return execute_retry(item, adapter)
    if item.state == "verifying":
        return verify_effect(item, adapter)
    return item
probeの成功は「アクセスできた」だけでなく、期待accountと必要権限の一致まで含めます。別accountでログインできた状態は回復ではありません。unknownなprobe結果はfail-closedし、writeへ進めません。
再試行に期限とbudgetを持たせる
すべてのpayloadを後日公開すればよいわけではありません。速報、朝の挨拶、キャンペーン期限など、鮮度を失ったpayloadがあります。Recovery Dispatcherはexpires_atとattempt budgetを検査します。
function retryDecision(item: RecoveryItem, now: Date): RetryDecision {
  if (now >= new Date(item.expiresAt)) {
    return { action: "drop", reason: "payload_expired" };
  }
  if (item.attempt >= item.maxAttempts) {
    return { action: "manual", reason: "retry_budget_exhausted" };
  }
  if (!item.approvalValid || item.currentHash !== item.approvedHash) {
    return { action: "hold", reason: "approval_or_hash_changed" };
  }
  return { action: "retry", reason: "within_budget" };
}
再試行前には公開台帳をもう一度照合し、分散lockを取ります。最初の実行と復旧実行が同時に走っても、同一route_id + payload_hashのwriteは一件に収束させます。attempt数はwriteを始める直前にatomicに確保し、プロセス終了で巻き戻しません。
後続枠を再計画する
失敗分を今すぐ出すと、次の予約投稿と衝突する場合があります。後続処理を全停止するのではなく、cadenceを守って再配置します。
def replan(queue, recovered_item, now):
    next_slot = cadence.next_available_after(now)
    if recovered_item.expires_at <= next_slot:
        return mark_dropped(recovered_item, "no_fresh_slot")
    queue.reserve(next_slot, recovered_item.id)
    for item in queue.after(next_slot):
        if cadence.distance(item.slot, previous_slot(item, queue)) < cadence.minimum:
            queue.move(item.id, cadence.next_available_after(item.slot))
    return queue
公開頻度が一日一件なら、復旧した二件を連続放出しません。期限切れをdropし、次に鮮度があるものを一枠だけ予約します。後続のブログ生成やread-only分析は、write障害と独立していれば継続します。
再計画結果もReceiptへ残し、recovered_now、rescheduled、dropped_expiredを区別します。「復旧したので全部成功」という雑な集約を避けます。
atomic Receiptと通知を組み合わせる
各遷移をJSONLのeventとしてappendし、latest stateは一時ファイルからrenameします。通知が失敗しても状態を失わないよう、保存を先に行います。
{
  "schema": "recovery-event/v1",
  "recovery_id": "rcv_20260722_001",
  "route_id": "agent_memories_x",
  "from": "waiting_probe",
  "to": "ready_retry",
  "reason": "identity_and_permission_restored",
  "payload_hash": "sha256:...",
  "external_effect_count": 0,
  "recorded_at": "2026-07-22T02:00:00Z"
}
通知はwaiting_probeが続くたびに送らず、初回障害、manual action化、recoveredの遷移に限定します。復旧通知には公開URLとreadback項目、繰り下げた後続枠を含めます。
失敗を注入して自動復帰をテストする
テストでは、人がcronをenableし直さなくても回復することを確認します。
def test_auth_recovers_without_manual_cron_restart(fake_adapter, clock):
    item = recovery_item(state="waiting_probe", attempt=1)
    fake_adapter.probe_results = [AuthError(), Probe(ok=True, account="agentmemories")]

    first = dispatch(item, fake_adapter, clock.now())
    assert first.state == "waiting_probe"
    assert fake_adapter.write_count == 0

    clock.advance(minutes=30)
    second = dispatch(first, fake_adapter, clock.now())
    assert second.state == "ready_retry"

    third = dispatch(second, fake_adapter, clock.now())
    assert third.state == "verifying"
    assert fake_adapter.write_count == 1
さらに「timeoutだが外部側は成功」「同一payloadを二つのworkerが処理」「probeが別accountを返す」「approval hashが変わる」「期限切れ」「readback不一致」を負試験にします。dry-runでは状態遷移と再計画だけを出し、external write countが0であることをassertします。
最終的な完了条件は、公開済み照合、write最大1回、readback一致、後続cadence維持、recovered Receipt、通知遷移の6点です。
まとめ
Recovery Dispatcherは失敗を再実行するだけのretry workerではありません。外部effectの照合、read-only probe、hashと承認の再確認、期限とbudget、後続枠の再計画、readback、復旧通知を一つの状態機械にします。
これにより、自動解消できない認証切れでも対象writeだけを待機させ、正常な処理を続けられます。そして認証が戻れば手動cron再開なしで安全に復帰します。AIエージェントの記憶には、障害の説明だけでなく、現在state、次のprobe、再試行条件、完了証拠を残すことが重要です。