
はじめに
AIエージェントを複数動かすと、同じキューを二台が読んだり、タイムアウトした親が子を再起動したりして、同一タスクが重複実行されます。下書き生成なら上書きで済んでも、SNS投稿、請求、デプロイなど外部作用では事故になります。
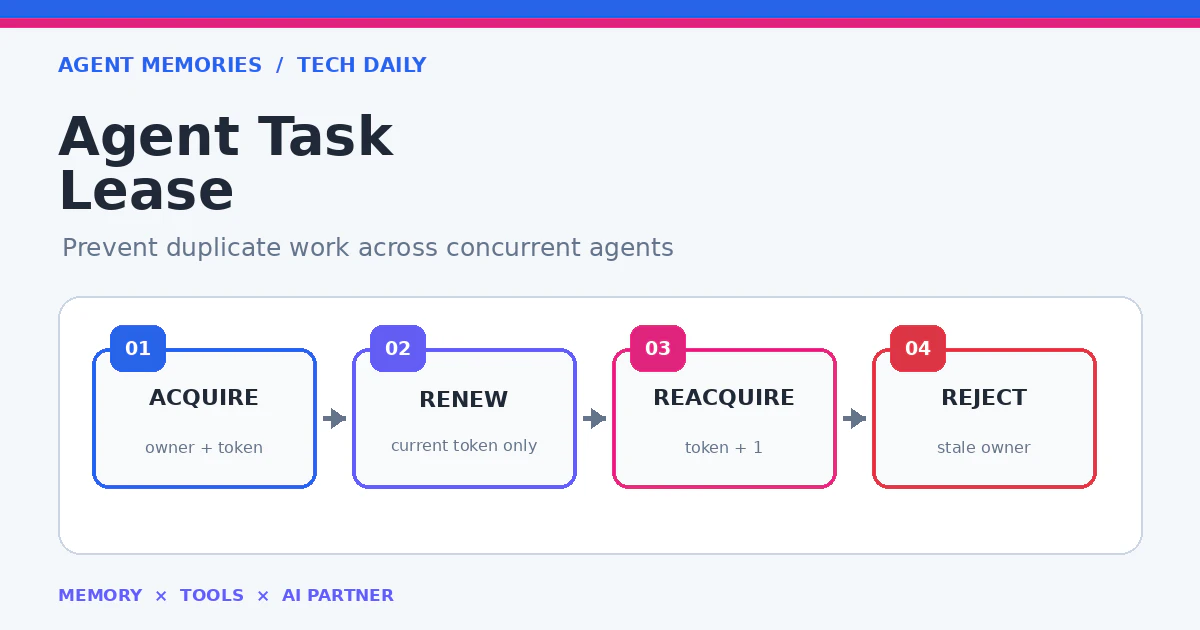
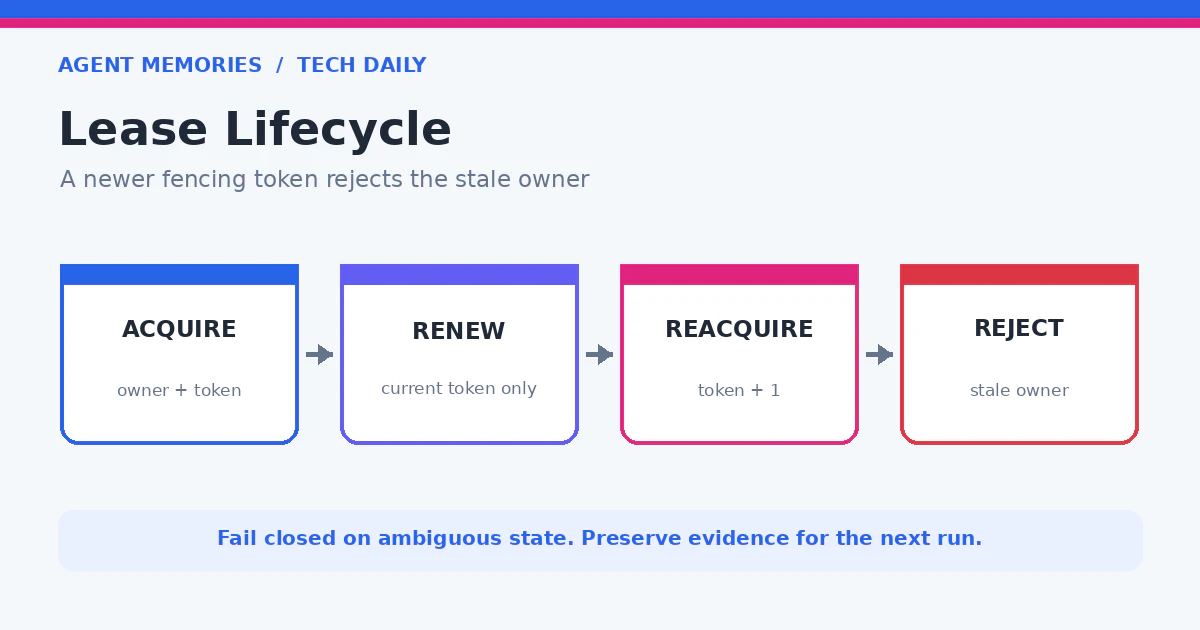
単純な locked=true は、ownerが停止すると永遠に残ります。逆に一定時間後にlockを削除するだけでは、遅れて復帰した旧ownerが処理を続けます。必要なのは期限付きTask Leaseと、古いownerの書き込みを拒否するfencing tokenです。
Leaseのschemaを決める
Task本体とLease状態を分け、owner、期限、単調増加tokenを持たせます。
from dataclasses import dataclass
from datetime import datetime

@dataclass(frozen=True)
class TaskLease:
    task_id: str
    owner_id: str
    release_id: str
    route_id: str
    payload_hash: str
    lease_until: datetime
    fencing_token: int
    acquired_at: datetime
    heartbeat_at: datetime

@dataclass(frozen=True)
class Task:
    task_id: str
    release_id: str
    route_id: str
    status: str
    payload_hash: str
owner_id だけでなく release_id、route_id、payload_hash もLeaseへ固定します。外部作用の直前にTaskを別途読んで結合すると、二回のreadの間に値が変わる余地が生まれます。Lease取得時の固定値を一組として扱い、別release、別アカウント、別payloadへの混同を拒否します。
compare-and-swapで取得する
Lease取得は読んでから書く二段階ではなく、DBのtransactionまたはcompare-and-swapで行います。workerから渡された時刻は使いません。DBの時計で期限を判定し、取得のたびに新しいownership epochとしてtokenを1増やします。heartbeatによる延長ではtokenを増やしません。
UPDATE task_leases
SET owner_id = :owner,
    release_id = :release_id,
    route_id = :route_id,
    payload_hash = :payload_hash,
    lease_until = clock_timestamp() + INTERVAL '60 seconds',
    fencing_token = fencing_token + 1,
    acquired_at = clock_timestamp(),
    heartbeat_at = clock_timestamp()
WHERE task_id = :task_id
  AND lease_until < clock_timestamp()
RETURNING task_id, owner_id, release_id, route_id,
          payload_hash, lease_until, fencing_token;
更新件数0なら取得失敗です。待つか別タスクへ進みます。同じownerの二つのthreadも例外にしません。期限内なら片方だけがownerで、期限後の再取得は同じownerでも新tokenです。強制的にlockを消す運用は避け、期限とownerの証跡を残します。
PostgreSQLのCURRENT_TIMESTAMPはtransaction開始時刻で固定されます。長いtransaction内で実時間の期限を判定する場合は、呼び出す瞬間の時刻を返すclock_timestamp()を使います。これでworker間の時計ずれをLease判定から外せます。
token確認と外部作用を直列化する
Leaseが切れた旧ownerは、自分が失効したことを知らず処理を続けるかもしれません。単にleaseStore.get()でtokenを確認してからAPIを呼ぶだけでは不十分です。確認後に新ownerがLeaseを取得すると、旧ownerも外部作用を実行できるからです。
外部resourceがfencing tokenを受け付けるなら、resource側にlast_fencing_tokenを持たせ、過去tokenのwriteを拒否します。受け付けないAPIでは、Lease取得とeffect adapterが同じDB行をロックし、token検証、effect intentの予約、外部callを直列化します。
type EffectRequest = {
  taskId: string;
  releaseId: string;
  routeId: string;
  payloadHash: string;
  fencingToken: number;
  action: "publish" | "deploy" | "send";
};

async function executeEffect(req: EffectRequest) {
  const effectKey = sha256([
    req.taskId,
    req.releaseId,
    req.routeId,
    req.action,
    req.payloadHash,
  ].join("\x1f"));

  const outcome = await db.transaction(async (tx) => {
    // Lease取得側も同じ行をUPDATEする。外部callが終わるまでtakeoverは待つ。
    const lease = await tx.taskLease.selectForUpdate(req.taskId);
    assertEqual(req.taskId, lease.taskId);
    assertEqual(req.releaseId, lease.releaseId);
    assertEqual(req.routeId, lease.routeId);
    assertEqual(req.payloadHash, lease.payloadHash);
    assertEqual(req.fencingToken, lease.fencingToken);
    assertDbClockBefore(lease.leaseUntil);

    const previous = await tx.effectReceipt.find(effectKey);
    if (previous?.status === "succeeded") return previous;
    if (previous?.status === "unknown_result") {
      throw new Error("reconcile_before_retry");
    }

    await tx.effectReceipt.insert({
      effectKey,
      fencingToken: req.fencingToken,
      status: "executing",
    });

    try {
      const result = await effectAdapter.execute({
        ...req,
        idempotencyKey: effectKey,
      });
      return tx.effectReceipt.succeed(effectKey, result.externalId);
    } catch (error) {
      if (isNetworkTimeout(error)) {
        await tx.effectReceipt.markUnknown(effectKey);
        // 例外でtransactionをrollbackせず、unknown_resultをcommitする。
        return { status: "unknown_result", effectKey };
      }
      throw error;
    }
  });
  if (outcome.status === "unknown_result") {
    throw new Error("unknown_result");
  }
  return outcome;
}
この例は分かりやすさを優先し、短いtimeoutを設定した外部call中もLease行のlockを保持します。長時間の外部処理では、transactional outboxとresource単位のsingle consumerへ分離します。ただしoutboxだけでは重複送信を消せません。外部APIにも同じeffectKeyをidempotency keyとして渡し、consumer側でもReceiptを照合します。
API成功後に応答だけ消えた場合は、成功・失敗を決め打ちしません。Receiptをunknown_resultへ置き、外部ID、投稿URL、請求オブジェクトなどをreadbackしてからsucceededへ収束させます。readback前に新しいkeyで再送すると二重実行になります。
外部resourceがfencing token、idempotency key、結果readbackのすべてに非対応なら、一般にはexactly-onceを保証できません。その操作は自動retryせず、人の確認を含むunknown_result復旧へ送ります。
heartbeatと延長条件を絞る
長いタスクではLeaseを延長します。ただし別threadが無条件に延長すると、停止した処理を永続化します。owner自身が進捗を記録した場合だけ延長し、最大保持時間を設けます。
def renew_lease(task_id, owner_id, token, progress_hash):
    lease = store.get(task_id)
    if lease.owner_id != owner_id or lease.fencing_token != token:
        raise RuntimeError("lease_lost")
    if not progress_store.is_new(task_id, progress_hash):
        raise RuntimeError("no_progress_no_renewal")
    server_now = store.clock_timestamp()
    if server_now - lease.acquired_at > MAX_LEASE_LIFETIME:
        raise RuntimeError("max_lease_lifetime_exceeded")
    return store.compare_and_renew(
        task_id=task_id,
        owner_id=owner_id,
        fencing_token=token,
        lease_until=server_now + LEASE_WINDOW,
    )
生成モデルの応答待ちなど進捗を測りにくい処理は、外部作用を伴わない段階に限定します。公開直前にはfresh leaseを取得し直し、routeとreleaseを再確認します。
handoffを状態遷移として残す
エージェント交代は口頭メッセージではなく、blocked → lease_expired → resumed のイベントとして台帳へ残します。新ownerは過去ログ全文ではなく、objective、artifact path、hash、next action、完了条件を読みます。
記憶基盤へはTask Leaseそのものではなく、なぜ交代したか、どの成果物が正本かを保存します。モデルや実行環境が変わっても、同じreleaseを続きから処理できます。
競合をテストする
テストでは二つのworkerを同時起動し、片方だけがLeaseを得ることを確認します。さらに旧ownerの遅延復帰を再現します。
def test_only_one_worker_acquires_lease(db):
    results = run_concurrently(
        lambda: acquire("task-1", "agent-a"),
        lambda: acquire("task-1", "agent-b"),
    )
    assert sum(result.acquired for result in results) == 1

def test_stale_owner_cannot_publish():
    old = acquire("task-2", "agent-a")
    clock.advance(seconds=61)
    new = acquire("task-2", "agent-b")
    assert new.fencing_token > old.fencing_token
    with pytest.raises(StaleTokenError):
        publish(task_id="task-2", fencing_token=old.fencing_token)

def test_same_effect_retry_converges_to_one_receipt():
    lease = acquire("task-3", "agent-a")
    first = publish(task_id="task-3", token=lease.token)
    second = publish(task_id="task-3", token=lease.token)
    assert first.receipt_id == second.receipt_id
    assert provider.call_count == 1

def test_timeout_requires_readback_before_retry():
    provider.succeed_then_drop_response()
    with pytest.raises(UnknownResult):
        publish(task_id="task-4")
    with pytest.raises(ReconcileBeforeRetry):
        publish(task_id="task-4")
    receipt = reconcile(task_id="task-4")
    assert receipt.status == "succeeded"
    assert provider.call_count == 1

@pytest.mark.parametrize("field", ["release_id", "route_id", "payload_hash"])
def test_binding_mismatch_is_rejected(field):
    request = valid_request() | {field: "different"}
    with pytest.raises(EffectBindingMismatch):
        publish(**request)
ほかにTOCTOUを再現し、旧ownerの外部call中はtakeoverが同じLease行で待つことを確認します。時計を大きくずらしたclient、同一ownerの二重thread、heartbeat停止、DB再接続も負系に入れます。完了条件は外部作用1回、Receipt 1件、最終ownerとtoken一致です。
運用で見る指標
lease_acquire_conflict_total、stale_token_rejected_total、lease_expired_total、task_resume_seconds を監視します。競合が急増したらworker数だけでなく、キューのpartition keyやtask ID生成を確認します。
ログにはtask ID、owner ID、token、statusを残し、payload本文やsecretは出しません。強制解除が必要な場合も削除ではなく、管理者によるrevokeイベントと新token発行を記録します。
まとめ
Task Leaseは「今誰が作業中か」を示し、fencing tokenは「古いownerの外部作用を拒否する」仕組みです。ただしtokenだけでは、確認直後のtakeoverや同一tokenのretryを防げません。resource側のfencingまたは共有lockによる直列化、安定したidempotency key、Receipt、unknown_resultのreadbackを組み合わせます。
役割を持つAIチームでは、記憶だけでなく作業所有権も引き継ぐ必要があります。正本path、hash、release ID、Leaseをそろえることで、別AIへ持ち出しても二重実行せず続きから再開できます。
参考: