
はじめに
Xで、t検定が話題になっていて、近くて遠い専門分野である検定に関して、勉強しようと思い記事を書いてみます。
t検定の前提が、標本の平均が正規分布である事をデータ自体が正規分布であると勘違いしてXで指摘されたところからスタートなので、間違えている所あるかもしれませんが、参考になると幸いです。
2つのグループの平均値に差があるかを調べる際、代表的な統計手法としてt検定が使われます。
t検定は比較的簡単に実施できる一方で、いくつかの前提条件があります。
例えば、次のような疑問があります。
- サンプル数が少ない場合でも正しく検定できるのか?
- 元データが正規分布に従わない場合はどうなるのか?
- 外れ値が含まれていると検定結果にどの程度影響するのか?
特に実際のデータ分析では、十分なサンプル数を確保できないケースや、データの分布が正規分布から大きく外れているケースもあります。
そこで今回は、Pythonを使ってデータを生成し、サンプル数や分布の違いによってt検定の結果がどのように変化するのかをシミュレーションで検証してみます。
検証手法
1. t検定
今回は、独立した2つのグループの平均値を比較する2標本t検定を対象とします。
t検定には、主に次の2種類があります。
- Studentのt検定:2群の分散が等しいことを仮定する
- Welchのt検定:2群の分散が等しいことを仮定しない
検定は両側検定とし、有意水準は5%とします。
2. 検証条件
サンプル数を変化させながら、2群のデータを生成します。
サンプル数は以下の条件とします。
5、10、15、20、30、50、75、100、150、200
また、データの分布による影響を確認するため、以下の分布を対象とします。
- 正規分布
- 一様分布
- 指数分布
- 対数正規分布
- t分布
- 二峰性分布
それぞれの条件でデータを生成し、t検定を繰り返し実施します。
3. 評価方法
検定結果の評価には、以下の2つを使用します。
第一種過誤率(Type I error rate)
本当は2群の平均値に差がない場合に、誤って有意差があると判定する割合です。
有意水準を5%に設定した場合、第一種過誤率もおおむね5%になることが期待されます。
検出力(Statistical power)
実際に2群の平均値に差がある場合に、有意差があると正しく判定できる割合です。
今回は効果量を0.5に設定し、平均値に差がある場合の検出力を評価します。
これらを比較することで、サンプル数やデータ分布が検定の信頼性に与える影響を確認します。
検証結果
1. サンプル数と検定結果(データ分布による影響)
まず、サンプル数を変化させた場合の第一種過誤率(Type I error rate)と検出力(Statistical power)を比較します。


サンプル数が増加すると、一般的に検出力が向上する傾向が確認できます。
一方、サンプル数が少ない場合には、実際に平均値に差があっても有意差を検出できないケースが多くなります。
正規分布と比較すると、対数正規分布や指数分布など、分布の歪みが大きい条件では検定結果に違いが見られます。
特にサンプル数が少ない場合には、元データの分布の影響が残りやすく、検定結果が安定しない可能性があります。
2. 標本平均の分布
ここで、元データだけでなく、標本平均の分布についても確認します。
二峰分布のサンプル30の時の標本平均

元データが正規分布でない場合でも、サンプル数を増やすことで標本平均の分布は正規分布に近づいていきます。
これは中心極限定理によるものです。
ただし、分布の歪みが大きい場合には、サンプル数が少ない段階では標本平均の分布にも歪みが残ります。
特に対数正規分布や外れ値を含むデータでは、この影響を確認することができます。
対数正規分布のサンプル30の標本平均
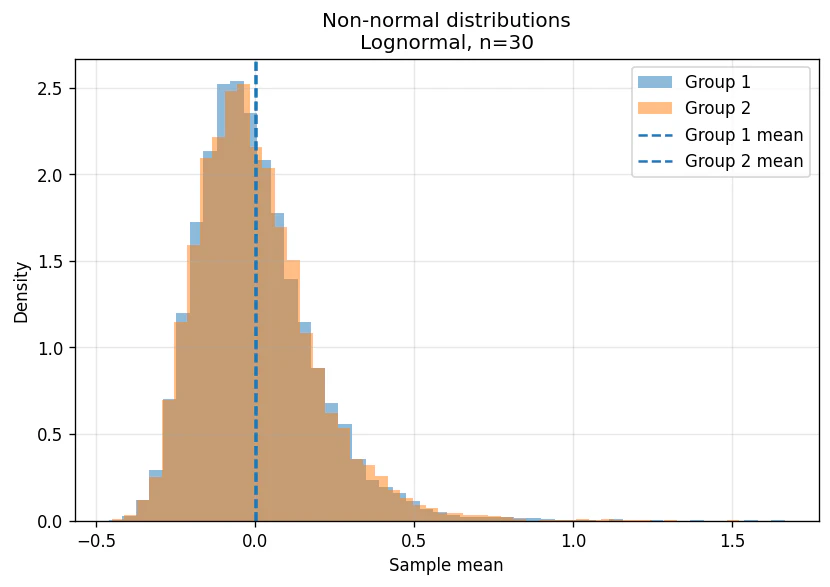
対数正規分布のサンプル200の標本平均

※サンプル数を増やしていくと正規分布に近づいていく事がわかります。
4. サンプル数25の場合
今回の検証では、サンプル数が25程度の場合についても確認しました。
第一種過誤率については、多くの条件でおおむね5%付近に収まる一方、検出力は条件によって低くなり、非正規分布では0.3~0.5程度となるケースも見られました。
つまり、サンプル数が少ない場合には、t検定の有意水準が維持されていても、実際の差を検出する能力は十分でない場合があります。
おわりに
今回は、Pythonによるシミュレーションを使って、t検定に対するサンプル数やデータ分布の影響を検証しました。
今回の結果から、次のことが分かりました。
- サンプル数が増えると検出力が向上する傾向がある
- データ分布の歪みは、特にサンプル数が少ない場合に影響する
- 標本平均の分布はサンプル数の増加によって正規分布に近づく
- 第一種過誤率と検出力は分けて評価する必要がある
t検定は、元データが完全な正規分布でなければ使えないというわけではありません。
今回記事で触れたのは、データ自体が正規分布でない場合の違いですが、
一方で、サンプル数が少なく、分布の歪みや外れ値が大きい場合には、検定結果の解釈に注意が必要です。
実際のデータ分析では、単純にp値だけを見るのではなく、データの分布やサンプル数、効果量なども含めて判断することが重要だと考えられます。
pythonコード
外れ値がある場合や分布の分散が違う場合も試せます。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats


# ============================================================
# 共通設定
# ============================================================

N_SIM = 10000
SAMPLE_SIZES = [5, 10, 15, 20, 30, 50, 75, 100, 150, 200]

ALPHA = 0.05
EFFECT_SIZE = 0.5

OUTLIER_SD = 10.0

rng = np.random.default_rng(42)


# ============================================================
# データ生成
# ============================================================

def generate_samples(
    distribution,
    n_sim,
    n,
    rng,
    contam_rate=0.0,
    outlier_sd=OUTLIER_SD,
):
    """
    平均0、分散1を基本としたデータを生成する。

    戻り値:
        shape = (n_sim, n)
    """

    if distribution == "Normal":
        return rng.normal(0, 1, size=(n_sim, n))

    elif distribution == "Uniform":
        # 平均0、分散1
        return rng.uniform(
            -np.sqrt(3),
            np.sqrt(3),
            size=(n_sim, n),
        )

    elif distribution == "Exponential":
        # 平均0、分散1
        return rng.exponential(
            scale=1.0,
            size=(n_sim, n),
        ) - 1.0

    elif distribution == "Lognormal":
        # 対数正規分布を平均0、分散1に標準化
        x = rng.lognormal(
            mean=0,
            sigma=1,
            size=(n_sim, n),
        )

        mean = np.exp(0.5)
        variance = np.exp(2) - np.exp(1)

        return (x - mean) / np.sqrt(variance)

    elif distribution == "StudentT":
        # 自由度3のt分布を分散1に標準化
        return rng.standard_t(
            df=3,
            size=(n_sim, n),
        ) / np.sqrt(3)

    elif distribution == "Bimodal":
        # 2つの正規分布を混合した二峰性分布
        signs = rng.choice(
            [-1, 1],
            size=(n_sim, n),
        )

        x = signs + rng.normal(
            0,
            0.5,
            size=(n_sim, n),
        )

        # 理論分散は 1 + 0.5^2 = 1.25
        return x / np.sqrt(1.25)

    elif distribution == "ContaminatedNormal":
        # 正規分布に外れ値を混入
        x = rng.normal(
            0,
            1,
            size=(n_sim, n),
        )

        mask = rng.random((n_sim, n)) < contam_rate

        x[mask] = rng.normal(
            0,
            outlier_sd,
            size=np.sum(mask),
        )

        # 混合分布の理論分散を1に標準化
        variance = (
            (1 - contam_rate)
            + contam_rate * outlier_sd**2
        )

        return x / np.sqrt(variance)

    else:
        raise ValueError(
            f"Unknown distribution: {distribution}"
        )


# ============================================================
# SciPyによる検定
# ============================================================

def evaluate_tests(x1, x2):
    """
    Studentのt検定とWelchのt検定を実行する。

    x1, x2:
        shape = (n_sim, n)

    axis=1により、シミュレーションごとに検定する。
    """

    student_p = stats.ttest_ind(
        x1,
        x2,
        axis=1,
        equal_var=True,
    ).pvalue

    welch_p = stats.ttest_ind(
        x1,
        x2,
        axis=1,
        equal_var=False,
    ).pvalue

    return {
        "Student": student_p,
        "Welch": welch_p,
    }


# ============================================================
# 1条件分のシミュレーション
# ============================================================

def simulate_case(
    experiment,
    condition,
    n,
    dist1,
    dist2,
    contam1=0.0,
    contam2=0.0,
    scale1=1.0,
    scale2=1.0,
):
    # --------------------------------------------------------
    # 帰無仮説
    # --------------------------------------------------------

    x1_null = generate_samples(
        dist1, N_SIM, n, rng,
        contam_rate=contam1,
    ) * scale1

    x2_null = generate_samples(
        dist2, N_SIM, n, rng,
        contam_rate=contam2,
    ) * scale2

    # 標本平均値を保存
    mean1 = np.mean(x1_null, axis=1)
    mean2 = np.mean(x2_null, axis=1)

    # --------------------------------------------------------
    # 対立仮説
    # --------------------------------------------------------

    reference_sd = np.sqrt(
        (scale1**2 + scale2**2) / 2
    )

    delta = EFFECT_SIZE * reference_sd

    x1_alt = generate_samples(
        dist1, N_SIM, n, rng,
        contam_rate=contam1,
    ) * scale1

    x2_alt = generate_samples(
        dist2, N_SIM, n, rng,
        contam_rate=contam2,
    ) * scale2

    x2_alt += delta

    # --------------------------------------------------------
    # 検定
    # --------------------------------------------------------

    null_results = evaluate_tests(x1_null, x2_null)
    alt_results = evaluate_tests(x1_alt, x2_alt)

    results = []

    for test_name in ["Student", "Welch"]:

        type1_error = np.mean(
            null_results[test_name] < ALPHA
        )

        power = np.mean(
            alt_results[test_name] < ALPHA
        )

        results.append({
            "Experiment": experiment,
            "Condition": condition,
            "SampleSize": n,
            "Test": test_name,
            "Type1Error": type1_error,
            "Power": power,
        })

    # 標本平均値の分布も返す
    mean_data = {
        "Experiment": experiment,
        "Condition": condition,
        "SampleSize": n,
        "Mean1": mean1,
        "Mean2": mean2,
    }

    return results, mean_data

# ============================================================
# 実験1:非正規分布
# ============================================================

def experiment1():

    experiment = "Non-normal distributions"

    conditions = [
        ("Normal", "Normal"),
        ("Uniform", "Uniform"),
        ("Exponential", "Exponential"),
        ("Lognormal", "Lognormal"),
        ("StudentT", "StudentT"),
        ("Bimodal", "Bimodal"),
    ]

    results = []
    mean_data = []

    for n in SAMPLE_SIZES:

        for dist1, dist2 in conditions:

            condition = dist1

            r, m = simulate_case(
                experiment,
                condition,
                n,
                dist1,
                dist2,
            )
            results.extend(r)
            mean_data.append(m)

    return results, mean_data

# ============================================================
# 実験2:外れ値の影響
# ============================================================

def experiment2():

    experiment = "Outliers"

    conditions = [
        ("No outlier", 0.0, 0.0),
        ("Both 1%", 0.01, 0.01),
        ("Both 5%", 0.05, 0.05),
        ("Group2 only 1%", 0.0, 0.01),
        ("Group2 only 5%", 0.0, 0.05),
    ]

    results = []
    mean_data = []

    for n in SAMPLE_SIZES:

        for condition, contam1, contam2 in conditions:

            r, m = simulate_case(
                    experiment,
                    condition,
                    n,
                    "ContaminatedNormal",
                    "ContaminatedNormal",
                    contam1=contam1,
                    contam2=contam2,
                )
            results.extend(r)
            mean_data.append(m)

    return results,mean_data


# ============================================================
# 実験3:等分散性の影響
# ============================================================

def experiment3():

    experiment = "Unequal variances"

    conditions = [
        ("Equal variance", 1.0, 1.0),
        ("Group1 SD 2x", 2.0, 1.0),
        ("Group2 SD 2x", 1.0, 2.0),
        ("Group1 SD 4x", 4.0, 1.0),
        ("Group2 SD 4x", 1.0, 4.0),
    ]

    results = []
    mean_data = []

    for n in SAMPLE_SIZES:

        for condition, scale1, scale2 in conditions:

            r,m = simulate_case(
                    experiment,
                    condition,
                    n,
                    "Normal",
                    "Normal",
                    scale1=scale1,
                    scale2=scale2,
                 )

            results.extend(r)
            mean_data.append(m)

    return results,mean_data


# ============================================================
# グラフ描画
# ============================================================

def plot_experiment(df, experiment, test_name):

    subset = df[
        (df["Experiment"] == experiment)
        & (df["Test"] == test_name)
    ]

    fig, axes = plt.subplots(
        1,
        2,
        figsize=(14, 5),
    )

    metrics = [
        ("Type1Error", "Type I error rate"),
        ("Power", "Statistical power"),
    ]

    for ax, (metric, title) in zip(axes, metrics):

        for condition in subset["Condition"].unique():

            data = subset[
                subset["Condition"] == condition
            ].sort_values("SampleSize")

            ax.plot(
                data["SampleSize"],
                data[metric],
                marker="o",
                label=condition,
            )

        ax.set_title(title)
        ax.set_xlabel("Sample size per group")
        ax.set_ylabel(metric)
        ax.grid(True, alpha=0.3)

        if metric == "Type1Error":
            ax.axhline(
                ALPHA,
                color="black",
                linestyle="--",
                label="Alpha = 0.05",
            )
            ax.set_ylim(0, 0.2)

        else:
            ax.set_ylim(0, 1)

        ax.legend(fontsize=8)

    fig.suptitle(
        f"{experiment} - {test_name}",
        fontsize=14,
    )

    plt.tight_layout()

    filename = (
        experiment.replace(" ", "_")
        + "_"
        + test_name
        + ".png"
    )

    plt.savefig(
        filename,
        dpi=150,
        bbox_inches="tight",
    )

    plt.show()


def plot_sample_mean_distribution(mean_data):

    for data in mean_data:
        experiment = data["Experiment"]
        condition = data["Condition"]
        n = data["SampleSize"]

        mean1 = data["Mean1"]
        mean2 = data["Mean2"]

        plt.figure(figsize=(8, 5))

        plt.hist(
            mean1,
            bins=50,
            density=True,
            alpha=0.5,
            label="Group 1",
        )

        plt.hist(
            mean2,
            bins=50,
            density=True,
            alpha=0.5,
            label="Group 2",
        )

        plt.axvline(
            np.mean(mean1),
            linestyle="--",
            linewidth=1.5,
            label="Group 1 mean",
        )

        plt.axvline(
            np.mean(mean2),
            linestyle="--",
            linewidth=1.5,
            label="Group 2 mean",
        )

        plt.title(
            f"{experiment}\n"
            f"{condition}, n={n}"
        )

        plt.xlabel("Sample mean")
        plt.ylabel("Density")

        plt.legend()
        plt.grid(alpha=0.3)

        filename = (
            f"mean_{experiment.replace(' ', '_')}_"
            f"{condition.replace(' ', '_')}_n{n}.png"
        )

        plt.savefig(
            filename,
            dpi=120,
            bbox_inches="tight",
        )

        plt.close()

# ============================================================
# 実行
# ============================================================

results = []
all_mean_data = []

r, m = experiment1()
results.extend(r)
all_mean_data.extend(m)

r, m = experiment2()
results.extend(r)
all_mean_data.extend(m)

r, m = experiment3()
results.extend(r)
all_mean_data.extend(m)

df = pd.DataFrame(results)

df.to_csv(
    "ttest_simulation_results.csv",
    index=False,
)

# 検定結果のグラフ
experiments = [
    "Non-normal distributions",
    "Outliers",
    "Unequal variances",
]

for experiment in experiments:

    for test_name in ["Student", "Welch"]:

        plot_experiment(
            df,
            experiment,
            test_name,
        )

# 標本平均値の分布
plot_sample_mean_distribution(all_mean_data)

print("Simulation completed.")