
はじめに
自宅のMacで使っているLLMサービス環境(日常会話AIエージェント用)の構築メモです。
前提
- Mac mini M4 (RAM:32GB)
LLMサーバ
llama.cpp 公式インストーラを実行します。
curl -LsSf https://llama.app/install.sh | sh
成功判定: 次のコマンドでバージョンとビルド情報が表示されます。
llama cli --version
version: 0.6.0-dev (build 11429, commit d81235049)
built with AppleClang 21.0.0.21000101 for Darwin aarch64
起動・停止スクリプト
前提として、$HOME/bin ディレクトリを作成して $PATH に追加している前提です。
モデルは、unsloth版の gemma-4-26B-A4B-it-qat のGGUFを使います。
※画像解析はメモリ節約のために外しています
cat > ~/bin/gemma4.sh <<'EOF'
#!/bin/zsh

# Mac mini 用 llama.cpp / Gemma 4 管理スクリプト
# 使用方法: gemma4.sh {start|stop|restart|status}

export PATH="$HOME/.local/bin:$PATH"

PID_FILE="$HOME/.gemma4.pid"
LOG_FILE="$HOME/.gemma4.log"
MODEL="unsloth/gemma-4-26B-A4B-it-qat-GGUF:UD-Q4_K_XL"
PORT=8080
LLAMA_BIN="$(command -v llama)"

start() {
    # 二重起動を防ぎ、停止済みのPIDファイルは掃除する
    if [ -f "$PID_FILE" ]; then
        local old_pid="$(cat "$PID_FILE")"
        if kill -0 "$old_pid" 2>/dev/null; then
            echo "Gemma 4 is already running. PID=$old_pid"
            return 0
        fi
        rm -f "$PID_FILE"
    fi

    if [ -z "$LLAMA_BIN" ]; then
        echo "llama command not found. Install llama.cpp first."
        return 1
    fi

    # Gemma 4 26B QAT / コンテキスト65536 / 並列1 / MTP有効
    # 画像用プロジェクタは読み込まず、テキスト用途で起動する
    nohup "$LLAMA_BIN" serve \
        -hf "$MODEL" \
        -ngl 999 \
        -fa on \
        --spec-type draft-mtp \
        --spec-draft-n-max 4 \
        --reasoning auto \
        --reasoning-effort low \
        --reasoning-budget 1024 \
        --ctx-size 65536 \
        --parallel 1 \
        --cache-ram 4096 \
        --no-mmproj \
        --host 0.0.0.0 \
        --port "$PORT" \
        > "$LOG_FILE" 2>&1 < /dev/null &

    local pid=$!
    echo "$pid" > "$PID_FILE"
    sleep 1

    # 初回ダウンロード中でもプロセスの生存を確認する
    if kill -0 "$pid" 2>/dev/null; then
        echo "Gemma 4 starting. PID=$pid"
        echo "Log: $LOG_FILE"
    else
        rm -f "$PID_FILE"
        echo "Gemma 4 failed to start. Check: $LOG_FILE"
        return 1
    fi
}

stop() {
    # PIDファイルがなければ停止済みと判定する
    if [ ! -f "$PID_FILE" ]; then
        echo "Gemma 4 is not running."
        return 0
    fi

    local pid="$(cat "$PID_FILE")"
    if ! kill -0 "$pid" 2>/dev/null; then
        rm -f "$PID_FILE"
        echo "Gemma 4 is not running."
        return 0
    fi

    # 通常終了を最大10秒待つ
    kill "$pid" 2>/dev/null
    local i
    for i in {1..10}; do
        if ! kill -0 "$pid" 2>/dev/null; then
            rm -f "$PID_FILE"
            echo "Gemma 4 stopped."
            return 0
        fi
        sleep 1
    done

    # 通常終了できなかった場合だけ強制終了する
    kill -9 "$pid" 2>/dev/null
    rm -f "$PID_FILE"
    echo "Gemma 4 force stopped."
}

status() {
    # プロセスとHTTP APIの状態を確認する
    if [ ! -f "$PID_FILE" ]; then
        echo "Gemma 4 is not running."
        return 0
    fi

    local pid="$(cat "$PID_FILE")"
    if ! kill -0 "$pid" 2>/dev/null; then
        echo "Gemma 4 is not running (stale PID file)."
        return 0
    fi

    echo "Gemma 4 is running. PID=$pid"
    echo "Model: $MODEL"
    echo "Web UI: http://127.0.0.1:$PORT/"
    echo "Responses API: http://127.0.0.1:$PORT/v1/responses"

    local code="$(curl -s -o /dev/null -w '%{http_code}' --max-time 3 "http://127.0.0.1:$PORT/health")"
    case "$code" in
        200) echo "API: ready" ;;
        503) echo "API: loading" ;;
        *)   echo "API: not ready (HTTP $code)" ;;
    esac
}

case "${1:-}" in
    start)   start ;;
    stop)    stop ;;
    restart) stop && start ;;
    status)  status ;;
    *)
        echo "Usage: $0 {start|stop|restart|status}"
        exit 1
        ;;
esac
EOF
続いて実行権限を付けます。
chmod +x "$HOME/bin/gemma4.sh"
起動・停止
初回はモデルのダウンロードがあります。
gemma4.sh start
Gemma 4 started. PID=13162
Log: /Users/haomei/.gemma4.log
状態確認するとエンドポイントとモデル名が表示されます。
※--host 0.0.0.0としているので、外部IPでの接続も可能です
gemma4.sh status
Gemma 4 is running.
PID:       13162
Web UI:    http://127.0.0.1:8080/
Responses: http://127.0.0.1:8080/v1/responses
Model:     unsloth/gemma-4-26B-A4B-it-qat-GGUF:UD-Q4_K_XL
停止はあっさり。
gemma4.sh stop
Gemma 4 stopped.
性能
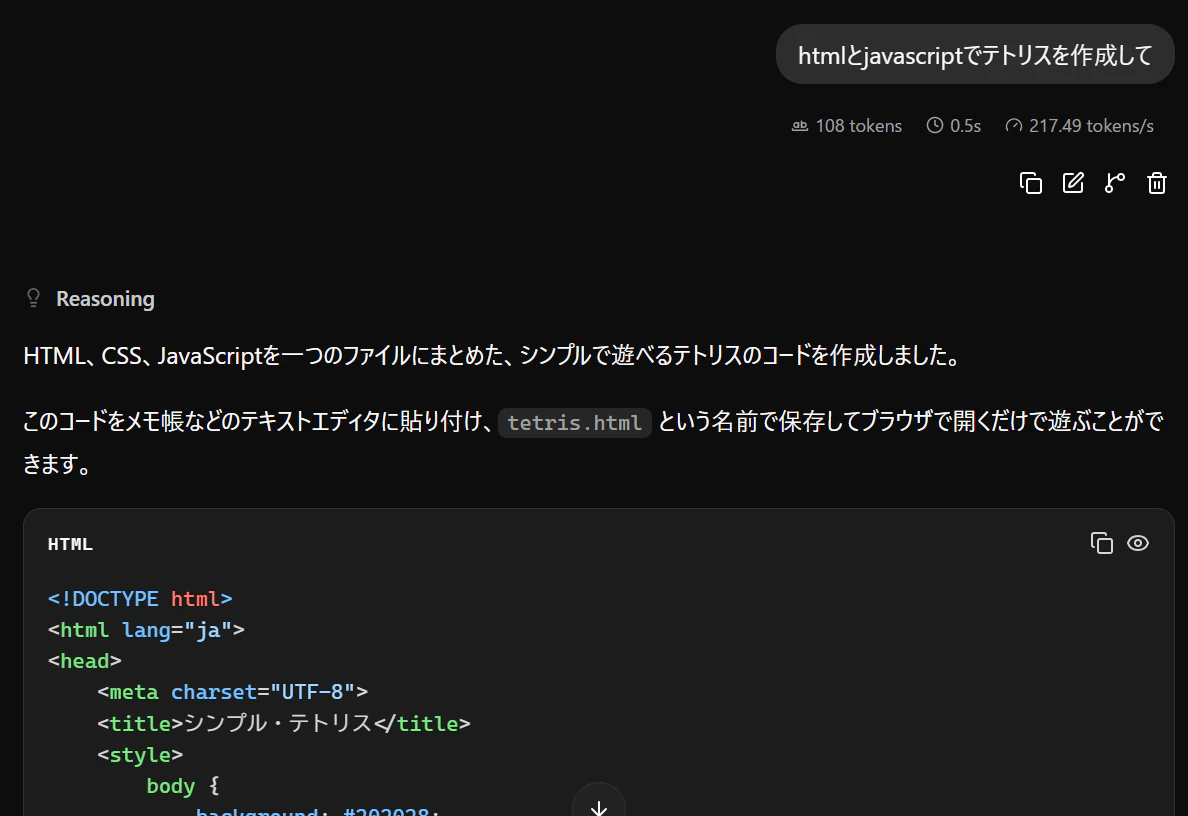
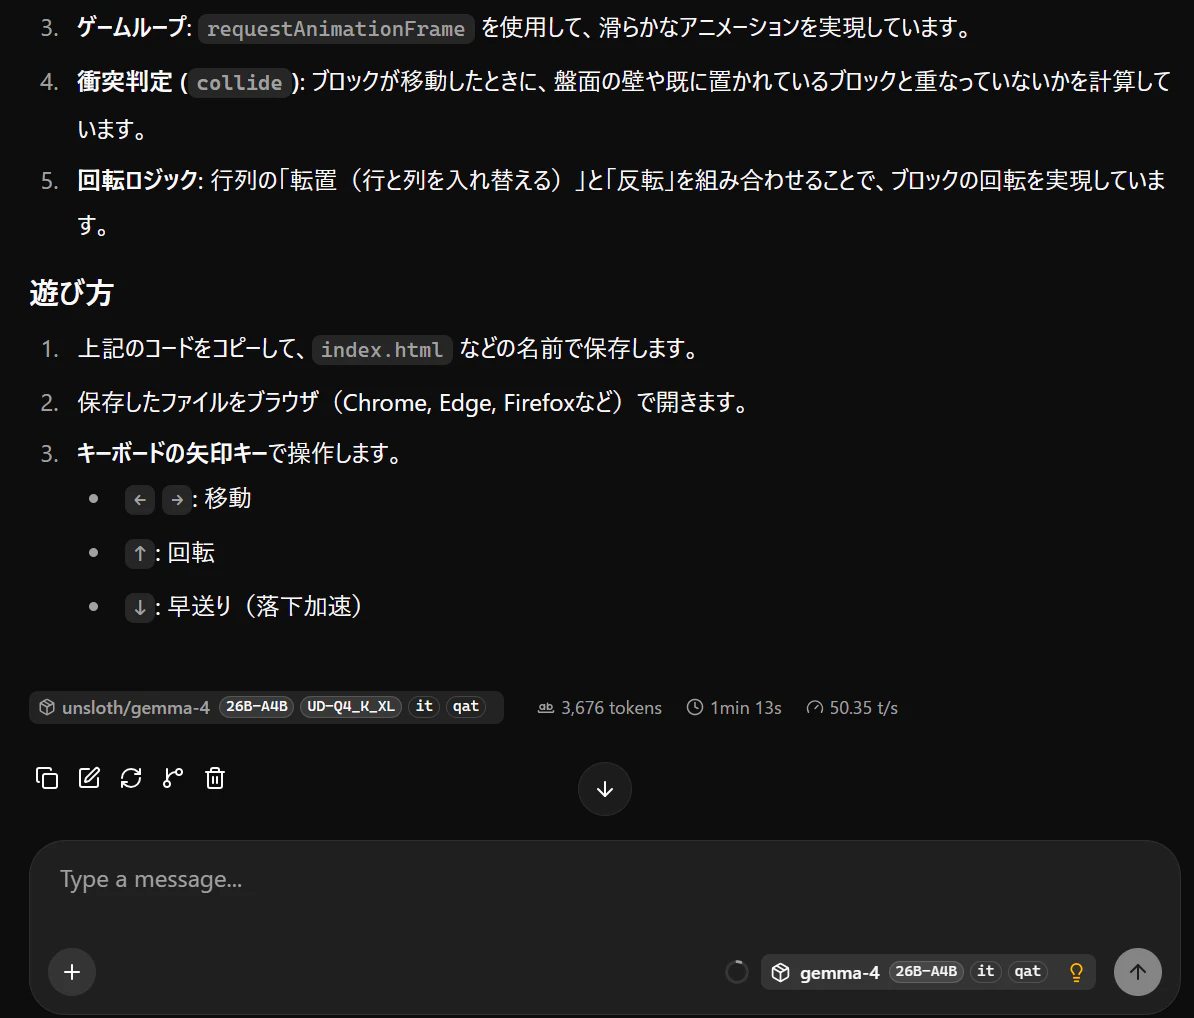
個人的にプログラム生成のベンチマークにしているプロンプトで50tps程度です。
AIエージェントから使う(おまけ)
Podman(コンテナ)環境が前提です。
BRAVEのAPIキー(有償)で検索できるようにしています。
mkdir -p "$HOME/podman/openclaw/runtime/workspace"
cd "$HOME/podman/openclaw"
cat > .env <<EOF
OPENCLAW_GATEWAY_TOKEN=$(openssl rand -hex 32)
BRAVE_API_KEY=<BraveのAPIキー>
EOF
設定ファイルの作成
cat > runtime/openclaw.json <<'JSON'
{
  "models": {
    "mode": "merge",
    "providers": {
      "mac-llama": {
        "baseUrl": "<LLMのベースURL>",
        "api": "openai-completions",
        "models": [
          {
            "id": "<モデル名>",
            "name": "Local LLM",
            "reasoning": false,
            "input": ["text"],
            "contextWindow": 65536,
            "maxTokens": 8192,
            "cost": {"input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0}
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "workspace": "/home/node/.openclaw/workspace",
      "model": {"primary": "mac-llama/<モデル名>"},
      "models": {
        "mac-llama/<モデル名>": {
          "params": {
            "extra_body": {
              "chat_template_kwargs": {"enable_thinking": false}
            }
          }
        }
      }
    }
  },
  "tools": {
    "web": {
      "search": {"enabled": true, "provider": "brave"}
    }
  },
  "gateway": {
    "mode": "local",
    "port": 18789,
    "bind": "lan",
    "auth": {
      "mode": "token",
      "token": "${OPENCLAW_GATEWAY_TOKEN}"
    },
    "controlUi": {
      "allowedOrigins": [
        "http://<MacのIPアドレス>:8081",
        "http://localhost:8081",
        "http://127.0.0.1:8081"
      ]
    }
  }
}
JSON
お試し用に起動スクリプトを作成。
cat > start.sh <<'SH'
#!/bin/sh
set -eu
ROOT=$(CDPATH= cd -- "$(dirname -- "$0")" && pwd)
exec /opt/podman/bin/podman run -d \
  --name openclaw-trial \
  --restart unless-stopped \
  --user 0:0 \
  --memory 2g \
  --cpus 2 \
  --publish 8081:18789 \
  --env HOME=/home/node \
  --env TZ=Asia/Tokyo \
  --env NODE_OPTIONS=--max-old-space-size=640 \
  --env-file "$ROOT/.env" \
  --volume "$ROOT/runtime:/home/node/.openclaw" \
  ghcr.io/openclaw/openclaw@sha256:e79f0168377a1ee77e29c652f133007d270558590bce8358967f456258c8bb16 \
  node openclaw.mjs gateway --bind lan --port 18789
SH
実行権付与して実行。
chmod +x start.sh
./start.sh
WebUIは http://<MacのIPアドレス>:8081/。
接続時に求められるトークンは、次のコマンドで表示する。
sed -n 's/^OPENCLAW_GATEWAY_TOKEN=//p' .env
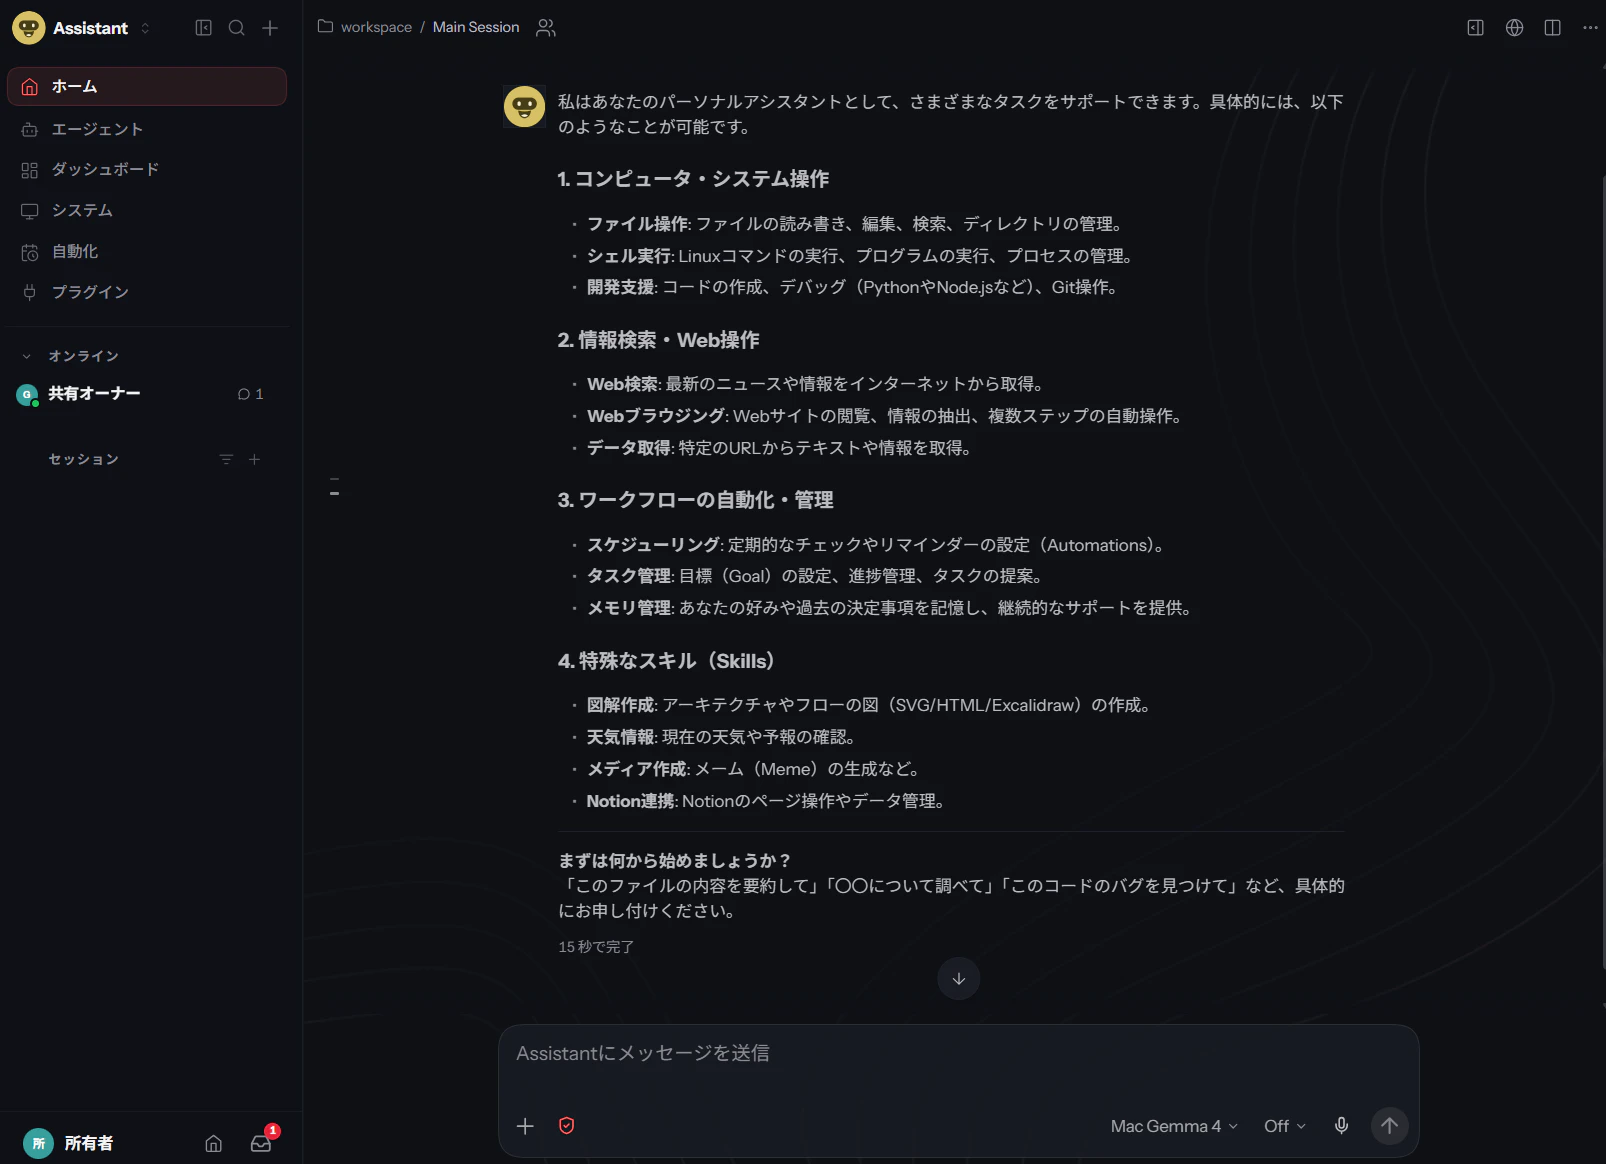
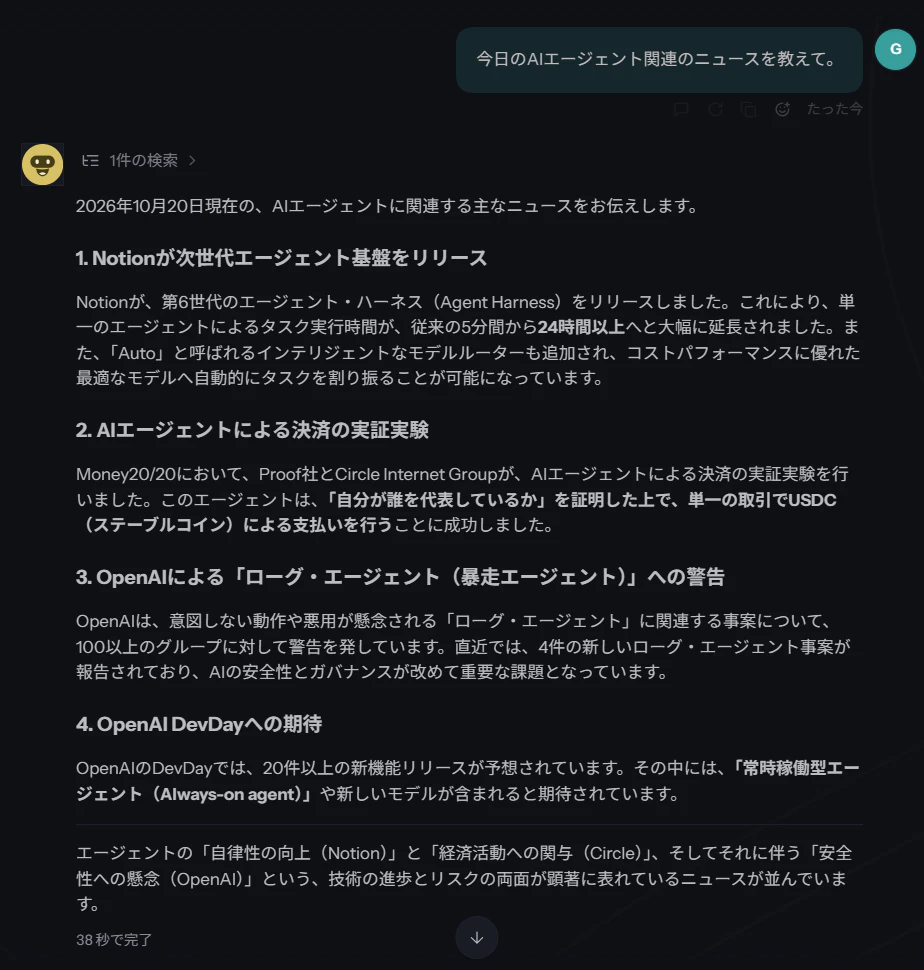
初回「何ができますか?」で15秒。
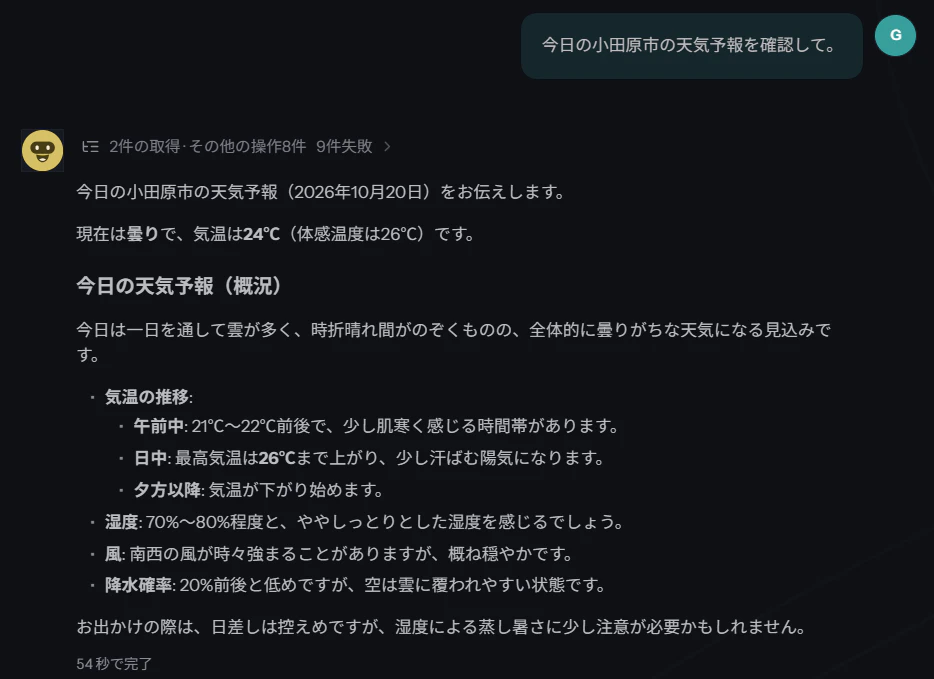
2ターン目、「今日の小田原市の天気予報を確認して。」は9回も失敗を繰り返し54秒。
3ターン目、「今日のAIエージェント関連のニュースを教えて。」は、検索1回で38秒。
停止してコンテナ削除。
podman stop openclaw-trial
podman rm openclaw-trial
次は非公開の自作のAIエージェント。※鹿児島弁で「超エージェント」
Codex Coreを使ってます。
podman ps -a
CONTAINER ID  IMAGE                                COMMAND     CREATED         STATUS                   PORTS                   NAMES
30a1a3b73ce8  localhost/wazzeagent:0.9.11              12 minutes ago  Up 10 minutes (healthy)  0.0.0.0:8081->8080/tcp  wazzeagent-trial
初回「何ができますか?」で10.2秒。
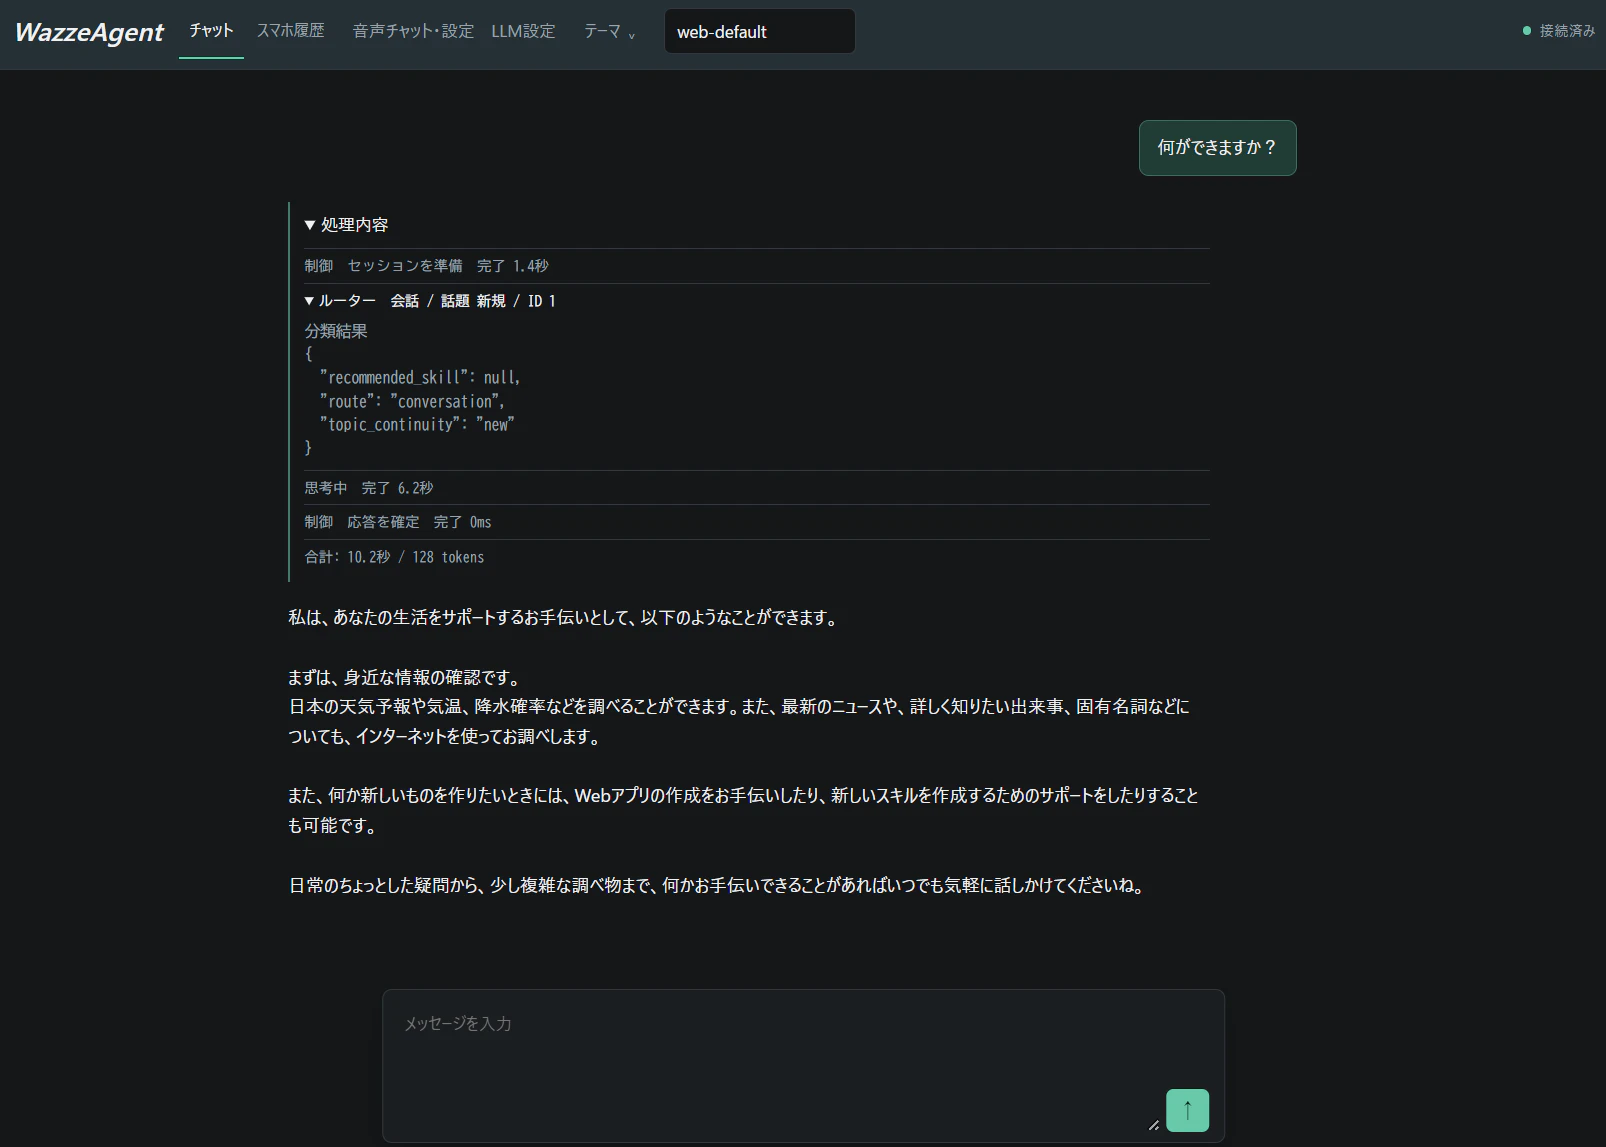
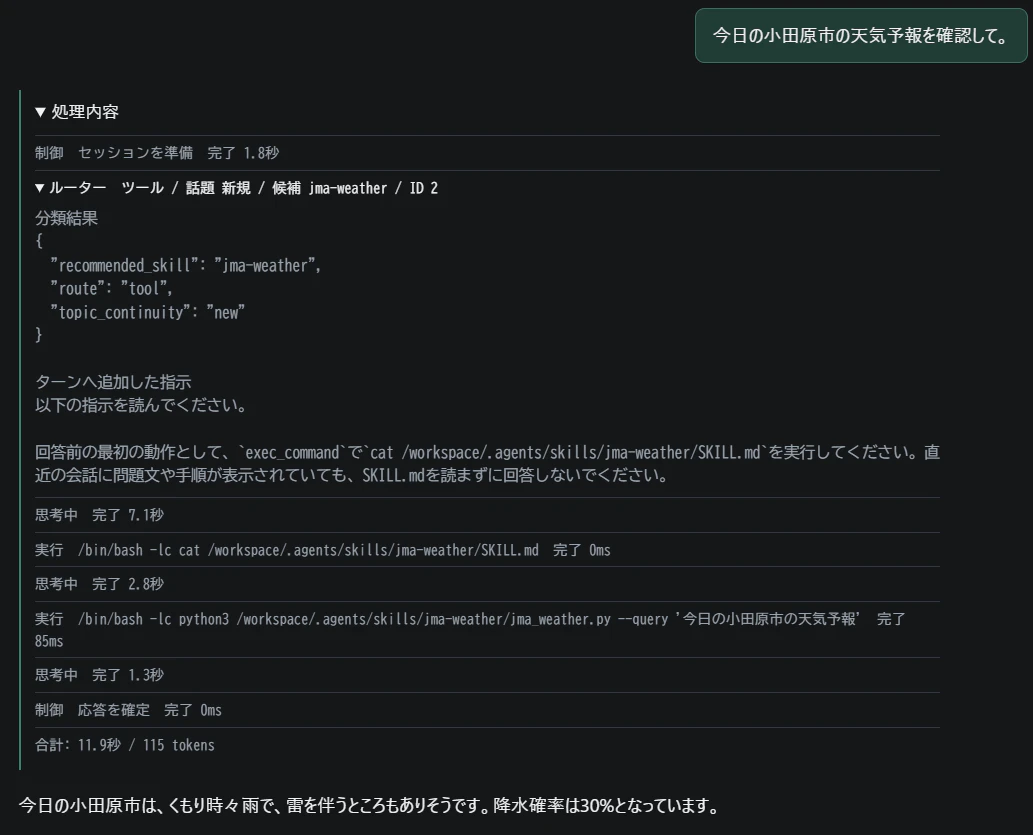
2ターン目、「今日の小田原市の天気予報を確認して。」は天気予報スキル(これも自作)で11.9秒。
3ターン目、「今日のAIエージェント関連のニュースを教えて。」は、検索1回で16.0秒。「今日」では検索しなかった...
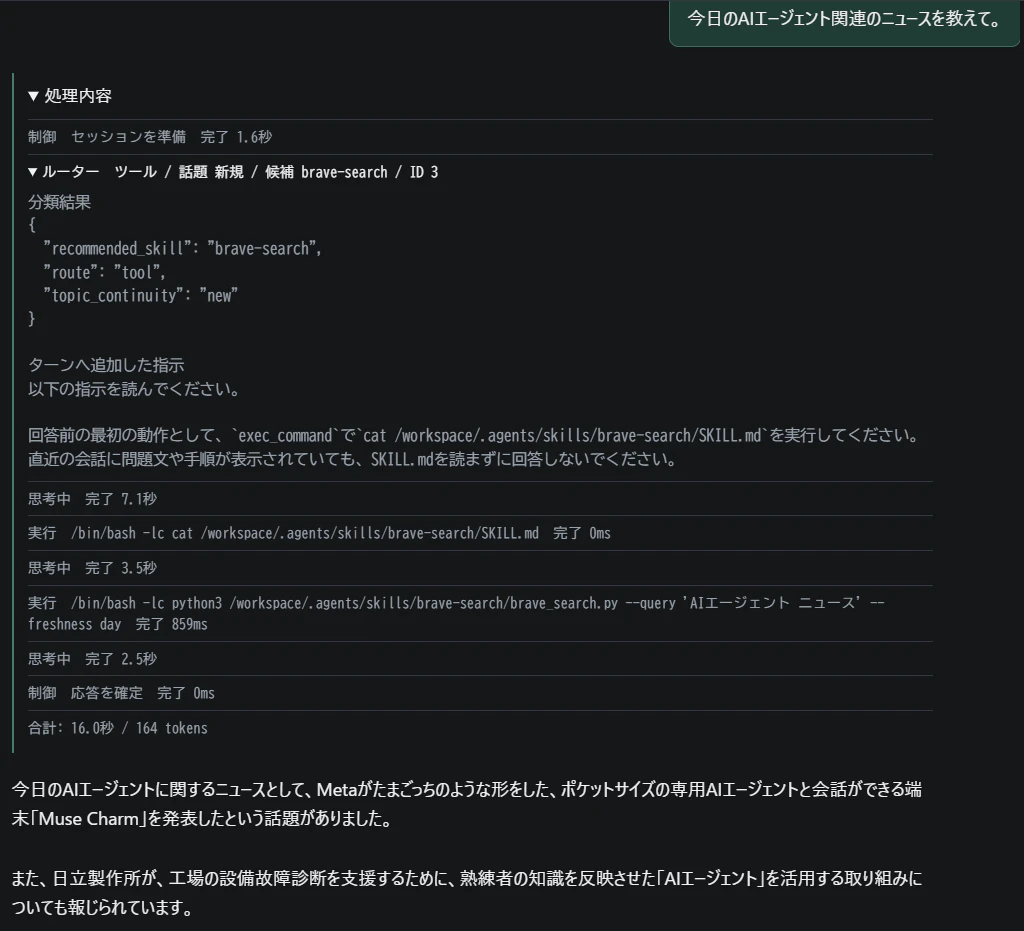
openclawのように毎ターン余計な検索動作はさせていないのでレスポンスは速いです。
キャッシュヒット率を上げるコンテキスト設計もしているので、コンテキストが溜まっても速さが持続します。
また、ローカル小規模モデル用に「会話ルーター」という問い合わせ内容がツール実行含む依頼の場合、ツール呼び出しを強化する実装もしています。
これにより、gemmaなのにqwen並みのツールコール性能があると思います。(計測はしていない)
大体のAIエージェントはフロンティアモデルのAPIや、つよつよローカルモデル向けの設定寄りだと感じます。
ローカル小規模モデルに特化した設定のAIエージェント製品は無いように思えるので、ローカル小規模モデルのみを使うつもりであれば、AIエージェントは自作した方が良いと思います。