
はじめに
JEV-CPUのDocker化、テトリスとのAPI連携について、実際の指示と回答の概要を時系列でまとめます。
前提
- Intel Core i5 12500H Windows 11
- Docker Desktop
- Codex
1. JEV-CPUのDocker化
指示(原文)
https://huggingface.co/Meanblock/JEV-CPU
このPCのdockerを使って、JEV-CPUのコンテナを作って欲しい。CPUとGPU(cuda)を切り替えられるようにして。モデルも変えられるようにして。
回答・実装の概要
Docker ComposeにCPU用・CUDA用サービスを用意し、モデル・デバイス・dtype・ポートを環境変数で変更できる構成にした。モデルキャッシュは永続volumeを利用する。
2. WebUIの日本語化とAPIデータ表示
指示(原文)
http://localhost:8080/
のWebUIは日本語化してください
回答・実装の概要
JEVのWebUIを日本語化した。
指示(原文)
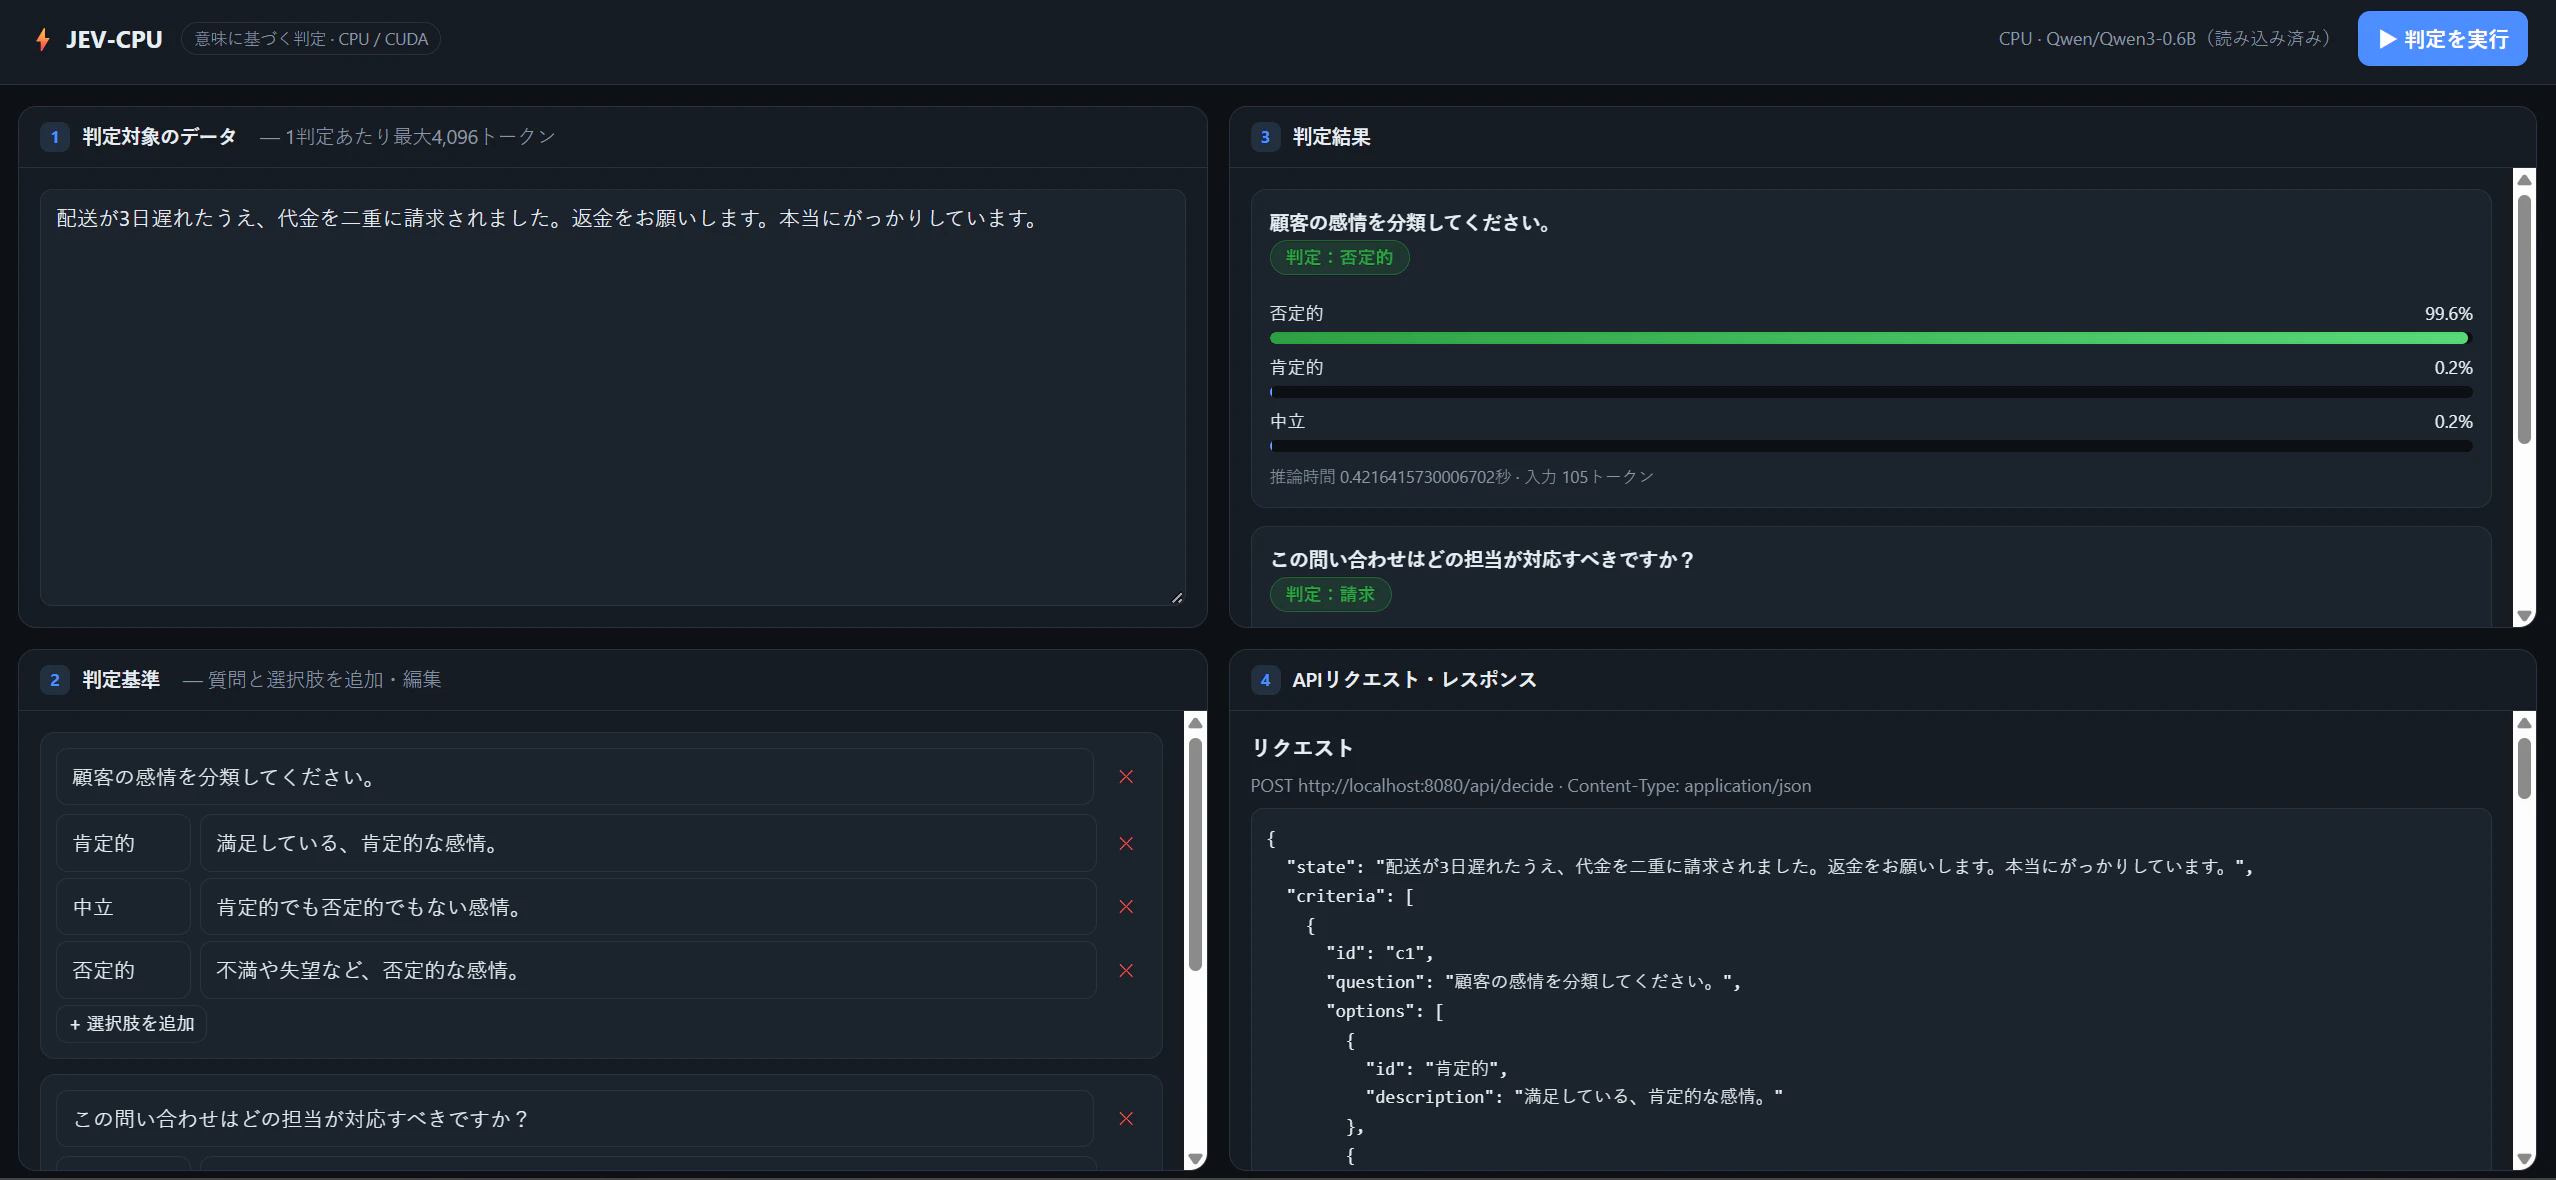
3判定結果の下に4で実際のAPIリクエスト・レスポンスデータを追加して。
回答・実装の概要
判定結果の下に、実際のAPIリクエストとレスポンスを確認できる表示を追加した。
その後、モデルにLFM2.5-JPを追加、GPU/CPUを切り替えてロードできるようにした。
日本語の判断補助(タグ付け)をさせるならモデルは選んだ方がいい。
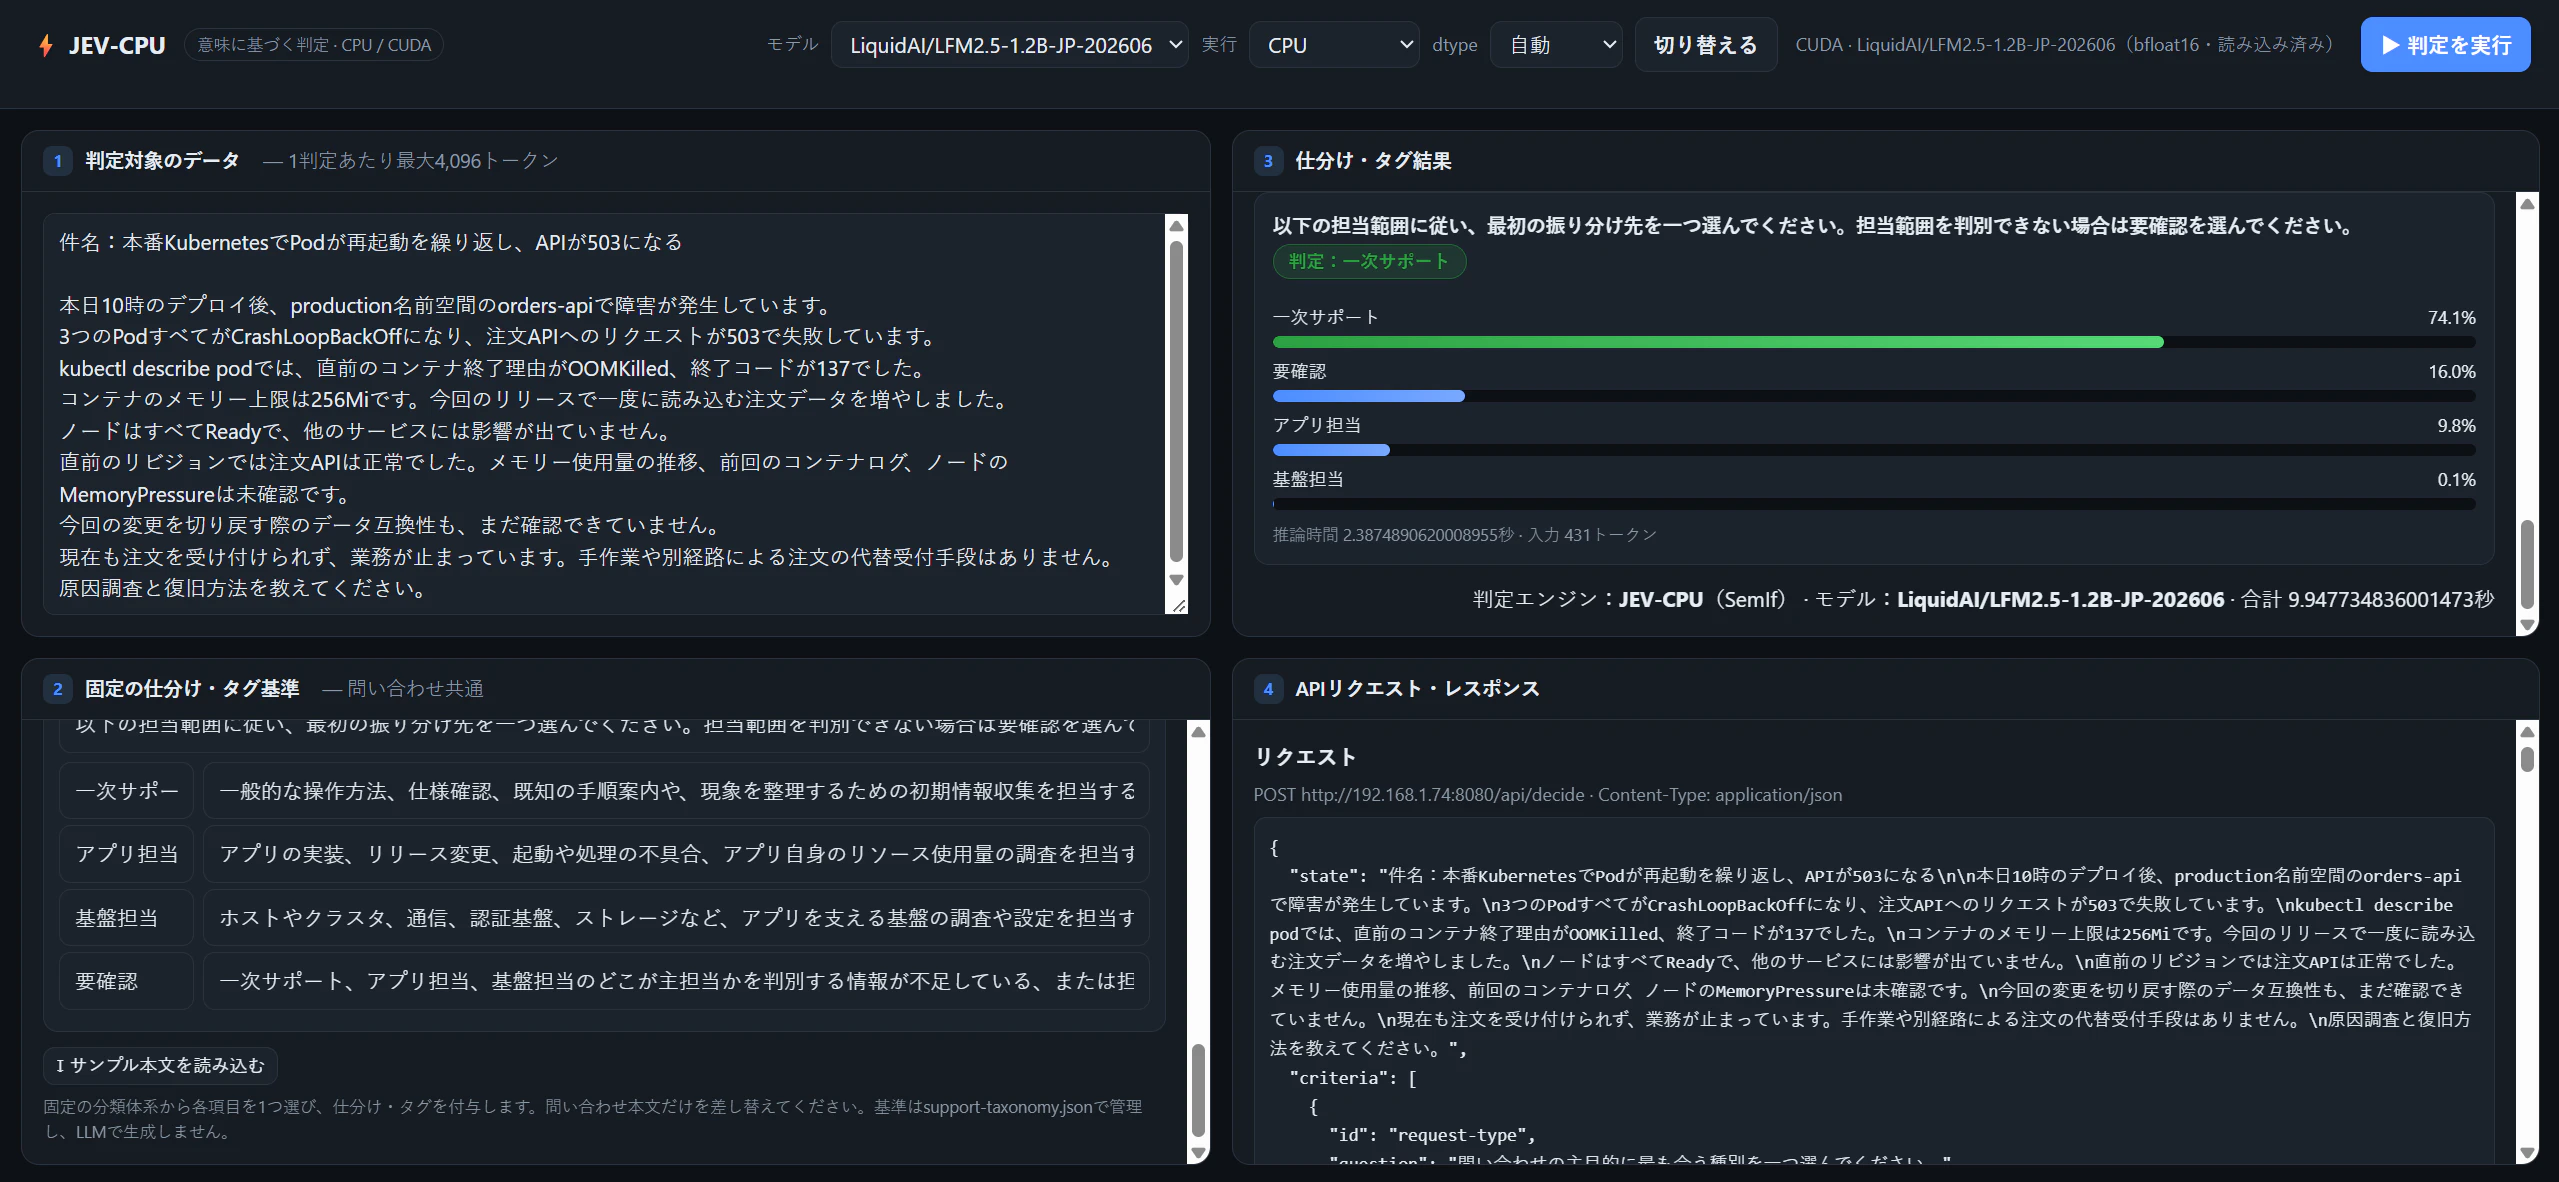
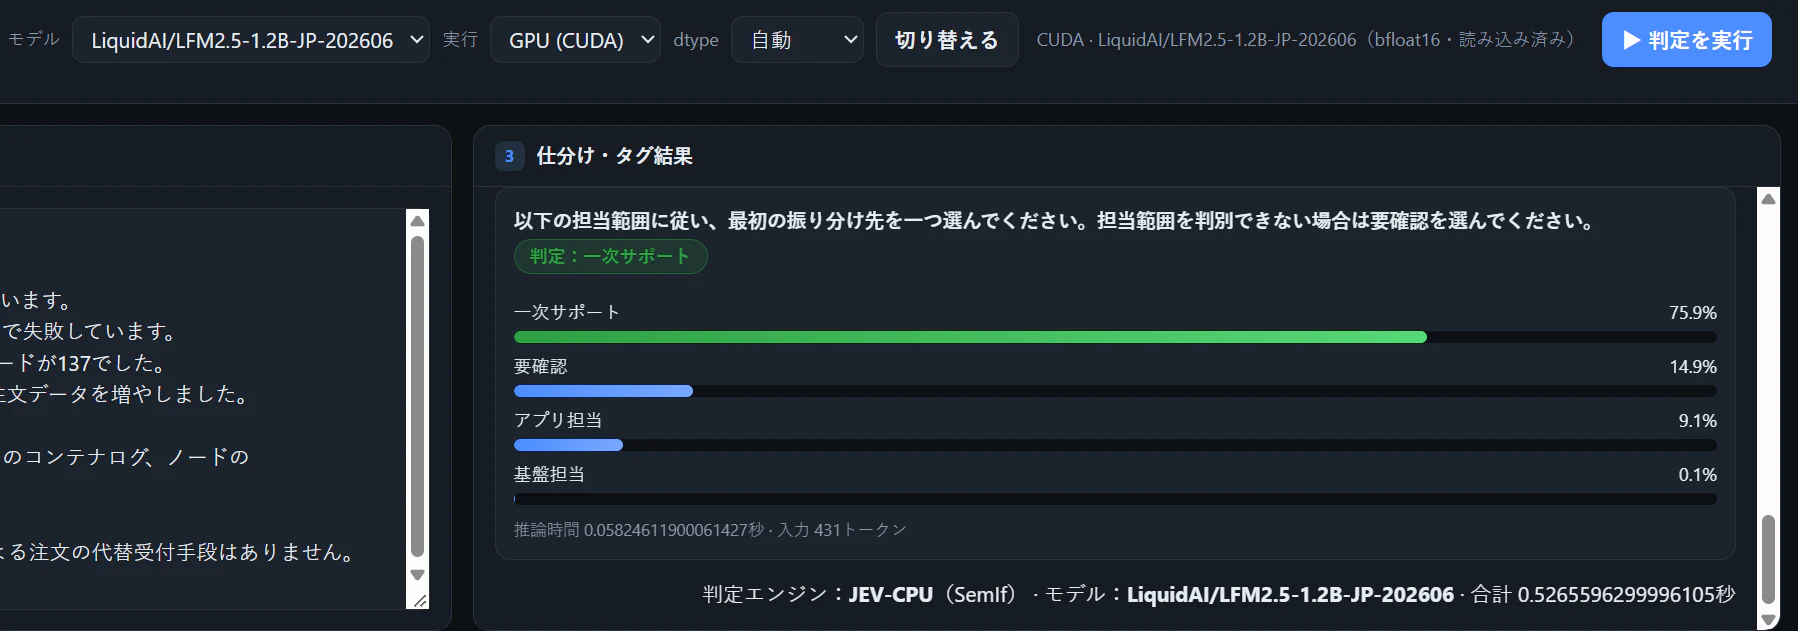
CPUでは10秒程度。GPU利用で0.5秒。
3. テトリス側のAPI仕様に合わせる
長い指示は折りたたんで掲載します。
指示(原文・全文)
既にデプロイ済みの JEV-CPU を、現在のテトリスAIクライアントからそのまま利用できるように改変してください。
既存コードを確認し、現在の構造をできるだけ維持してください。全面書き換えは不要です。
目的
テトリス側は、合法配置候補の中から1件をJEVに選ばせます。
JEV側は、
- テトリスを操作しない
- 回転や左右移動を計算しない
- 盤面の合法性を判定しない
- placement_idを生成しない
ものとします。
JEV側の責務は、
与えられた最大16候補の中から、最も良い候補IDを1つ返す
だけです。
1. HTTP API
以下を維持・実装してください。
Health
GET /api/health
成功例:
{
  "ok": true,
  "model": "Qwen/Qwen3-0.6B",
  "loaded": true
}
Decide
POST /api/decide
Content-Type: application/json
リクエスト形式は以下で固定します。
{
  "state": "T I",
  "criteria": [
    {
      "id": "tetris-placement",
      "question": "Choose best Tetris placement. Prefer lines; avoid holes, height, bumps.",
      "options": [
        {
          "id": "A",
          "description": "1 4 17 1 24 6 0 8 3"
        },
        {
          "id": "B",
          "description": "0 7 16 0 29 8 2 13 4"
        }
      ]
    }
  ]
}
以下の別形式へ変更しないでください。
promptlabeltext
使用するフィールドは、
state
criteria[]
criteria[].id
criteria[].question
criteria[].options[]
options[].id
options[].description
です。
2. レスポンス形式
正常時は以下の構造を維持してください。
{
  "results": [
    {
      "id": "tetris-placement",
      "question": "Choose best Tetris placement. Prefer lines; avoid holes, height, bumps.",
      "winner": "A",
      "ranked": [
        {
          "id": "A",
          "prob": 0.91
        },
        {
          "id": "B",
          "prob": 0.09
        }
      ],
      "forward_seconds": 0.123,
      "input_tokens": 123,
      "error": null
    }
  ],
  "total_seconds": 0.130,
  "model": "モデル名"
}
テトリス側は、
results[0].winner
を使用します。
winner には、入力された options[].id のいずれかを返してください。
テトリス側では現在、
A ~ P
を一時IDとして使用しています。
存在しないIDを返してはいけません。
3. 候補数
1 criteriaあたり最大16候補を想定してください。
16件を超える候補の分割とトーナメント処理はテトリス側で行います。
JEV側で、
- 候補を削る
- 上位候補だけ選別する
- 独自トーナメントを実施する
必要はありません。
1リクエスト内のoptionsだけを比較してください。
4. テトリス用description仕様
テトリス側のoption descriptionは以下の順序です。
rotation x y clearedLines aggregateHeight maxHeight holes bumpiness maxWellDepth
例:
1 4 17 1 24 6 0 8 3
意味:
rotation        = 1
x               = 4
y               = 17
clearedLines    = 1
aggregateHeight = 24
maxHeight       = 6
holes           = 0
bumpiness       = 8
maxWellDepth    = 3
JEV側ではこの文字列を変更・展開・再JSON化しないでください。
そのままモデル入力へ利用してください。
5. state仕様
テトリス側は、共通状態を短いstateとして渡します。
例:
T I
意味:
current piece = T
next piece    = I
stateは将来追加情報が増える可能性があります。
固定長前提の厳密なパーサーを実装せず、文字列としてモデルへ渡してください。
6. モデル入力形式
モデルへ渡すpromptは可能な限り短くしてください。
同じ情報を何度も繰り返してはいけません。
特に、
state
question
options
を1回ずつだけモデル入力へ含めてください。
候補ごとにquestionやstateを繰り返さないでください。
テトリス用途では入力トークン数が性能へ直結するため、冗長なテンプレートを追加しないでください。
7. 生成を使用しない
通常のテキスト生成、
model.generate(...)
は使用しないでください。
JEVの設計どおり、
forward
↓
候補IDトークンのlogits取得
↓
候補ごとのscore
↓
softmax
↓
winner
で判断してください。
文章やJSONをモデルに生成させてから解析する方式へ変更してはいけません。
8. 候補IDのlogits
入力されたoptionsのIDだけを評価対象にしてください。
例えば、
A
B
C
D
の4候補なら、この4候補だけを比較します。
A〜Pすべてを常に比較してはいけません。
入力に存在しないIDがwinnerになることを防いでください。
9. tokenizer確認
モデル変更時には、候補ID、
A
B
C
...
P
がどのようにtokenizeされるか必ず確認してください。
候補IDが単一tokenでないモデルの場合は、単純な1token logits比較をしてはいけません。
現在の実装方式が対象モデルで成立することを確認してください。
成立しないモデルの場合は、そのモデルで候補IDのスコアを正しく比較できる実装へ変更してください。
ただしHTTP API仕様は変えないでください。
10. モデルを固定しない
Qwen/Qwen3-0.6B をソースコードへ固定しないでください。
環境変数で変更可能にしてください。
例:
JEV_MODEL=Qwen/Qwen3-0.6B
または、
JEV_MODEL=openbmb/MiniCPM5-2B
などへ切り替えられる構造にしてください。
デフォルト値として現在のモデルを指定するのは構いません。
11. deviceも設定可能にする
CPU固定にしないでください。
環境変数で、
JEV_DEVICE=cpu
または、
JEV_DEVICE=cuda
を指定できるようにしてください。
CUDA利用可能時は、
cuda
を使用できるようにします。
自動判定を実装する場合でも、環境変数による明示指定を優先してください。
12. dtype
CPUでは現在の互換性を壊さない設定を使用してください。
CUDAでは対応GPUであれば、
bfloat16
を優先してください。
環境変数で変更可能にしても構いません。
例:
JEV_DTYPE=float32
JEV_DTYPE=bfloat16
モデルとデバイスの組み合わせで未対応dtypeを使用してクラッシュしないようにしてください。
13. Docker
既にコンテナ化されている場合は現在の構成を利用してください。
以下を環境変数で渡せるようにしてください。
JEV_MODEL
JEV_DEVICE
JEV_DTYPE
JEV_PORT
ポートのデフォルトは、
8080
です。
コンテナ内部のHTTP待受は、
0.0.0.0
にしてください。
14. Hugging Faceキャッシュ
モデルをコンテナ再起動のたびに再ダウンロードしないようにしてください。
Hugging Faceのキャッシュディレクトリをvolume化してください。
例えば、
/root/.cache/huggingface
を永続volumeへ割り当てます。
15. CUDAコンテナ
NVIDIA GPU環境の場合は、
docker run --gpus all
またはDocker ComposeのGPU設定でCUDAを利用できる構成にしてください。
コンテナ内部で、
torch.cuda.is_available()
がtrueになることを確認してください。
CUDA指定なのに利用できない場合は、黙ってCPUへ落とさず、起動時に明確なエラーを出してください。
16. CORS
テトリスは別マシン・別オリジンのブラウザからアクセスします。
以下を返してください。
Access-Control-Allow-Origin: *
Access-Control-Allow-Methods: GET, POST, OPTIONS
Access-Control-Allow-Headers: Content-Type
OPTIONS preflightへ、
204 No Content
で応答してください。
17. timeout
JEVサーバー内部で不必要なsleepやretryを入れないでください。
1リクエストは、
HTTP受信
↓
tokenize
↓
forward
↓
score計算
↓
HTTP応答
だけで完了するようにしてください。
内部で自動retryは不要です。
18. 並行処理
同じモデルインスタンスを無制限に並行forwardしないでください。
現在の用途ではテトリス側が直列で問い合わせるため、まず1リクエストずつ安全に処理できれば十分です。
必要ならサーバー側にもlockを入れてください。
ただし、ロック待ち時間を計測できるようにしてください。
19. 計測値
レスポンスには引き続き、
input_tokens
forward_seconds
total_seconds
を返してください。
意味は以下で統一します。
input_tokens
= tokenizerがモデルへ実際に渡した入力token数

forward_seconds
= model forwardだけの実時間

total_seconds
= HTTP受信後のJEV判断開始から結果生成までの実時間
20. サーバーログ
各リクエストについて最低限、
model
device
dtype
options
input_tokens
tokenize_seconds
forward_seconds
total_seconds
winner
を1行程度で確認できるようにしてください。
prompt全文や巨大な入力内容を毎回ログへ出さないでください。
21. 起動時ログ
起動時に以下を表示してください。
例:
JEV server
model=Qwen/Qwen3-0.6B
device=cuda
dtype=bfloat16
port=8080
CUDA利用時は、
GPU名
CUDA version
VRAM
も確認可能なら表示してください。
22. API互換テスト
以下のリクエストを実際に送信してください。
{
  "state": "T I",
  "criteria": [
    {
      "id": "tetris-placement",
      "question": "Choose best Tetris placement. Prefer lines; avoid holes, height, bumps.",
      "options": [
        {
          "id": "A",
          "description": "1 4 17 1 24 6 0 8 3"
        },
        {
          "id": "B",
          "description": "0 7 16 0 29 8 2 13 4"
        }
      ]
    }
  ]
}
以下を確認してください。
- HTTP 200
-
results[0].winnerがAまたはB -
rankedにAとBだけが存在 results[0].error == nullinput_tokens > 0forward_seconds > 0total_seconds >= forward_seconds
23. 16候補テスト
A〜Pの16候補を送信し、
- HTTP 200
- winnerがA〜Pのどれか
- rankedが16候補
- 入力に存在しないIDを返さない
ことを確認してください。
24. 異常系
以下を正しくエラーとして扱ってください。
- criteriaなし
- optionsなし
- optionsが0件
- optionsが17件以上
- option id重複
- option id欠落
- description欠落
- モデルロード失敗
- CUDA指定なのにCUDA利用不可
サーバープロセス全体を落とさず、可能な範囲でHTTPエラーまたは results[].error として返してください。
25. 性能テスト
CPU版とCUDA版の両方が利用可能なら比較してください。
同じ16候補入力を最低5回実行し、
初回ウォームアップを除外して、
input_tokens
forward_seconds
total_seconds
の平均値を取得してください。
比較表を報告してください。
26. モデル変更テスト
少なくとも現在設定されているモデルについて、
- モデルロード
- tokenizer
- 候補ID scoring
/api/decide- winner取得
まで確認してください。
別モデルへ切り替え可能な構造を実装してください。
モデル固有処理をHTTPハンドラへ直接書き散らさず、
model loader
decision engine
HTTP API
を可能な範囲で分離してください。
27. テトリス側は変更しない
今回の変更対象はJEVサーバー側です。
テトリス側の、
jev.js
tetris.js
index.html
は変更しないでください。
現在のテトリス側API仕様へJEVサーバー側を合わせてください。
完了条件
以下をすべて満たしてください。
-
/api/health正常 -
/api/decideが現在のテトリス仕様と完全互換 - CORS対応
- 最大16候補対応
- winnerは入力候補IDのみ
- モデル変更可能
- CPU/CUDA切替可能
- dtype設定可能
- Dockerで再現可能
- HFキャッシュ永続化
- input_tokens / forward_seconds / total_seconds取得可能
- 2候補テスト合格
- 16候補テスト合格
- 異常系テスト合格
- テトリス側変更なし
- デプロイ後の実APIで疎通確認済み
実装、コンテナ再ビルド、再デプロイ、APIテストまで完了してください。
途中で設計確認は不要です。既存コードから判断可能な内容は自分で判断して進めてください。
完了報告には以下だけを記載してください。
変更ファイル
使用モデル
device
dtype
Dockerイメージ
/api/health結果
/api/decide結果
2候補テスト結果
16候補テスト結果
CPU/CUDA性能
公開先IP:port
回答・実装の概要
/api/health と /api/decide を維持し、指定されたフィールドと候補IDによる判断に対応した。文章やJSONの生成ではなく、forwardで得た候補IDのスコアを比較する。モデル設定・判断処理・HTTP APIを分離し、CORS、入力検証、計測値、モデルの並行実行制御を整えた。
この段階の指示はJEVサーバー側だけを対象としていた。後のゲーム側修正は、別途の指示を受けて実施した。
おわりに
- JEVはQwen3-0.6B、CPU、float32で稼働。
- テトリスは最大4候補から最終配置を選択し、操作はゲーム側が実行。
本記事のテスト結果は、実施した条件での動作確認を示すもので、あらゆる盤面での勝利や回収成功を保証するものではありません。