
横向き(16:9、1920×1080、24 fps、9.17秒)のワンテイク動画を、後工程の動画編集に向けて縦向き(9:16、1080×1920、30 fps、冒頭9.0秒)に変換する必要がありました。被写体の人物が画面の左右に移動するため、各コマから取り出す607.5×1080の領域である切り抜き窓を人物に追従させて動かします。
また、完成動画に使う楽曲は同じテイクの別アップロード(人物のみ差し替えられ、部屋や照明、カメラの動きは同一)にしか含まれていませんでした。そのため、2本の動画の時間のずれを特定し、その音声を映像に合わせて配置します。
本稿では、実動画と同じ処理を行うスクリプトを用いて全体の処理を5段階で進めます。
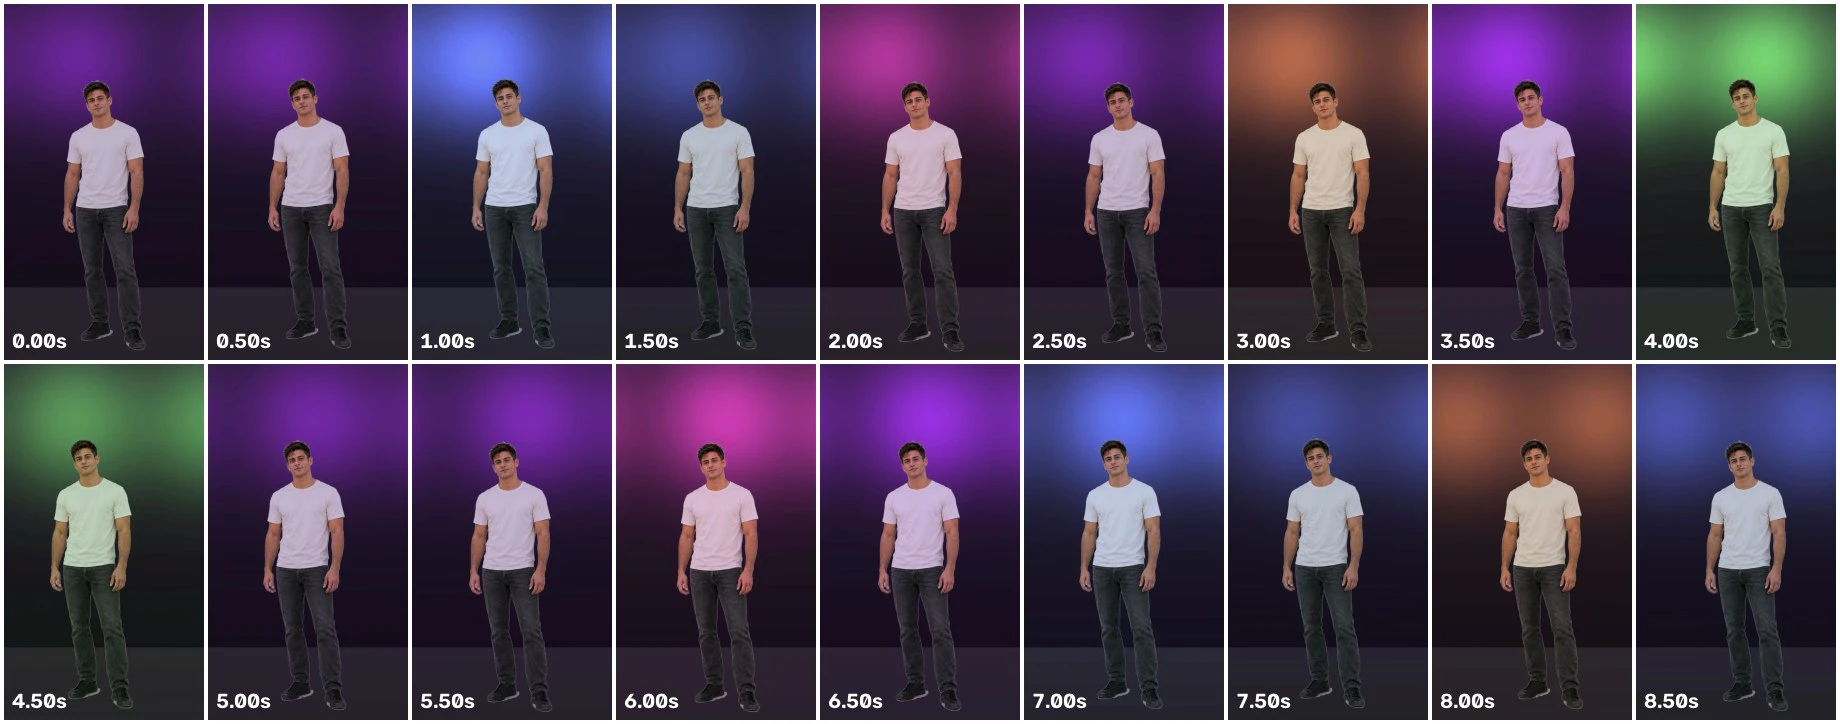
図1 練習用クリップの切り抜き結果(0.5秒おきの一覧画像)
| 時点 | 1080p元動画 | 480p・16:9全体(854×480) | 480p・9:16切り抜き(480×854) |
|---|---|---|---|
| 0.0秒(カメラから遠い位置) | 100 | 44 | 79 |
| 4.75秒(カメラに最接近した位置) | 299 | 133 | 236 |
表A 実動画における人物の顔幅(OpenCV Haar検出器による測定値、単位:px)
同一の480p表示時において、9:16の切り抜き動画では被写体の人物の顔が16:9全体表示と比べて1.78倍の大きさになります。
図1〜3および表B・表Dは、スクリプトで生成して人物の正確な位置やずれの正解が分かっている練習用クリップでの測定結果です。表A、表C、図4には実動画での測定値やグラフも記載していますが、実動画のコマ画像自体は掲載していません。
実行環境を整える
- OS: macOS 26.6 (Apple M2)
- Python: 3.14.7
- OpenCV: opencv-python-headless 5.0.0(第1段階の顔検出確認のみ 4.14.0 を使用)
- NumPy: 2.5.4
- ffmpeg: 8.1.2
uv を利用することで、仮想環境を個別に作成することなくスクリプトを直接実行できます。以下で実行します。
uv run --with opencv-python-headless --with numpy python -c "import sys, cv2, numpy; print(sys.version.split()[0], cv2.__version__, numpy.__version__)"
3.14.7 5.0.0 2.5.4
0.25秒ごとに人物の位置を目視で読み取る
実動画に対して OpenCV の Haar 顔検出器(haarcascade_frontalface_default、OpenCV 4.14.0)を0.25秒間隔で実行したところ、0.0秒および0.75〜5.5秒では検出できましたが、0.25秒、0.5秒、および人物が向きを変えて立ち去る5.75秒以降は検出されませんでした。顔検出のみで軌道を作成すると、人物が反転して離れる区間に追従の欠落が生じます。
なお、opencv-python-headless 5.0.0 には cv2.CascadeClassifier がなく AttributeError になりますが、opencv-contrib-python-headless 5.0.0 には含まれています。コマを格子状に並べた一覧画像を作成するスクリプトを以下に示します。
# 一定間隔のコマを並べた一覧画像(コンタクトシート)を作る
# 使い方: python sheet.py 動画 出力.jpg 間隔秒 列数 タイル幅 [開始秒 終了秒] [--ruler]
#   --ruler: 元の解像度で 160px ごとに縦線と x 座標を描く(被写体の中心 x を目で読むため)
import sys, math, cv2, numpy as np

ruler = '--ruler' in sys.argv
a = [s for s in sys.argv[1:] if s != '--ruler']
src, dst, step, cols, tw = a[0], a[1], float(a[2]), int(a[3]), int(a[4])
cap = cv2.VideoCapture(src)
fps, n = cap.get(cv2.CAP_PROP_FPS), int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
start, end = (float(a[5]), float(a[6])) if len(a) > 6 else (0.0, n / fps)
want = {}
for k in range(int(round((end - start) / step)) + 1):
    t = start + k * step
    if round(t * fps) < n:
        want[int(round(t * fps))] = t
tiles = []
for i in range(max(want) + 1):
    ok, f = cap.read()
    if not ok:
        break
    if i not in want:
        continue
    if ruler:
        for x in range(0, f.shape[1], 160):
            cv2.line(f, (x, 0), (x, f.shape[0]), (0, 255, 255), 2)
            cv2.putText(f, str(x), (x + 6, 60), cv2.FONT_HERSHEY_SIMPLEX, 1.6, (0, 255, 255), 4)
    th = round(f.shape[0] * tw / f.shape[1])
    im = cv2.resize(f, (tw, th), interpolation=cv2.INTER_AREA)
    cv2.putText(im, f"{want[i]:.2f}s", (8, th - 12), cv2.FONT_HERSHEY_SIMPLEX, 0.7, (255, 255, 255), 2)
    tiles.append(im)
th, rows, pad = tiles[0].shape[0], math.ceil(len(tiles) / cols), 4
sheet = np.full((rows * (th + pad) + pad, cols * (tw + pad) + pad, 3), 255, np.uint8)
for k, im in enumerate(tiles):
    r, c = divmod(k, cols)
    sheet[pad + r * (th + pad):pad + r * (th + pad) + th, pad + c * (tw + pad):pad + c * (tw + pad) + tw] = im
cv2.imwrite(dst, sheet, [cv2.IMWRITE_JPEG_QUALITY, 88])
print(dst, len(tiles), "tiles", f"{fps:g}fps", n, "frames")
sheet.py --ruler は、元解像度で160 pxごとに縦線とx座標を描いた目盛り付きの一覧画像を出力し、ここでは幅960 pxのタイル2列で6コマ(1.5秒分)ずつ並べます。
# 0〜1.25秒の6コマ(0.25秒おき)を、幅960pxのタイル2列で並べる
# 1.5・3・4.5・6・7.5秒から始まる5枚と、9秒の1コマも同じように作る
uv run --with opencv-python-headless --with numpy python sheet.py A.mp4 ruler-0.jpg 0.25 2 960 0 1.25 --ruler
ruler-0.jpg 6 tiles 24fps 240 frames
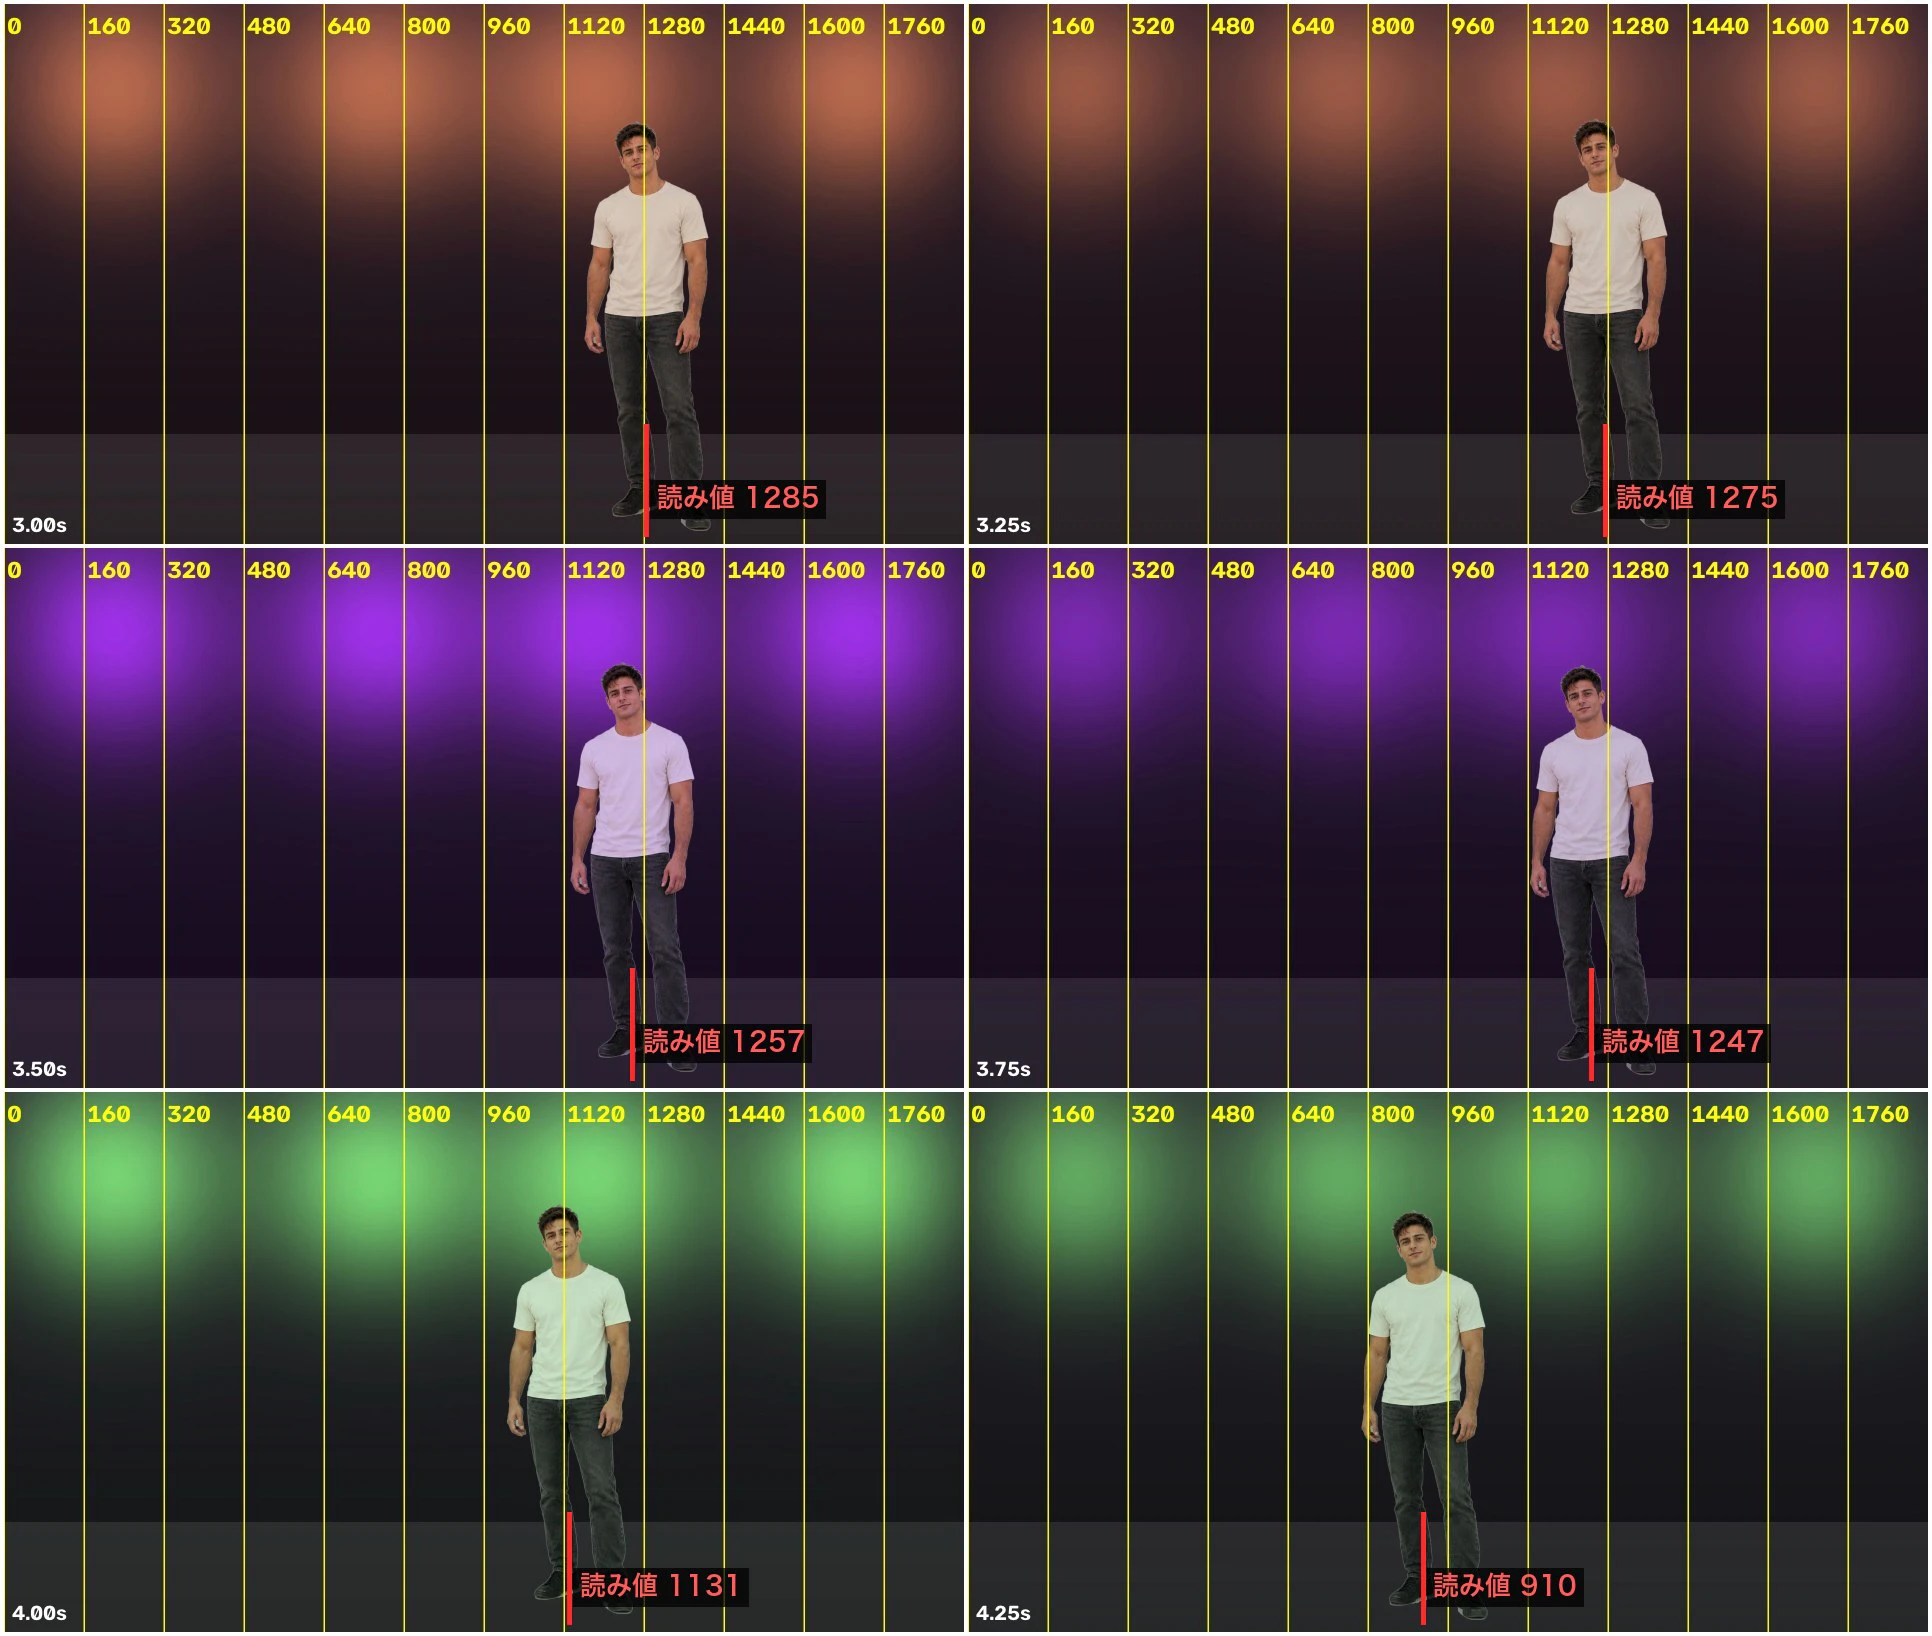
図2 目盛り付き一覧画像(3.00〜4.25秒、4.0秒から急な移動が開始)
読み取りの基準は、腕を含む身体の最左端と最右端の中間位置(元フレームのpx単位)です。以下のように、ある時点での人物の位置の読み取り値であるキーフレームを記録します。
[[0.00, 1254], [0.25, 1256], [0.50, 1268], [0.75, 1272], [1.00, 1269], [1.25, 1263],
 [1.50, 1260], [1.75, 1265], [2.00, 1281], [2.25, 1287], [2.50, 1289], [2.75, 1285],
 [3.00, 1285], [3.25, 1275], [3.50, 1257], [3.75, 1247], [4.00, 1131], [4.25, 910],
 [4.50, 792], [4.75, 767], [5.00, 709], [5.25, 677], [5.50, 689], [5.75, 709],
 [6.00, 718], [6.25, 717], [6.50, 711], [6.75, 709], [7.00, 739], [7.25, 793],
 [7.50, 820], [7.75, 881], [8.00, 994], [8.25, 1057], [8.50, 978], [8.75, 835],
 [9.00, 756]]
練習用クリップの37点の読み取り値は正解との平均誤差が2.1 px、最大誤差が5.1 pxでした。実動画(9.17秒)では0.00秒から9.17秒まで計38点を同様に読み取りました。
読み取り値をなめらかな切り抜き軌道に変換する
直線でつなぐ線形補間のみでは0.25秒ごとに移動速度が急変し、カメラが小刻みに揺れます。以下のスクリプトで軌道の平滑化と切り抜きを行います。
# 16:9 の動画から、被写体を追いかける 9:16 の縦動画を切り出す
# 使い方: python crop916.py 入力.mp4 keys.json 出力.mp4 秒数 [σ秒]
#   keys.json: [[秒, 被写体の中心x], ...](元の解像度の px、0.25秒ごとに目で読んだ値)
#   出力と同じ場所に <出力名>.path.json(コマごとの切り抜き窓の中心 x)も書き出す
import sys, json, subprocess, numpy as np, cv2

src, keys, dst, seconds = sys.argv[1], sys.argv[2], sys.argv[3], float(sys.argv[4])
sigma = float(sys.argv[5]) if len(sys.argv) > 5 else 0.25
FPS, W, H = 24, 1920, 1080  # 入力(ffprobe で確かめた値)
OW, OH = 1080, 1920         # 出力
s = OH / H                  # 拡大率 1.7778
cw = OW / s                 # 入力から切り出す窓の幅 607.5px

# 1) キーフレームを 1 コマごとに直線でつなぐ
n = int(round(seconds * FPS))
t = np.arange(n) / FPS
kt, kx = zip(*json.load(open(keys)))
x = np.interp(t, kt, kx)
# 2) ガウス窓(σ 秒)でならす。両端は端の値をのばしてから畳み込む
sig = sigma * FPS
k = np.arange(-3 * int(sig), 3 * int(sig) + 1)
g = np.exp(-0.5 * (k / sig) ** 2); g /= g.sum()
xs = np.convolve(np.pad(x, len(k) // 2, mode='edge'), g, mode='valid')
# 3) 窓が画面の外にはみ出さないように止める
xs = np.clip(xs, cw / 2, W - cw / 2)
json.dump({'fps': FPS, 'window_w': cw, 'centre_x': [round(float(v), 2) for v in xs]},
          open(dst.rsplit('.', 1)[0] + '.path.json', 'w'))

# 4) ffmpeg で読み、OpenCV で切り抜いて拡大し、ffmpeg で書く(YUV と RGB の変換はどちらも BT.709)
dec = subprocess.Popen(['ffmpeg', '-v', 'error', '-i', src, '-frames:v', str(n),
                        '-vf', 'scale=in_color_matrix=bt709:in_range=tv',
                        '-f', 'rawvideo', '-pix_fmt', 'bgr24', '-'], stdout=subprocess.PIPE)
enc = subprocess.Popen(['ffmpeg', '-v', 'error', '-y', '-f', 'rawvideo', '-pix_fmt', 'bgr24',
                        '-s', f'{OW}x{OH}', '-r', str(FPS), '-i', '-',
                        '-vf', 'fps=30,scale=out_color_matrix=bt709:out_range=tv,format=yuv420p,'
                               'setparams=colorspace=bt709:color_primaries=bt709:color_trc=bt709:range=tv',
                        '-t', f'{seconds:.3f}', '-c:v', 'libx264', '-preset', 'slow', '-crf', '14',
                        '-movflags', '+faststart', '-an', dst], stdin=subprocess.PIPE)
for i in range(n):
    f = np.frombuffer(dec.stdout.read(W * H * 3), np.uint8).reshape(H, W, 3)
    M = np.float32([[s, 0, -s * (xs[i] - cw / 2)], [0, s, 0]])  # 窓の位置は小数のまま。平行移動と拡大を一度に
    o = cv2.warpAffine(f, M, (OW, OH), flags=cv2.INTER_LANCZOS4, borderMode=cv2.BORDER_REPLICATE)
    enc.stdin.write(o.tobytes())
enc.stdin.close(); enc.wait(); dec.terminate()
print(dst, n, "frames in, window x", round(float(xs.min())), "-", round(float(xs.max())))
スクリプトの前半では以下の3段階の処理を実行します。
- キーフレーム列を入力動画の全コマ(毎秒24コマ)へ線形補間します。
- 平滑化幅を秒単位で指定したσ(シグマ)によるガウス平滑化を行い、端点での曲がりを防ぐため両端の値を延長して±3σの範囲で畳み込みます。
- 幅607.5 pxの切り抜き窓が1920 pxの画面外に出ないよう、中心座標を303.75〜1616.25にクリッピングします。
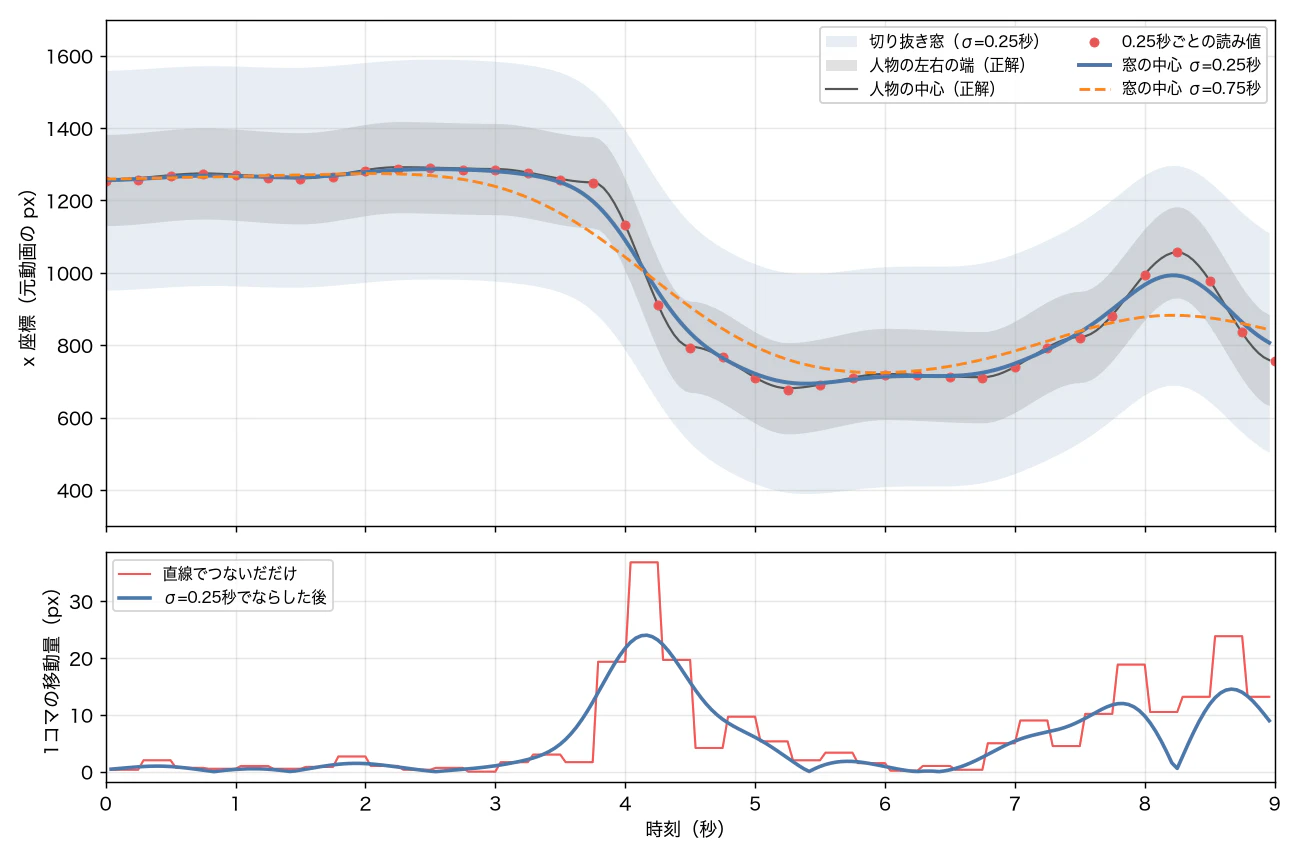
図3 平滑化軌道と移動量の検証(上:軌道比較、下:コマごとの移動量)
| σ | 最大速度(px/コマ) | コマ間の最大速度変化(px/コマ) | 窓中心と人物中心の最大乖離(px) | 最小余白(px) |
|---|---|---|---|---|
| 0(線形補間のみ) | 36.8 | 23.67 | 27.3 | 150.5 |
| 0.1秒 | 33.2 | 4.10 | 31.0 | 146.8 |
| 0.25秒(採用値) | 24.0 | 2.15 | 65.9 | 111.8 |
| 0.5秒 | 15.9 | 0.76 | 131.1 | 46.7 |
| 0.75秒 | 11.7 | 0.38 | 174.4 | 3.3 |
表B 練習用クリップにおける平滑化幅σの影響(1920×1080解像度、24 fps基準)
表Bのとおり、σを0.25秒にするとコマ間の最大速度変化は23.67から2.15へ約11分の1に減少し、人物中心と窓中心の乖離は65.9 px以内に収まります。一方、σを0.75秒まで広げると動きは穏やかになるものの、急激な移動時に人物端と窓枠の余白が3.3 pxまで減少します。
実動画でもσを0.25秒に設定することで、最大速度変化は線形補間時の26.7から1.3へと抑えられ、窓の中心はx = 828から1247の間を移動しました。
9:16縦動画として切り出しと書き出しを行う
crop916.py の後半部では、パイプ経由で ffmpeg から BGR バイト列を読み込み、OpenCV で切り抜きと拡大を行って別のパイプ経由で ffmpeg に送出し H.264 でエンコードします。
窓の座標は1画素未満の小数値のまま保持し、cv2.warpAffine で小数の移動と1.7778倍の拡大を同時に実行します。Lanczos 補間(INTER_LANCZOS4)を用い、整数丸めで生じる1 px刻み(出力上で1.78 px刻み)の不連続な動きを回避します。
色の変換係数(BT.601 / BT.709)の扱いにも留意します。色情報のない動画に対し、ffmpeg 8.1.2 のデフォルトの YUV/RGB 変換は BT.601 係数を用います。実動画の4.5秒目のコマでは in_color_matrix=bt601 と完全に一致し、BT.709 との間で緑チャンネルにおいて最大27階調(平均で赤4.9、緑7.3、青0.6階調)の差が生じました。HD動画は BT.709 が標準であるため、スクリプトの読み込みと書き出しの双方で明示的に bt709 を指定しています。
また、ffmpeg 8.1.2 では -color_primaries bt709 等の出力オプションで色のタグが unknown となるため、setparams フィルタで書き込みます。
24 fps 入力に対し、ffmpeg の fps フィルタの仕様 に従ってコマを重複させて 30 fps に変換します。練習用クリップおよび実動画ともに、全270コマ中54コマ(5コマに1回)が直前コマの重複となります。
uv run --with opencv-python-headless --with numpy python crop916.py A.mp4 keys.json out916.mp4 9.0
ffprobe -v error -show_entries stream=codec_name,width,height,r_frame_rate,nb_frames,color_space,color_transfer,color_primaries:format=duration -of compact out916.mp4
out916.mp4 216 frames in, window x 693 - 1286
stream|codec_name=h264|width=1080|height=1920|color_space=bt709|color_transfer=bt709|color_primaries=bt709|r_frame_rate=30/1|nb_frames=270
format|duration=9.000000
出力結果は 1080×1920、30 fps、270コマ、9.000秒で、各色タグもすべて bt709 と記録されています。216コマの処理時間は Apple M2 環境の2回の試行でそれぞれ33秒および43秒でした。
一覧画像で全コマの構図を確認する
出力された動画全体を目視確認するため、sheet.py を用いて目盛りなしの一覧画像を生成します。
uv run --with opencv-python-headless --with numpy python sheet.py out916.mp4 qa.jpg 0.5 9 200
qa.jpg 18 tiles 30fps 270 frames
生成された画像が冒頭の図1です。
確認の要点は、人物の頭部・腕・足先が窓の境界に接触していないか、およびコマ間で不自然な跳躍がないかです。練習用クリップで最も速く動く4秒前後(3.75〜4.5秒にかけて読み取り値が 1247 → 1131 → 910 → 792 と推移)においても、図1の全コマで人物が完全に画角内に収まっています。
正解データと照合したところ、σ = 0.25秒の条件で余白が最も小さくなったのは急激な移動中の3.83秒時点であり、その最小余白は111.8 pxでした。実動画でも同様に0.25秒間隔で全コマを確認し、すべての時点で人物が枠内に収まっていることを確かめました。
色変化から別動画のずれを検出し音声を同期する
色変化による時間ずれの検出
画角や解像度、fps、人物が異なっても、照明やカメラの動きによる平均的な色変化は同じ瞬間に発生します。以下のスクリプトで2本の動画の時間のずれを求めます。
# 同じ映像を使った 2 本の動画の時間のずれを、コマごとの色の変化から求める
# 使い方: python picalign.py a.mp4 b.mp4 [比べる秒数(既定 9)]
#   lag の意味: b の「t + lag 秒」のコマに、a の「t 秒」のコマが映っている
import sys, cv2, numpy as np

def signal(path):
    cap = cv2.VideoCapture(path)
    fps, v = cap.get(cv2.CAP_PROP_FPS), []
    while True:
        ok, f = cap.read()
        if not ok:
            break
        h, w = f.shape[:2]
        c = f[h // 6:h - h // 6, w // 6:w - w // 6]   # 中央部だけを見る(上下左右の黒帯や文字を避ける)
        v.append(c.reshape(-1, 3).mean(0))             # B, G, R それぞれの平均
    v = np.array(v)
    t = np.arange(len(v)) / fps
    tt = np.arange(0, t[-1], 0.02)                     # 50Hz に打ち直す(fps が違う動画どうしでも比べられる)
    r = np.stack([np.interp(tt, t, v[:, k]) for k in range(3)], 1)
    d = np.diff(r, axis=0)                             # 明るさそのものではなく、コマ間の変化を使う
    return (d - d.mean(0)) / (d.std(0) + 1e-6)

A, B = signal(sys.argv[1]), signal(sys.argv[2])
n = int((float(sys.argv[3]) if len(sys.argv) > 3 else 9.0) / 0.02)
best = (-9.0, 0)
for lag in range(-100, 101):                           # ±2 秒を 0.02 秒刻みで探す
    i0, i1 = max(0, -lag), min(n, len(A), len(B) - lag)
    if i1 - i0 < 100:
        continue
    c = float(np.mean(np.sum(A[i0:i1] * B[i0 + lag:i1 + lag], 1)) / 3)
    if c > best[0]:
        best = (c, lag)
print(f"best corr {best[0]:.3f} at b-lag {best[1] * 0.02:+.2f}s")
端の黒帯や文字を避けるため、中央の3分の2の領域から B, G, R の平均値を取得します。異なる fps を比較するため信号を50 Hzに再サンプリングし、色そのものではなく正規化したコマ間の変化を用います。冒頭9秒間について−2秒から+2秒の範囲を0.02秒刻みで探索し、相関が最大となるずれ(lag)を計算します。
uv run --with opencv-python-headless --with numpy python picalign.py A.mp4 B.mp4
uv run --with opencv-python-headless --with numpy python picalign.py out916.mp4 B.mp4
best corr 0.719 at b-lag +0.44s
best corr 0.600 at b-lag +0.44s
0.45秒先行するBに対し、0.02秒刻みの探索でA・B間は+0.44秒(相関0.719)が検出されました。9:16切り抜き動画との照合でも、異なる画角でありながら+0.44秒(相関0.600)が得られました。
実動画のペア(元の16:9動画と別アップロード動画)に対して同一のスクリプトを実行した結果を以下に示します。
best corr 0.787 at b-lag +0.00s
実動画と別アップロード動画との相関は+0.00秒で最大(0.787)となり、先頭コマから同期していることが判明しました。
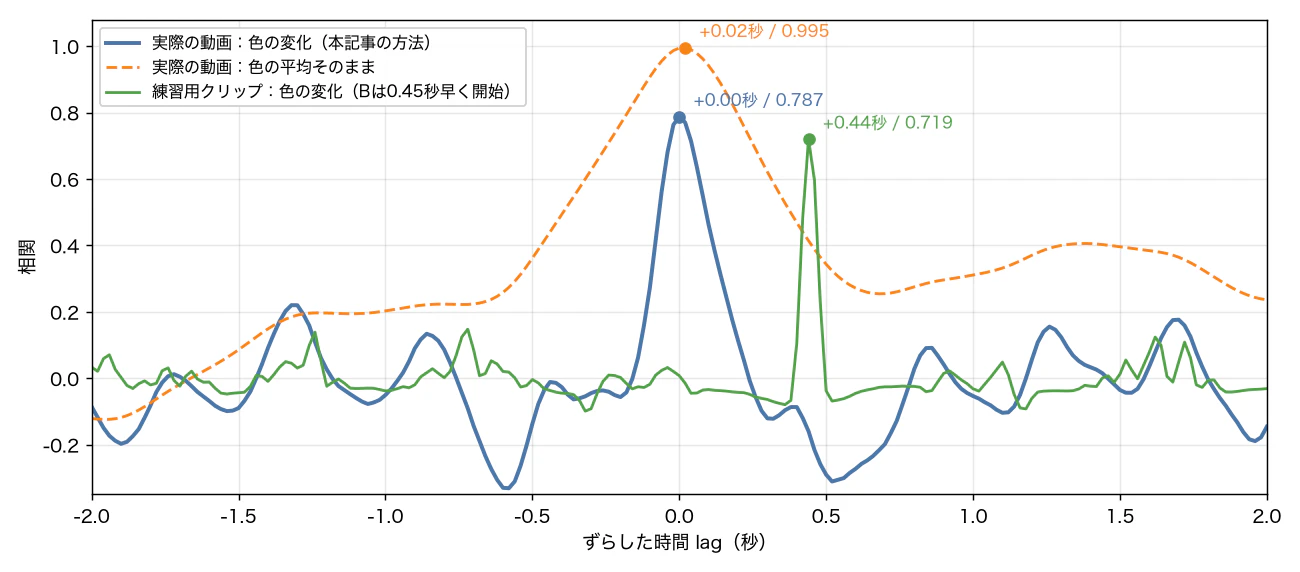
図4 ずれ量と相関値の推移(コマ間の変化を用いることで鋭いピークを形成)
| 信号の抽出方法 | 実動画: lag | 実動画: 相関 | 実動画: 0.2秒以上離れた位置の最大相関 | 練習用: lag | 練習用: 相関 | 練習用: 0.2秒以上離れた位置の最大相関 |
|---|---|---|---|---|---|---|
| 中央部・コマ間の変化(本稿の手法) | +0.00秒 | 0.787 | 0.220 | +0.44秒 | 0.719 | 0.148 |
| 中央部・色そのものの値 | +0.02秒 | 0.995 | 0.794 | +0.44秒 | 0.670 | 0.247 |
| 画面全体・コマ間の変化 | −0.02秒 | 0.914 | 0.242 | +0.44秒 | 0.732 | 0.140 |
表C 信号抽出方法の違いによるずれの検出精度比較
色そのものでは相関曲線がなだらかになり、0.2秒離れても0.794と高く、実動画の検出値が+0.02秒にずれました。コマ間の変化を使うとピークが鋭くなり、0.2秒以上離れた位置の相関は0.220以下に抑えられます。なお、画面全体を用いた場合は実動画で−0.02秒となりました。
| 生成時に設定した真のずれ D | 検出された lag | 相関値 |
|---|---|---|
| 0.00秒 | +0.00秒 | 0.818 |
| 0.45秒 | +0.44秒 | 0.719 |
| 1.20秒 | +1.20秒 | 0.496 |
| −0.80秒 | −0.80秒 | 0.851 |
表D 練習用クリップにおける各種ずれ量と検出結果
表Dのとおり、他のずれ量でも0.02秒の格子上で真値が正確に検出されました。
音声を映像に合わせて配置する
以下で音声を配置します。
# B の 0.44 秒目からの音を、縦動画の 0 秒目に合わせて敷く(最後の 30ms はフェードアウト)
ffmpeg -v error -i out916.mp4 -ss 0.44 -i B.mp4 -map 0:v -map 1:a -c:v copy -c:a aac -b:a 160k \
  -af "afade=t=out:st=8.97:d=0.03" -t 9 -movflags +faststart final.mp4
ffprobe -v error -show_entries stream=codec_name,nb_frames,duration:format=duration -of compact final.mp4
stream|codec_name=h264|duration=9.000000|nb_frames=270
stream|codec_name=aac|duration=9.000000|nb_frames=423
format|duration=9.000000
Bの0.44秒以降の音声を縦動画の先頭に合わせ、AAC 160 kb/s で末尾30 msをフェードアウトして9秒で切り出します。出力は映像(270コマ)と音声ともに9.000秒です。
final.mp4 では15回の照明変化に対し、音声が真の変化点から9.7〜9.8 ms遅れて再生されました。これは0.02秒探索グリッドによる0.01秒の残差で、30 fpsの1コマ(33.3 ms)の3分の1未満です。
実動画ではずれが0.00秒だったため、別アップロードの0.0〜9.0秒の音声をそのまま配置しました。
検証用の練習用クリップを作成する
以上の処理を再現・検証するための練習用クリップ生成スクリプトを以下に示します。
# 練習用クリップを作る(答え合わせ用の正解つき)
#   A.mp4      16:9(1920x1080, 24fps, 10秒, 音なし)。人物が左右に動き、照明の色が切り替わる
#   B.mp4      同じ場面を 9:16 に切り抜いた別カット(720x1280, 30fps)。A より D 秒早く始まり、照明に合わせた音つき
#   truth.json A の各コマの人物の中心 x
# 使い方: python make_practice_clip.py person.png D
import sys, json, wave, subprocess, numpy as np, cv2

person = cv2.imread(sys.argv[1], cv2.IMREAD_UNCHANGED)  # 背景を透過した全身画像
D = float(sys.argv[2])
rng = np.random.default_rng(2026)
W, H = 1920, 1080

# 人物の中心 x(t): 0.75秒ごとに「その場で揺れる」か「別の場所へ移る」かを決め、加減速しながらつなぐ
kt = np.arange(-2.25, 12.01, 0.75)
kx = [960.0]
for _ in kt[1:]:
    kx.append(rng.uniform(450, 1470) if rng.random() < 0.5 else min(max(kx[-1] + rng.normal(0, 60), 450), 1470))
def centre(t):
    s = min(max((t - kt[0]) / 0.75, 0), len(kt) - 1.001)
    i, f = int(s), s - int(s)
    return kx[i] + (kx[i + 1] - kx[i]) * f * f * (3 - 2 * f)

# 照明: 0.3〜0.9秒おきに色が切り替わり、そのたびに強く光って減衰する
beats = -2.0 + np.cumsum(rng.uniform(0.3, 0.9, 40))
pal = np.float32([[255, 60, 170], [200, 80, 255], [110, 255, 120], [60, 140, 255], [255, 120, 80]])  # BGR
cols = pal[rng.integers(0, len(pal), len(beats))]
yy, xx = np.mgrid[0:H, 0:W].astype(np.float32)
glow = sum(np.exp(-((xx - x) ** 2 + (yy - 170) ** 2) / (2 * 150 ** 2)) for x in (220, 740, 1180, 1700))[..., None]
base = np.dstack([np.linspace(34, 14, H)[:, None].repeat(W, 1)] * 3) * np.float32([1.3, 0.8, 1.1])
base[860:] += 22  # 床

h = 820
w = round(person.shape[1] * h / person.shape[0])
p = cv2.resize(person, (w, h), interpolation=cv2.INTER_AREA).astype(np.float32)
rgb, a = p[..., :3], p[..., 3:] / 255

def frame(t):
    b = np.searchsorted(beats, t) - 1
    k = 0.45 + 0.55 * np.exp(-(t - beats[b]) / 0.25)
    f = base + glow * cols[b] * k * 0.9 + cols[b] * k * 0.06
    x0 = int(round(centre(t) - w / 2))
    y0 = 1050 - h + int(round(6 * np.sin(2 * np.pi * 1.7 * t)))
    tint = 0.75 + 0.25 * k * cols[b] / 255
    f[y0:y0 + h, x0:x0 + w] = rgb * tint * a + f[y0:y0 + h, x0:x0 + w] * (1 - a)
    return np.clip(f, 0, 255).astype(np.uint8)

def encode(name, size, fps, extra):
    return subprocess.Popen(['ffmpeg', '-v', 'error', '-y', '-f', 'rawvideo', '-pix_fmt', 'bgr24', '-s', size,
                             '-r', str(fps), '-i', '-', *extra,
                             '-vf', 'scale=out_color_matrix=bt709:out_range=tv,format=yuv420p,'
                                    'setparams=colorspace=bt709:color_primaries=bt709:color_trc=bt709:range=tv',
                             '-c:v', 'libx264', name], stdin=subprocess.PIPE)

# A: 24fps, 10秒
enc = encode('A.mp4', f'{W}x{H}', 24, ['-crf', '18'])
truth = []
for i in range(240):
    enc.stdin.write(frame(i / 24).tobytes())
    truth.append(round(float(centre(i / 24)), 2))
enc.stdin.close(); enc.wait()
json.dump({'fps': 24, 'half_width': w / 2, 'centre_x': truth}, open('truth.json', 'w'))

# B の音: 照明が切り替わる瞬間(B の時刻では +D 秒)に短いキック音
sr, dur = 48000, 10 + D
s = np.zeros(int(sr * dur), np.float32)
u = np.arange(int(0.15 * sr)) / sr
kick = np.sin(2 * np.pi * (50 * u + 300 * (1 - np.exp(-u / 0.03)) * 0.03)) * np.exp(-u / 0.06)
for bt in beats + D:
    j = int(round(bt * sr))
    if 0 <= j < len(s) - len(u):
        s[j:j + len(u)] += kick
with wave.open('B.wav', 'wb') as wf:
    wf.setnchannels(1); wf.setsampwidth(2); wf.setframerate(sr)
    wf.writeframes((s * 0.8 * 32767).astype(np.int16).tobytes())

# B: 30fps。中央を 9:16 に切り抜いて 720x1280 にし、A より D 秒早く始める
enc = encode('B.mp4', '720x1280', 30, ['-i', 'B.wav', '-c:a', 'aac', '-b:a', '128k', '-crf', '28'])
for i in range(int(round(dur * 30))):
    f = frame(i / 30 - D)[:, 656:1264]
    enc.stdin.write(cv2.resize(f, (720, 1280), interpolation=cv2.INTER_AREA).tobytes())
enc.stdin.close(); enc.wait()
print('A.mp4: 240 frames / B.mp4:', int(round(dur * 30)), 'frames / D =', D)
# person.png: 背景を透過した人物の全身画像(RGBA の PNG)
uv run --with opencv-python-headless --with numpy python make_practice_clip.py person.png 0.45
A.mp4: 240 frames / B.mp4: 314 frames / D = 0.45
| ファイル名 | 内容 |
|---|---|
A.mp4 |
1920×1080、24 fps、240コマ(10秒)、H.264、無音。暗いステージ上で身長820 pxの人物が左右に移動し、0.3〜0.9秒ごとに照明が変化 |
truth.json |
A動画の各コマにおける人物の真の中心x座標 |
B.mp4 |
同一場面の中央9:16を切り出して720×1280・30 fps化。AよりD秒早く始まり、照明変化に応じたキック音を含む |
B.wav |
エンコード前のB動画の音声 |
表E 練習用クリップ生成スクリプトの出力ファイル
固定シード値(2026)により、A動画では人物が冒頭9秒間に x = 681 から 1292 の間を最大毎コマ37.7 pxの速度で移動し、何度実行しても同一のファイルが生成されます。B動画は中央固定切り抜きのため人物が枠外に出る場面がありますが、照明変化が画面全体に及ぶためずれの検出が成立します。Apple M2 での生成時間は2回の実行でそれぞれ74秒および86秒でした。
まとめ
- 0.25秒ごとの目視読み取り: 練習用クリップでは正解との平均誤差2.1 pxで位置を取得できました。
- 平滑化幅σ = 0.25秒: 練習用クリップではコマ間の最大速度変化を約11分の1に抑えつつ十分な余白を維持しました。
- 小数座標とBT.709指定: 1画素未満の移動を保持し、BT.601への誤変換による階調ずれを防ぎました。
- 一覧画像での全コマ確認: 追従の破綻や人物の画角外へのはみ出しがないことを確認しました。
- 色変化による時間ずれ検出: コマ間の変化を用いることで0.02秒刻みで正確に音声を同期できました。
※ 筆者は写真1枚の人物を主役と差し替えた9秒の縦動画を生成するWebサービス、Dime Dime Baby AI の開発に携わっています。本稿の切り抜きと音声同期はその素材準備のために実施したものであり、練習用クリップの人物は画像生成による架空の人物です。