
2000年前に炭になった巻物を CT と機械学習で開かずに読む、Vesuvius Challenge。その公開モノレポ ScrollPrize/villa に、解像度の違う2つのCTスキャンを自動でアフィン位置合わせするスクリプトを PR として出しました。
結果: 人が目印を置いて作っていた位置合わせを、コマンド1つ・約15分の自動処理にし、精度もチャレンジのカタログに載っている既存の変換を上回りました。 組織外の参加者が、フィットに使っていない点(held-out)で独立に測った中央値は、既存の変換 1.35 / 1.50 ボクセルに対して 1.20 / 1.16 ボクセルです。
- PR: https://github.com/ScrollPrize/villa/pull/2374 (2026-11-02 時点で OPEN・未マージ)
- 変換と検証の置き場: https://github.com/yuichi916/vesuvius-9um-vs-2p4um
- 書いたのは Claude Code。方向を決めて結果を確かめたのは人(私)。コミットはどちらも
Co-Authored-By: Claude Opus 5.5
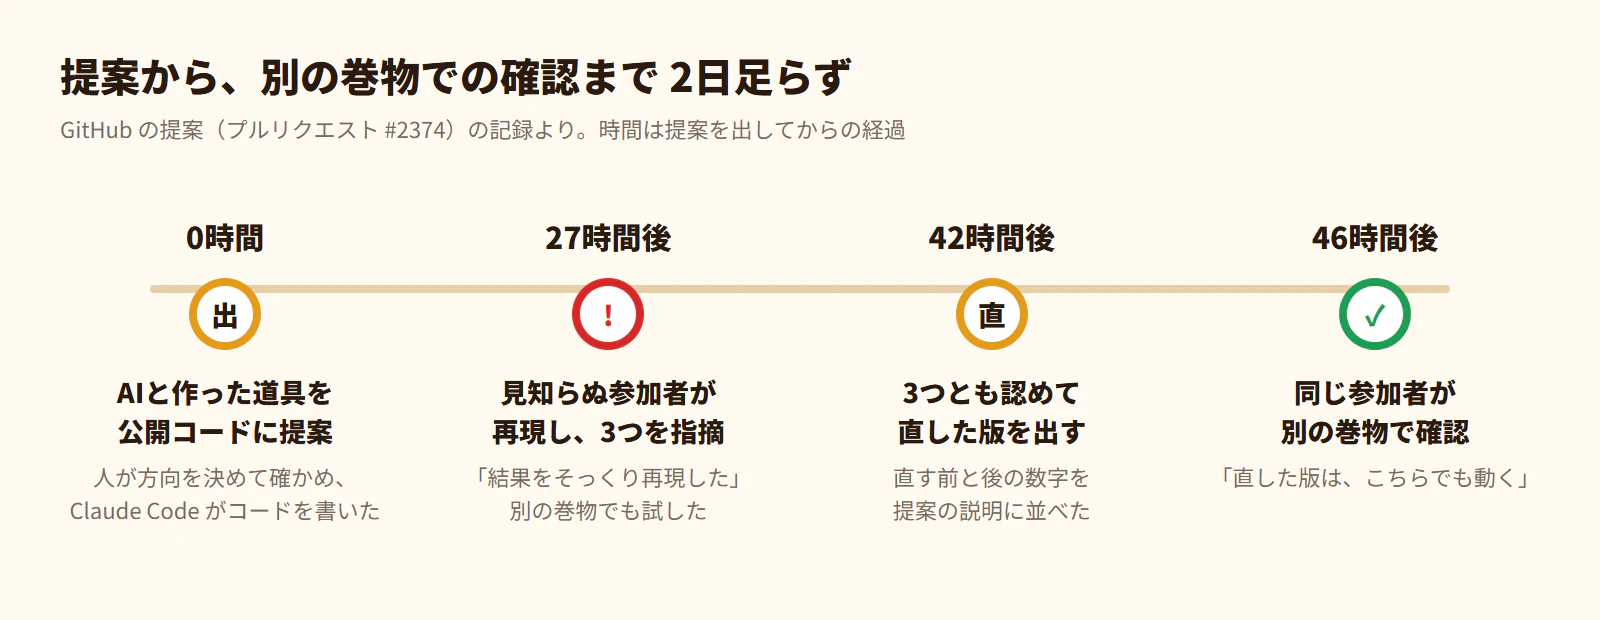
出して27時間後、組織外の参加者が手元で再現し、3つの問題を指摘してくれました。1つは in-sample の残差には原理的に出ない系統的なオフセットでした。直した版は、出してから46時間で、同じ人が別の巻物で確認しています。held-out の検証では、カタログに載っている既存の変換よりずれが小さくなりました。
この記事は、手法・見つかったバグ・数字・Claude Code で OSS に PR を出すときの実務メモです。一般向けの話は note に、映像は YouTube に置きました。
- note: https://note.com/views_of_life/n/n0f73b5e1c609
- 動画 #1 紹介編: https://youtu.be/raonOEpgGL4
- 動画 #2 貢献編: https://youtu.be/e1I69aw6BaU
- 再生リスト「炭の巻物を読む」: https://www.youtube.com/playlist?list=PLHfgC-PAaIYM
何を解いたか
データ
ヘルクラネウムの巻物の一部は、2回撮られています。巻物全体を約 9.36 µm で撮ったスキャンと、その一部の高さだけを 2.4 µm で撮ったスキャンです。どちらも S3 の公開バケットに、OME-Zarr(zarr v2 形式、multiscales 付き)のピラミッドとして置かれています。レベル L は 2×2×2 平均を L 回重ねたもので、ボクセルサイズは隣の metadata.json に入っています。
https://vesuvius-challenge-open-data.s3.amazonaws.com/PHerc0841/volumes/20250821151531-9.366um-1.2m-113keV-masked.zarr
https://vesuvius-challenge-open-data.s3.amazonaws.com/PHerc0841/volumes/20260319124803-2.403um-0.2m-77keV-masked.zarr
やりたいこと
9 µm 側でトレースされた面(メッシュ)を、2.4 µm 側へ写したい。そのためには2つのボリュームの間の変換 p_fixed = M @ p_moving(3×4 のアフィン)が要ります。
PR 本文に書いた動機は、「9 µm でインク検出が空振りしたとき、それが解像度のせいかを、同じ面の 9 µm / 2.4 µm の描き出しを並べて確かめたい」です。
既存の手順
foundation/volume-registration/README.md の手順は、neuroglancer の上でキー操作で粗く合わせ、目印(landmark)を手で置いてフィットする、というものです。SimpleITK による自動の微調整もありますが、README 自身が「Not particularly recommended」と書いています(低解像度レベルを使うため精度が出ない)。
手法(auto_register.py)
PR の差分は auto_register.py(265行の新規ファイル)と、transform_utils.py の3行です。流れは3段です。
レベルの選び方
ピラミッドのレベルは、ボクセルサイズから目標の解像度に一番近いものを選びます。
COARSE_UM = 75.0
FINE_UM = 19.0

def level_near(self, target_um: float) -> int:
    return max(0, round(math.log2(target_um / self.um)))
9.362 µm 側は coarse が L3(約75 µm)・fine が L1(約18.7 µm)、2.403 µm 側は coarse が L5(約77 µm)・fine が L3(約19.2 µm)になります。この「2.4 µm 側の fine は L3」が、後で出てくるバグの大きさ(8ボクセル幅)を決めています。
coarse:1枚の断面で、高さ・回転・鏡映・xy ずれを探す
前提は「どちらのスキャンも巻物の軸が z」(BM18 のヘリカルスキャンでは成り立つ)。moving 側の真ん中の軸断面を1枚取り、ボクセルサイズ比で fixed 側の縮尺に合わせます。これを 鏡映 2通り × 2° 刻み 180 通りの回転でテンプレートにし、fixed 側の 10 枚おきの軸断面すべてと、FFT の相互相関で照合します(さらに 4 画素おきに間引いた画像で)。
for zi, sl in enumerate(np.asarray(F[::zstep])):  # one read: each chunk fetched once
    ...
    for (mirror, angle), (C, n) in templates.items():
        c = np.real(ifft2(T * C))
        i = int(c.argmax())
        score = c.flat[i] / (n * tn)
F[::zstep] を1回で読むのは、S3 越しに同じチャンクを何度も取りに行かないためです。
scipy.ndimage.rotate の回転の向きがこの座標系でどちらになるかは、決め打ちせず、±両方の候補アフィンを作ります。サンプル点の6点おき(20点)で fine の照合を試し、ピークの強さの中央値が大きいほうを採ります。
fine:120点で 64³ の立方体を3Dで照合する
サンプル点は、moving 側の 高さ5段 × 角度8方向 × 半径3段 = 120点です。各点で、fine レベル(約19 µm)の 64³ の立方体を moving 側から切り出し、fixed 側の縮尺に zoom し、現在の変換の回転成分で fixed 側の向きに回します。fixed 側は「現在の変換で写した位置」の周りに ±16 の余白を付けた立方体を取ります。
両方を平均0にして3次元のハニング窓をかけ、FFT で3次元の相互相関を取ります。ピークは各軸の放物線補間でサブボクセルまで詰め、ピークの強さは max / std にしています。立方体の半分以上が空(マスクの外)の点は捨てます。
robust affine:最小二乗と外れ値除去
def robust_affine(P, Q, usable):
    idx = np.where(usable)[0]
    for _ in range(6):
        A, *_ = np.linalg.lstsq(np.c_[P[idx], np.ones(len(idx))], Q[idx], rcond=None)
        res = np.linalg.norm(np.c_[P, np.ones(len(P))] @ A - Q, axis=1)
        keep = np.where(usable & (res < max(3 * np.median(res[idx]), 1.0)))[0]
        if np.array_equal(keep, idx):
            break
        idx = keep
    return A.T, idx, res
12自由度のアフィンを最小二乗で当て、残差が「中央値の3倍、ただし最低1ボクセル」を超える点を外して、集合が変わらなくなるまで(最大6回)繰り返します。ピークの強さが10以下の点は最初から使いません。得た変換を種にして、120点の照合からもう1回やり直します(2パス)。
出力とリモート読み
出力は find_transform.py と同じスキーマの transform JSON(XYZ 順)で、インライアの照合点を landmark として入れています。そのまま find_transform.py --initial-transform で開いて、目で確かめたり手で直したりできます。
入力は S3 の URL をそのまま zarr.open に渡すだけです(requirements には fsspec / aiohttp が入っている)。PHerc1203 では、S3 から読んでコマンド1回・約15分でした。
結果(PR 本文の表、括弧はレビューで直す前)
| ペア | coarse の一致 | インライア | 残差の中央値(直す前) | 当てた拡大率 3軸(ボクセルサイズ比) |
|---|---|---|---|---|
| PHerc1203 9.362 ← 2.403 µm | z 1240 (L3), 0° | 38/38 | 0.45 vox (0.87) | 0.25659–0.25666 (0.25668) |
| PHerc0841 9.366 ← 2.403 µm | z 1840 (L3), 0° | 17/22 | 1.01 vox (1.51) | 0.25647–0.25664 (0.25657) |
フィットに使っていない検証も2つ置きました。
- チェッカーボード: PHerc1203 で、変換した 2.4 µm を 9.36 µm と市松に並べた面のピクセル相関 r は 0.955(直す前の変換では 0.83)。図は PR 本文にあります
- メッシュの照合: PHerc0841 にはチームが公開した segment w00 のメッシュが 9.366 µm 版と 2.403 µm 版の両方ある。9.366 µm 版を変換で写し、2.403 µm 版との距離を 36,829 頂点の 99.7% で測った。法線方向の中央値 4.2 µm・p90 9.3 µm(直す前 7.7 µm・16 µm)、面内の中央値 4.8 µm(変わらず)
レビューで見つかった3つ
PR を出したのは 2026-10-30 15:57 UTC。27時間後に、組織のメンバーではない参加者からコメントが来ました。PHerc1203 で 1abce222 を動かして「38/38 inliers, 0.87 vx, and the same matrix as your published JSON」と完全に再現し、私が試していない PHerc0139(2.399 µm → 9.362 µm、coarse は 182° で一致、32/34 インライア)でも動かしたうえでの指摘です。
1. match_point の立方体の中心のずれ(c − 0.5)
修正前の match_point は、こうなっていました(抜粋)。
c = np.round(to_level(p_moving, lm)).astype(int)
a = np.asarray(M[c[0] - half:c[0] + half, c[1] - half:c[1] + half, c[2] - half:c[2] + half])
...
p_fixed = lo + o + (a.shape[0] - 1) / 2 + d
return to_level0(p_fixed, lf), float(cc.max() / (cc.std() + 1e-9))
そして register() は、返ってきた p_fixed を、丸める前の p_moving とペアにしていました。
問題は2つ重なっています。
-
M[c-half : c+half]は要素数 64(偶数)なので、立方体の中心はレベル座標でcではなくc − 0.5 -
cはround(u)(u = to_level(p_moving, lm))なので、uとcの間にも最大 ±0.5 の差がある
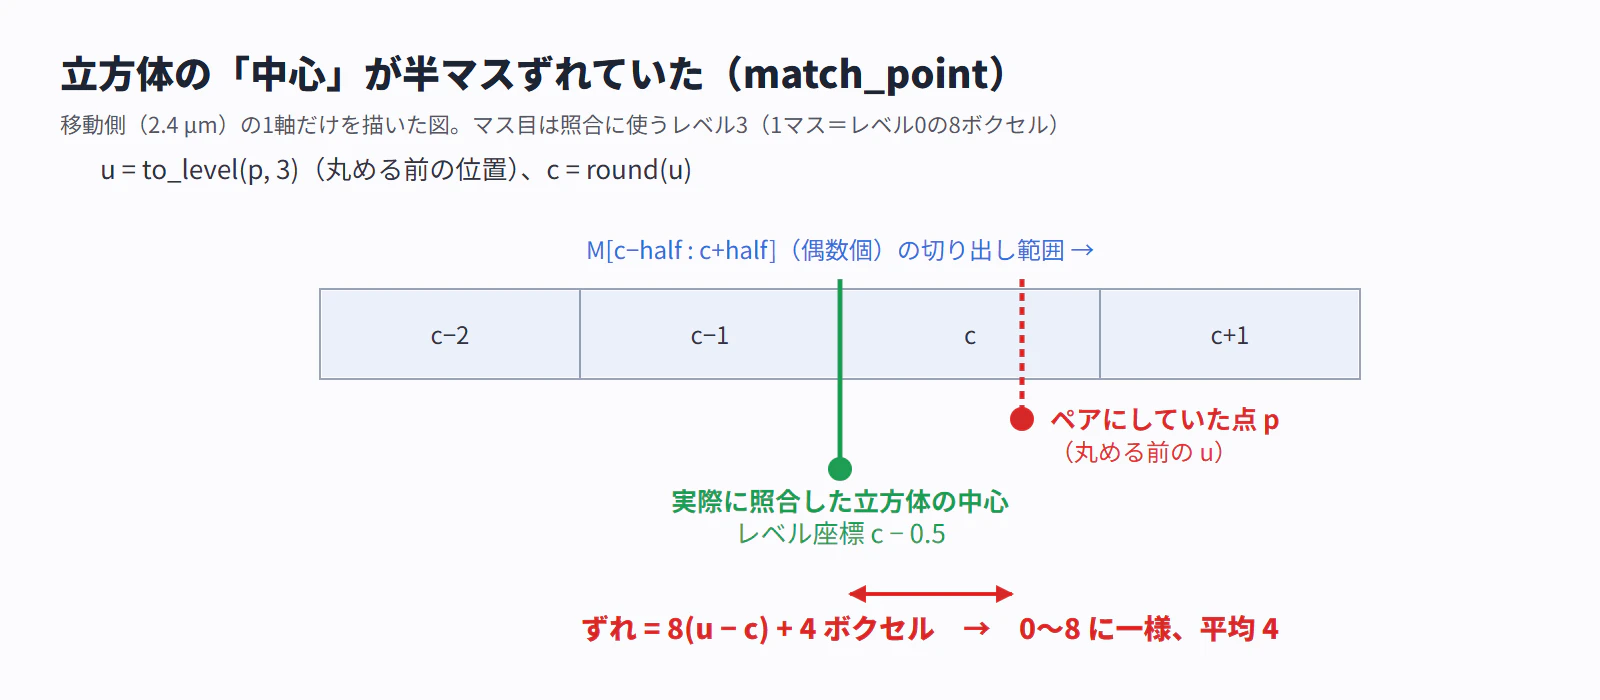
レベル座標の変換は to_level0(q, L) = (q + 0.5)·2^L − 0.5 なので、ペアにした点 p と実際に照合した中心の差は、1軸あたり
p − to_level0(c − 0.5, L) = 2^L (u − c) + 2^(L−1)
                          = 8 (u − c) + 4      (L = 3)
レベル0のボクセルで [0, 8) に一様に散り、平均は 4 です。
これがなぜ残差に出ないのか。最小二乗のアフィンは並進を持っているので、全点に共通の平均 4 ボクセルは並進に吸い込まれます。2.4 µm のボクセル 4 個を3軸、fixed 側の縮尺(×0.2567)で見ると √3 × 4 × 0.2567 ≈ 1.8 ボクセル(9.36 µm 単位)。レビューの言葉では「about 1.8 voxels at 9.36 µm, and the in-sample residual can't show it」。点ごとに散る部分だけが残差を押し上げていて、in-sample の中央値 0.87 はその姿でした。
直し方は、レビューで提案された1行(T を使った補正項を足す)とは少し変えています。match_point が、実際に照合した立方体の中心を返すようにしました。
-    return to_level0(p_fixed, lf), float(cc.max() / (cc.std() + 1e-9))
+    return to_level0(c - 0.5, lm), to_level0(p_fixed, lf), float(cc.max() / (cc.std() + 1e-9))
-        rows = [(p, match_point(fixed, moving, T, p)) for p in points]
-        rows = [(p, m) for p, m in rows if m is not None]
-        P = np.array([p for p, _ in rows])
-        Q = np.array([m[0] for _, m in rows])
-        peaks = np.array([m[1] for _, m in rows])
+        rows = [m for m in (match_point(fixed, moving, T, p) for p in points) if m is not None]
+        P = np.array([m[0] for m in rows])
+        Q = np.array([m[1] for m in rows])
+        peaks = np.array([m[2] for m in rows])
補正項を使わないので、ペアの作り方が「その時点の T」(1パス目では coarse の粗い変換)に依存しません。JSON の moving 側 landmark も、照合した立方体の中心になります。
| 直す前(1abce22) | 直した後(94cd12c) | |
|---|---|---|
| PHerc1203 in-sample 中央値 | 0.87 vx (38/38) | 0.45 vx (38/38) |
| PHerc0841 in-sample 中央値 | 1.51 vx (17/22) | 1.01 vx (17/22) |
| PHerc0841 w00 メッシュ、法線方向(フィット点を使わない) | 中央値 7.7 µm, p90 16.0 µm | 中央値 4.2 µm, p90 9.3 µm |
| 同、面内 | 中央値 4.8 µm | 中央値 4.8 µm |
レビュアーの1行版でも PHerc1203 は 0.46 vx で、ほぼ一致しました。
レビュアーはさらに、フィットに使っていない点で測っています。PHerc0139 の2つのセグメントで、9.36 µm の 64³ ブロックの 3-D NCC を計160点(各80点)。中央値は 2.67 / 2.48 vx から 1.20 / 1.16 vx に下がり、2つの版の差は予測したオフセットと全軸で符号が一致した、とのことです。
2. zarr 3 で with zarr.open(...) が落ちる
-    with zarr.open(path, mode="r") as store:
-        sanity_check_zarr_store(store)
-        voxels_z, voxels_y, voxels_x = store["0"].shape
+    # zarr 3 groups are not context managers; a read-only open needs no close
+    store = zarr.open(path, mode="r")
+    sanity_check_zarr_store(store)
+    voxels_z, voxels_y, voxels_x = store["0"].shape
transform_utils.get_volume_dimensions は main に前からあるコードですが、zarr 3.1.6 / 3.4.2 では 'Group' object does not support the context manager protocol で落ちます(2.18.3 は動く)。Scan は必ずこの関数を通るので、PR 本文の「zarr 3.4.2 で試した」は誤りでした。読み取り専用で開くだけなので with を外しました。直した後の PHerc0841 の実行は zarr 3.4.2 / Python 3.14 でこの経路を通っています(PHerc1203 は zarr 2.18.3 / Python 3.10)。
3. 拡大率がボクセルサイズ比と合うことは、検証にならない
最初の本文は、当てた拡大率がボクセルサイズ比と合うことを、変換が正しい根拠のように書いていました。PHerc0139 では当てた拡大率が 0.2571、ピクセル比は 2.399/9.362 = 0.25625 で、カタログの変換も 0.2571。巻物によっては合わないので、この主張は本文から外し、レビュアーの数字を引いて注に置きました。
直した版の確認
修正コミット 94cd12c は、元の 1abce22 の上に積み、squash していません。本文には「Changes after review」の節を足し、上の表を置きました。チェッカーボードと2つの変換も作り直しています(r 0.83 → 0.955。古い変換で図のスクリプトを回し直すと 0.829 なので、差は修正によるもの)。
返信から約4時間後、レビュアーから確認が来ました。
Thanks, the fix works for me too. I reran 94cd12c on PHerc0139 (2.399 µm 20260102150214 → 9.362 µm 20250728140407), unpatched on zarr 3.4.2: in-sample median 1.00 vx (9.36 µm voxels) with 32/34 inliers.
On a held-out check (3-D NCC of 64³ blocks at 80 mesh points on each of two segments) the median error is 1.20 / 1.16 vx, against 1.35 / 1.50 for the catalogue transform.
held-out の中央値で、カタログの変換 1.35 / 1.50 vx に対して 1.20 / 1.16 vx。1回目のコメントの検証(同じ2セグメント・64³ ブロックの 3-D NCC・計160点)では、直す前が 2.67 / 2.48 vx でした。数字を並べると、直す前はカタログの変換より悪く、直した後は良い、という並びです。
Claude Code で OSS に PR を出すときの実務メモ
分担
- 人(私): 何を作るか(9 µm のメッシュを 2.4 µm に写す道具)、どのデータで試すか、結果を確かめる。PR 本文の「Why I made this」の節は、私の日本語を訳したもの
-
Claude Code: コード、テスト、実行、PR 本文(
Generated with Claude Code)。2つのコミットとも共著
in-sample の残差は検証ではない
今回いちばん効いた教訓です。0.87 ボクセルという残差は「フィットに使った点が、フィットした変換にどれだけ乗っているか」でしかありません。全点に共通のずれは、モデルの自由度(並進)がそのまま吸収します。
見つけたのは、フィットに使っていない点での測定でした。私の側にもメッシュの照合(法線方向 7.7 µm)という out-of-sample の物差しは最初からありましたが、比べる相手がいないと「この 7.7 µm のうちどれだけがバグか」は分かりません。直した版ができて初めて、作者の返信にある通り「about half the along-normal error was this offset」と切り分けられました。
位置合わせに限らず、AIにフィットや最適化のコードを書かせるときは、最初から held-out の評価を別の経路で用意させるのが安上がりです。
「試した環境」は、実行ログに紐づける
zarr 3.4.2 の件は、コードではなく本文の誤りでした。本文の「Tested with」の行は、その行を支える実行ログ(バージョンを出力した行ごと)と対にしておくべきでした。他人が別のバージョンで動かすと、ここはすぐに割れます。
他人の再現は、自分では通らない経路を通る
レビュアーの実行は、私のと3点違っていました。
- zarr 3.x(私の PHerc1203 は 2.18.3)
- 別の巻物 PHerc0139
- coarse の一致が 182°(私の2本はどちらも 0°。回転の経路を通ったのはこれが初めて)
3つの指摘のうち、zarr 3 と拡大率の2つは、この違いから出ています。研究コードでは、独立した再現がテスト行列の代わりになります。
指摘への返し方
- 指摘はまず自分の側で確かめる(立方体の中心が
c − 0.5であること、ずれが 1軸あたり8(u − c) + 4になることを確かめてから直した。結果の 0.45 vx は、レビュアーの1行版の 0.46 vx とほぼ一致) - 修正は squash せず別コミットに積み、本文に before / after の表を足す。誤った主張は消すだけでなく、何が誤りだったかを書く
- 図や変換などの成果物も、同じ修正で作り直して、どれが古いかを明記する
返信から確認まで約4時間。再確認しやすい形で返すと、往復が速くなります。
いまの状態と限界
- PR は 2026-11-02 時点で OPEN・未マージ。運営チームのレビューはまだ
- アフィンだけなので、2回のスキャンの間のゆがみは残差に入る
- coarse は moving 側の断面1枚だけで探す。真ん中の断面にパピルスがほとんど無いスキャンでは、誤って一致する可能性がある
- 前提は「両スキャンとも巻物の軸が z」
コードとライセンス
記事中のコードは ScrollPrize/villa(MIT License)の foundation/volume-registration/auto_register.py と transform_utils.py(PR #2374 のコミット 94cd12c と、その差分)から引用しました。
- リポジトリ: https://github.com/ScrollPrize/villa
- PR: https://github.com/ScrollPrize/villa/pull/2374
- 変換・検証・図のスクリプト: https://github.com/yuichi916/vesuvius-9um-vs-2p4um (MIT)
- Vesuvius Challenge: https://scrollprize.org/ / 参加の入口: https://scrollprize.org/get_started
関連
- AIと組んだほかの「人類初」の記録(サイト): https://yuichi916.github.io/?ref=qiita-vesuvius#firsts
- 数学で答えの出ていなかった値を決めた記録: https://yuichi916.github.io/unsolved.html?ref=qiita-vesuvius