皆さんこんばんわ!
急な気温の変化についていけず風邪をひきそうなポンコツエンジニアのGONです。
今日から急に涼しくなりましたね!
猛暑でぐったりするのは嫌ですが、もうちょっと穏やかに秋になっていって欲しいと願います。
こちとらただでさえ身体にガタが来ているので、
自然様に軽く小突かれただけで軽く吹っ飛びます。。
さて、先日まで『PHP』『PostgreSQL』『AWS』の選定理由や、
データベースのセキュリティ実践レクチャー、
ネットワーク設計のポイントなどなど書かせていただきましたが、
最近書かせていただいている『AWS』の設定シリーズとして、本日は
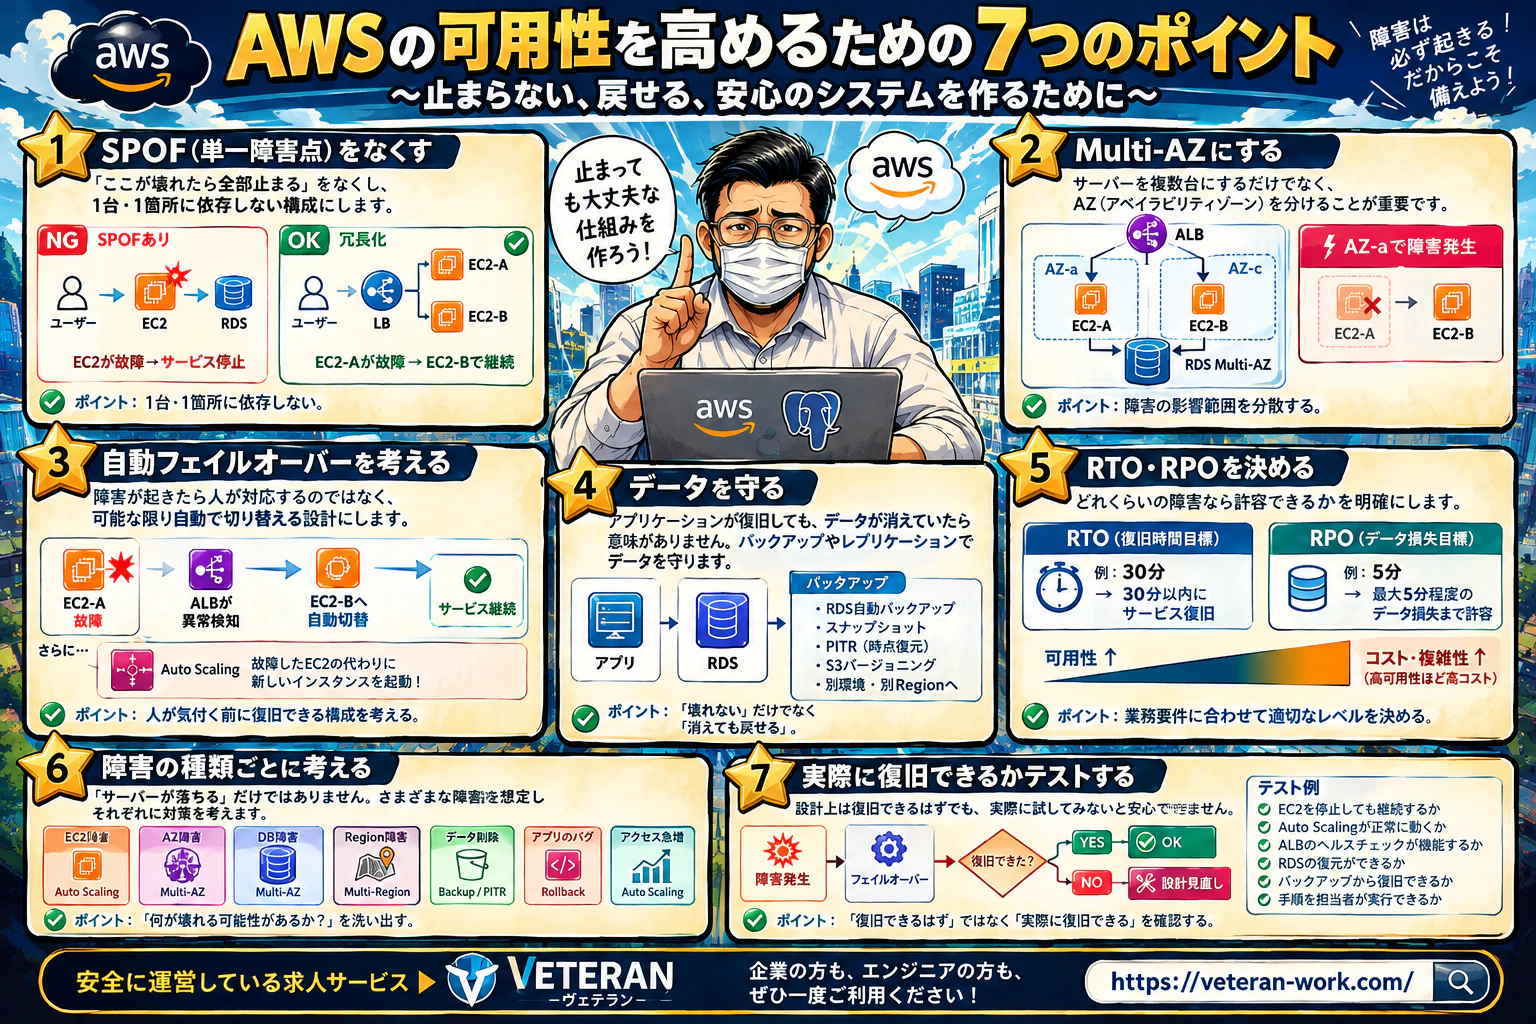
AWSの可用性を高めるための7つのポイントについて、
書かせていただきます!
「可用性(かようせい)」とは、必要なときにシステムやサービスを問題なく利用できる度合いのことです。
たとえば、Webサイトが24時間ほぼ停止せずアクセスできるなら、
「可用性が高い」と言えます。逆に、障害が頻繁に起きて利用できない時間が多い場合は
「可用性が低い」と言います。
ITでは「Availability」と呼ばれ、情報セキュリティの重要な3要素(CIA)の一つです。
・機密性(Confidentiality):許可された人だけが情報を見られる
・完全性(Integrity):情報が勝手に改ざんされない
・可用性(Availability):必要なときに情報・システムを利用できる
はじめに① SPOF(単一障害点)をなくす事からです。
まずは「ここが壊れたら全部止まる」という箇所をなくします。
【NG】

ユーザー
   ↓
  EC2
   ↓
  RDS

EC2が故障 → サービス停止
冗長化すると、
【OK】

          ┌→ EC2-A
ユーザー → LB
          └→ EC2-B

EC2-Aが故障 → EC2-Bで継続
ポイントは1台・1箇所に依存しない。
人間はそうもいきませんがシステムは複製を何台も用意できます。
② Multi-AZにする
サーバーを複数台にするだけでなく、AZを分けることが重要です。
         ALB
        /   \
       ↓     ↓
    EC2-A   EC2-B
    AZ-a    AZ-c
      │       │
      └───┬───┘
          ↓
      RDS Multi-AZ
AZ-aで障害が発生しても、AZ-c側でサービスを継続できます。
ポイント:障害の影響範囲を分散する。
③ 自動フェイルオーバーを考える
「障害が起きたら人が対応」ではなく、可能な限り自動で切り替える設計にします。
EC2-A
  ×
  ↓
ALBが異常検知
  ↓
EC2-Aへの通信停止
  ↓
EC2-Bへ自動切替
  ↓
サービス継続
AWSではALBのヘルスチェックやRDS Multi-AZなど、障害時の切り替えを自動化できる仕組みがあります。
ポイント:人が気付く前に復旧できる構成を考える。
④ データを守る
アプリケーションが復旧しても、データが消えていたら意味がありません。
アプリ
  ↓
 RDS
  ↓
バックアップ
  ↓
S3等に保管
例えば、
・RDSのバックアップ
・スナップショット
・S3のバージョニング
・別環境・別Regionへのバックアップ
などを検討します。
ポイント:「壊れない」だけでなく「消えても戻せる」。
⑤ RTO・RPOを決める
「どれくらいの障害なら許容できるか」を明確にします。
障害発生
   │
   ├── RTO:何分で復旧する?
   │
   └── RPO:どこまでのデータを戻す?
例えば、
RTO:30分
→ 30分以内にサービス復旧
RPO:5分
→ 最大5分程度のデータ損失まで許容
この要件によって、バックアップだけでよいのか、Warm StandbyやMulti-Regionが必要なのかが変わります。
ポイント:可用性は「高ければ高いほど良い」ではなく、業務要件に合わせる。
⑥ 障害の種類ごとに考える
「サーバーが落ちる」だけではありません。
              障害
               │
     ┌─────────┼─────────┐
     ↓         ↓         ↓
   EC2障害    AZ障害    DB障害
     │         │         │
 Auto Scaling Multi-AZ  Multi-AZ
さらに、
Region障害
    ↓
Multi-Region

データ削除
    ↓
Backup / PITR

アプリのバグ
    ↓
Rollback
のように、障害の種類ごとに対策を考えることが重要です。
ポイント:「何が壊れる可能性があるか?」を洗い出す。
⑦ 実際に復旧できるかテストする
最後が意外と重要です。
        障害発生
           ↓
      フェイルオーバー
           ↓
        復旧?
        ↙    ↘
      YES     NO
       ↓       ↓
      OK     設計見直し
例えば、
・EC2を停止してもサービスが継続するか
・AZ障害時に切り替わるか
・RDSからデータを復元できるか
・バックアップから本当に復旧できるか
・復旧手順を担当者が実行できるか
などを実際に確認します。
ポイント:「復旧できるはず」ではなく「実際に復旧できる」を確認する。
この様に机上の空論だけではなく、実際に試験しておくことで、
有事の際にも安心していられますね。
「備えあれば憂いなし」という事です。
この様に、障害発生時にも動き続ける様に知恵を絞った求人マッチングサービスは以下になります。
▼求人マッチングサービス【ヴェテラン】
エンジニアのみなさま、
企業の採用ご担当者のみなさま、
ぜひ、使ってみてくださいっ!!!
まずは登録からお願いします!!!
「7つじゃなくてもっと深く教えろ!」
「ジェフ・ベゾスより髪が薄いって本当?(2回目」
など、ご質問やご意見・ツッコミなどいただけますとモチベーションが爆上がりします!
本日もお疲れ様でした。
明日も頑張って生きていきましょう。