
VRChatで、『どうぶつタワーバトル』のコピーゲームを作りました。
基本的なルールは本家と完全に一緒ですが、操作はワンボタンで、どうぶつは盤面上部を左右に動き、Useを押すと位置が固定されて回転を始めます。
Useを離すと、その角度で落下します。
画像ではAstraくんお手製のクールなどうぶつですが、どうぶつはちゃんと差し替えられます。差し替えたバージョンがカエルの森にあると思うので遊びに来てね。
開発のきっかけ&制作方針
開発のきっかけは所属してるイベントのオーナーさんに「なんか『どうぶつタワーバトル』とかあったら面白そう!」とかやや適当に投げられたのが始まりです。
先行実装があることは知っていたので、割と作るだけではあったんですが、向こうがそれ単品のワールドであるのに対して、うちはこれがサブコンテンツの1つでしかないイベントです。そのまま移植してはまあ問題があるだろうと感じていました。
特に危惧していたのが、これ以上イベントにObjectSyncが増えることでした。すでに森には大量のPickUpオブジェクトで溢れています。
先人に倣い物体の位置・回転をそれぞれObjectSyncで送り続ける方式だと、積み上がるほど更新対象が増えます。
そこで、位置を送り続ける代わりに、各クライアントで同じ物理演算を再生する方針にしました。同期するのは主に「何を、どこから、いつ落としたか」というイベントと、手番の終わりに確定した盤面状態のチェックポイントです。
この方針を実現するために、決定論的な物理演算が必要になりました。
当然Udonでこんなことをやると実行速度が足りないので、整数ベースの物理計算をGPUに載せて実行する仕組みを作りました。
この記事では、同期設計、GPUでの整数計算、衝突の並列処理、最適化などを紹介します。
実装はほとんどGPT-6 Astraにお願いしています。
僕たちはAIの奴隷。
開発・確認環境
開発・確認環境はUnity 2022.3.22f1、VRChat Worlds SDK 3.10.5、Direct3D 11、RTX 3070 Tiです。
最大どうぶつ64体、60tick/秒、1tickあたり衝突解決16反復を想定しています。
現在できているのは、各クライアントが落下入力をもとに盤面を計算し、手番ごとに確定状態を受け取って揃え直す仕組みです。
異なるGPU・ドライバ間での完全一致は検証できていないのですが、テストプレイではおおむね問題なさそうでした。
設計方針
入力とスナップショットのみ同期する
よくある物理演算の同期実装では、オブジェクトオーナーのクライアントでのみRigidbodyによる物理演算を行い、結果としての位置や回転を他のプレイヤーに送る、なんてのが思い浮かびます。
今回の方式では、まず全員が同じ確定済みの盤面を持ち、次の落下入力を受け取ったら、それぞれの環境で盤面を計算します。
【位置・回転を継続同期する方式】
オーナーで物理計算
     ↓
物体ごとの位置・回転を繰り返し送信
     ↓
他クライアントで表示

【今回の方式】
確定済み盤面を共有
     ↓
種類・落下位置・角度・開始時刻を共有
     ↓
各クライアントで同じtickの物理を計算
     ↓
手番終了時の確定状態を共有し、次の手の起点にする
スナップショットをわざわざ作ってるのは、イベントの送受信にラグがあるので、落下の開始時刻をもらってもその時刻の演算からやり直せなくなっちゃうからです。
ここなんかいい感じに解決する方法があればもっと全体の同期量は減るはずです。
この方式で重要なのは、わずかな計算誤差が、その後の盤面全体の違いにつながることです。バタフライエフェクトってやつですね。
接触位置が少しずれるだけで、あるクライアントでは倒れ、別のクライアントでは倒れない、みたいなことが起きえます。
環境によらず同じ物理演算を実行できる必要があります。
更新タイミングの統一
「同じ物理演算」のために、物理の刻みは60tick/秒で固定しています。
落下開始時刻を共有し、サーバー時刻から目標tickを求めます。
目標tick = 経過ミリ秒 × 60 ÷ 1000
描画フレームレートが異なっても、物理の1tickの計算は同じになります。
処理が追いつかない場合は、フレームごとの実行上限内で目標tickまで進めます。
描画のみ前後の物理状態を補間して使うようにします。
手番ごとのスナップショット
先述の通り同じ計算を目指すだけでなく、手番の終了時にはオーナーが確定した盤面を全員に共有します。
1体あたりの確定状態は8整数です。
位置X・位置Y・角度・種類
速度X・速度Y・角速度・静止状態
最大64体なら8 × 64 = 512整数で、値そのものは2,048バイト(2 KiB)。これにプラスして手番や時刻などの情報をイベントとして投げます。
ただ、この8整数だけではすべての盤面状態を再現できません。あくまで静止状態の盤面だけです。
このゲームのルールによって、新しい手は静止した盤面から始まることが確約されてるのでこれで十分なわけです。
受信側のtickがまだ終了tickに達していなかったり、すでに追い越していたりしても、このスナップショットを適用します。
スナップショットを採用したことで、完全に同じ物理を計算し続けられることをまだ実証できていなくても、手番の境界で次の盤面の起点を合わせられるようになってます。
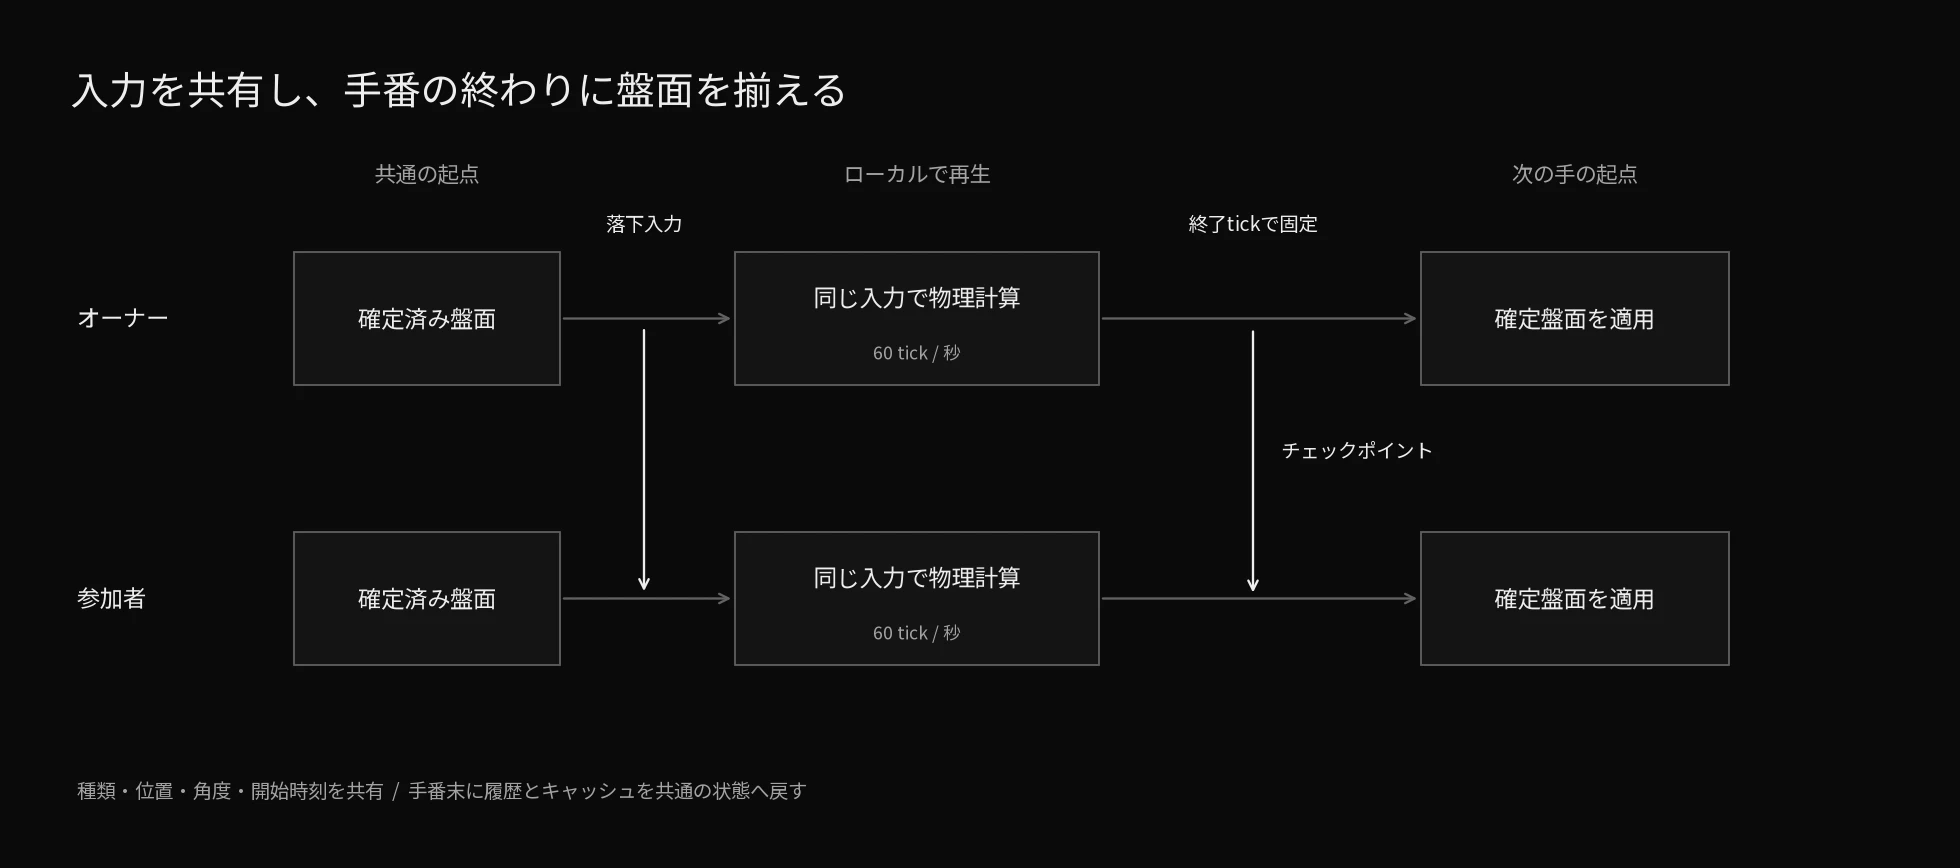
Codexが作った図、って感じの図
GPUで(なるべく)誤差なく計算する
物理エンジンをGPU計算にする
最大64体のどうぶつが、それぞれ複数の凸形状(凹形状は凸に分割)で接触する処理をGPUに移しました。
VRChatからVRCGraphics.Blitと複数パスのシェーダーを呼び出し、RenderTextureを計算用の配列として使うGPGPUです。
Udon側にはtick管理、シェーダー呼び出し、同期の仕事を残し、物理状態の更新と描画はGPU側で行います。
描画はGPU上の状態を直接参照するため、どうぶつ64体のTransformをUdonから毎フレーム更新する構成ではありません。
整数ベースの固定小数点を使う
物理の主要な状態や接触計算には整数を使い、丸め方も揃えています。
| 対象 | 表現 | 1.0を表す整数 |
|---|---|---|
| 位置・形状頂点 | Q12(小数部12bit) | 4,096 |
| 並進速度・角速度 | Q20(小数部20bit) | 1,048,576 |
| 姿勢の角度 | 1周を65,536分割 | — |
| 三角関数 | 4,096段階の事前計算テーブル | — |
例えばQ12なら、1.5は1.5 × 4,096 = 6,144という整数で持ちます。
速度をQ20にしているのは、わりとなんとなくです。
速度を位置に反映する際にQ12へ整数除算で変換してるので微小速度を保持していてもあんま意味ないような気もしてきたな。
三角関数は実行時のsin・cosの代わりに、Editorで作った共通テーブルを参照してます。こういう手法は本当に知らないとできないのでAstraくんありがとう。
角度は1周65,536刻みで保存し、テーブル参照時には上位12bitを使います。
Astra君曰く、
また、積や除算では、整数を使うだけで決定論が保証されるわけではありません。負数の整数除算の丸め、演算途中のオーバーフロー、同じ順序での加算、GPUの実行環境なども考慮する必要があります。接触応答では途中値が大きくなるため、演算を分割する補助関数も用意しました。
らしいです。そんなことまで勝手にやってくれてたのか。ありがとう。
結果RenderTextureはARGBFloat
計算の中身は整数ベースでも、データを受け渡すRenderTextureはARGBFloatになってます。
RGBAの各チャンネルは32bit浮動小数点ですが、単精度floatで整数を正確に表せる範囲に保存値を制限しています。
例えば状態テクスチャは64 × 4画素で、横方向が物体ID、縦方向が状態の種類です。
| 行 | 入っている情報 |
|---|---|
| 0 | 位置X・位置Y・角度・種類 |
| 1 | 速度X・速度Y・角速度・静止状態 |
| 2 | tick開始時の姿勢・静止判定の履歴 |
| 3 | 前の反復の姿勢・キャッシュ用フラグ |
1画素にRGBAの4成分があるので、1体につき4画素・16成分です。テクスチャ1枚の画素データは4 KiB。計算時は画素座標を直接指定するLoadを使い、フィルタリングやsRGB変換などを計算経路に入れません。
32bitの値をすべて1チャンネルへ整数として格納できるわけではないため、ハッシュは16bitずつに分割しています。

GPUでの衝突判定と解決
1tickを複数パスに分ける
CPU上の物理演算と違って、GPUでは「接触した2体をその場で直接書き換える」みたいな設計が取りにくくなります。
複数の接触ペアが同じ物体に同時に補正を書き込むと、書き込み順序が結果に影響しかねないからです。
そこで、次のように仕事を分けてます。
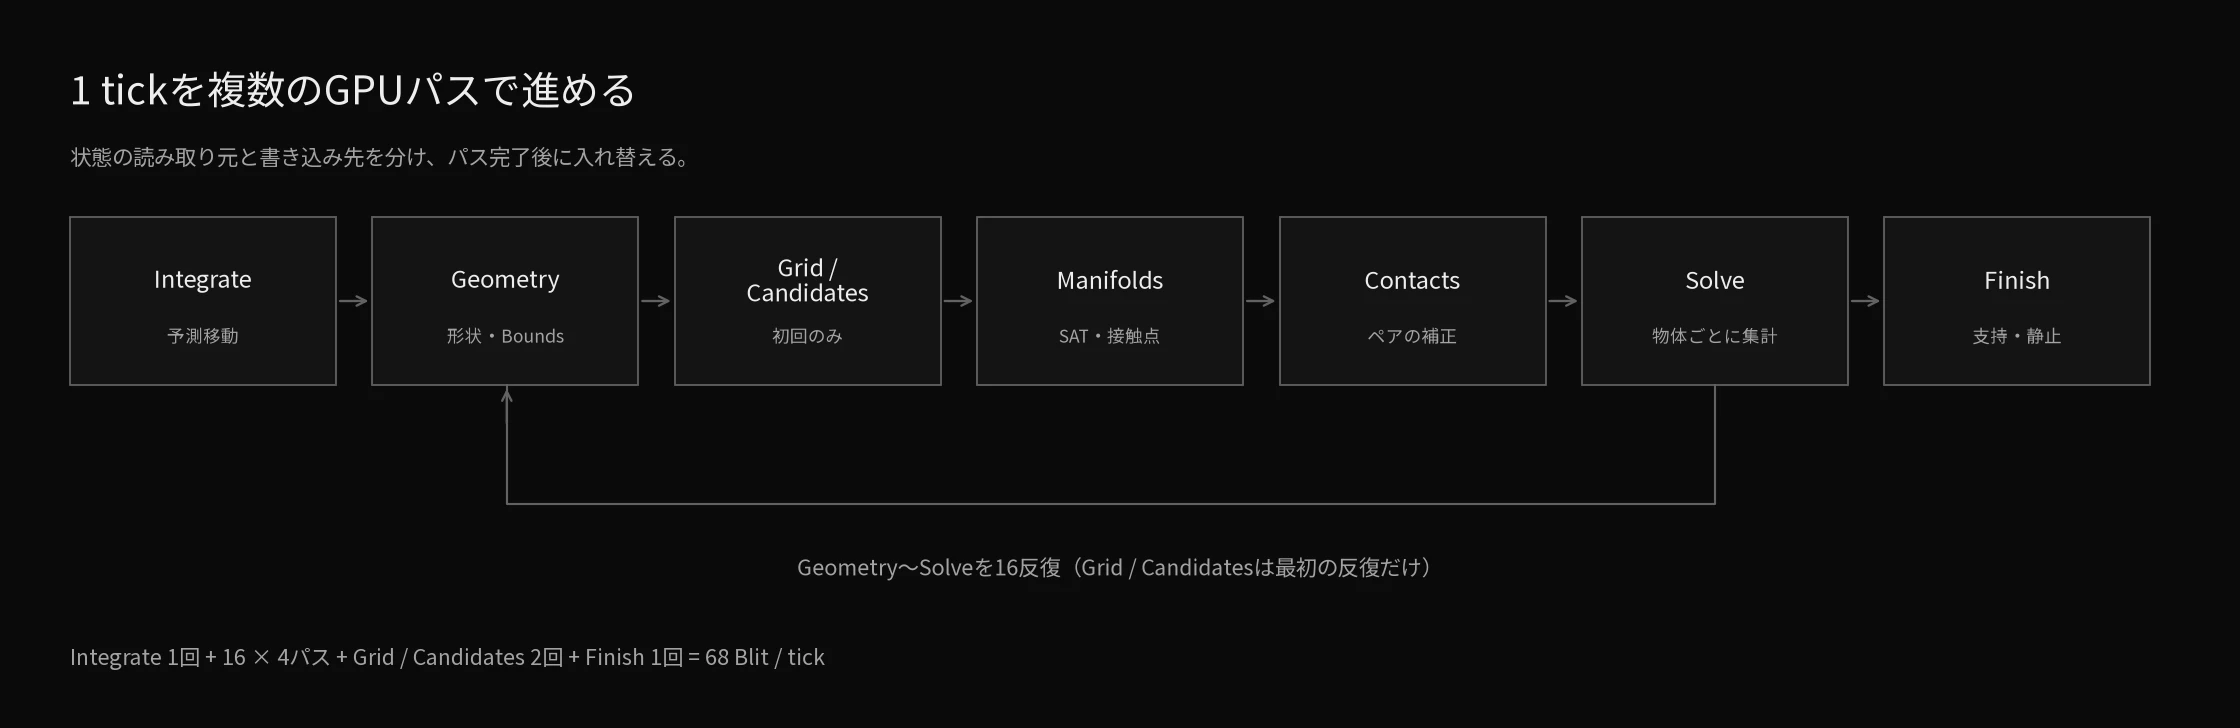
すべての物体が同じ更新前の状態を読めることが重要なので、状態を書き換えるときには読み取り元と書き込み先のテクスチャを分け、パス完了後に入れ替えます。
SATの前に接触候補を絞る
どうぶつは複数の凸パーツからできており、凸多角形同士の判定にSAT(分離軸定理)を使っています。なんかGPUに向いてる方式らしいです。
SAT自体を全パーツの全組み合わせに適用すると無駄が多いため、先に候補を絞ります。
空間グリッド
    ↓
外接半径による粗い判定
    ↓
凸パーツのBounds
    ↓
SAT(必要な組み合わせだけ)
今回のグリッドは16×16セルにしました。
各セルに64体分の所属情報を16bitマスク4本で保存し、候補数と物体IDを求めます。
グリッドを毎反復作り直すのではなく、tickの最初に作って16反復で使い回しています。
代わりに、各反復の位置補正には上限を設け、探索範囲にも16反復分の動きを見込んだ余裕を加えています。
Manifoldsパスでは、ジオメトリシェーダーで候補領域を生成し、候補のない物体ペアに対するフラグメント処理を減らしています。
開発初期の8反復版では、64体を同時に出す同じ配置を使い、次の順に改善しました。
| 段階 | 主な変更 | GPU中央値/tick |
|---|---|---|
| 当初のGPU版 | 大まかな枝刈りはあるが、物体の全ペアを走査 | 1.430 ms |
| 回転形状のキャッシュ | 頂点・法線の変換を外へ出し、凸パーツのBoundsを追加 | 0.873 ms |
| 空間分割 | グリッドから接触候補を列挙 | 0.818 ms |
| SAT結果の共有 | 同じ凸パーツペアの判定を最大4回から1回へ削減。候補タイルの描画と投影結果の再利用も追加 | 0.332 ms |
RTX 3070 Ti/D3D11/ClientSim、各120tick×3回、1描画フレームにつき1tick、フレーム上限なしでの測定。
まったく成果物を見ずに、途中までゴリゴリ回していたところ、普通に動物が貫通するケースがあったので、16反復へと切り替えています。
接触の検出結果は一度バッファに出す
SATではA・Bの各辺の法線を分離軸候補として調べ、めり込みが最小となる軸を選びます。接触点は、その軸に沿う支持位置と接線方向の重なりを使い、凸パーツのペアにつき代表点を1つ求めています。
その結果をManifoldsに保存します。
接触軸コード / めり込み量 / 接触点X / 接触点Y
軸コードは形状データ中の法線を指す番号なので、法線ベクトルそのものを保存せずに済みます。
接触点は、片方の物体の重心を原点にした相対座標になっています。
その後、Contactsパスで接触点の相対速度、回転による速度、有効逆質量、法線方向の力積、摩擦、めり込みを解消する位置補正を計算します。台は逆質量・逆慣性を0として扱います。
最後に物体ごとに補正を集計する
例えばAとB、BとCが同時に接触しているとき、Bには2組の接触から補正が届きます。
 A ──接触AB── B ──接触BC── C
          ↓               ↓
       ペアABの補正     ペアBCの補正
          └──────┬────────┘
                 ↓
          Bの補正を集計
                 ↓
          次の状態へ書き込み
Solveパスは物体IDごとに並列実行し、該当する補正を固定順序で集計して次の状態へ反映します。共有状態に対する競合書き込みを避けると同時に、演算順序も揃えるためです。
1つの物体ペアに複数の凸パーツの接触がある場合はパーツ接触の補正を平均し、さらにSolve側でその物体に接触しているペアの補正を平均します。接触解決はこれを16反復します。
1段目は「同じ2体の間に何個の凸パーツ接触があるか」、2段目は「その物体が何体と接触しているか」で補正を正規化します。例えばAとBの間に4個のパーツ接触があっても、Bから来る補正を4倍の重みでそのまま加える形にはなりません。接触ごとに求めた補正を平均し、固定回数の反復で解き直す構成です。
平均化による、接触が増えたときの収束がネックです。
静止状態とする判定を緩めにとることで覆い隠しています。
Spriteから物理形状の自動生成
どうぶつの当たり判定を手作業で用意するのではなく、Editorで透過Spriteから凸パーツを生成しています。
画像を差し替えても、同じ工程で物理形状と表示データを再生成できます。
輪郭取得・初期簡略化
       ↓
通常の凸分割(Q12頂点・1パーツ最大8頂点)
       ├─ 16パーツ以内 → 採用
       └─ 16パーツ超過、かつアルファ輪郭
                  ↓
          形状を変えない対角線分割も試す
                  ↓ 収まらない場合
          許容誤差内で輪郭を簡略化し、凸分割を再試行
                  ↓
          16パーツ以内の候補を採用
       ↓
重心・慣性を計算し、重心基準へ移動
       ↓
法線とともにGPU用テクスチャへ保存
輪郭はアルファ値から抽出してます。アルファ解析用の画像は長辺最大512画素に縮小します。抽出直後の頂点が多すぎる場合も、入力上限を検査する前に輪郭の簡略化を試します。
通常の分割では、一時的なPolygonCollider2Dから生成したMeshを三角形へ分け、頂点をQ12へ量子化します。面積ゼロの三角形を除き、反時計回りに向きを揃え、隣接するパーツを凸性と8頂点の上限を確認しながら結合します。すでに上限内の凸パーツに分かれていて互いに重ならない入力は、そのまま使います。
パーツ数の最適化
アルファ輪郭によるとりあえずの分割で16パーツを超えたときだけ、追加の簡略化と独自の凸分割を試すようにしています。
独自の分割では、凹んだ頂点から輪郭の内側に引ける対角線を探し、少ない凸パーツに分かれる候補を調べます。外周・穴・離れた島の包含関係も扱い、穴にあたる部分を凸パーツから切り抜きます。
輪郭を変えない分割で収まらなければ、輪郭の頂点数の目標を段階的に下げて再試行します。小さな角から順に頂点を取り除きますが、元の輪郭からの距離と累積面積変化を制限し、新しい辺の交差や、穴・別の島をまたいで消してしまう変更も検査します。
穴を切り抜いた交点をQ12格子へ戻す際は、隣のパーツへはみ出さないよう元パーツの内側に丸めます。
距離と面積の制約内で上限へ収まらなければ、ベイクはエラーにします。必要に応じて許容誤差や輪郭を調整します。
透過画像のベイク例
以下は800×800の透過画像を使った例です。標準設定では16パーツ以内に収まらなかったため、上記調整を適用しました。この設定で、通常の凸分割28パーツから15パーツ・合計72頂点へ収まりました。
| 入力画像 | 通常の凸分割 | 自動調整後 | 合計頂点数 |
|---|---|---|---|
| 800×800 | 28パーツ | 15パーツ | 72 |
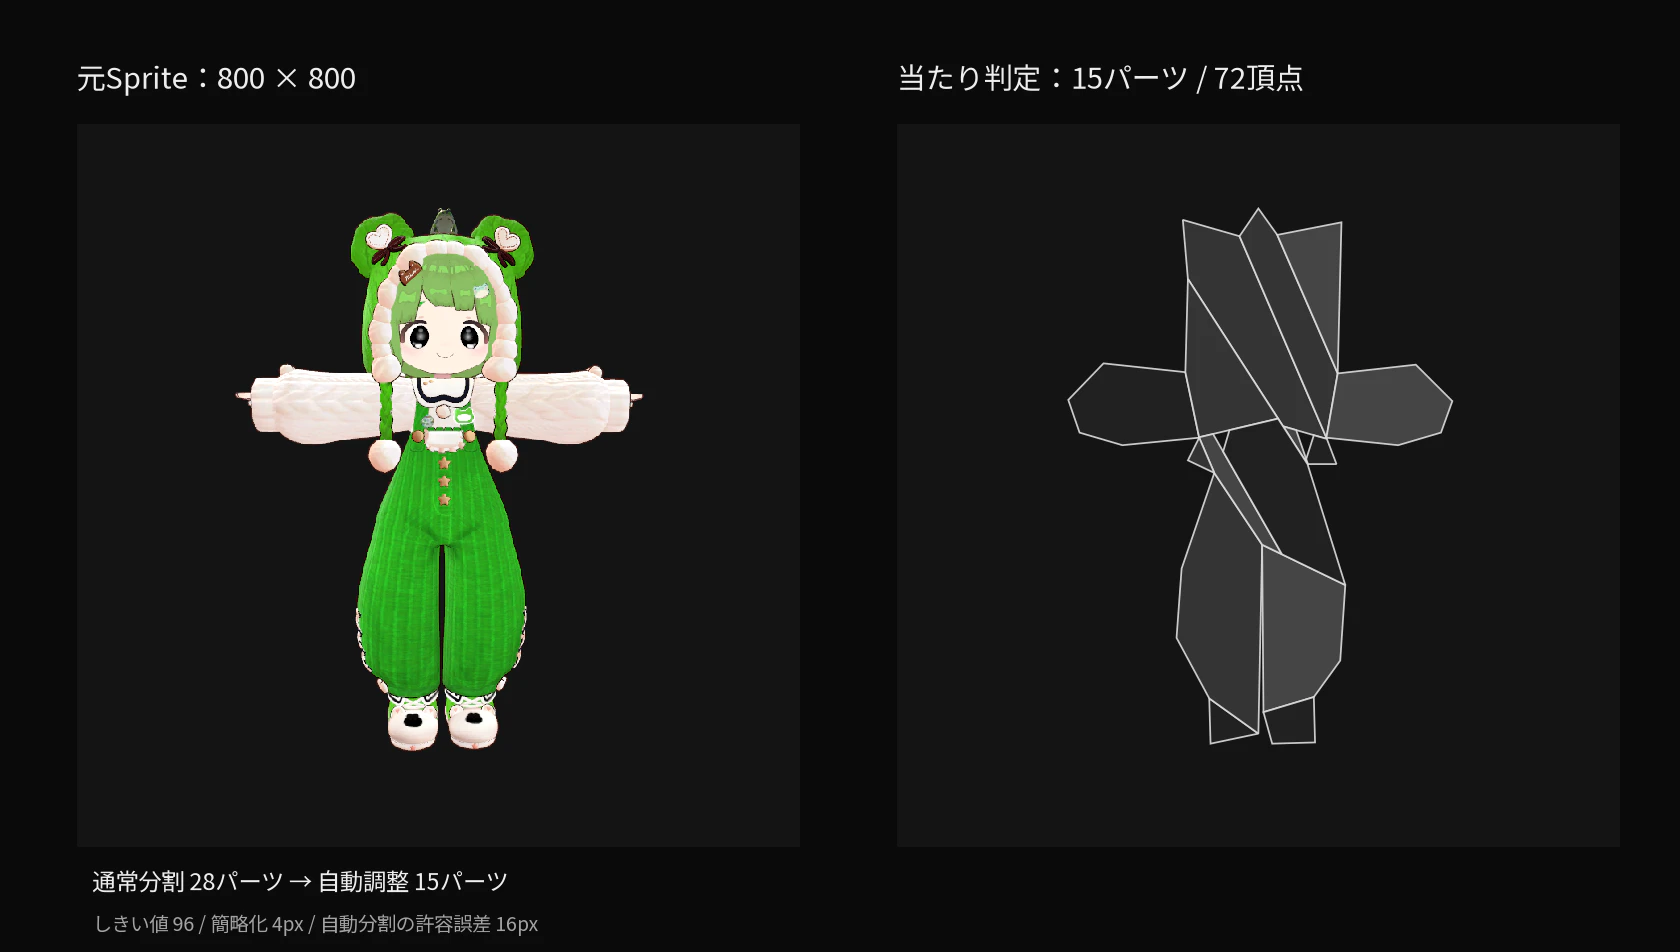
画像の色や解像度を保ち、当たり判定の細かい凹凸を近似しています。図はこの画像・この設定のベイク結果です。
生成した各パーツが凸で8頂点以下になっていることと、パーツ同士に重なりがないことを確認しました。穴・離れた島・穴の中の島を含む形状については、別の検証ケースでも確認しています。
重心もベイクする
SpriteのPivotをそのまま物理的な中心にはせず、形状内部に質量が一様に分布すると仮定して重心と慣性を求め、形状と画像表示の両方を同じ重心基準に揃えています。
最終的な形状、逆質量、逆慣性、外接半径、各頂点・法線などはShapesテクスチャに保存します。回転用のsin・cosテーブル、表示矩形、SpriteアトラスもEditorでまとめて生成します。
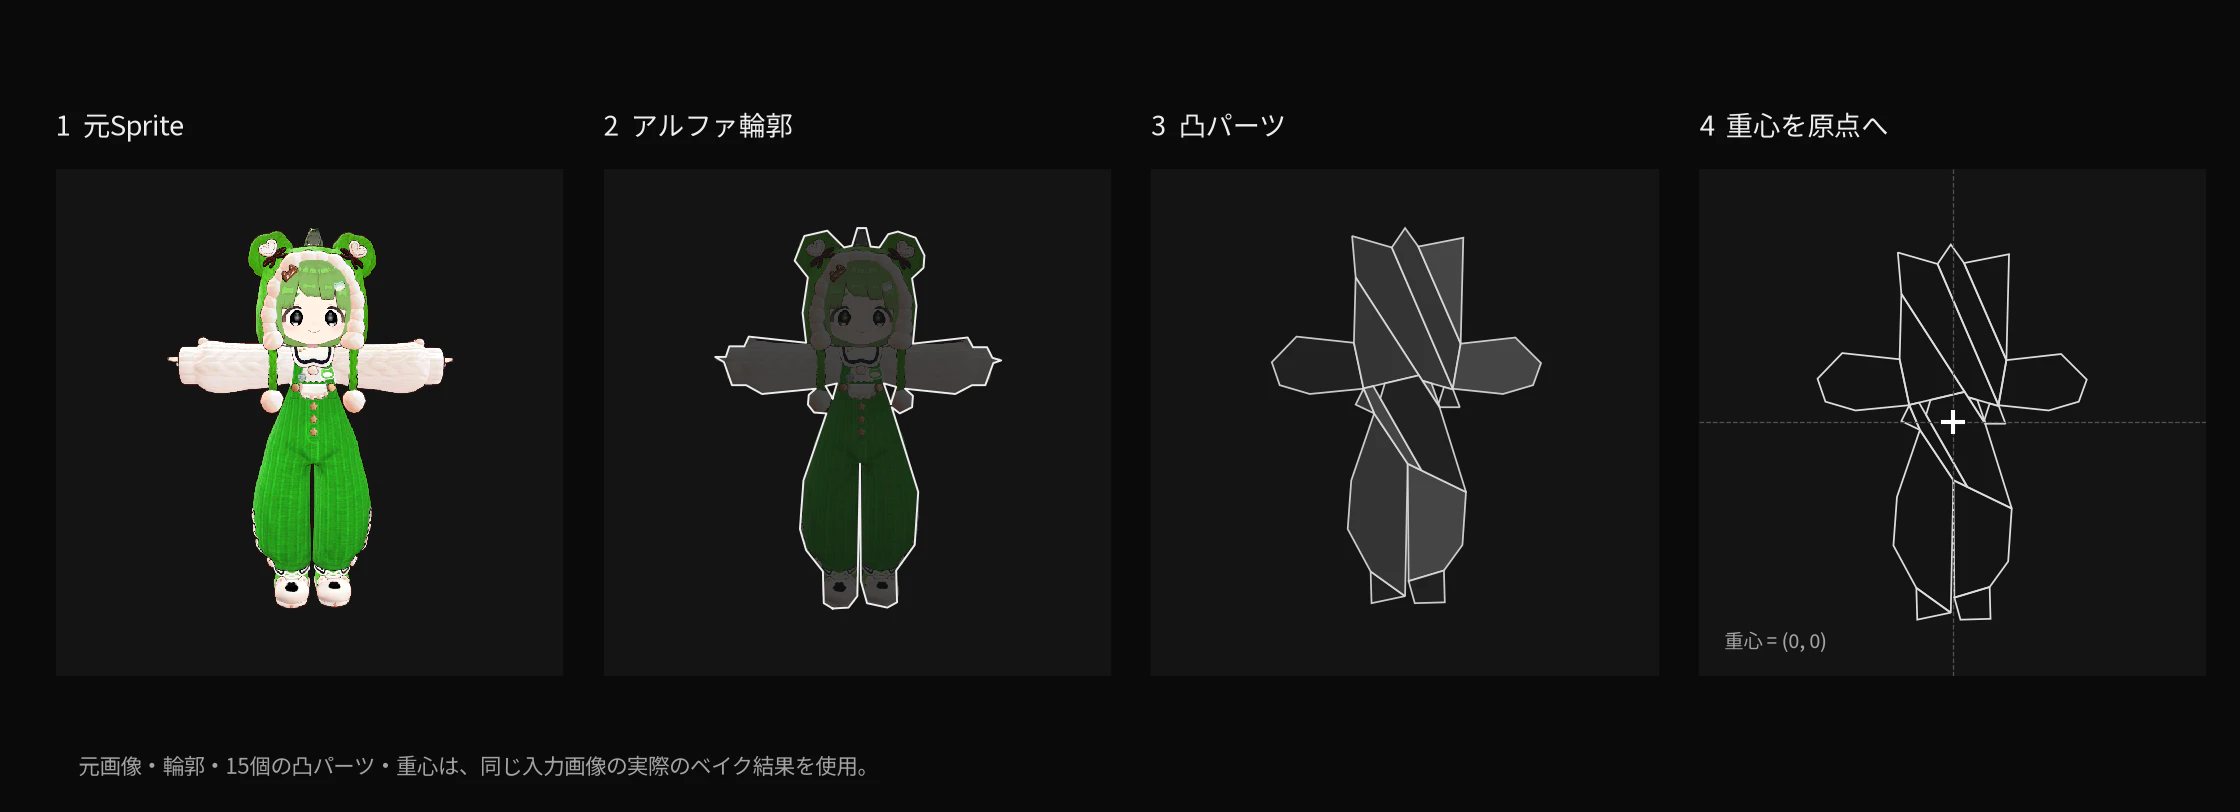
同じ800×800画像の元Sprite・アルファ輪郭・凸パーツ・重心を並べています。重心は、採用した最終形状から計算しています。
Editorでは画像の一覧から登録し、幅・高さ・重さを変更しながら、台との大きさや凸パーツをプレビューできます。プレビューで採用した分割済み輪郭を本番ベイクへ引き継ぎ、同じ形状をゲームへ反映できるようにしています。
まとめ
VRChatで盤面の継続的な同期を減らすために、入力から盤面を再生する設計を取り、整数ベースのGPU物理をBlitとRenderTextureで実装しました。
ぶっちゃけほぼAI丸投げではあります。
自分の理解のための整理と、類似の実装で困っている方の助けとなればと思い執筆しました。(文章もほぼAIなんですが)
詳しい負荷などをこれからイベント本番で計測していくつもりなのですが、すでに静止判定が正常に動作しないなど、もしかしたらまだ運用段階にないものになってる可能性があります。ひーん。
付録:実装を読む人向けのデータ配置メモ
ここからは、本文の流れを優先して省略した、RenderTextureの配置や計算ルールの概要です。再実装の仕様書ではなく、構成を把握するためのメモです。
主な実行時テクスチャ
N = 64は最大物体数、Hは1種類の最大凸パーツ数(現在のベイク済みMaterialではH = 8、上限16)です。すべてARGBFloatです。
| 名前 | サイズ(幅×高さ) | 主な役割 |
|---|---|---|
state/_other/_snapshot
|
64×4 | 現在状態・更新先・確定用コピー |
_geometry |
256×65 | 64体と台の回転済み形状 |
_grid |
16×16 | セルごとの64体ビットマスク |
_candidates |
64×5 | 物体ごとの接触候補 |
_manifolds |
(64×H)×(65×H)、現在512×520 | 凸パーツ同士の接触結果 |
_pairs |
64×130 | 候補65枠×速度・位置補正の2種類 |
_summary |
2×1 | 終了判定とハッシュの集計 |
台はどうぶつ64体とは別の候補枠です。_geometryの65行目や、_manifolds・_pairsの65候補枠はそのためにあります。64体+台を「65体の動的物体」として扱っているわけではありません。
_manifoldsの座標は、物体AのIDをi、A側パーツ番号をp、候補順位をr、B側パーツ番号をqとして、x = i×H+p、y = r×H+qです。RGBAには接触軸コード、めり込み量、接触点X/Yを保存します。
_pairsは、x=物体ID、y=候補順位(0〜64)に速度補正を、y=65〜129に位置補正を保存します。速度補正はQ20、位置補正はQ12、角度補正の内部値はQ12ラジアンです。
形状ベイク済みアセット
| アセット | 現在のサイズ | 役割 |
|---|---|---|
Shapes |
256×6(RGBAFloat) | 各どうぶつの凸形状と物性値 |
Trig |
4,096×1(RGBAFloat) | Q12化したsin/cosテーブル |
Visuals |
2×6(RGBAFloat) | 重心基準の表示矩形、アトラスUV |
Atlas |
1,024×1,024(RGBA32) | Sprite画像 |