

TL;DR: プロンプトエンジニアリングは死んでいない。ただ、AI作業の統制系「全体」ではなくなった。モデルが「答える」だけでなく「動く」ようになると、負荷はプロンプトの外側の構造 — スコープ、契約、メモリ、検証、ロールバック、承認 — に移る。この記事ではそれを ハーネス(harness) と呼ぶ。やっかいなのは、ハーネスには「置き場所」が要ること。チャット画面はその場所を持たないが、ファイル・フック・スキルレイヤーを持つCLIエージェントは持っている。残る問いは、チャットUIがいずれその足場を獲得できるのか、それとも構造的に向いていないのか、だ。
まず、この記事で言いたい「実務上の結論」を先に置いておく。エージェント時代に「良い依頼」を出すというのは、説得的な長文プロンプトを書くことではなく、次のチェックリストを埋めることに近づいていく。
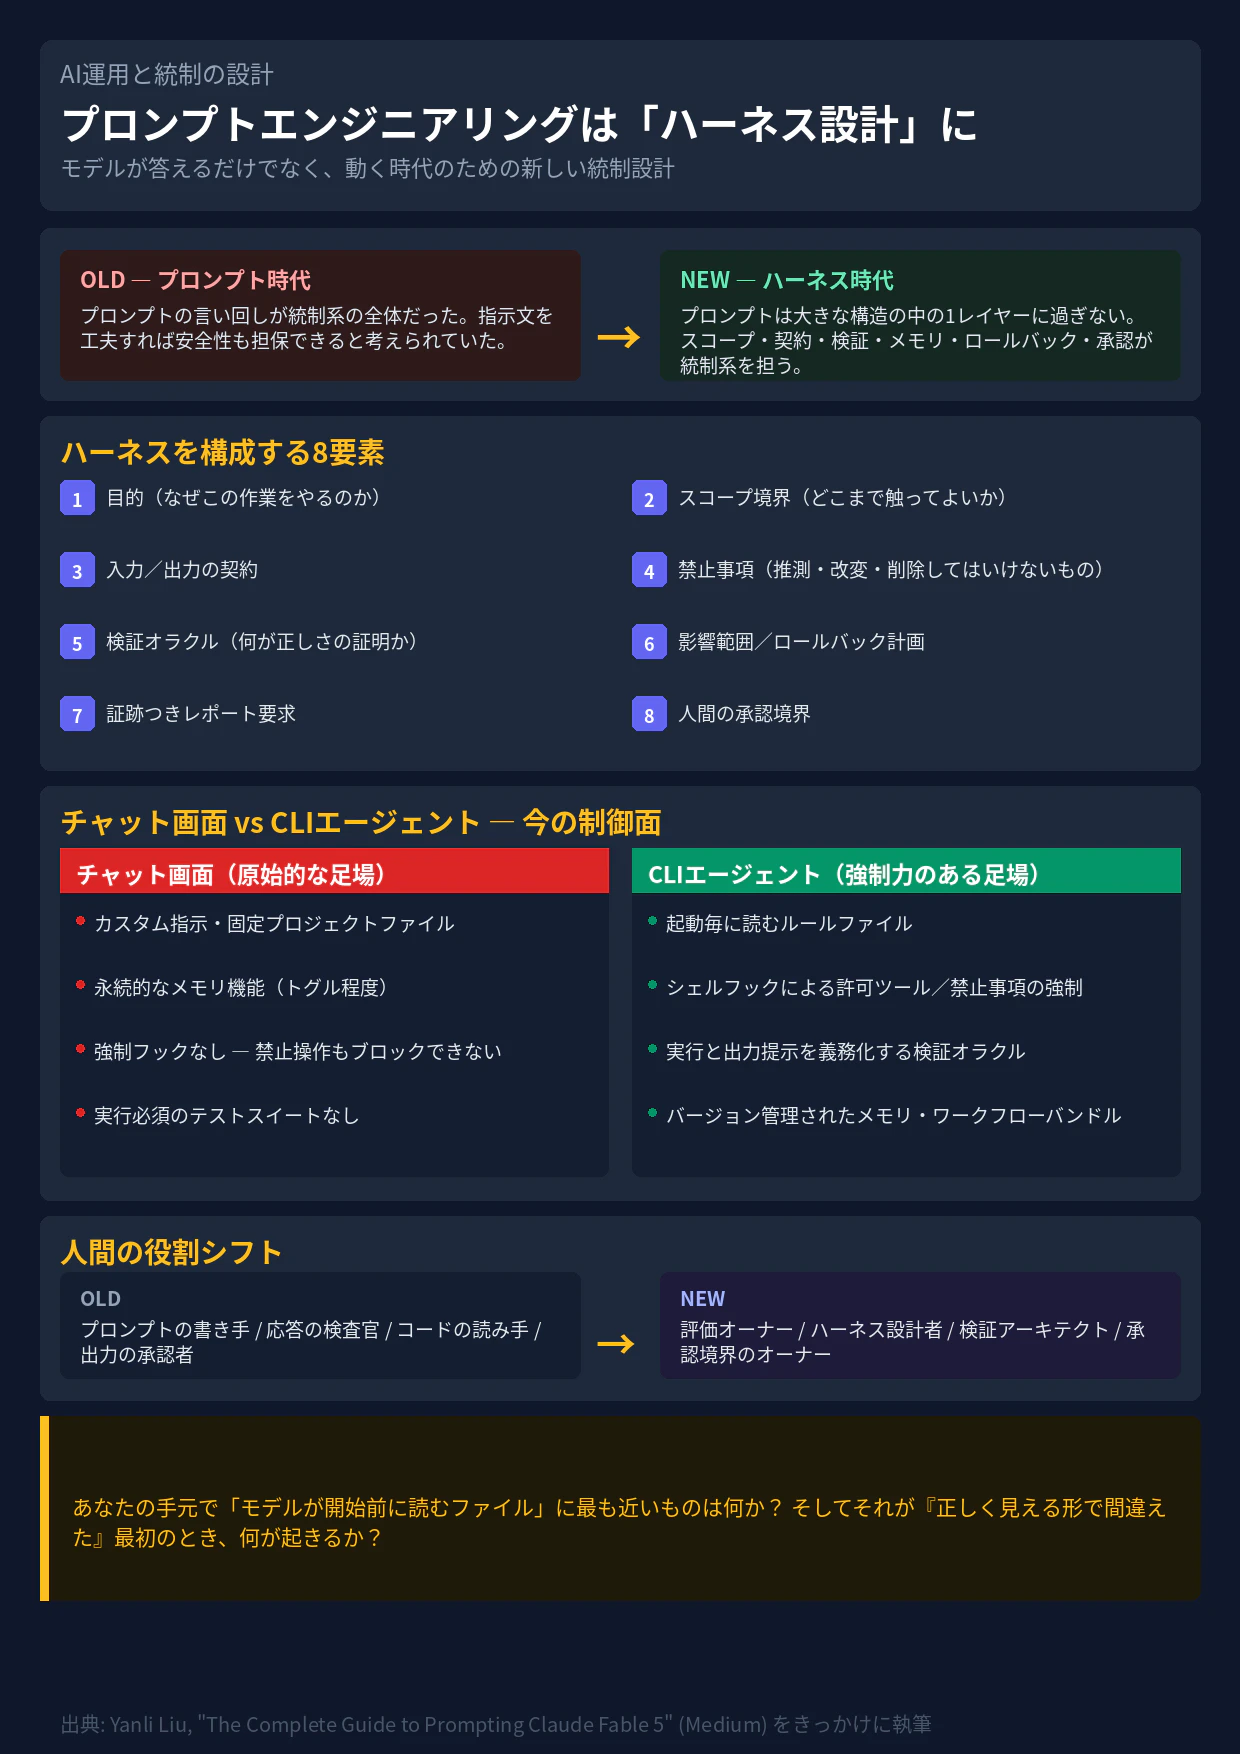
1. 目的(なぜやるか)
2. スコープ境界(どこまで触ってよいか)
3. 入力/出力の契約(何を受け取り、何を返すか)
4. 禁止事項(推測・改変・削除してはいけないもの)
5. 検証オラクル(何が通れば「正しい」と言えるか)
6. 影響範囲/ロールバック(間違えたらどこまで波及し、どう戻すか)
7. 証跡つきレポート(作業が実際に行われた証拠)
8. 承認境界(誰がどの証拠で「完了」と言えるか)
以下は、なぜこのチェックリストが「良いプロンプトを書く技術」より効くようになったのか、という話だ。
プロンプト時代は「言い回し」への過集中を訓練した
ここ数年、AIをうまく使うということは、しばしば「より良いプロンプトを書く」ことを意味していた。
ペルソナを足す。「あなたは世界一流の専門家です」と言わせる。「ステップバイステップで考えて」と頼む。ルール・優先順位・禁止事項を並べた長い指示ファイルを書く。言い回しの小さな違いが回答の質を目に見えて変えたので、みんなが最適化する対象は「言い回し」になった。
これは不合理ではなかった。プロンプトエンジニアリングは、チャット時代の操作インターフェースそのものだったからだ。
AI作業の単位が「チャット画面上の1回の応答」だったとき、プロンプトはほぼ全部を背負っていた — 目的、文脈、トーン、手順、制約、期待する出力形式。答えが間違っていたら、自然な対処は「プロンプトを直す」ことだった。
でもこの習慣は、静かに罠になりうる。指示の言い回しそのものを安全装置だと扱うようになる — ルールを増やし、例を増やし、ロールプレイを増やし、警告を増やし、手順スクリプトを増やす。モデルが「テキストを生成するだけ」なら、これはそこそこ機能する。
モデルが「動き始める」と、途端に弱くなる。
エージェント能力の高いモデルは、失敗の形を変える
エージェント時代の問題は「どうすれば良い答えが得られるか」だけではない。「ツールを使い、ファイルを編集し、リポジトリを検索し、APIを叩き、進捗を報告するモデルに、スコープ・証拠・責任の統制を失わずに作業させるにはどうするか」だ。
これは別種の失敗モードだ。弱いチャットモデルは「悪い答えを返す」ことで失敗し、こちらはすぐ気づく。強いエージェントは「やりすぎる」ことで失敗し、しばらく気づかないことがある。
- 誰も触れと言っていないファイルを触る
- 誤った前提を、1ステップではなく5ステップ横断して引きずる
- コマンドを実行していないのに「検証が通った」と報告する
- 又聞きのブログ記事を読み、3段落後にはその主張を静かに「事実」に格上げする
どれも「悪い答え」には見えない。進捗に見える。
この環境では、「もっと長いプロンプトを書く」は答えにならない。むしろ逆効果になりうる — 経路を過剰にスクリプト化する一方で、肝心の受け入れ条件は曖昧なまま残る。結果、エージェントは指示の「文字」には従い、本当に大事だった「境界」を外す。
問いの形が変わる。
✕ どうすればモデルにもっと良く答えさせられるか?
○ このエージェントの作業を、安全に「受理/却下」できる運用境界は何か?
「依頼を言葉にする」から「境界を設計する」へ — このシフトが、この記事の言う ハーネス設計 だ。
プロンプトが死んだわけではない
「プロンプトエンジニアリングは死んだ」と言うのは単純化しすぎだ。指示は依然として重要だし、文脈も重要だ。曖昧な依頼は今も曖昧な仕事を生むし、雑な指示は今も実害を生む。
変わったのは、プロンプトがもはや統制系の「全体」ではなくなったこと。
プロンプトは「出力」を求める。ハーネスは「その出力を信頼してよい条件」を定義する。エージェントの作業が実際に走る、周辺構造を含む概念だ。
| 要素 | 問い |
|---|---|
| 目的と理由 | なぜこの作業をやるのか |
| スコープ境界 | どこまで触ってよいか |
| 入力契約 | 何を受け取るか |
| 出力契約 | 何を返さねばならないか |
| 禁止事項 | 何をしてはいけないか |
| 許可ツール/権限 | 何を使ってよいか |
| メモリ境界 | 何を保持し、何を捨てるか |
| 検証オラクル | 何が「正しさ」の証明か |
| 証跡つき報告 | 作業が起きた証拠は何か |
| ロールバック境界 | 間違えたらどこまで波及し、どう戻すか |
| 人間の承認境界 | 誰が「完了」と言えるか |
チャットだけのワークフローでは、これらのいくつかは暗黙のままでも壊れない。エージェントのワークフローでは、エージェントが「正しく見える形で間違えた」瞬間に、その暗黙が初めてリスクに変わる。
エージェントが動けるなら、何を変えてよいかを誰かが決めないといけない。メモリを使えるなら、何が残り何が失効するかを誰かが決めないといけない。「検証が通った」と報告できるなら、何をもって証明とするかを誰かが決めないといけない。リポジトリを触れるなら、どのファイルがスコープ内で、どれが禁止で、どのチェックが結果を受理するかを誰かが決めないといけない。
ここで問われるスキルは「より良い指示を書くこと」ではない。その指示が走る『受け入れ環境』を定義することだ。
ハーネスには「置き場所」が要る — チャットはそれを与えない
抽象論としてハーネス設計を考えていると見落としやすいのがここだ。ハーネスは単なる考え方ではなく、成果物の集合 — ファイル、フック、チェック、メモリストア — であり、それらはターン間・セッション間でどこかに永続化されねばならない。
CLIのコーディングエージェントには、明確な置き場所がある。
- スコープ境界 → 起動のたびにエージェントが読むルールファイルに置ける
- 許可ツール/禁止事項 → 散文で「お願い」するのではなく、シェルフックで強制できる
- 検証オラクル → 実際のテストスイートやlintコマンドとして、実行と出力提示を義務化できる
- メモリ → 毎回ユーザーが打ち直す一段落ではなく、バージョン管理されたファイル群にできる
- 再利用可能な運用知識 → ワークフロー・ゲート・エージェント役割をまとめた「小さな社内ルールブック」に相当するものを、チャットログに埋もれさせず、ファイルシステム上の探索可能なバンドルとして置ける
素のチャット画面は、もっと薄い足場から始まる。カスタム指示と固定のプロジェクトファイルは、開始前にモデルに読ませる「実在する、ただし原始的な足場」を与えてくれる。足りないのは 強制(enforcement) だ。禁止された操作を実行前にブロックするフックは無いし、モデルに実行と出力提示を要求するテストスイートも無い。メモリは、存在する場合でも、たいていプラットフォームが後付けした機能であって、ユーザーが完全に制御しバージョン管理するストアではない。こうして強制されない契約や境界は、結局プロンプトの中で言い直すしかなく、その大半はセッション終了やコンテキストのロールオーバーで消える。
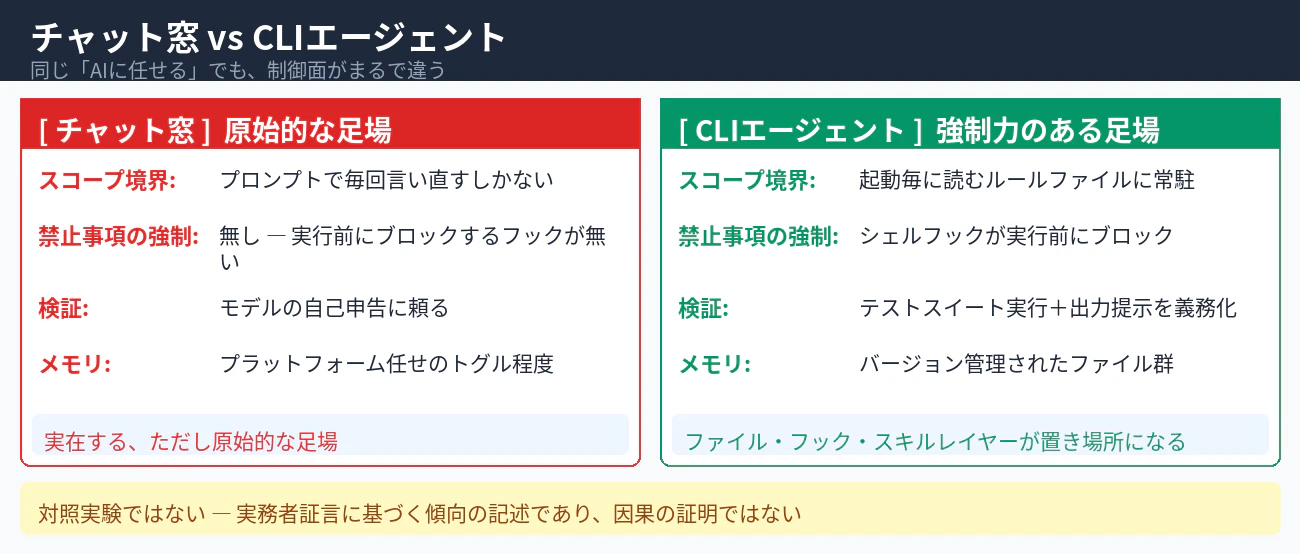
これは対照実験ではない。チャットUIのAIと、ファイル&フックのエージェントAIを、実務で厳密に比較した査読つき研究は存在しない — そう言い切るのは誠実さを欠く。
代わりに存在するのは、同じ方向を指す実務者の証言の山だ。チャットUIが特定のパターンで繰り返し失敗する描写 — すでに決めたことを見失う、一定ターンを超えると質が落ちる、同じ文脈を何度も説明し直させられる。別の角度からは、ファイルベースのエージェントを使う人たちが「チャット画面越しなら、そもそも着手すらしなかっただろう案件を拾えた」と報告する。毎回の文脈再説明のセットアップコストが、小さめのタスクを「やる価値なし」にしていたからだ。これは速度差の「証明」ではない。構造的な差が、なぜ速度差として現れうるのか、の妥当な説明だ。
より小さく具体的なインシデントも、同じ点を突く。ただしこれは上の「チャット対エージェント」比較の証拠ではなく、まったく別種の失敗モードだ — エージェントが「作業を永続化する場所」を持って初めて存在する種類の失敗である。
あるスケジュール実行の監視ジョブが、依存していた環境が静かにサポートを打ち切ったことで、無言のうちに無効化されていた。別のジョブは、その存在意義が「使用量上限の監視」でありながら、監視対象の上限そのものを自分で消費していた。
どちらの失敗もチャット画面は不要で、どちらも「誰も可視化していなかった依存を持つ永続プロセス」を必要とした。教訓はこの一件を超えて一般化する。エージェントが作業を永続化する場所を持った瞬間、ステートレスなチャットセッションが決して直面しない失敗のクラスが生まれる。そしてそれを捕まえるには、何が動いていて、何に依存し、その依存が消えたら何が起きるかを可視化するハーネスが要る。
重心は「指示の質」から「検証の質」へ移る
実務上のルールはシンプルだ。
検証が先。実装は次。ピンポイントのコードリーディングは最後。
これは人間がコードを読むのをやめる、という意味ではない。行単位のレビューが、AI生成物のスケールにおける第一の安全機構にはなり得ない、という意味だ。ワーカーが巨大なdiffを出したとき、人間は全行を読むことで欠けた検証を確実に埋め合わせることはできない。エージェントが文書を要約したとき、人間は「慎重に聞こえる」からといって要約を受理できない。アシスタントがレポートを出したとき、文章への信頼は「作業が起きた証拠」ではない。
レビューはもっと早く始めないといけない。実装の前に — どんな入力を正確に受理するのか? どんな出力を正確に生成せねばならないのか? 何を推測・改変・削除・暗黙変更してはいけないのか? どのコマンド・ゴールデンケース・diffチェックが結果を受理可能と証明するのか? もし間違っていたら、被害はどこまで広がり、どう戻すのか?
ピンポイントのコードリーディングは依然として重要だ — ただ「狙いを定める」ようになる。人間は最もリスクの高い面に読解の注意を集中すべきだ — 認証、金銭、削除、外部呼び出し、データ露出、バリデータ、そしてまだテストが無いすべて。人間の最初の仕事は「全ステップを見張る」ことから、「最後に何が真でなければならないか、何が決して起きてはならないか、違反をどう捕まえるかを定義する」ことへ変わる。
メモリは制御面の一部だ
エージェントのワークフローは、メモリの目的も変える。
一発勝負のチャットでは、メモリはほぼ「便利さ」だ — 文脈の再入力を省いてくれる。エージェントのワークフローでは、メモリはハーネスそのものの一部になる。メモリを持たない強いエージェントは、毎回文脈の再構築に労力を浪費し、人間に同じ制約を繰り返し言わせる。だが 制御されていない メモリを持つ強いエージェントには、別の問題がある — 誤った前提を保存し、古いルールを新しいタスクに持ち込み、昨日の一時しのぎを今日の恒久ドクトリンとして静かに扱いうる。
つまりメモリには「存在」だけでなく「ガバナンス」が要る。何を覚えるべきか? 何を失効させるべきか? 何をタスクローカルに留めるべきか? 何を再利用前に人間の確認にかけるべきか? 何を「根拠なき信念」として保存せず「出典に紐づけて」引用すべきか?
メモリは自動的に善でも、自動的に危険でもない。制御面(control surface) であり、制御面にはルールが要る。
強いモデルは、統制の価値を下げるのではなく上げる
よくある誤りは「AIが強くなれば統制の必要は減る」と思い込むことだ。実際はたいてい逆になる。速く動き、より多くの文脈を保持し、より尤もらしい仕事を出すモデルこそ、境界が最も重要になる。リスクは「失敗すること」だけではないからだ。リスクは 『役に立つ形で』失敗すること にある — 取っておきたくなる程度に一貫した何かを生み、周囲の論旨にたまたま馴染む無根拠な主張をし、タスクに隣接して見えるファイルを更新し、表層的なチェックは通しつつ本当の受け入れ条件を外す。
だから強いエージェントは、人間の判断の必要を消さない。判断を適用すべき場所を動かすのだ。人間は行単位の検査官に矮小化されるべきではない — それは一定を超えるとスケールしない。だが人間は、エージェント自身の自己申告を受動的に承認するだけの存在にもなれない。人間は 評価関数のオーナー になる — 何を正しいとみなし、どんな証拠を受理し、どこでプロセスを止めて承認にかけるかを決める者だ。
人間の役割が変わる
かつての役割はこんな感じだった — プロンプトの書き手、応答の検査官、コードの読み手、出力の承認者。
新しい役割はこれに近い — 評価オーナー、ハーネス設計者、検証アーキテクト、承認境界のオーナー。
これはより高レベルな役割であって、より楽な役割ではない。人間に対して、正しさとは何か、何が禁止か、正しさをどうテストするか、どんな証拠を受理するか、誰が結果を信頼してよいか、を定義することを求める。これはソフトウェアに固有の話ではない。リサーチ、金融、出版、分析、法務、サポート — AIの出力が「他の誰かが行動する意思決定」に流れ込むあらゆる場所に当てはまる。
AIがより多くの出力を生めるようになると、希少資源は「出力」ではなく「信頼された受理」になる。誰が、どんな証拠で、どの境界の中で、間違っていた場合のどんなロールバック計画とともに、「この作業は本当に完了した」と言えるのか。それが今の本当のボトルネックだ。
実務ではどうなるか
強いエージェントへの実務的な応答は「もっと長いプロンプト」ではない。「より明確な契約」と「より良い検証ステップ」だ。
エージェント時代の「良い依頼」は、説得の段落ではなく、短いチェックリストの形に近づいていく(冒頭に置いたものを再掲する)。
1. 目的
2. スコープ境界
3. 入力/出力の契約
4. 禁止事項
5. 検証オラクル
6. 影響範囲/ロールバック
7. 証跡つきレポートの要求
8. 承認境界
これは巧妙なプロンプトよりロマンがない。だがより長持ちする。巧妙なプロンプトは「1つの答え」を改善できる。良いハーネスは「その後に来るすべて」の受け入れ条件を改善する — しかもプロンプトと違って、一度ファイルに書けば、打ち直さずに再利用できる。
プロンプトは生き残る。だが作業の単位が変わった
プロンプトエンジニアリングは死んでいない。だが作業の単位が変わり、プロンプトは今やより大きな何かの中の1レイヤーにすぎない — ツール、メモリ、スコープ、契約、バリデータ、レポート、ロールバック、承認。
チャット時代、AIが上手いとは「より良いプロンプトを書けること」だった。エージェント時代、それはますます「より良い運用境界を設計できること」を意味する — そして、いくつかのインターフェースが今なお、それらを置く堅牢で強制力のある場所を与えてくれない、と気づくことを含む。
素のチャット画面がいずれその足場を獲得できるのかは、本物の問いだ。そして正直な答えは「今ある証拠では決着しない」だ。ファイル&フックのエージェントがチャットUIより良い実世界の成果を出す、とは証明されていない — 誰も測っていない。観察できるのは、各インターフェースが今さらけ出している制御面の機能の差だ。エージェント環境はその面を増やし続けている — バージョン管理されたルールファイル、ワークフローとゲートの探索可能なバンドル、スキルレイヤー、操作を実行前にブロックするフック。チャットUIも、同じものへの最初の試みを足してきている — カスタム指示、永続的なプロジェクト文脈、メモリのトグル。何も無いのではなく、ハーネスの原始的な初期版だ。まだ無いのは強制だ — 禁止操作を実行前にブロックするフック、インターフェースが要求し出力を提示させるチェック。この差が機能の成熟とともに埋まるのか、それとも「モデルと1ターンずつ話す」ことの構造的限界なのかは、今決着させるより見守る価値がある。
もしあなた自身の作業が今なおチャット画面の中で完結しているなら、この問いのより身近な版はもっと小さい。あなたの手元で「モデルが開始前に読むファイル」に最も近いものは何か? そしてそれが『正しく見える形で間違えた』最初のとき、何が起きるか?
この記事は、Yanli Liu 氏の "The Complete Guide to Prompting Claude Fable 5"(Medium)をきっかけに書いた。取り上げているのは、その記事が描く一般的なシフト — プロンプトの言い回しから、運用境界の設計へ — であって、特定の製品仕様の主張ではない。モデル固有の詳細は、一次情報で独立に確認できない限り未検証として扱っている。