

はじめに
Claude Code や Codex のような AI エージェントを仕事で使っていると、同じモデルなのに「指示文を1行足しただけで急にうまくいく」「スキルを1つ作ったら失敗が消えた」という経験をよくします。モデルの性能だけでなく、モデルの周りに置く道具立てが結果を大きく左右するからです。
この道具立てを、最近は ハーネス(harness) と呼びます。システムプロンプト、守るべき決まり、スキル、補助スクリプト、サブエージェントなど、モデルを「仕事ができるエージェント」にするための仕組み全体のことです。
ただ、ハーネスの調整はたいてい人の手仕事です。失敗した実行ログを読み、勘で指示文を書き足し、もう一度試す。しかも新しい種類の仕事には 正解も採点基準もない ので、直した結果が本当に良くなったのか確かめにくいという問題があります。
2026年10月9日に Google Cloud AI Research などのチームが論文を公開した Harness²(ハーネス・スクエア) は、この調整を AI 自身に任せる枠組みです。コードも GitHub の google-research/harness2 で Apache 2.0 として公開されています。
まずは、何が変わるのかを図で見てください。左が人の手で直す従来の流れ、右が Harness² の流れです。

正解がなくても「直す前と後で実行がどう変わったか」は観察できます。Harness² はこの違いを証拠にして直し、直し方の経験まで次の仕事に持ち越します。
この記事では、Harness² の仕組みを初めての人にも分かるように順を追って説明し、論文の結果を整理したうえで、実際に手元の Mac(M5 Max)で動かした結果 を紹介します。公式の手順は Google Cloud(Vertex AI)の Gemini を前提にしていますが、今回は LM Studio のローカルモデル(Qwen3.8-27B)だけ で、実在のベンチマーク JobBench の課題を回してみました。
先に手元の結果を書いておくと、2問のうち1問目は元のハーネスの 57.6% から 81.8% に上がり、2問目は 36.7% から 20.0% に下がりました。点数の上下より印象的だったのは、AI が1問目で見つけた弱点(文書ごとに URL を勝手に作る)への直し方が、ライブラリを通じて2問目のハーネスにそのまま受け継がれたことです。詳しくは後半で紹介します。
この記事で分かること
- ハーネスの8つの部品と、Harness² がどこを書き換えるのか
- 正解なしで直すための「Propose → Probe → Compose」という1回の改善ステップ
- 経験を次の仕事に持ち越す「ライブラリ」の中身
- 論文の結果と、その読み方の注意点
- Mac で付属デモを動かす手順と、ローカルモデルだけで JobBench を回す方法・つまずきどころ
想定読者
AI エージェント(Claude Code、Codex、OpenCode など)を使ったことがあり、プロンプトやスキルを自分で調整した経験がある方を想定しています。Python の仮想環境を作ってコマンドを実行できれば、手元での再現も追えます。
この記事の確認範囲
- 確認日:2026年10月21〜22日
- リポジトリ:google-research/harness2 のコミット
1cfe254(2026年10月13日「Fix arXiv link」)、パッケージ版 0.1.0 - 論文:arXiv 2610.14224 v1(2026年10月9日投稿)
- 検証環境:MacBook Pro(Apple M5 Max、メモリ 128GB)、macOS 26.6.2、Python 3.12.15、uv 0.12.22、LM Studio(Qwen3.8-27B 4bit)
- 論文の数値は論文の表から引用しています。手元で測った数値は「手元の実測」と明記して区別します
ハーネスとは何か:8つの部品
Harness² の論文は、エージェントを「モデル+ハーネス」と捉えます。モデルの重み(学習済みのパラメータ)は一切変えず、周りのハーネスだけを書き換えて性能を上げる、という立場です。
Harness² が書き換えの対象にする部品は8つあります。どれも1つのファイルとして置かれるので、直した内容は「差分」として残り、あとから人が読んで確かめられます。
常時読み込まれる部品と、呼んだときだけ働く部品があります。Harness² の編集役は「常時の文章は毎回コストがかかる」と指示されています。
8つの部品と、実行時に効くタイミングを表にまとめます。
| 部品 | ファイル | 効くタイミング | 役割 |
|---|---|---|---|
| C1 システムプロンプト | systemprompt.md |
毎回 | 役割と全体の手順 |
| C2 ガードレール | guardrails.md |
毎回 | どんな仕事でも守る決まり |
| C3 メモリ | LongTermMEMORY.md |
毎回 | その分野の不変の事実 |
| C4 ツールの手引き | tool_descriptions/tool_guidance.md |
毎回 | 既存ツールをいつ・どう使うか |
| C5 サブエージェント | sub_agents/<名前>/AGENT.md |
task ツールで呼んだとき | 別の文脈で調べ、結果だけ返す |
| C6 スキル | skills/<名前>/SKILL.md |
skill ツールで呼んだとき | 専門の手順を必要なときだけ読む |
| C7 スクリプト | scripts/<名前>.py |
bash で実行したとき | 決まった処理を確実にこなす |
| C8 プラグイン | plugin/<名前>.ts |
ツール呼び出しのたび | モデルが飛ばせない処理を差し込む |
この表で大事なのは「いつ効くか」の列です。常時読み込まれる部品に文章を足すと、毎回の実行でモデルの文脈(コンテキスト)を圧迫します。リポジトリの編集役向けの指示(harness2/core/prompts.py)には、新しい手順はまず スキル、決まった処理は スクリプト、入力が大きく答えが小さい調べものは サブエージェント にする、という優先順位まで書かれています。
Claude Code を使っている方なら、CLAUDE.md・スキル・フック・サブエージェントを思い浮かべると近いイメージです。Harness² は、そうした部品を AI が自分で書き足したり書き換えたりする仕組みだと考えてください。
Harness² の全体像:2段の「再帰」
Harness² の名前の「²(2乗)」は、改善の輪が2段になっていることを表しています。
1つめの輪は タスク内の再帰(task-level recursion) です。今取り組んでいる仕事のために、ハーネスを試して直します。2つめの輪は ハーネス改善の再帰(harnessing-level recursion) です。直した経験を記録し、次の仕事で「どう直すか」を良くします。

モデルの重みも、各段階への指示文も固定です。変わるのは「この仕事のハーネス」と「編集役が読むライブラリ」の2つだけです。
ここで押さえておきたいのは、次の仕事のハーネスは毎回まっさらな初期状態(H0)から始まる という点です。前の仕事で直したハーネスをそのまま引き継ぐわけではありません。
論文は、前の仕事に合わせ込んだハーネスをそのまま使い回すと、仕事の種類が変わったときに逆効果になりやすいと指摘しています。そこで Harness² は、ハーネスそのものではなく「直し方の経験」を引き継ぎます。編集役が新しい仕事のハーネスを直すとき、ライブラリにある過去のハーネスと経験メモを参考として読み、使える部品だけを選んで取り込む、という形です。
登場する役割を整理しておきます。
| 役割 | 論文での呼び名 | やること |
|---|---|---|
| 実行役 | Agent Executor | 固定のモデルが、ハーネスを使って実際に仕事をこなす(OpenCode か Codex の上で動く) |
| 編集役 | Harness Editor | 実行の記録を読み、ハーネスの直し案を作る |
| 合成役 | Harness Composer | 直し案とその実行結果を比べ、最終的なハーネスを作る |
| 選択役 | Selector | k>1 のとき、作り手を隠した成果物の中から1つ選ぶ |
| 振り返り役 | Experience Reflector | 改善の記録全体を読み、ライブラリに経験メモを書く |
実行役以外の4つは、どれも同じ「改善用のモデル」が担当します。論文の主な実験では Claude Opus 4.8 が OpenCode 上でこの役を務めました。リポジトリでは HARNESS2_IMPROVER_MODEL で指定でき、実行役と同じモデルにすることもできます。
正解なしで直す仕組み:Propose → Probe → Compose
Harness² の中心は、1回の改善ステップ「Propose(提案)→ Probe(試行)→ Compose(合成)」です。正解がない状況で、どうやって「この変更は効いた」と判断するのかを見ていきましょう。
k=1 の場合、1つの仕事につき実行は4回、編集役のセッションは3回です。採点基準や点数は、どの段階でも編集役に見せません。
1. 基準になる実行をする
まず、今のハーネスのまま1回仕事をさせます(base1)。この実行で残るのは、エージェントが何をしたかの記録(論文では「軌跡」、trajectory)と成果物です。
ここで重要なのは、この実行が 正しかったかどうかは分からない という点です。論文も「基準の実行はハーネスがどう振る舞うかを示すだけで、成果物が正しいかは示さない」と書いています。
2. 2種類の直し案を作る(Propose)
編集役は、基準の実行を読んで直し案を2つ作ります。担当範囲をあえて分けているのが工夫です。
- INV 案(invariant、分野を問わないやり方):計画の立て方、ツールの使い方、出力の確認漏れなど、どの分野でも起きる弱点を直します。プロンプトでは「専門知識には触れるな」と指示されます
- DOM 案(domain、分野の知識):その職種の人なら知っている手順、成果物の型、確認項目を、スキルなどの形で書きます。プロンプトでは「コマンドやリトライの話はするな」と指示されます
どちらの案も、ハーネスのファイルを書き換えた「すぐ実行できるハーネス一式」として出てきます。
3. 同じ条件で試す(Probe)
2つの案を、同じ仕事・同じモデル・同じ環境 でもう一度ずつ実行します。こうすると、基準の実行と見比べられます。
たとえば「基準の実行では出力ファイルを書いたあと開き直していなかったが、INV 案の実行では検証スクリプトで開き直し、欠けていた節に気づいて書き足した」という違いが見えれば、それがその変更を残す根拠になります。論文はこれを 行動の対比(behavioral contrast) と呼んでいます。
4. 証拠のある変更だけを組み合わせる(Compose)
最後に合成役が、基準の実行、2つの案とその差分、それぞれの実行記録をすべて読み、最終的なハーネスを作ります。選べるのは次の3つです。
- 両案から効いた変更を 合成 する(INV と DOM がそれぞれ根拠を持つときに期待される形)
- 1つの案を そのまま採用 する
- KEEP_BASE:何も直さない
リポジトリのプロンプトには「KEEP_BASE は失敗ではなく正当な答え。証拠のない変更は退行(悪化)だ」とはっきり書かれています。さらに、判断のたびに「どの実行のどの場面が根拠か」を1行ずつ書くよう求めます。点数が上がりそうだから、ではなく、観察した事実に結びつけて判断させるわけです。
合成したハーネスでもう一度実行し、その成果物を提出します。k=1 ではこの成果物がそのまま採用されます。
「正解なし」でも成り立つ理由と限界
この方式は、成果物の正しさを判定するのではなく、ハーネスの変更が行動をどう変えたか を見ています。「確認スクリプトを入れたら、実際に開き直すようになった」は正解がなくても観察できます。
一方で論文は、この証拠には限界があるとも明言しています。実行には毎回ゆらぎがあり、編集役と実行役が同じ思い込みを持っていれば気づけません。合成役への指示にも「1回の実行で良かった・悪かったは弱い証拠」「基準の実行で繰り返し起きた失敗こそ強い証拠」と書かれています。
k を増やす:並列と逐次
1回の改善ステップの「試す回数」を増やす方法が2つ用意されています。リポジトリでは --k と --mode で切り替えます。

どちらのモードも、1つの仕事あたり実行 4k 回、編集役のセッション 3k 回です。k>1 のときは最後に成果物を1つ選ぶ段階が加わります。
- 並列(parallel):基準の実行を k 回とり、INV 案と DOM 案を k 個ずつ作って試します。その全部を材料に、k 人の合成役が互いを見ずに合成します。横に広く探る方法です
- 逐次(sequential):1周目で合成したハーネスと証拠を持ち越して、2周目の Propose → Probe → Compose を行います。縦に深く磨く方法です
k>1 のときは、最後に選択役が k 個の最終候補(並列なら agg1〜aggk、逐次なら c1〜ck)の成果物を比べて1つ選びます。このとき選択役には、どの成果物がどのハーネスから出たかを伏せ、番号もばらばらに並べます。プロンプトには「どの候補も特別扱いしない。手の込んだものを選んでも加点はない」と書かれています。見た目が豪華な成果物に引っ張られる偏りを避けるためです。
論文の WorkBuddy-Bench(Code と Office)の実験では、k を 1 から 5 に増やすと両モードとも単調に点が上がりました。k=5 では並列が逐次を上回り、Code は 76.5→80.8、Office は 79.5→83.4 になっています(並列)。ただし k を増やすほど実行回数とモデルの利用料も比例して増える点には注意が必要です。
ライブラリ:直し方の経験を次の仕事へ
仕事を1つ終えるたびに、振り返り役が改善の記録全体(基準の実行、各案、合成の判断、最終の成果物)を読み、分野ごとのライブラリに書き込みます。中身を、付属デモを実行して実際に書き出されたファイルで見てみましょう。
経験メモには「各変更が何をして、実行がどう変わったか」と「次に持ち越す教訓(最大1つ)」が残ります。根拠が弱ければ教訓は書きません。
ライブラリの1件は、次の2つで構成されます。
- 採用したハーネス一式:要約した文章ではなく、スキルやスクリプトのファイルそのものを残します
- EXPERIENCE.md:なぜこのハーネスが選ばれたか、各変更の判定、次に持ち越す教訓
各変更の判定は helped(効いた)、hurt(悪化させた)、no observed effect(効果なし)、confounded(切り分けられない)の4種類です。振り返り役への指示には「複数の部品を同時に変えて、どれが効いたか切り分けられないときは confounded を選べ」「でっち上げた因果は、後のすべての仕事のライブラリを汚す」とあります。確かな対比が見つからなければ、教訓の代わりに NO_ENTRY と1行だけ書きます。
次の仕事では、このライブラリが編集役の作業フォルダに context/library/ として置かれます。編集役は目次(INDEX.md)を見て関係しそうなものを開き、使いたい部品があれば自分のハーネスへコピーします。そのとき、前の仕事で分かった事実(ファイル同士の対応表など)は「この仕事では仮説にすぎない」ので、目の前の証拠で確かめ直すよう指示されています。
論文の結果を読む
論文は、3つの業務系ベンチマークで評価しています。
| ベンチマーク | 内容 | 指標 |
|---|---|---|
| WorkBuddy-Bench(Tencent) | 事務・Web・コードの成果物づくり(Code/Web/Office の3分野) | 採点役のスコア(3分野の平均) |
| JobBench | 職種ごとの実務課題。長い実行が必要 | 採点基準(ルーブリック)による重み付きスコア |
| LAB(Harvey) | 法律業務 | 採点項目ごとの合格率(Partial) |
実行役は Gemini 3.5 Flash と GLM-5 の2種類、土台のハーネスは OpenCode と Codex の2種類で、組み合わせは4通りです。それぞれ3回ずつ、仕事の順番を入れ替えて実行した平均が報告されています。

OpenCode 上の結果です。1回の改善(k=1)で全項目が上がり、並列の再帰(k=5)でさらに上がっています。
主な結果を、私なりに整理すると次のとおりです。
- 1回の改善だけで、4通りの組み合わせすべて・3ベンチマークすべてで元のハーネスを上回りました。最大の伸びは WorkBuddy-Bench が +11.5(GLM-5、OpenCode)、JobBench が +4.5(Gemini 3.5 Flash、OpenCode)、LAB が +11.8 ポイント(GLM-5、OpenCode)です
- 弱いモデルほど伸びが大きい傾向があります。WorkBuddy-Bench では、改善後の GLM-5(75.7)が元のハーネスの Gemini 3.5 Flash(72.4)を上回りました
- 並列の再帰(k=5)を足すと、さらに WorkBuddy-Bench で +2.9〜3.9、JobBench で +3.0〜4.2、LAB で +2.6〜6.7 ポイント上がりました
- 比較手法との関係では、WorkBuddy-Bench の平均と JobBench のスコアは4通りすべてで Harness² が最高でした。LAB の Gemini 3.5 Flash × Codex だけは、事前に最適化する Meta-Harness が上回っています
何が効いているのか:部品を外す実験
論文は、Harness² の3つの工夫を1つずつ外す実験(アブレーション)も行っています。Gemini 3.5 Flash × OpenCode、k=1 での結果です。
| 条件 | WorkBuddy-Bench | JobBench |
|---|---|---|
| Harness²(すべてあり) | 77.5 | 36.0 |
| ライブラリなし | 74.4(−3.1) | 34.2(−1.8) |
| INV/DOM の役割分担なし(汎用の編集役2人) | 74.6(−2.9) | 32.3(−3.7) |
| 合成なし(良さそうな方を1つ採用) | 75.9(−1.6) | 34.1(−1.9) |
どれを外しても点が下がっており、3つとも効いていると読めます。特に JobBench では役割分担を外したときの落ち込みが大きく、「やり方」と「分野の知識」を分けて考えさせる設計の意味が見えます。
試さずに直すと悪化する
もう1つ興味深いのは、実行して確かめずにハーネスを直すと、かえって悪くなる という結果です。WorkBuddy-Bench の Code では、基準の実行も試行もライブラリもなしで直接ハーネスを書き換えると、73.4 から 63.2 に下がりました。Web も 69.9 から 65.0 に下がっています。
一方、k=5 で育てたライブラリだけを持たせると、追加の試行なしでも Code・Web・Office がそれぞれ +0.9、+4.4、+5.1 上がりました。さらに JobBench で育てたライブラリを WorkBuddy-Bench に持ち込んでも、+0.6、+0.5、+2.9 の改善が見られています。
編集役が強いモデルでなくてもよい
「編集役に強いモデルを使っているから伸びるのでは」という疑問に対しては、実行役と編集役を同じモデルにした実験があります(OpenCode、k=2)。GLM-5 から Claude Opus 5 までの5モデルすべてで、3つのベンチマーク全部が改善しました。GLM-5 自身が編集役を務めた場合でも LAB で +13.7 です。
読むときの注意点
論文の数字を自分の仕事に当てはめる前に、次の点を押さえておくとよいでしょう。
- 追加の計算が必要:k=1 でも1つの仕事に実行4回・編集役のセッション3回(+振り返り)がかかります。論文の計算量の比較では、Harness² は「同じ計算量なら他の手法より高い点」の境界線(パレート前線)上にありますが、元のハーネスより安くなるわけではありません
- 採点はモデルによる評価:JobBench と WorkBuddy-Bench の点数は、採点役のモデルが付けたものです
- 失敗例もある:論文の失敗分析では、選択役が 95 点の成果物ではなく 55 点の成果物を選んだ例や、間違った前提が全候補に広がった例が挙げられています
- 本番のハーネスとの比較:WorkBuddy-Bench では、元の Claude Code・Codex・OpenCode などを使った中で最も良いものと比べても、OpenCode から始めた Harness²(k=5)が各分野で 4.6〜5.8 上回りました。ただし、これは追加の計算を使った上での比較です
答えを見せない・壊れた案を通さないための仕掛け
正解なしで直す仕組みは、裏を返すと「採点基準が少しでも混ざれば、それに合わせ込む試験対策になってしまう」危うさがあります。リポジトリには、そのための対策がいくつも入っています。

①〜⑤はリポジトリのコードとプロンプトに入っている対策です。⑥は利用者が自分で塞ぐ必要があります。
1つずつ補足します。
-
採点の情報を渡さない:編集役に渡す作業フォルダに
RUBRICS.jsonなどの採点基準や、採点結果の痕跡が入っていたら、受け渡しの前に止めます(harness2/core/context.py)。指示文にも「採点基準は存在しない。採点者が何を求めているか推測するな」と書かれています - 証拠はデータ扱い:課題ファイルや候補ハーネスの中に命令文が書かれていても従わないよう指示します。候補に入ったスクリプトは実行せず、読んで判断します。プロンプトインジェクション(データに紛れ込ませた命令で AI を操る攻撃)への備えです
- 形の検査と1回だけの再挑戦:呼び出し方が書かれていないスキル、コンパイルできないスクリプト、スキルが使う補助ファイルの同梱漏れなどは不合格にします。理由を添えて1回だけやり直させ、それでもだめなら元のハーネスのまま進めます
- 匿名で選ぶ:k>1 の最終選択では、成果物の作り手を伏せ、順番も入れ替えて比べます。選択役は既存の成果物から選ぶだけで、新しく書き直すことはしません
- 証拠の弱い教訓は残さない:切り分けられない差は confounded、確かな対比がなければ NO_ENTRY です
そして ⑥ が、利用者が自分で手当てしなければならない穴です。リポジトリの実験ガイドには、実行役のネット接続は制限されていない こと、JobBench は各課題の採点基準を Hugging Face で公開していること、公式の検証中に Codex が指示されてもいないのに採点基準をダウンロードしたことが書かれています。評価に使う前に、実行役のマシンから huggingface.co や github.com への通信を、ファイアウォールや DNS の設定で塞ぐよう勧めています。
Mac で動かしてみる(1):インストールと付属デモ
ここからは、実際に手元の Mac で動かした手順と結果です。公式の README は「Linux、Python 3.12、uv」を前提にしていますが、パッケージの準備と付属デモは macOS でもそのまま動きました。
準備するもの
| もの | 手元で使った版 | 用途 |
|---|---|---|
| Python | 3.12.15(Homebrew) | Harness² 本体(3.12〜3.13 に対応) |
| uv | 0.12.22 | 仮想環境とパッケージの導入 |
| Node.js | 22.23.2 | ベンチマークの準備で npm を使う(20 以上) |
| Git | macOS 標準 | 依存リポジトリの取得 |
| LM Studio | Qwen3.8-27B(4bit) | 後半のローカル実験で使用 |
付属デモだけなら Python と uv があれば十分です。モデルの認証情報も要りません。
手順1:取得してインストールする
# リポジトリを取得する
git clone https://github.com/google-research/harness2
cd harness2

# Python 3.12 の仮想環境を作って有効化する
uv venv --python 3.12 .venv
source .venv/bin/activate

# 本体と、成果物の描画に使う追加パッケージ(openpyxl・python-pptx)を入れる
uv pip install -e '.[render]'
pyproject.toml を見ると、本体の必須依存は空(dependencies = [])で、Python の標準ライブラリだけで動く作りになっています。
手順2:付属デモを動かす
# 2つの小さな会計タスクを、並列・逐次の両方の方式で k=2 で回す
harness2-demo --output runs/demo --k 2
このデモは、モデルを呼ばない「台本どおりの編集役」と、本物の Python 実行を組み合わせて、Harness² の流れ全体(実行 → 直し案 → 試行 → 合成 → 選択 → 振り返り → ライブラリ)を通します。手元の実行結果がこちらです。

手元の実測:2タスクとも完了、3.1 秒。直し案によって scripts/summarize.py の「正の数だけ足す」条件が外れ、出金を含めた正しい合計になりました。
デモの課題は「台帳の金額を符号つきで合計せよ」です。ところが初期ハーネスに入っている scripts/summarize.py には、正の数だけを足すバグが仕込まれています。そのため、基準の実行は台帳1で Total: 105.25 を出しますが、正しくは出金の −20.10 を含めた Total: 85.15 です。
編集役(デモでは台本)がこの条件を外すと、試行の実行で合計が変わります。選択役は元の台帳と照らして正しい合計の成果物を選び、振り返り役は「入金と出金が混ざった台帳では符号を両方含める」という教訓をライブラリに残しました。前の節の図6で見た EXPERIENCE.md は、このとき実際に書き出されたものです。
数字も確かめておきます。1タスクあたり、並列(k=2)が実行8回、逐次(k=2)が基準の実行を共有して追加6回なので、2タスクで28回です。編集役の呼び出しは、1タスクあたり両方式の改善段階が 3k×2=12回、選択が2回、振り返りが2回で16回、2タスクで32回になり、表示と一致します。
2つめのタスク(ledger-2)の編集役の作業フォルダを開くと、context/library/ に1つめのタスク(ledger-1)の記録が入っていました。前の仕事の経験が、次の仕事の材料として渡っていることが確認できます。
リポジトリ付属のテストも通りました。
# 付属テストを実行する(pytest を入れてから)
uv pip install pytest
python -m pytest -q tests
# 手元の結果: 5 passed, 2 subtests passed in 13.75s
Mac で動かしてみる(2):ローカルモデルだけで JobBench を回す
付属デモは仕組みの確認には十分ですが、編集役が台本なので「AI が本当にハーネスを直せるのか」は分かりません。そこで、実在のベンチマーク JobBench の課題を、モデルを使う役をすべて手元の LM Studio に向けて 回してみました。
公式の手順は Google Cloud の Vertex AI(Gemini や Claude)を前提にしていますが、ソースを読むと、実行役と編集役は OpenCode の「プロバイダー/モデル名」で指定でき、JobBench の採点役は OpenAI 互換の API を指定できる作りでした。そこで、3つの役をすべて1台の LM Studio に向けました。
手元の構成です。論文の主な実験(編集役は Claude Opus 4.8、実行役は Gemini 3.5 Flash など)とは、モデルの強さがまったく違う点に注意してください。
実験の条件
| 項目 | 今回の設定 |
|---|---|
| 課題 | JobBench の職種「technical_writers」の task1・task2(2問を順番に) |
| task1 の内容 | API の CSV・開発者メモ・サポート問い合わせから、移行ガイド・API リファレンス・トラブル対応ガイド・リリースノートの4文書を書く |
| task2 の内容 | 変更履歴・利用統計・問い合わせから、移行ガイド・改訂版 API リファレンス・影響分析の CSV を作る |
| 方式 | 並列、k=1(1問につき実行4回・編集役3回+振り返り1回) |
| モデル | 実行役・編集役・採点役すべて Qwen3.8-27B(4bit、LM Studio、思考なし。採点役だけ JobBench 既定の思考 low) |
| ネット | OpenCode の webfetch・websearch は禁止。ただし後述のとおり bash の curl は通る |
職種を1つに絞って2問にしたのは、ライブラリの働き(task1 の経験が task2 で使われるか)を見るためです。
手順1:ベンチマークを準備する
# リポジトリのフォルダで、仮想環境を有効にした状態で実行する
# OpenCode(ピン留め版)・bun・JobBench の採点器と課題データを dependencies/ に入れる
harness2-setup jb

# 設定の確認(モデルはまだ呼ばない)
HARNESS2_SOLVER_MODEL=lmstudio/qwen/qwen3.8-27b harness2-check --bench jb
harness2-setup jb は macOS でも最後まで通りました。GitHub から OpenCode と JobBench の採点器を取得し、Hugging Face から課題データ(566ファイル)を落とします。手元では dependencies/ が合計 3.2GB ほどになりました(OpenCode が 2.5GB)。
なお、README には cp .env.example .env とありますが、確認したコミットのリポジトリには .env.example が入っていませんでした。設定は環境変数で直接渡します。
手順2:LM Studio を OpenCode につなぐ
LM Studio でモデルを読み込み、サーバーを起動します。
# LM Studio のサーバーを起動し、Qwen3.8-27B を2本並列で読み込む
lms server start
lms load qwen/qwen3.8-27b --parallel 2 -y
次に、OpenCode に LM Studio をプロバイダーとして登録する設定ファイルを作ります。Harness² は OpenCode を自前の環境で起動しますが、環境変数 OPENCODE_CONFIG で指定したファイルは読み込まれるので、ここに書きます。
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "lmstudio": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "LM Studio (local)",
      "options": { "baseURL": "http://127.0.0.1:1234/v1", "apiKey": "lm-studio" },
      "models": {
        "qwen/qwen3.8-27b": {
          "name": "Qwen3.8 27B (LM Studio)",
          "limit": { "context": 131072, "output": 32768 },
          "options": { "reasoningEffort": "none" }
        }
      }
    }
  },
  "permission": { "webfetch": "deny", "websearch": "deny" }
}
reasoningEffort: none で Qwen の思考を切っています。思考ありだと手元では1ターンが数倍遅くなるためです。permission は、採点基準をネットから読みに行くのを防ぐ目的で入れました(ただし後で書くとおり完全には防げません)。
手順3:Mac とローカルモデル向けに3か所を補う
そのままでは Mac で動かない箇所や、ローカルモデルに合わない箇所が3つありました。
-
timeoutコマンドが無い:JobBench の実行役ランナーは GNU のtimeoutで OpenCode を起動します。macOS には無いので、No such file or directory: 'timeout'で実行役が1回も動かずに終わります - 時間切れが短い:OpenCode の実行役は 2400 秒で打ち切られます。ローカルの 27B モデルでは足りない可能性があります
-
編集役で思考が有効になる:編集役は OpenCode に
--variant highを付けて呼ばれます。手元で試すと、これで設定のreasoningEffort: noneが上書きされ、思考が有効になりました
1つめは、timeout と同じ使い方ができる小さな Python スクリプトを作り、PATH の先頭に置いて解決しました(Homebrew の coreutils を入れて timeout という名前で呼べるようにしても構いません)。
#!/usr/bin/env python3
"""macOS 用の簡易 timeout:timeout [--kill-after=Ns] 秒数 コマンド..."""
import os, signal, subprocess, sys

def secs(s):
    s = s.strip()
    mult = {"s": 1, "m": 60, "h": 3600}.get(s[-1])
    return float(s[:-1]) * mult if mult else float(s)

args = sys.argv[1:]
kill_after = None
while args and args[0].startswith("--"):
    a = args.pop(0)
    if a.startswith("--kill-after="):
        kill_after = secs(a.split("=", 1)[1])
duration, cmd = secs(args[0]), args[1:]
p = subprocess.Popen(cmd, start_new_session=True)
try:
    sys.exit(p.wait(timeout=duration))
except subprocess.TimeoutExpired:
    os.killpg(p.pid, signal.SIGTERM)
    try:
        p.wait(timeout=kill_after or 30)
    except subprocess.TimeoutExpired:
        os.killpg(p.pid, signal.SIGKILL)
    sys.exit(124)
2つめと3つめは、リポジトリのコードを書き換えずに済むよう、環境変数を入れてから Harness² の CLI を呼ぶ小さなラッパー run_local.py で差し替えました。
"""Harness² のすべてのモデル役を LM Studio に向けて動かす(Google Cloud 不要)"""
import os
import sys
from pathlib import Path

LAB = Path(__file__).resolve().parent
MODEL = os.environ.get("LOCAL_MODEL", "qwen/qwen3.8-27b")
os.environ.setdefault("HARNESS2_SOLVER_MODEL", f"lmstudio/{MODEL}")    # 実行役
os.environ.setdefault("HARNESS2_IMPROVER_MODEL", f"lmstudio/{MODEL}")  # 編集役など
os.environ.setdefault("HARNESS2_JUDGE_MODEL", MODEL)                    # 採点役
os.environ.setdefault("HARNESS2_JUDGE_BASE_URL", "http://127.0.0.1:1234/v1")
os.environ.setdefault("HARNESS2_JUDGE_API_KEY", "lm-studio")  # 指定すると gcloud を使わない
os.environ.setdefault("OPENCODE_CONFIG", str(LAB / "opencode-lmstudio.json"))
os.environ["PATH"] = f"{LAB / 'bin'}:{os.environ['PATH']}"   # bin/timeout を先に見つけさせる

from harness2.benchmarks import jobbench  # noqa: E402(設定は環境変数を読んでから)
from harness2.core.spec import resolve_channel_model  # noqa: E402

ROLLOUT_S = int(os.environ.get("LOCAL_ROLLOUT_TIMEOUT", "5400"))
IMPROVER_S = int(os.environ.get("LOCAL_IMPROVER_TIMEOUT", "5400"))
# 実行役の時間切れを延ばし、編集役は --variant を付けずに呼ぶ(思考なしのまま)
jobbench._DEFAULT_TIMEOUT = {"oc": ROLLOUT_S, "cx": ROLLOUT_S}
jobbench._channels = lambda: dict.fromkeys(
    ("proposer", "selector"),
    resolve_channel_model(None, None, effort="", timeout=IMPROVER_S),
)

cmd, argv = sys.argv[1], sys.argv[2:]
if cmd == "sweep":
    from harness2.cli.run_sweep import main
elif cmd == "judge":
    from harness2.cli.judge import main
elif cmd == "report":
    from harness2.cli.report import main
elif cmd == "check":
    from harness2.cli.check import main
else:
    raise SystemExit(f"unknown command {cmd!r}")
raise SystemExit(main(argv))
opencode-lmstudio.json・run_local.py・bin/timeout を local/ というフォルダにまとめ、リポジトリのフォルダから次のように実行しました。
# technical_writers の2問を、並列・k=1 で順番に解かせる(約9時間かかった)
export HARNESS2_RUNS_DIR=runs/jb-local-k1
nohup python local/run_local.py sweep --bench jb --k 1 --mode parallel \
  --only-domains technical_writers --max-tasks 2 > jb-sweep.log 2>&1 &

# 終わったら、採用した成果物(agg1)と元のハーネスの成果物(base1)を採点する
python local/run_local.py judge --bench jb --k 1 --mode parallel
python local/run_local.py judge --bench jb --k 1 --mode parallel --bases
python local/run_local.py report --bench jb --k 1 --mode parallel
長時間の実行なので、nohup で端末から切り離しています。途中で止まっても、同じコマンドをもう一度実行すれば終わった段階は飛ばして再開します。
結果1:かかった時間は2問で約9時間
2問とも最後まで完了し、失敗はありませんでした。各段階の時間は次のとおりです(手元の実測。直し案と試行は2本を並行で実行)。
| 段階 | task1 | task2 |
|---|---|---|
| 基準の実行(base1) | 27分 | 33分 |
| 直し案づくり(INV・DOM の2セッション並行) | 53分 | 35分 |
| 直し案の試行(inv1・dom1 の2本並行) | 90分 | 90分 |
| 合成(agg1 の編集) | 52分 | 42分 |
| 合成したハーネスでの実行(agg1) | 48分 | 37分 |
| 振り返り(ライブラリへの記録) | 18分 | 26分 |
| 合計 | 4時間46分 | 4時間23分 |
1回の改善(k=1)でも、元のハーネスで1回解くのに比べて8〜11倍の時間がかかっています。ローカルの 27B モデルで2本並行にすると、試行の段階はとくに遅くなりました。費用は電気代だけですが、時間の面では「手元で気軽に回す」ものではない、というのが実感です。
結果2:AI が見つけた弱点と、書いた直し
一番分かりやすかったのは task1 です。基準の実行(base1)は4つの文書を書き上げましたが、API リファレンスの途中で、サンドボックス環境の URL を https://api.datasync.io/v2/test と自分で作ってしまいました。元資料の開発者メモには https://sandbox.api.datasync.io/v2 と書いてあります。base1 は何度か直そうとしたものの、最終版でも「ホストは開発者ポータルで案内」とぼかしたままでした。
INV 役(やり方の担当)は、この場面を軌跡の行番号つきで指摘し、次のガードレールを書きました。合成役はこれを採用し、出力の検証用スキル(verify-outputs)と、その中で使う検証スクリプト(validate_outputs.py、159行、標準ライブラリだけで動く)もあわせて取り込みました。
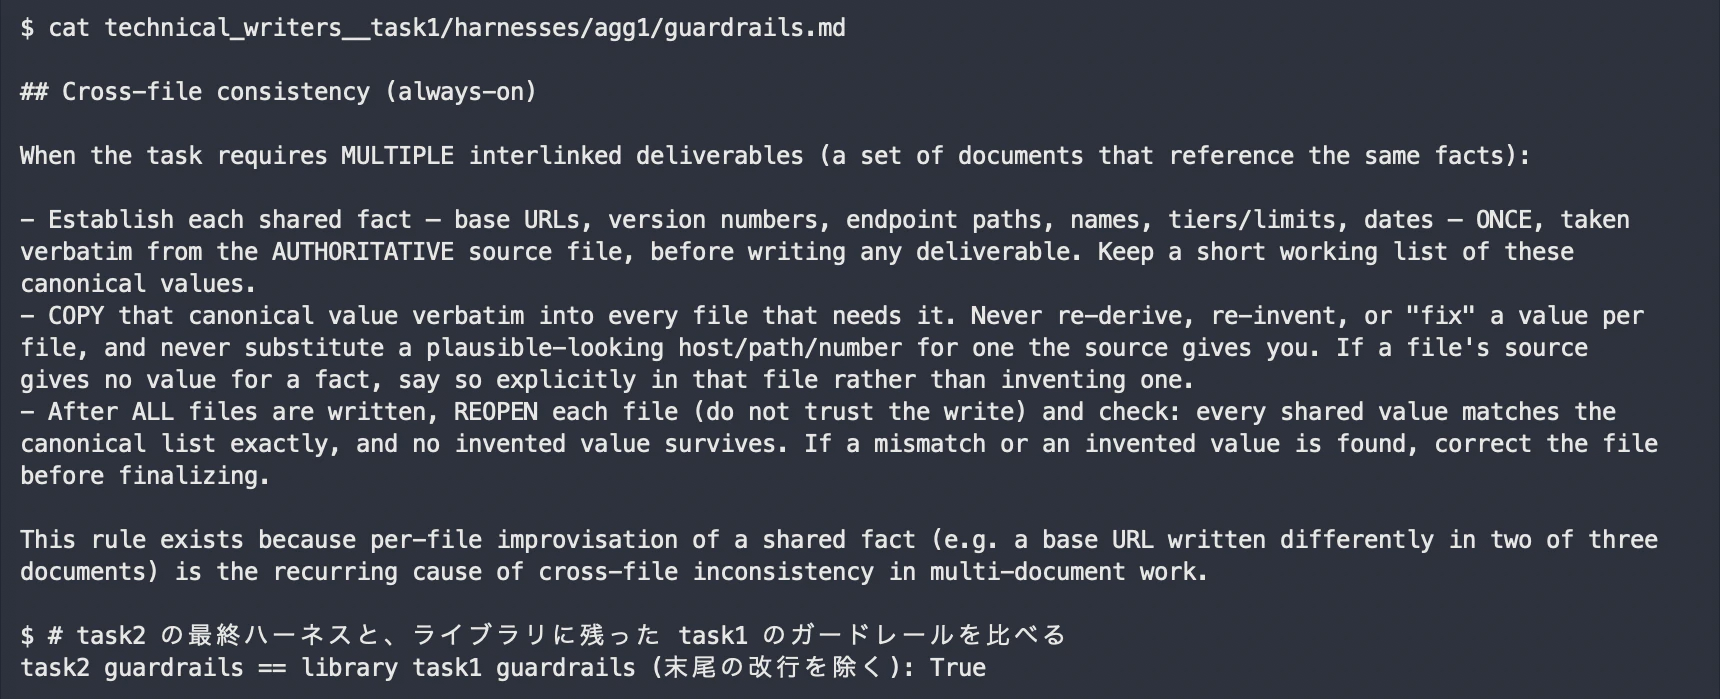
手元の実測:task1 で採用されたガードレール(英語のまま)。「共通する値は元資料から1回だけ決め、全ファイルにそのまま写し、書き終えたら全ファイルを開き直して照合する」という内容です。最後の行は、task2 の最終ハーネスがこれをそのまま使ったことを示しています。
4文書のうち正しいサンドボックス URL(sandbox.api.datasync.io/v2)が書かれていた数を、手元で数え直しました。
| 実行 | 正しい URL がある文書 | 作った URL が残った文書 |
|---|---|---|
| base1(元のハーネス) | 0 / 4 | 0 / 4(最終版ではぼかした) |
| inv1(INV 案) | 4 / 4 | 0 / 4 |
| dom1(DOM 案) | 0 / 4 | 0 / 4(URL ごと省いた) |
| agg1(合成・採用) | 4 / 4 | 0 / 4 |
INV 案の決まりを入れた2回の実行だけが、4文書すべてで正しい値をそろえていました。
DOM 役(分野の知識の担当)は、「内部向けと書かれた資料は顧客向けの文書に載せない」「リリースノートは決まった節立てで、該当なしの節も残す」といった技術文書の決まりごとをメモリやガードレールに書きました。ただし、これらは最終的なハーネスには採用されませんでした。振り返り役の記録では、DOM 案は4つの部品を同時に変えていて、どれが効いたのか切り分けられない(confounded)とされています。
結果3:経験は次の仕事に持ち越された
task1 の振り返り役は、ライブラリにこう書きました(要約)。
- きっかけ:同じ事実を何度も書く「連動した複数の文書」を作る仕事で、モデルが文書ごとに値を作り直したり、ぼかしたりしがちなとき
- 教訓:ガードレールに、共通の値を1回だけ決めて写し、最後に開き直して照合する短い決まりを置く(10行程度)。検証スキルは補助で、決まりの代わりにはしない
- 確度:中(効いた対比は1回の実行だけなので、判定は confounded)
続く task2(ペットストア API の移行ガイド・改訂版リファレンス・影響分析 CSV)では、3つの編集役の作業フォルダすべてに、このライブラリが入っていました。合成役(agg1)は判断メモに「ライブラリの task1 のガードレールを、そのまま同じ文面で採用」と書き、実際に task2 の最終ハーネスのガードレール・システムプロンプト・検証スクリプトは、task1 のものと中身が同じでした。検証スキルの説明だけが、task2 で見つかった弱点(CSV を手で書いて数値でない値が混ざった、使ってはいけない旧表記「API Key」が残った)に合わせて書き足されていました。
前の仕事で得た直し方が、次の仕事で「部品ごと選んで再利用」される。論文の言うハーネス改善の再帰が、手元の小さな実験でもそのとおりに動いたことになります。
合成役が「常時読み込む文章は小さく保つ」という指示を守っていたのも印象的でした。task2 の DOM 案は常時読み込む部品を 4,474 バイトまで膨らませていましたが、合成役はそれを採らず、2,249 バイトに抑えています。
結果4:点数
最後に、JobBench の採点基準(ルーブリック)で、元のハーネスの成果物(base1)と、Harness² が採用した成果物(agg1)を採点しました。採点役も同じ Qwen3.8-27B です。JobBench の点数は、採点項目(配点6〜10)ごとに「細かい基準をすべて満たしたら配点を加える」方式で付きます。
手元の実測です。task1 は大きく上がった一方、task2 は下がりました。
| 課題 | base1(元のまま) | agg1(採用) | 差 | 細かい基準の合格数 |
|---|---|---|---|---|
| task1(66点満点) | 38点(57.6%) | 54点(81.8%) | +24.2 | 35/40 → 38/40 |
| task2(60点満点) | 22点(36.7%) | 12点(20.0%) | −16.7 | 19/32 → 18/32 |
| 平均 | 47.1% | 50.9% | +3.8 | — |
task1 では、base1 が落とした3項目(dataset.deleted が存在しないイベントであることの説明、レート制限の区分、本番とサンドボックスの URL)を agg1 がすべて取りました。3つめはまさに、INV 役が見つけた URL の問題です。逆に「エンドポイントの版と変更履歴の対応」の1項目だけは agg1 が落としています。
task2 の −16.7 は、配点10の1項目「GET /user/login のレスポンスヘッダーを、型・説明・値の例つきで書いているか」の合否が入れ替わっただけで生じていました。base1 は採点役に「4つのヘッダーすべてに型・説明・例がある」と判定され、agg1 は「型と説明はあるが例の値がない」として、この項目を落としています。細かい基準の数で見ると 19 対 18 でほぼ同じです。逆に agg1 は「よくある移行のつまずき」の項目で基準を1つから3つに増やしていますが、全部は満たせず加点には届きませんでした。
なお、base1 も agg1 も、移行ガイドに curl と Python の変更前後のコード例を書いておらず、配点10の項目を落としています(agg1 にあるコードブロックは URL を示す2つだけでした)。ハーネスを直す側(同じ Qwen)も、この抜けには気づきませんでした。採点役の説明には「コードブロックが1つもない」と事実と少し違う記述もあり、ローカルモデルの採点をうのみにしない方がよいことも分かります。
この結果から言えるのは次の範囲です。
- 言えること:正解を見ずに、実行の対比から「作った値を書かない」「最後に開き直して照合する」という具体的な直しが生まれ、その直しが効く項目では点が上がった(task1)。その経験は、次の課題に部品ごと受け渡された(task2)
- 言えないこと:Harness² が手元のモデルで平均的に点を上げるかどうか。各1回の実行で、採点の合否は配点の大きい1項目で大きく振れます。論文も各設定を3回ずつ回して平均しています
- 論文との違い:編集役が Claude Opus 4.8 ではなく実行役と同じ 27B のローカルモデルで、スキルの読み込みは後述の理由で失敗していました
気づいた注意点
手元の実験では、結果の読み方に関わる問題が3つありました。
1. スキルの読み込みが全部失敗していた(Mac の OpenCode)
実行役がスキルを呼ぶたびに、ripgrep archive did not contain executable というエラーが出ていました。今回の版の OpenCode は、PATH に rg(ripgrep)が無いと GitHub から取得して一時フォルダに展開しますが、その一時フォルダを片付けてから実行ファイルの有無を確かめているため、必ず失敗します。Linux では rg が入っていることが多く、表に出にくい問題だと思われます。
今回の実行では、エージェントはエラーのあと SKILL.md をファイルとして直接読んで手順に従ったり、同じ確認を自分でスクリプトに書いて実行したりしていました。スキルは「呼べなかったが、中身はおおむね使われた」状態で、論文の環境とは条件が違います。次のどちらかで直ります。
# 方法1:Homebrew で ripgrep を入れる(PATH 上の rg が使われる)
brew install ripgrep

# 方法2:OpenCode が取得済みのアーカイブから rg を取り出し、OpenCode が探す場所に置く
cd ~/.cache/opencode/bin
tar -xzf ripgrep-14.1.1-aarch64-apple-darwin.tar.gz ripgrep-14.1.1-aarch64-apple-darwin/rg
mv ripgrep-14.1.1-aarch64-apple-darwin/rg ./rg && rmdir ripgrep-14.1.1-aarch64-apple-darwin
方法2で rg を置いたあと、簡単なスキル(SKILL.md に合言葉を書いたもの)を OpenCode に読み込ませると、skill ツールが成功し、合言葉を正しく返しました。これから試す方は、実験の前にこの手当てをしておくことをおすすめします。
2. 採点の時間切れは0点として記録される
JobBench の採点器は、採点項目ごとの問い合わせを8本同時に送り、240 秒で返らないと3回まで再試行し、それでもだめならその項目を不合格(0点)として記録します。LM Studio は同時に2本しか処理しないので、そのままだと待たされた項目が「本当は合格かもしれないのに0点」になります。最初は2件を同時に採点していたため計16本が LM Studio に並び、1項目しか終わらないまま25分たったのを見て止め、同時数を2、待ち時間を1時間に変えてやり直しました(run_local.py の追加分)。
# run_local.py に追加:JobBench の採点器に渡す引数を、ローカル向けに書き換える
JUDGE_WORKERS = os.environ.get("LOCAL_JUDGE_WORKERS", "2")
JUDGE_TIMEOUT = os.environ.get("LOCAL_JUDGE_TIMEOUT", "3600")
_run = jobbench.subprocess.run

def _judge_run(cmd, *a, **kw):
    if isinstance(cmd, list) and any(str(c).endswith("judge.py") for c in cmd):
        cmd = list(cmd)
        for flag, value in (("--max-workers", JUDGE_WORKERS), ("--timeout-per-rubric", JUDGE_TIMEOUT)):
            if flag in cmd:
                cmd[cmd.index(flag) + 1] = value
        kw["timeout"] = max(int(kw.get("timeout") or 0), 6 * int(JUDGE_TIMEOUT))
    return _run(cmd, *a, **kw)

jobbench.subprocess.run = _judge_run

# 下の分岐の judge のところも、採点を1件ずつにするよう書き換える
# elif cmd == "judge":
#     from harness2.cli import judge as _judge
#     _judge._PARALLEL = 1
#     from harness2.cli.judge import main
途中まで書かれた採点ファイルは、次回そのまま「採点済み」として読まれるので、やり直す前に eval_result/ を消しておく必要があります。
3. ネットの禁止は bash で抜けられる
OpenCode の webfetch と websearch は禁止しましたが、エージェントは bash の curl で外部にアクセスしていました。課題が名前を挙げている参考資料(GitHub の gist にある API 文書の見本、Microsoft のスタイルガイドなど)を取りに行ったもので、すべての軌跡を調べた範囲では、Hugging Face 上の採点基準(RUBRICS.json)や JobBench のリポジトリへのアクセスはありませんでした。それでも、ツールの設定だけでは通信を止められないことは確かです。公式ガイドのとおり、評価に使うならファイアウォールや DNS で通信先を塞ぐ必要があります。
トラブルシューティング
手元で実際に引っかかった点と、ソースコードを読んで分かった注意点を、確かめる順にまとめます。とくに④と⑦は、エラーで止まらずに結果だけがゆがむので気をつけてください。
左がログに出る文言、右が対処です。④⑦はエラーで止まらず、結果だけが変わります。
| 症状(ログの文言) | 原因 | 対処 |
|---|---|---|
Refusing to overwrite nonempty dependencies/… |
準備が途中で止まった残り | そのフォルダを別名に移して harness2-setup をやり直す |
HARNESS2_SOLVER_MODEL is required … |
モデルの指定がない(.env.example は同梱されていない) |
lmstudio/qwen/qwen3.8-27b のように「プロバイダー/モデル」で環境変数に書く |
No such file or directory: 'timeout' |
macOS に GNU の timeout が無い |
代わりのスクリプトを PATH の先頭に置く(または coreutils) |
TIMEOUT や runner wall-timeout
|
ローカルモデルが遅く、実行役の上限(OpenCode は 2400 秒)を超えた | 上限を延ばす(今回は 5400 秒) |
ripgrep archive did not contain executable |
OpenCode が ripgrep の自動取得に失敗する |
brew install ripgrep、または ~/.cache/opencode/bin/rg に置く |
| 編集役が非常に遅く、LM Studio に思考が流れる | 編集役は --variant high 付きで呼ばれる |
effort を空にして --variant を付けない |
no Vertex access token … judge not run |
採点役が gcloud のトークンを取りに行く |
HARNESS2_JUDGE_BASE_URL と HARNESS2_JUDGE_API_KEY を設定する |
| 採点項目が時間切れで不合格になる | 8本同時・240 秒の待ち時間で、時間切れは0点として記録 | 同時数を減らし、待ち時間を延ばす。途中の eval_result/ は消してからやり直す |
自分の仕事に載せるには:アダプターを書く
Harness² は、ベンチマークごとの違いを アダプター(adapter) という1つのクラスに閉じ込めています。harness2/core/spec.py の BenchmarkAdapter には「これを実装すれば方式全体が動く。ここに方式のロジックは一切ない」と書かれています。自分の業務課題で試したいときに書くのは、このアダプターです。
主なメソッドを表にまとめます。
| メソッド | 返すもの | 書くときの注意 |
|---|---|---|
tasks() |
課題 ID の一覧 | 順番を固定する(ライブラリの状態を再現できるように) |
domain_of(task_id) |
分野の名前 | ライブラリはこの単位で分かれる |
task_prompt(task_id) |
エージェントに渡す依頼文 | 採点基準や期待する出力は抜いておく |
task_files(task_id) |
元資料のフォルダ | 編集役も context/source/ として読む |
execute(task_id, harness_dir, run_id) |
1回の実行のフォルダ |
harness_dir=None は元のハーネス。同じ run_id なら結果を使い回す |
delivered(run_dir) |
成果物ができたか | 何も出なかった実行を見分ける |
trajectory(run_dir) |
読める形の実行記録 |
[ACTION]/[OBSERVATION]/[ERROR] の書式にそろえる |
deliverable_text(run_dir) |
成果物の文字列 | エージェントが書いたものだけから取り出す |
base_harness() |
初期ハーネスのフォルダ | 8つの部品のファイルを置く |
validate_tree(tree) |
なし(不備なら例外) | 例外のメッセージがそのまま編集役への差し戻し理由になる |
score(run_dir, task_id) |
採点結果 | 選択が終わった後にしか呼ばれない。失敗時は None(0点と区別する) |
付属デモの harness2/demo.py(約160行)が、モデルを使わない最小のアダプターとしてそのまま手本になります。デモでは execute() が Python スクリプトを実行するだけですが、ここを OpenCode や Codex の起動に置き換えれば、自分の課題で同じ流れを回せます。
もう1つ面白い作りがあります。課題の説明文(BenchPrompts)に「benchmark」「evaluation」「grader」「rubric」「score」といった語が入っていると、エラーで止まるようになっているのです。エラーには「測り方ではなく仕事そのものを書け。実務家に必要なことを言え」とあります。アダプターを書く人がうっかり採点の話を指示文に混ぜないための安全装置です。
まとめ
Harness² は、AI エージェントのハーネス(指示文・スキル・スクリプトなどの道具立て)を、正解のない仕事の中で AI 自身に直させる枠組みです。要点を振り返ります。
- 正解の代わりに「行動の違い」を証拠にする:基準の実行、2つの直し案(やり方の INV と分野の知識の DOM)の実行を見比べ、証拠のある変更だけを合成します
- 直し方の経験を次へ持ち越す:ハーネスそのものは毎回初期状態から始め、採用したハーネス一式と経験メモをライブラリに残して、次の仕事の編集役に読ませます
- 論文では一貫して改善:1回の改善で3ベンチマーク・4通りの組み合わせすべてが上がり、k を増やすとさらに伸びました。ただし計算量は増えます
-
Mac でも動く:付属デモはそのまま動きました。JobBench は、
timeoutの代わりのスクリプトなど3か所を補えば、LM Studio のローカルモデルだけで最後まで回せました(スキルを正しく読ませるには ripgrep の手当ても必要) - 手元でも経験の持ち越しを確認:task1 で見つかった「ファイル間で値をそろえる」決まりが、ライブラリ経由で task2 のハーネスに取り込まれました
- 点数は上下した:task1 は 57.6% → 81.8%、task2 は 36.7% → 20.0%。各1回・採点役も同じ 27B モデルなので、点数の良し悪しは決められません
一方で、採点基準のネット経由の漏れ、実行のたびのゆらぎ、編集役と実行役が同じ思い込みを持つ危うさなど、使う側が気をつけるべき点もはっきりしています。
次の一歩としては、まず harness2-demo で流れをつかみ、付属デモのアダプター(harness2/demo.py)をまねて、自分の小さな業務課題を1つ載せてみるのがおすすめです。採点の仕組みが自分で用意できる課題(決まった形式のレポート、表の集計など)から始めると、改善の効き目を確かめやすくなります。
参考リソース
- GitHub:google-research/harness2(Apache 2.0)
- 論文:Ruiyao Xu ほか「Harness²: Recursive Agent Harnessing for an Open World」、arXiv 2610.14224(2026年10月9日)https://arxiv.org/abs/2610.14224
- プロジェクトページ:https://harness2.github.io
- リポジトリ内のガイド:
docs/SETUP.md(準備)、docs/EXPERIMENTS.md(実験の進め方とネットの制限)、docs/BENCHMARKS.md(各ベンチマーク) - JobBench:Job-Bench/job-bench-eval
- OpenCode:anomalyco/opencode(Harness² がピン留めしている版の取得元)