
はじめに
ここ数週間、「判断だけに特化した AI モデル」の話題が続いていました。TypeSafe の Jev、Cloudflare の Clef、Strands の Decider などです。どれも「この問い合わせはどの部署へ?」「この文章は今日中の対応が必要?」といった判定を、普通のチャット AI より速く・安く返すことを売りにしています。
2026年10月2日に公開された SGLang v0.5.21 にも、似た名前の Decisions API(/v1/decisions) が入りました。リリースノートでは「LLM/VLM を低遅延の分類器・採点器にする」機能として紹介されています。
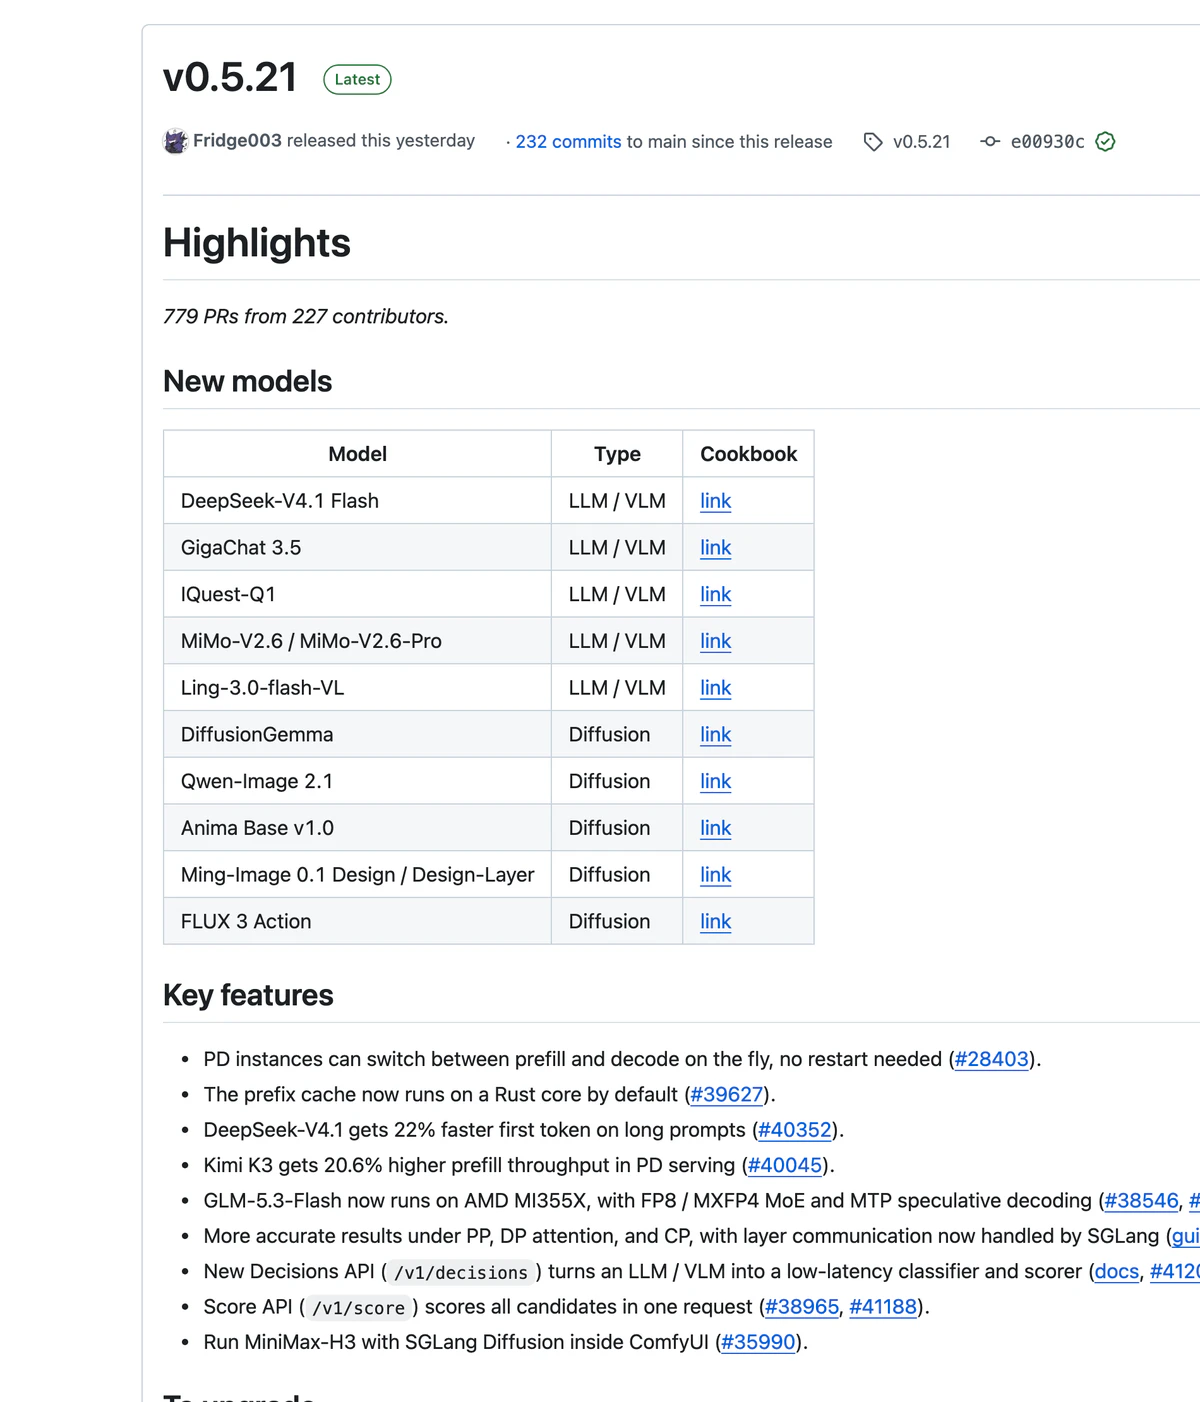
SGLang v0.5.21 のリリースページ(2026年10月3日撮影)。Key features の下から3つ目が Decisions API です
ただ、ニュースを読んだだけでは次のような疑問が残ります。
- SGLang は Jev や Clef のような「判定モデル」なのか?
- SGLang と vLLM、Ollama、LM Studio は何が違うのか?
- 自分の Mac で動かすと、実際どれくらい速くなるのか?
この記事では、まず SGLang がどんな種類のソフトなのかを整理し、Decisions API の仕組みを図で追います。そのうえで、筆者の Mac(Apple M5 Max・メモリ128GB)に SGLang を入れて、同じモデル・同じ40件の問い合わせで「Decisions API」と「これまでの JSON で答えさせる方法」を比べました。vLLM の Mac 版(vllm-metal)でも同じことを試しています。
先に結論を書くと、Decisions API は 新しいモデルではなく、推論エンジンに足された「判定の窓口」 です。手元の測定では、判定1件の時間が 0.57秒 → 0.17秒(約3.3倍速) になり、正解率は変わりませんでした。一方で、Mac で動かすには公式手順に書かれていない設定がいくつか必要でした。
図1:同じ判定でも、答えの取り出し方が違う。差が出るのは「②で文章を書くかどうか」の部分です
この記事の確認範囲
| 項目 | 内容 |
|---|---|
| 確認日 | 2026年10月3日 |
| SGLang | v0.5.21(2026-10-02 公開、タグ e00930c)+ MLX 起動修正 PR #41314 を適用 |
| vLLM | vllm-metal 0.30.0(Homebrew 版、vLLM 0.30.0 ベース) |
| Mac | Apple M5 Max(40コア GPU)、メモリ 128GB、macOS 26.6.2 |
| 主に使ったモデル |
mlx-community/Qwen3.8-27B-4bit(公式が検証済みとする Qwen3.8-27B の Mac 向け4bit版) |
| 参考にした資料 | SGLang のリリースノート・公式ドキュメント・ソースコード、vLLM・vllm-metal の公式資料(末尾に一覧) |
この記事の数値は、1台の Mac で測った結果です。NVIDIA の GPU サーバーでの速さや、公式がうたう性能を確かめたものではありません。
SGLang は何をするソフトなのか
「モデル」と「モデルを動かす係」は別もの
AI モデル(たとえば Qwen3.8)は、学習で得た膨大な数値の集まりです。ファイルをダウンロードしただけでは、質問に答えてくれるサービスにはなりません。そのモデルを GPU に読み込み、届いた質問を計算して、答えを API として返す係が必要です。
この係を 推論エンジン(推論サーバー)と呼びます。SGLang はこの推論エンジンの一つで、オープンソースのプロジェクトです。現在は非営利団体の LMSYS がホストしており、公式の README では xAI、NVIDIA、AMD、LinkedIn、Cursor などが採用企業として紹介されています(プロジェクト側の公表情報です)。
「SGLang は Jev のような判定モデルなのか?」という疑問への答えは いいえ です。層で整理すると、位置がはっきりします。

図2:SGLang は「推論エンジン」の層にあります。Jev・Clef は判断が得意な「モデル」をサービスで提供するもので、手を入れている層が違います
OpenAI の dots のような完成したエージェント製品や、検索→読む→次の質問…と作業を進めるハーネスは、もっと利用者に近い側の仕組みです。どのモデルに送るかを決めるルーター(LiteLLM Router など)とも別物です。SGLang にも「Model Gateway」という振り分け用の部品がありますが、本体の中心は推論の実行です。
同じ種類のソフトと、Ollama・LM Studio との関係
SGLang と同じ層に入る代表的なソフトは、次のとおりです。
| 名前 | 開発元 | 特徴 |
|---|---|---|
| SGLang | LMSYS ほかのコミュニティ | 共通する入力の計算を使い回す RadixAttention で知られる。今回 Decisions API を追加 |
| vLLM | UC Berkeley 発のコミュニティ | 最も直接の比較対象。メモリを小さな区画で管理する PagedAttention で知られる |
| TensorRT-LLM | NVIDIA | NVIDIA の GPU 向けに最適化された実行基盤 |
| LMDeploy | InternLM/OpenMMLab | モデルの圧縮・実行・API 提供 |
| llama.cpp | ggml-org | PC を含む幅広い環境で動く実行ソフト。API サーバー機能もある |
Ollama や LM Studio も「モデルを動かすソフト」なので、役割は重なります。違いは得意な場面です。LM Studio はモデルの検索・ダウンロード・チャットを画面で操作でき、内部では llama.cpp や Apple の MLX を実行エンジンとして使っています。Ollama はモデルの取得と実行をコマンド1つで手軽にできます。
一方、SGLang や vLLM は 多数の依頼を同時にさばく ことに重点を置いています。「自分の Mac で試す」なら Ollama や LM Studio が手軽で、「自社サービスのモデルを多くの利用者に提供する」なら SGLang や vLLM が候補になる、というのが大まかな使い分けです。ただし、どちらも1人で使えますし、逆も可能です。
推論エンジンの中で起きていること
Decisions API を理解するには、推論エンジンが質問を処理する流れを知っておくと近道です。
図3:通常の文章生成は ③ デコードを何十回・何百回と繰り返します。Decisions API は ② のあとで止まります
大事なのは ② プリフィル と ③ デコード の違いです。プリフィルは入力全体を一度にまとめて計算する段階です。デコードは答えを1トークン(単語のかけら)ずつ足していく段階で、トークンを1つ足すたびにモデル全体をもう一度動かします。
答えが長くなるほどデコードの回数が増え、時間がかかります。SGLang も vLLM も、複数人の依頼を同じ計算に相乗りさせる(バッチ処理)、共通する入力の途中結果を使い回す、といった工夫でこの負担を減らしています。
Decisions API の仕組み
「次に来る1文字の確率」を読むだけ
LLM はもともと、次に来るトークンを確率で予測する仕組みです。たとえば選択肢に A〜D の記号を付けて「記号で答えて」と頼むと、モデルの内部には「次に A が来る確率は何%、B は何%…」という数字が計算されます。
Decisions API は、この数字を 文章を書き始める前に 取り出して返します。公式ドキュメントの説明を要約すると、次のとおりです。
- 文章は生成せず、回答の位置にある「次のトークンの確率」から各選択肢の確率を読む
- 特別なモデルは不要で、チャットテンプレートを持つ生成モデルなら使える(条件あり)
- 質問の種類は
choice(選択)、score(段階評価)、yes_noの3つ
図4:アプリは入力・質問・選択肢を送るだけ。プロンプト作りと確率の読み取りはサーバーが行います
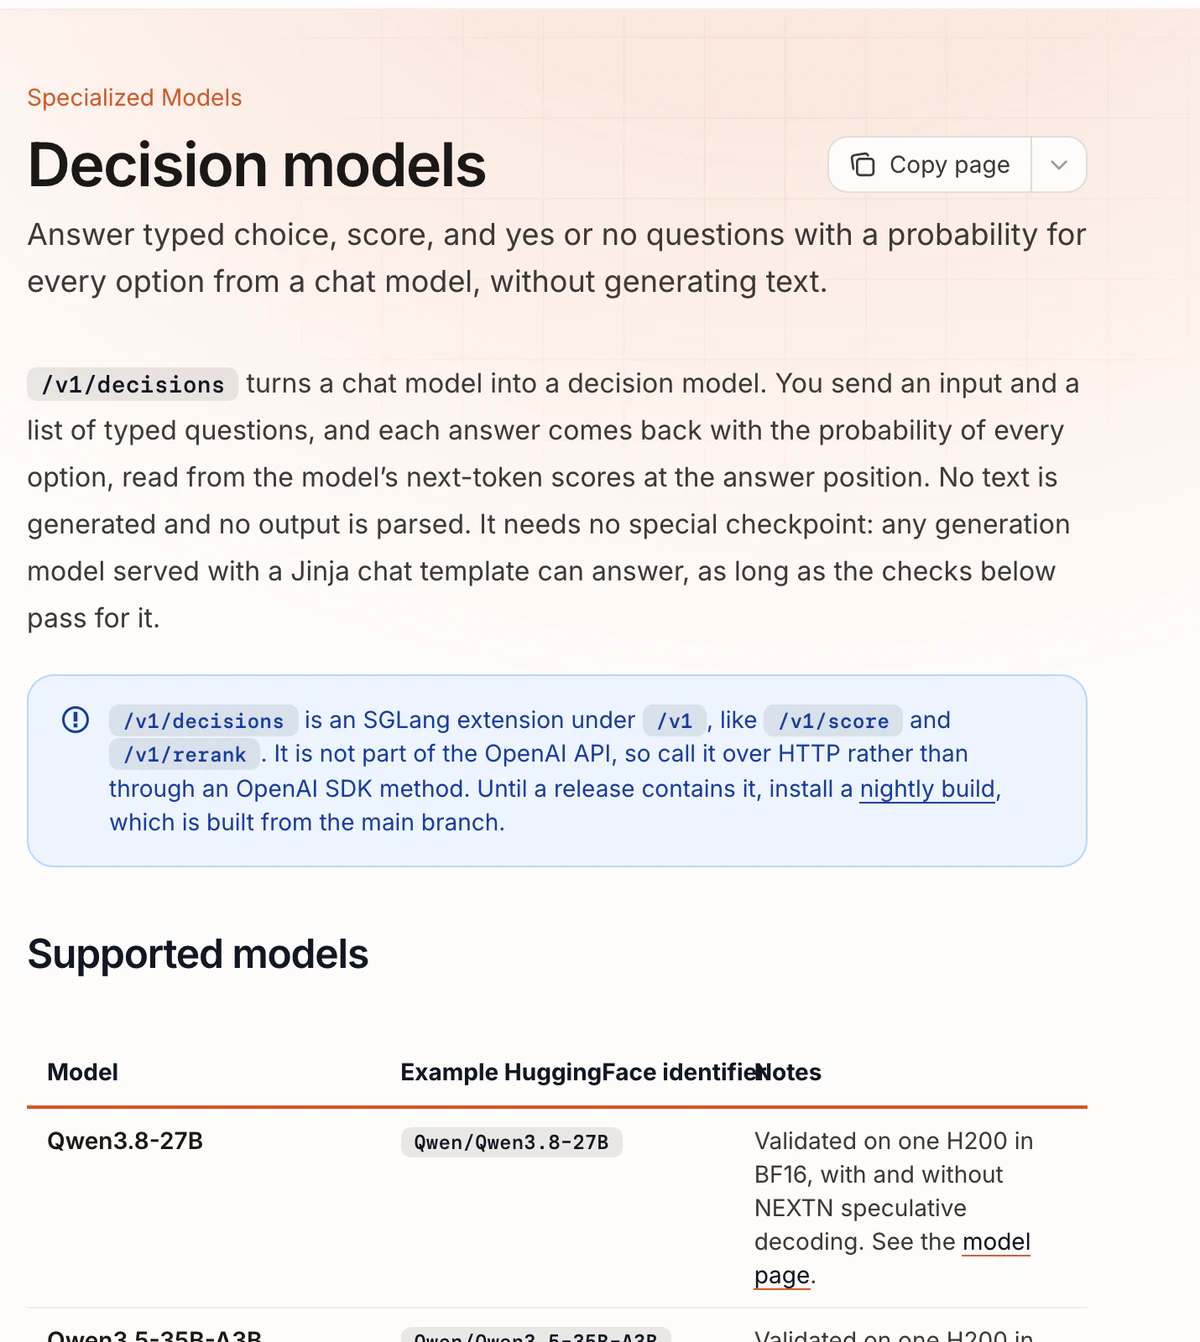
SGLang 公式ドキュメント「Decision models」(2026年10月3日撮影)。注意書きの「リリースに含まれるまでは nightly を」という一文は、v0.5.21 の公開後も残っていました
実際にモデルへ渡されたプロンプト
「サーバーがプロンプトを作る」と言われても、中身が見えないと不安です。Decisions API には、組み立てたプロンプトをトークン番号で返す return_prompt_token_ids というオプションがあります。これを文字に戻して表示してみました。
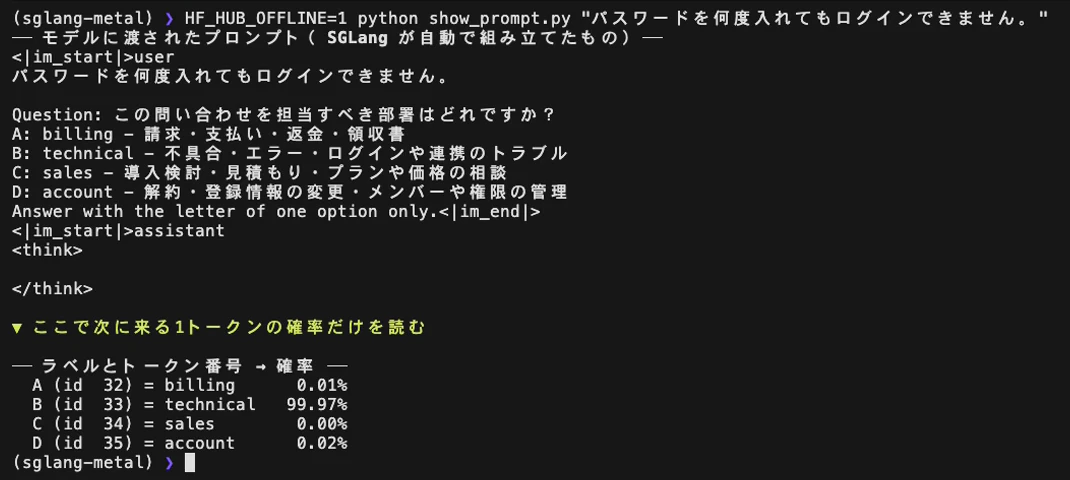
筆者の Mac で表示した、Decisions API の内部プロンプト(Qwen3.8-27B)。最後の </think> の直後に来る1トークンの確率だけを読んでいます
ポイントは3つです。選択肢には自動で A〜D の記号が振られています。最後に「記号1文字だけで答えて」という指示が付きます。そして、Qwen3.8 のように考えてから答える「思考モード」を持つモデルでは、空の思考ブロック(<think></think>)を閉じた状態にして、思考の途中で確率を読まないようにしています。
返ってくる値と、注意したい点
1件の問い合わせに3つの質問をまとめて送ると、次のような答えが返ります(実測値、一部省略)。
{
  "object": "decisions",
  "answers": {
    "team":    {"type": "choice", "choice": "technical",
                "probabilities": {"billing": 0.0002, "technical": 0.9995, "sales": 0.0003},
                "label_mass": 0.999},
    "urgent":  {"type": "yes_no", "probabilities": {"yes": 0.97, "no": 0.03}, "label_mass": 0.61},
    "mood":    {"type": "score", "score": 1.21, "probabilities": {"0": 0.03, "1": 0.73, "2": 0.24}}
  },
  "usage": {"prompt_tokens": 166, "completion_tokens": 0}
}
completion_tokens が 0 になっているのが、文章を1文字も生成していない証拠です。label_mass は「記号に割り当てられた確率の合計」で、低いときはモデルが用意した選択肢以外の答えを出したがっていることを示します。yes_no では小文字の yes/no だけを数えるため、はっきりした質問でも低めに出ると公式資料に書かれています。
公式資料は、返る確率は「その判定が正しい確率」ではない とも明記しています。「確率が0.8未満なら人が確認する」といったしきい値は、自分の業務の正解付きデータで決める必要があります。
Jev 用の SDK がそのまま使える窓口もある
Decisions API と同時に、TypeSafe 社の System One API(Jev を呼び出す API)と同じ形で答える /v1/systemone も入りました。公式の Python SDK(typesafe-sdk)の接続先を自分の SGLang サーバーに向けるだけで判定できる、という説明です。実際に試すと、そのまま動きました。
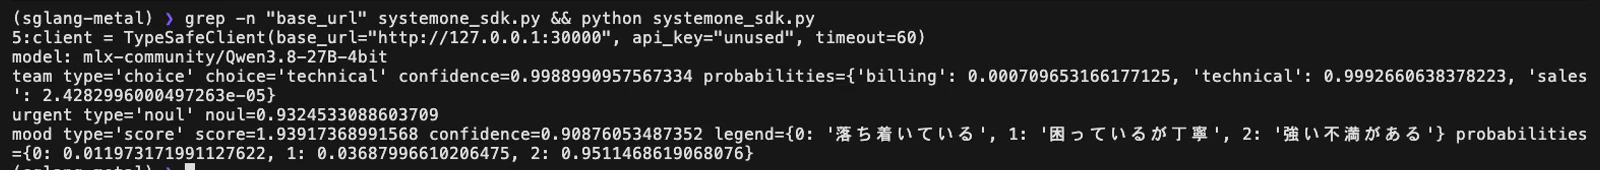
Jev 用の SDK(typesafe-sdk 0.7.2)を手元の SGLang に向けた結果。返ってきた model は Jev ではなく、SGLang が動かしている Qwen3.8-27B です
ここで勘違いしやすいのが、「Jev そのものが SGLang で動く」わけではない点です。同じ呼び出し方で、自分のサーバーのモデルに判定を頼める というのが正確な意味です。判定の質は、そのとき動かしているモデル次第です。
SGLang と vLLM は何が違うのか
大枠は同じ、違うのは「どこまで用意されているか」
SGLang と vLLM は、どちらも同じ層の推論エンジンです。文章生成、JSON 形式での出力、複数 GPU での分散、投機的デコード(小さなモデルで先読みして速くする工夫)、途中結果のキャッシュなど、主要な機能はどちらにもあります。「片方にしかできない」と言い切れる機能は多くありません。
違いが出やすいのは、得意分野と、機能をどこまで「すぐ使える形」で用意しているかです。
| 比べる点 | SGLang v0.5.21 | vLLM 0.30.0 |
|---|---|---|
| 知られている工夫 | RadixAttention(共通する入力の使い回し) | PagedAttention(メモリの区画管理) |
| 判定用の窓口 |
/v1/decisions:プロンプト作り・記号の検査・全選択肢の確率まで一式 |
/generative_scoring:指定したトークンの確率を返す(下ごしらえは利用者) |
| 低レベルの採点 |
/v1/score(今回、複数候補を1回で採点できるように) |
/generative_scoring がこれに近い |
| System One 形式 | 本体に /v1/systemone
|
DiffusionGemma 向けのサンプルが main ブランチにある(本体の窓口ではない) |
| 独自の仕組み | 処理の流れを Python で書ける Frontend Language、Model Gateway | プラグインで多様なハードウェアに対応 |
| Apple Silicon | 本体に MLX の実行経路(ソースから導入) | 別プロジェクトの vllm-metal(Homebrew で導入) |
vLLM の /generative_scoring も、Decisions API と同じく「次のトークンの確率」を読む機能です。つまり、確率で判定する発想そのものは SGLang だけのものではありません。違いは手間です。
図5:どちらも確率で判定できますが、vLLM では準備と呼び出しをアプリ側で行います
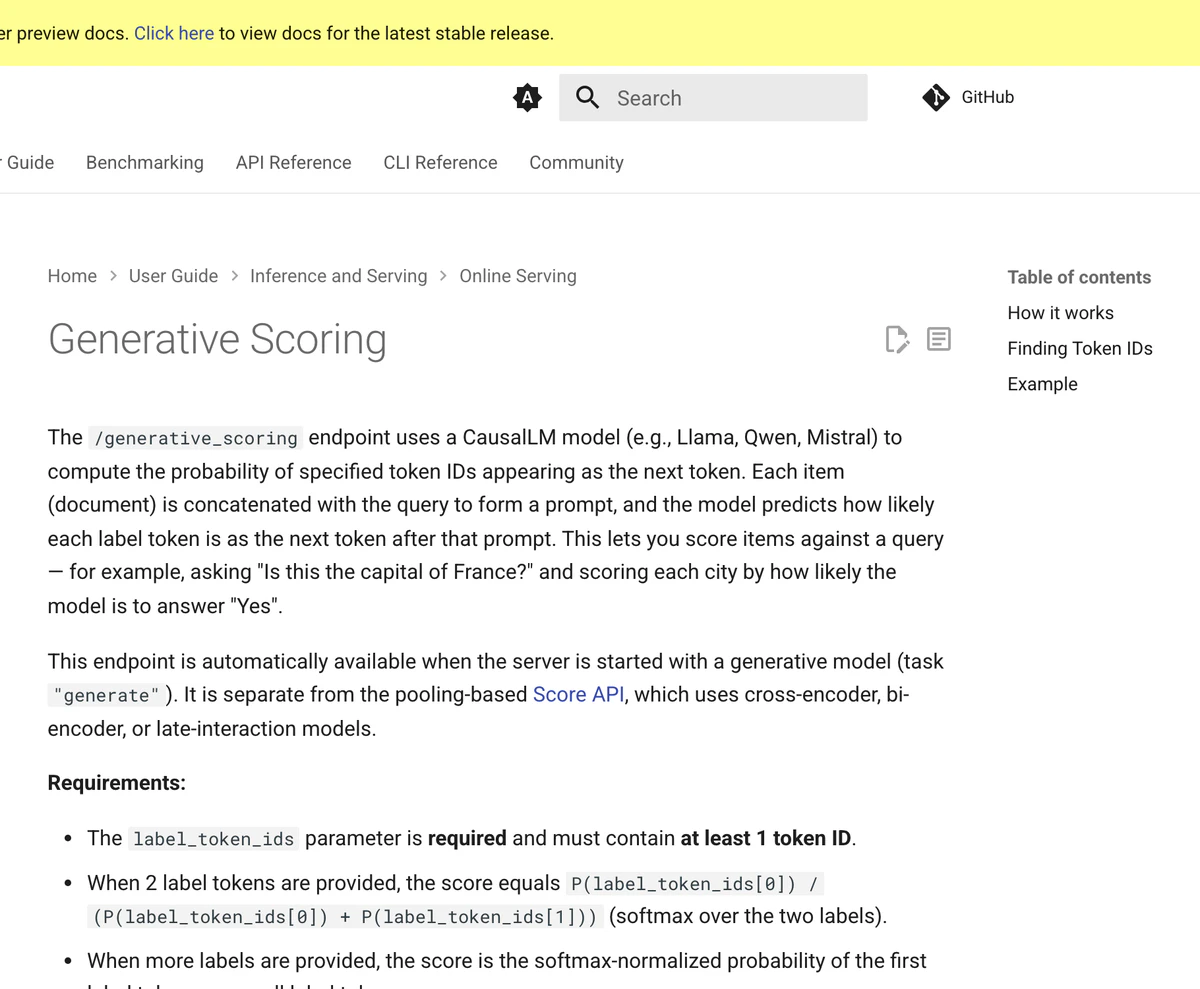
vLLM 公式ドキュメント「Generative Scoring」(2026年10月3日撮影)。返す score は先頭に指定したラベルの確率です
vLLM の /generative_scoring は、先頭に置いたラベルの確率だけを返します。4択で全選択肢の確率を知るには、ラベルの順番を入れ替えて4回呼ぶか、別の方法で計算する必要があります。チャットテンプレートの適用や、記号のトークン番号を調べる作業もアプリ側の仕事です。
Mac に SGLang を入れて動かす
公式の Apple Silicon 手順
SGLang の公式ドキュメントには「Apple Silicon with Metal」というページがあり、Apple の機械学習フレームワーク MLX を使って Mac の GPU で動かす手順が載っています。条件は macOS 14 以降、PyTorch 2.13 系、MLX 0.32.0 以降です。
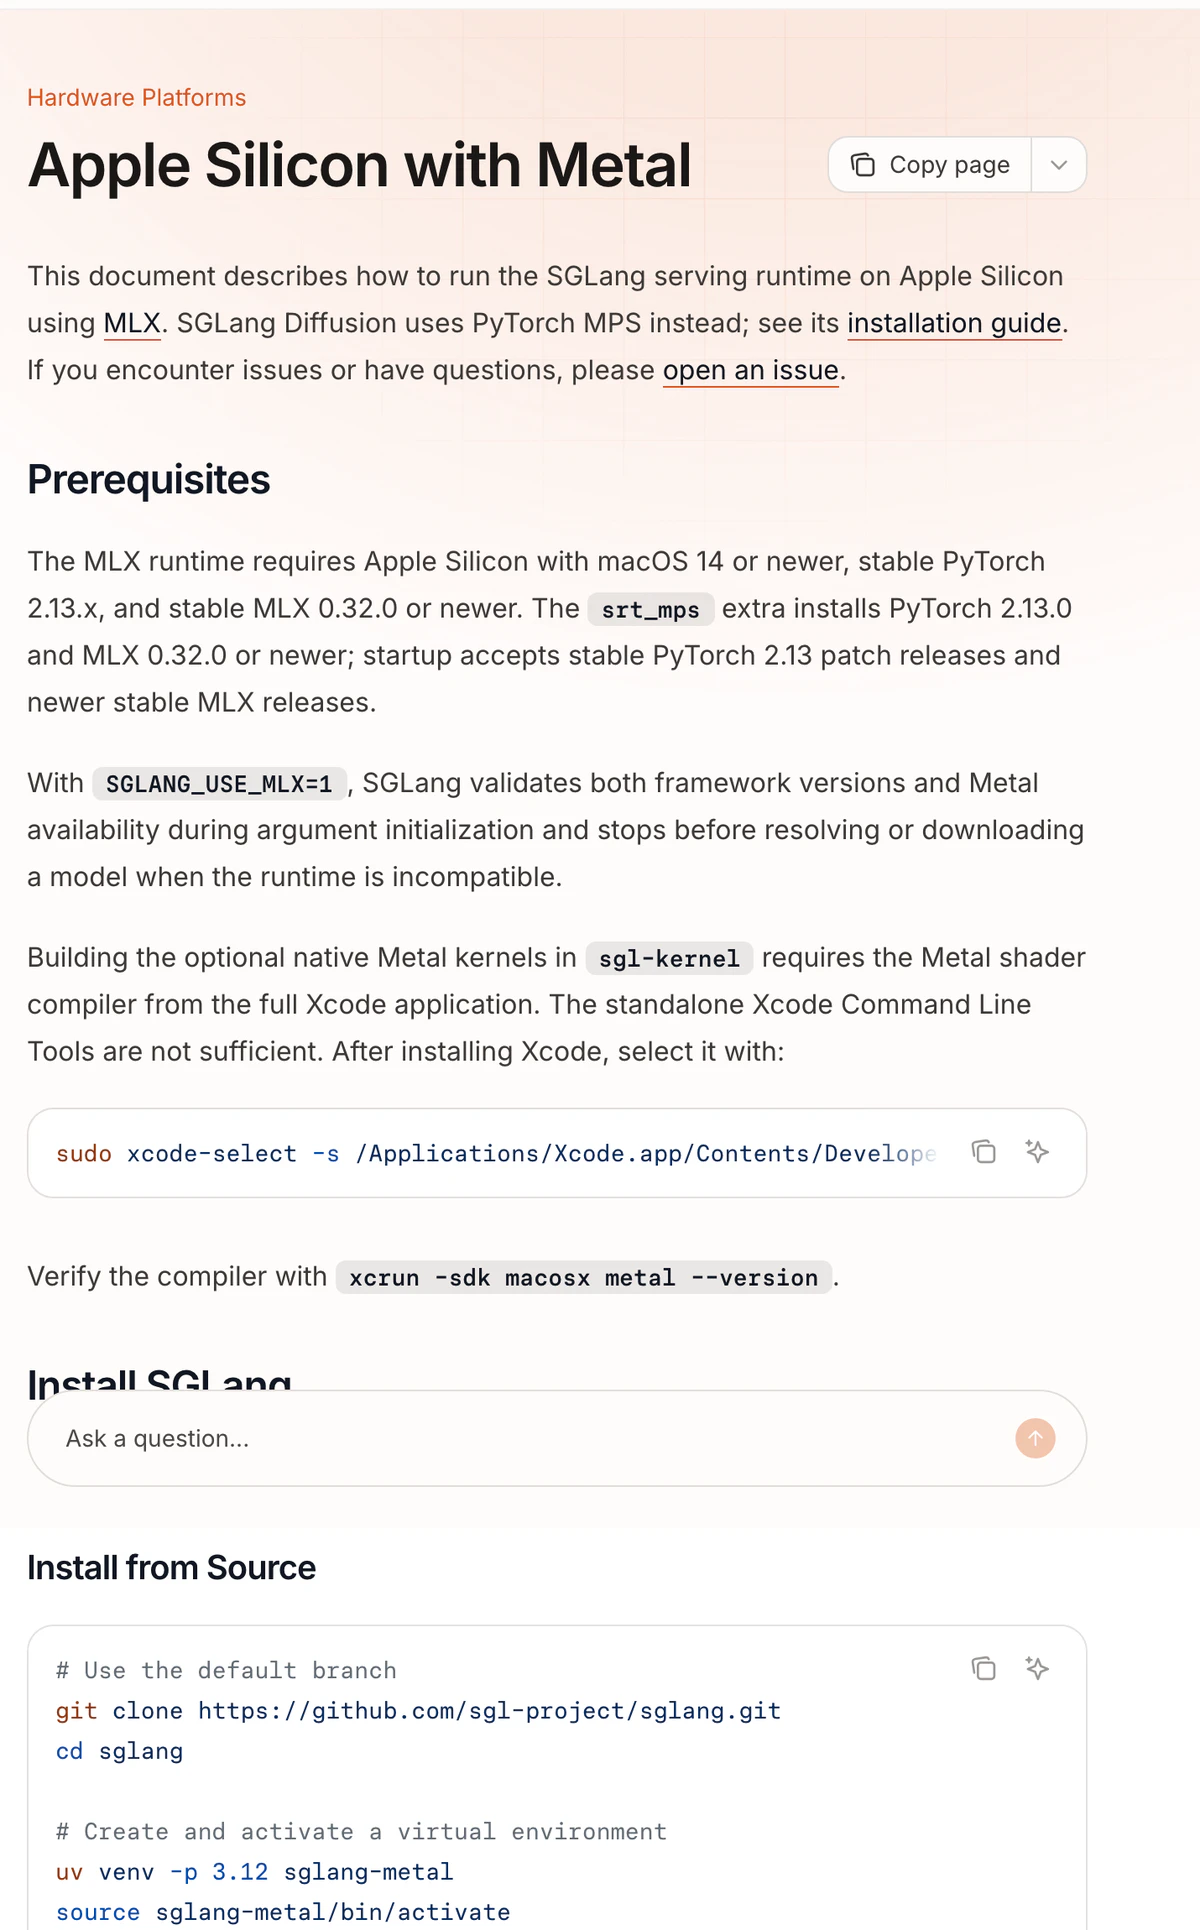
SGLang 公式ドキュメント「Apple Silicon with Metal」(2026年10月3日撮影)
ただ、手順どおりに進めても、v0.5.21 ではそのまま動きませんでした。筆者が通った道を図にまとめます。
図6:赤い枠が今回つまずいた所です
手順1:道具をそろえる
Python の環境を作る uv と、Rust を入れます。v0.5.21 はプレフィックスキャッシュの中核が既定で Rust 製になるなど、ビルド時に Rust の部品を含みます。Rust がないとインストールが「cargo is required」で失敗 しました。公式の Mac 向け手順には書かれていませんでした。
# Homebrew で uv と Rust を入れる
brew install uv rust

# Metal のコンパイラは任意(sgl-kernel をビルドする場合だけ必要)
xcrun -sdk macosx metal --version
手順2:SGLang をインストールする
公式手順は「デフォルトのブランチ(main)を使う」と書いています。筆者は v0.5.21 を検証したかったため、タグを指定して取得しました。
# v0.5.21 を取得する(main を使う場合は --branch を外す)
git clone --depth 1 --branch v0.5.21 https://github.com/sgl-project/sglang.git
cd sglang

# Python 3.12 の仮想環境を作る
uv venv -p 3.12 sglang-metal
source sglang-metal/bin/activate

# Mac 用の設定ファイルに差し替えてインストールする
rm -f python/pyproject.toml && mv python/pyproject_other.toml python/pyproject.toml
uv pip install -e "python[all_mps]"
インストール自体は約42秒で終わりました(PyTorch 2.13.0、MLX 0.32.3、mlx-lm 0.32.0 が入りました)。
手順3:v0.5.21 のタグには起動の修正が足りない
最初の起動では、次のエラーで止まりました。
AttributeError: 'MlxModelRunnerStub' object has no attribute 'kv_cache_configurator'.
調べると、同じ症状を直す修正(PR #41314「[MLX] Fix startup after logical token capacity change」)が9月30日に main ブランチへ入っていましたが、v0.5.21 のタグ(9月29日のコミット)には含まれていませんでした。公式手順どおり main を使えば入っています。筆者は v0.5.21 にこの修正1件だけを当てました。
# v0.5.21 に MLX の起動修正だけを当てる(gh コマンドを使う場合)
gh pr diff 41314 -R sgl-project/sglang > ../pr41314.diff
git apply ../pr41314.diff
手順4:起動する場所に注意する
もう一つ、筆者が自分で招いたつまずきも書いておきます。git clone した sglang フォルダの 一つ上の階層 でサーバーを起動したところ、「No module named 'triton'」で止まりました。Python が、インストールした SGLang 本体ではなく、その場にある sglang フォルダを読み込んでしまったためです。SGLang は Mac で起動するとき、NVIDIA 向けの部品(triton)の代わりを自動で用意しますが、その処理が動きませんでした。sglang という名前のフォルダがない場所で起動すれば解決します。
手順5:Decisions API に必要な起動オプション
ここが一番大事な点です。公式手順のオプションだけで起動すると、チャットは動きますが、Decisions API は 「output_logprobs is empty」という500エラー になります。さらに、チャットで確率(logprobs)を要求すると、サーバーごと停止しました。
MLX 版のソースを読むと、確率を返す処理は --mlx-enable-sampling というオプションを付けたときだけ有効になる作りでした。また Qwen3.8 や Qwen3.5 のように、通常のアテンションと線形アテンションが混在するモデルでは、起動前のチェックで「extra_buffer needs CUDA…」と止まるため、--disable-radix-cache も必要でした。
# sglang フォルダの外(例:別に作った run フォルダ)で起動する
mkdir -p ~/sglang-run && cd ~/sglang-run
source <clone した場所>/sglang/sglang-metal/bin/activate

SGLANG_USE_MLX=1 python -m sglang.launch_server \
  --model-path mlx-community/Qwen3.8-27B-4bit \
  --mlx-enable-sampling \
  --disable-radix-cache \
  --disable-cuda-graph \
  --port 30000
--disable-radix-cache は、共通する入力の途中結果を使い回す仕組みを止めるオプションです。SGLang の得意技の一つを止めることになるので、速さの面では不利な条件で測っています。代わりの --mamba-radix-cache-strategy no_buffer は「overlap scheduling を止めること」が条件でしたが、その --disable-overlap-schedule を付けると、Mac では起動直後の生成でサーバーが停止しました。
起動の様子を録画しました。上がサーバーのログ、下が起動を待つコマンドです(2倍速)。
Qwen3.8-27B(4bit)の起動。入力から起動完了まで約40秒でした(2倍速)
ログを見ると、SGLang は重み約14GBのほかに、会話の途中データ(KV キャッシュ)用として 約69GB を最初に確保していました。メモリ128GBの Mac なので問題ありませんでしたが、メモリの少ない Mac では、確保する割合を --mem-fraction-static で下げる必要があるはずです(今回は試していません)。
実測:Decisions API はどれくらい速いのか
測り方
架空の SaaS のお問い合わせを40件作り、請求(billing)・技術(technical)・営業(sales)・アカウント(account)の4部署に10件ずつ正解を付けました。これを次の2つの方法で判定し、正解率と時間を比べました。
| 方法 | 送り先 | 中身 |
|---|---|---|
| Decisions API | /v1/decisions |
4択の choice 質問1つ |
| JSON 方式(従来) | /v1/chat/completions |
同じ選択肢を書いたプロンプト+JSON スキーマで出力を4択に制限、温度0、思考モードなし |
JSON 方式も、出力を JSON スキーマで縛っているので、でたらめな文字列は返りません。いま実務でよく使われる「Structured Output+LLM」と同じ条件です。どちらも同じサーバー・同じモデルで、ウォームアップの2件を除いて測りました。
まず1件を両方の方法で判定した様子です。上の画面にはサーバー側の処理が流れています。
1件の問い合わせを、Decisions API と JSON 方式で判定(等速)。この録画は3つの質問をまとめて送っています
40件をまとめて測った録画がこちらです。

40件の測定(2.5倍速)。録画中は画面の書き出しも動いているため、下の表の値より少し遅く出ています
結果:1件あたり約3.3倍速く、正解率は同じ
Qwen3.8-27B(4bit)での結果です。同じ条件で3回測り、熱の影響と思われる遅い回を除いた2回の値を並べました。
| 条件 | 正解率 | 1件の時間(中央値) | 同時8件のときの処理量 |
|---|---|---|---|
| Decisions API・質問1つ | 40/40 | 0.17〜0.18秒 | 毎秒 3.9〜4.4件 |
| JSON 方式・質問1つ | 40/40 | 0.57〜0.61秒 | 毎秒 2.1〜2.7件 |
| Decisions API・質問3つ | 40/40 | 0.55〜0.59秒 | — |
| JSON 方式・質問3つ | 40/40 | 1.24〜1.41秒 | — |
図7:1件あたりの時間(中央値)。正解率はすべて40/40でした
差の理由は、JSON 方式が約12トークンを1つずつ生成しているからです。{"team": "technical"} という短い JSON でも、デコードを十数回繰り返します。Decisions API は入力を1回処理するだけなので、その分が丸ごと消えます。
3回のうち1回(長い文章生成の測定を続けた直後)は、全体が遅くなりました(Decisions API 0.28秒、JSON 方式 0.95秒)。それでも差の比率は約3.4倍で、ほぼ変わりませんでした。
質問を3つにすると、どうなるか
「担当部署」「今日中の対応が必要か」「不満の度合い」の3つを同時に聞くと、Decisions API は0.55秒、JSON 方式は1.24秒でした。差は約2.3倍に縮まります。
Decisions API は、質問ごとに別のプロンプトを作って入力を処理します。入力トークンの数を見ると、質問1つで114、3つで231でした。問い合わせ文を質問の数だけ処理しているわけです。NVIDIA の GPU などで途中結果の使い回し(radix cache)が有効なら、共通する問い合わせ部分の計算は再利用できるはずですが、今回の Mac では止めているため、その恩恵は受けていません。
同時に8件送ったとき
8件を同時に送ると、1秒あたりの処理件数は Decisions API が3.9〜4.4件、JSON 方式が2.1〜2.7件でした。Decisions API のほうが多くさばけましたが、1件ずつ送ったとき(毎秒5.5〜5.7件)より減っています。Mac の MLX 版では、入力処理(プリフィル)を相乗りさせても速くならなかったようです。GPU サーバーとは傾向が違う可能性があるので、本番で使うなら、実際の同時アクセス数で測る必要があります。
モデルの大きさで、正解率は大きく変わる
同じ40件を、別のモデルでも試しました。
| モデル | Decisions API | JSON 方式 |
|---|---|---|
| Qwen3-0.6B(4bit) | 27/40・0.06秒 | 34/40・0.06秒 |
| Qwen3.5-35B-A3B(4bit) | 40/40・0.10秒 | 39/40・0.20秒 |
| Qwen3.8-27B(4bit) | 40/40・0.17秒 | 40/40・0.57秒 |
小さな0.6Bでは、Decisions API のほうが正解率が低くなりました。「ログインできない」を請求担当と答えるなど、確率を読む方式でもモデルの理解力は補えません。JSON の生成も短いので、時間の差もほとんど出ませんでした。
35B-A3B は、全体で350億の重みを持ちながら、1トークンの計算には一部(約30億)しか使わない MoE(専門家の組み合わせ)型のモデルです。このモデルでは Decisions API が0.10秒と最も速く、JSON 方式は1件(「年払いに切り替えたら日割りで返金されるか」)を間違えました。
確率の値について気づいたこと
Mac 版では、確率が細かい値にならない場面がありました。たとえば「今日中の対応が必要か」の yes の確率が、0.6B と 35B-A3B の別々のモデルで、小数点以下まで同じ0.2227になりました。計算すると、yes と no の差がちょうど1.25だった場合の値です。確率の元になる値を bf16 という粗い精度で扱っているため、段階的な値になりやすいと考えられます(筆者の推測で、コードでは確かめていません)。並び順(どれを選ぶか)には影響しませんが、確率をしきい値に使うなら、この粒度を知っておくとよいでしょう。
vLLM(vllm-metal)でも同じことを試す
インストールと起動
vLLM の Mac 対応は、vLLM 本体ではなく vllm-metal という別のプラグインです。Homebrew で入れると、仮想環境を意識せずに vllm コマンドが使えます。
# vllm-metal を入れる(約1分36秒)
brew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal

# 同じモデルで起動する(ポートは 8000)
vllm serve mlx-community/Qwen3.8-27B-4bit --port 8000
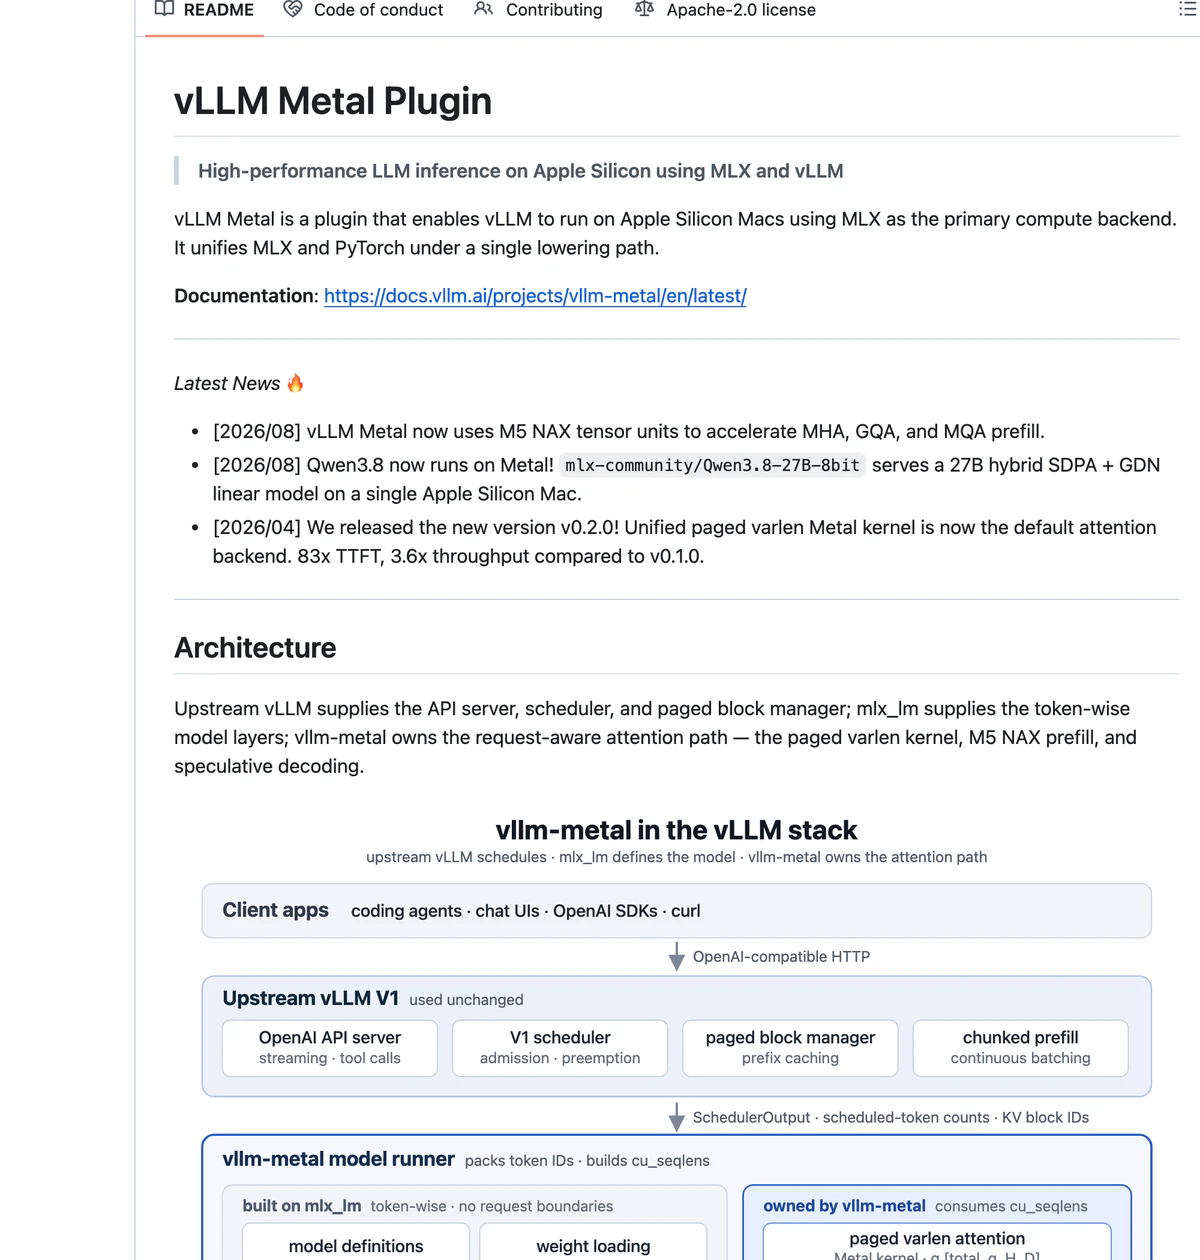
vllm-metal の GitHub ページ(2026年10月3日撮影)。2026年8月に Qwen3.8 の 27B が Mac で動くようになったと書かれています
こちらは追加の設定なしで、そのまま起動しました(約61〜74秒)。SGLang の Mac 版のような修正や起動オプションは不要でした。
generative_scoring で4択を判定する
SGLang の Decisions API が組み立てたものと まったく同じプロンプト(トークン列) を、vLLM の /generative_scoring に送りました。先頭のラベルを入れ替えながら4回呼び、いちばん確率の高い選択肢を答えにします。

vLLM での判定(等速)。最初の1回は約1.3秒かかり、2回目以降は0.2〜0.35秒でした
40件の結果は、次のとおりです。
| 方法(vLLM・Qwen3.8-27B) | 正解率 | 1件の時間(中央値) |
|---|---|---|
/generative_scoring を4回 |
40/40 | 1.04〜1.35秒 |
| チャット+JSON(質問1つ) | 40/40 | 0.94〜1.00秒 |
| チャット+JSON(質問3つ) | 40/40 | 1.95秒 |
答えは40件すべて SGLang と一致し、選んだ選択肢の確率の差も最大0.019でした。同じ重みと同じプロンプトなら、エンジンが違っても判定は同じになります。
時間は SGLang より長くかかりました。/generative_scoring は4回呼ぶ必要があることに加え、vllm-metal ではこの経路で1トークンの生成も行っていました(レスポンスの completion_tokens が1)。
普通の文章生成の速さも比べた
判定とは別に、文章を256トークン生成する速さも両方で測りました(16件、出力の長さは固定)。
| エンジン | 1件ずつ | 同時8件 |
|---|---|---|
| SGLang(MLX) | 毎秒 25.1 トークン | 毎秒 54.3 トークン |
| vLLM(vllm-metal) | 毎秒 18.6 トークン | 毎秒 55.0 トークン |
1件ずつでは SGLang が速く、同時8件ではほぼ同じでした。ただし、2つのサーバーを同時には動かせないため、測った時刻は別々です。熱の状態などの影響も考えられるので、「この Mac・このモデルでは、大きな差はない」くらいに受け取ってください。
どんなときに使うと良いか
ここまでの結果を踏まえて、判定の仕組みの選び方を整理しました。
図8:判定の仕組みの選び方(筆者の整理)。返る確率は正解率ではない点は、どの方式でも共通です
一番うれしいのは、すでに自分の GPU で SGLang を使い、文章生成のサービスを動かしている場合 です。同じサーバーに Decisions API が最初から付いているので、「どの部署へ回すか」「人の確認が必要か」「ツールを使うべきか」といった細かな判定のために、別のサービスを立てる必要がありません。エージェントの中で、検索をやり直すかどうかの判定に使う、といった用途も考えられます。
一方、GPU を持っていないなら、Jev や Clef のような判定専用の API のほうが手軽です。また、判定の理由も文章で欲しい場合や、件数が少ない場合は、今の JSON 方式のままでも十分です。
トラブルシューティング
Mac で試すときに出たエラーと対処を、確認する順番にまとめます。
図9:上から順に確認すると早く解決できます
| 出たエラー | 原因 | 対処 |
|---|---|---|
cargo is required to discover the Rust extension modules |
Rust がない |
brew install rust のあと再インストール |
No module named 'triton' |
起動した場所の sglang フォルダを読み込んだ |
sglang フォルダのない場所で起動 |
'MlxModelRunnerStub' object has no attribute 'kv_cache_configurator' |
v0.5.21 のタグに起動修正がない | main ブランチを使う、または PR #41314 を当てる |
extra_buffer needs CUDA/MUSA/NPU/ROCm/XPU (FLA). |
線形アテンション混在モデルの既定設定が Mac 非対応 |
--disable-radix-cache を付ける |
Decisions API が output_logprobs is empty(500) |
MLX 版で確率を返す処理が無効 |
--mlx-enable-sampling を付けて起動 |
| チャットで logprobs を頼むとサーバーが停止 | 同上 | 同上(付けずに logprobs を頼まない) |
| Decisions API が 400 エラー | 記号が1トークンにならない、思考ブロックが閉じない等 |
return_prompt_token_ids で中身を確認。公式資料の「Errors」を参照 |
まとめ
- SGLang は推論エンジン(モデルを動かして API で提供する係)で、vLLM と同じ種類のソフトです。Jev や Clef のような判定モデルではありません
- Decisions API は、普通のチャットモデルから「選択肢の確率」を直接読む窓口 です。文章を生成しないので、短い判定ほど速くなります
- 筆者の Mac(M5 Max)と Qwen3.8-27B では、判定1件が 0.57秒 → 0.17秒(約3.3倍) になり、正解率は40/40で同じでした。質問3つでも約2.3倍速でした
- vLLM にも確率を読む
/generative_scoringがあり、同じプロンプトなら答えは全件一致しました。違いは「サーバーがどこまで用意してくれるか」です - Mac で SGLang v0.5.21 を使うなら、Rust、起動修正(main または PR #41314)、
--mlx-enable-sampling、--disable-radix-cacheが必要でした
次に試すなら、NVIDIA の GPU サーバーで radix cache を有効にしたときに、質問を増やしたときの時間がどこまで縮むかを確かめたいところです。自分の業務データで、しきい値をどこに置けば人の確認を減らせるかを測るのもおすすめです。
参考リソース
- SGLang v0.5.21 リリースノート(GitHub)
- SGLang 公式ドキュメント:Decision models
- SGLang 公式ドキュメント:Apple Silicon with Metal
- SGLang PR #41208:System One 互換の /v1/systemone と /v1/decisions
- SGLang PR #41314:[MLX] Fix startup after logical token capacity change
- vLLM 公式ドキュメント:Generative Scoring
- vllm-metal(GitHub)
- vLLM(GitHub)
- TypeSafe:System One models と Jev の紹介