
はじめに
「人物は左、商品は右、背景の建物は真ん中に」。画像生成 AI にこう頼んでも、出てくる画像はたいてい「だいたい合っている」止まりです。ブログのアイキャッチのように文字とイラストの位置が決まっている画像を作りたいときは、何度も作り直すことになりがちです。
2026年10月15日、Black Forest Labs(BFL)が公開した FLUX.3 Image Klein(以下 FLUX.3 Klein)は、この悩みに正面から答えるモデルです。文章から画像を作る機能、参照画像を使った編集、そして座標の枠(バウンディングボックス)で「どこに何を置くか」を指定する機能を、5.6B(56億パラメーター)の1つのモデルにまとめています。重みは公開されていて、条件付きで無料で使えます。
一方、ChatGPT で多くの人が使っている画像生成は、OpenAI が2026年9月に出した最新モデル GPT Image 2.5(ChatGPT では「Images 2.5」)です。そこで気になるのは次の点です。
- 手元の Mac で動く無料のモデルは、ChatGPT の画像生成とどこまで張り合えるのか
- 「座標で置ける」ことは、文章で位置を伝える GPT Image 2.5 に比べて本当に有利なのか
- アイキャッチ(16:9)と X 用バナー(5:2)を、同じ構成で作り分けられるのか
この記事では、同じ8種類のお題を ChatGPT(Images 2.5) と Mac 上の FLUX.3 Klein の両方に出し、画質・文字・配置・編集・速さ・費用・ライセンスを並べて比べます。FLUX.3 Klein を Mac で動かす手順とコードも載せます。
想定している読者は、画像生成 AI を ChatGPT などで使ったことがあり、「ローカルで動く画像モデルはどのくらい使えるのか」が気になっている方です。Python の基本が分かれば、手順はそのまま再現できます。
図1:比較の全体像。お題は共通で、違うのは画像になるまでの経路
この記事の確認範囲
- 確認日:2026年10月16日(日本時間)
-
FLUX.3 Image Klein:蒸留版
black-forest-labs/flux-3-image-klein(16ステップ)を、Mac(Apple M5 Max・メモリ128GB)で Diffusers(0.41.0.dev0、GitHub の main)から実行。公式のプロンプト拡張モデル(pup)も同じ Mac で実行 - GPT Image 2.5:chatgpt.com(Chat モード)で生成。API では試していません。ChatGPT では Flare と Sunburst のどちらが使われたかは表示されません
- 出典:Hugging Face 公式ブログ「Welcome FLUX.3 Image Klein in Diffusers」(2026-10-15)、BFL のブログとモデルカード・推論コード、OpenAI の発表と API ドキュメント
- 画像の良し悪しの判定は筆者の目視です。配置は指定した枠を画像に重ねて確認しました。各お題は FLUX が3シード(0〜2)、ChatGPT が1回です
FLUX.3 Image Klein とは
3つの仕事を1つのモデルで
FLUX.3 Image Klein は、BFL の新しい世代「FLUX 3」の2つ目のオープン重みモデルです(1つ目はロボット制御用の FLUX 3 Action)。「Klein」はドイツ語で「小さい」という意味で、FLUX 3 の上位モデルと同じ機能を、小さな体格に収めた版という位置づけです。
1つのモデルで、次の3つをこなします。
| 仕事 | 入力 | できること |
|---|---|---|
| 文章から画像(Text-to-Image) | 文章 | 1枚の画像を新しく作る |
| 参照画像からの生成・編集(Image-to-Image) | 文章+画像(最大10枚) | 夜に変える、別の写真の物を合成する、など |
| 配置の指定(Layout Control) | 文章+座標の枠 | 「この枠にカメラ、この枠に見出し」と置き場所を指定する |
公開されたのは2種類のチェックポイント(学習済みの重みのファイル)です。
| チェックポイント | ステップ数 | CFG | 向いている用途 |
|---|---|---|---|
flux-3-image-klein(蒸留版) |
16 | なし | 普段の生成・編集。BFL の API もこれ |
flux-3-image-klein-base(Base 版) |
50 | あり(3.5) | LoRA などの追加学習、研究 |
蒸留(distillation)は、大きく手間のかかる手順を、少ない手順でまねできるように学習し直すことです。Base 版が50回かけてノイズを取り除くところを、蒸留版は16回で済ませます。CFG(Classifier-Free Guidance)は、プロンプトありとなしの2回分を計算して差を強める仕組みで、なくせば1回分の計算で済みます。BFL の README では、H200 で 1MP(約100万画素)の画像を作る時間が蒸留版で約3秒、Base 版で約12秒と書かれています。
Hugging Face の H100 での計測では、蒸留版が 1024×1024 を 1.93秒 で作り、参照画像を1枚入れた編集は 3.87秒でした。参照画像はそのぶんトークン(モデルが扱う単位)が増えるため、時間がほぼ倍になります。
中身は「4つの部品」と「2段階の本体」
図2で、短い依頼が画像になるまでの流れを見てください。紫の pup から始まり、本体の前段・後段を経て、右端の VAE で画像に戻ります。
図2:FLUX.3 Klein の中身(HF ブログとモデルカードをもとに作図)
部品は次の4つです。
- pup(プロンプト拡張モデル):Qwen3.5-9B を BFL が調整した 9B のモデル。「午後の光の商品写真」程度の短い依頼を、被写体・光・構図・色まで決めた英語の長いキャプションに書き直します。依頼は日本語でもかまいませんが、出力は英語です
- テキストエンコーダー(Qwen3-VL-4B):キャプションを読み、数値の列に変えます。最終層だけでなく、36層のうち8層の途中結果を束ねて渡すのが特徴です
- 本体(5.6B のトランスフォーマー):ここで画像を描きます。前段の5ブロックでは「文章」「生成中の画像」「参照画像」がそれぞれ別の重みで下ごしらえされ、後段の28ブロックでは全部を1列につないで、お互いを参照しながら仕上げます
- VAE:画像を小さな潜在表現(16×16 画素を1トークンにまとめたもの)に変えたり、戻したりする部品です。FLUX.2 と同じものです
pup は「付けたほうがよい」ではなく「付ける前提」
ここは使う前に必ず知っておきたい点です。BFL のモデルカードと推論コードの README には、太字で 「プロンプト拡張なしでモデルを使わないこと」 と書かれています。本体は pup が書く長いキャプションで学習されているため、短い文章をそのまま渡すと、ありきたりな画像になるそうです。
ところが、Diffusers のパイプラインは pup を自動では呼びません。Diffusers の例のように pipe(prompt="a red fox") と書くだけでは、本来の力を出せない使い方になります。この記事では、公式の推論コードと同じシステムプロンプト・同じデコードの設定で pup を Mac 上で動かし、そのキャプションを本体に渡しました(公式との細かな違いと手順は後半で紹介します)。pup を通さなかった場合の画像も、比較のために作っています。
座標で配置する仕組み
枠は [上, 左, 下, 右] を 0〜1000 で書く
配置の指定では、プロンプトの最後に JSON の配列で「枠の表」を付けます。1行が1つの物で、id(名前)、bbox(枠)、desc(説明)を持ちます。キャプションの本文では、その物を <camera_1> のように id で呼びます。
枠の数字は [y_min, x_min, y_max, x_max]、つまり「上・左・下・右」の順で、画像の大きさに関係なく 0〜1000 の目盛りで書きます。図3でこの読み方と、同じ枠を別の縦横比に使い回す様子を確認してください。
図3:枠の座標の読み方。同じ数字が縦横比の違う画面にもそのまま使える
ふだん目にする座標は (x, y) の順が多いので、縦が先という点はつまずきやすいところです。x を先に書くと、縦長の枠が横長になってしまいます。なお、公式の推論コードに渡す boxes.json は 0〜1 の小数で書き、内部で 0〜1000 に変換されます。Diffusers に直接キャプションを渡すときは 0〜1000 です。
目盛りが画像の大きさに依存しないので、16:9 のアイキャッチで決めた枠を、そのまま 5:2 のバナーにも使えます。今回の検証でも、この性質を試しました。
なぜ枠が効くのか
FLUX.3 では、トランスフォーマーの中で各トークンに「どこにあるか」を教える位置の情報(RoPE と呼ばれる回転式の位置埋め込み)を、時刻・縦・横・並び順の4つの軸で持たせています。参照画像も出力画像と同じ縦横の座標を使うため、「参照画像のこの場所」と「出力のこの場所」が対応します。編集で src_bbox(元の場所)から tgt_bbox(移動先)へ物を動かせるのは、この仕組みのおかげです。
また、文章と参照画像のトークンは常に「時刻0=もう完成している文脈」として扱われ、生成中の画像だけが現在の時刻で処理されます。参照画像が出力とほとんど同じに見えても、モデルは「描き直す対象」ではなく「手がかり」として読むわけです。
ただし、モデルカードには 「枠は置き場所と大きさの目安で、ピクセル単位のマスクではない」 とも書かれています。枠からのはみ出しや少しのずれは起こりうる、という前提で使うのが正確です。
比べる相手:GPT Image 2.5
OpenAI は2026年9月8日に ChatGPT Images 2.5 を発表しました。ChatGPT・ChatGPT Work・Codex のすべてのプランで使え、Images 2.0 と比べて待ち時間を最大50%短くしたとしています。参照写真の人物や物の特徴を保つ力、狙った箇所だけを直す編集、何度も直したときの一貫性が改善点として挙げられています。
API では2つのモデルに分かれています。
| モデル | 位置づけ(OpenAI の説明) |
|---|---|
gpt-image-2.5-flare |
ほとんどの用途の標準。GPT-Image-2 より高品質で、待ち時間は50%短い |
gpt-image-2.5-sunburst |
時間をかけて、編集をより精密に制御する用途向け |
料金は2つとも同じで、100万トークンあたり文章入力 5ドル、画像入力 8ドル、画像出力 30ドル です。1枚あたりの値段は品質(low〜max)と大きさで変わります。参考までに、1つ前の GPT Image 2 の 1024×1024 は low 0.006ドル、medium 0.053ドル、high 0.211ドルです。
FLUX.3 Klein と比べるうえで大事なのは、API ドキュメントにバウンディングボックスで配置を指定する機能の記載がない点です。編集用のマスク(変えてよい範囲を塗った画像)は使えますが、ドキュメント自身が「形に厳密に従うとは限らない」「レイアウトが重要な構図は正確に置くのが難しいことがある」と書いています。つまり GPT Image 2.5 で位置を指定する手段は、基本的に文章です。
そこで今回は、FLUX.3 Klein には枠を、ChatGPT には同じ枠を「横40〜60%・縦0〜60%」のような文章に直して伝え、どこまで位置が合うかを比べました。
| 項目 | FLUX.3 Image Klein(蒸留版) | GPT Image 2.5 |
|---|---|---|
| 提供のかたち | 重みを公開(Hugging Face で規約に同意) | ChatGPT・API のみ |
| 大きさ | 本体 5.6B(テキストエンコーダー別) | 非公開 |
| 位置の指定 | 座標の枠(0〜1000) | 文章、編集はマスク |
| 参照画像 | 最大10枚 | 複数可(ドキュメントの例は4枚) |
| 最大サイズ | 4K まで(BFL) | 1辺3840px・約830万画素まで |
| 料金 | 自分の PC なら電気代のみ。BFL API は1枚 約0.9セント〜 | ChatGPT はプランの範囲、API は従量課金 |
| 生成画像の印 | 推論コードは EXIF に「AI generated」 | C2PA メタデータと見えない電子透かし |
検証のやり方
8つのお題
お題はすべて日本語で書き、ChatGPT にも FLUX.3 Klein の pup にも同じ文章を渡しました。ChatGPT には頭に「画像を生成してください。」だけを足しています。
| # | お題 | 見たいこと |
|---|---|---|
| 1 | 午後の光が差す木のデスクに置いた、黒いワイヤレスイヤホンケースの商品写真(正方形) | 写真としての質感 |
| 2 | 英字の見出し「OPEN WEIGHTS NIGHT」と日時・3語の副題が入った縦長ポスター | 英字の正確さ |
| 3 | 左に日本語の見出し「画像生成を座標で操る」と小見出し、右に枠で囲んだカメラ・植木鉢・ロボット(16:9) | 日本語の文字と、アイキャッチの構成 |
| 3b | 3 と同じ構成の 5:2 バナー | 縦横比を変えても構成を保てるか |
| 4 | 街角の写真。女性は左、エスプレッソの屋台は右、時計塔は中央の上半分(16:9) | ふつうの配置指定 |
| 5 | 白地の 3×3 マスに、指定した9つの物を1つずつ | 多数の物の並び |
| 8 | 部屋の写真。小さな風船は右下の隅、大きな観葉植物は左、黄色い椅子は中央下、青い時計は右上、本の山は左下(16:9) | 不自然な位置・大きさの指定 |
| 6・7 | 1 の画像を「夜に変える」「ケースだけ右へ動かす」 | 編集で他の部分を残せるか |
(番号の 6・7 は編集、8 はあとから追加した難しい配置のお題です。)
配置のお題では、FLUX.3 Klein には座標の枠を渡し、ChatGPT には同じ枠を「横40〜60%・縦0〜60%」のような文章で伝えました。さらに FLUX.3 Klein には、ChatGPT と同じ文章だけを渡す回(枠なし)も用意して、「枠そのものの効果」と「モデルの違い」を分けて見られるようにしました。
進め方
- ChatGPT:お題ごとに新しいチャットを開いて1回だけ生成(5:2 バナーと編集は、元の画像と同じチャットで続けて依頼)
- FLUX.3 Klein:pup でキャプションを作り、本体でシード 0・1・2 の3枚を生成。記事に並べるのは、事前に決めたとおりシード0の画像です
- 配置は2つの方法で確認しました。1つは指定した枠を画像に重ねて目で見る方法、もう1つは物体検出モデル OWLv2 で各物の位置を自動で検出し、指定した枠との**重なり具合(IoU)**と「物の中心が枠の中にあるか」を数える方法です
IoU(Intersection over Union)は、2つの四角形の重なった面積を、両方を合わせた面積で割った値です。完全に一致すれば1、まったく重ならなければ0になります。
環境
| 項目 | 内容 |
|---|---|
| Mac | Apple M5 Max(メモリ128GB)、macOS 26 |
| Python | 3.12(uv で作った仮想環境) |
| PyTorch | 2.14.1(MPS バックエンド) |
| Diffusers | 0.41.0.dev0(GitHub の main) |
| Transformers | 5.20.0 |
| FLUX.3 Klein | 蒸留版、bf16(VAE は fp32)、16ステップ |
| pup | bf16、貪欲デコード、presence penalty 1.5(公式と同じ値) |
| ChatGPT | chatgpt.com(Chat モード)、2026-10-16 10:50〜11:10 |
結果:先に結論
8つのお題の結果を、先に表でまとめます。○△× は筆者の判定です。
| 比べたこと | GPT Image 2.5(ChatGPT) | FLUX.3 Klein(Mac) |
|---|---|---|
| 写真の質感(お題1) | ◎ 光・木目・小物まで自然 | ○ 自然。小物は少なめで素直な構図 |
| 英字(お題2) | ◎ 正確 | ◎ 正確 |
| 日本語(お題3) | ◎ 見出し・小見出しとも正確 | △ 遠目には読めるが「操」が13枚すべてで崩れた |
| ふつうの配置(お題4・5) | ◎ 文章の指示でほぼ正しい位置 | ◎ 枠ありで全部の物が枠内。3×3 は文章だけでも全問正解 |
| 不自然な配置(お題8) | ○ 5つ中4つが枠内(重なり 0.54) | ◎ 枠ありで15/15が枠内(重なり 0.81) |
| 16:9 → 5:2(お題3b) | ◎ 会話で頼むだけでほぼ同じデザイン | ○ 同じ枠で配置は保てる。絵柄は別の1枚 |
| 夜にする編集(お題6) | ◎ 卓上ライトまで描き足した。画像の縦横比が変わった | ○ 夜らしくなるかはシード次第(3枚中2枚は十分) |
| 1つだけ動かす編集(お題7) | ◎ 文章だけで右へ移動、ほかはほぼそのまま | × 文章だけでは動かず / ◎ 枠を付けると指定どおり移動 |
| 1枚の時間 | 約26秒 | 約28〜48秒(pup 込み、休ませた場合)。連続生成では約44〜66秒 |
| 費用 | ChatGPT のプランの範囲 | 電気代のみ(Mac がある前提) |
ひとことで言うと、完成度と日本語は GPT Image 2.5、位置を数字どおりに決める力は FLUX.3 Klein です。以下、お題ごとに見ていきます。
お題1:写真の質感
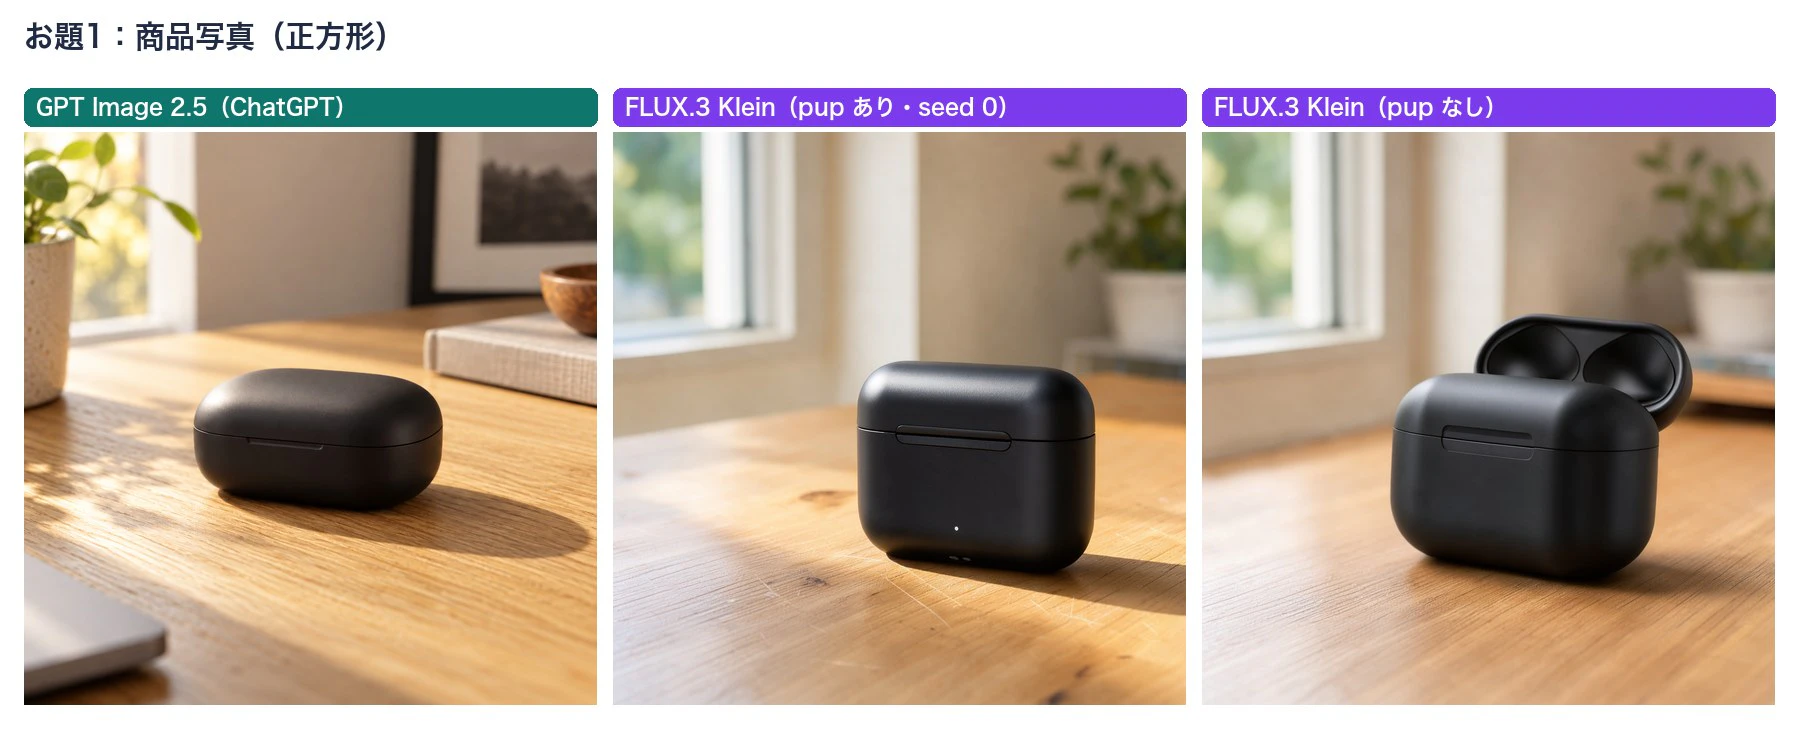
まずは基本の商品写真です。左が ChatGPT、中央が pup を通した FLUX.3 Klein、右が pup を通さず日本語の依頼をそのまま渡した FLUX.3 Klein です。
お題1。左から ChatGPT、FLUX(pup あり)、FLUX(pup なし)
ChatGPT は、木目に落ちる葉の影、植木鉢・本・木の器といった小物まで描き込み、雑誌の商品写真のような仕上がりです。FLUX.3 Klein(pup あり)は小物を減らした素直な構図で、ケースの質感や窓からの光は十分に自然です。pup はキャプションに「小さな白い表示ランプ」「左から差す午後の光と右へ伸びる影」などの細部を書き足していて、実際に画像にも反映されています。
右の pup なしは、依頼にないのにケースのふたが開いた状態で描かれました。日本語の短い依頼でもそれらしい写真にはなりますが、細部はモデルまかせになる、というのが pup の有無の違いです。
お題2:英字ポスター
お題2。英字はどちらも正確
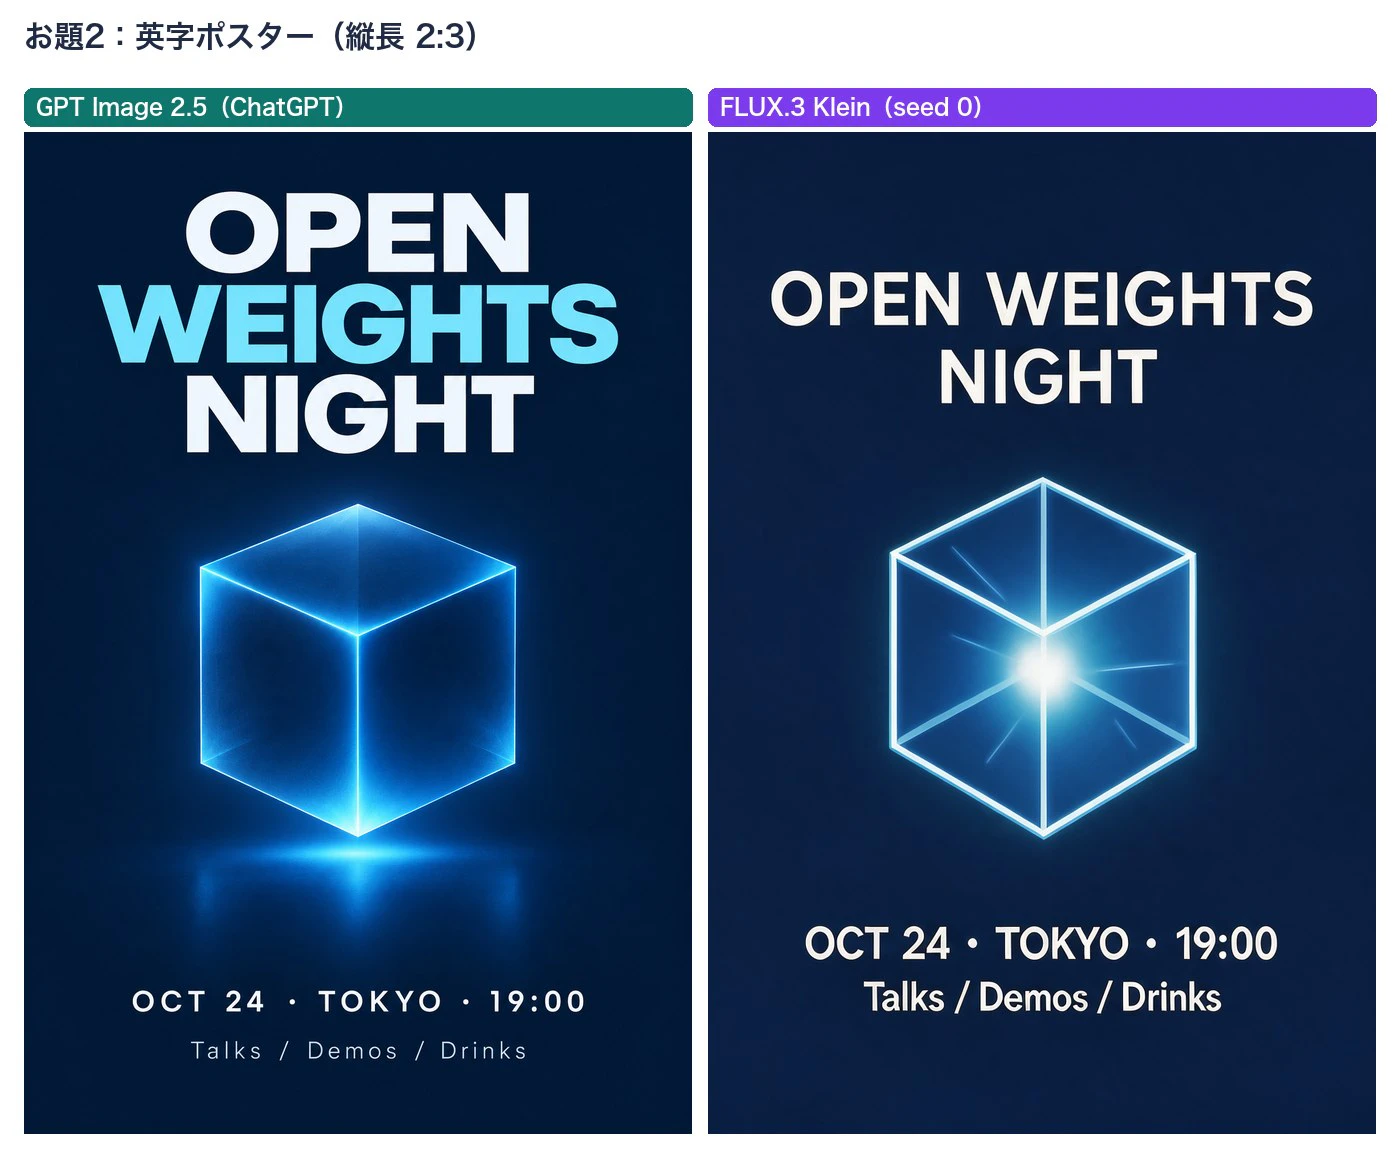
英字は両者とも完璧でした。見出し「OPEN WEIGHTS NIGHT」、日時の「OCT 24 · TOKYO · 19:00」、「Talks / Demos / Drinks」の3行すべてで、つづりの誤りはありません。ChatGPT は見出しの「WEIGHTS」だけ色を変えるなどデザインの工夫まで入れてきます。FLUX.3 Klein は文字をそのまま素直に置いた印象で、立方体の光り方はこちらのほうが控えめです。
お題3:日本語のアイキャッチ
ここが一番はっきり差が出たところです。
お題3。左が ChatGPT、右が FLUX(枠あり・seed 0)
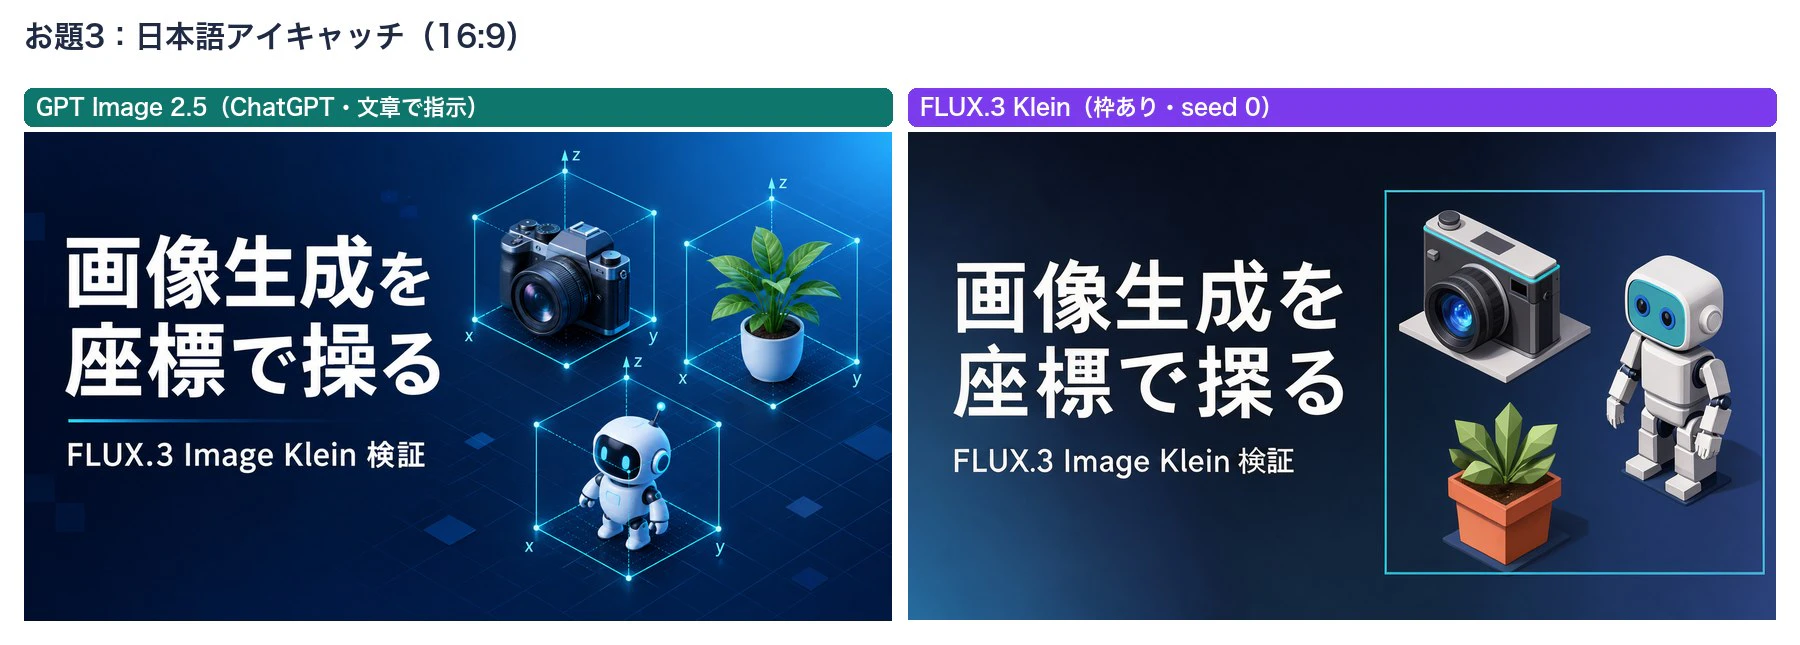
遠目には、どちらも「画像生成を座標で操る」「FLUX.3 Image Klein 検証」と読めます。構図は FLUX.3 Klein のほうが指定に忠実で、見出しは左、3つの物は右の枠の中に収まりました(枠ありの3枚で、カメラ・植木鉢・ロボットの重なりは平均 0.80)。ChatGPT には座標を伝えていないので、3つの物はそれぞれ別の立方体の枠に入る、ChatGPT なりの解釈になっています。
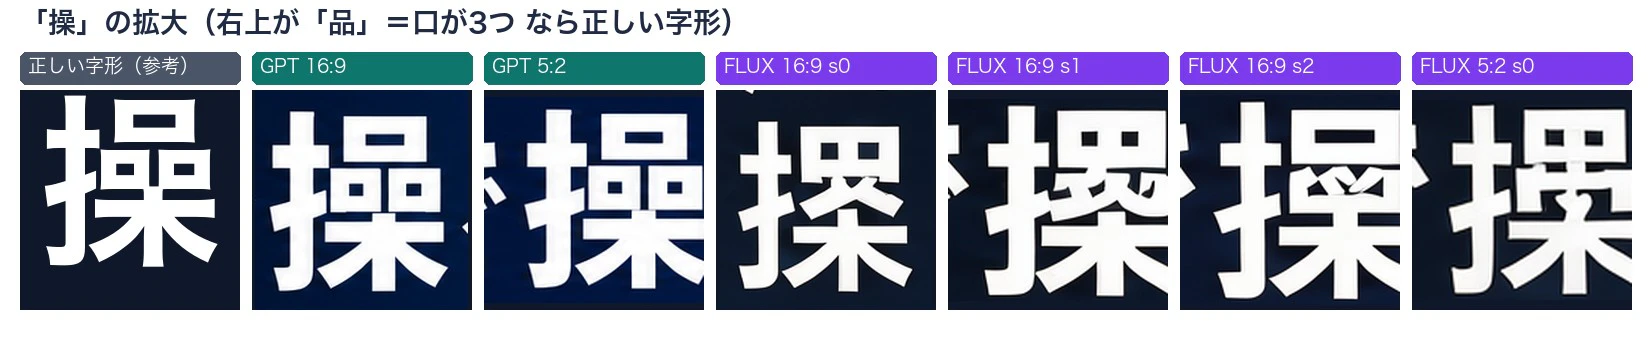
ところが拡大すると、FLUX.3 Klein の「操」は正しい字形ではありませんでした。
「操」の拡大。ChatGPT は正しく、FLUX は13枚すべてで崩れた(うち4枚を掲載)
「操」の右上は「品」(口が3つ)ですが、FLUX.3 Klein は口が2つになったり、「探」に近い形になったりしています。枠あり・なし、16:9・5:2、3つのシードの計12枚に pup なしの1枚を足した 13枚すべてで崩れていました。ほかの文字(画像生成を座標で・る・検証)はおおむね正しく、pup なしの1枚では「標」も崩れていました。ChatGPT は 16:9 と 5:2 の両方で「操」まで正確です。
アイキャッチに日本語の見出しを焼き込むなら、現時点では GPT Image 2.5 のほうが安心です。FLUX.3 Klein を使うなら、絵の部分だけを作り、文字は画像編集ソフトで重ねるのが確実です。
お題3b:同じ構成で 5:2 のバナーにする
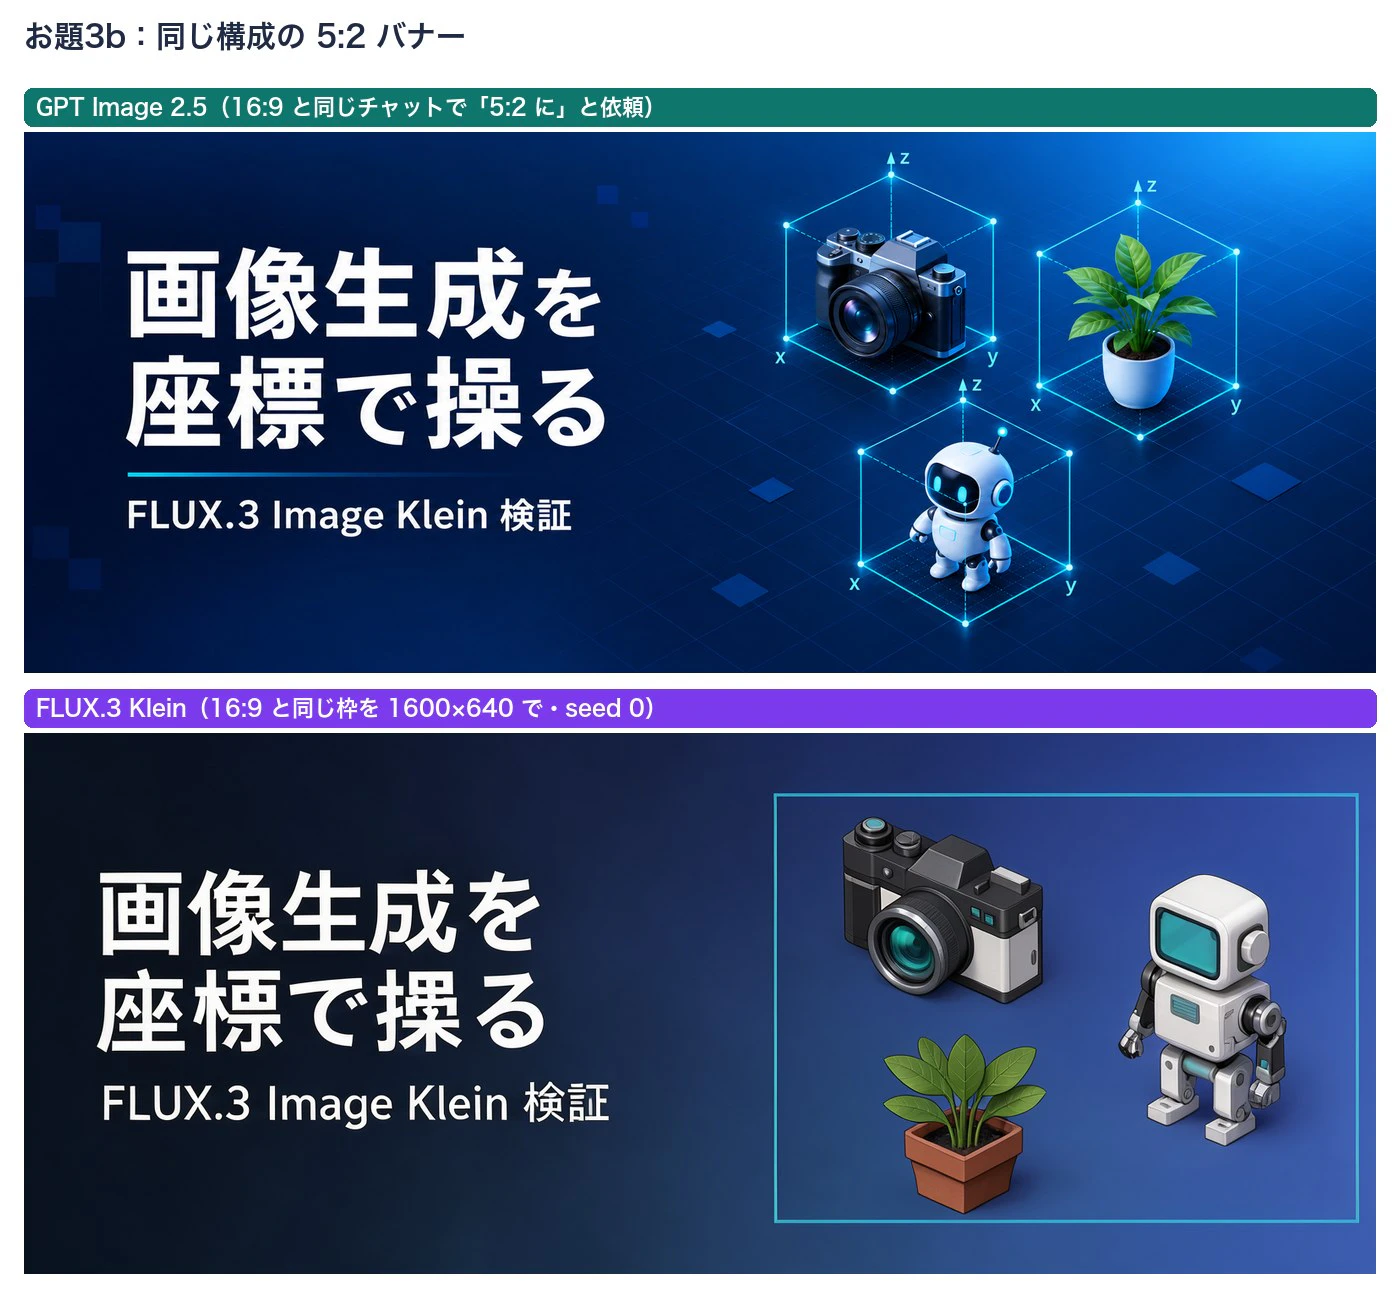
お題3b。上が ChatGPT、下が FLUX(16:9 と同じ枠)
ChatGPT は、16:9 を作った同じチャットで「同じデザインで 5:2 に」と頼むだけで、見出し・3つの物・背景の模様まで、ほぼ同じデザインのバナーを作りました。1983×793 で、X のヘッダー用にそのまま使える比率です。
FLUX.3 Klein は 16:9 と同じ枠を 1600×640 で使いました。配置はきちんと保たれ(見出しは左、物は右の枠内)、文字も読めます。ただし、カメラやロボットの絵柄は 16:9 版とは別物です。FLUX.3 Klein にとっては「同じ設計図で描いた別の1枚」なので、16:9 版そのものを横に伸ばしたいなら、16:9 の画像を参照画像として渡す編集にするのがよさそうです(今回は試していません)。
お題4・5:ふつうの配置
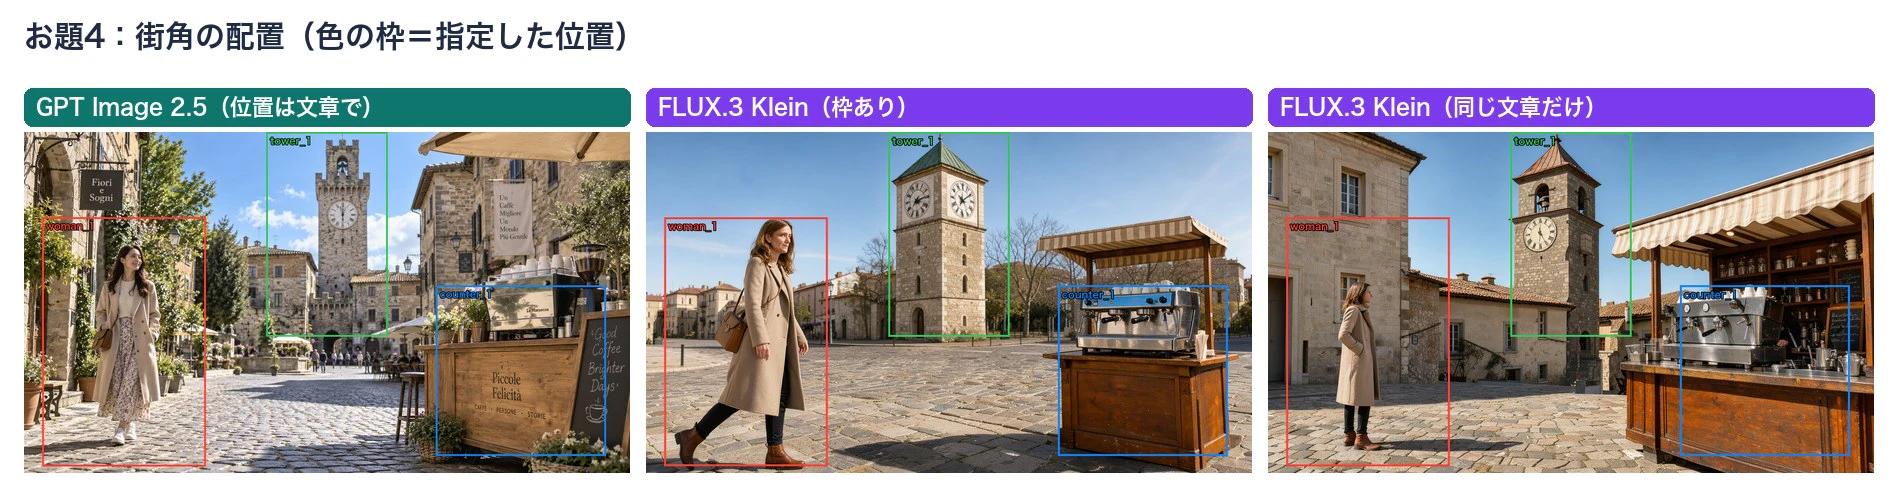
お題4。色の枠が指定した位置
色の枠が指定した位置です。街角のお題では、ChatGPT も「横0〜30%」などの文章の指示をよく守り、3つとも物の中心が枠の中に入りました。FLUX.3 Klein の枠ありは、女性・時計塔・屋台が枠にぴったり収まっています。一方、FLUX.3 Klein に ChatGPT と同じ文章だけを渡すと、女性が中央寄りに立ち、時計塔が左にずれるなどの乱れが出ました(3シード中1枚で時計塔の中心が枠外)。
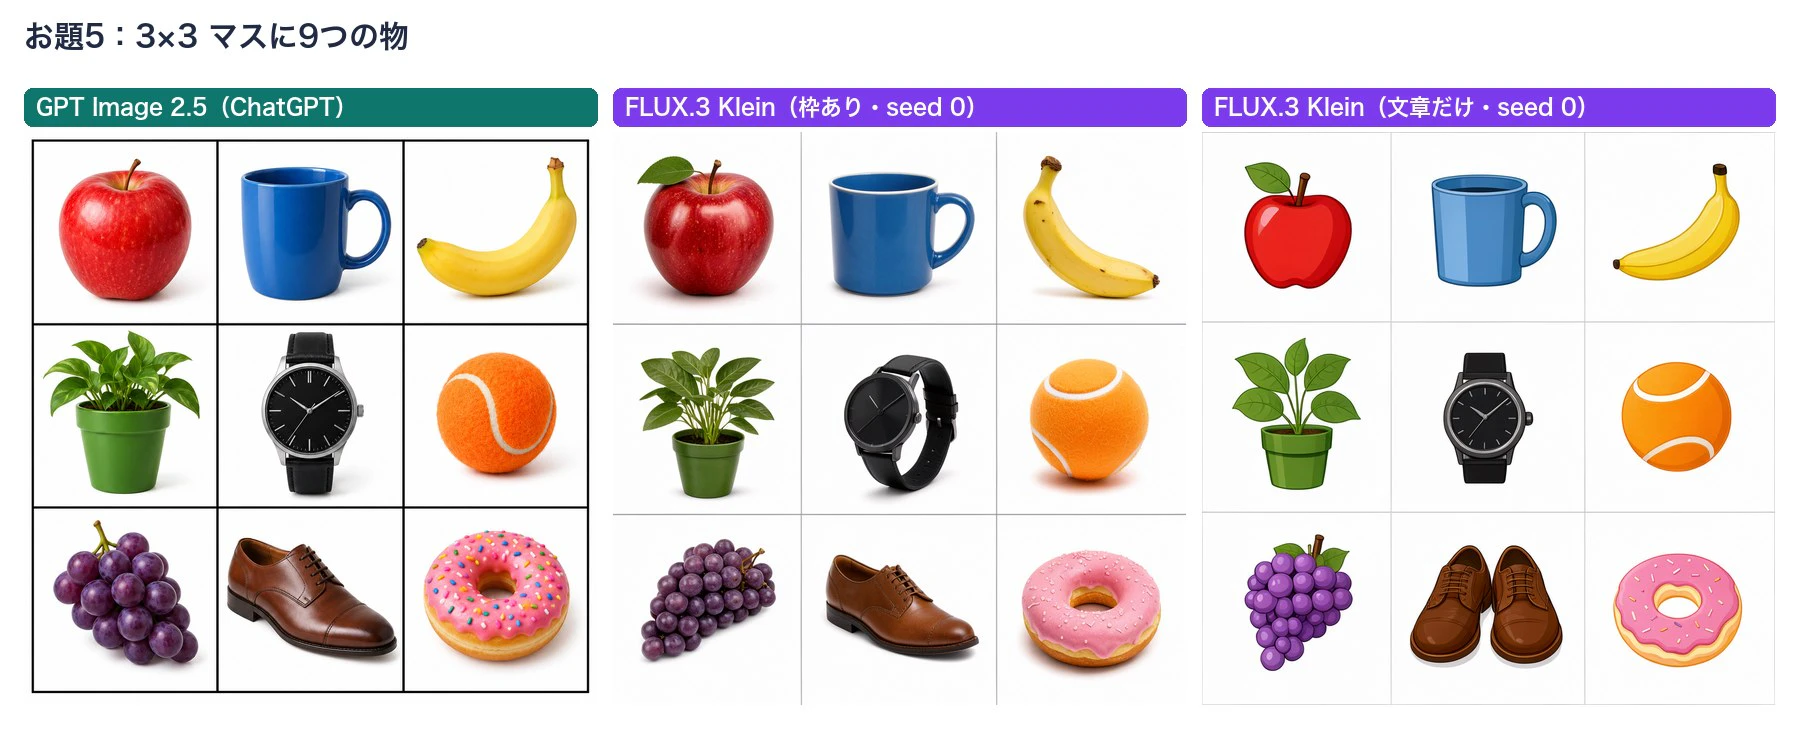
お題5。どれも9マス全問正解
3×3 のマス目は、ChatGPT、FLUX.3 Klein の枠あり、文章だけ、pup なしのすべてで9マス全問正解でした。マス目のように規則正しい並びは、文章だけでもどのモデルも正確に描けます。
お題8:不自然な位置・大きさの配置
位置の指定がはっきり効いたのが、このお題です。「小さな風船は右下の隅」「時計は右上」といった、ふつうの写真ならそこに置かない配置を指定しました。
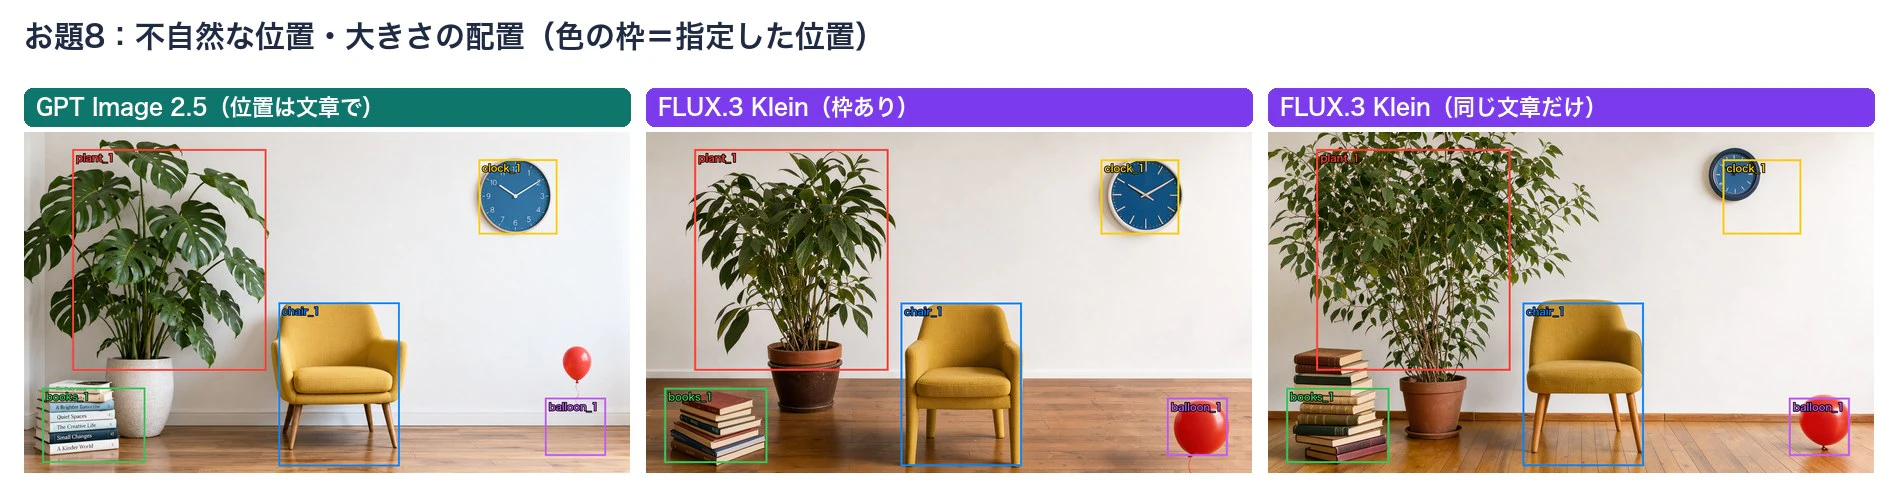
お題8。FLUX(枠あり)だけが5つとも枠に収まった
ChatGPT は全体としてよく指示に従っていますが、風船が枠より上に浮かび、植物は枠からはみ出しています。FLUX.3 Klein の枠ありは、5つの物が枠の中にほぼ収まりました。同じ文章だけを渡した FLUX.3 Klein は、植物が大きすぎ、時計が左にずれています。
物体検出モデル OWLv2 で測った「指定した枠との重なり(IoU)」をグラフにすると、次のようになります。
図4:指定した枠と、検出した物の重なり(IoU)。FLUX は3シードの平均
お題8では FLUX.3 Klein(枠あり)が 0.81、ChatGPT が 0.54、FLUX.3 Klein(文章だけ)が 0.53 でした。ChatGPT と FLUX.3 Klein の文章だけがほぼ同じ値なので、差を生んだのはモデルの地力というより枠という入力手段そのものだと考えられます。お題4は、全身の人物に対して指定した枠が横に広めだったため、どの方法でも値は低めに出ていますが、順位は同じでした。
なお、OWLv2 の検出枠は人物では体の一部しか囲まないことがあり、数値は目安です。比較画像の目視でも、同じ傾向であることを確認しています。
お題6・7:編集
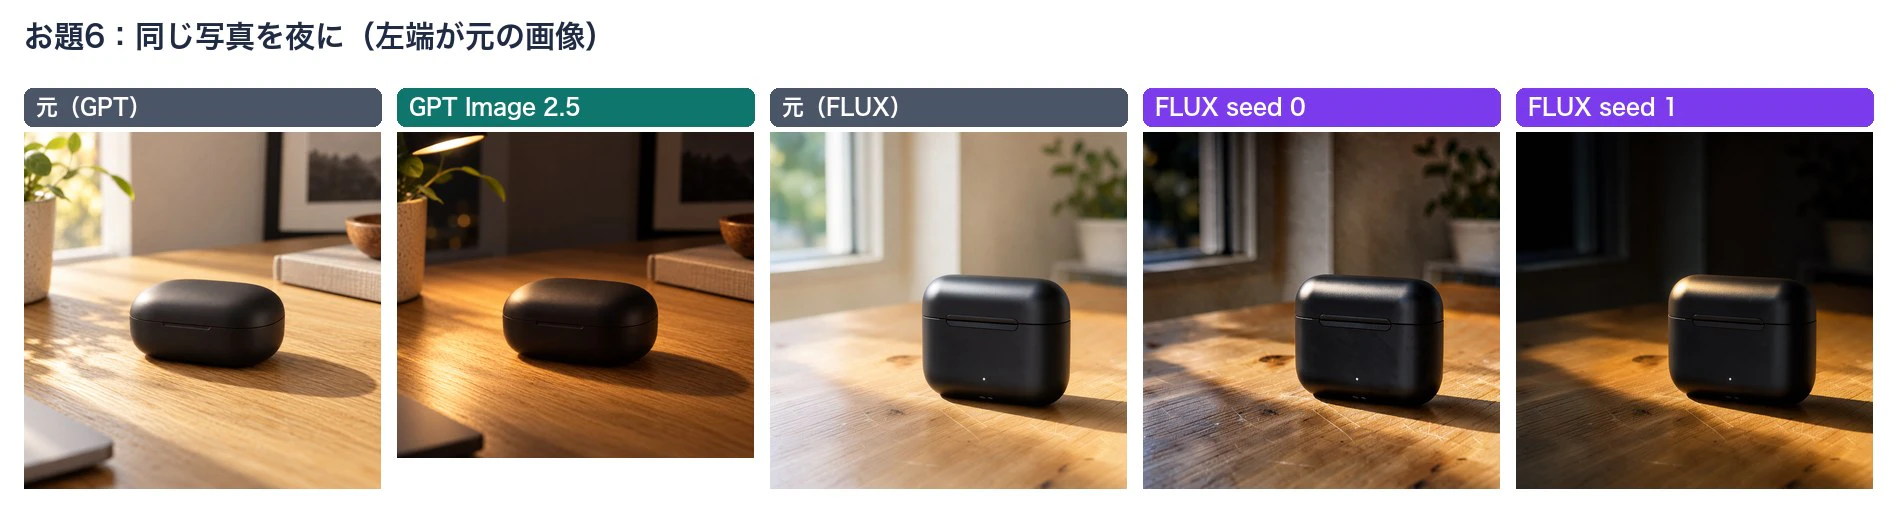
お題6。左2枚が ChatGPT(元・編集後)、右3枚が FLUX(元・seed 0・seed 1)
「夜に変える」は、ChatGPT が卓上ライトを描き足し、窓の外を夜景にするなど、気の利いた変え方をしました。ただし、画像の大きさが 1254×1254 から 1312×1199 に変わり、正方形ではなくなっています。FLUX.3 Klein は構図と大きさを保ったまま暗くしましたが、シード0は「夕方」程度で、夜らしさが十分だったのは3枚中2枚でした。
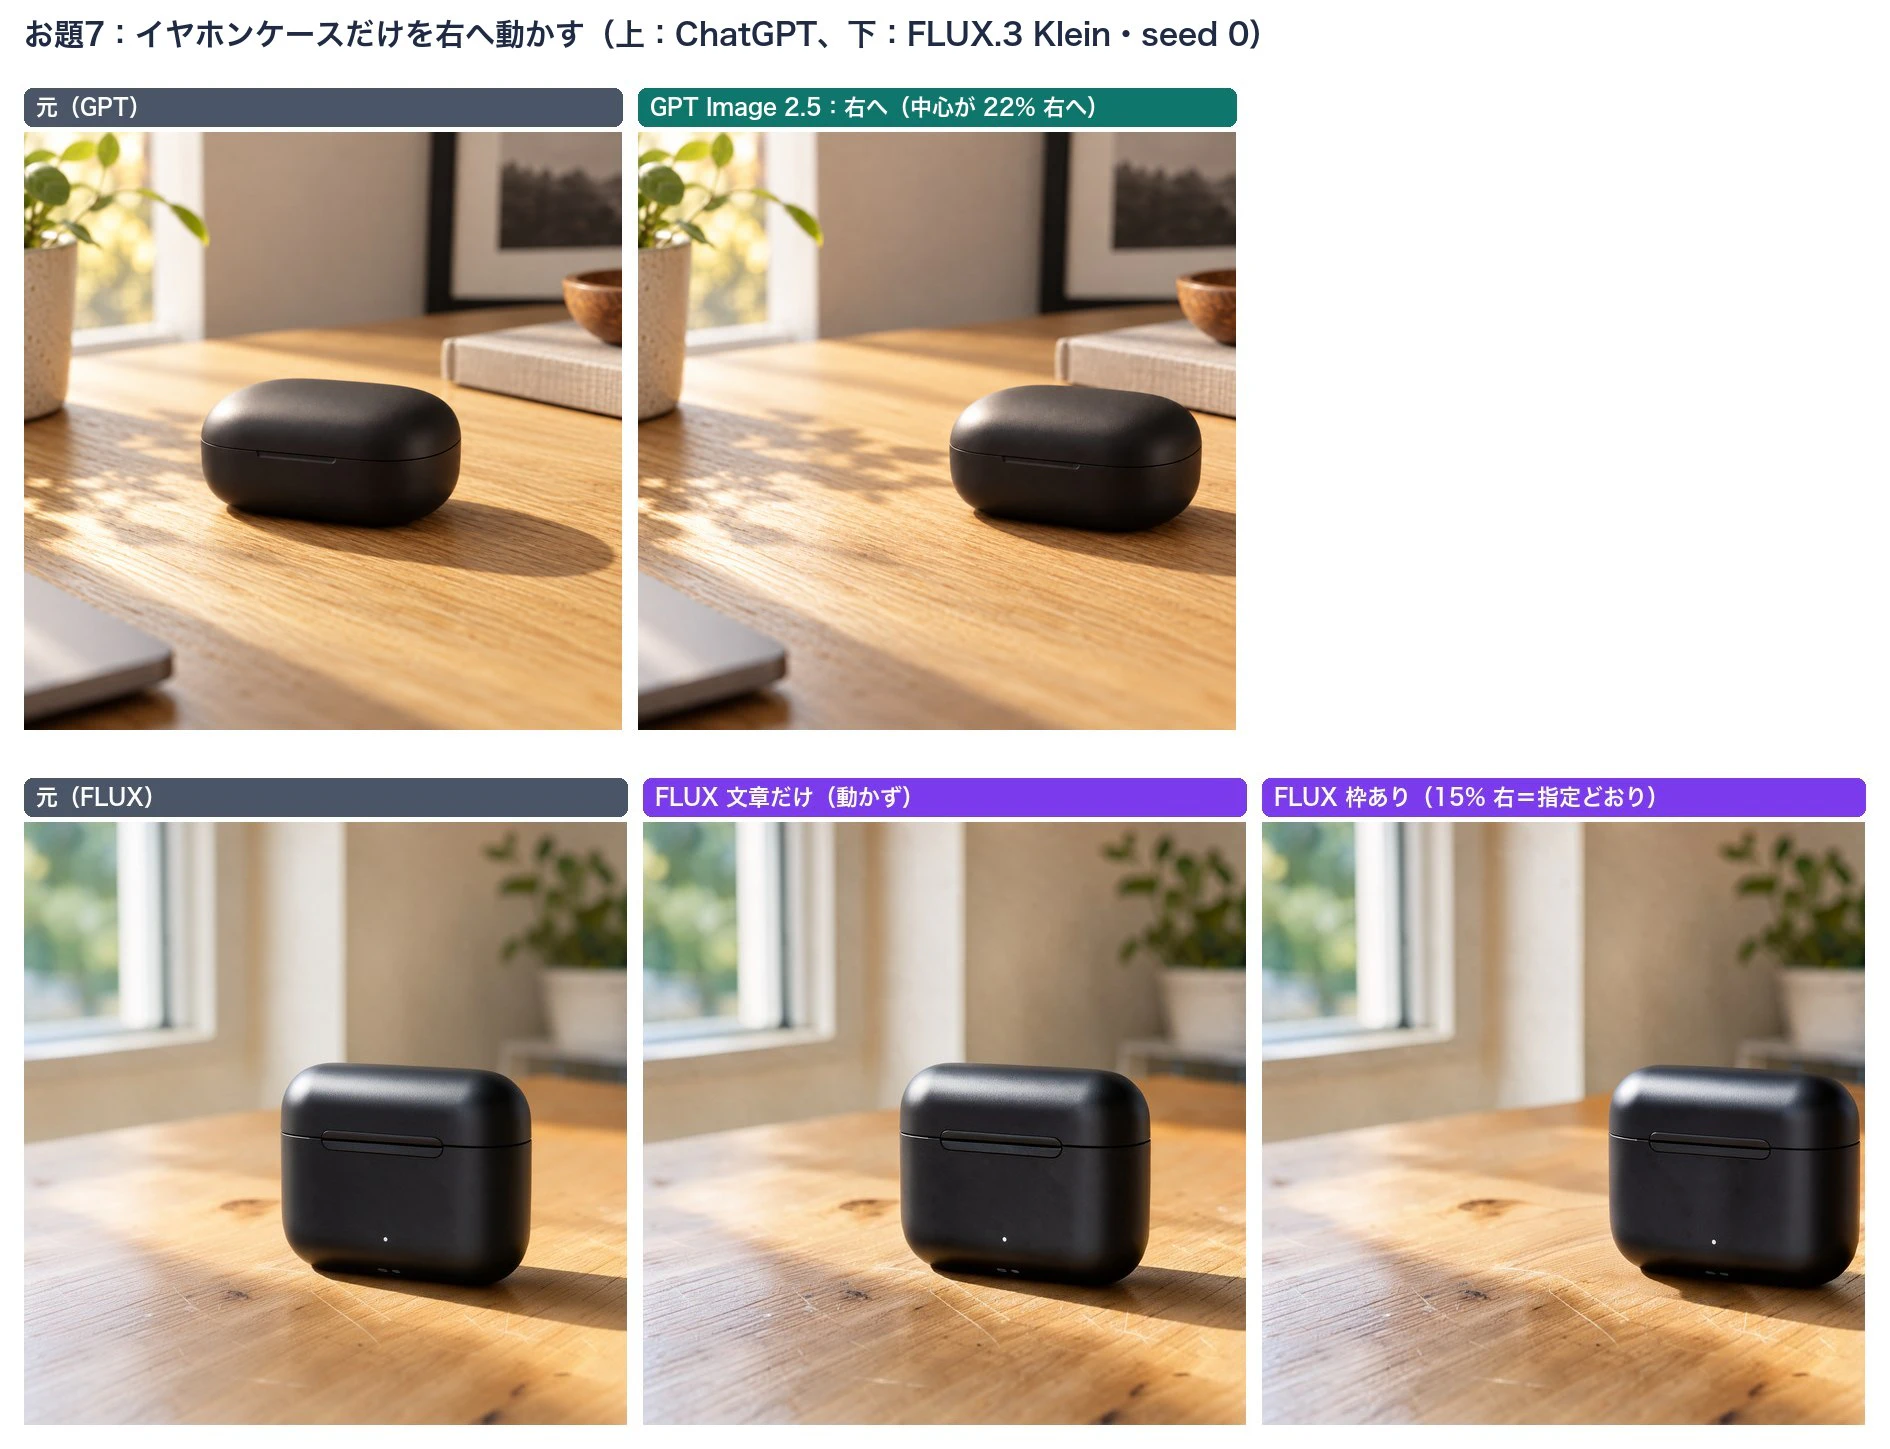
お題7。上が ChatGPT、下が FLUX(元・文章だけ・枠あり)
「ケースだけ右へ」は、FLUX.3 Klein の弱点と強みが同時に出ました。文章だけで頼むと、3シードともケースはほとんど動きませんでした(中心の移動は 0〜3%)。pup はキャプションに「右へ動かす」と正しく書いているので、本体が文章の「移動」を絵に反映できていないことになります。ところが src_bbox→tgt_bbox の枠を付けると、3シードとも中心が指定どおり 15% 右へ動きました。
ChatGPT は文章だけで中心を 22% 右へ動かし、ケースの外側の画素の平均差は 2.4(0〜255 の目盛り)と、ほぼ元のままでした。FLUX.3 Klein の枠ありは 4.0〜6.3 で、窓の外の木や机の木目がわずかに描き直されています。BFL の API には、編集していない部分を元の画素に戻す「pixel restoration」という機能がありますが、Diffusers の手順には含まれていません。
速さ
図5:1枚にかかる時間(中央値)。FLUX は pup と画像生成の合計で、休ませた場合と連続で作った場合
ChatGPT は、送信から完成画像のファイルができるまでの中央値が 約26秒(20〜41秒)でした。会話モデルが依頼を読んで画像ツールを呼ぶ時間も含んでいます。
Mac の FLUX.3 Klein は、条件によって速さが大きく変わりました。最初の一括生成(約50枚を休まず連続)では、画像生成の中央値が 1024×1024 で 33.6秒、16:9(1536×864)で 46.5秒、参照画像1枚の編集で 80.1秒 でした。ところが、あとで1枚ごとに30秒休ませて測り直すと、それぞれ 18.5秒・28.0秒・60.9秒 まで縮みました。休まずに測り直したときも 20→24→31秒と1枚ごとに遅くなっていったので、Mac が熱を持って GPU の速度が落ちたためとみられます。
ここに pup の約10〜25秒(1秒あたり約22トークン)が加わります。1024×1024 なら、冷えた状態では pup 込みで約28秒と ChatGPT とほぼ同じ、連続で作ると約44秒です。H100 での 1.93秒と比べると、Mac の GPU では約10〜17倍かかる計算です。
それでも、手元の Mac で通信なしに30秒〜1分ほどで1枚できるのは、試行錯誤には十分な速さです。何十枚作っても追加料金はかかりません。
どちらを使うか
結果をふまえた使い分けを、図6にまとめました。左から GPT Image 2.5 が向く場面、FLUX.3 Klein が向く場面、両方を組み合わせる方法の順に見てください。
図6:今回の結果から見た使い分け
判断の軸は2つです。
- 文字の正確さが大事なら GPT Image 2.5。特に日本語の見出しを画像に焼き込むなら、今回の結果では差がはっきりしていました
- 位置と大きさの正確さが大事なら FLUX.3 Klein。文章で伝えにくい「右下の隅に小さく」のような指定も、枠ならそのまま守られます
もとのニュースで触れられていた「技術ブログのアイキャッチを 16:9 と 5:2 で作り分ける」用途で言えば、次のような分担が現実的です。
- FLUX.3 Klein に、見出しの場所を空けた構図を枠で指定して、16:9 と 5:2 の絵を作る(同じ枠の表を使い回せる)
- 見出しの文字は、Figma や Canva などで後から重ねる
- 見出しまで含めて1回で仕上げたいときは、ChatGPT で 16:9 を作り、同じチャットで「5:2 に」と頼む
ChatGPT だけで完結させるほうが手軽ですが、毎回の構図が少しずつ変わります。記事ごとに同じレイアウトのアイキャッチをそろえたい場合は、枠の表を保存しておける FLUX.3 Klein の方式が向いています。
ライセンスと商用利用
FLUX.3 Klein の重みは FLUX Kommunity License v1.0 で配布されています。オープンソースのライセンスではなく、年商と用途で条件が変わる独自のライセンスです。判断の流れを図7で確認してください。
図7:FLUX.3 Klein の画像は仕事やブログで使ってよいか(法的助言ではありません)
条文から読み取れる要点は次のとおりです(2026年10月16日にモデルリポジトリの LICENSE.md で確認)。
| 項目 | 内容 |
|---|---|
| 無償で使える範囲 | 非商用(研究・評価・趣味、企業の本番以外での検証) |
| 年商500万ドル未満(関連会社を含む) | 生成した画像(Output)を商用に使ってよい。そのための本番運用も可 |
| その条件(2.e) | コンテンツフィルターを入れるか、公開前に違法・権利侵害の内容がないか確認する。法律が求める範囲で AI 生成と表示する |
| 禁止されていること(例) | 生成画像を使って似た画像モデルを改良・蒸留する、軍事・監視・生体情報の処理、権利侵害 |
| 生成画像の権利 | BFL は所有権を主張しない。使い方の責任は利用者 |
| それ以外の商用 | BFL の有償ライセンス(自前ホスト)か BFL API |
個人ブログのアイキャッチであれば、多くの個人は「年商500万ドル未満」に当たるので、生成画像を使うこと自体はできます。ただし「公開前に内容を確認する」という条件があるので、生成したものを確認せずに自動で公開する使い方は避けたほうがよいでしょう。
pup(Apache 2.0)と公式の推論コード(Apache 2.0)は、本体とは別のライセンスです。また、Hugging Face で同意するとき、メールアドレスとユーザー名が BFL に共有されます。
GPT Image 2.5 は OpenAI の利用規約の範囲で使います。年商による線引きはありませんが、手元で動かす選択肢はなく、API では1枚ごとに課金されます。
※ライセンスの説明は条文の整理であり、法的助言ではありません。仕事で使う場合は原文を確認してください。
Mac で FLUX.3 Klein を動かす手順
ここからは、今回の検証と同じ構成(pup → FLUX.3 Klein)を Mac で再現する手順です。重みは pup が 18.8GB、本体とテキストエンコーダーなどが約20GB あり、両方を同時に読み込むとモデルだけで約40GB になります。筆者はメモリ128GB の Mac でしか試していません。下のコードは pup を使い終えて解放してから本体を読み込むので、同時に載るのは片方ずつですが、どこまで少ないメモリで動くかは確認していません。
図8:Mac で動かす手順の全体像
1. Hugging Face で規約に同意してログインする
本体の重みは、Hugging Face のモデルページで規約に同意しないとダウンロードできません。
- https://huggingface.co/black-forest-labs/flux-3-image-klein をログインした状態で開く
- 「You need to agree to share your contact information…」の枠にある 「Agree and access repository」 を押す(メールアドレスとユーザー名が BFL に共有されます。承認は自動です)
- Hugging Face の設定画面で read 権限のアクセストークンを作り、ターミナルでログインする
# uv が入っていれば、インストールせずに hf コマンドを使える
uvx --from huggingface_hub hf auth login
pup(flux-3-image-klein-pup)は Apache 2.0 で、同意なしでダウンロードできます。
2. 仮想環境を作る
FLUX.3 のパイプラインは Diffusers の main ブランチにしか入っていないので、GitHub から入れます。
mkdir flux3-lab && cd flux3-lab
uv venv -p 3.12 .venv
# Diffusers は GitHub の main から。transformers は Qwen3.5 / Qwen3-VL に対応した新しい版が必要
uv pip install -p .venv/bin/python torch torchvision \
  "git+https://github.com/huggingface/diffusers.git" transformers accelerate safetensors pillow
source .venv/bin/activate
python -c "from diffusers import Flux3AutoBlocks; print(Flux3AutoBlocks().available_workflows)"
# ['text2image', 'image_conditioned'] と出れば OK
3. 重みをダウンロードする(約39GB)
本体のリポジトリには、FP8・NVFP4 の量子化版(NVIDIA の新しい GPU 向け)や見本画像も入っていて、全部で43GB あります。Mac では使わないので外します。
# FLUX.3 Klein 本体(bf16)+テキストエンコーダー+VAE、約20GB
hf download black-forest-labs/flux-3-image-klein --local-dir weights/flux-3-image-klein \
  --exclude "variants/*" --exclude "assets/*" --exclude "*.jpg" \
  --exclude "model.safetensors" --exclude "ae.safetensors"

# pup(プロンプト拡張)、約18.8GB
hf download black-forest-labs/flux-3-image-klein-pup --local-dir weights/pup
model.safetensors(本体を1ファイルにまとめた版、11GB)と ae.safetensors(VAE の1ファイル版)は公式の推論コード・ComfyUI 用で、Diffusers は transformer/・vae/ フォルダのほうを読むので不要です。筆者の回線では hf download が 10MB/s 前後で頭打ちになったため、ファイルを範囲に分けて curl で並列に取得しました(約 7〜9MB/s。回線が細い場合は数時間かかることもあります)。
4. 生成する
pup と本体をつなぐスクリプト flux3_mac.py と、公式の bbox.py のコピー(flux3_bbox.py)を同じフォルダに置いて実行します。
# 公式の枠の処理(Apache 2.0)を取ってくる
curl -sL https://raw.githubusercontent.com/black-forest-labs/flux-3-image-klein/main/src/flux3/bbox.py -o flux3_bbox.py

# 文章だけで
python flux3_mac.py "午後の窓辺の光が差し込む木のデスクに置かれた、黒いワイヤレスイヤホンケースの商品写真" \
  --out product.png --size 1024x1024

# 枠を付けて(boxes_eyecatch.json は 0〜1 の [上, 左, 下, 右])
python flux3_mac.py "技術ブログのアイキャッチ画像。左に大きな白い日本語の見出し「画像生成を座標で操る」…" \
  --out eyecatch.png --size 1536x864 --boxes boxes_eyecatch.json
flux3_mac.py の中心部分は次のとおりです。pup の出力をそのまま prompt に渡しているだけで、Diffusers 側は公式ブログの例と同じです。
import torch
from diffusers import ModularPipeline

# pup が書いたキャプション(枠があれば末尾に JSON の枠の表が付いている)
caption = upsample(request, size=(1536, 864), boxes=boxes)

pipe = ModularPipeline.from_pretrained("weights/flux-3-image-klein")
# VAE は fp32、それ以外は bf16(公式の Base 版の例と同じ指定)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("mps")  # CUDA の "cuda" の代わりに Apple Silicon の GPU を指定

image = pipe(prompt=caption, width=1536, height=864,
             generator=torch.Generator().manual_seed(0), output="images")[0]
image.save("eyecatch.png")
pup の部分で公式と違うのは、vLLM の代わりに transformers で動かしている点です(vLLM は Mac の GPU に対応していないため)。公式は「一度出た単語の点数を一律に下げる」presence penalty(1.5)を使っていますが、transformers の generate にはこの引数がないので、同じ計算をする小さなクラスを足しています。
from transformers import LogitsProcessor

class PresencePenalty(LogitsProcessor):
    """vLLM の presence_penalty と同じ:すでに出力したトークンの点数から一律に penalty を引く"""
    def __init__(self, penalty, prompt_len):
        self.penalty, self.prompt_len = penalty, prompt_len

    def __call__(self, input_ids, scores):
        seen = torch.zeros_like(scores, dtype=torch.bool).scatter_(1, input_ids[:, self.prompt_len:], True)
        return scores - self.penalty * seen.to(scores.dtype)
もう1つ、pup のシステムプロンプトは先頭行の TARGET CANVAS: 16:9 のような指定を受け付けるように書かれています。公式の推論コードはこれを付けていませんが、16:9 や 5:2 の画像では構図を縦横比に合わせてもらうために付けました。
編集するとき
参照画像を渡すときは、pup にも同じ画像を見せて i2i(枠があれば i2i_bbox)のシステムプロンプトでキャプションを書かせ、本体には image= で参照画像を渡します。物を動かすときの枠は、from(どの参照画像か)、src_bbox(元の位置)、tgt_bbox(移動先)を持ちます。
[{"id": "case_1", "from": "ref_image_0",
  "src_bbox": [0.398, 0.427, 0.769, 0.842],
  "tgt_bbox": [0.398, 0.575, 0.769, 0.990],
  "desc": "matte black wireless earbud charging case"}]
トラブルシューティング
今回の検証で実際に出たつまずきを、止まった段階ごとにまとめます。図9で確認する順番を追ってから、下の表で対処を確かめてください。
図9:うまくいかないときの確認順
| 症状・メッセージ | 原因 | 対処 |
|---|---|---|
Access to model … is restricted and you are not in the authorized list |
ログインはしたが、モデルページで規約に同意していない | ログインしたアカウントでモデルページを開き「Agree and access repository」を押す |
hf download が 10MB/s 前後で頭打ち・途中で止まる |
回線や配信側の都合 |
variants/ などを除外して量を減らす。ファイルを範囲に分けて並列に取る |
The following model_kwargs are not used by the model: ['presence_penalty'] |
transformers の generate に presence penalty の引数がない |
記事中の PresencePenalty を logits_processor で渡す |
tokenizer … with an incorrect regex pattern の警告 |
transformers の判定 | 今回は無害だった(fix_mistral_regex=True の有無でトークン列が完全に一致) |
| 画像がありきたり・細部の指示が抜ける | pup を通さず短い文を渡している | pup のキャプションを prompt に渡す |
| 枠と違う場所に出る・縦横が入れ替わる | 座標の順番や目盛りの間違い |
[上, 左, 下, 右] の順か確認。Diffusers は 0〜1000、推論コードの boxes.json は 0〜1 |
| 文章で「右へ動かして」と頼んでも動かない | 本体が文章の「移動」を反映しにくい |
src_bbox と tgt_bbox の枠を付けた i2i_bbox で頼む |
| 難しい漢字が別の字になる | 文字の描画の限界(今回は「操」) | 拡大して確認。見出しは後から重ねる |
メモリが足りないときは、pup を使い終えたら解放してから本体を読み込みます(flux3_mac.py はそうしています)。HF ブログには、テキストエンコーダーを先に動かして解放する方法や、CPU オフロードの例も載っています。
まとめ
FLUX.3 Image Klein と GPT Image 2.5 を、同じ8つのお題で比べました。
- 完成度と日本語は GPT Image 2.5。写真の作り込み、日本語の見出し(難しい漢字まで)、会話での編集のしやすさで上回った
- 位置の正確さは FLUX.3 Klein。枠を付けると、不自然な配置でも指定との重なりが 0.81(ChatGPT は 0.54)。差を生んだのはモデルより「枠で渡せること」だった
- FLUX.3 Klein は pup とセットで使う。Diffusers だけでは pup が呼ばれないので、自分でつなぐ必要がある
- Mac でも実用的な速さ。M5 Max で pup 込み1枚約28〜48秒(連続で作ると約44〜66秒)。ChatGPT(約26秒)と同じか2倍程度で、追加料金なしで何枚でも作れる
- 商用は年商500万ドル未満なら生成画像を使える。ただし公開前の確認などの条件付き
「ChatGPT の代わりになるか」への答えは、全部の代わりにはならないが、位置を決める仕事は FLUX.3 Klein のほうが得意です。アイキャッチのように構図を毎回そろえたい用途では、枠の表を使い回せる FLUX.3 Klein と、文字に強い GPT Image 2.5 を組み合わせるのが今のところいちばん確実だと感じました。
次に試すなら、Base 版(50ステップ)で画質と文字がどこまで良くなるか、ブログのアイキャッチの絵柄を LoRA で覚えさせられるか、が気になるところです。
参考リソース
- Hugging Face 公式ブログ「Welcome FLUX.3 Image Klein in Diffusers」(2026-10-15):https://huggingface.co/blog/flux-3
- Black Forest Labs「FLUX 3 Image Klein」:https://bfl.ai/blog/flux-3-image-klein
- モデルカード(蒸留版):https://huggingface.co/black-forest-labs/flux-3-image-klein
- モデルカード(Base 版):https://huggingface.co/black-forest-labs/flux-3-image-klein-base
- プロンプト拡張モデル pup:https://huggingface.co/black-forest-labs/flux-3-image-klein-pup
- 公式の推論コード:https://github.com/black-forest-labs/flux-3-image-klein
- 公式デモ(Hugging Face Spaces):https://huggingface.co/spaces/black-forest-labs/flux-3-image-klein
- OpenAI「ChatGPT Images 2.5 のご紹介」(2026-09-08):https://openai.com/ja-JP/index/introducing-chatgpt-images-2-5/
- OpenAI API ドキュメント「Image generation」:https://developers.openai.com/api/docs/guides/image-generation
- OpenAI API 料金:https://developers.openai.com/api/docs/pricing