
この記事の確認範囲
- 対象:AG2 v1.3.2(2026年11月15日公開)。比較のため v1.3.1 も同じ Mac に入れて実行しました
- 判定モデル:OpenAI Decisions API(
gpt-6-luna)と TypeSafe Jev(jev-latest) - 検証環境:macOS(Apple M5 Max)、Python 3.12.15、uv 0.12.22
- 実験:自作の求人票×候補者 72 件を、6通りの聞き方で各 3 回ずつ判定(2026年11月16日)
- 料金・仕様は 2026年11月16日時点の公式ページで確認しました。数字はすべてこの環境での実測です
はじめに:同じ文章を3回送る、をやめられるようになった
問い合わせ1件に対して「スパムか」「どの部署に回すか」「どれくらい急ぎか」を判定したい。求人の書類選考なら「どの職種の求人か」「経験年数は足りているか」「推薦の優先度はどうか」を知りたい。業務で AI エージェントを組むと、同じ入力に対して、決まった選択肢から選ぶ判定をいくつも行う場面がよく出てきます。
オープンソースのエージェントフレームワーク AG2(旧 AutoGen の流れをくむプロジェクト)には、こうした判定を専門に行う「判定モデル(Decision Model)」を呼ぶ仕組みがあります。ただし v1.3.1 までは、1つのエージェントが答えられる質問は1つだけでした。3つ判定したければ、エージェントを3つ作り、同じ文章を3回 API に送る必要がありました。
2026年11月15日に公開された v1.3.2 では、質問を付けたフィールドを並べたクラスを1つ渡すだけで、3つの判定が1回のリクエストで返ってくるようになりました。共有している入力(問い合わせ文や求人票)は1回だけ送られ、課金も1回分です。
この変化をひと目で表すと、次の図のようになります。左が v1.3.1 までのやり方、右が v1.3.2 からのやり方です。
図1:同じ求人票に3つの判定をするときの、v1.3.1 までと v1.3.2 からの違い。数字は今回の実測(OpenAI Decisions、1件あたり)
この記事では、実際に Mac で v1.3.1 と v1.3.2 を並べて動かし、次のことを確かめた結果をまとめます。
- v1.3.2 の「まとめて聞く」書き方と、本当に1回で送られているかの確認方法
- 求人票×候補者 72 件で、「1問ずつ聞く」「まとめて聞く」「LLM に JSON を書かせる」の時間・トークン・料金・正答率の比較
- 判定モデルが返す確率(スコア)をそのまま信じてはいけない理由と、今回の実験で効いた直し方
- エラーになる書き方と、その直し方
想定読者は、Python で LLM の API を呼んだことがあり、エージェントの中で「分類」「振り分け」「優先度付け」を作ろうとしている方です。AG2 を初めて触る方でも、手順どおりに進めれば動かせるように書いています。
背景:判定モデルとは何か
文章を書かずに「確率つきの答え」だけ返すモデル
ふだん使う ChatGPT のようなモデルは生成モデルと呼ばれ、文章を1文字ずつ作っていきます。分類に使う場合は「JSON で答えて」と頼み、返ってきた文字列を読み取ります。最近は構造化出力(Structured Output)で形式を守らせることもできますが、返ってくるのは答え1つだけで、モデルがどれくらい迷ったかは分かりません。
これに対して判定モデルは、文章を書きません。「はい/いいえ」「決まった選択肢のどれか」「段階のどこか」という形の質問だけを受け付け、選択肢ごとの確率を返します。2026年11月時点で AG2 が対応している判定モデルは次の2つです。
-
OpenAI Decisions API:
POST /v1/decisions。モデルはgpt-6-lunaのみ。2026年10月にパブリックベータとして公開され、現在は一般提供(GA)になっています。1回のリクエストに最大400問まで入れられます -
TypeSafe Jev:
POST /v1/systemone。判定専用に作られたモデルで、入力単価が安いのが特徴です
両者の違いと、生成モデルとの違いを図にまとめます。
図2:生成モデルに JSON を書かせる方法と、判定モデルの違い。時間は今回の実測の中央値
判定モデルの料金は入力トークンだけで決まり、出力は無料です(OpenAI は入力100万トークンあたり \$0.10、Jev は \$0.042)。そのため、同じ入力を何度も送ることが、そのまま料金と待ち時間の無駄になります。ここが今回のアップデートの効きどころです。
AG2 の判定エージェント
AG2 では、生成モデルも判定モデルも同じ Agent クラスで扱います。違いは config と response_schema(答えの型)だけです。
| 答えの型(response_schema) | 判定の種類 | 返ってくるもの |
|---|---|---|
文字列の Enum
|
選択(choice) | 選ばれたメンバーと、各選択肢の確率・confidence |
bool |
はい/いいえ(predicate、Jev では noul) | True/False と「はい」の確率 |
0 から始まる IntEnum
|
段階(score) | 最も近い段階と、確率の重み付き平均(score) |
| 上の型を並べたクラス(v1.3.2 から) | 複数の質問 | クラスのインスタンスと、フィールドごとの確率 |
v1.3.1 までは表の上3行しか使えず、クラスを渡すと「判定の型ではない」というエラーで止まっていました。v1.3.2 で4行目が加わった、というのが今回の主役です。
v1.3.2 で変わったこと
v1.3.2 のリリースノートには、一括判定以外の変更も含まれています。業務で使っている方が影響を受けそうなものを表に整理しました。
| 変更 | 内容 | 影響 |
|---|---|---|
| 複数の判定を1回で(新機能) |
response_schema にクラスを渡すと、フィールドごとに1問として1リクエストで送る。dataclass・TypedDict・Pydantic に対応 |
追加の設定・フラグは不要。1問のスキーマは従来どおり |
| トークン使用量の数え方を統一 |
prompt_tokens はキャッシュの読み書きを含む入力の全体、と全プロバイダーでそろえた |
Anthropic・Bedrock では値が増える(後述) |
| ACP 1.0(破壊的変更) |
acp extra が agent-client-protocol>=1.0.0,<2 を要求 |
0.12 系を固定している人は先に更新が必要 |
| Python 3.15 対応 | テスト・型チェックの対象に追加 | PyYAML の 3.15 用 wheel が未公開で、ソースからのビルドが走る |
| AG-UI | assistant-ui のクイックスタート追加、Base64 の厳密な検証 | 不正な Base64 は 400 で拒否されるようになった |
一括判定には、ドキュメントに書かれた決まりがいくつかあります。後で実際にエラーを出して確かめますが、先に要点を挙げておきます。
- 各フィールドは必須で、判定の型(
bool、0〜1 の数値、文字列のEnum、0 始まりのIntEnum)であること。str、Optional、入れ子のクラス、既定値つきは送る前に拒否される - 各フィールドの質問文は
Annotated[型, Question("…")]かField(description="…")、または Enum のクラスの docstring から取られる。どれもなければエラー - エージェントの
promptは、全部の質問の先頭に共通で付く。クラス自体に質問を付けることはできない - 各フィールドは独立に答えられる。ある答えを見てから次を聞く、という依存関係のある質問は別々に聞く
- OpenAI で1問でも拒否(refusal)されると、全体が
DecisionRefusedErrorになり、部分的な結果は返らない
準備:環境を作る
必要なものは、Python 3.11 以上と、使う判定モデルの API キーだけです。準備の流れを図にしました。
図3:準備の手順と、2つの判定モデルの違い
作業フォルダを作り、仮想環境を用意します。今回は高速なパッケージ管理ツールの uv を使いましたが、python -m venv と pip でも同じです。
# 作業フォルダと仮想環境を作る(AG2 1.3 系は Python 3.11 以上が必要)
mkdir ag2-decisions-lab && cd ag2-decisions-lab
uv venv -p 3.12 .venv
source .venv/bin/activate

# AG2 1.3.2 を、OpenAI と TypeSafe の extra つきで入れる
uv pip install "ag2[openai,typesafe]==1.3.2" python-dotenv

# 版を確かめる(1.3.2 と表示されれば OK)
python -c "import ag2; print(ag2.__version__)"
片方の判定モデルしか使わないなら、ag2[openai] か ag2[typesafe] だけで構いません。比較のために v1.3.1 も試したい場合は、別の仮想環境(例:.venv-131)に ag2[openai,typesafe]==1.3.1 を入れます。
API キーは、コードに直接書かず .env ファイルに置きます。
# .env(Git に入れないこと)
OPENAI_API_KEY=<YOUR_OPENAI_API_KEY>
TYPESAFE_API_KEY=<YOUR_TYPESAFE_API_KEY>
最後に、キーを読み込む小さな共通ファイルを作っておきます。
# app/common.py
import json
from pathlib import Path
from dotenv import load_dotenv

ROOT = Path(__file__).resolve().parent.parent
load_dotenv(ROOT / ".env")  # OPENAI_API_KEY と TYPESAFE_API_KEY を読む


def load_rows():
    """検証データ(1行1件の JSON)を読む"""
    return [json.loads(l) for l in (ROOT / "data/screening.jsonl").read_text().splitlines() if l.strip()]
手順1:3つの判定を1つのクラスにまとめる
判定の中身を型で書く
今回は、人材紹介会社の書類選考を例にします。求人票と候補者の経歴を読み、次の3つを判定します。
- 職種(job_category):求人の主な業務はどれか。7つの選択肢から1つ
- 経験年数の適合(experience_fit):その職種での実務年数が、必須年数以上か。はい/いいえ
- 推薦の優先度(priority):見送り・通常・優先の3段階
まず、選択肢と段階を Enum で定義します。メンバーの下に書いた文字列が、そのまま選択肢の説明として API に送られるのがポイントです(AG2 がソースコードから読み取ります)。
# app/schemas.py(前半)
from dataclasses import dataclass
from enum import Enum, IntEnum
from typing import Annotated

from ag2.response import Question

PROMPT = "あなたは人材紹介会社の書類選考担当です。求人票と候補者の経歴を読んで、質問に答えてください。"

Q_CATEGORY = "この求人票の主な業務は、どの職種に当たりますか? 職種名ではなく仕事内容で判断してください。"
Q_FIT = "候補者の「この求人の職種での」実務経験年数は、求人票の必須年数以上ですか? 別の職種での経験年数は数えません。"
Q_PRIORITY = "この候補者をこの求人に推薦する優先度はどれですか?"


class JobCategory(Enum):
    BACKEND = "backend"
    """サーバー側(API・データベース・業務ロジック)の開発"""
    FRONTEND = "frontend"
    """ブラウザで動く画面の開発"""
    MOBILE = "mobile"
    """iPhone・Android アプリの開発"""
    DATA_ML = "data_ml"
    """データ分析、機械学習モデルの開発"""
    INFRA = "infra"
    """インフラの構築・運用、SRE、クラウド"""
    PM = "pm"
    """プロダクトやプロジェクトのマネジメント(自分では主に実装しない)"""
    OTHER = "other"
    """上のどれにも当てはまらない"""


class Priority(IntEnum):
    SKIP = 0
    """見送り:必須スキルのどれかが経歴にない、または職種での実務年数が必須年数に足りない"""
    NORMAL = 1
    """通常:必須スキルと必須年数を満たすが、歓迎条件を1つも満たさない"""
    HIGH = 2
    """優先:必須スキルと必須年数を満たし、歓迎条件を1つ以上満たす"""
選択肢の最後に「other(どれにも当てはまらない)」を置いているのは、判定モデルが答えに迷ったとき、無理にどれかへ寄せないための逃げ道です。
次に、v1.3.2 の新しい書き方で、3つの判定を1つのクラスにまとめます。
# app/schemas.py(後半):v1.3.2 の一括判定用。1フィールド = 1問
@dataclass
class Screening:
    job_category: Annotated[JobCategory, Question(Q_CATEGORY)]
    experience_fit: Annotated[bool, Question(Q_FIT)]
    priority: Annotated[Priority, Question(Q_PRIORITY)]
Annotated[型, Question("質問文")] は、型に質問文を貼り付ける書き方です。dataclass の代わりに TypedDict や Pydantic の BaseModel を使っても同じように動きます。
1件だけ判定してみる
このクラスを response_schema に渡したエージェントで、1件の求人票と候補者を判定します。入力は DataInput に辞書で渡すと、項目名つきで送られます。
# app/screen_one.py:1件の求人票と候補者に、3つの判定をまとめて聞く
import asyncio, sys
sys.path.insert(0, "app")
import common  # noqa: .env からキーを読む
import ag2
from ag2 import Agent, DataInput
from ag2.config import OpenAIDecisionsConfig, TypeSafeConfig
from schemas import PROMPT, Screening

JOB = """【募集職種】SRE(Site Reliability Engineer)
【仕事内容】サービスの監視・障害対応・インフラのコード化
【必須条件】インフラ運用・SREの実務経験3年以上/Kubernetes・Terraformの実務経験
【歓迎条件】Datadog、GCP"""
CANDIDATE = """山本さん(31歳)
職務経歴:インフラ運用・SREの実務4年
使える技術・スキル:Terraform、k8s、GCP"""


async def main(provider: str):
    print("ag2", ag2.__version__, "/", provider)
    config = OpenAIDecisionsConfig() if provider == "openai" else TypeSafeConfig()
    screener = Agent("screener", prompt=PROMPT, config=config, response_schema=Screening)
    reply = await screener.ask(DataInput({"求人票": JOB, "候補者": CANDIDATE}))
    result = await reply.content()          # Screening のインスタンス
    print(result)
    meta = reply.response.metadata          # {フィールド名: そのフィールドの確率など}
    print("confidence  職種:", meta["job_category"]["confidence"], " 優先度:", meta["priority"]["confidence"])
    print("優先度の確率:", meta["priority"]["probabilities"])
    u = reply.response.usage
    print(f"usage: prompt_tokens={u.prompt_tokens} completion_tokens={u.completion_tokens}")

asyncio.run(main(sys.argv[1] if len(sys.argv) > 1 else "openai"))
候補者は Kubernetes を「k8s」と略して書いています。表記ゆれがあっても必須スキルを満たしていると判断できるかも、ついでに見てみます。同じコードを v1.3.1 と v1.3.2 の両方で実行した結果が次の画面です。
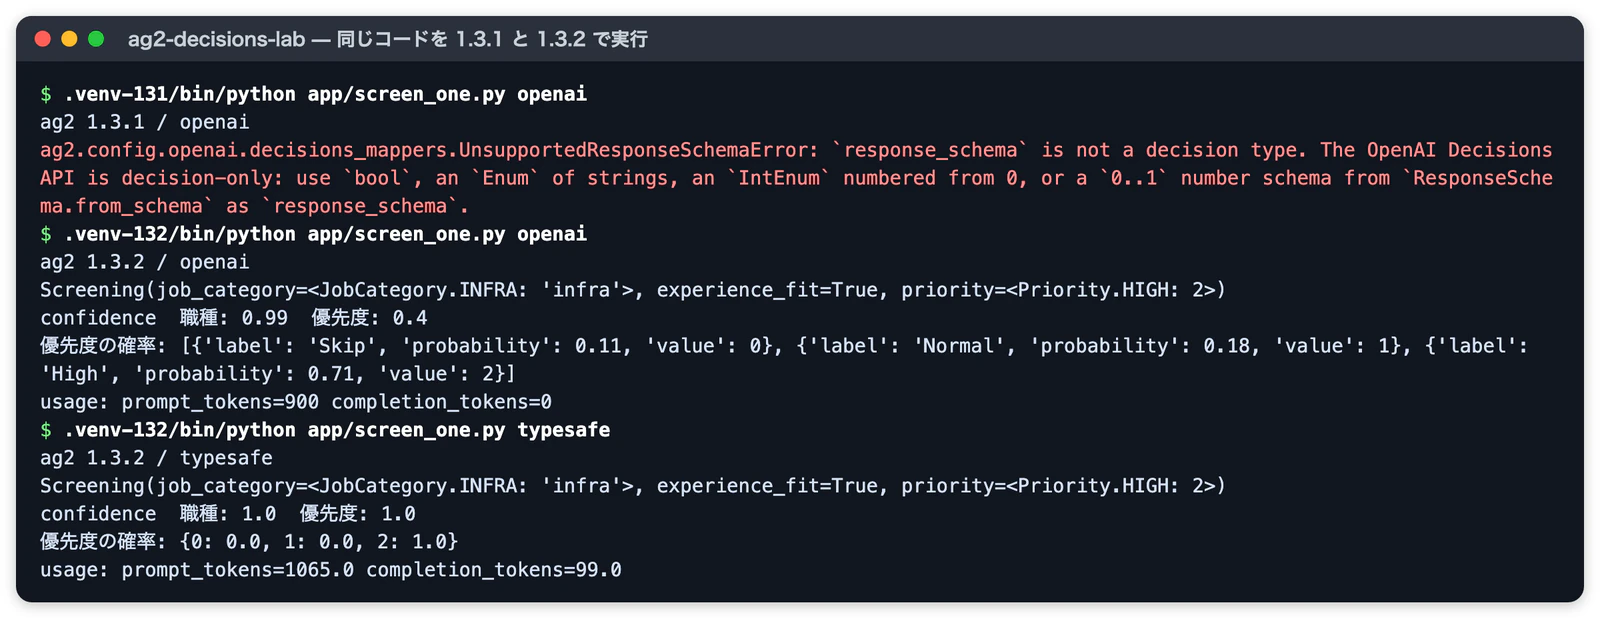
図4:同じコードを v1.3.1 と v1.3.2 で実行した画面(ターミナルの出力をそのまま画像化)
v1.3.1 では、クラスを渡した時点で UnsupportedResponseSchemaError(判定の型ではない)になります。v1.3.2 では、3つの答えが Screening のインスタンスとして返ってきました。「k8s」も Kubernetes と読み取られ、優先度は「優先(HIGH)」です。
返ってくる付加情報(metadata)は、フィールド名をキーにした辞書になります。ただし中身の形は判定モデルごとに少し違うので、取り出すときは注意が必要です。
| 取り出したいもの | OpenAI Decisions | TypeSafe Jev |
|---|---|---|
| はい/いいえの確率 | meta[項目]["probability"] |
meta[項目]["noul"] |
| 選択肢ごとの確率 |
meta[項目]["probabilities"]({"value", "probability"} のリスト) |
meta[項目]["probabilities"]({選択肢: 確率} の辞書) |
| 迷いの少なさ | meta[項目]["confidence"] |
meta[項目]["confidence"] |
| 段階の重み付き平均 | meta[項目]["score"] |
meta[項目]["score"] |
同じ候補者でも、OpenAI は優先度の confidence が 0.4、Jev は 1.0 と、確信の度合いがかなり違いました。この「確率の出方の違い」は、後の手順4で大事になります。
手順2:本当に1回で送られているか確かめる
「1回で送られる」とリリースノートに書いてあっても、自分の目で確かめておくと安心です。AG2 の config には自前の HTTP クライアントを渡せるので、送信の直前に呼ばれるフック(event hook)でリクエストを記録します。
# app/wire.py:実際に送られるリクエストを記録する
import asyncio, json, sys
import httpx
import httpx2  # TypeSafe の config は httpx2 のクライアントを受け取る
sys.path.insert(0, "app")
from common import ROOT, load_rows
from ag2 import Agent, DataInput
from ag2.config import OpenAIDecisionsConfig, TypeSafeConfig
from schemas import PROMPT, SINGLE, Screening

LOG = []

async def on_request(req):
    LOG.append({"url": str(req.url), "body": json.loads(req.content or b"{}")})

def client(mod=httpx):
    return mod.AsyncClient(event_hooks={"request": [on_request]}, timeout=60)

async def main():
    row = load_rows()[0]
    inp = DataInput({"求人票": row["job"], "候補者": row["candidate"]})
    out = {}
    for prov, mk in [("openai", lambda: OpenAIDecisionsConfig(http_client=client())),
                     ("typesafe", lambda: TypeSafeConfig(http_client=client(httpx2)))]:
        LOG.clear()   # v1.3.2 の一括判定
        await Agent("screen", prompt=PROMPT, config=mk(), response_schema=Screening).ask(inp)
        batch = list(LOG)
        LOG.clear()   # 従来の聞き方:1問ずつ3エージェント
        cfg = mk()
        await asyncio.gather(*(Agent(k, prompt=PROMPT, config=cfg, response_schema=t).ask(inp)
                               for k, t in SINGLE.items()))
        out[prov] = {"batch": batch, "separate": list(LOG)}
        print(prov, "batch requests:", len(batch), "separate requests:", len(LOG))
    (ROOT / "results/wire.json").write_text(json.dumps(out, ensure_ascii=False, indent=1))

asyncio.run(main())
ここで使っている SINGLE は、従来の「1問ずつ」聞くためのスキーマです。同じ質問文を、1問だけの型として用意しています。
# app/schemas.py に追加:従来どおり1問ずつ聞くときのスキーマ
CategoryQ = Annotated[JobCategory, Question(Q_CATEGORY)]
FitQ = Annotated[bool, Question(Q_FIT)]
PriorityQ = Annotated[Priority, Question(Q_PRIORITY)]
SINGLE = {"job_category": CategoryQ, "experience_fit": FitQ, "priority": PriorityQ}
記録したリクエストを要約して表示したのが次の画面です。
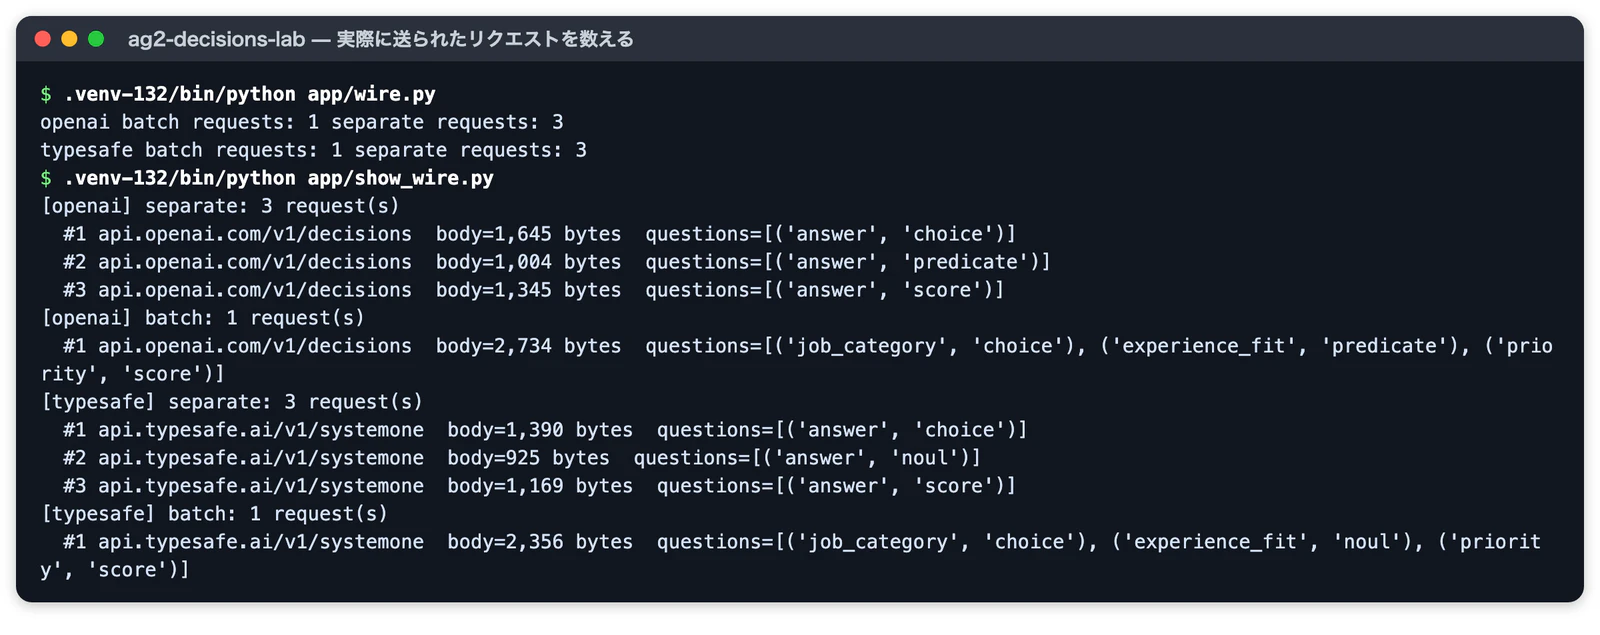
図5:実際に送られたリクエストの数と中身(app/show_wire.py で要約)
従来の聞き方では、どちらの判定モデルにも3リクエストが飛び、質問の名前はすべて answer でした。一括判定では1リクエストの中に3問が入り、名前はフィールド名(job_category など)になっています。リクエスト本文の大きさは、3回分の合計(OpenAI で約4.0KB)より、1回にまとめたほう(約2.7KB)が小さくなりました。求人票と経歴が1回分で済んでいるためです。
クラスの各フィールドが、どのように API の質問へ変換されるかを図にしておきます。
図6:クラスのフィールドと、API に送られる質問の対応(OpenAI Decisions の通信記録より)
記録を読んで気づいた点が2つあります。1つは、DataInput の辞書が OpenAI には JSON 文字列のテキストとして、Jev には辞書のまま(state の中身)として送られていたことです。もう1つは、エージェントの prompt が3問それぞれに繰り返し付くことです。入力本体は1回で済みますが、共通の指示文は質問の数だけ送られます。長い指示文を prompt に書く場合は、この分のトークンも見込んでおきましょう。
手順3:72件で「従来の方法」「LLM の JSON」と比べる
1件で動くことが分かったので、次はまとまった件数で、時間・料金・正答率を比べます。
検証データの作り方
公開されている求人データには正解ラベルがないため、正解がルールで一意に決まるデータを自作しました。6職種×2件の求人票それぞれに、6タイプの候補者を組み合わせた 72 件です。
図7:検証データの構成。正解はタイプごとのルールで決まる
引っかけとして、「社内 AI チャットの iOS アプリ開発」(AI という語があるがモバイル)や、「別の職種で6年働いた後、この職種は1年」(社会人歴は長いが年数不足)、必須スキルを「k8s」「TS」「Rails」のように略した候補者を混ぜています。データを作るスクリプト(app/make_dataset.py)は乱数の種を固定しているので、同じデータを再現できます。
比べた6つの聞き方
同じ質問文を使い、聞き方だけを変えた6条件を用意しました。
| 条件 | 中身 | 1件あたりのリクエスト |
|---|---|---|
| Decisions・1問ずつ×3 | v1.3.1 までのやり方。3エージェントを asyncio.gather で同時に送る |
3 |
| Decisions・まとめて1回 | v1.3.2 の一括判定 | 1 |
| Jev・1問ずつ×3 | 同上(TypeSafe) | 3 |
| Jev・まとめて1回 | 同上(TypeSafe) | 1 |
| LLM JSON(gpt-6-luna) | 生成モデルに構造化出力で3項目を書かせる | 1 |
| LLM JSON(gpt-6.1-terra) | 上位の生成モデルで同じことをする | 1 |
LLM の JSON 生成は、同じ質問文と選択肢の説明を Pydantic のモデルに書き、response_schema に渡しました。AG2 では生成モデルでも同じ書き方で構造化出力が使えます。
# app/schemas.py に追加:LLM に JSON を書かせるとき(説明文は判定モデルと同じ)
from typing import Literal
from pydantic import BaseModel, Field

class ScreeningJSON(BaseModel):
    job_category: Literal["backend", "frontend", "mobile", "data_ml", "infra", "pm", "other"] = Field(
        description=Q_CATEGORY + " 選択肢 → backend: サーバー側(API・データベース・業務ロジック)の開発 / …")
    experience_fit: bool = Field(description=Q_FIT)
    priority: Literal[0, 1, 2] = Field(
        description=Q_PRIORITY + " 選択肢 → 0: 見送り:… / 1: 通常:… / 2: 優先:…")

# 生成モデルのエージェント(OpenAIConfig は Chat Completions を使う)
from ag2 import Agent
from ag2.config import OpenAIConfig
llm = Agent("screen", prompt=PROMPT, config=OpenAIConfig(model="gpt-6-luna"), response_schema=ScreeningJSON)
計測の本体は、条件ごとに時間を測り、使用トークンと答えを記録するだけの単純なものです。「1問ずつ」の条件では3つの ask() を同時に送り、3つのうち最後に返ってきた時刻までを1件の時間としました。
# app/run_bench.py(抜粋)
async def run_one(cond, agent, row):
    inp = DataInput({"求人票": row["job"], "候補者": row["candidate"]})
    t0 = time.perf_counter()
    if isinstance(agent, dict):            # 1問ずつ×3:同時に送る
        results = await asyncio.gather(*(timed(a, inp) for a in agent.values()))
        wall = time.perf_counter() - t0
        usage = sum_usage(r[0].response.usage for r in results)   # 3回分を合計
        ...
    else:                                  # まとめて1回、または LLM の JSON
        reply, content, wall = await timed(agent, inp)
        usage = reply.response.usage
        ...
72 件を1件ずつ順番に処理し、6条件の実行順は1件ごとにずらしました(時間帯による偏りを避けるため)。これを 3 回繰り返し、合計 216 件ずつの結果を集計しています。エラーは全条件で0件でした。集計スクリプト(app/analyze.py)の出力をそのまま載せておきます。
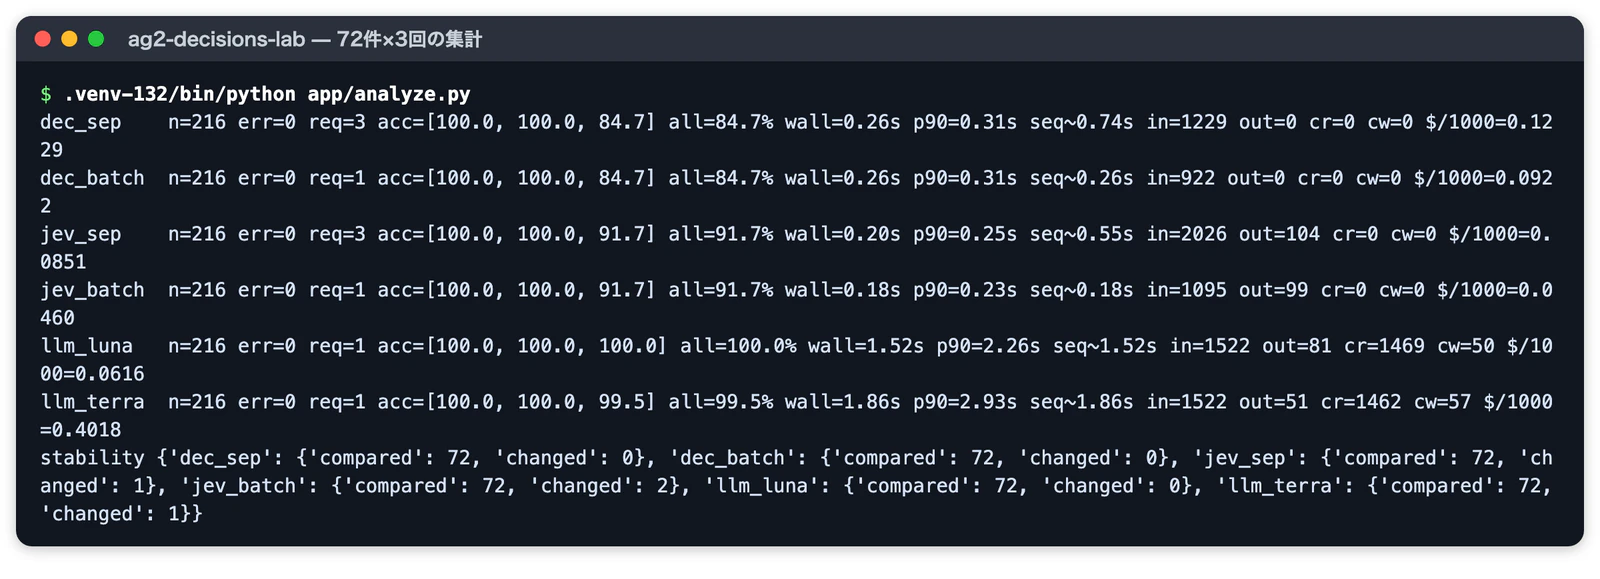
図8:72件×3回の集計結果(ターミナルの出力をそのまま画像化)
以下、この結果を時間・料金・正答率の順に見ていきます。
結果1:時間
まず、1件あたりの時間です。
図9:1件あたりの時間(中央値)。72件×3回
判定モデルは、まとめて1回でも、1問ずつ3つを同時に送っても、待ち時間はほとんど同じでした(Decisions 0.26 秒、Jev 0.18 秒)。3リクエストを同時に送れば、待ち時間は一番遅い1本で決まるからです。
ただし、3つを順番に送るコードだと話は変わります。1問ずつの所要時間を足した推定では、Decisions で約 0.74 秒、Jev で約 0.55 秒になり、まとめた場合の約3倍です。既存のコードが for 文で順に ask() している場合は、v1.3.2 に移すだけで待ち時間も縮みます。
生成モデルの JSON は、gpt-6-luna で 1.52 秒、gpt-6.1-terra で 1.86 秒でした。判定モデルのまとめて1回と比べると、約 6〜8 倍の時間がかかっています。遅いほうの1割(p90)では 2.26〜2.93 秒まで伸びました。
結果2:入力トークンと料金
次に、1件あたりの入力トークンと、1,000件あたりの料金です。
図10:入力トークン(左)と 1,000件あたりの料金(右)。単価は2026年11月16日時点
| 条件 | 入力トークン/件 | 出力トークン/件 | 料金/1,000件 |
|---|---|---|---|
| Decisions・1問ずつ×3 | 1,229 | 0 | \$0.123 |
| Decisions・まとめて1回 | 922 | 0 | \$0.092 |
| Jev・1問ずつ×3 | 2,026 | 104(課金なし) | \$0.085 |
| Jev・まとめて1回 | 1,095 | 99(課金なし) | \$0.046 |
| LLM JSON(gpt-6-luna) | 1,522(うちキャッシュ読み 1,469) | 81(うち推論 51) | \$0.062 |
| LLM JSON(gpt-6.1-terra) | 1,522(うちキャッシュ読み 1,462) | 51 | \$0.402 |
まとめて聞くと、入力トークンは Decisions で 25%、Jev で 46% 減りました。料金も同じ割合で下がります。Jev の減り方が大きいのは、Jev が入力(state)を質問の数に関係なく1回だけ数える仕組みだからです。一方 Decisions では、先ほど見たとおり共通の指示文が質問ごとに付くため、減り幅が小さくなります。
意外だったのは、gpt-6-luna の JSON 生成が Decisions より安かったことです。生成モデルのほうは、AG2 が付ける指示文とスキーマで1件あたり約 1,522 トークンになりますが、そのうち約 1,469 トークンは毎回同じ内容なので、OpenAI のプロンプトキャッシュに当たり、単価が10分の1になっていました。Decisions にもプロンプトキャッシュはありますが、共有の入力が 1,024 トークン以上のときだけ効きます。今回のように求人票と経歴が短い入力では、キャッシュは一度も効きませんでした。
とはいえ、どの条件も 1,000件で1ドル未満です。この規模では料金の差は小さく、**判定モデルを選ぶ理由は「速さ」と「確率が取れること」**だと考えたほうが現実に合っています。
結果3:正答率
最後に正答率です。3項目すべてが正解だった割合を比べました。
図11:3項目すべて正解だった割合。72件×3回
職種と経験年数の適合は、6条件すべてで全問正解でした。差が出たのは優先度だけです。
| 条件 | 3項目すべて正解 | 優先度の正答率 |
|---|---|---|
| Decisions・1問ずつ×3 | 84.7% | 84.7% |
| Decisions・まとめて1回 | 84.7% | 84.7% |
| Jev・1問ずつ×3 | 91.7% | 91.7% |
| Jev・まとめて1回 | 91.7% | 91.7% |
| LLM JSON(gpt-6-luna) | 100.0% | 100.0% |
| LLM JSON(gpt-6.1-terra) | 99.5% | 99.5% |
まず大事な点として、まとめて聞いても正答率は下がりませんでした。1問ずつ聞いた答えとまとめて聞いた答えは、Decisions で 216 件中 216 件、Jev で 216 件中 214 件が一致しました。各質問は独立に答えられるので、まとめることで判断が混ざることはないようです。なお、3回の繰り返しで答えが変わったのは、Decisions で0件、Jev で1〜2件でした。
一方、優先度は「必須スキルと年数を満たすか」を確かめたうえで「歓迎条件を満たすか」を見る、2段階の判断です。こうした条件の組み合わせは、文章で考えながら答えられる生成モデルのほうが得意でした。判定モデルの誤りは、Decisions では別表記(synonym)の候補者が21回、スキル欠け(missing_skill)が9回、年数ちょうどの候補者が3回、Jev ではスキル欠けの候補者だけ(18回)に集中していました。Jev は「必須スキルが1つ足りない」ことを見落とし、通常や優先と答えがちでした。
ただ、この誤りの多くは、モデルの判断そのものではなく、答えの取り出し方で直せることが分かりました。次の手順で見ていきます。
手順4:スコアをそのまま信じない
score 型の答えは「平均を丸めた段階」
誤った例を1件ずつ見ていくと、モデルの確率では正解の段階が1位なのに、AG2 の答えが1段ずれているものが多く見つかりました。原因は、IntEnum(score 型)の答えの作り方にあります。
図12:score 型の答えが、確率が1位の段階とずれる仕組み(実際の1件)
Decisions API の score は、各段階の番号を確率で重み付けした平均です。AG2 の reply.content() は、この平均に最も近い段階を答えにします。「深刻度」や「満足度」のように程度を測る質問なら自然な作りですが、今回の優先度のようにルールで1つに決まる区分では、確率が割れたときに真ん中の段階へ引っ張られます。
そこで、同じ応答から「確率が最大の段階(argmax)」を取り出す関数を用意しました。2社で確率の形が違うので、両方に対応させています。
def top_level(meta_field: dict) -> int:
    """score 型の metadata から、確率が最大の段階を返す(OpenAI・Jev 両対応)"""
    probs = meta_field["probabilities"]
    if isinstance(probs, list):                       # OpenAI:[{"value": 0, "probability": 0.26}, ...]
        probs = {p["value"]: p["probability"] for p in probs}
    return int(max(probs, key=probs.get))             # Jev:{0: 0.26, 1: 0.29, 2: 0.45}

reply = await screener.ask(inp)
priority = Priority(top_level(reply.response.metadata["priority"]))
もう1つの直し方は、優先度を最初から IntEnum ではなく文字列の Enum(choice 型)で聞くことです。choice 型の答えは確率が最大の選択肢そのものなので、丸めは起きません。
class PriorityChoice(Enum):
    SKIP = "skip"
    """見送り:必須スキルのどれかが経歴にない、または職種での実務年数が必須年数に足りない"""
    NORMAL = "normal"
    """通常:必須スキルと必須年数を満たすが、歓迎条件を1つも満たさない"""
    HIGH = "high"
    """優先:必須スキルと必須年数を満たし、歓迎条件を1つ以上満たす"""

@dataclass
class ScreeningChoice:
    job_category: Annotated[JobCategory, Question(Q_CATEGORY)]
    experience_fit: Annotated[bool, Question(Q_FIT)]
    priority: Annotated[PriorityChoice, Question(Q_PRIORITY)]
取り出し方と confidence で正答率がどう変わるか
まとめて聞いた結果を、取り出し方だけ変えて採点し直しました。choice 型で聞き直した結果(別に 72件×3回を実行)と、confidence のしきい値で「自信のないものは人に回す」場合もあわせて示します。
図13:優先度の正答率は、答えの取り出し方と confidence のしきい値で変わる
| 優先度の取り出し方 | OpenAI Decisions | TypeSafe Jev |
|---|---|---|
| ① AG2 の答え(score を丸める) | 84.7% | 91.7% |
| ② 確率が最大の段階(argmax) | 97.2% | 94.0% |
| ③ Enum(choice)で聞き直す | 95.8% | 93.5% |
| ① のうち confidence ≥ 0.2 だけ | 96.8%(88% を自動処理) | 96.1%(95%) |
| ① のうち confidence ≥ 0.4 だけ | 100.0%(72% を自動処理) | 98.5%(93%) |
| ① のうち confidence ≥ 0.6 だけ | 100.0%(54% を自動処理) | 100.0%(88%) |
Decisions では、取り出し方を変えるだけで優先度の正答率が 84.7% から 97.2% に上がりました。Jev はもともと確率が1つの段階に集まりやすく、丸めの影響は小さめでした。
confidence は「どれくらい迷わずに選んだか」を0〜1で表す値です。Decisions では、confidence が0.4以上のものだけを自動で処理すると、残りは全問正解でした(自動で処理できたのは 72%、残りは人の確認に回す)。誤った答えは confidence が低く出ていたので、「自信のないものは人に回す」という運用が機能することが分かります。
ただし、ここで出した数字は、今回の自作データでの値です。スコアはそのまま正解の確率ではありません。同じ候補者でも Decisions は confidence 0.4、Jev は 1.0 を返したように、確率の出方はモデルごとに違います。しきい値は、自分の業務の正解つきデータで「人に回す件数」と「誤りの件数」を見比べて決めてください。今回の経験年数の適合(はい/いいえ)は、Decisions では確率が0.2未満か0.8以上にはっきり分かれ(Jev は0.6〜0.8が数件だけ)、どの区間も全問正解でした。データが簡単すぎたためで、実際の業務文書ではもっと中間の値が出るはずです。
つまずきやすい点
送る前に止められる書き方
一括判定のクラスには、使えない書き方がいくつかあります。代表的なものを1つずつ実行してみました。
# app/gotchas.py(抜粋):どれもリクエストを送る前にエラーになる
@dataclass
class OptionalField:      # Optional は不可
    experience_fit: Annotated[Optional[bool], Question("必須年数を満たしますか?")]

@dataclass
class WithDefault:        # 既定値つきは不可
    experience_fit: Annotated[bool, Question("必須年数を満たしますか?")] = False

@dataclass
class NoQuestion:         # 質問文がないフィールドは不可
    experience_fit: bool

@dataclass
class FreeText:           # 自由記述(str)は不可
    reason: Annotated[str, Question("推薦理由を書いてください")]
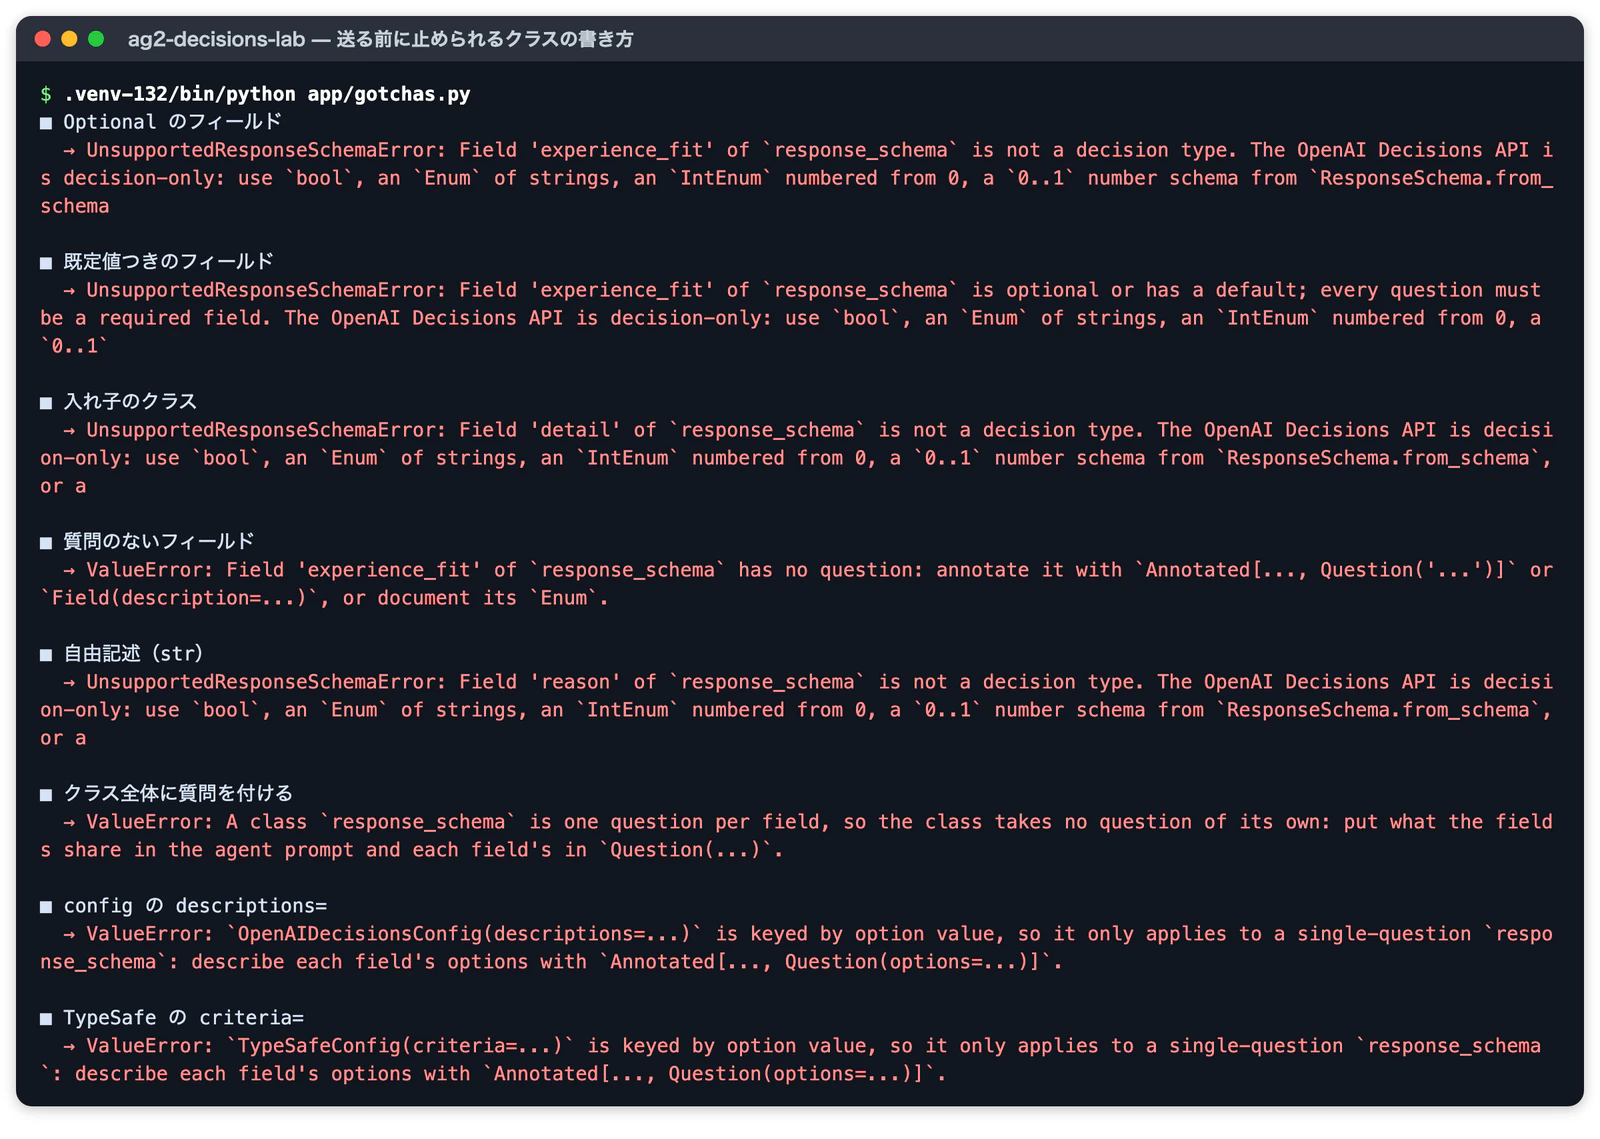
図14:使えない書き方8つを実行した画面。すべてリクエストを送る前に止まる
8つとも、API に送る前にエラーで止まりました。料金はかかりませんし、エラー文に直し方が書かれているので、慌てずに読めば対処できます。特に間違えやすいのは次の2つです。
-
クラス全体の説明は
ResponseSchema(Screening, description=...)では渡せない。全質問に共通の説明は、エージェントのpromptに書く -
選択肢の説明を config で渡す方法(OpenAI の
descriptions=、Jev のcriteria=)は、1問だけのスキーマでしか使えない。クラスでは、Enum のメンバーの下の文字列かQuestion(options={...})で書く
「どれか1つ」を bool で並べない
「バックエンドか」「フロントエンドか」「インフラか」を bool で3つ並べると、それぞれが独立に答えられるため、全部 True や全部 False もありえます。職種のようにどれか1つに決まるものは、Enum 1つで聞くのがドキュメントの勧める書き方です。あいまいな求人で実際に比べてみました。
図15:bool を3つ並べた場合と Enum 1つの場合の比較(OpenAI Decisions の実測)
「React の画面と Go の API の両方を担当」というフルスタックの求人では、bool では「画面(frontend)」が True、Enum では「サーバー側(backend)」が選ばれ、答えが食い違いました。bool の3つの確率は互いに無関係なので、比べても意味がありません。Enum なら確率の合計が1になり、confidence で迷い具合も分かります。
そのほかの注意点
-
質問どうしに依存関係があるときは分ける:「破損があるときだけ修理区分を聞く」のように、前の答えで次の質問が変わる場合は、別々の
ask()を順番に呼びます -
1問の拒否で全体が失敗する:OpenAI で1問でも拒否されると
DecisionRefusedErrorになり、ほかの答えも返りません。拒否されやすい質問(個人情報の推測など)は別のエージェントに分けておきます -
Enum の説明はソースコードから読まれる:Jupyter ノートブックや REPL で定義した Enum はソースが読めず、選択肢の説明が送られません。その場合は
Question(options={...})で説明を書きます。Jev の段階(score)はすべての段階に説明が必要なので、説明が読めないとエラーになります - 質問は1リクエスト400問まで(OpenAI)。それを超えるクラスは送る前に拒否されます
もう1つの変更:トークン使用量の数え方がそろった
v1.3.2 では、一括判定のほかに、トークン使用量の数え方も変わりました。複数のプロバイダーを混ぜて使っている方は、集計の値が変わるので注意が必要です。
図16:prompt_tokens の数え方の変更(v1.3.2 のリリースノートと今回の実測から)
これまで Usage.prompt_tokens の意味はプロバイダーごとに違い、OpenAI と Gemini はキャッシュに当たった分も含め、Anthropic と Bedrock はキャッシュされなかった分だけを数えていました。リリースノートには、実際には 8,630 トークン読んでいるのに prompt_tokens が 3 と記録される例が挙がっています。v1.3.2 では次のルールに統一されました。
-
prompt_tokensは入力の全体(キャッシュの読み・書きを含む) -
cache_read_input_tokensとcache_creation_input_tokensはその内訳で、足し算しない -
total_tokensはprompt_tokens + completion_tokens以上
今回の料金計算も、このルールに沿って「キャッシュなしの入力 = prompt − 読み − 書き」として、それぞれの単価を掛けています。
def cost_usd(usage, price_in, price_cache_read, price_cache_write, price_out):
    """100万トークンあたりの単価から、1回の料金(ドル)を出す"""
    read = usage.cache_read_input_tokens or 0
    write = usage.cache_creation_input_tokens or 0
    uncached = usage.prompt_tokens - read - write      # v1.3.2 のルールでは内訳を引く
    return (uncached * price_in + read * price_cache_read
            + write * price_cache_write + usage.completion_tokens * price_out) / 1e6
Anthropic と Bedrock を使っている場合、更新後は prompt_tokens・total_tokens・テレメトリの入力トークンがキャッシュ分だけ増えます。トークン予算や TokenMonitor のしきい値に、以前より早く届くようになる点に気をつけてください。過去に保存した使用量は書き換えられません。Gemini Live の思考モデルでは、思考トークンが completion_tokens に含まれるようになりました(今回は Anthropic・Gemini Live での実測はしていません)。
トラブルシューティング
今回の検証で実際に出たエラーと、直し方をまとめます。どれもエラー文の先頭を見れば、どこを直せばよいかが分かります。
図17:エラー文から直す場所を決める
| エラー文(先頭) | 原因 | 直し方 |
|---|---|---|
`response_schema` is not a decision type(Field 名なし) |
AG2 が 1.3.1 以前 | pip install -U "ag2[openai]==1.3.2" |
Field 'x' of response_schema is not a decision type |
str・Optional・入れ子・list | bool/Enum/0始まりの IntEnum/0〜1の数値にする |
… is optional or has a default |
既定値つきのフィールド | 既定値を外して必須にする |
ValueError: Field 'x' … has no question |
質問文がない |
Annotated[..., Question("…")] を付ける |
ValueError: A class response_schema … takes no question |
クラス全体に説明を付けた | 共通の説明は prompt に書く |
ValueError: … descriptions=(criteria=) … only applies to a single-question |
config で選択肢の説明を渡した |
Question(options={...}) かメンバーの docstring に書く |
DecisionRefusedError |
1問が拒否された | 拒否されやすい質問を別のエージェントに分ける |
TypeError: must be real number, not Timeout |
Jev の config に httpx のクライアントを渡した |
httpx2.AsyncClient を渡す |
最後の行は、手順2で通信を記録しようとしたときに実際に出たエラーです。TypeSafe の config は httpx ではなく httpx2 のクライアントを受け取るため、型が合わないと分かりにくいエラーになりました。
どう使い分けるか
ここまでの結果を踏まえて、「まとめる」「分ける」「生成モデルに任せる」の判断の順番を図にしました。
図18:まとめる・分ける・生成モデルに任せる、の判断の順番
業務のエージェントに組み込むなら、次のような分担が現実的だと考えています。
- 入口の振り分け・分類(職種、部署、スパム判定など)は、判定モデルの一括判定で速く安く済ませる
- 条件が重なる判断(今回の優先度のような2段のルール)は、choice 型で聞くか argmax で取り出し、confidence が低いものだけを生成モデルや人に回す
- 理由の説明や返信文が必要な部分は、最初から生成モデルに任せる
今回の「求人票に職種・経験年数の適合・推薦優先度の3項目を一括判定し、LLM の JSON 生成と比べる」実験の結果は、時間では判定モデルが大きく勝ち、料金はこの規模ではどれも誤差の範囲、正答率は条件の重なる項目で生成モデルが上でした。一括判定はそのどれも悪くせずに、リクエスト数とトークンを減らせる、というのが実感です。
まとめ
- AG2 v1.3.2 では、質問を付けたフィールドを並べたクラスを
response_schemaに渡すだけで、複数の判定が1リクエストで返るようになった。OpenAI Decisions と TypeSafe Jev の両方で、dataclass・TypedDict・Pydantic が使える - 実際の通信を記録すると、従来の3リクエストが1リクエストになり、入力トークンは Decisions で 25%、Jev で 46% 減った。まとめても正答率は下がらなかった
- 判定モデルは1件 0.18〜0.26 秒で、LLM の JSON 生成(1.52〜1.86 秒)より大幅に速い。一方、条件が重なる優先度の判定は生成モデルのほうが正確だった
-
IntEnum(score 型)の答えは確率の重み付き平均を丸めた段階なので、区分を選ぶ質問では Enum で聞くか argmax で取り出す。Decisions の優先度は 84.7% → 97.2% に上がった - confidence で「自信のないものは人に回す」運用は機能したが、しきい値は自分の正解つきデータで決める。スコアはそのまま正解の確率ではない
- トークン使用量の数え方が全プロバイダーでそろい、Anthropic・Bedrock では
prompt_tokensが増える。ACP を使う人はagent-client-protocol1.0 への更新が必要
次の一歩としては、自分の業務の判定(問い合わせの振り分け、レビューの分類など)を数十件ほど正解つきで用意し、今回の run_bench.py と同じ形で「1問ずつ」「まとめて」「LLM の JSON」を比べてみるのがおすすめです。confidence の分布を見て、どこから人に回すかを決めるところまでやると、そのまま本番の設計に使えます。
参考リソース
- AG2 v1.3.2 リリースノート(GitHub):https://github.com/ag2ai/ag2/releases/tag/v1.3.2
- AG2 ドキュメント「Decision Models」(Several questions at once):https://docs.ag2.ai/docs/user-guide/decision_models/
- AG2 ドキュメント「Telemetry」(トークン使用量):https://docs.ag2.ai/docs/user-guide/telemetry/agent/
- OpenAI「Decisions」ガイド:https://developers.openai.com/api/docs/guides/decisions
- OpenAI 料金ページ:https://developers.openai.com/api/docs/pricing
- TypeSafe 料金ページ(Jev):https://typesafe.ai/pricing