
個人開発で、情報収集、日記分析、ポッドキャスト制作などを動かすマルチエージェントの仕組みを作っています。
機能が増えてくると、新しい処理は動くのに、それまで動いていたワークフローが止まることが増えてきました。原因を調べると、AIの判断よりも、その前後で受け渡している入力や成果物の形式が合っていないケースが目立ちます。
必要な項目がない。参照先の解釈が違う。ある場所では省略可能だった値が、別の場所では必須になっている。そうした修正を重ねるうちに、実行基盤全体の契約を見直すことになりました。
この記事では、2026年9月に行った契約構造の改修を振り返ります。ここでいう「契約」は、処理の入力・出力・参照・権限など、各部品が守る機械的な約束です。現在の基盤には後続の改修も入っているため、当時の設計と移行の話として読んでください。
Schemaはあるのに受け渡しがずれる
当時の基盤には、すでにWorkflow、Job、成果物などのSchemaがありました。何も決めずにJSONを渡していたわけではありません。
それでも、同じ契約を解釈する場所が増えていました。
- Materializer:計画から実行用のJobを作る
- Dispatcher:依存関係や承認を確認して配送する
- Runner Launcher:実行環境を選び、Runnerを起動する
- Runner:実際の処理を実行する
例えばMaterializerが新しい形式でJobを作っても、Runner側に古い必須条件が残っていれば止まります。Dispatcherが不足項目を独自に補完すると、そこを通ったJobだけが動く状態にもなります。
固定ワークフローに加えて、一時的な計画や、途中で計画が増える動的ワークフローも扱うようになり、経路ごとの差がさらに増えていました。
問題はSchemaの数だけではありません。Schemaに書かれた約束と、実際に各層が要求する約束がずれていたことです。

何を実行するかを一枚の契約から辿れるようにする
改修では、job-contract.jsonを、そのJobの現在の実行契約を示す正本にしました。
実行対象、入力、出力先、要求する書込み範囲などは、この契約か、契約から一意に辿れる参照に置きます。大きな資料まで全部JSONに埋め込むのではなく、必要に応じて参照とSHA-256で結び付けます。
後段の処理がWorkflow固有の設定を探し回って、「たぶんこの保存先だろう」と補う構成は避けます。契約で足りない情報は、その情報を確定する責任のある場所へ戻って直すようにします。
ただし、契約に書けばどんな操作でも実行できる、という意味ではありません。実行環境の安全制約やHost起動のポリシーは別に残します。Jobが自分で権限を付与することはできません。
4層そのものを一つにまとめることもしませんでした。配送と環境選択と実行には、それぞれ役割があります。減らしたかったのは、それぞれの層に増えた独自の契約解釈でした。
Materializerを契約のコンパイラとして扱う
もう一つ変えたのが、Jobを作る段階です。
従来は、作ったJobがCapabilityの入出力に合っているかを、後から検査する使い方が中心でした。新しい設計では、Capabilityの宣言とSchemaを使い、適合するJobを最初から生成する方向に寄せました。
Capabilityは、ここでは「資料を準備する」「台本を書く」といった実行可能な能力の単位です。Materializerは、その宣言から入力、出力、参照、設定を解決し、最初の契約を作ります。仕様書ではこれをContract Compilerと呼んでいます。
共通Materializerに、Capabilityの名前ごとの分岐を増やさないことも原則にしました。能力を追加するたびに基盤本体を書き換えると、別の能力への影響が広がるからです。
一方で、すでに動いている個別の変換処理まで全部捨てたわけではありません。既存のAdapterや生成処理は必要に応じて残し、共通契約の保存・検査へ接続する方針にしています。今回の問題と関係のない全面的な汎用化は、改修の目的から外しました。
現在の契約は更新し重要な時点は固定する
この部分は、検討の途中で方針が変わりました。
9月5日の初期案では、Jobを作ったら不変にし、変更が必要なら新しいJobを作る考え方でした。しかし9月9日付の詳細仕様では、現在の契約は更新可能にし、重要な時点の状態を不変のcheckpointとして保存する方式に整理しています。
配送や起動の段階で初めて決まる情報があるためです。すべてを最初に確定したことにするより、確定した情報を担当層が追記し、その経緯を残す方が実際の処理に合っています。
そこで、契約にcontract_revisionを持たせました。実質的な更新があればrevisionを一つ進め、変更者と理由を記録します。再読取りや検査だけでは進めません。
さらに、承認、Queue受入、実行開始などでは、その時点の契約をsnapshotに固定します。
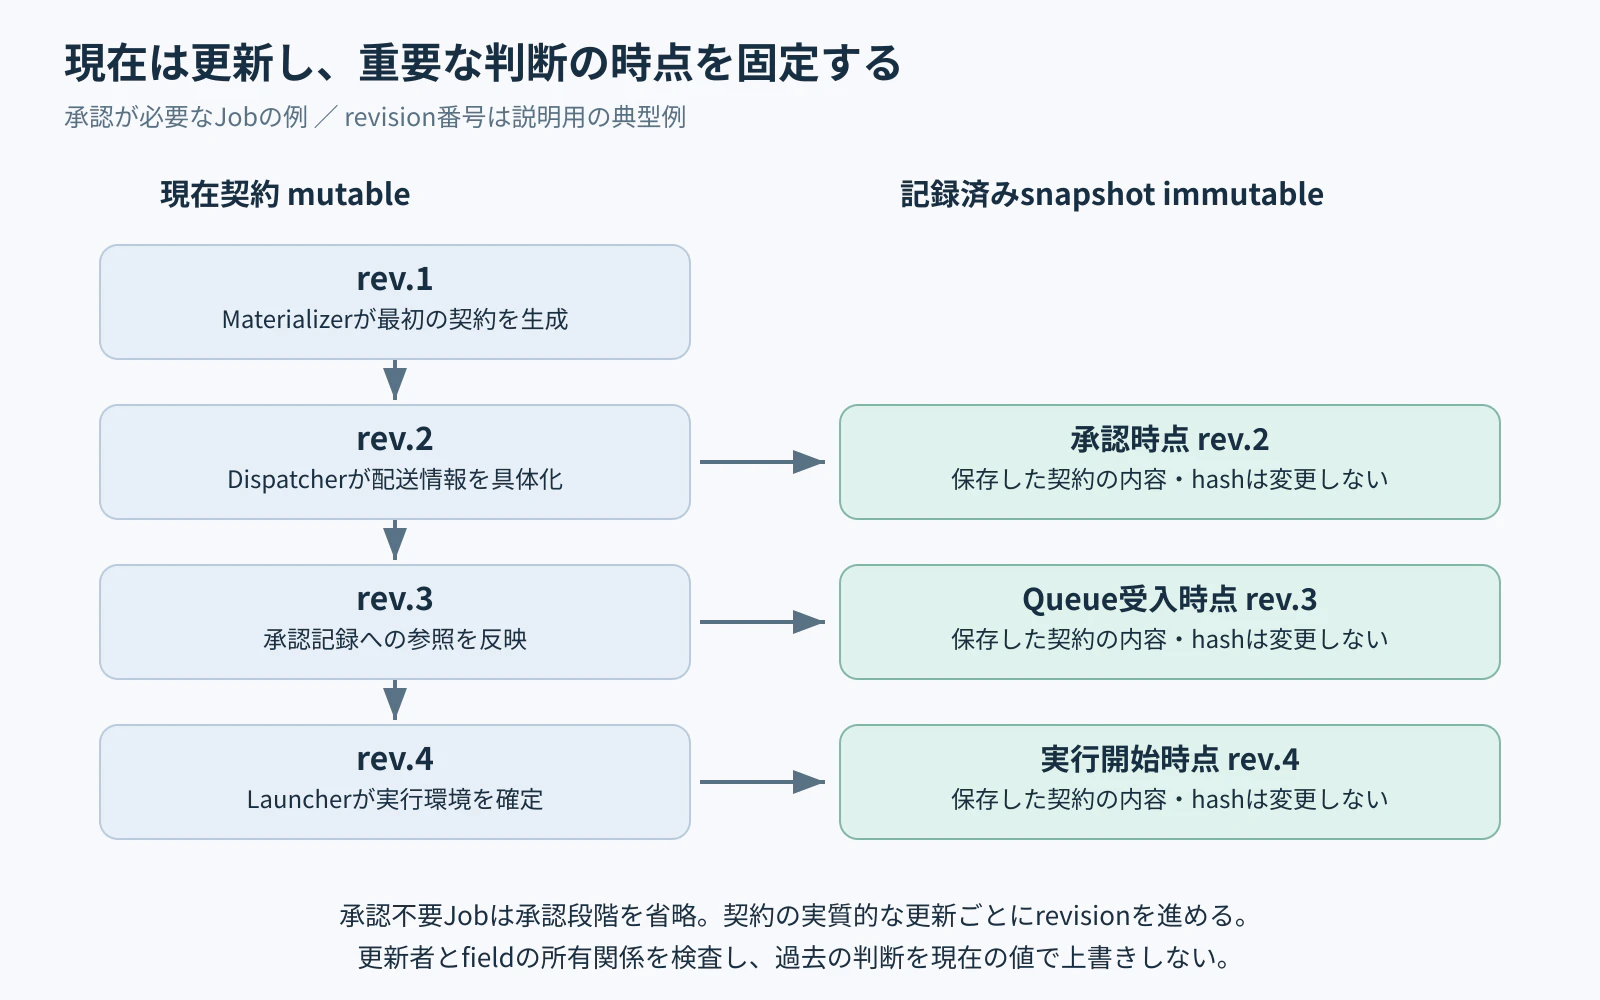
これで、「現在何を実行しようとしているか」と「何に対して承認したか」を別々に確認できます。
承認後の変更も一律には扱いません。入力や出力先、書込み範囲などが変われば、以前の承認をそのまま使ってよいか確認が必要です。一方、承認対象に影響しない実行時の監査情報が増えただけなら、revisionが進んだという理由だけで再承認する必要はありません。
一枚に集約しても誰でも書ける状態にはしない
現在契約を更新可能にすると、今度は複数の層が勝手に上書きする問題が起きます。そのため、fieldごとに更新できる層を決めました。
主な分担は、実行対象や入出力はMaterializer、配送と承認への参照はDispatcher、起動環境や事前照合はRunner Launcher、実行時の監査情報はRunnerです。
例えばRunnerが、入力の省略可能な項目を独自に必須扱いすることは認めません。Launcherが実行対象のCapabilityを勝手に変更することも認めません。
更新時には、期待していたrevisionと現在のrevisionが一致しているか、変更するfieldをその層が所有しているかを確認する仕様にしました。古い内容を元にそのまま上書きするのではなく、不一致なら読み直して判断します。
正本を一つにするだけでなく、更新できる人と更新方法もセットで決める必要がありました。
AIには成果の意味を任せ機械的な情報を分ける
契約見直しでは、AIが返す内容の範囲も整理しました。
台本、分析結果、観察、結論などはAIが生成します。一方、正式な成果物のメタデータ、参照先、SHA-256、出力先の確定などはRunnerやAdapterなどの機械層が担当します。
例えば分析結果が欲しいなら、AIには必要な観察や結論を書いてもらいます。その結果をどこへ保存し、どの型の成果物として扱い、どのhashを持つかは、保存された実体に基づいて機械的に決めます。
AIがもっともらしいhashや参照を返しても、それをそのまま正式な契約として採用しないようにしました。入力と出力の意味を伝える提示も、既存のCapability契約やSchemaから導出し、別の独立した契約を増やさない方針です。
実装して終わりではなく実際のワークフローへ戻した
9月13日の日記には、契約見直しの実装を終え、固定ワークフローを通していく段階に入ったことが残っています。ただ、その時点ですべてが通ったわけではありません。日記分析レポートは作れた一方で、その先のWeeklyTodo作成まで進まなかった記録もあります。
その後も修正を続け、9月20日にはAI探求ラボが最後まで完走したと記録しました。途中では最後の処理で失敗することもあり、設計を変えた瞬間に安定したわけではありません。
今回の改修と修正から得た知見は、ポリシーと手順としても残しました。同じ契約の問題を、次の実装で繰り返さないためです。
ここで示せる結果は、実装後に実際のワークフローを動かし、問題を直しながら完走へ進めたことです。障害率の比較や、すべての実行経路の無欠陥を示すものではありません。
振り返り
マルチエージェントの仕組みでは、各エージェントの役割を分けることに目が向きやすいと思います。実際に運用してみると、その間をつなぐ機械的な約束も、同じくらい重要でした。
今回、特に意識するようになったのは次の点です。
- 同じ契約を各層が独自に補完していないか
- 現在の状態と、過去の判断に使った状態を区別できるか
- 新しい能力を追加するたびに、共通基盤へ専用分岐を増やしていないか
小さな不一致への修正を続けるうちに、契約の置き場所と更新の仕方まで見直すことになりました。最初からここまでの構成が必要とは思いません。ただ、部品が増えるたびに別の経路が壊れ始めたときには、入力項目を足す前に、約束を誰が決め、誰が読み、誰が更新しているかを整理する価値がありました。