
個人開発で、複数のAIエージェントを組み合わせた仕組みを作っています。情報を集め、資料を準備し、ポッドキャストを制作するほか、ワークフロー自体の改善監査などもワークフローとして動かしています。
2026年8月末、その基盤で子Codexを動かす部分が詰まりました。実装エージェントを直していたのですが、業務の手順を調整するだけでは片付かず、最終的にはRunner Launcherという起動窓口を追加して、実行経路を作り直しました。
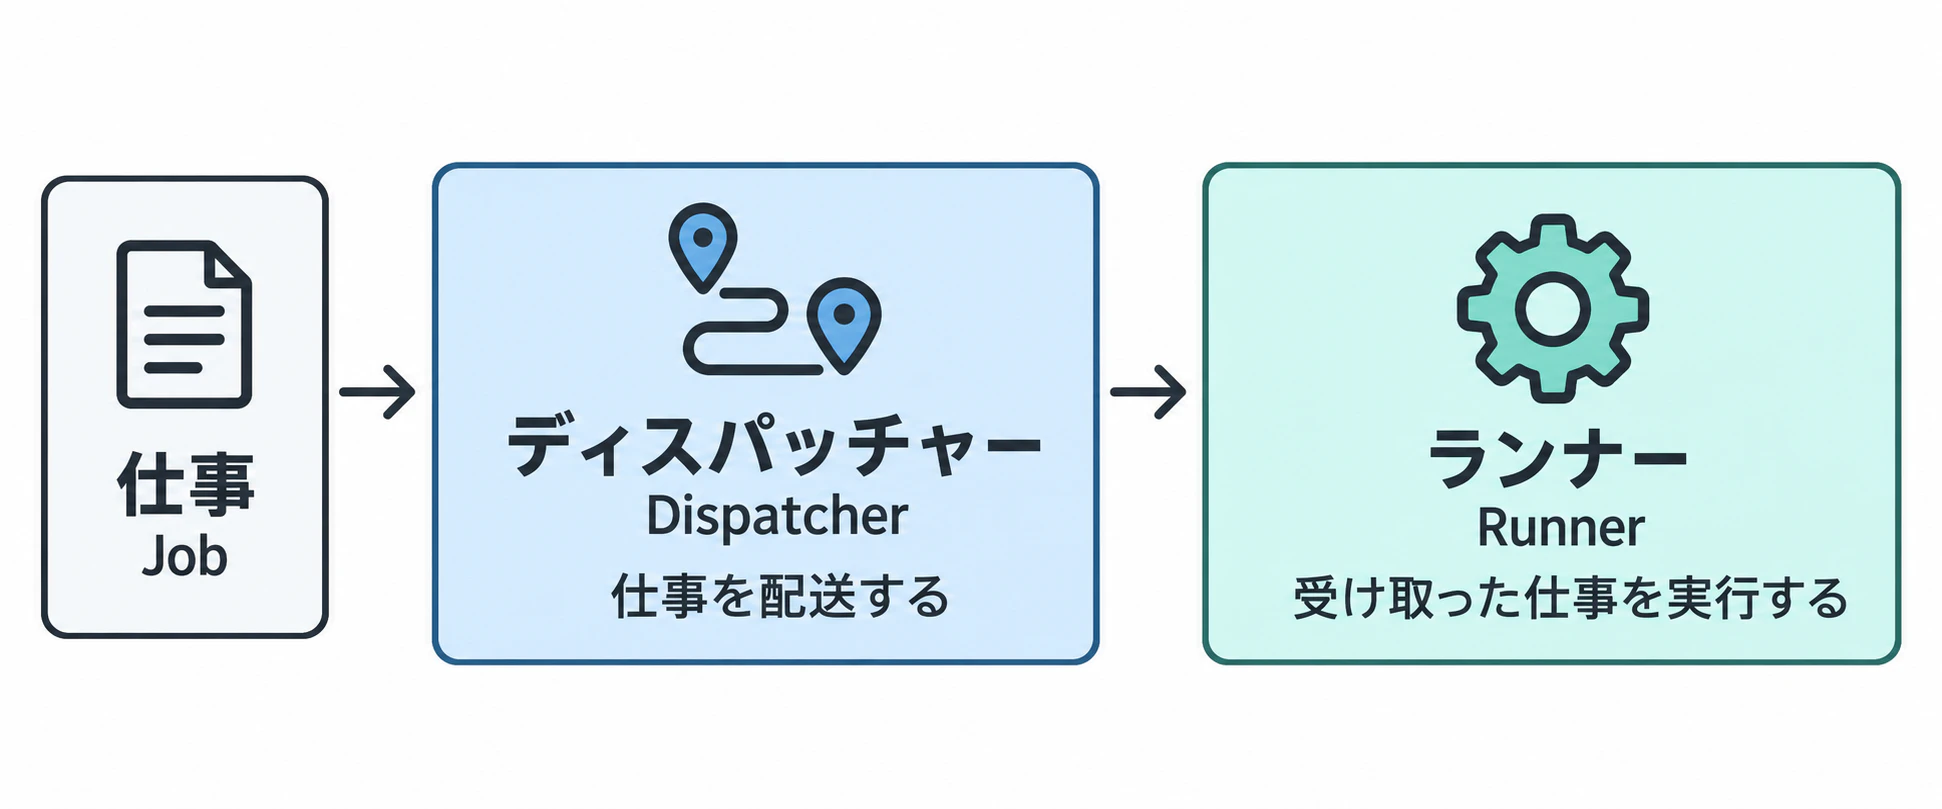
仕事を配送するDispatcherと実行するRunnerの間に、実行環境を選ぶ窓口を置きました。子Codexを使うJob(実行単位)は利用者が明示的にHost起動する経路へ、スクリプトだけで完結するJobは従来の実行環境へ分けます。子エージェントへの指示を直す前に、起動条件をそろえる必要があったためです。
この記事では、2026年8月末〜9月初頭の設計と、既存ワークフローを通し直した記録をまとめます。対象は当時のWindows環境での事例です。現在のCodex全般の制約や、どの環境でも同じ方法で解決することを示すものではありません。
子Codexまで届く前に止まっていた
当時確認できていた状況は、次のようなものでした。
- WindowsのSandbox内から子Codexを起動すると、モデルとの通信に失敗する。
- Codex Desktopで利用者が明示的にEscalated Executionを使い、Host側の実行主体から既存Runnerを起動すると、Codex SDKと出力検証まで動作する。
- 一方、外部プログラムからDesktopの昇格実行を要求する正式APIは確認できていない。
ここでいうHost側は、Sandbox内の実行主体とは別に、利用者が明示的な操作で起動した実行主体です。Launcherが自動的に権限を上げるわけではありません。
この条件では、Jobの説明を詳しくしたり、子エージェントへの指示を言い換えたりしても、通信を始める環境の問題は残ります。
また、「Hostなら動いた」という確認だけで、通常の実行経路をすべてHostへ移してよいわけでもありません。スクリプトだけで完結するJobもあり、承認が必要な実行との区別も必要です。
そこで、Jobを選んで渡すDispatcherと、Jobを実行するRunnerの間に、起動のための境界を置くことにしました。
起動窓口をRunner Launcherへ集める
新しい構成では、通常のFixed/Dynamic Jobを起動するとき、DispatcherはRunnerを直接起動しません。Runner Launcherへ最小限の情報を渡します。
LauncherはJobの実行種別を見て、起動経路を分けます。
-
script:従来どおり、現在の実行環境で既存Runnerを起動する。 -
codex:必要な承認対象を固定し、利用者による明示的なHost起動を待つ。
ここで重要なのは、Launcherに業務処理を移していないことです。成果物の作成や出力検証は既存Runnerのままです。Launcherは「何を作るか」を判断せず、「このJobをどの経路で起動するか」を扱います。

初回の移行では、Podcast公開などの専用外部Runnerは例外として残しました。既存の承認や外部アクセスの契約を、その場でまとめて変更しないためです。入口を整理することと、すべての実行経路を一度に統合することは分けました。
自動化できない境界を、待機状態として表す
当時の仕様では、Codex Jobをすぐ実行待ちのQueueへ入れるのではなく、Host起動が必要な段階で利用者への入力待ちにします。
Run(一連の処理全体)の状態は既存のwaiting_for_inputを使い、独自の状態は増やしません。この待機中は当該RunのQueueをpending 0 / leased 0にし、実行待ちや実行担当を割り当て済みのJobを残しません。
これは小さな条件に見えますが、承認待ちの処理を実行可能な仕事として残さないために必要でした。人の操作が必要なのにQueueには動けるJobがある、という状態では、再試行や別のRunnerがそれを拾ったときの意味が曖昧になります。
利用者が取り消した場合は、入力応答を記録してRunを終了します。承認待ちのまま処理を回し続けたり、失敗した経路へ勝手に戻したりはしません。
起動する内容をチケットで固定する
手動で起動するとしても、毎回自由なコマンドを組み立てる方式にはしませんでした。
Launcherは、対象Job、承認要求、実行ポリシー、Runner、Host Launcherなどの参照とSHA-256を持つ、一回限りの起動チケットを作ります。Host Launcherが受け取る入口は、そのチケットだけです。
Host側では、実際の実行主体、チケットの配置場所、対象Runの状態、参照とハッシュ、固定ポリシーとの一致を再確認します。チケットは排他的にclaimし、同じチケットから実行を重複登録できないようにします。
ここでのハッシュは、プログラムの安全性そのものを証明するものではありません。承認した内容と、実際に起動しようとしている内容が食い違わないようにするための照合です。固定ポリシーの作成・更新も、通常Runが勝手に行う処理にはしませんでした。
当時の流れは、チケットを作成して入力待ちに入り、利用者が固定Host Launcherを実行し、Host側の検証と承認を経て、新しい実行Jobを登録する順序でした。その後で既存RunnerがJobを受け取り、通常の実行へ進みます。

この「承認後に別の実行Jobを作る」方式は、9月9日付の契約見直し仕様書では、承認後も同じJobを使う方式へ変わっています。ここで説明しているのは、Launcher導入時の設計です。
チャットでの承認と、Host起動を同一視しない
もう一つ決めたのは、チャットで「approve」と返しただけでは、Host起動の承認済み状態にしないことです。
当時の経路では、利用者が表示された固定Host Launcherを、DesktopのEscalated Executionで明示的に実行します。そのHost側の検証結果をもとに、承認と実行を結びつけます。通常チャットからは取消を選べますが、Host起動を代行したことにはしません。
チャット上の返答だけで、Hostでの検証を済ませたことにしないためです。
また、自動フォールバックもしません。Host起動に失敗したからといって、Sandbox側で同じCodex Jobを再実行する設計にはしませんでした。動作条件を変えるのであれば、その条件に合った承認と検証が必要になるからです。
起動の責任を独立させると、失敗を追いやすくなる
この改修で整理したかったのは、単に子エージェントを起動する方法ではなく、失敗した場所を区別できる構造でした。
Jobの内容に問題があるのか、モデルへの入力に問題があるのか、その前に実行環境で止まっているのか。これらを同じ「エージェントが失敗した」にまとめると、業務の指示ばかりを直し続けてしまいます。
今回、Launcherに集めたのは実行環境の選択と起動条件です。業務処理を担うRunnerとの境界を置くことで、どこを直すべきか、どこで人の操作を待つべきかを説明しやすくなりました。
マルチエージェントの仕組みでは、エージェントを増やす部分に目が向きます。ただ、増えた仕事をどの実行主体で、どの承認に基づいて開始するかも、同じくらい重要な基盤の設計でした。