
個人で、情報収集やポッドキャスト制作などを行うマルチエージェントの仕組みを作っています。いくつかの処理を順番につなぎ、途中で失敗すれば再試行し、必要に応じて人の承認も受ける構成です。
処理が止まったときに困ったのが、ログは残っているのに、今の状態をすぐには判断できないことでした。実行を管理するファイルが増え、状態、履歴、結果、承認などの記録を突き合わせる必要が出てきたためです。
そこで2026年9月に、現在の状態、そこへ至った経緯、作った成果物を分けて保存し、正式な記録を書き込む窓口もそろえました。この記事では、9月25〜26日の移行記録に沿って、何を変え、どこまで確認したのかをまとめます。
この記事でいうRunとJob
先に、実行の単位を二つだけ説明します。
- Run:一連の処理を最初から最後まで実行する、ひとまとまり。たとえば「今回のポッドキャストを1本作る」という実行全体です。
- Job:Runの中で実行する個々の仕事。たとえば、台本作成や音声生成に相当する単位です。
この記事では、処理の手順をWorkflow、仕事を実際に動かす実行器をRunnerと呼びます。同じ工程を再試行することもあるため、工程数とJobの試行数は一致しない場合があります。
今回作り直したのは、こうしたRunやJobの状態と経緯を残す仕組みです。新しい保存方式には、Run Record V1という名前を付けました。以下では、まず記録の役割分担を説明し、その後に旧履歴の移行と実行後の検証を紹介します。
どの記録を見れば今の状態が分かるのか
処理が止まったとき、知りたいことはそれほど複雑ではありません。
- どの工程まで終わったのか
- 何が原因で止まり、次に何をすればよいのか
- その成果物は、どの試行からできたものなのか
ところが、状態や結果が複数のファイルへ分かれ、仕事の配送・実行待ちを管理するQueueにも別の状態があると、それぞれが同じ実行を表しているか確認しなければなりません。古い形式の履歴も混ざるので、新しい形式のルールだけで読むこともできません。
ファイルを一つにまとめれば済むかというと、それも違いました。現在の状態、そこへ至った経緯、実際に作った成果物は、読む目的も更新の仕方も異なります。必要だったのは、情報を無理に一か所へ詰めることよりも、どの情報を何の根拠として扱うかを決めることでした。
現在の状態と経緯と成果物を分ける
新しい構造では、記録を読む目的に合わせて、主に三つの役割へ整理しました。
- Record:RunやJobの現在の状態・結果と、実行する仕事の取り決め(契約)を確認するための記録
- Event:制御、実行、対話の経緯を残す履歴
- Artifact:記事、音声、報告などの成果物
Runの情報はrun-record.json、各Jobの契約・状態・結果はjobs/<job-id>.jsonへ集約します。Eventは制御・実行・対話の3系統に分け、成果物そのものはArtifactとして扱います。
この区別があると、「今の状態を見る」と「その状態になった理由を追う」を分けられます。Queueや承認の仕組みは残し、それらと正式な記録の役割を整理しました。人向けの要約も便利ですが、その表示だけを根拠に処理を進めず、正式な記録と照合します。
書込みの窓口も一つにする
保存形式をそろえても、複数の実行器がそれぞれ正式ファイルを更新できれば、更新のルールはまた分散します。そこで、正式な記録の更新を、保存を受け付ける窓口であるStorage Brokerへ集約しました。以下ではBrokerと略します。
Runnerは業務処理を実行しますが、正式なRunやJobの記録を好きなように書き換える役割にはしません。正式保存への要求はBrokerを通し、対象のRunやJobの範囲を検証します。
なお、実装上の保存窓口を一本化することと、OSの権限で直接書込みを防ぐことは、別の確認項目です。別Windowsユーザーを使った隔離試験では直接書込みの拒否も検証しましたが、本番の保存領域に同じ設定を適用した、という意味ではありません。この区別は後の検証でも残しました。

過去の履歴は、全部新形式に変換しなかった
移行時にもう一つ大きかったのが、旧形式の扱いです。過去の実行を新形式へ変換し直すと、移行の不具合で元の証拠を変えてしまうおそれがあります。
今回は、新規RunをV1へ切り替え、旧Runは読取り専用で残す方針にしました。ただし、実行途中の旧Runや、処理中に見えるQueueを放置したまま切り替えたわけではありません。
切替前に旧Runを273件照合しました。更新可能な旧形式については、残っていた実行や入力待ちを正規の手順で終端・整理しました。もともと履歴専用だった古い世代は、無理に更新せず、その時代の状態として保持しています。旧Queueも記録と実プロセスを照合して整理しました。
そのうえで、18,646ファイルを監査対象として正式切替を行いました。切替後は旧273件の監査対象バイト列が変わっていないこと、旧形式の書込み処理(Writer)からの書込みが拒否されること、読取り用の互換処理では参照できることを確認しています。
つまり、273件を新形式へ変換したのではありません。古い履歴を守りながら、新規実行の入口を切り替えた移行です。
履歴から組み立てた状態と保存済みの状態を照合する
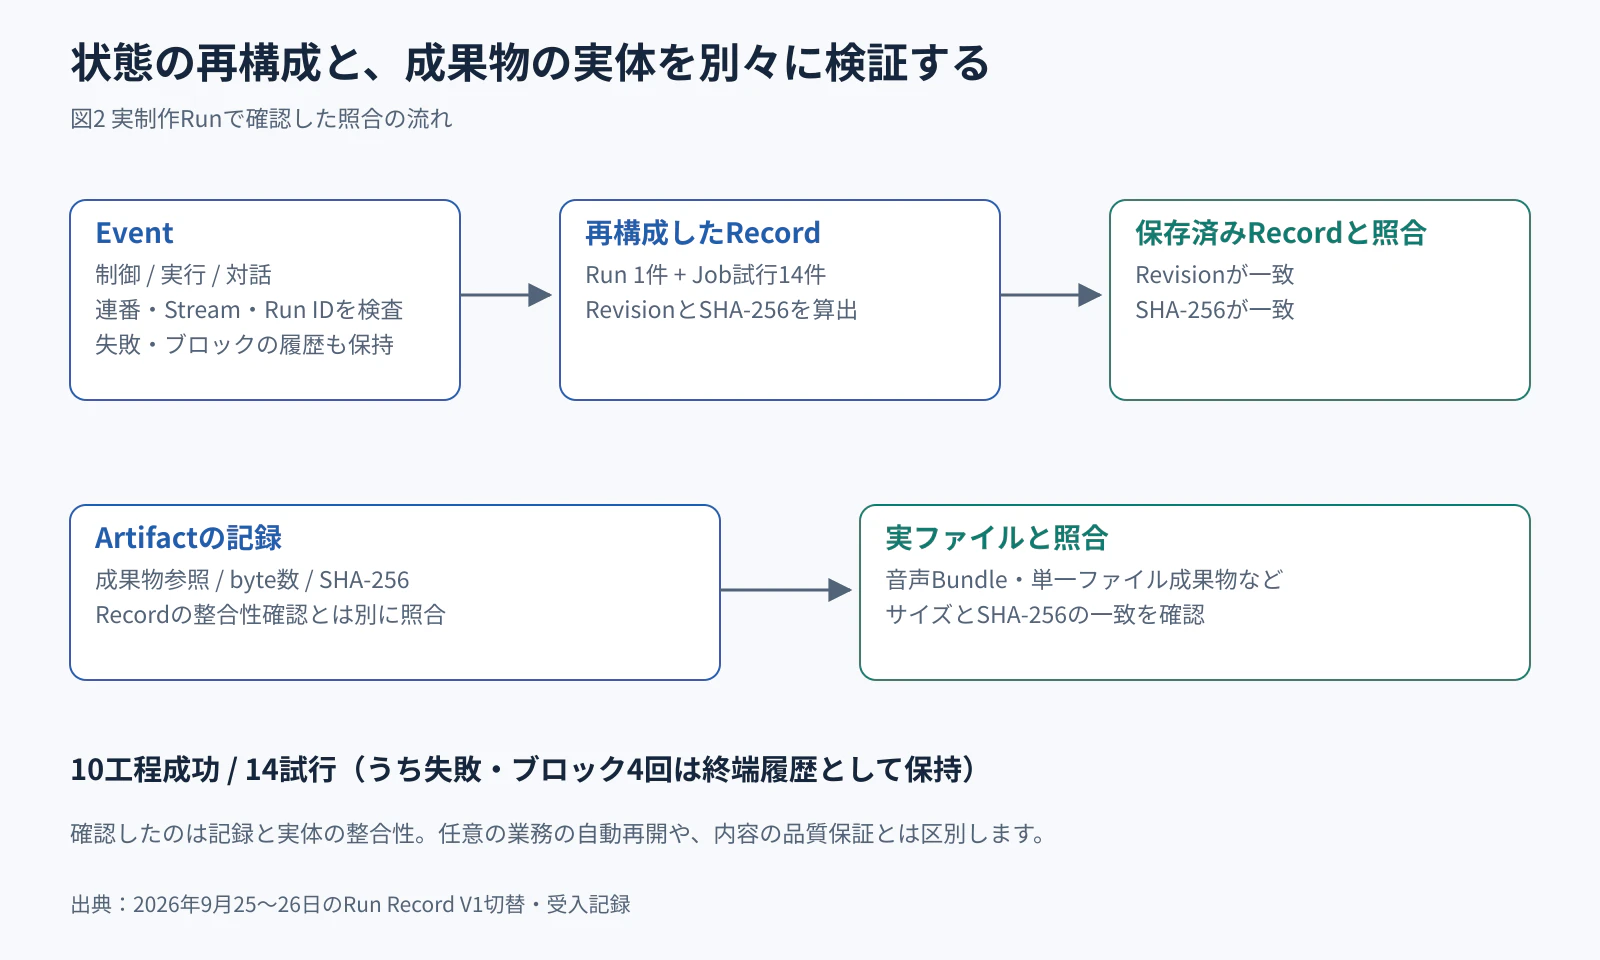
保存できたことだけでは、記録同士が整合しているとは限りません。そこで、EventからRunとJobの状態を再構成し、保存済みのRecordと比較しました。
実際に完走したポッドキャスト制作Runでは、10工程が成功しています。ただし途中の再試行も含めると、Jobの試行は14回でした。そのうち4回は失敗・ブロックであり、成功した試行には数えていません。削除せず、終端した試行として残しています。
このRunについて、Eventの連番、格納先の系統(Stream)、Run IDを検査しました。さらに、Run全体のRecordと14件のJob RecordをEventから再構成し、保存済みのRecordと比べました。更新番号(Revision)と、内容の一致を照合するためのハッシュ値(SHA-256)が一致することを確認しています。
状態の再構成とは別に、成果物も照合しました。記録された参照だけで済ませず、音声をまとめたBundleに含まれる112ファイルと、11件の単一ファイル成果物のサイズ・SHA-256を確認しています。アーカイブ先も記録と照合しました。これらは保存内容の整合性の確認であり、台本や分析などの意味内容の正しさまで証明するものではありません。
公開の確認は、そのRunで公開・検証Jobが残した証跡に基づきます。この監査時に公開URLを再取得したわけではありません。また、この再構成試験は記録の整合性を確認するもので、障害後の任意の業務を安全に自動再開できることまで示すものではありません。
管理ファイル数は同条件では比較できなかった
旧方式の基準Runでは、通常管理ファイルは173件でした。V1の実制作Runでは19件です。見た目には大きく減っていますが、この数字だけで削減率を出すことはしませんでした。
両者ではJobの試行数などの条件が異なります。さらに、管理ファイルと成果物を混ぜて数えると、音声ファイルが多いRunほど大きく見えてしまいます。今回のV1 Runは合計149ファイルで、そのうち通常管理19件、通常管理とは別枠の「独立例外」6件、成果物124件でした。Run外のQueueも別枠です。
比較するなら、何を管理ファイルに含めるか、工程数と試行数、承認条件などをそろえる必要があります。まずは「どんな種類の記録がどれだけあるか」を説明できることを優先しました。
実行して初めて見つかった二重記録
移行後の実Runを調べると、標準出力・標準エラーが、専用Eventと、進捗などを伝えるActivityの両方に保存されていることが分かりました。重複は465件、508,277 bytesでした。
これは履歴を消すのではなく、今後の実行で重複するActivity転送だけを止める修正にしました。生の出力と、意味のある進捗Activityは残します。保存済みのRunは書き換えていません。
修正後は、外部公開を伴わない隔離環境で、実Codexを使う2 Jobの固定Workflowを検証しました。最初の再検証では、出力ファイルなどを申告するManifestに形式不備があり、受理されませんでした。そのため、必要な形式を明記し、再実行で完走を確認しています。標準出力・標準エラー・進捗は残り、削減対象のActivityは0件でした。これは2 Jobの再検証であり、修正後に同じ10工程の制作Runをもう一度通した、という話ではありません。
振り返り
今回の改修は、ファイルを減らす作業から、実行状態の根拠を整理する作業へ広がりました。
現在の状態はRecordで確認し、理由を追いたいときはEventを読み、作ったものはArtifactとして照合する。その役割を分けたうえで、正式な書込み窓口をそろえました。
移行では、新しい実行を新形式へ切り替え、過去の履歴を守ることを優先しました。実行後には、Eventから再構成した状態と保存された状態を照合し、成果物についても実ファイルまで確かめています。
マルチエージェントの処理が増えるほど、成功した成果物だけでなく、失敗や再試行の経緯も次の改善に使います。そのために、記録を増やす前に、何をどの根拠として残すかを決めておくことが今回の改修から得られた学びです。