

AI アプリのリポジトリに、モデルやデータセットが何個入っているか把握していますか。
数えるための仕組みが AI-BOM(AI 部品表)です。SBOM を AI 領域に広げたもので、Snyk CLI には snyk aibom というコマンドがあります。
今回は Snyk が公開している snyk-labs/ai-bom-goof を使います。AI-BOM の挙動を見るために意図的に作られたデモリポジトリです。そのつもりで読んでください。
1. モデルを1つ呼んだだけで、データセットが21件載る
embed.py の中身です。Hugging Face のサンプルをそのまま貼ったような内容です。
from sentence_transformers import SentenceTransformer

sentences = ["This is an example sentence", "Each sentence is converted"]

model = SentenceTransformer("sentence-transformers/all-mpnet-base-v2")
embeddings = model.encode(sentences)
print(embeddings)
ところが AI-BOM には、データセットが21件載ります。
このリポジトリは、データセットを1つも直接使っていません。21件すべてがモデルカード由来です。all-mpnet-base-v2 の学習に使われたデータセットが20件、gemini-2.5-flash から1件、芋づる式にぶら下がってきます。
そのうち5件はライセンスが確定できません。
| データセット | ライセンス |
|---|---|
code_search_net |
Other |
eli5 |
Unknown |
search_qa |
Unknown |
trivia_qa |
Unknown |
yahoo_answers_topics |
Unknown |
npm や PyPI の SBOM なら、package.json に書いたものが載ります。AI-BOM は違います。モデルを1つ呼ぶと、その裏側にある学習データまで部品表に載ります。
2. 出してみる
必要なのは Snyk CLI v1.1298.3 以降だけです。
snyk aibom
標準出力に CycloneDX v1.6 の JSON が出ます。ai-bom-goof で出た内訳がこちらです。
| 種別 | 件数 |
|---|---|
| データセット | 21 |
| ライブラリ | 10 |
| モデル | 9 |
| エージェント | 6 |
| MCP サーバー | 2 |
| MCP クライアント | 1 |
| MCP リソース | 1 |
| MCP ツール | 1 |
| サービス | 1 |
| アプリケーション(Root) | 1 |
JSON のままだと読めないので可視化します。方法は2つあります。
# 1. Snyk 標準
snyk aibom --html > aibom.html

# 2. OSS のビューア
snyk aibom | npx aibom --view
標準の --html は閲覧時に cdnjs と unpkg から CodeMirror・Cytoscape を取りに行くので、閉域網では絵が出ません。この記事では見やすかった 2 のスクリーンショットを使います。
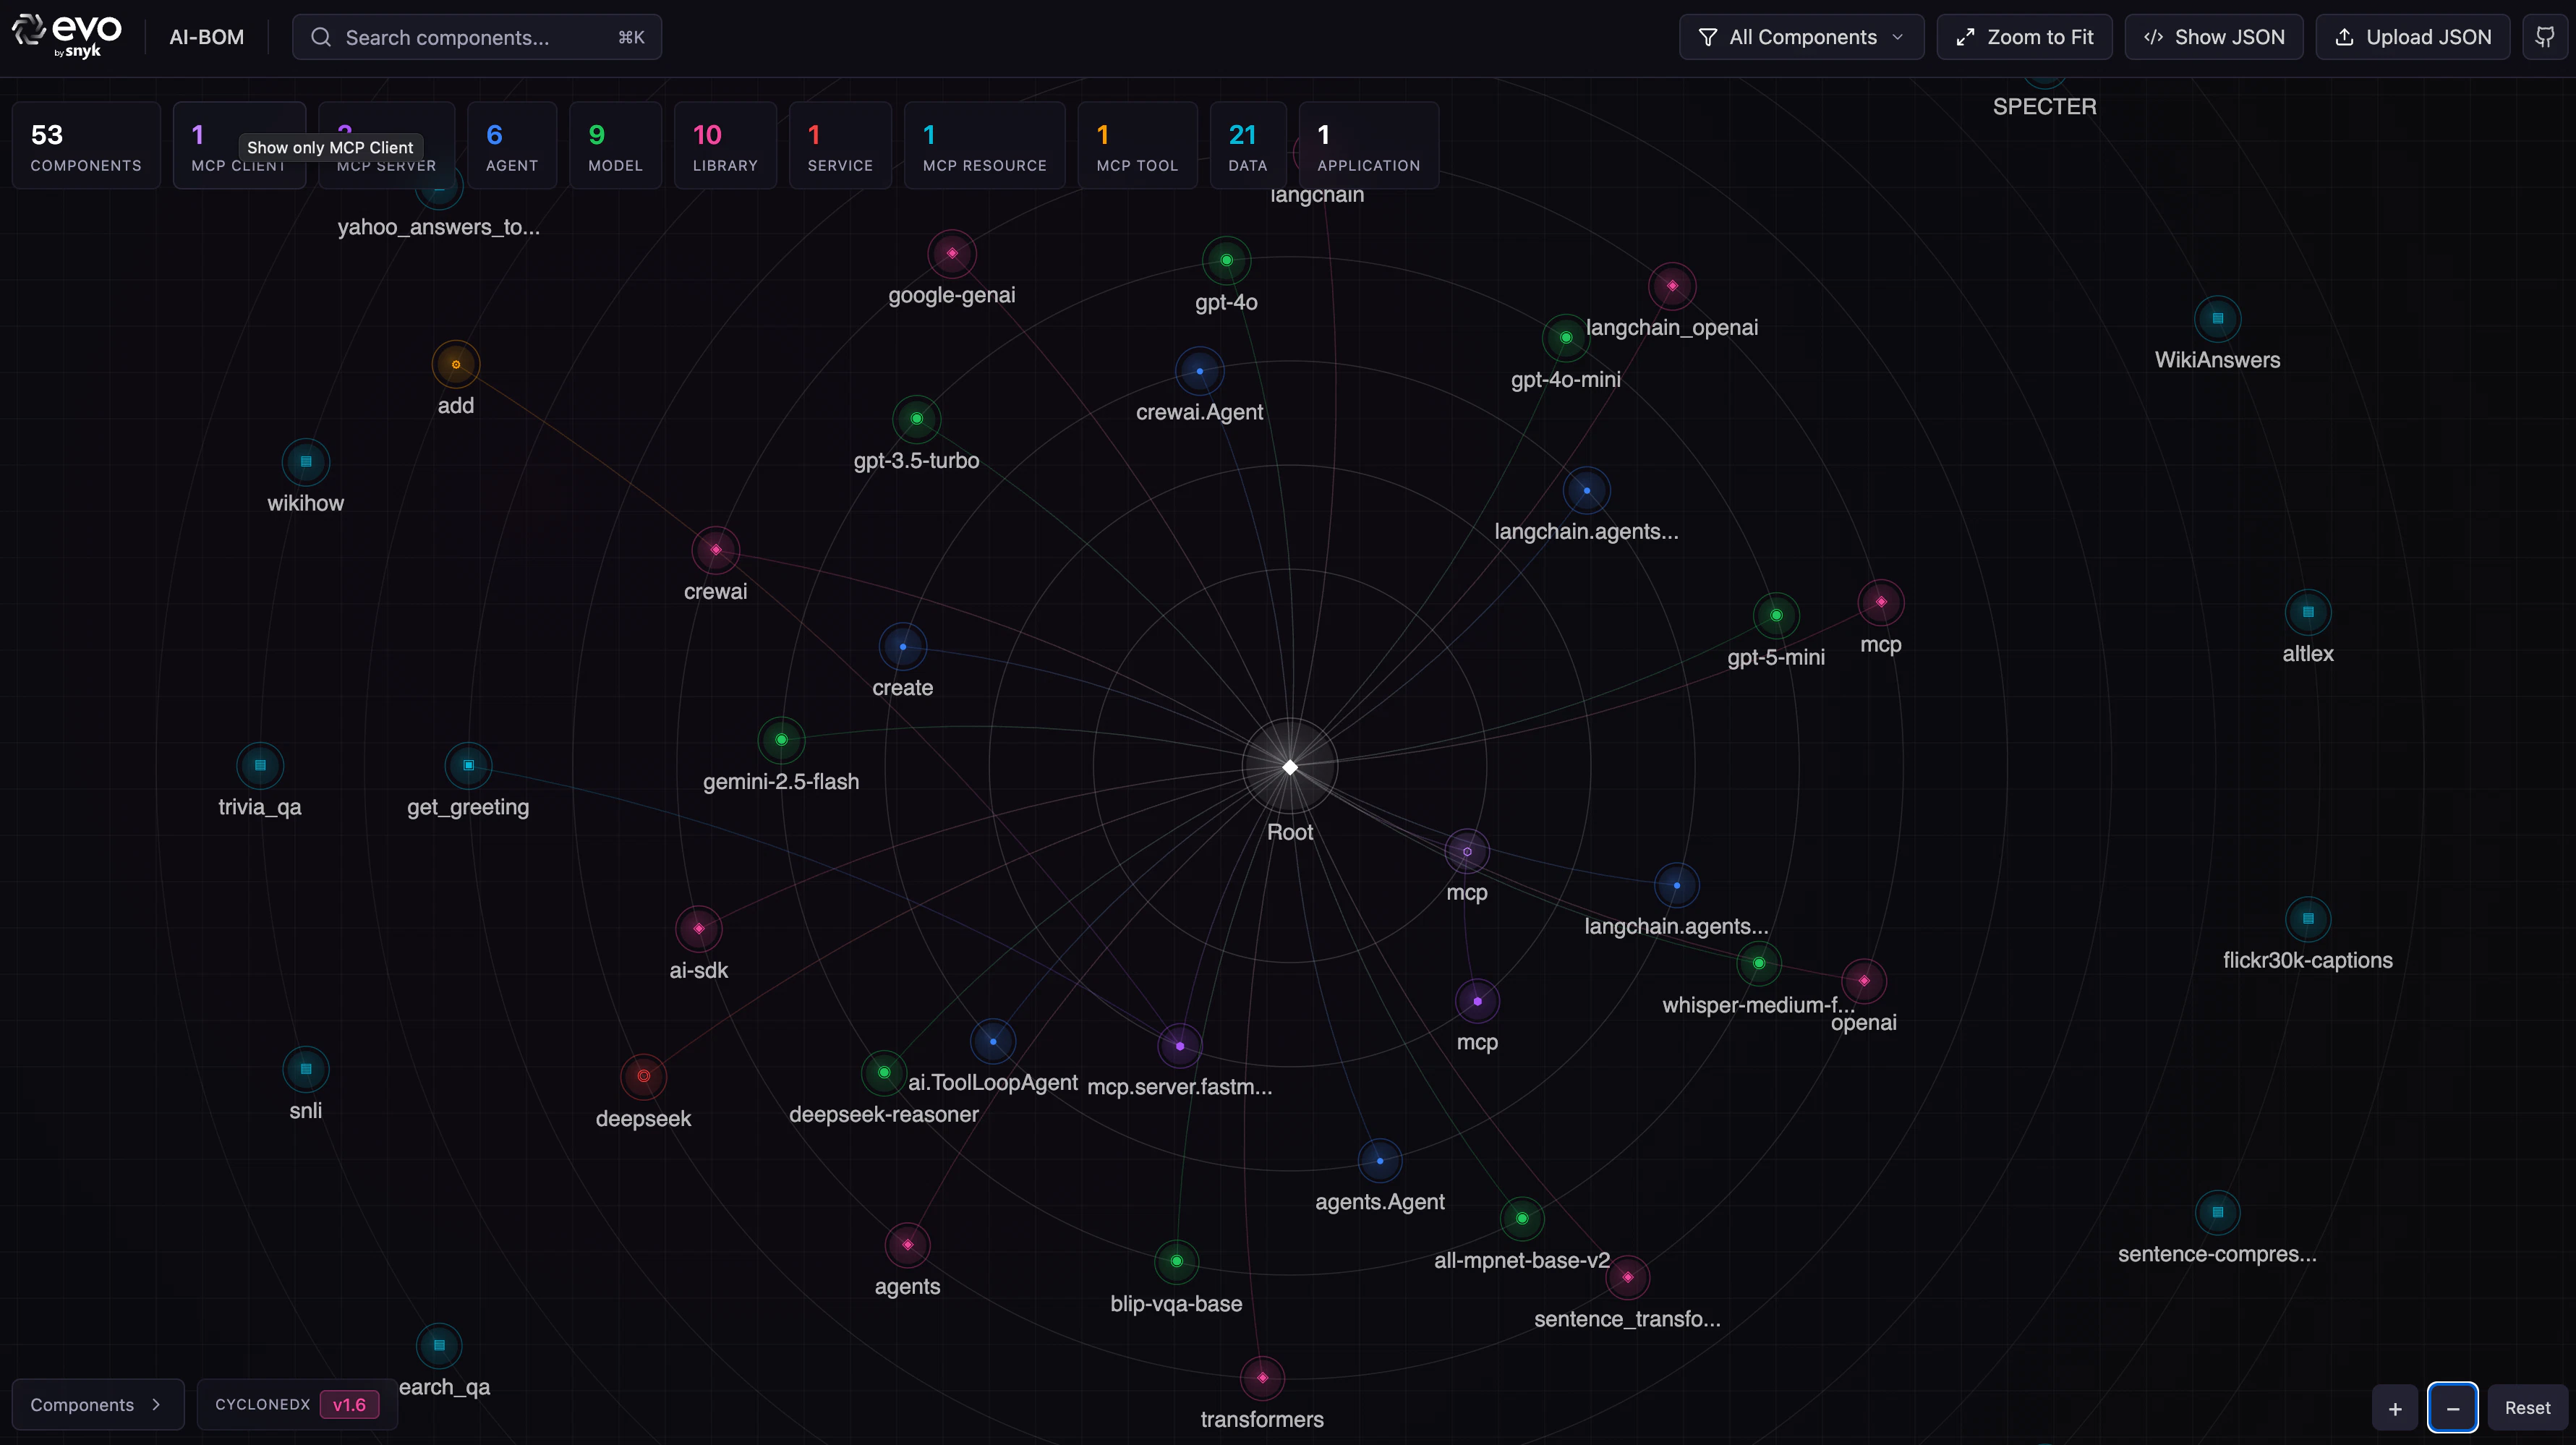
ここで1つ気づいたことがあります。1章の主役だった all-mpnet-base-v2 を選択しても、光るエッジは Root との1本だけです。21件のデータセットには線が伸びません。
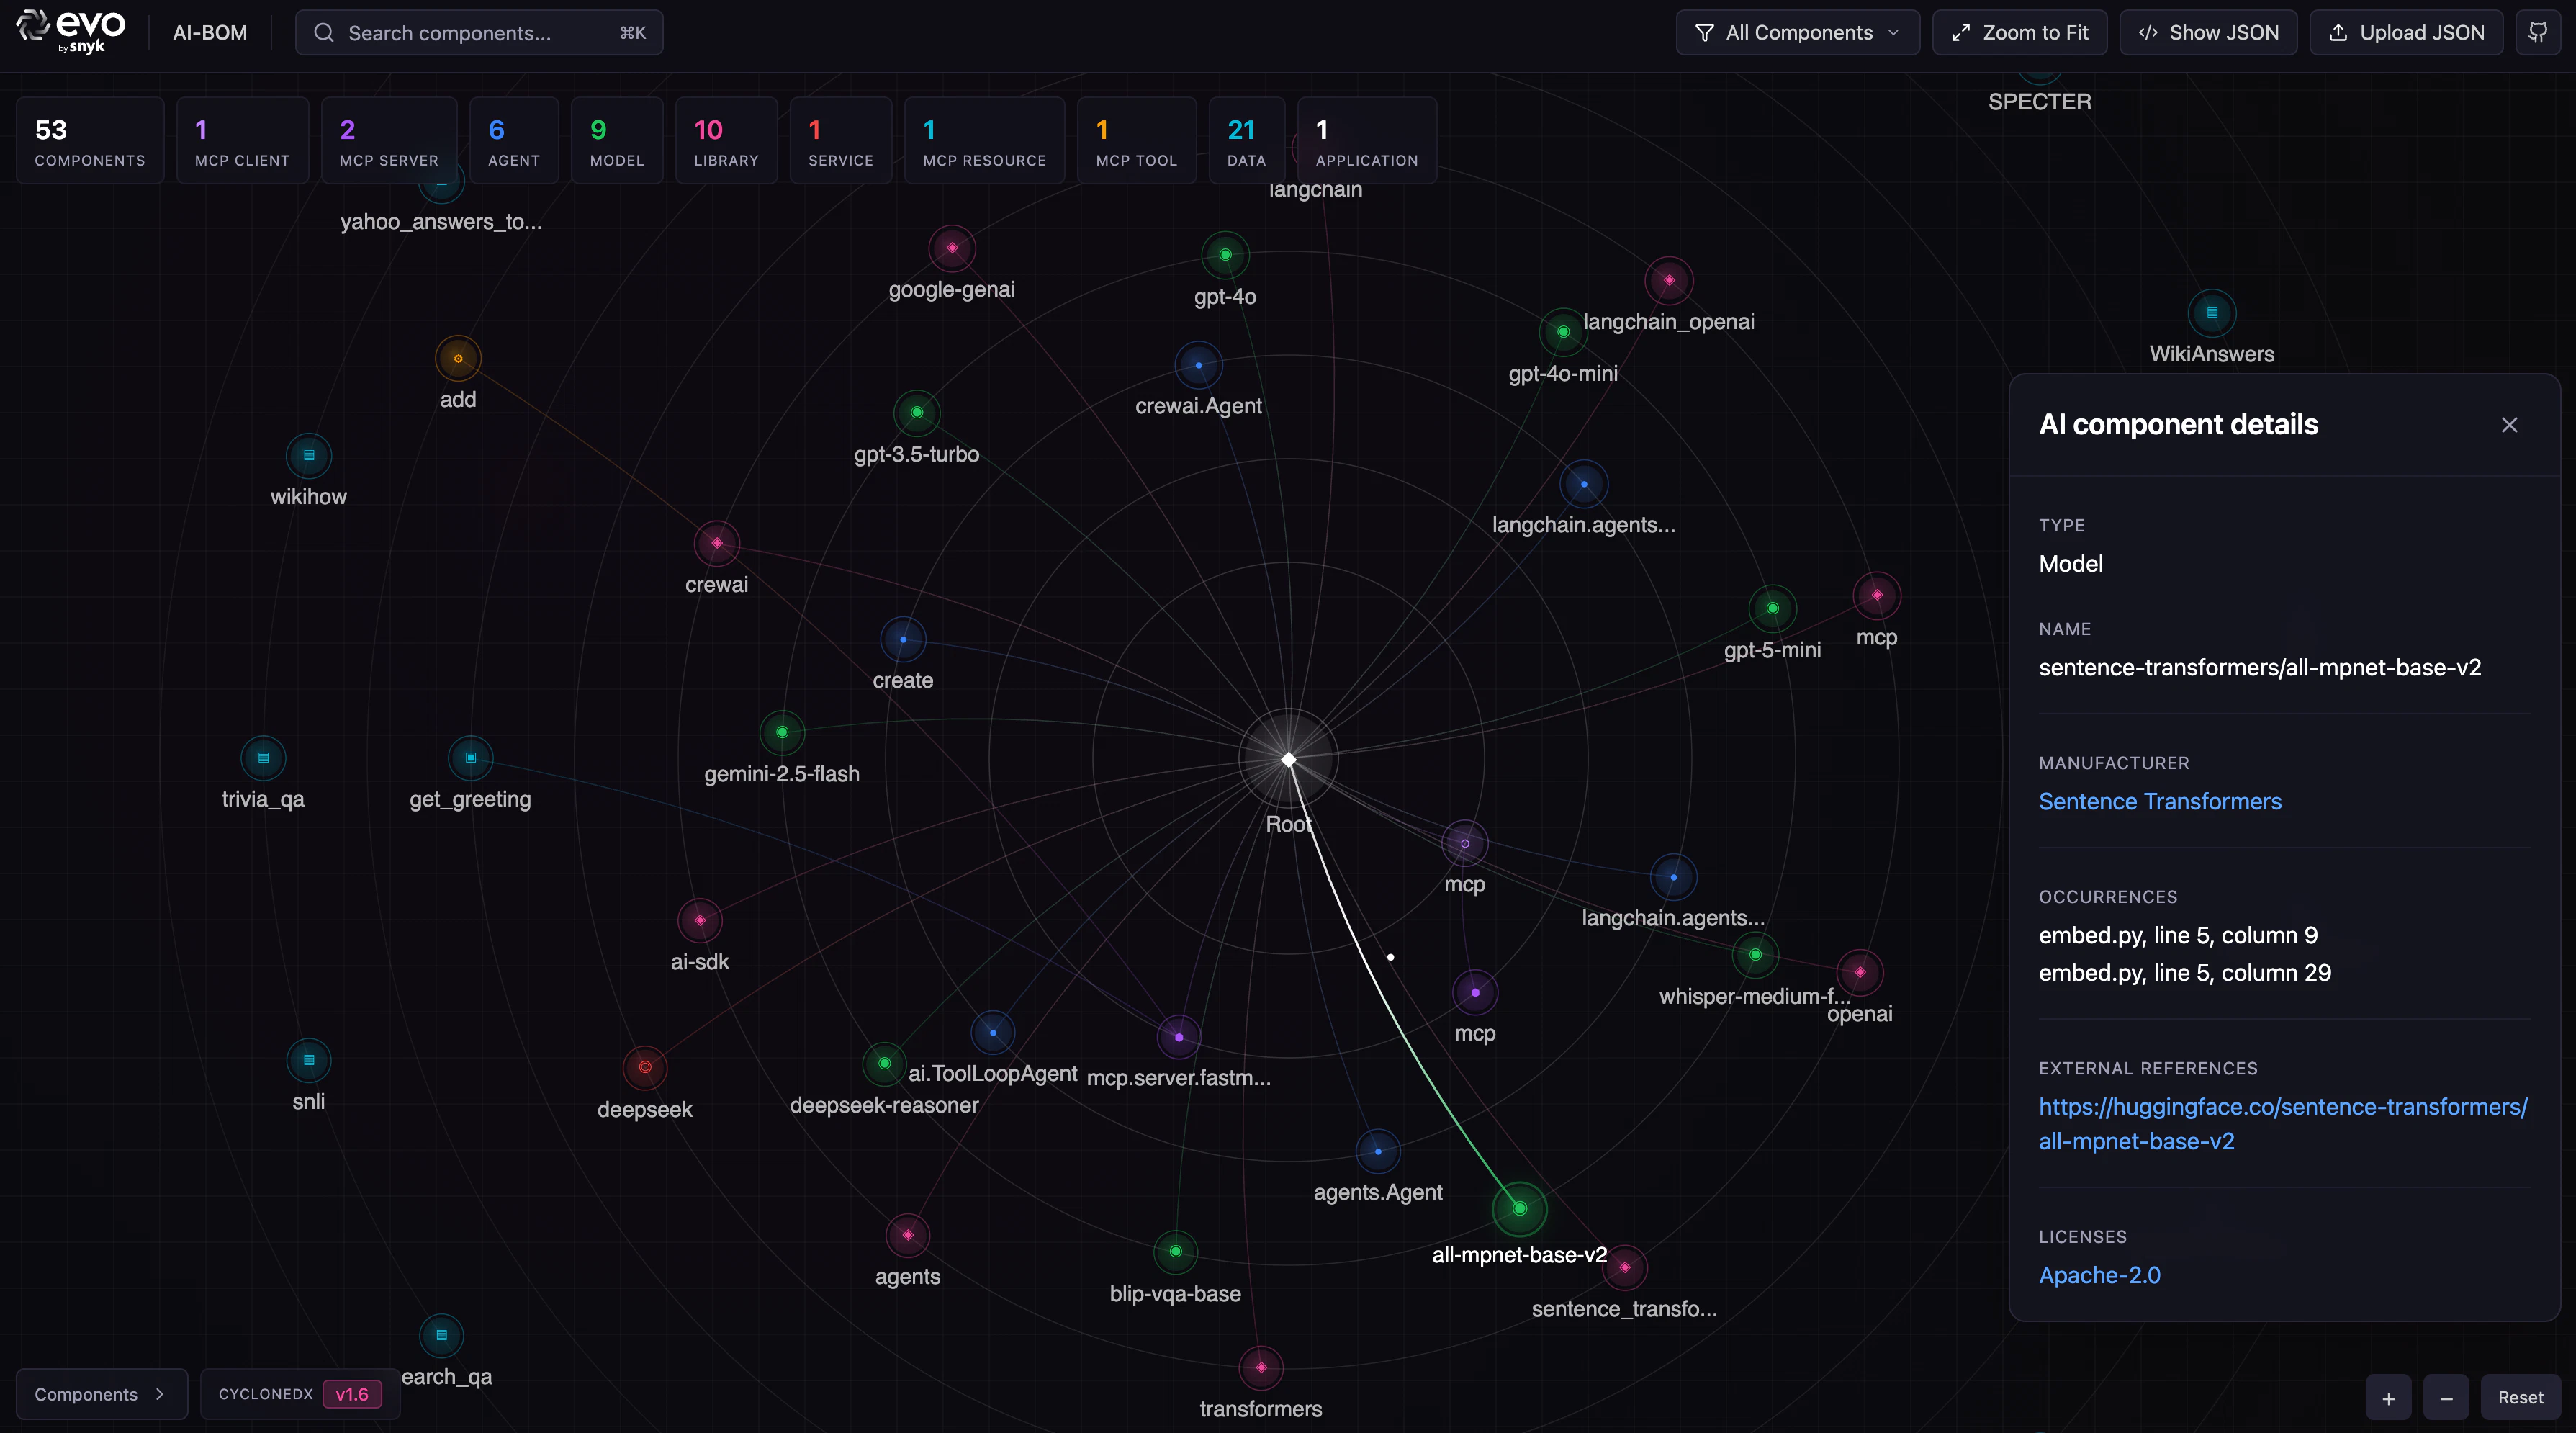
JSON を見ると理由が分かります。CycloneDX の dependencies に入っているのは Root と各コンポーネントの関係だけで、データセットは modelCard の中に ref として書かれているだけです。グラフ上では孤立ノードになります。
つまり「21件がモデルカード由来」という1章の話は、絵を見ていても気づけません。
3. 使われていないモデルが1行だけ残っている
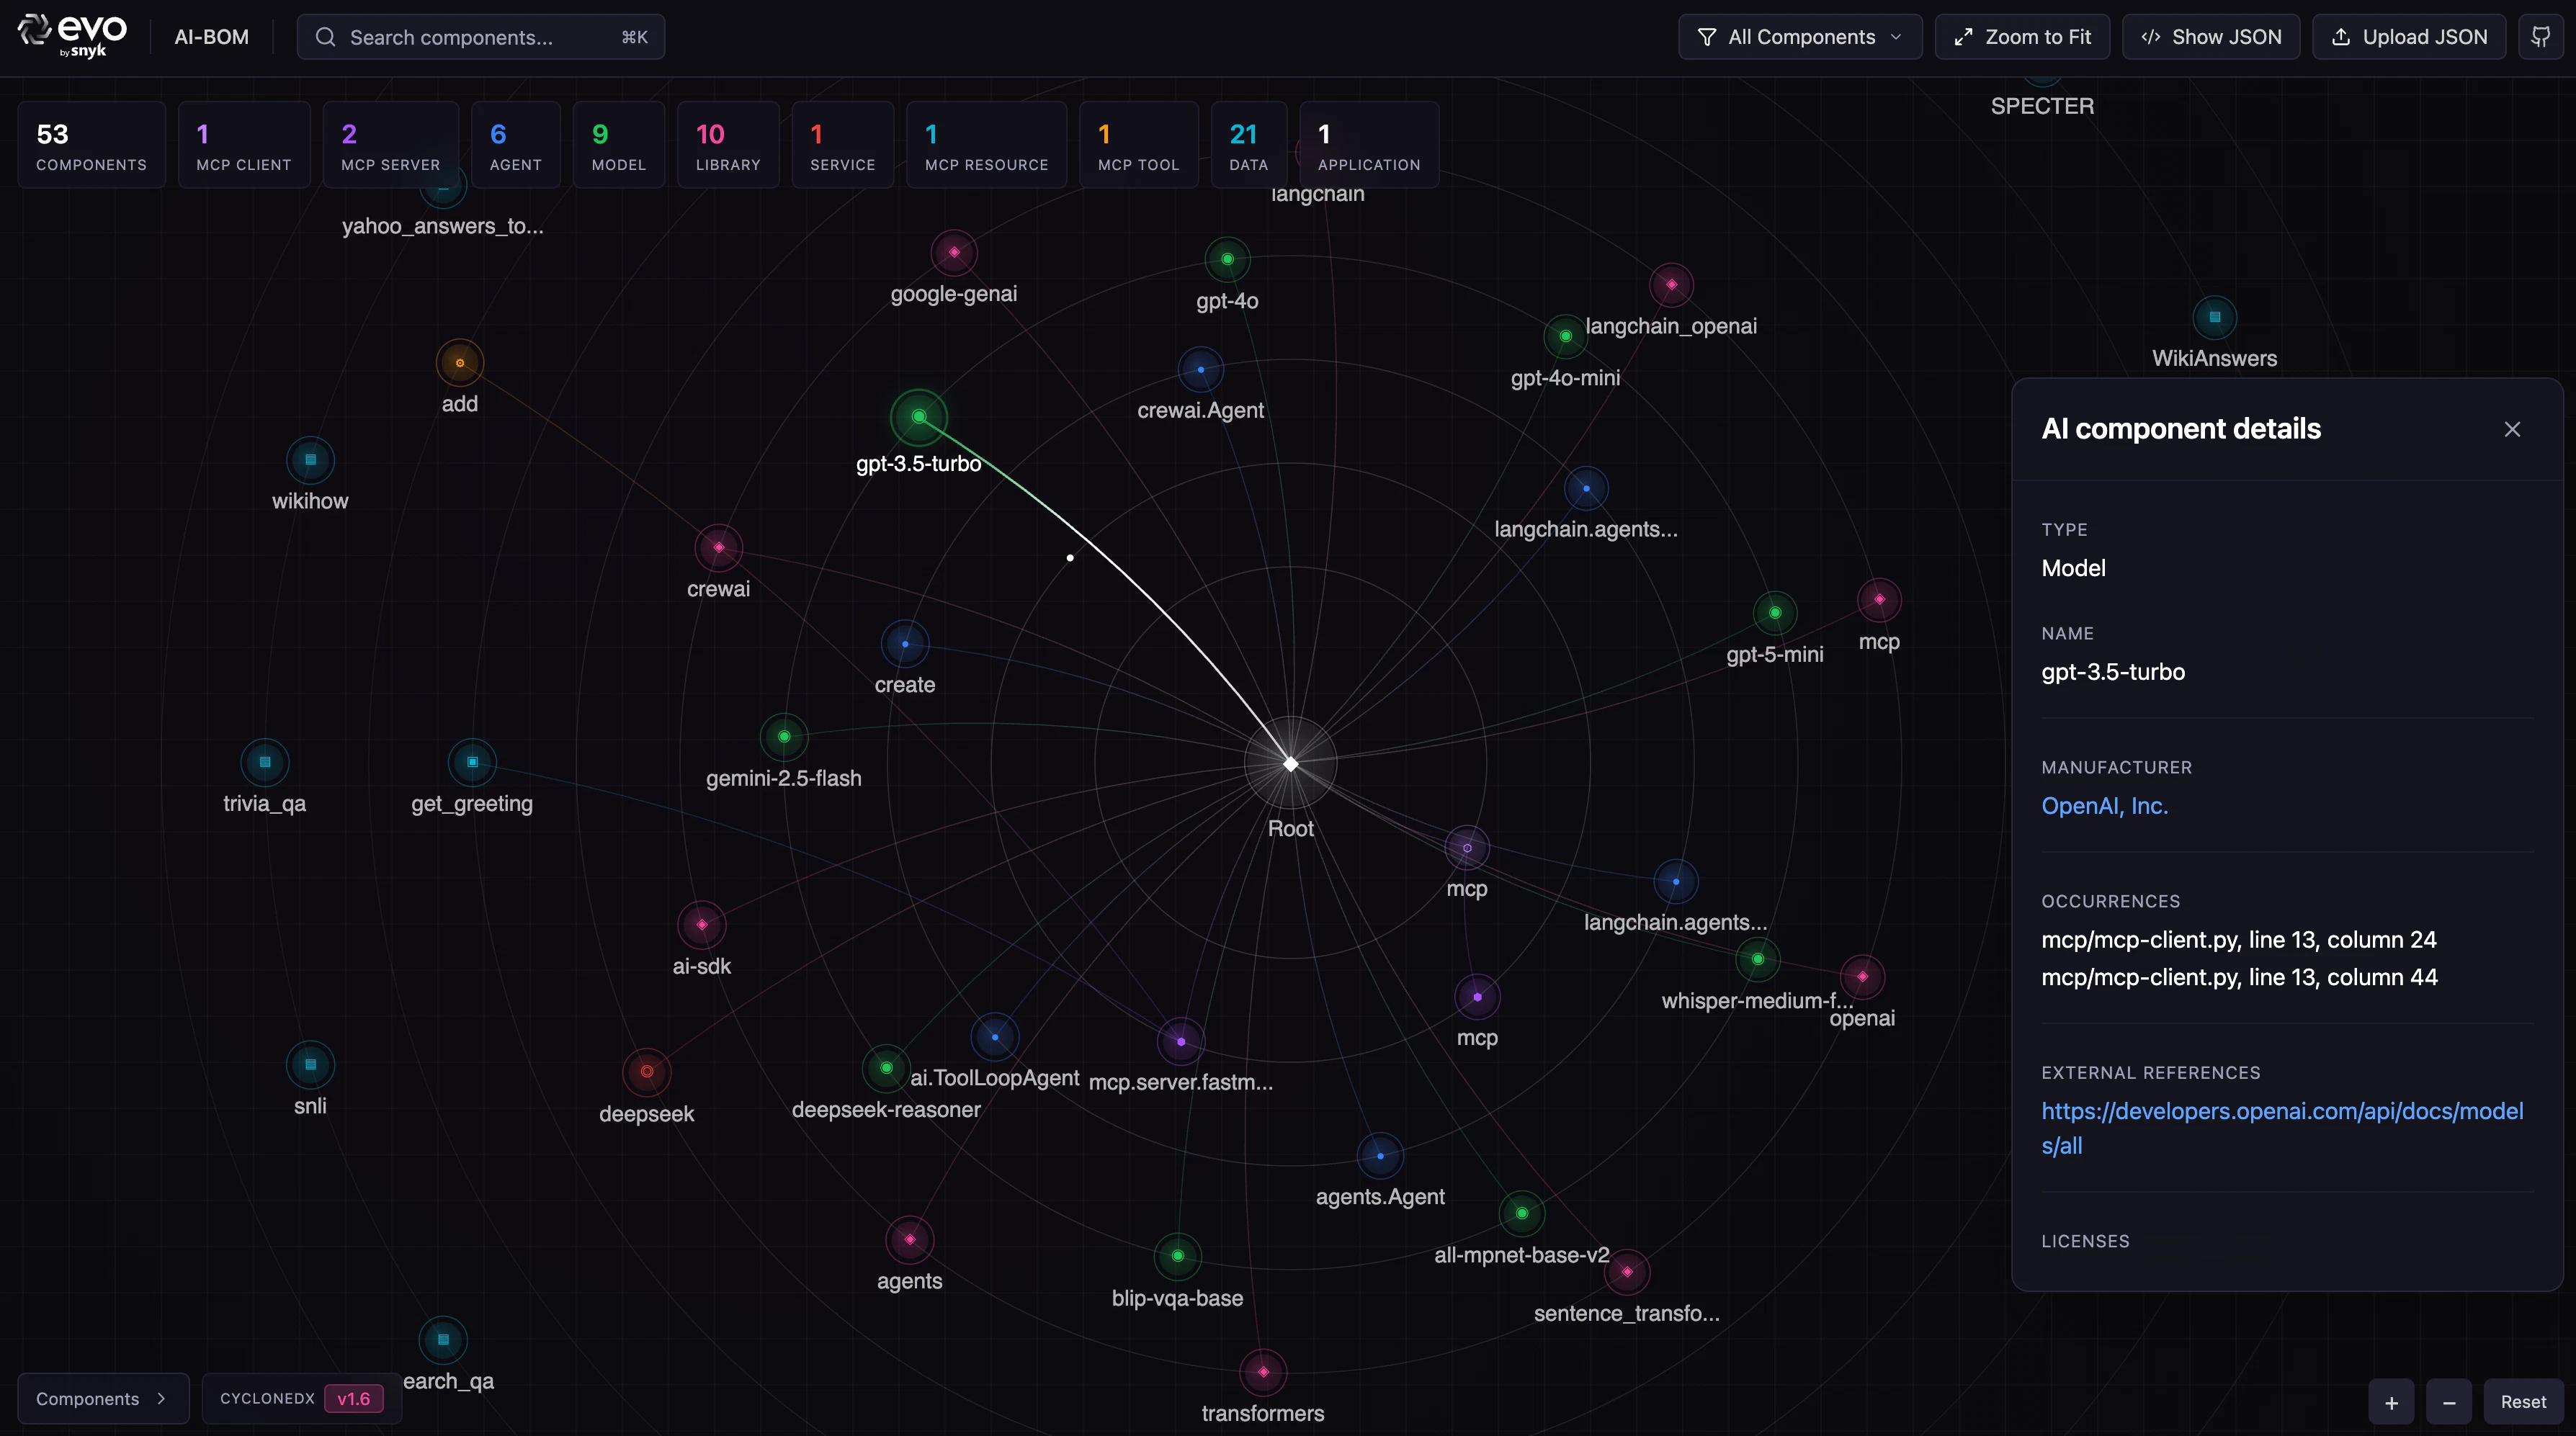
グラフを眺めていて目に留まったのが gpt-3.5-turbo です。
出現箇所は mcp/mcp-client.py の13行目、1行の中に2箇所だけです。他のモデルは複数のファイルにまたがって使われているのに、これだけが1行に取り残されています。モデルのタイムスタンプは 2023-02-28 でした。
ビューアの詳細パネルが見せてくれるのは、この9項目です。
- Publisher / Manufacturer / Provider / Authors
- Endpoints
- Properties
- Occurrences(ファイル名と行番号)
- External references
- Licenses
Occurrences があるので「どこで使われているか」がすぐ分かります。ただしライセンス欄は空でした。JSON には proprietary としか書かれておらず、SPDX の ID がありません(all-mpnet-base-v2 では Apache-2.0 が出ます)。
棚卸しとしては、ここまでで十分に見えました。
4. ビューアが表示していないもの
念のため JSON を直接見たら、ビューアに出ていない情報が入っていました。
{"type":"snyk:risk_score:sensitive_data:pii_extraction","value":"806"}
modelCard.quantitativeAnalysis.performanceMetrics の下に、リスクスコアがカテゴリ別に大量に入っています。gpt-3.5-turbo の PII 抽出スコアは 806 です。
このスコアは 0〜1,000 で、750 以上が critical です。スコアが付いていたのは商用モデル5件だけ(OSS モデルには1件も付きませんでした)で、その中で critical 帯に入るのはこの1件だけでした。
そして、標準の --html もリランの aibom も、この数字を表示しません。実装の中身を確認しましたが、どちらも quantitativeAnalysis を参照していませんでした。作りの違う2つのビューアが、揃って同じデータを落としています。
数字を見るには、AI-BOM を Evo にアップロードします。
snyk aibom --upload --repo https://github.com/snyk-labs/ai-bom-goof
(以下のスクリーンショットは、手元の fork で実行したものです)
Web UI の Risk profile に 806 がそのまま出ます。加えて、この攻撃目標が MITRE ATLAS(AML.T0051.000 / AML.T0057)、OWASP LLM Top 10(LLM02)、NIST AI 600-1(AI600-1:2.4) のどこに対応するかまで並びます。
Issues タブでは「Critical PII extraction」という名前のポリシー違反になっていました。806 という数字が、そのまま判断に変換されています。
こうして AI アセットを棚卸しし、リスクを評価して統制する領域は AI-SPM(AI Security Posture Management) と呼ばれます。

まとめ
-
snyk aibomはモデル1つから21件のデータセットを引っ張り出します。AI-BOM は SBOM より深く潜ります - ビューアで見えるのは「何が、どこにあるか」までです
- 「それが危ないかどうか」は JSON か Evo を見ないと分かりません
ai-bom-goof はデモですが、コマンド自体は自分のリポジトリでそのまま動きます。Python / Java / JavaScript / Go に対応しています。何が出てくるか、試してみてください。