
目次
はじめに
今回はCockroachDBを使ってみます。
複数台で一つのDBとして動いて、1台止まっても使えるらしい。
手元のOCIのVMで試してみることにしました。
個人的に名前が好き。
何億年経っても稼働してそう。
東京に2台、大阪に1台あるので、今回はこの3台を使います。
まずは1台でSQLを使えるところまで作って、その後で残りの2台を追加。
そこからDBを止めたり、同じデータを同時に更新したりしてみました。
CockroachDBについて
CockroachDBは、複数のノードで一つのクラスタを作る分散リレーショナルデータベースです。
今回は3ノード・3複製、商品3件だけのミニマム構成。
データの更新内容をノード間で共有し、それぞれが自分のディスクに反映します。
ただ、ファイルを丸ごと同期しているわけではないらしい。
マネージドのCockroachDB Cloudもありますが、今回はVM上で自分で動かします。
ノードを増やしたり止めたりしたいので。
参考にしたのはこちら。
今回の環境と、最初の1台
環境
OCIのAmpere A1のVMを使います。OSはOracle Linux 9.8。
1台に1ノードずつ置きました。
| サーバー | リージョン | node ID | 接続名 | VMの資源 |
|---|---|---|---|---|
| 東京2 | ap-tokyo-1 | 1 | crdb-tokyo2 | ARM64、2 CPU、約10GiB RAM |
| 東京1 | ap-tokyo-1 | 2 | crdb-tokyo1 | ARM64、2 CPU、約10GiB RAM |
| 大阪 | ap-osaka-1 | 3 | crdb-osaka | ARM64、2 CPU、約10GiB RAM |
東京2から作り始めたので、node IDも東京2が1です。
名前と番号がちょっとややこしいですが、この対応で進めます。
今回は3台で3コピー。このうち1台を止めても、残りの2台にデータがあるので、そこで読み書きを続けられるか試します。
東京同士はVCNのプライベートIP、大阪との通信はTailscaleです。
crdb-*の名前は各VMの/etc/hostsに設定しました。
SQLとノード間通信は26257/TCP、TLSを使用。
DB Consoleは127.0.0.1:8080で待ち受けさせて、SSHトンネル経由で開いています。
検証日は2026年10月16〜17日、バージョンはv26.2.7です。
公式の導入手順からARM64版を取得し、SHA256も照合しました。
CockroachDB CCL v26.2.7 (aarch64-unknown-linux-gnu, built 2026/09/21 19:51:32, go1.25.13)
他の処理も同居しているVMなので、DB側は小さめにしています。
| 項目 | 設定 |
|---|---|
| systemdのCPUQuota | 100%(1 CPU分のCPU時間) |
| systemdのMemoryMax | 2GiB |
| ブロックキャッシュ | 256MiB |
| SQLメモリ | 256MiB |
| 時系列メトリクス用メモリ | 64MiB |
| ディスク上のSQL一時領域 | 256MiB |
ライセンスはキー未設定の7日間の猶予期間中です。
スクショに出ている「10月23日までにキーが必要」という警告はこれです。
継続して使う場合の条件はLicensing FAQsを確認。
東京2で起動
まずは東京2から。
/data/cockroachdb-labにバイナリとデータの保存先を用意。
証明書はcockroach certで、CA・ノード用・rootクライアント用を作成。
systemdに登録した起動設定の主な部分はこんな感じです。
ExecStart=/data/cockroachdb-lab/bin/cockroach start \
  --certs-dir=/data/cockroachdb-lab/certs \
  --store=path=/data/cockroachdb-lab/data,size=5GiB,ballast-size=64MiB \
  --listen-addr=10.0.1.11:26257 \
  --advertise-addr=crdb-tokyo2:26257 \
  --http-addr=127.0.0.1:8080 \
  --join=crdb-tokyo2:26257 \
  --locality=region=ap-tokyo-1 \
  --cache=256MiB \
  --max-sql-memory=256MiB \
  --max-tsdb-memory=64MiB \
  --max-disk-temp-storage=256MiB
後でノードを追加するので、通常のcockroach startを使いました。
サービスを起動したら、クラスタを初期化します。
/data/cockroachdb-lab/bin/cockroach init \
  --host=crdb-tokyo2:26257 \
  --certs-dir=/data/cockroachdb-lab/client
Consoleも開いてみます。
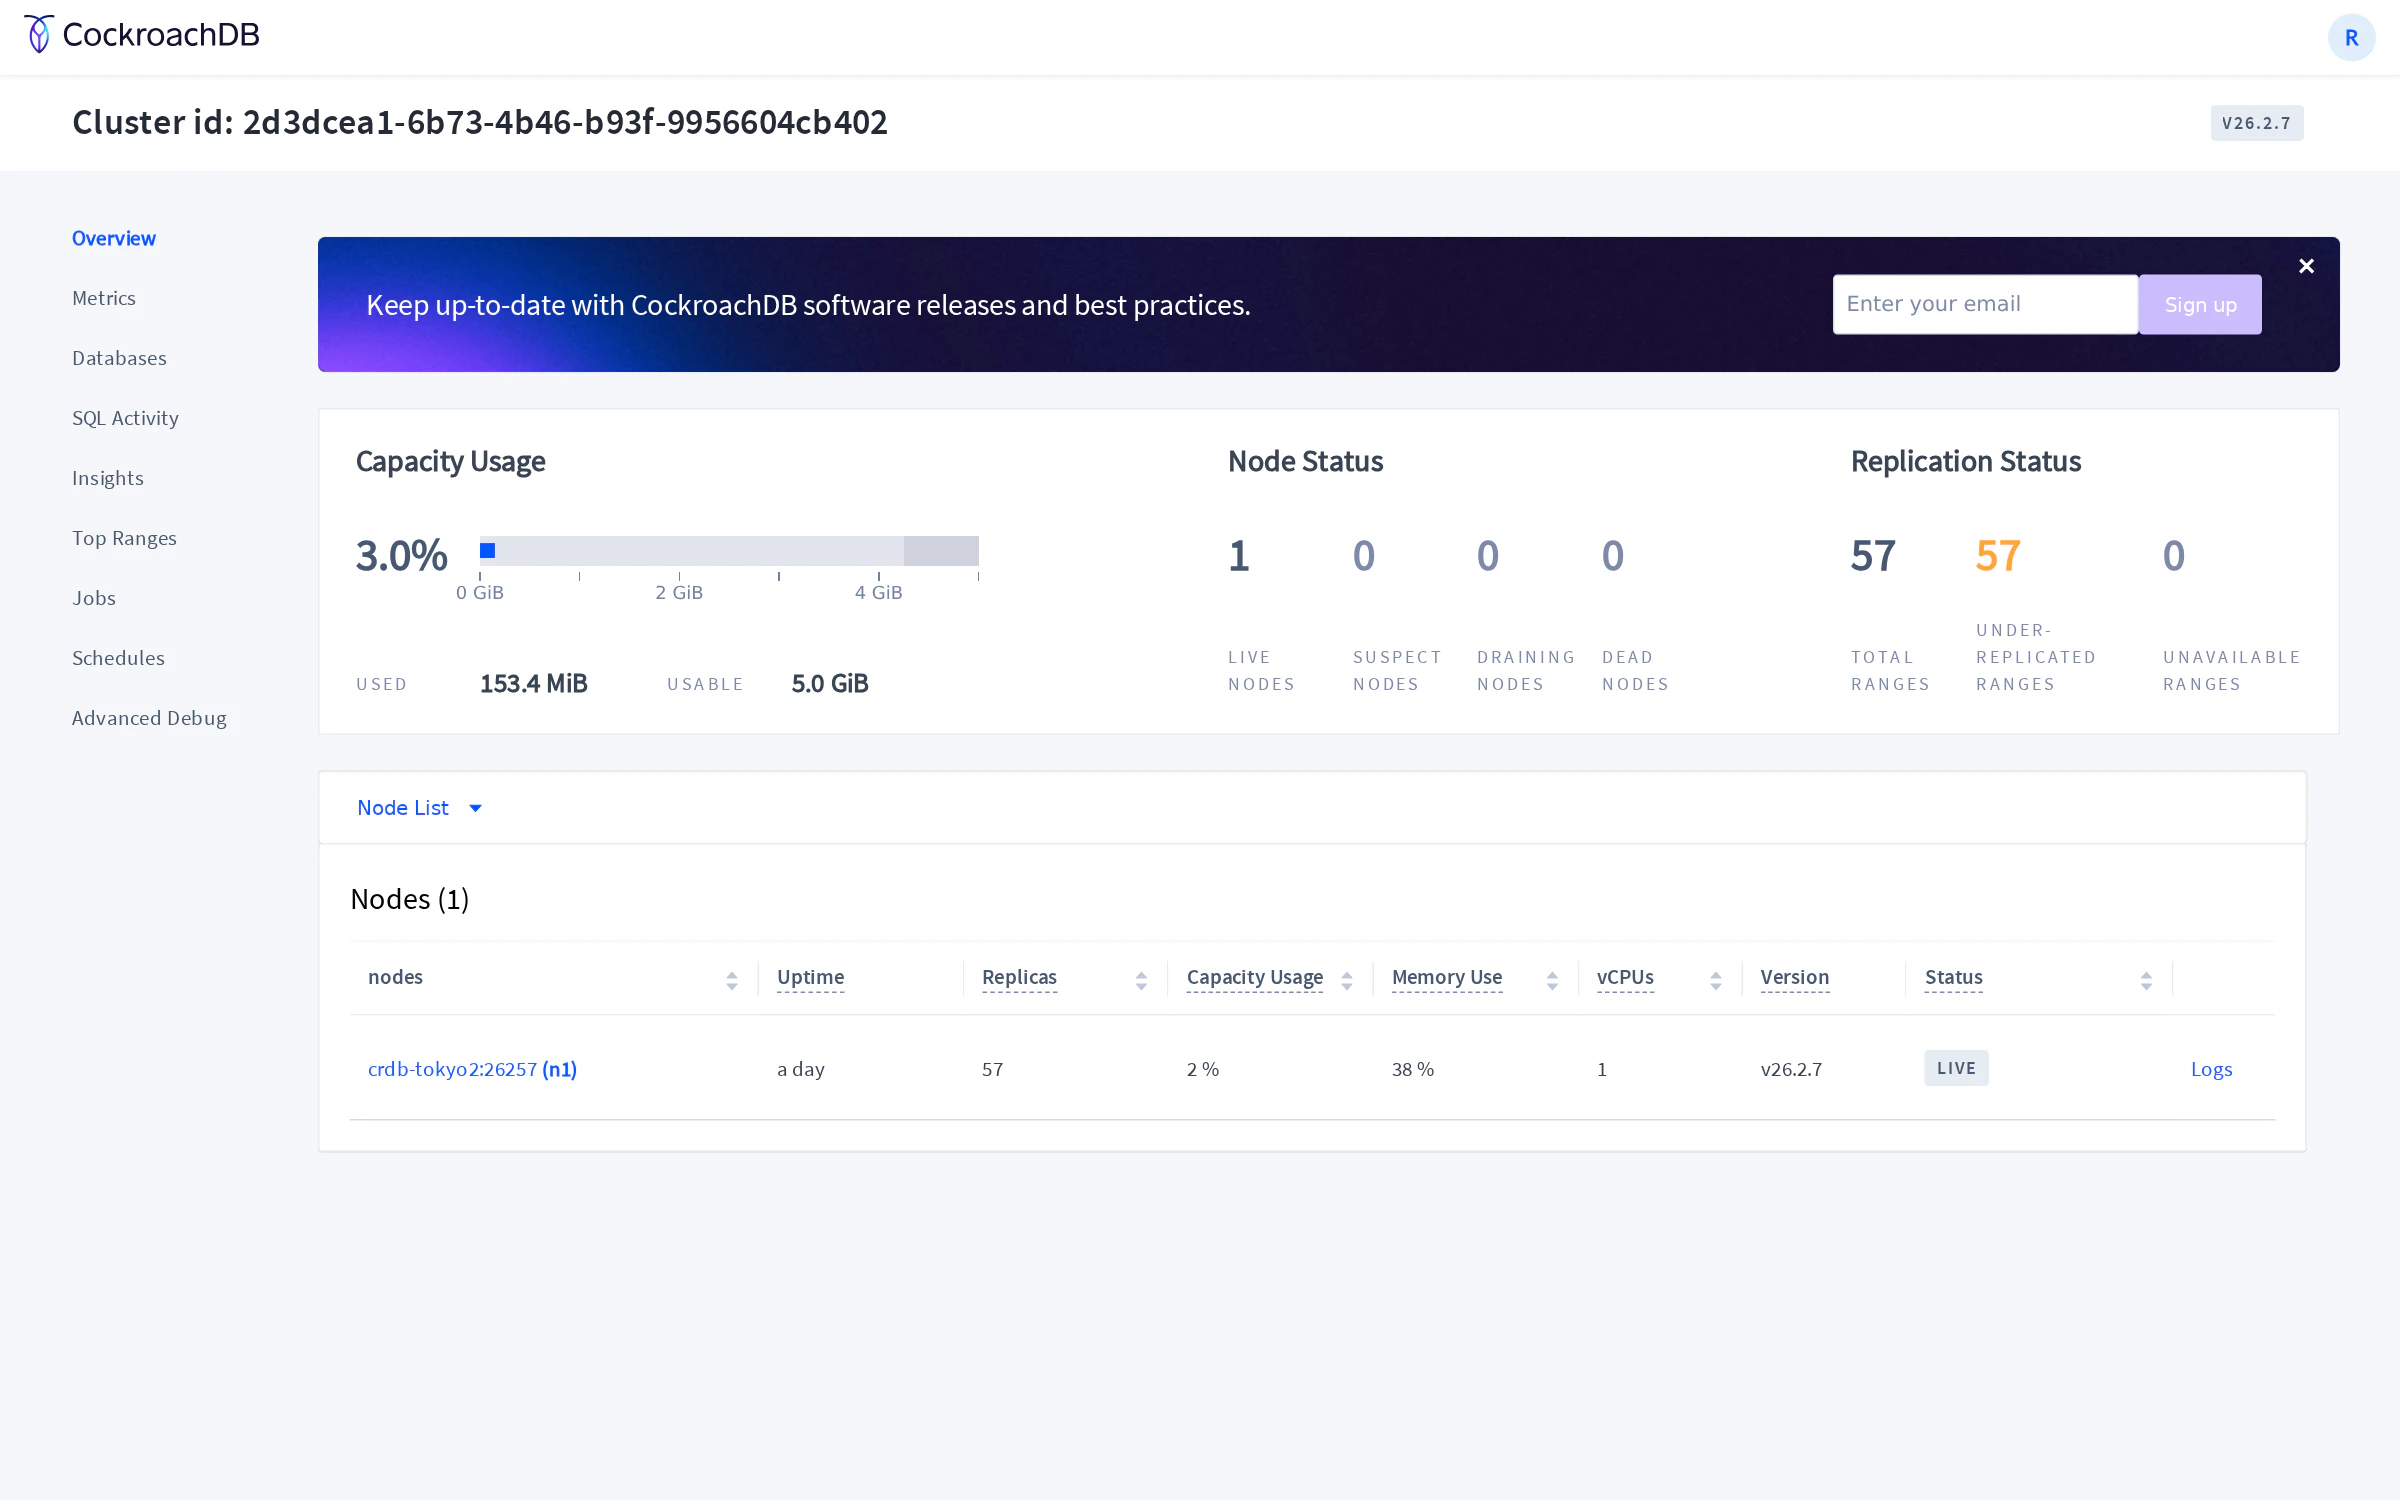
動いた。
ただ、複製不足が出ています。
通常の複製数が3なのに、まだ1台しかいないためでした。
これは残りの2台を追加した後で、もう一度見てみます。
SQLを使ってみる
まずはテーブルを作ります。
付属のSQLクライアントで東京2へ接続。
clientはrootクライアント証明書を置いたディレクトリです。
/data/cockroachdb-lab/bin/cockroach sql \
  --host=crdb-tokyo2:26257 \
  --certs-dir=/data/cockroachdb-lab/client
商品と在庫のテーブルにしました。CoffeeとTeaを入れてみます。
CREATE DATABASE qiita_lab;
USE qiita_lab;

CREATE TABLE products (
  id INT PRIMARY KEY,
  name STRING NOT NULL,
  stock INT NOT NULL CHECK (stock >= 0)
);

INSERT INTO products (id, name, stock)
VALUES (1, 'Coffee', 10), (2, 'Tea', 20);

SELECT * FROM products ORDER BY id;
返ってきた結果がこちら。出力の空白は整えています。
id  name    stock
1   Coffee  10
2   Tea     20
普通に入っていますね。
Coffeeの在庫を1個減らしてCOMMITします。
BEGIN;
UPDATE products SET stock = stock - 1 WHERE id = 1;
COMMIT;

SELECT * FROM products ORDER BY id;
id  name    stock
1   Coffee  9
2   Tea     20
10から9になりました。
次はTeaを更新して、ROLLBACKしてみます。
BEGIN;
UPDATE products SET stock = 999 WHERE id = 2;
ROLLBACK;

SELECT * FROM products ORDER BY id;
こちらは20のまま。
DBサービスを再起動した後も、Coffee=9、Tea=20が残っていました。
ひとまずSQLで読み書きするところまでは出来ました。
このテーブルを残して、ノードを増やしていきます。
3台に増やしてみる
東京1と大阪を追加
残りの2台にも同じバージョンを入れ、ノードごとの証明書を作成しました。
CA秘密鍵とrootクライアント秘密鍵は東京2に残しています。
待ち受けはVCNとTailscaleの両方から接続できる0.0.0.0:26257に変更。
firewalldで、接続元を対向ノードに絞りました。
東京1の設定はこうです。
--listen-addr=0.0.0.0:26257
--advertise-addr=crdb-tokyo1:26257
--join=crdb-tokyo2:26257,crdb-tokyo1:26257,crdb-osaka:26257
--locality=region=ap-tokyo-1
大阪はcrdb-osaka:26257、localityはregion=ap-osaka-1にしました。
追加先ではcockroach startだけです。cockroach initは最初の1回だけ。
東京1、大阪の順に起動すると、Consoleにも3台出てきました。

3 LIVE。
最初に出ていた複製不足も0になりました。
接続先を変える
さっき作ったテーブルを、別のノードから使ってみます。
SQLクライアントは東京2上で動かし、接続先だけを変更しました。
まず東京1へ接続して、Cocoaを追加。
INSERT INTO qiita_lab.public.products (id, name, stock)
VALUES (3, 'Cocoa', 30)
RETURNING *;
次は大阪へ接続して、Cocoaの在庫を2個減らします。
UPDATE qiita_lab.public.products
SET stock = stock - 2
WHERE id = 3
RETURNING *;
それぞれコミットした後、東京2へ接続して読みます。
SELECT id, name, stock
FROM qiita_lab.public.products
ORDER BY id;
id  name    stock
1   Coffee  9
2   Tea     20
3   Cocoa   28
Cocoaもいるし、在庫も28になっています。
東京1と大阪でもSELECTしてみましたが、同じ結果でした。

実際のCLI出力を整形した画像。
最初の1台で作ったテーブルを、そのまま3台から使えました。
ノード追加に合わせてテーブルを作り直す、といった作業はしていません。
同じ商品データを3台が持っていた
どこにつないでも同じ結果が返ります。
ただ、それだけではデータの置き場所までは分からないので、SHOW RANGESも実行してみました。
SHOW RANGES FROM TABLE qiita_lab.public.products WITH DETAILS;
関連する列を抜き出すと、こうなっていました。
range_id  lease_holder  replicas  voting_replicas
83        3             {1,2,3}   {1,3,2}
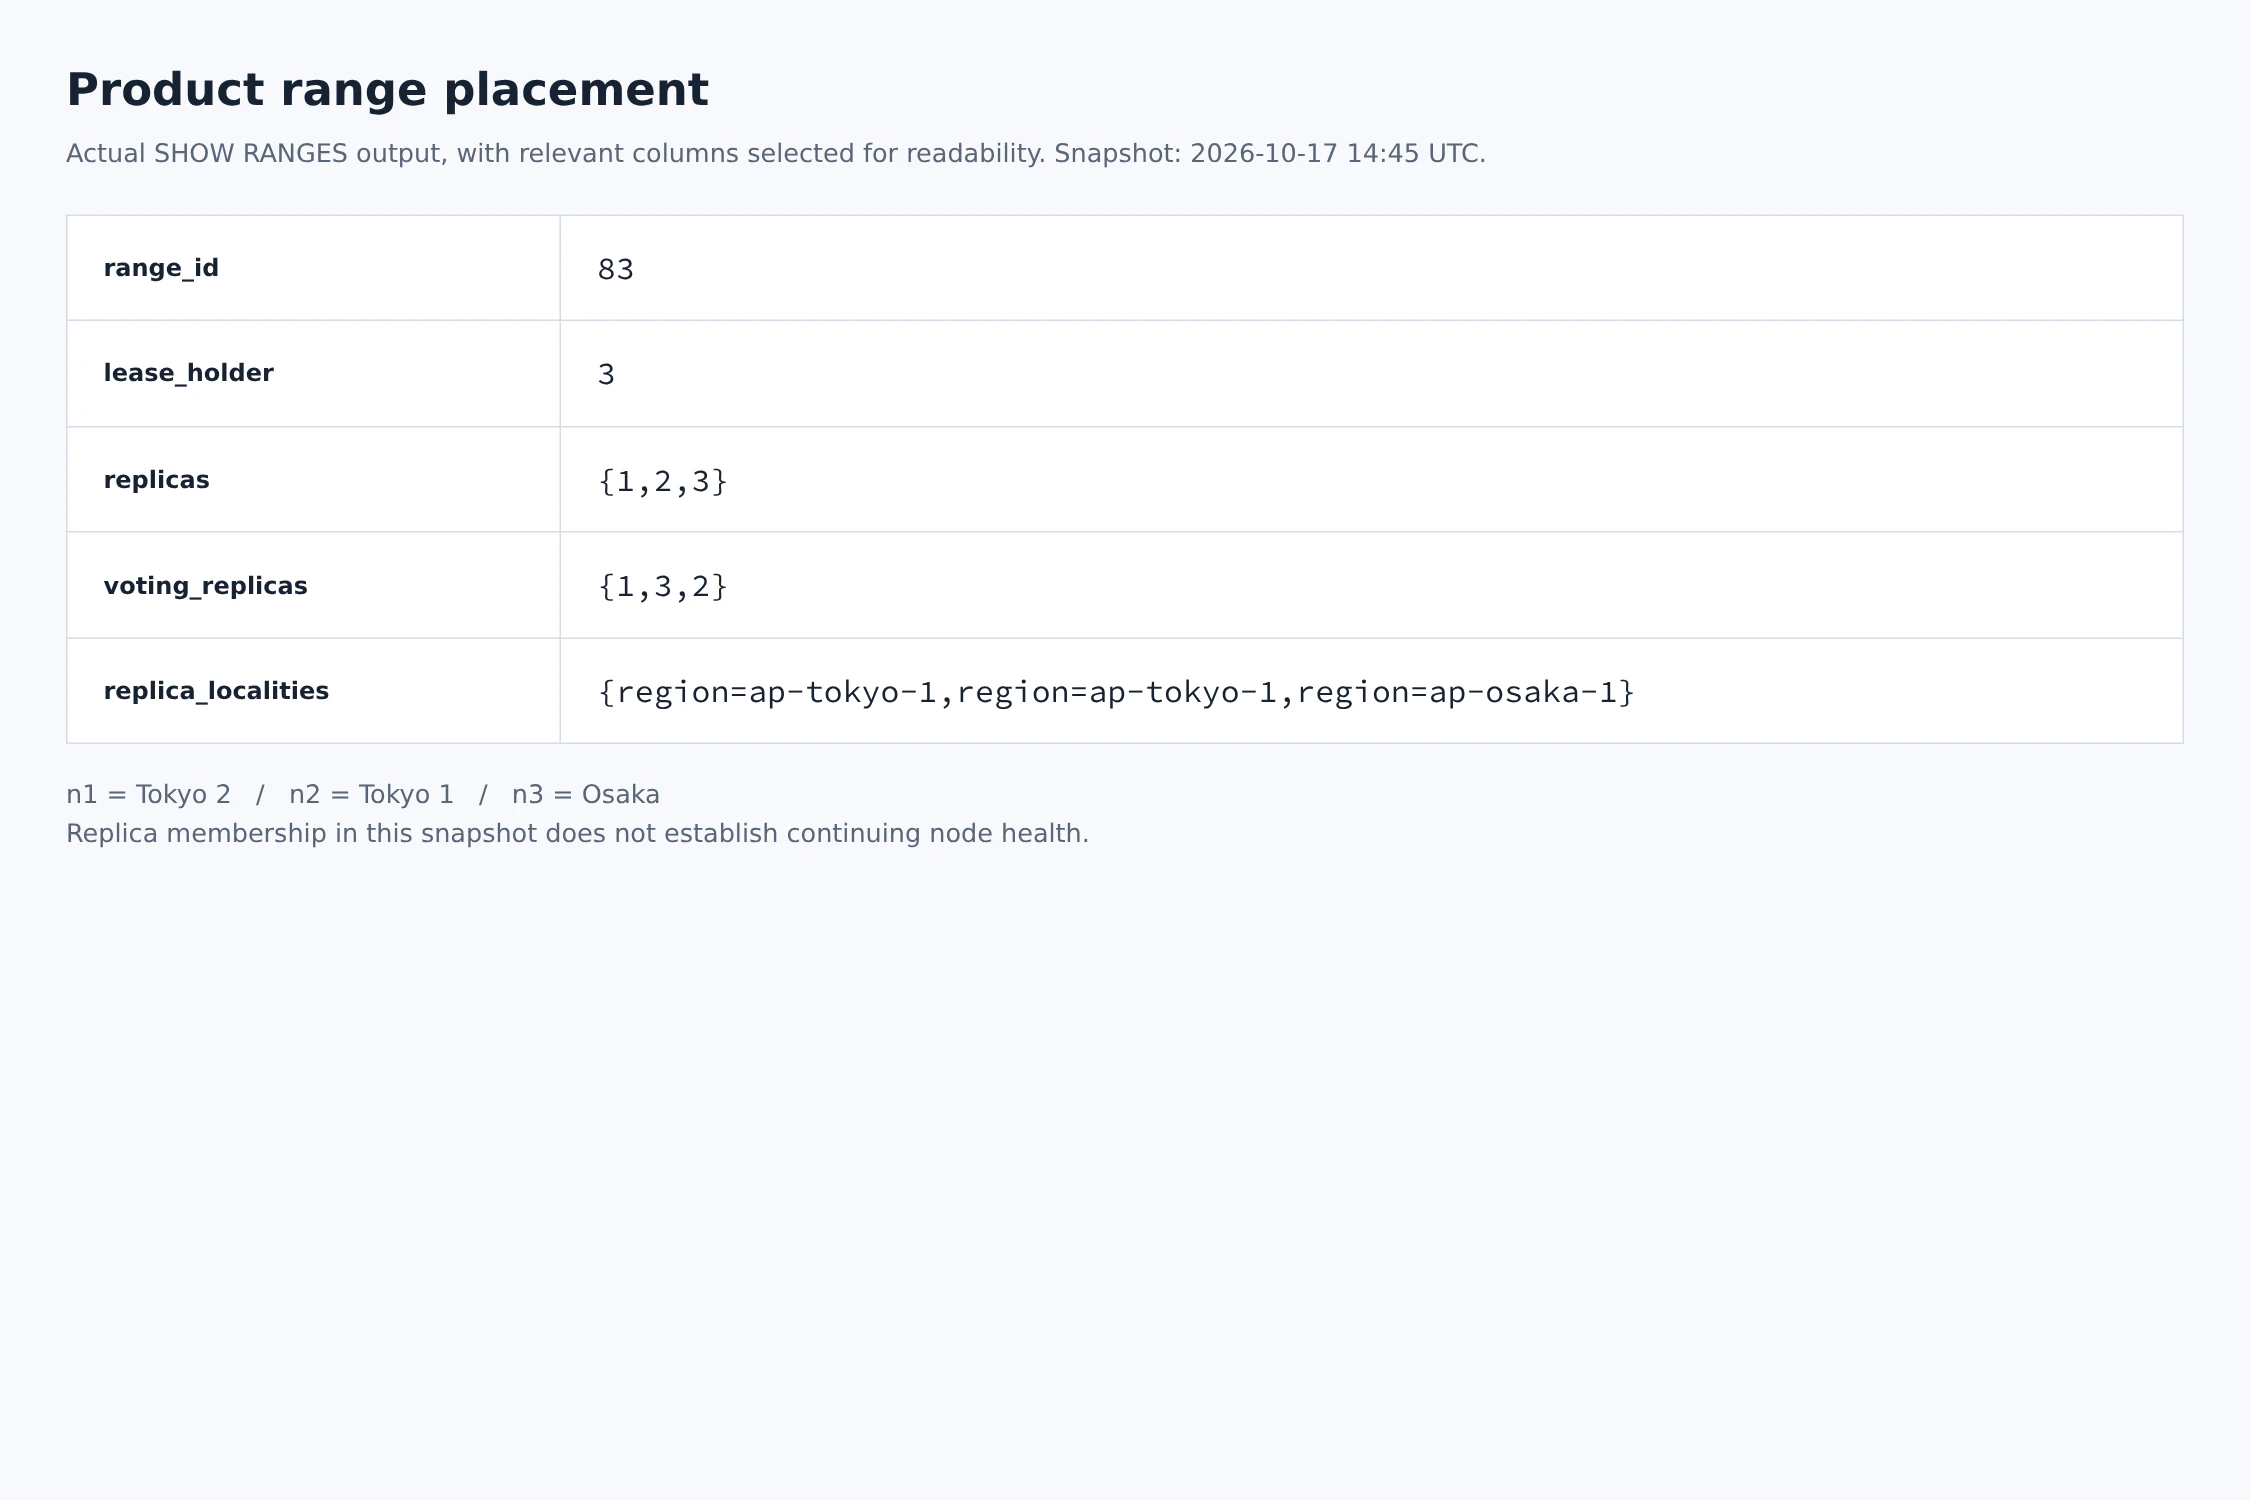
replicasに{1,2,3}と出ています。東京2・東京1・大阪の全部です。
今回の商品データは、こういう状態でした。
| 商品 | 東京2にあるコピー | 東京1にあるコピー | 大阪にあるコピー |
|---|---|---|---|
| Coffeeの在庫 | 9 | 9 | 9 |
| Teaの在庫 | 20 | 20 | 20 |
| Cocoaの在庫 | 28 | 28 | 28 |
CoffeeもTeaもCocoaも、3台とも持っています。
このデータのまとまりがレンジ、コピーがレプリカ。今回は商品データがrange 83に含まれ、そのレプリカが3つありました。
更新すると、その変更がほかのコピーにも反映されます。
ファイルをそのまま配るのではなく、更新内容をそろえる仕組みです。複製の仕組みもこの単位で動いています。
今回は3台に3コピーなので、全台に同じものがありました。
もっとノードを並べる大規模なDBだと、データをレンジに分け、そのコピーを3台ずつに置くとのこと。
そっちは各ノードがDBの一部ずつを持つ感じかな。
lease_holderは3。通常の読み取りなどを担当するのは、この時点では大阪です。
SQLの接続先とは別に担当がいて、そこへ処理を取り次いでくれる仕組みっぽい。
列の意味はSHOW RANGESのリファレンスと構成の説明を見ながら確認しました。
後で見直すとleaseholderは別のノードに移っていました。固定ではなかったです。
DBを止めてみる
まずは大阪の1台
3台ともLIVEで、複製不足・利用不能レンジが0になったところから始めます。
同じ商品データを持つ3台のうち、大阪のDBサービスを停止。
sudo systemctl stop cockroach-qiita.service
inactiveになったのを確認し、約7秒待って東京2からSELECTしてみました。
Coffee=9、Tea=20、Cocoa=28。
普通に読めました。
読むだけでなく、確認用のavailability_eventsテーブルにも1行INSERT。
これも成功しました。

Consoleは2 LIVE、1 DRAINING。複製不足57、利用不能0です。
下の一覧はまだ古いLIVE表示が残っていましたが、上の数字は変わっています。
1台止めても、残りの東京2台で読み書き出来ています。
止めた瞬間からSQLを流し続けたわけではなく、今回は約7秒待ってからの確認です。
大阪を起動し直すと3 LIVEに戻り、複製不足も0になりました。
さっきINSERTした行も残っていました。
東京2台を止めてみる
1台は大丈夫でした。では2台。
いったん3台が正常に戻った後、大阪へ接続しておきます。
そのまま東京1、東京2の順でDBサービスを停止しました。
約8秒後、止めた東京2につなぎ直すとECONNREFUSED。
接続先が止まっているので、当然そうなる。
残した大阪への接続からINSERTしてみると、今度は待ったままです。
その後、返ってきたのがこれ。
SQLSTATE: 57014
query execution canceled due to statement timeout
SELECTも同じ。
| 操作 | 結果 | 時間 |
|---|---|---|
| 大阪へINSERT | statement timeout | 5,012ms |
| 大阪でSELECT | statement timeout | 5,010ms |
5秒なのは、こちらでstatement_timeout=5000msにしていたためです。
大阪のDB自体は起動したままですが、SQLが進みません。
Consoleも20秒待って開けなかったので、このときは実行ログを残しました。

実行ログを整形した画像。
残った1台にもデータはあるのに
大阪にもCoffee・Tea・Cocoaのコピーが残っているのは、さっき見たとおり。
でも、それだけでは検索も更新もできないらしい。
Replication Layerを見ると、更新の確定には、合意に参加するコピー(投票レプリカ)の過半数が要るとのこと。
今回なら3つのうち2つです。
大阪を止めたときは、東京の2台にあるコピーで合意できる。
東京2台を止めると、動いているのは大阪の1コピーだけ。データはあっても、過半数に届かない。
なるほど。2台停止で検索も更新もできない理由はここか。

今回の止め方ではSELECTもタイムアウトしました。
読み取りにはleaseholderも関わるので、毎回の読み取りで過半数の投票をする、という意味ではなさそう。
たまたまleaseholderが落としたノードだったっぽい。
起動して戻す
東京2、東京1のサービスを起動します。
sudo systemctl start cockroach-qiita.service
3 LIVE、複製不足0、利用不能0に戻りました。
データや設定はそのままです。既存のサービスを起動しただけで復帰しました。
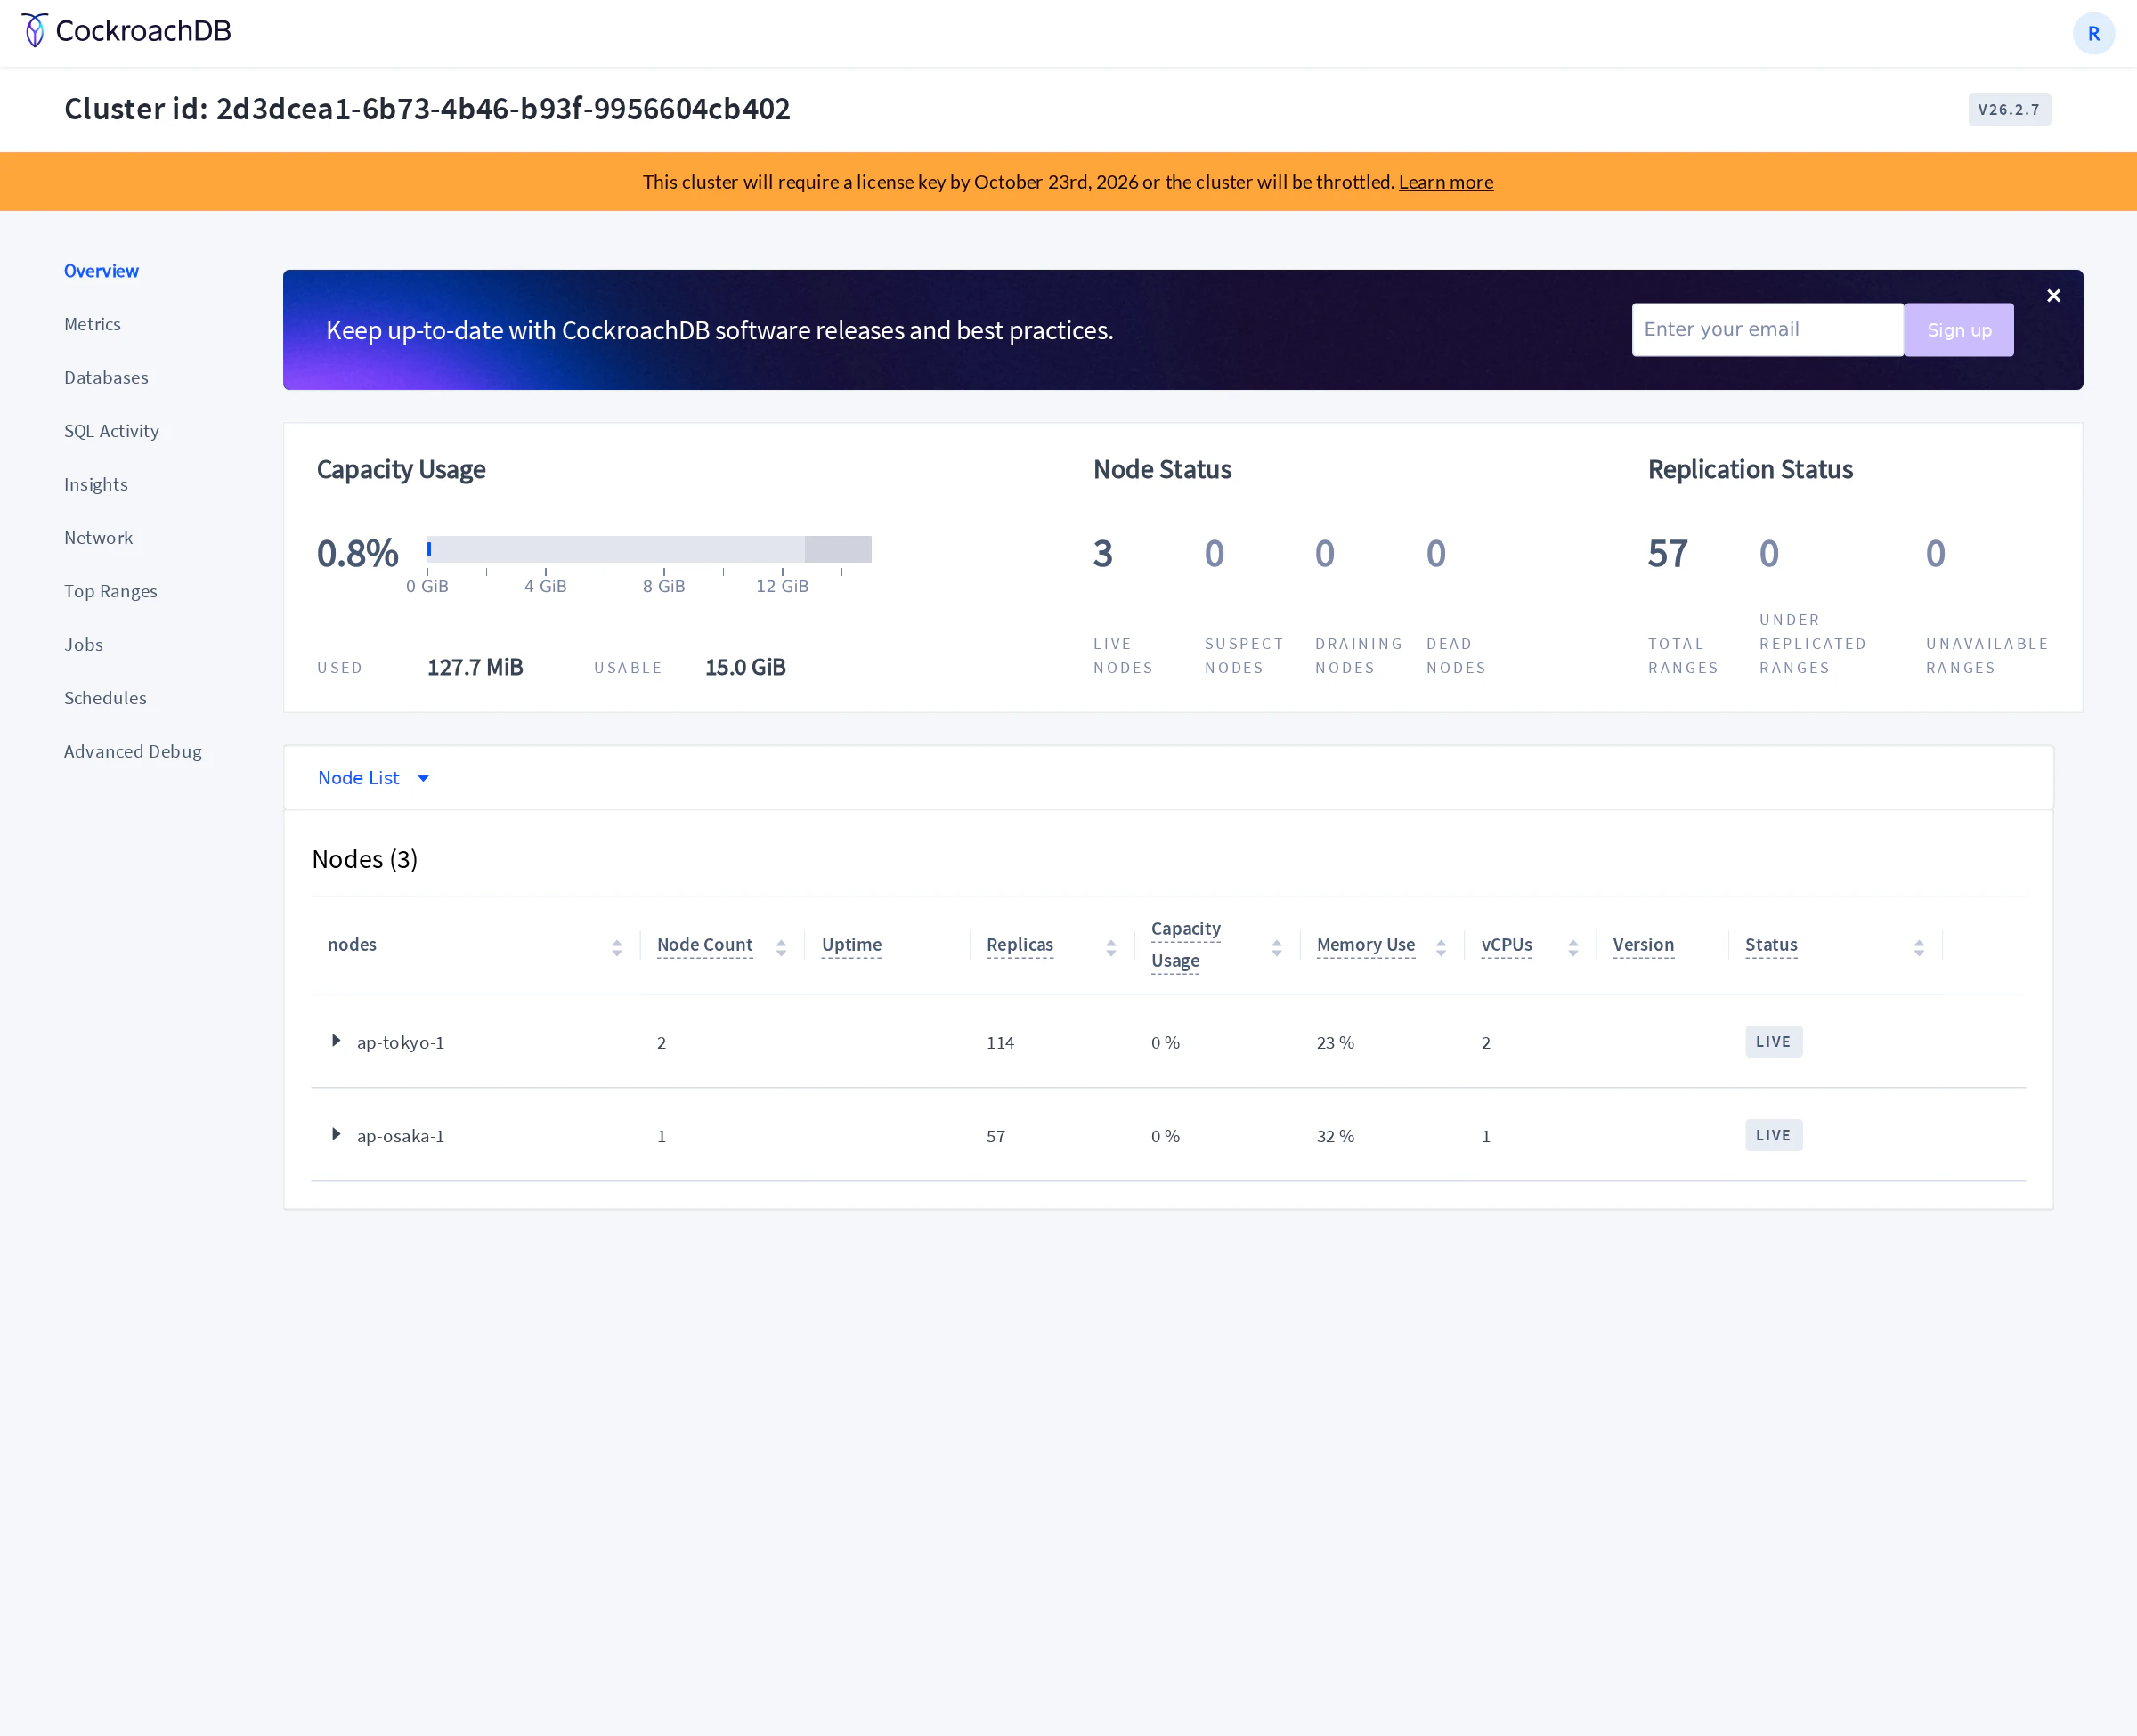
停止中のINSERTがどうなったかも見ておきます。
| 書き込み | 復帰後 |
|---|---|
| 大阪停止中、東京から成功したINSERT | 行が残っていた |
| 大阪だけの状態でタイムアウトしたINSERT | 今回は行がなかった |
タイムアウトした方は結果が気になるので、一意なIDで実データを確認しました。
今回は残っていませんでした。
同じ在庫を同時に更新してみる
ノードを止める方は一旦ここまで。
次は2つの接続から、同じ在庫を更新してみます。
在庫を読んで、あれば1個減らし、注文を登録するだけの処理です。
別のテーブルを用意しました。
CREATE TABLE inventory_demo (
  sku STRING PRIMARY KEY,
  initial_stock INT NOT NULL,
  stock INT NOT NULL CHECK (stock >= 0)
);

CREATE TABLE orders_demo (
  order_id UUID PRIMARY KEY,
  sku STRING NOT NULL REFERENCES inventory_demo(sku),
  quantity INT NOT NULL CHECK (quantity = 1)
);
initial_stockは最初の在庫を残しておく列です。
最後に残在庫と注文数が合っているかを見るために入れています。
Node.jsのpg 8.16.3で、Aは東京1、Bは大阪につなぎました。
クライアントは両方とも東京2で動かしています。
まずは再試行なし
分離レベルを見てみます。
SHOW default_transaction_isolation;
両方ともserializableでした。
在庫を2にして、両方でBEGIN。
AもBも在庫2を読んだところで待ち合わせ、Aだけ先に更新・COMMITさせます。
SQLは一文ずつ送っています。
| 順序 | A:東京1へ接続 | B:大阪へ接続 |
|---|---|---|
| 1 | BEGIN、在庫2を読む | BEGIN、在庫2を読む |
| 2 | 在庫を1減らし、注文登録してCOMMIT | 待ち合わせ |
| 3 | 完了 | 在庫を1減らそうとする |
BがUPDATEしたところで、これが返ってきました。メッセージの先頭だけ載せます。
SQLSTATE: 40001
restart transaction: TransactionRetryWithProtoRefreshError: WriteTooOldError
restart transaction。やり直してくれということなので
今回はひとまずROLLBACKして終了させました。
残在庫1、注文1件。
Aだけが完了して、Bの注文は入っていません。
やり直す処理を足す
Transaction Retry Error Referenceを見ながら、40001が返ってきたら再試行するようにしました。
やり直すのはUPDATEだけでなく、BEGINからです。
在庫ももう一度読みます。
注文IDは先にUUIDで決め、やり直しても同じIDを使います。
対象は40001だけ、初回込みで最大5回にしました。
再試行部分を抜き出すとこんな感じ。
// clientは一つのpg.Client。orderIdは再試行の外で決めておく。
for (let attempt = 1; attempt <= 5; attempt++) {
  try {
    await client.query('BEGIN');

    // 在庫を読み直す → 在庫の有無を判断する
    // → 在庫を減らす → 同じorderIdで注文を登録する
    const result = await placeOrderInTransaction(client, sku, orderId);

    await client.query('COMMIT');
    return result;
  } catch (error) {
    await client.query('ROLLBACK');

    if (error.code !== '40001' || attempt === 5) {
      throw error;
    }

    await sleep(30 * (attempt + 1));
  }
}
placeOrderInTransactionは在庫確認・更新・注文登録を表した仮の関数です。
トランザクション中はpgの同じClientを使っています。
新しい商品行で同じようにぶつけてみると、Bは一度40001になりました。
その後やり直して在庫1を読み、今度はCOMMIT出来ました。
残在庫0、注文2件。
今度は両方の注文が入りました。
最後の1個でも試す
在庫1で同じことをすると、Aの注文が先に確定して、Bは40001。
ここまでは同じです。
ただし、Bが読み直した在庫はもう0でした。
なので売り切れで終了。2件目の注文は入りません。
並べるとこうなりました。
| ケース | 初期在庫 | 残在庫 | 注文数 | Bの結果 |
|---|---|---|---|---|
| 再試行なし | 2 | 1 | 1 | 40001の後、ROLLBACKして終了 |
| 全体を再試行 | 2 | 0 | 2 | 在庫1を読み直し、2回目で注文確定 |
| 最後の1個・再試行あり | 1 | 0 | 1 | 在庫0を読み直し、売り切れで終了 |

実行ログを整形した画像。
3回とも、残在庫と注文数量の合計は最初の在庫と一致しました。
在庫が負になったり、注文IDが重複したりもしていません。
最初の再試行なしでも数は合っています。Bが中断されたままだっただけです。
そこに再試行を加えると、残っている在庫を見直して、注文するか売り切れにするかを判断出来ました。
この辺はアプリ側で面倒を見ることになる部分かな。
東京と大阪に置いてみて
今回は東京に2台、大阪に1台です。
大阪を止めても東京に過半数が残りますが、逆はそうなりませんでした。
リージョンごと止まる場合はどうするのかも調べると、SURVIVE REGION FAILUREには3以上のデータベースリージョンが要るとのことでした。
今回の2リージョンとは別の構成になります。
--localityは付けていますが、SQLのマルチリージョン設定は使っていません。今回止めたのもDBサービスだけです。
Network画面も見てみました。
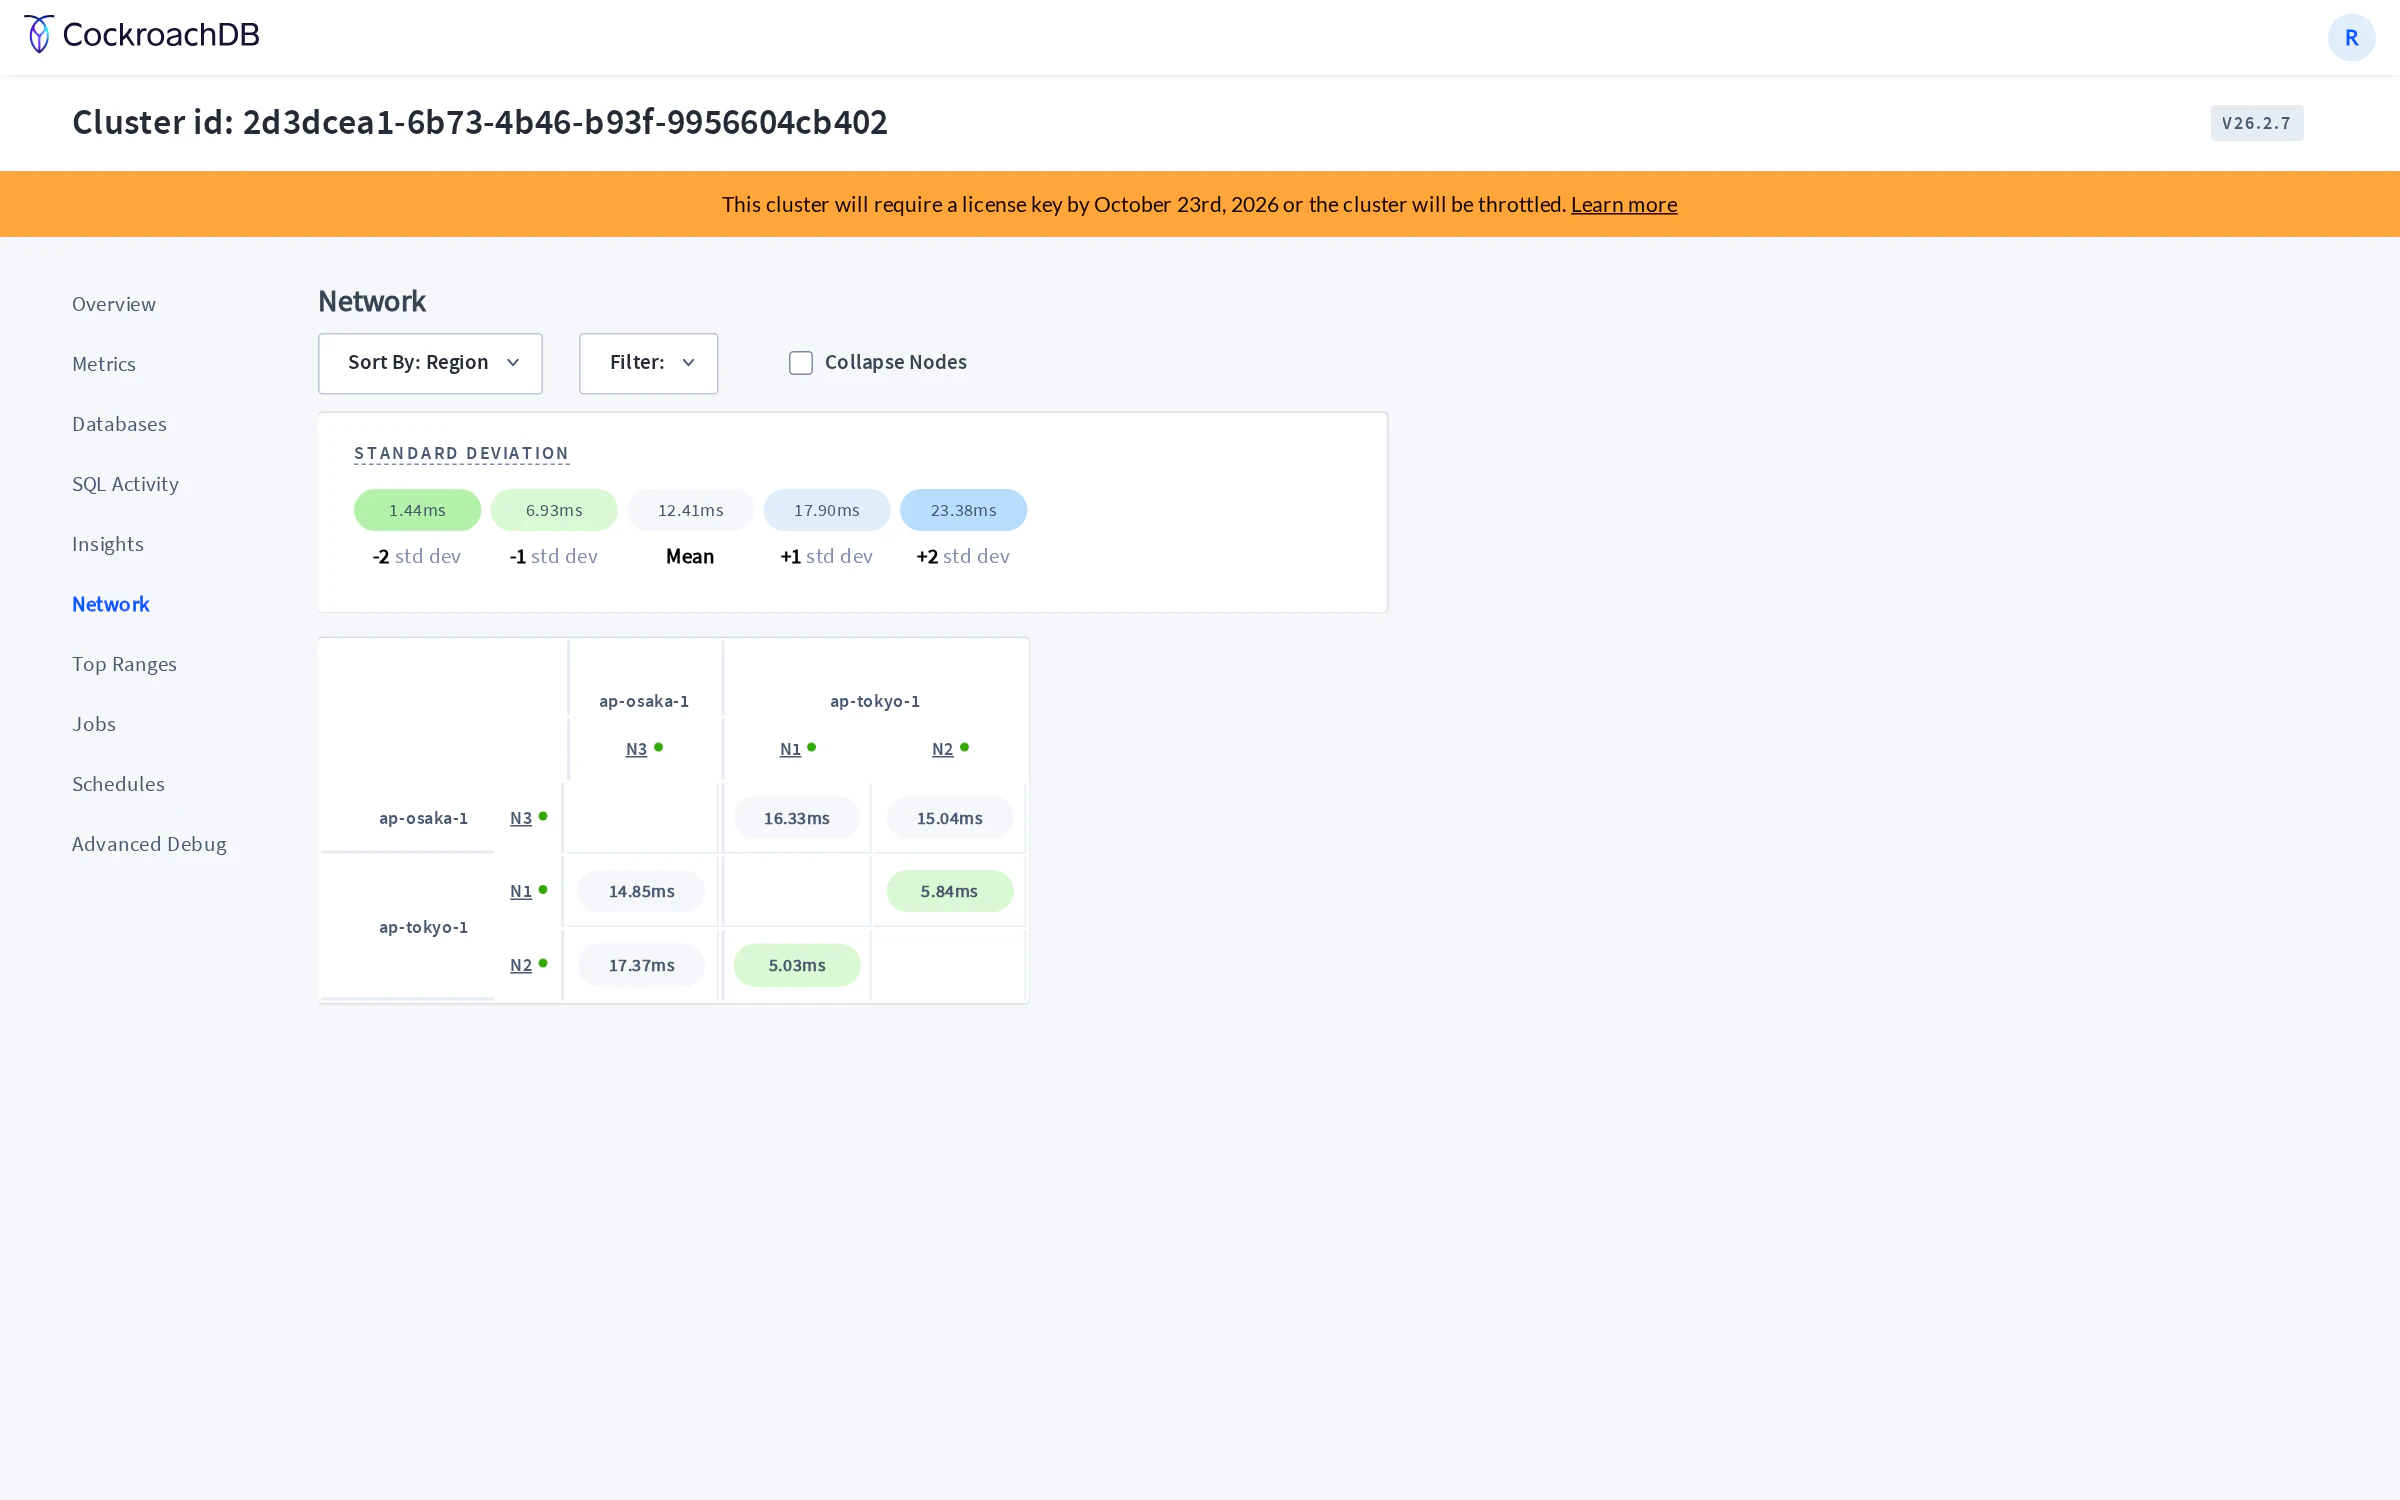
ここに出ているのはノード間RPCの往復時間です。
SELECTやCOMMITの所要時間とは別の数字。
SQLの応答時間も気になりますが、今回はそこまでは測っていません。
接続先だけでなくleaseholderも動いていたので、測るときはその辺も見ながらになるのかなと。
感想
最初はSQLでテーブルを作って読み書きするだけでしたが、3台に増やしても、そのテーブルはそのまま使えました。
接続先を変えても同じデータが見えるので、SQLだけ触っていると、あまり3台を意識しないです。
DBを止めると、残した台数で動きが変わりました。
どこに何個の複製があるかは、実際に止めてみると分かりやすかったです。
同時更新の40001は、DB側でなくてアプリ側で保証しないといけなさそう。
コンセプトと管理の仕方などはそれなりに理解できた気がする。
どっかでちゃんとしたアプリに採用してみたい。
今回はこの辺で終わり。
AIと一緒にやったとはいえ、作業量多すぎて疲れた・・・