
初めに
Jnini&Vella2025のテクニック.
コードを公開する: Colab
Methods
非線形最小二乗問題
\begin{align}
    \mathcal{L}
    = \frac{1}{2} \| \boldsymbol{r} \|_2^2
    = \frac{1}{2} \sum_{n}^{N} r_{n}^{2}
\end{align}
に対して($r_{n} = r_{n} (\boldsymbol{\theta}), \ \boldsymbol{\theta} \in \mathbb{R}^{P}$),
\begin{align}
    \frac{\partial}{\partial \theta_{p}} \mathcal{L}
    &= \sum_{n} r_{n} \frac{\partial}{\partial \theta_{p}} r_{n}
    \\
    \frac{\partial}{\partial \theta_{q}}
    \frac{\partial}{\partial \theta_{p}} \mathcal{L}
    &= \sum_{n} \frac{\partial}{\partial \theta_{q}} r_{n} \frac{\partial}{\partial \theta_{p}} r_{n}
        + \sum_{n} r_{n} \frac{\partial^2}{\partial \theta_{q} \partial \theta_{p}} r_{n}
    \\
    &\simeq \sum_{n} \frac{\partial}{\partial \theta_{q}} r_{n} \frac{\partial}{\partial \theta_{p}} r_{n}
    \\
    &= \left[ \boldsymbol{J}^{\top} \boldsymbol{J} \right]_{q, p}
\end{align}
を用いてNewton法を近似する.即ち,
\begin{align}
    (\nabla_{\boldsymbol{\theta}} \otimes \nabla_{\boldsymbol{\theta}} \mathcal{L}) \boldsymbol{\delta}
    &= - \nabla_{\boldsymbol{\theta}} \mathcal{L}
    \\
    (\boldsymbol{J}^{\top} \boldsymbol{J}) \boldsymbol{\delta}
    &= - \boldsymbol{J}^{\top} \boldsymbol{r}
    \\
    (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{\delta}
    &= - \boldsymbol{J}^{\top} \boldsymbol{r}
\end{align}
である.第1式がNewton法,第2式がGauss-Newton法,第3式がLevenberg-Marquardt法である.得られた$\boldsymbol{\delta}$を使って
\begin{align}
    \boldsymbol{\theta}^{(k+1)}
    &= \boldsymbol{\theta}^{(k)} + \boldsymbol{\delta}
\end{align}
と更新する(trust region method).機械学習モデルでは,$P \gg N$となることが多い.Newton法,およびGauss-Newton法,Levenberg-Marquardt法は,$\boldsymbol{\delta}$を求める際に$\mathcal{O} (P^2)$だけのメモリストレージと,$\mathcal{O} (P^3)$だけの浮動小数点演算を要求するため,Hessianを近似するGNやLMを採用してもなお,計算コストの面から実行が困難となる場合がある.
Jnini&Vella2025のテクニックは,
\begin{align}
    (\boldsymbol{J} \boldsymbol{J}^{\top} + \mu \boldsymbol{I}_{N}) \boldsymbol{y}
    &= - \boldsymbol{J} \boldsymbol{J}^{\top} \boldsymbol{r}
\end{align}
を解き,得られた$\boldsymbol{y} \in \mathbb{R}^{N}$から
\begin{align}
    \mathbb{R}^{P}
    \ni
    \boldsymbol{\delta}
    &= - \frac{1}{\mu} (\boldsymbol{J}^{\top} \boldsymbol{y} + \boldsymbol{J}^{\top} \boldsymbol{r})
\end{align}
を作ることで,メモリストレージを$\mathcal{O} (N P)$に,浮動小数点演算を$\mathcal{O} (N^3)$に低減させるものである.
元のLMの式に$\boldsymbol{\delta}$を代入し,等価性をチェックする(Ito2025に倣った).
\begin{align}
    (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{\delta}
    &= - \frac{1}{\mu}
        (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P})
        (\boldsymbol{J}^{\top} \boldsymbol{y} + \boldsymbol{J}^{\top} \boldsymbol{r})
    \\
    &= - \frac{1}{\mu}
        (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{J}^{\top} \boldsymbol{y}
        - \frac{1}{\mu}
        (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{J}^{\top} \boldsymbol{r}
    \\
    &= - \frac{1}{\mu} \boldsymbol{J}^{\top}
        (\boldsymbol{J} \boldsymbol{J}^{\top} + \mu \boldsymbol{I}_{N}) \boldsymbol{y}
        - \frac{1}{\mu}
        (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{J}^{\top} \boldsymbol{r}
    \\
    &= \frac{1}{\mu} \boldsymbol{J}^{\top}
        (\boldsymbol{J} \boldsymbol{J}^{\top} \boldsymbol{r})
        - \frac{1}{\mu}
        (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{J}^{\top} \boldsymbol{r}
    \\
    &= - \boldsymbol{J}^{\top} \boldsymbol{r}
\end{align}
となり,$\boldsymbol{y}$を作ってから元の次元に戻せば,元の空間で$\boldsymbol{\delta}$を解いたことと等価であることが確認できる.
同様に,測地線加速(Transtrum&Sethna2012)が入る場合にも同様の手続きが実行可能であると考える(後から,Jnini&Vella2025にも同じことが書いてあったことに気付いた).即ち,通常解くべき
\begin{align}
    (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{\delta}_{a}
    &= - \boldsymbol{J}^{\top} \boldsymbol{r}_{a}
\end{align}
の代わりに
\begin{align}
    (\boldsymbol{J} \boldsymbol{J}^{\top} + \mu \boldsymbol{I}_{N}) \boldsymbol{y}_{a}
    &= - \boldsymbol{J} \boldsymbol{J}^{\top} \boldsymbol{r}_{a}
\end{align}
を解く.得られた$\boldsymbol{y}_{a} \in \mathbb{R}^{N}$から
\begin{align}
    \mathbb{R}^{P}
    \ni
    \boldsymbol{\delta}_{a}
    &= - \frac{1}{\mu} \boldsymbol{J}^{\top} (\boldsymbol{y}_{a} + \boldsymbol{r}_{a})
\end{align}
をrecoverし,これを元の解くべき式に代入すると,
\begin{align}
    (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P}) \boldsymbol{\delta}_{a}
    &= - \frac{1}{\mu}
        (\boldsymbol{J}^{\top} \boldsymbol{J} + \mu \boldsymbol{I}_{P})
        \boldsymbol{J}^{\top} (\boldsymbol{y}_{a} + \boldsymbol{r}_{a})
    \\
    &= - \frac{1}{\mu}
    \left[
        (\boldsymbol{J}^{\top} \boldsymbol{J} \boldsymbol{J}^{\top} + \mu \boldsymbol{J}^{\top}) \boldsymbol{y}_{a}
        + (\boldsymbol{J}^{\top} \boldsymbol{J} \boldsymbol{J}^{\top} + \mu \boldsymbol{J}^{\top}) \boldsymbol{r}_{a}
    \right]
    \\
    &= - \frac{1}{\mu}
    \left[
        \boldsymbol{J}^{\top} (\boldsymbol{J} \boldsymbol{J}^{\top} + \mu \boldsymbol{I}_{N}) \boldsymbol{y}_{a}
        + \boldsymbol{J}^{\top} \boldsymbol{J} \boldsymbol{J}^{\top} \boldsymbol{r}_{a}
        + \mu \boldsymbol{J}^{\top} \boldsymbol{r}_{a}
    \right]
    \\
    &= - \boldsymbol{J}^{\top} \boldsymbol{r}_{a}
\end{align}
となり,合致する.
Results
1次元Poisson方程式
\begin{alignat}{2}
    - u''
    &= 1
    \quad && (x \in \left( 0, 1 \right))
    \\
    u
    &= 0
    \quad && (x \in \lbrace 0, 1 \rbrace)
\end{alignat}
に対してPINNを適用する.中間次元64,中間層数3のMLPを用い,損失関数を100点の選点で離散化した($P = 8{,}513, \ N = 100$).境界条件は厳密に要請した(e.g., Sukumar&Srivastava2022, Deguchi&Asai2025).
最適化に上述のLMを適用し,通常のLM法(Primal)と,Jnini&Vella2025のテクニックを利用したLM法(Dual)が合致するか検証した.測地線加速項は1次近似とした(Transtrum&Sethna2012).$\mu$の最大値,最小値は,$1 \times 10^{6}$,$1 \times 10^{-6}$とした.
NVIDIA T4 GPU上で数値実験を行った.また,乱数シードを全く固定した.
without geodesic acceleration
| $\text{Single precision}$ | $\text{Double precision}$ | |
|---|---|---|
| $\text{Solution}$ |  |
 |
| $\text{Loss func}$ |  |
 |
| $\text{Damping param}$ |  |
 |
| $\text{Wall clock time}$ |  |
 |
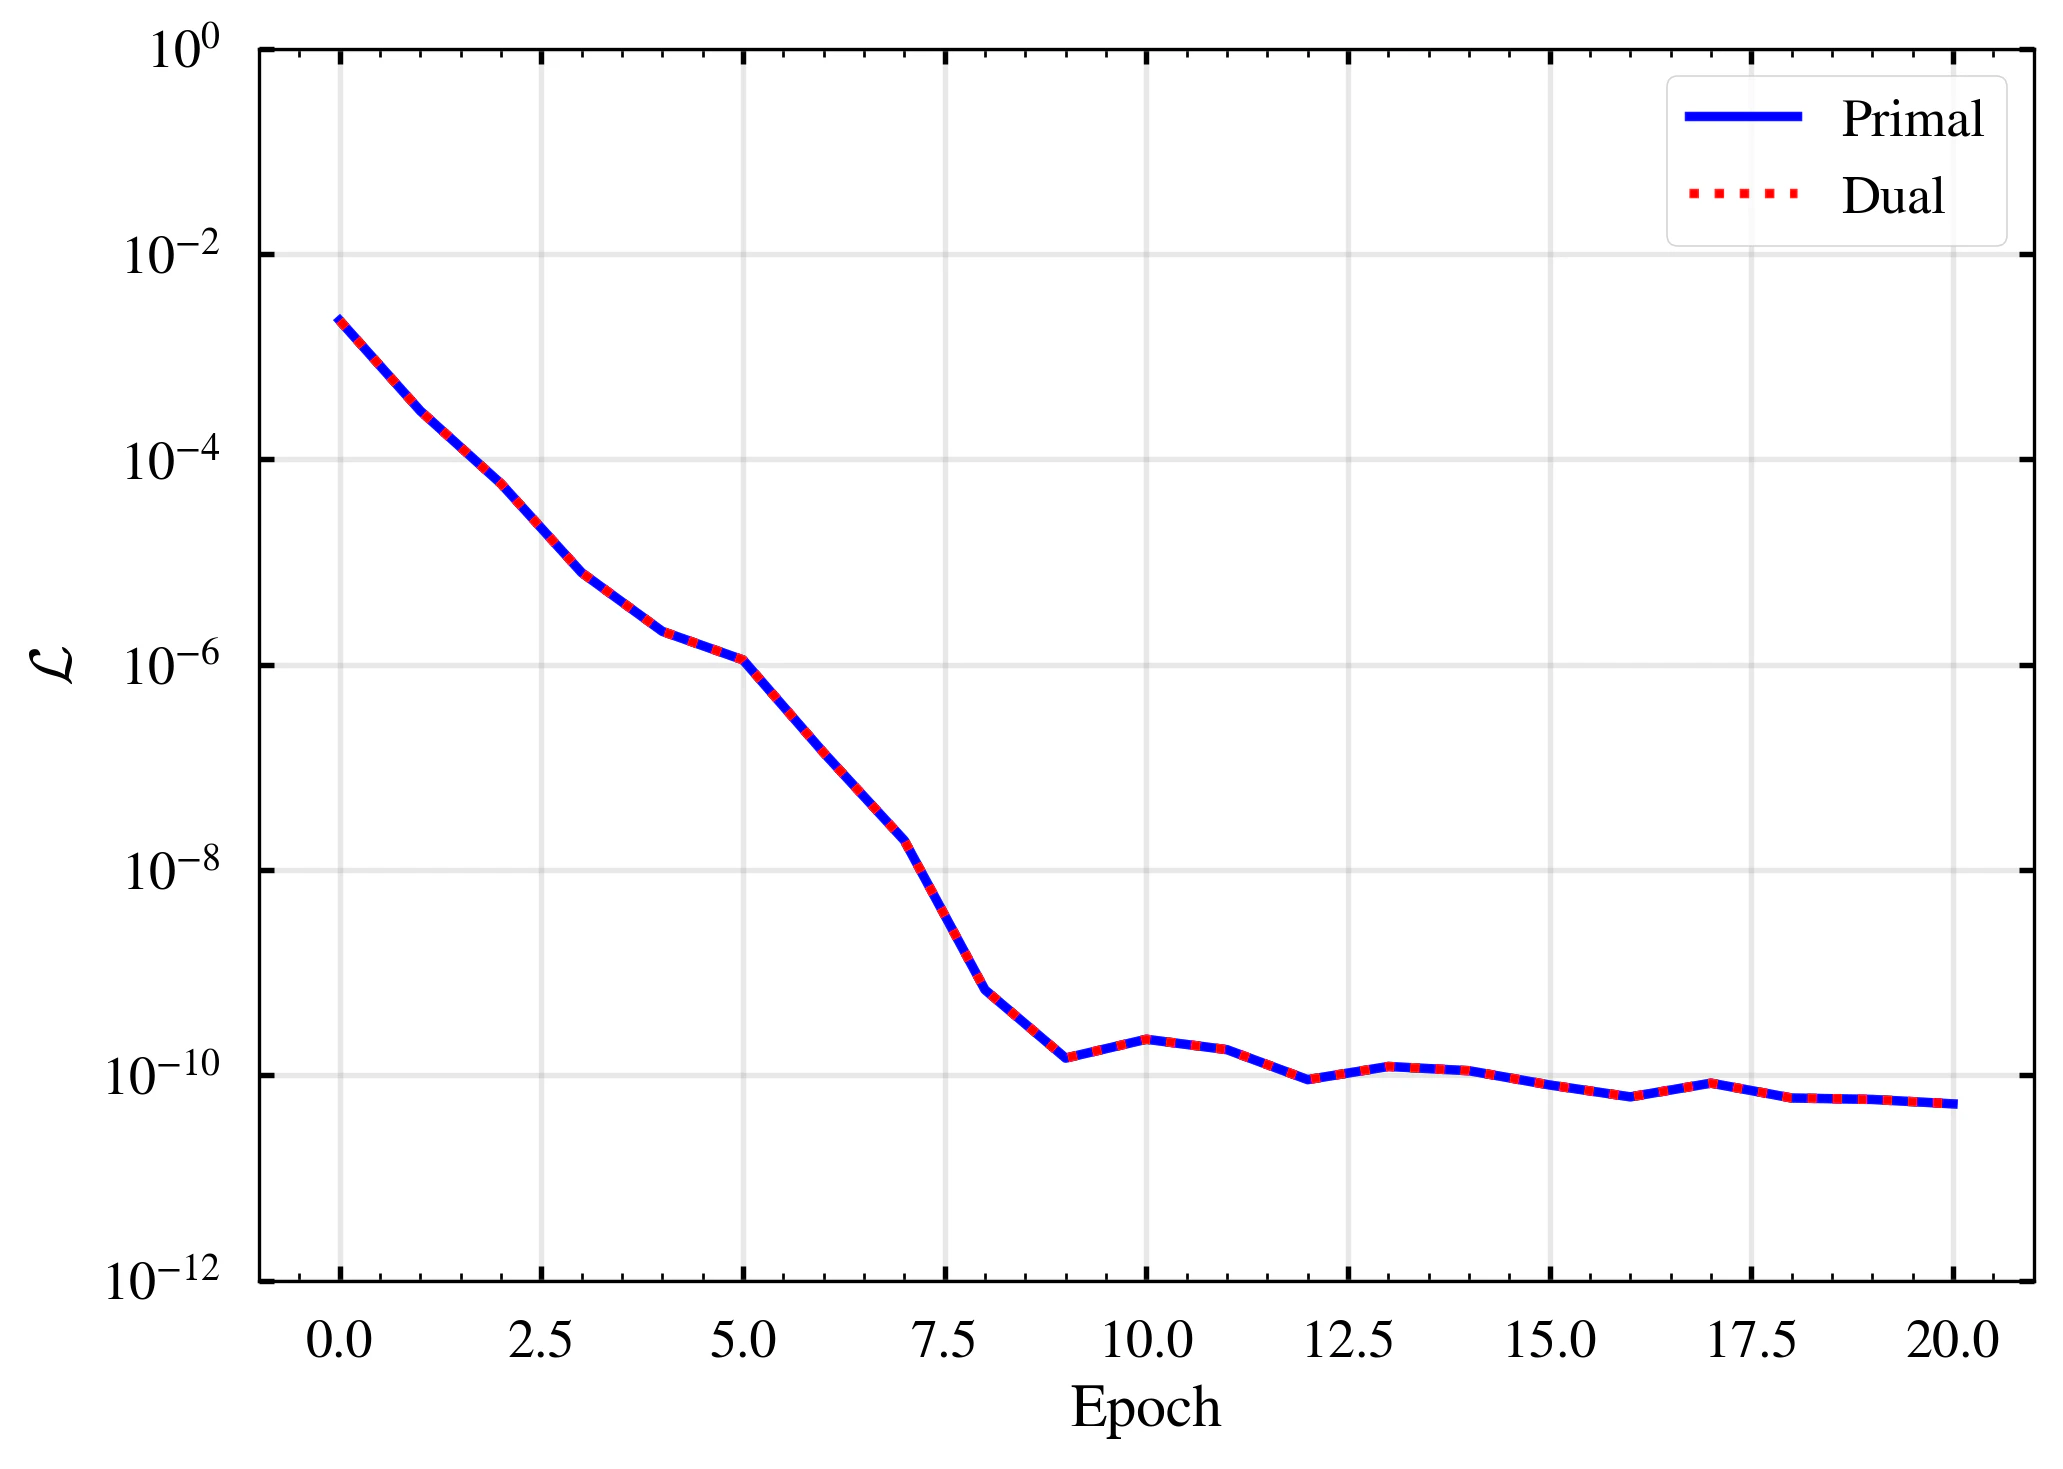
単精度では,PrimalとDualはほぼ同様の動きをしているが,若干の乖離がある.恐らく丸め誤差によるものと考えている.
倍精度では,上記の差が殆ど見えなくなり,上述の議論がそのまま数値実験に現れる結果となった.
また,単精度・倍精度両者で,Dualの方が,1 epoch当たりの計算コストが小さい.これは,解くべき行列のサイズが小さいことによる(Primal: $P \times P = 8{,}513 \times 8{,}513$, Dual: $N \times N = 100 \times 100$).
with geodesic acceleration
| $\text{Single precision}$ | $\text{Double precision}$ | |
|---|---|---|
| $\text{Solution}$ |  |
 |
| $\text{Loss func}$ |  |
 |
| $\text{Damping param}$ |  |
 |
| $\text{Wall clock time}$ |  |
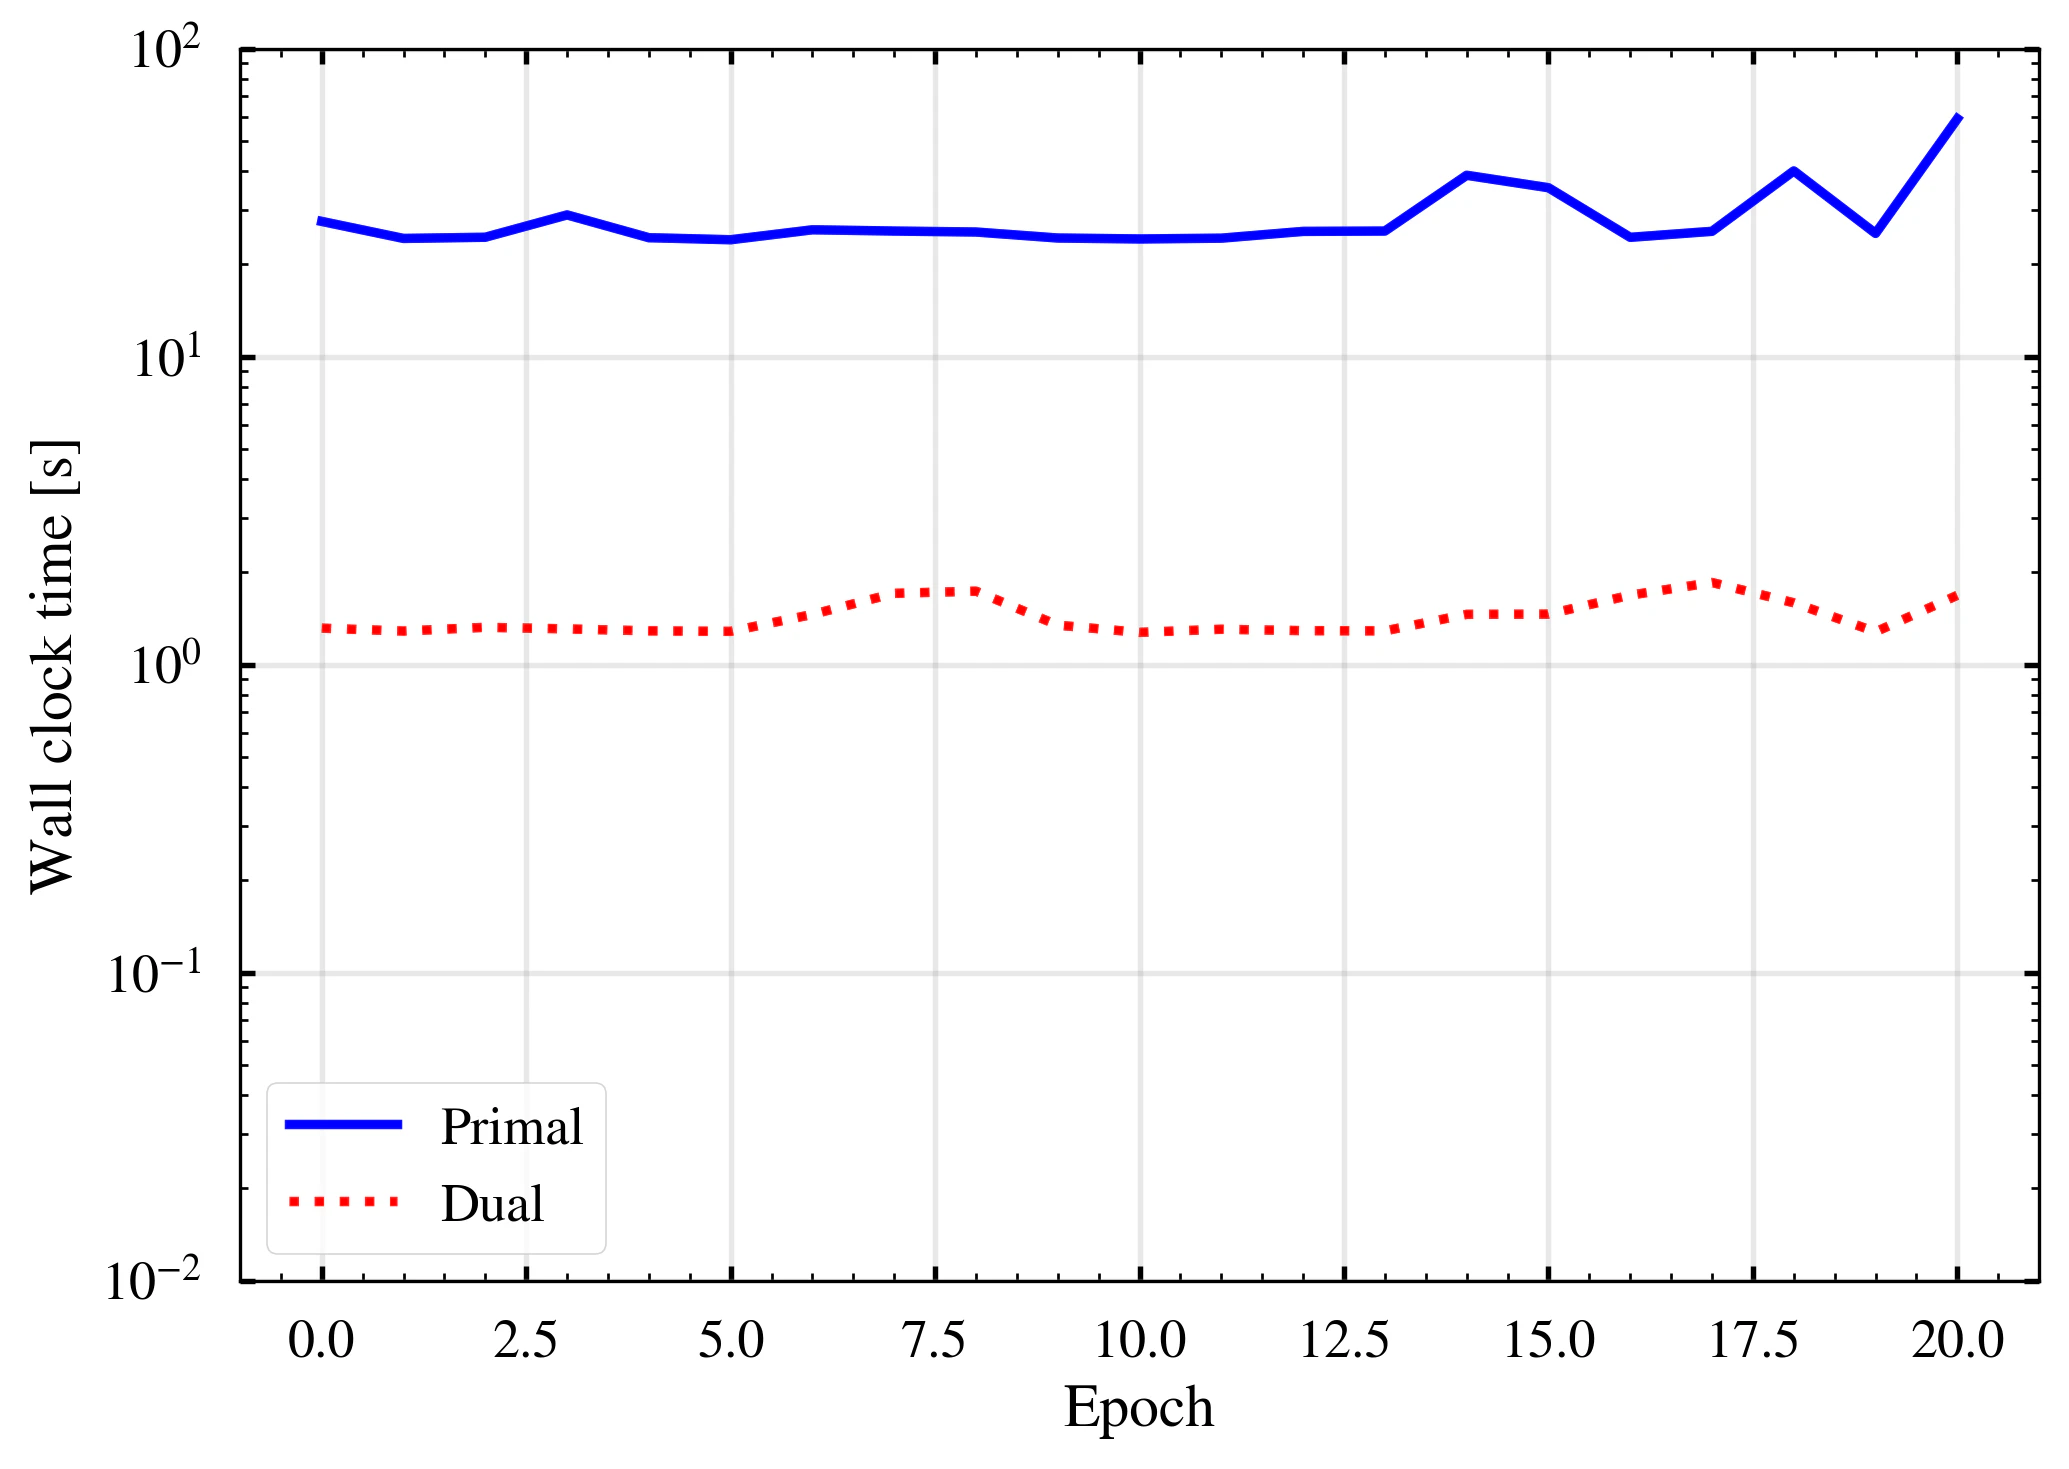 |
測地線加速を入れても同様に,単精度・倍精度の選択により,Primal・Dualの一致・不一致が確認できる.
また,この問題においては,測地線加速が有効であったが,常に測地線加速が有益かには懐疑的である(測地線加速を入れると,これを入れない場合より若干だけ精度が悪くなる結果を別の問題で得ている).他方,どのような問題で入れるべきか / 入れないべきかについては整理し切れていない.
終わりに
$P$と$N$の大小関係によってどちらを解くべきか選択することができるので,嬉しい場合がある(当然,それでも行列が非現実的なほど大きくなる場合もある).