
はじめに:コードは1時間で書けた。請求で3日止まった。
先月、社内ツールに LLM を組み込む小さな機能を作った。OpenAI SDK で base_url を書いて、ストリーミングを繋いで、テストも通った。所要時間は1時間ちょっと。
そのあと、経理から戻ってきた。
「このカード、海外決済で弾かれてます。あと、ドル建ての領収書だけだと、適格請求書がないので経費処理のフローに乗せられません。」
コードは動いているのに、本番に出すための請求と支払いで止まった。これがきっかけで AIプロキシ / AI APIプロキシ を調べ、実際に自分で契約して使ってみることにした。
この記事は「AIプロキシとは何か」の解説ではなく、日本から海外AI APIを使うときに実際に詰まるポイントと、プロキシを実際に使ってどうだったかに絞って書く。
詰まり①:支払いと経理 — ドル建て・海外手数料・適格請求書なし、どれか一つで止まる
海外の LLM API は、多くがドル建てのクレジットカード決済だ。日本のクレジットカードでそのまま払うと、いくつかの層で止まる。
カード会社の海外取引制限・不正利用検知:普段使っていない海外決済が突然通ると、カード会社側で止められることがある。
3Dセキュア未完了:認証画面が出ない、承認後も同じ画面に戻る、といったケース。
請求先情報の不一致:住所や郵便番号がカード登録と微妙に違うだけで弾かれる。
そして一番厄介なのが経理:ドル建て決済には為替変動があり、カードの海外事務手数料が乗り、適格請求書が発行されないことが多い。
最初は「API が叩ければいい」と思っていた。でも会社として使うには「誰が・いつ・いくらで・適格請求書付きで払ったか」が必要になる。ここが揃わないと、個人の検証はできてもチームの正式導入に進めない。
そこで、円建てのプリペイド残高と適格請求書に対応した AI APIプロキシ を自分で契約してみた。 使ってみた感想は、正直「もっと早く調べればよかった」だった。
登録してから円建てでチャージするまで、数分で終わった。海外カードの審査も3Dセキュアもない。
チャージ後に適格請求書(PDF)がすぐダウンロードできた。登録番号が入っているので、そのまま経理に回せる形になっている。
為替と海外事務手数料はチャージ時点で確定する。毎月ドル建ての請求書を見て「今月はいくらになるんだ」と怯えることがなくなった。
個人の検証用に小さくチャージして、うまくいったらチーム用に増やす、という使い方ができるのもよかった。
エンジニアから見ると地味な話だが、支払いと請求の摩擦が減るだけで、チームへの展開速度は変わる。経理に出す材料が揃っているかどうかは、正式導入の手前で効いてくる。
詰まり②:レイテンシ — 東京から直結していた頃の「最初の沈黙」が消えた
これはプロキシを入れるまで気づきにくい。OpenAI も Anthropic も、推論基盤の多くは米国データセンターにある。東京から呼ぶと、モデルが最初のトークンを出す前に、ネットワークだけで時間が消える。
最初は「ネットワークの遅延なんて、たかが数百ミリ秒だろう」と半信半疑だった。ただ、ストリーミングでチャット UI を触っていると、最初の1文字が出るまでの沈黙が妙に気になる。そこで、同じ東京のマシンから直結とプロキシ経由を同じ条件で測ってみた。
計測地点 直接APIのTTFB(p50) プロキシ経由のTTFB(p50)
アジア(東京)→ OpenAI 211 ms 52 ms
直結だと最初のバイトまで 211 ms。プロキシ経由だと 52 ms。差は 159 ms。数字だけ見ると地味だが、ストリーミングの体感ではこの「最初の沈黙」がかなり効く。同じプロンプトを投げ比べると、プロキシ経由のほうが明らかに「話し始めが早い」。
別のチームの検証では、東京から米国リージョン経由で GPT-4o を呼んでいたとき P50 で 450 ms、P99 で 1,850 ms だったレイテンシが、中継導入後は P50 165 ms、P99 410 ms まで下がったというデータもある。平均だけでなく P99 が下がるのは、体感の安定感につながった。
モデルそのものは変えていない。変えたのは経路だけ。それだけで「待たされている感」が減るのは、使ってみて初めて分かった。
詰まり③:モデルを増やすたびに、鍵と請求と障害対応が増える
最初は GPT 1本で始める。しばらくして「要約は安いモデルで、コーディングは別のモデルで」となり、Claude を試し、DeepSeek を検証する。ここで一気に運用が重くなる。
APIキーがプロバイダごとに増える
請求書が通貨もサイクルもバラバラで届く
レート制限の仕様が違う
片方が落ちたときのフォールバックをアプリ側で書く必要がある
どのモデルにいくら使ったかを、横断で見られない
さらに、日本の開発チームには「何を API に送っていいか分からない」という固有の不安が乗る。ITエンジニア調査では、生成AI活用の最大のハードルとして「業務情報をどの程度利用していいかわからない」が最多回答だった。信頼性とセキュリティ・プライバシーを課題に挙げる回答も、それぞれ 62.9% / 52.4% に上る。
AIプロキシを挟むと:OpenAI 互換の1つのエンドポイントに、1つのキーで複数プロバイダを集約できる。モデルの切り替えは model の値を変えるだけ。ゲートウェイ側でレート制限の緩和、フォールバック、利用量の可視化、予算上限の設定ができる。LiteLLM のような OSS プロキシを使えば、誰がどのモデルにいくら使ったかを横断で追跡できる。
「何を送っていいか」のポリシーそのものはプロキシだけでは解決しないが、送信先を1点に集約し、ログとレート制限を効かせられることは、社内説明の材料になる。
で、AIプロキシには何を選ぶか
大きく2つに分かれる。
托管型(マネージド型)
円建て・適格請求書・アジア向け経路最適化がパッケージになっているサービス。支払いと経理の問題を最短で消したいならこれ。OpenAI 互換の base_url を差し替えるだけで試せるものが多い。今回自分が先に試したのもこのタイプで、最初の一歩としては正解だった。
セルフホスト型
LiteLLM Proxy や Cloudflare AI Gateway、Kong AI Gateway などを自分で立てる。コスト管理とモデル切り替えの自由度は高い。ドコモの開発者ブログでも、LiteLLM をプロキシとして挟み、Cline からのリクエストを中継しつつコストとログを記録する事例が紹介されている。さくらの AI エンジンを Kong 経由で OpenAI 互換 API として中継する構成も、Qiita で手順付きで公開されている。
最初からフルセルフホストで組むと、鍵管理と可用性設計だけで疲れる。まず托管型で「支払い・レイテンシ・鍵の一本化」を体感し、要件が固まったらセルフホストに移す、くらいの順番が現実的だと思う。
実際にコードはどれだけ変わるか
OpenAI SDK を使っている場合、多くの托管型プロキシでは base_url と api_key を差し替えるだけで動く。
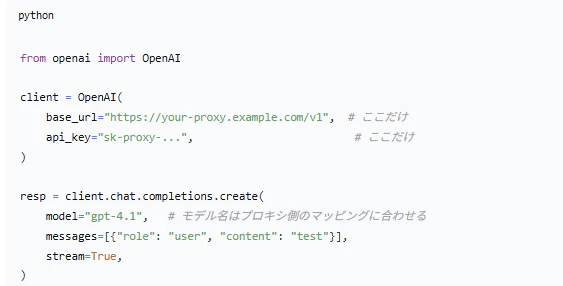
Claude Code や Cline のようなコーディングエージェントでも、設定画面の「OpenAI 互換エンドポイント」にプロキシの URL を入れる形で接続できるものが増えている。既存のアプリケーションコードを書き換える範囲は、多くの場合ごく小さい。
まとめ:使ってみて、いちばん変わったのは「止まらなくなった」こと
日本から海外 AI API を使うとき、コードを書く部分はいちばん簡単だ。難しいのはそのあとにある。
支払い:ドル建て・海外事務手数料・適格請求書なし、で止まる
→ 円建てプリペイド+適格請求書のプロキシに変えて、支払いと請求の摩擦が減った
レイテンシ:東京→米国リージョンの物理距離が、毎回の TTFB に乗る
→ 同じ東京のマシンで測って TTFB p50 が 211 ms → 52 ms。ストリーミングの「最初の沈黙」が減った
運用:モデルを増やすたびに鍵・請求・障害対応が分散する
→ 1エンドポイント・1キーに集約できる
AIプロキシ / AI APIプロキシ は、魔法ではない。ただ、「動くコード」を「チームで使えるコード」に変えるための、実務的なショートカットにはなる。自分で使ってみて、いちばん実感したのは「技術的な性能向上」よりも「止まらないこと」だった。
まずは検証用の小さなプロジェクトで、base_url を1行差し替えるところから試してみるのがいいと思う。