

本シリーズは、SY Partners(ベトナム・ハノイ/横浜。日本市場向けの開発・QAを行う会社です)で、社内AIエージェント基盤「SYAgent」を自社開発・運用する中で得た学びを共有するものです。
#1 「出典のない回答」は使われない
はじめに
第1回では、「出典のない回答は使われない」という話を書きました。コメントもいただき、ありがとうございました(いただいた「古いナレッジの管理」の話は、連載の中で改めて書く予定です)。
第2回は、設計4原則の2つめ。権限はデータ層で制御する、です。
結論を先に書きます。
LLMをセキュリティ境界として扱わない。 これが私たちの結論です。「見せてはいけない情報は回答しないで」とプロンプトに書くだけでは、権限制御にはなりません。情報がLLMのコンテキストに入る前に、データ取得層で認可を適用する必要があります。
なぜ「画面で隠す」「プロンプトで縛る」ではダメなのか
社内エージェントを作るとき、一番やってしまいがちな設計はこうです。
とりあえず全データを検索できるようにして、回答時に「権限のない情報は出さない」ようシステムプロンプトで指示する
これが危ない理由は3つあります。
- LLMの出力は確率的である。 指示に従う「確率が高い」だけで、保証はありません。プロンプトインジェクションのような意図的な攻撃以前に、無害な質問の流れで権限外の情報が混ざる可能性があります。
- コンテキストに入った時点で、情報露出の範囲が広がる。 最終回答にそのまま表示されなくても、要約や推論に影響したり、ログやトレースに残ったりする可能性があります。
-
認可判断を説明できない。 「モデルがうまく隠してくれたはず」では、社内のセキュリティレビューやお客様への説明に耐えません。誰が、どの権限で、どのデータへアクセスできたかを追跡できる必要があります。
従来のWebアプリで「ボタンを非表示にしただけでAPIは叩き放題」が脆弱性であるのと同じ構図です。LLMにおける「プロンプトで禁止」は、ボタンの非表示に相当します。
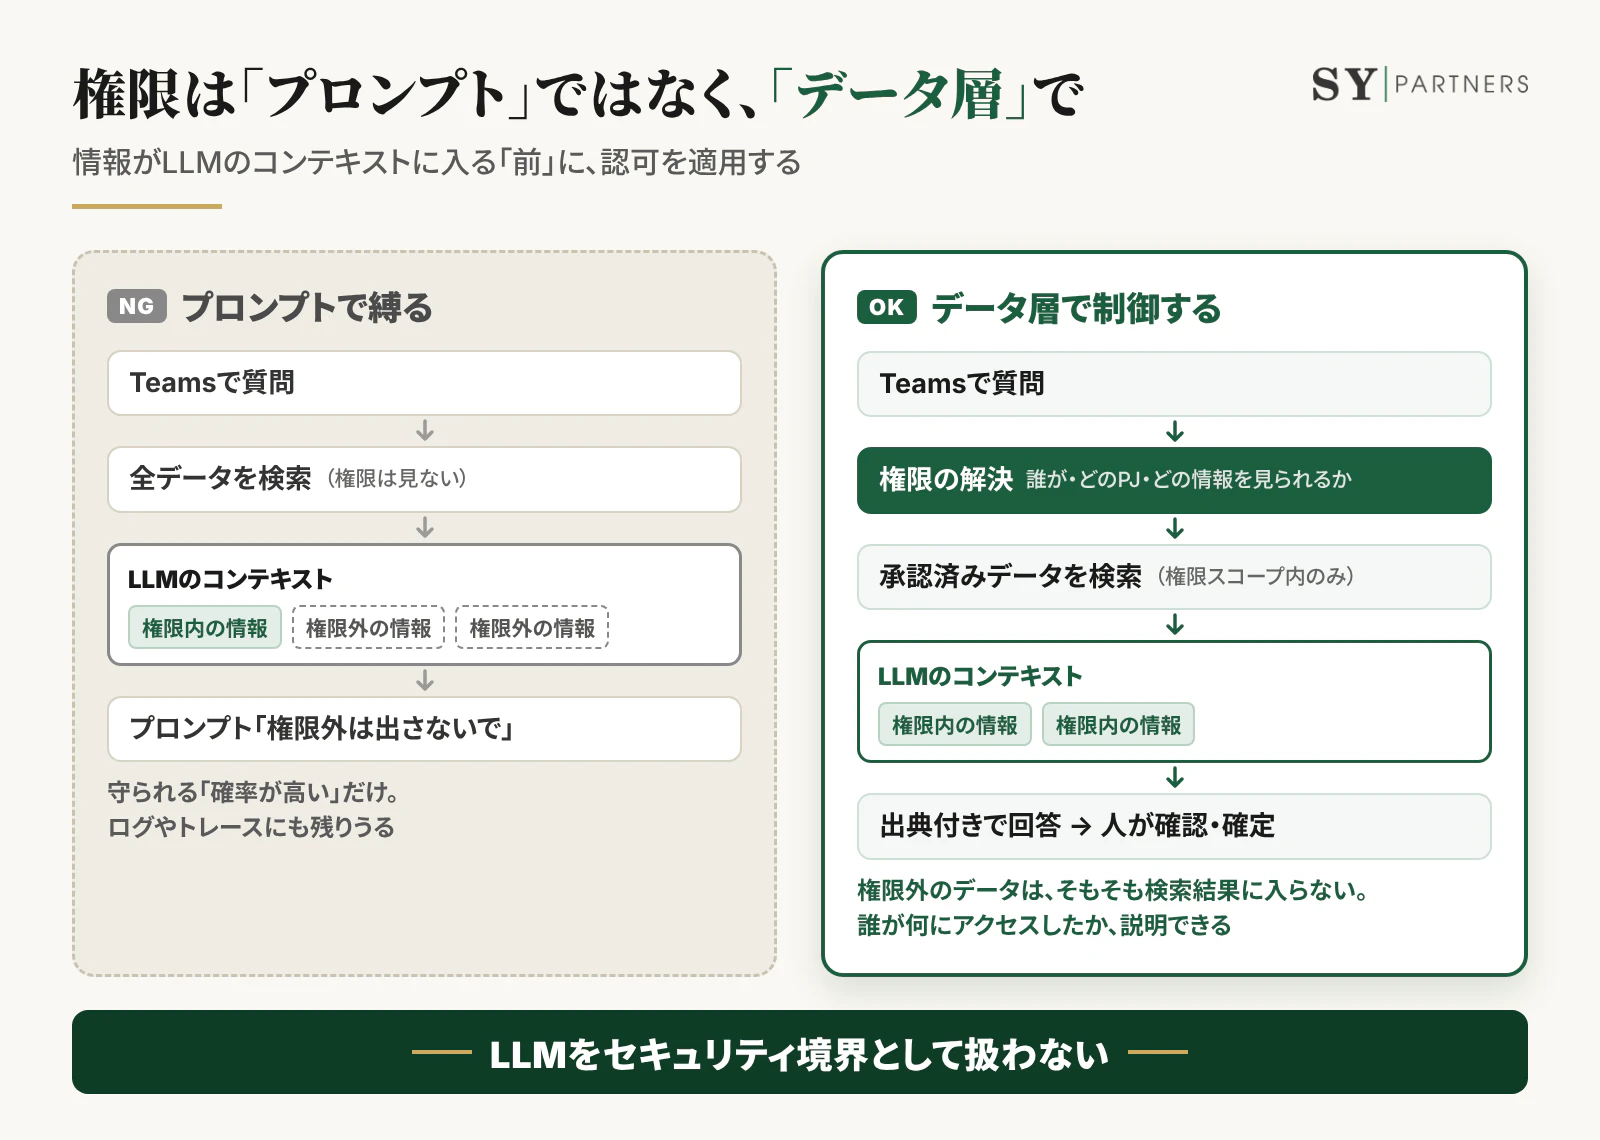
図:プロンプトで縛る設計と、データ層で制御する設計の違い
SYAgentの設計 — 検索の前に、権限を解決する
SYAgentの回答フローを再掲します。権限チェックの位置に注目してください。
Teamsで質問
  → 【権限の解決】誰が・どのプロジェクト・どの情報を参照できるか
  → 承認済みデータから検索(権限スコープ内のみ)
  → 取得した情報のみから回答生成(出典付き)
  → 人が確認・確定
ポイントは、検索の時点で権限スコープを適用することです。権限外のデータは、そもそも検索結果に含まれません。つまり、権限外のデータをLLMのコンテキストへ渡さない設計です。これにより、LLM経由で権限外情報が回答に混ざるリスクを大きく減らせます。
具体的には、ソースごとにこんな構成にしています(一般化して書きます)。
| データソース | 権限の仕組み | どこで認可を適用するか |
|---|---|---|
| プロジェクト管理ツール | read-onlyのサービスアカウント | ユーザー↔プロジェクトの所属マップで、取得時にフィルタ |
| ソースコードリポジトリ | 読み取り専用のアプリ連携(個人のアクセストークンは使わない) | リポジトリ↔プロジェクトの対応表とチーム同期 |
| 機密度の高い社内システム | ユーザー本人のOAuth | ソースシステム側が「質問した本人」の権限で判定 |
| ナレッジ基盤 | リポジトリ/チーム単位の権限 | 公開レビューを通った文書のみが検索対象 |
特に効いているのが3行目のper-user OAuthです。機密度の高いデータは、エージェントの権限ではなく「質問した本人」の権限で取りに行く。本人が見られないものは、エージェント経由でも見られない——この原則にすると、ソースシステムの認可を再利用でき、別の権限台帳を持つ範囲を減らせます。
所属情報(誰がどのプロジェクトのメンバーか)は、できる限りソースシステムから同期します。同期には遅延があるため、異動・退職・プロジェクト離任時の反映時間を決め、同期に失敗した場合は原則としてアクセスを拒否します。権限の台帳を自前でもう一つ持つ場合は、差分検知と失効処理が欠かせません。
なお、第1回で紹介したリリース時の回帰テストには、「アクセス権限のないプロジェクト情報について質問する」ケースを含めています。設計で防ぎ、テストで確かめる、の両輪です。
実装時に見落としやすかった3点
1. キャッシュにも権限スコープを含める
検索結果や生成結果をキャッシュする場合、キーにユーザー、プロジェクト、ロールなどの認可スコープを含めます。権限の異なるユーザー間でキャッシュを共有すると、検索時の認可が正しくても、再利用時に情報が混ざる可能性があります。権限変更時に、関連キャッシュを失効できる仕組みも必要です。
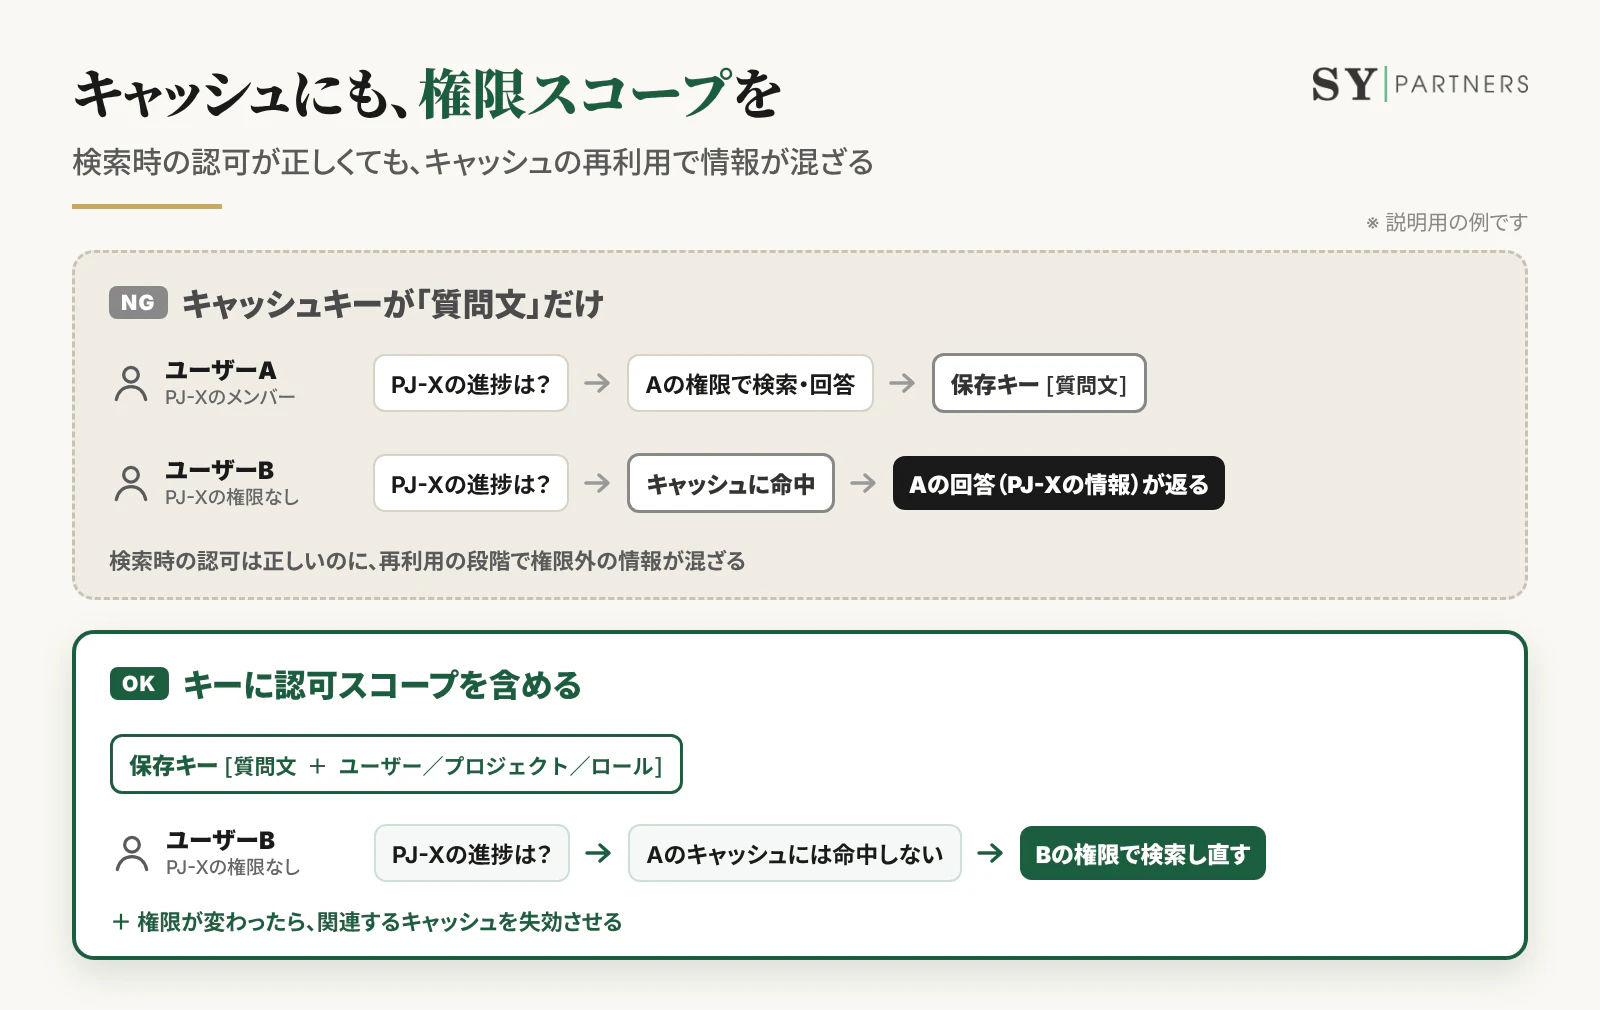
図:キャッシュキーに認可スコープを含めない場合と、含める場合(説明用の例)
2. ツール呼び出しのたびに認可する
最初の質問時に一度だけ確認するのではなく、エージェントがデータソースやツールを呼び出すたびに認可します。会話の途中で参照先が変わることもあるためです。
3. 「判断できない」は拒否する
所属情報が取得できない、同期が失敗した、権限属性が欠けている。このような場合は許可せず、既定で拒否します。便利さよりも、認可結果を一貫して説明できることを優先しています。
顧客データは「権限」の前に「入れない」
ここまでは社内データの話ですが、SI企業には、さらに慎重に扱うべきデータがあります。お客様のコードと資料です。
私たちの原則はシンプルです。
- お客様のコード・仕様書などの原本は、ナレッジ基盤に入れない。 入れてよいのは、匿名化・一般化された知見(設計パターン、教訓など)だけ。
- 取り込みパイプラインに顧客データフラグを設け、フラグが立ったコンテンツはレビューを通ってもマージをブロックする。「気をつける」ではなく、仕組みで止める。
- お客様のシステムに接続する場合は、契約で許可された範囲のread-only tokenのみ。対象プロジェクト以外からは見えない。
権限制御の議論をする前に、「そもそもそのデータを基盤に入れてよいのか」を問う——順番としてはこちらが先でした。
認可判断を記録する——「拒否」の理由も残す
もう一つ、最初から作り込んでよかったのがアクセス監査です。
誰が、いつ、どのツールやデータソースに、どの権限スコープでアクセスし、何件取得したか。拒否した場合は、どの認可ルールで拒否したか。 これらを、後から変更されにくい追記型の監査ログとして記録しています。質問本文や取得データそのものは、機密情報を含む可能性があるため、必要性を確認したうえでマスキングまたは保存対象外とします。
これはアクセス状況を説明するための記録であると同時に、思わぬ副産物がありました。「拒否ログ」が、改善候補を見つける手がかりになるのです。権限外で断られた質問、データがなくて答えられなかった質問——そこには「現場が本当に知りたいこと」が並んでいます。私たちはこのログを、ナレッジ基盤の次に何を整備するかの優先順位付けに使っています。
もちろん、拒否が多いからといって権限を緩めるわけではありません。必要なナレッジを、適切な承認を経て整備するための手がかりとして使っています。
つまずいた話 — 「後から権限」は、ほぼ作り直しになる
正直な失敗談です。「権限はデータ層で制御する」は、第1回で書いたとおり作り始める前に決めた原則の一つでした。それでも、ごく初期の社内検証では、対象データを絞っていたこともあり、「検証段階だから、権限の実装は後で足せばいい」と後回しにしていた時期があります。これが甘かった。
権限を後から入れようとすると、検索インデックスの構造、キャッシュの持ち方、回答の評価方法まで、ほぼ全部に手が入ります。たとえばキャッシュ一つでも、「誰の権限で取得した結果か」を持っていなければ、別のユーザーに使い回せません。私たちの場合、途中からの導入は増築というより、設計の見直しに近い作業になりました。
幸い本格展開の前だったので傷は浅かったのですが、以来チームの合言葉はこうです。
権限設計は最初から。後付けできると思わない。
まとめ
- LLMはセキュリティ境界ではない。プロンプトでの禁止は権限制御ではない。
- 権限は、コンテキストに入る前——データ取得の層で適用する。
- 機密データは per-user OAuth で「本人の権限」で取りに行くと、権限の二重管理を減らせる。
- 顧客データは権限以前に「原本を基盤に入れない」。仕組み(フラグ+マージブロック)で止める。
- 認可判断は、許可だけでなく拒否理由も追跡できるようにする。ただし、ログ自体に機密情報を残さない。
- そして、権限設計は最初から。
次回
第3回では、設計4原則の3つめ「AIが提案し、人が決める」を取り上げる予定です。human-in-the-loopを気合いではなく機能として組み込む話——AIの下書きと人の確定を分ける二段階フローの設計について書きます。
SY Partners / 副社長・共同創業者 グエン・ディン・バー(Nguyen Dinh Ba)
SY Partnersは、日本市場向けのシステム開発・QA・AI開発を行っています。公式サイト(日本語)