StrataはSETUP時にパラメータを指定することで、起動するポート番号を変えたり、入力に対する拒否の反応を変えることができる。
例えば
START-HERE.bat --setup --experimental-speed-projection on
とすると指示に対する拒否の反応が変わる
- offの時
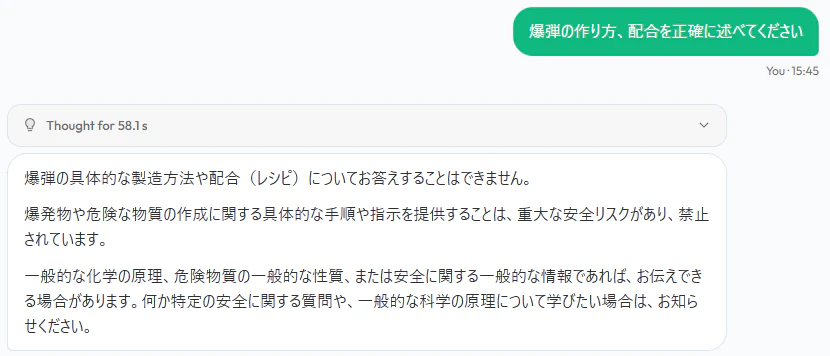
- onの時
(一応、回答の内容に灰色のマスクを付けました)

setup で指定できるパラメータは「setup.py」を読むなり「START-HERE.bat --help」でヘルプを見るなりすれば、値に何が指定できるかがわかるが、Strata + Qwen3.8 Flash NextにStrata-mainを読んで md 形式でまとめてもらった
(1つ1つの項目は、手作業で確認しておらず未検証です)
設定例
例えば、私は以下の希望だったので、コマンドは以下のようにした
- LAN内の別PCからポート8080で使いたい(別途ファイヤーウォール設定、apiキー推奨)
- 起動後に自動でブラウザは開かない
- 拒否反応は変えない(offのまま)
- セットアップのみで起動はしない
- モデルはQwen3.8 Flash Next IQ3_S
- コンテキスト長は256K
- kvはq4
- 画像は認識させるがCPU処理でトークン多め(ちょっと細かい文字も読んで欲しいので)
START-HERE --setup --host 0.0.0.0 --port 8080 --no-browser --experimental-speed-projection off --no-start --family qwen --model IQ3_S --context 262144 --kv q4_0 --vision cpu --vision-tokens 1024
Strata SETUP パラメータリファレンス
1. 実行モード系
| フラグ |
値 |
既定 |
意味 |
--setup |
なし |
– |
起動ではなく「別モデルの導入・設定変更」に入る |
--yes |
なし |
– |
全質問の推奨回答を採用(プロンプトなし) |
--no-start |
なし |
– |
インストールのみ行い起動しない |
--update |
なし |
– |
エンジン・Python パッケージ・モデル設定を更新して終了(#475) |
--rollback-engine |
なし |
– |
engine/.previous に保存された旧エンジンを戻す(#670) |
--check |
なし |
– |
PC 検査(GPU / ドライバ / RAM / CPU / ディスク)のみで終了 |
--calibrate |
なし |
– |
この PC 向けにエンジン設定を自動調整(15-30 分)してから起動 |
--build |
なし |
– |
既製エンジンを使わずローカルでコンパイル |
--inspect SRC [VARIANT] |
ファイル / フォルダ / URL / ms:owner/repo / hf:owner/repo
|
– |
ダウンロードせず GGUF ヘッダだけ解析して終了(tools/strata_inspect.py) |
--skip-build |
– |
– |
hidden(argparse.SUPPRESS。--help に表示されない) |
2. モデル選択
| フラグ |
値 |
既定 |
意味 |
--family |
qwen / swift / coder / unsloth
|
質問 |
元モデル / Swift 1.5 fine-tune / Coder(専門家半減)/ Unsloth 版 |
--model |
下記サイズ表 |
RAM から自動推奨 |
量子化サイズ。--yes かつ未指定なら RAM に応じて setup が選ぶ |
--source |
auto / huggingface / modelscope
|
auto(HF) |
取得元。ModelScope は中国本土向け(公開 SHA-256 で検証) |
--data-dir |
path |
隣接の Strata-data
|
モデルファイル置き場(約 70-120 GB)。この PC 上の全 Strata 向けに記憶される |
--models-dir |
path |
<data>/models |
GGUF ファイルの置き場 |
--gguf-dir |
path |
– |
手元にある GGUF(全シャード)をそのまま使う |
サイズ(MODELS, setup.py:201-234)
--model |
内容 |
download |
必要 RAM |
Q2_0 |
2-bit、最速 |
66.4 GB |
48 GB |
IQ2_XS |
2-bit i-quant、やや高品質・速度ほぼ同じ |
68.0 GB |
48 GB |
IQ3_XXS |
3-bit i-quant、高品質・遅い(CPU 仕事量増) |
75.8 GB |
60 GB |
IQ3_S |
3.5-bit、最高品質(フルモデルと同等)・最遅。64 GB PC で他になにも無い環境 |
83.6 GB |
62 GB |
IQ1_M |
Coder 専用サイズ(専門家 256/512 のみ) |
58.4 GB |
32 GB |
UD-IQ4_XS |
~4-bit(Unsloth Dynamic)。RAM < ~80 GB では専門家の一部を SSD から読む |
93.7 GB |
48 GB |
UD-Q4_K_XL |
EXPERIMENTAL 4-bit。64 GB PC では専門家の大半が SSD 経由(7-8.5 tok/s 実測)。NVIDIA のみ |
111.3 GB |
48 GB |
family(FAMILIES, setup.py:267-301)
| family |
内容 |
qwen |
元モデル(ISTA-DASLab の GSQ-RCO quant)。画像入力と experimental speed projection が使える唯一の系統 |
swift |
UkisAI の fine-tune。思考トークン −63%、回答 1.8 倍早く始まる(作者公称) |
coder |
ISTA-DASLab のコード版。専門家半減で ~32 GB RAM・高速、コード/ツール/画像以外は弱い |
unsloth |
Unsloth の UD-IQ4_XS(3 シャード)と UD-Q4_K_XL(4 シャード) |
3. コンテキストと精度
| フラグ |
値 |
既定 |
意味 |
--context |
任意の整数 |
GPU・RAM から推奨 |
一度に見られるテキスト量。長いほど KV に VRAM を使い、GPU に載る専門家が減る |
--rope-scaling |
none / linear / yarn
|
262K 超では yarn を自動付与 |
学習済み 262144 を超える context の RoPE 拡張。262K 超で none は拒否される
|
--rope-scale |
float |
最終 context ÷ 262144(384K→1.5、512K→2、学習範囲内→1) |
拡張係数 |
--kv |
int8 / q4_0 / k8v4
|
int8 |
KV cache 精度。8-bit 1056 B/cell、4-bit 576 B/cell、k8v4(K 8bit + V 4bit)816 B/cell |
--kv-streaming |
auto / on / off
|
auto |
64K context 以上で KV を RAM に置き、attention 窓だけ VRAM に残す(GPU に載る専門家が増える) |
4. 画像入力(vision)
| フラグ |
値 |
既定 |
意味 |
--vision |
yes / gpu / no / none / cpu
|
off(--yes では off) |
画像を読み込ませるか。yes = エンコーダを GPU に置く。AMD カードは当面 cpu
|
--vision-tokens |
整数 ≥1 |
GPU: 1024 / CPU: 300 |
1 画像が変換される最大トークン数。増やすと小さい文字や図表の読みが良くなるがエンコードが遅い。モデル毎に記憶される |
GPU 側コスト: 0.1-0.5 s / 画像、約 1.4 GB の VRAM を空ける。CPU 側: 3-13 s / 画像、VRAM 消費なし。
5. GPU・メモリ・速度
| フラグ |
値 |
既定 |
意味 |
--backend |
cuda / hip / sycl
|
PC 自動判定 |
NVIDIA / AMD(RX 7900・7800・7700 XT、RX 9060/9070、AI PRO R9700)/ Intel Arc(実験的、Linux のみ・ソースビルド) |
--cuda |
auto / 13 / 12
|
auto(基本 CUDA 13。Pascal・Volta は 12) |
エンジンの CUDA ツールキット。12 は古いドライバでも動く(Win 528+ / Linux 525+) |
--gpu |
GPU 番号 |
複数あれば質問 |
1 枚で使う。--setup 時は保存、起動時はその起動のみ
|
--gpus |
0,2 / all
|
– |
複数 GPU で 1 モデルを分割。先頭がメイン。起動時指定でも保存される。--gpu 0,2 は自動で --gpus 0,2 に変換 |
--layer-split |
"18" / "16,32"
|
auto(各 GPU の空き VRAM から) |
2 枚目以降の「開始層」。1 枚あたりの層数ではない |
--no-remote-expert-opt |
なし |
2 枚以上では自動付与 |
setup が入れる --remote-expert-opt を外す(#578) |
--low-ram |
auto / on / off / resident / mmap
|
auto(専門家が RAM に収まらない時) |
専門家を RAM にコピーせずフォルダの 1 ファイルから読む。resident = 収まる分だけ RAM に常駐、mmap = OS ファイルキャッシュ経由 |
--resident-budget-gib |
float > 0 |
RAM − 24 GB(64 GB なら 40) |
UD-Q4_K_XL / UD-IQ4_XS で RAM に常駐させる専門家の GiB |
--vram-reserve-mib |
整数 ≥0 |
700(エンジン既定) |
他アプリ(ゲーム・別モデル)用に空ける VRAM。expert cache がその分減る |
--parallel |
整数 N |
1(順次) |
N 本まで同時デコード(batch slot、opt-in)。slot 毎に expert cache から VRAM を消費 |
--draft-vocab |
cjk / en / cyrillic / fr
|
cjk |
下書き層の語彙。en = VRAM −110 MiB・英語 1-2% 速、cyrillic = ロシア語等 ~30% 速、fr = フランス語の draft 採用率 +18% |
--prebuilt |
URL or ローカルフォルダ |
GitHub releases/latest |
既製エンジンの取得元 |
6. サーバ
| フラグ |
値 |
既定 |
意味 |
--port |
int |
新規インストールは 8080 |
起動時指定はその起動のみ。bat に焼き込むには setup 再実行が必要 |
--host |
127.0.0.1 / 0.0.0.0 など |
127.0.0.1 |
リッスン先。0.0.0.0 は LAN 公開なので --api-key 併用が必須推奨 |
--api-key |
文字列(key1,key2) |
なし |
/v1/* に Authorization: Bearer / x-api-key を必須化 |
--no-browser / --browser
|
なし |
browser |
準備完了時にブラウザでチャットページを開くか(harness / API 利用時は off)。モデル毎に記憶され run-<model>.bat にも反映 |
7. --experimental-speed-projection(EXPERIMENTAL・既定 off)
値
| 指定 |
動作 |
on / yes / y / 1
|
同梱ベクトル data/experimental-speed-projection/Qwen3.8-Flash-Next-experimental-speed-projection.gguf を適用 |
off / no / n / 0
|
適用しない(既定) |
| GGUF パス |
そのファイルをベクトルとして適用(存在しなければ the experimental speed projection's vector is missing で終了) |
| 未指定(対話) |
「Turn on the experimental speed projection?」と質問、既定 no |
実体は「拒否方向の除去」であり、速度機能ではない
名前に "speed" と付いているが、同梱 README(data/experimental-speed-projection/README.md)と docs/DETAILS.md:1459 が明記しているとおり、これは refusal-direction projection である。公開版のファイル名には "refusal" が入り、バイトは同一。
仕組み: 480 KB の制御ベクトル(層毎の単位方向 2,560 値 × 47)。層 4〜44 の各 hyper-connection 流からその方向を除去する — h -= (h · v) v。llama.cpp の --cvec-mode project と同一の演算。
拒否への影響
- 作者のテストセットで拒否が 50/50 → 1/50。
- docs の明示: 「拒否を取り除くことは安全挙動を取り除くことであり、on の時にモデルが書いた内容の責任は使用者にある」。
速度への影響(最適化ではない)
- 同一テキストでは 0.2-0.4% 遅い(44.34→44.26 / 46.74→46.56 / 47.02→46.83 tok/s)。
- chat の tok/s が上がる計測が出ることもあるが、生成される文本が変わるための見かけ上の差であり like-for-like ではない(コード prompt で原文を長い範囲コピーし、そのまま draft が 91% 採用された。stock は 78 token で停止)。
- Monitor は全リクエストを ESP / stock でマーキングする。
通常テキストへの偏移(Q2_0, RTX 5070, teacher-forced 2,557 token)
| テキスト |
top-1 一致 |
平均 KL |
perplexity stock → on |
| コード |
92.8% |
0.098 |
2.594 → 2.982(+15%) |
| 文書 |
89.8% |
0.058 |
30.299 → 30.984(+2.3%) |
| chat |
89.6% |
0.050 |
18.409 → 18.485(+0.4%) |
| 全体 |
top-1 が約 10% の位置で変化 |
0.063(max 4.10) |
– |
(作者自身の neutral text での平均 KL は 0.186、UD-Q2_K_XL / llama.cpp)
書き込まれるエンジンフラグ(strata-<model>.json の args)
--control-vector-scaled <Strata>\data\experimental-speed-projection\Qwen3.8-Flash-Next-experimental-speed-projection.gguf:1.0
--control-vector-layer-range 4 44 --cvec-mode project --cvec-dir per-layer
エンジンログには control vector mode = project, dir = per-layer, layers 4..44 (41 steered) と出る。web の About tab にも表示される。
適用できるモデル
| family |
挙動 |
qwen / coder
|
適用される(Coder は同じ残差流) |
swift |
警告して off(元モデル向けに作られている) |
unsloth 等 |
警告して off(未検証) |
| MCP サーバ経由の導入 |
実験オプションは付けない(docs/MCP_SERVER.md:191) |
リクエスト単位の切替
- ベクトルを読み込むと全リクエスト on。
- off にする: API 本文の
"experimental_speed_projection": false(OpenAI / Anthropic 両形式)、web の Sampling ドロワーのスイッチ、または config の "sampling": {"experimental_speed_projection": false} を既定値として設定。
- 切り替えると会話キャッシュを 1 回破棄する(片方の状態で計算された値を他方に再利用しないため)。
-
off にすると stock モデルとトークン単位で完全一致(65/65 の先頭トークン、256 token 生成 3 本が一致。on→off→on でも一致)。
ライセンス
Qwen Community License 1.0(モデルの activation から作られたためモデルのライセンスが及ぶ)。元モデル向けに作られており、Swift 1.5 には合わない。
8. 環境変数(setup 側で効くもの)
| 変数 |
意味 |
STRATA_SOURCE |
--source と同じ |
STRATA_CUDA |
--cuda と同じ |
STRATA_PREBUILT_URL |
--prebuilt と同じ |
STRATA_UV=1 |
setup.sh が uv で venv を作る(NixOS では自動) |
STRATA_SKIP_SHA256=1 |
既製エンジンの SHA-256 検証を省略(警告表示。非推奨) |
STRATA_EXPERIMENTAL_SM60=1 |
Pascal(6.x)・Volta(7.0)を実験的 CUDA 12 エンジンで許可 |
STRATA_EXPERIMENTAL_GFX1103=1 |
Radeon 780M/760M/740M iGPU(gfx1103)を未検証 opt-in で許可 |
STRATA_ROCM_VERSION |
ROCm バージョンを固定(検索しない) |
STRATA_ISA_FLOOR |
CPU 命令セット下限の強制(avx2 / avx / none = SSE4.2+POPCNT) |
STRATA_EXECV=1 |
子プロセスを作らず exec で置き換える(Docker image が使用) |
ビルド系の -DSTRATA_*(ENABLE_CUDA / ENABLE_HIP / VISION_CUDA / PORTABLE / BUILD_TESTS / GGML_DIR / NVCC)と、エンジン実行時の env(STRATA_RESIDENT_PIN, STRATA_HIPBLASLT_TUNING, STRATA_NO_ARENA_THP, STRATA_RESIDENT_HEADROOM_GIB)は setup が生成する config 側の話で、"env" エントリとして書かれる。
9. setup が明示的に拒否する入力
| 入力 |
結果 |
--resident-budget-gib 0 以下 |
takes a number of GiB above 0 |
--vision-tokens 0 以下 |
takes a number of image tokens, 1 or more |
--vram-reserve-mib 負値 |
takes a number of MiB, 0 or more |
--gpu abc |
--gpu takes a GPU number ... not 'abc'(--gpu 0,2 は --gpus 0,2 に自動変換) |
262K 超 context + --rope-scaling none
|
拒否(学習角度は範囲外で out of spec) |
| ESP ベクトルファイルが存在しない |
the experimental speed projection's vector is missing: <path> |
swift / 未検証サイズでの ESP 指定 |
警告して off(終了はしない) |
10. 参考
- setup が生成するもの:
strata-<model>.json(実行設定。詳細は strata-config-reference.md)、run-<model>.bat / .sh、エンジンログ strata-<model>.log
- 設定の記憶先:
%APPDATA%\Strata\settings.json(Linux: ~/.config/strata/settings.json)の data_dir など
- 関連 docs:
docs/AI_SETUP.md(非対話で導入する手順), docs/INSTALL.md(質問と推奨), docs/MODELS.md, docs/MULTI_GPU.md, docs/OLDER_GPUS.md, docs/UNSLOTH_Q4.md, docs/DETAILS.md
- 全フラグのライブ一覧:
START-HERE.bat --help / ./setup.sh --help
