
はじめに
この記事はデータ分析の定石というシリーズの1つになります。シリーズでは実データ分析をいくつかのフェーズに分けてまとめています。今回はそのうちの「探索的データ分析(EDA)」と「データクレンジング」に焦点を当てています。
シリーズ全体の流れはこちらになります。
【実践】カリフォルニア住宅価格予測で学ぶ、データ分析の定石
探索的データ分析とデータクレンジング
現実のデータは、必ずしもきれいに整っているわけではありません。複数のデータセットを共通項目名を起点に結合したり、時間などの情報を揃えたりが必要な場合があります。また、ある数値列に一部文字が入っていたり、特定のデータがごっそり抜け落ちていることだってあります。これらは主にデータベースの仕様や設計に由来するものでしょう。このような形式のデータが混在すると、モデルとしてら異なるデータとしては扱うので、精度に影響します。
また、それ以外でも、ごく一部のデータだけが極端に大きな値(外れ値)を持つこともあります。そしてその要因が、センサーの故障によるものなど分析にとってノイズになる場合があります。これらは主に通常では発生しない稀な環境条件でデータになったことが由来するでしょう。このような稀に発生するデータは統計的に扱うのが難しく、多くの場合モデルの精度を下げる要因になります。
このように、このフェーズでは、データセットを1つに結合する、データの課題を特定し、分析に影響するノイズを取り除く作業を行います。
今回のデータはデータセット1つですので、データ結合より後の作業を進めていきます。
欠測値やデータの型の確認と処理
# データ読み込み
california_housing_data = fetch_california_housing()
rawdata = pd.DataFrame(california_housing_data.data, columns=california_housing_data.feature_names)
rawdata["Price"] = california_housing_data.target
rawdata.head()  # データの先頭5行を表示
# 項目の意味がわかるように日本語にしよう
rawdata.rename(columns={
    "MedInc": "世帯所得",
    "HouseAge": "家の築年数",
    "AveRooms": "部屋の数",
    "AveBedrms": "寝室の数",
    "Population": "居住人数",
    "AveOccup": "世帯人数"
}, inplace=True)

# データの型を確認
display(rawdata.info())
# データの値の範囲
display(rawdata.describe())
実行結果を確認します
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 20640 entries, 0 to 20639
Data columns (total 9 columns):
 #   Column     Non-Null Count  Dtype
---  ------     --------------  -----
 0   世帯所得       20640 non-null  float64
 1   家の築年数      20640 non-null  float64
 2   部屋の数       20640 non-null  float64
 3   寝室の数       20640 non-null  float64
 4   居住人数       20640 non-null  float64
 5   世帯人数       20640 non-null  float64
 6   Latitude   20640 non-null  float64
 7   Longitude  20640 non-null  float64
 8   Price      20640 non-null  float64
dtypes: float64(9)
memory usage: 1.4 MB
世帯所得         家の築年数          部屋の数          寝室の数          居住人数  \
count  20640.000000  20640.000000  20640.000000  20640.000000  20640.000000
mean       3.870671     28.639486      5.429000      1.096675   1425.476744
std        1.899822     12.585558      2.474173      0.473911   1132.462122
min        0.499900      1.000000      0.846154      0.333333      3.000000
25%        2.563400     18.000000      4.440716      1.006079    787.000000
50%        3.534800     29.000000      5.229129      1.048780   1166.000000
75%        4.743250     37.000000      6.052381      1.099526   1725.000000
max       15.000100     52.000000    141.909091     34.066667  35682.000000

               世帯人数      Latitude     Longitude         Price
count  20640.000000  20640.000000  20640.000000  20640.000000
mean       3.070655     35.631861   -119.569704      2.068558
std       10.386050      2.135952      2.003532      1.153956
min        0.692308     32.540000   -124.350000      0.149990
25%        2.429741     33.930000   -121.800000      1.196000
50%        2.818116     34.260000   -118.490000      1.797000
75%        3.282261     37.710000   -118.010000      2.647250
max     1243.333333     41.950000   -114.310000      5.000010
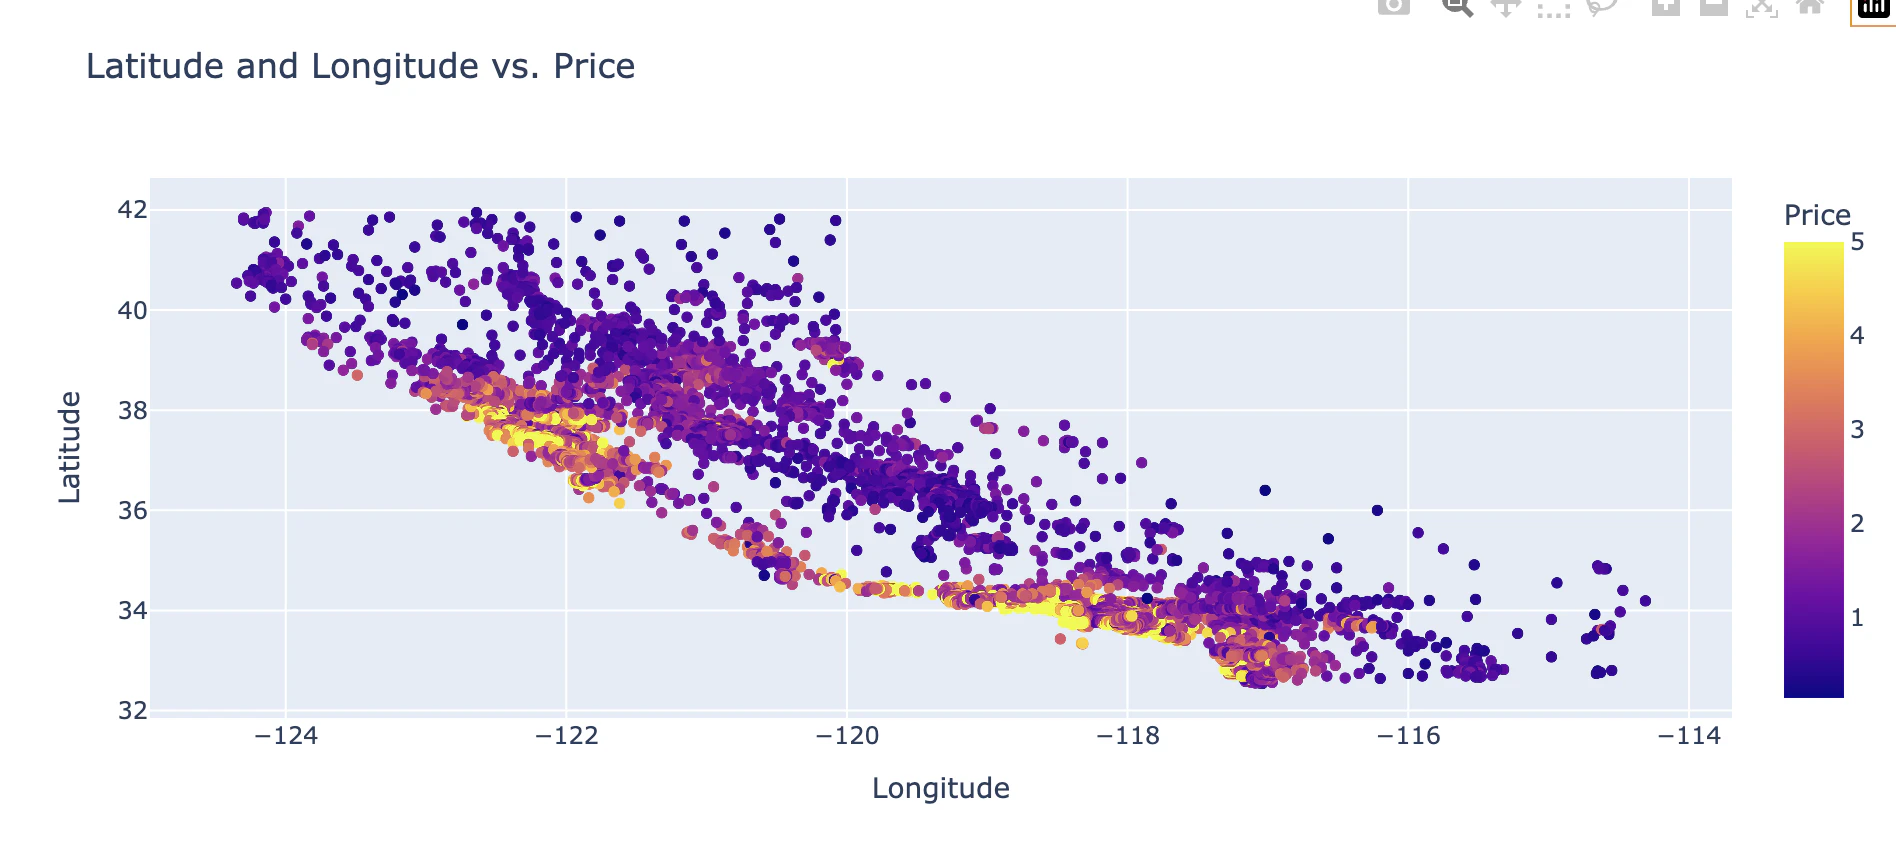
今回は緯度経度情報があるので、地図上の分布が妥当かも確認します
# 場所の可視化(地図データならではの処理)
import plotly.express as px
import pandas as pd

# 散布図の作成(価格で色分け)
fig = px.scatter(
    rawdata,
    x='Longitude',
    y='Latitude',
    color='Price',
    title='Latitude and Longitude vs. Price'
)

# グラフの表示
fig.show()
分析結果の考察
欠損値: データに欠損値は見られませんでした。
データの型:各列の要素のデータの型は一致していました。
データ範囲の考察: 「部屋の数」「寝室の数」「居住人数」「世帯人数」といった項目は、データの75パーセンタイル値から最大値にかけて値が大きく増加しています。ここで、データの概要を振り返りますと、大部分が一戸建ての物件で構成されている集合住宅のようなデータも含まれていると書いておりました。ですので、その影響が現れている可能性があります。
地理的分布: 緯度経度のデータを確認したところ、カリフォルニア州の地理的特徴と一致していました。特に、沿岸部に高価な物件が多く集中している傾向も見られました。
外れ値の確認と処理
「部屋の数」「寝室の数」「居住人数」「世帯人数」の分布から、外れ値を確認します。
ここで外れ値と目的変数である価格の関係も同時に把握するため、価格帯別の分布も観察できるようにします。
# Priceが連続値なので、離散化して可視化しよう。ヒストグラムで分割方法を検討する。
import matplotlib.pyplot as plt
import pandas as pd

bins_pattern = [5, 7, 10, 15, 20, 25]

# 複数のヒストグラムを重ねて表示
plt.figure(figsize=(10, 6))
for bin in bins_pattern:
    plt.hist(rawdata["Price"], bins=bin, alpha=0.5, label=f'{bin} bins')

plt.title('Price Distribution with Different Bin Counts')
plt.xlabel('Price')
plt.ylabel('Frequency')
plt.grid(True)
plt.legend()
plt.show()
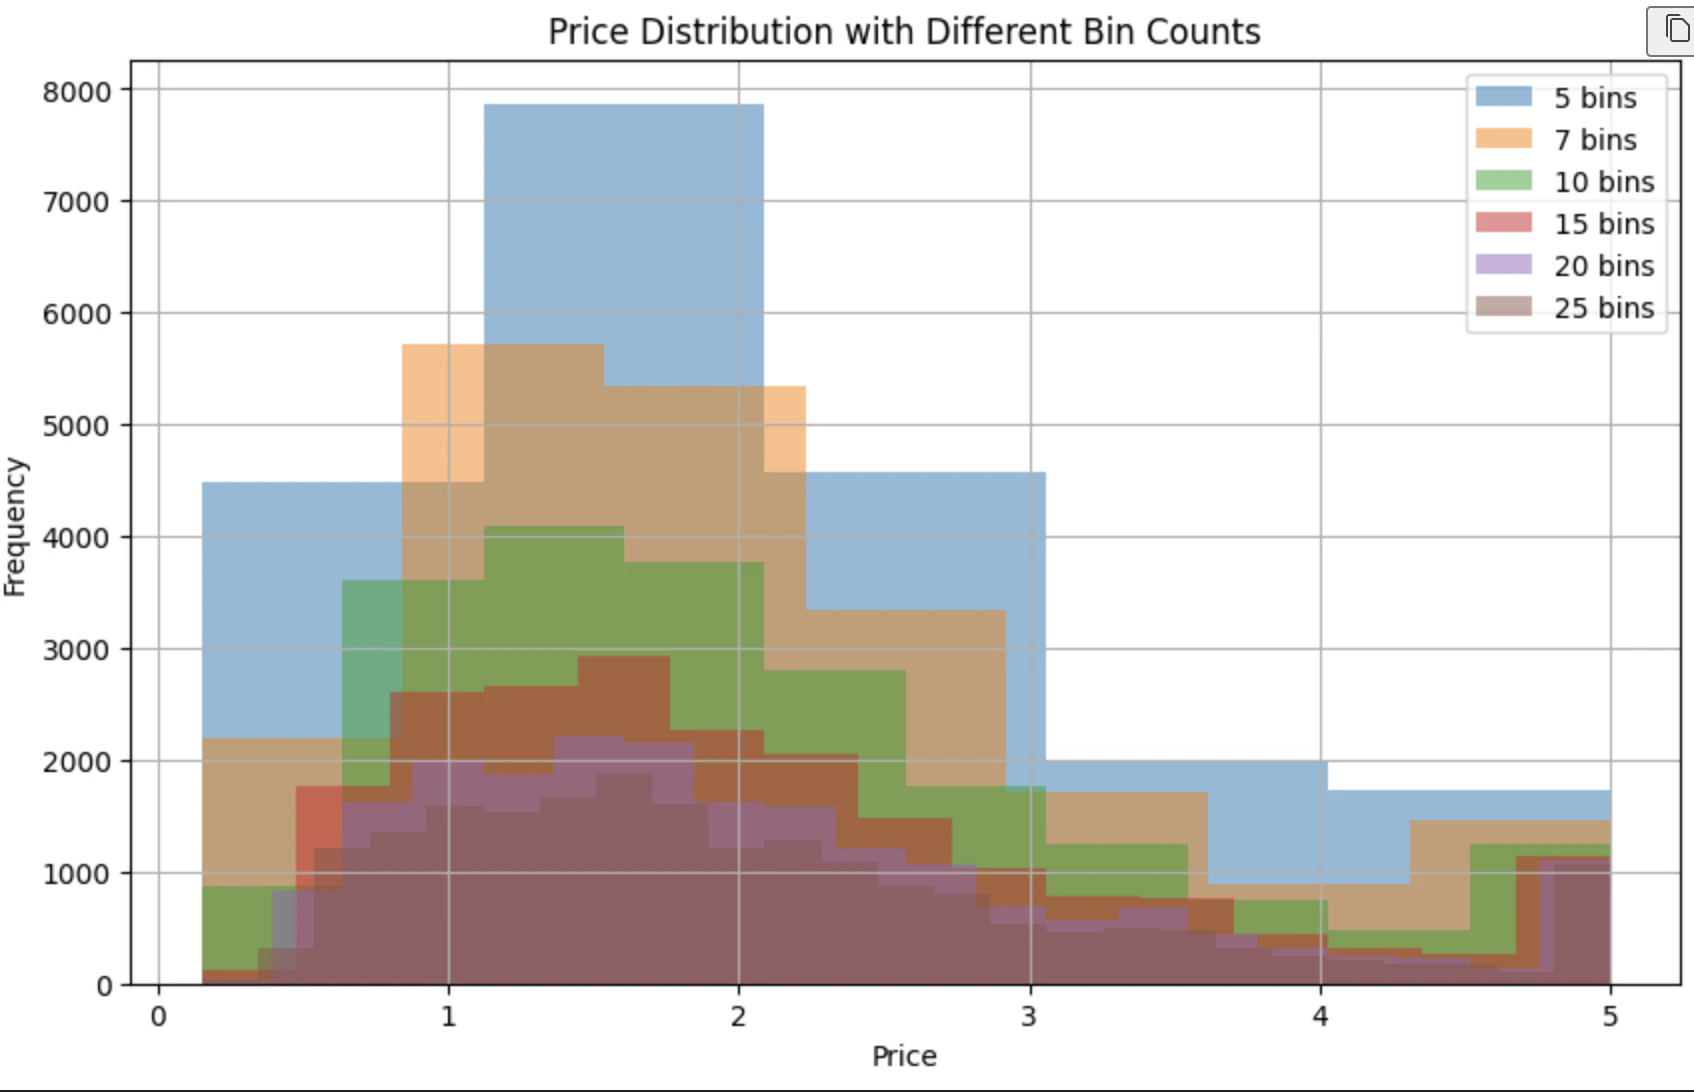
# メモ:7段階で2つの山(二峰性)が見られるため、7段階に分割する。
# Priceが大きいほどランクも大きくなるようにする。
rawdata['Price_rank'] = pd.qcut(rawdata['Price'], q=7, labels=False)
import seaborn as sns
import matplotlib.pyplot as plt

# 日本語表示のためにフォントを設定
plt.rcParams['font.family'] = 'MS Gothic'

# データのコピーを作成
raw_pair = rawdata.copy()

# 各ランクが明確になるように、視認性の高い色を選んでみました。
custom_palette = ['red', 'green', 'blue', 'orange', 'purple', 'brown', 'gray']

# pairplotを作成し、Price_rankで色分け、カスタムパレットを適用
g = sns.pairplot(raw_pair, corner=True, hue='Price_rank', palette='RdYlGn')#palette=custom_palette)


# グラフ全体のサイズを調整
g.fig.set_size_inches(20, 20)

# グラフを表示
plt.show()
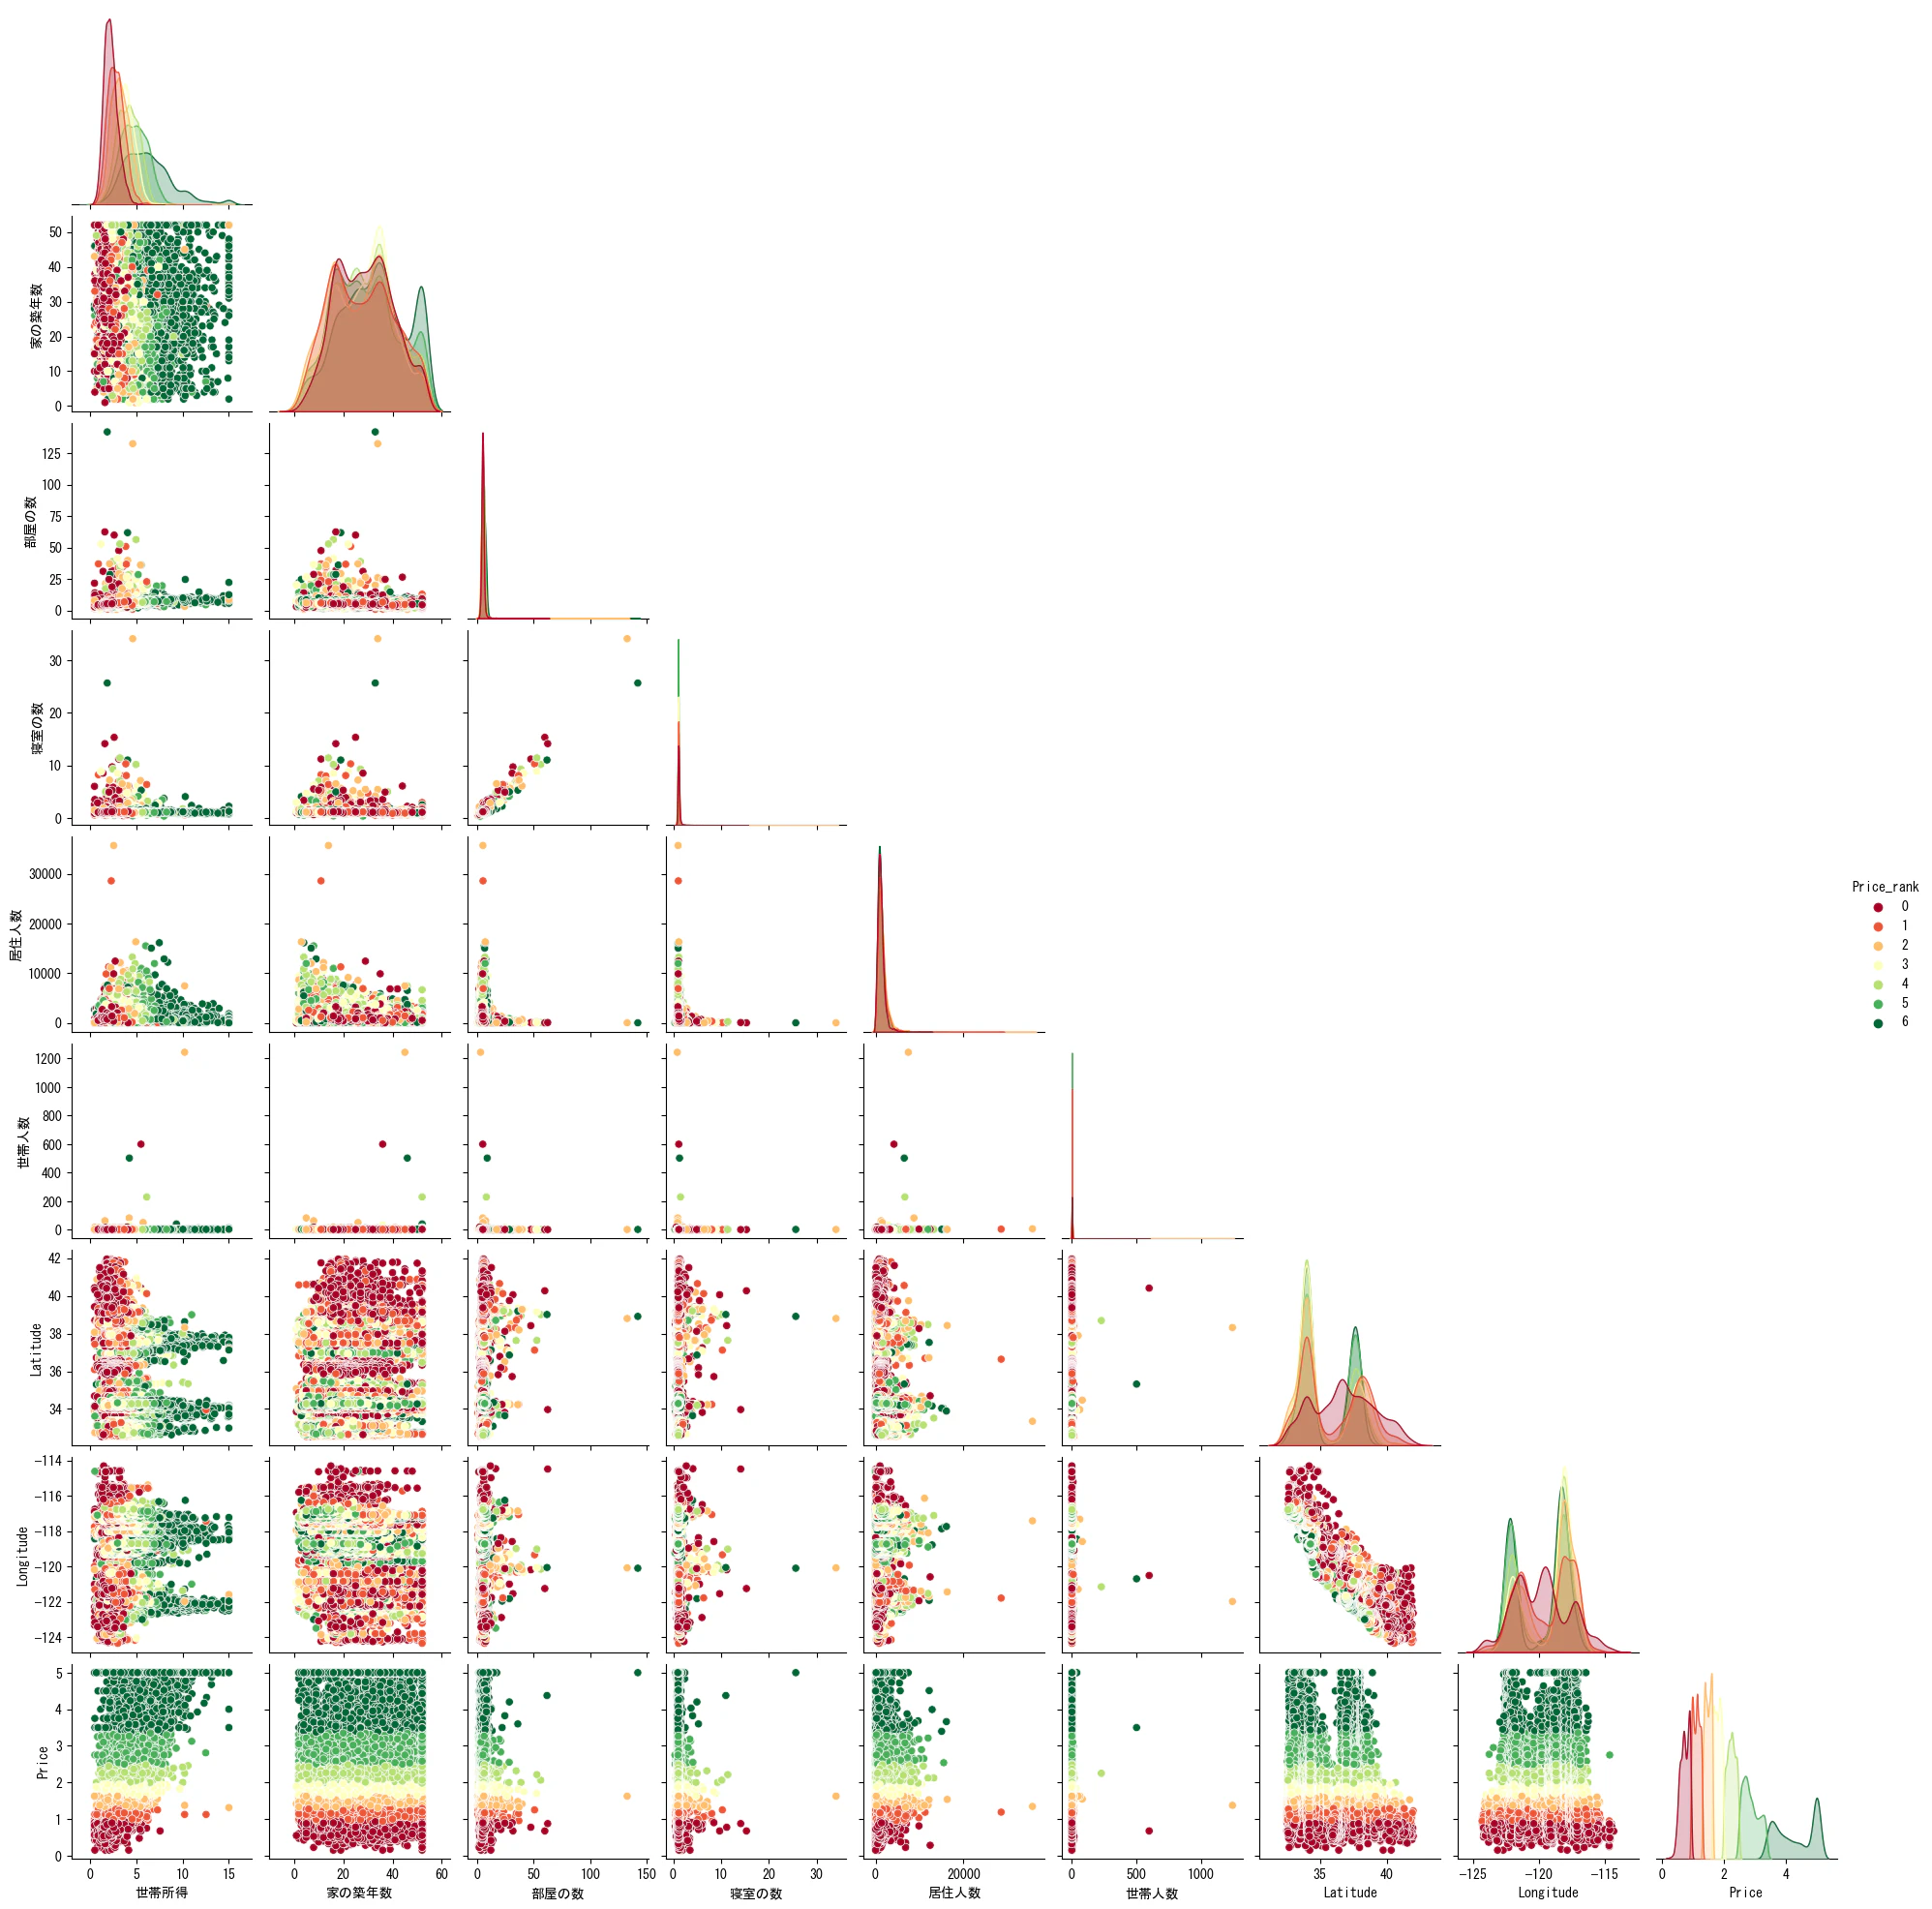
「部屋の数」「寝室の数」「居住人数」「世帯人数」は外れ値の影響か、ヒストグラムの分布が左端に集中しています。
居住人数の外れ値の様子をヒストグラムで観察します。
(説明が冗長になるので、その他の属性情報の観察は割愛します)
import matplotlib.pyplot as plt

def simply_hist(df, bin_num, name, height):
    """
    指定された列のヒストグラムを生成する関数。
    y軸の範囲を調整して、外れ値も確認できるようにする。
    """
    plt.figure(figsize=(8, 5))

    plt.hist(df[name], bins=bin_num, alpha=0.5, label=name)
    plt.title(f'Histogram of {name}')
    plt.xlabel(name)
    plt.ylabel('Frequency')
    plt.grid(True)
    plt.ylim(0, height)
    plt.legend()
    plt.show()

# 代表例として、居住人数のヒストグラムを観察
simply_hist(rawdata, 1000, "居住人数", height=10)
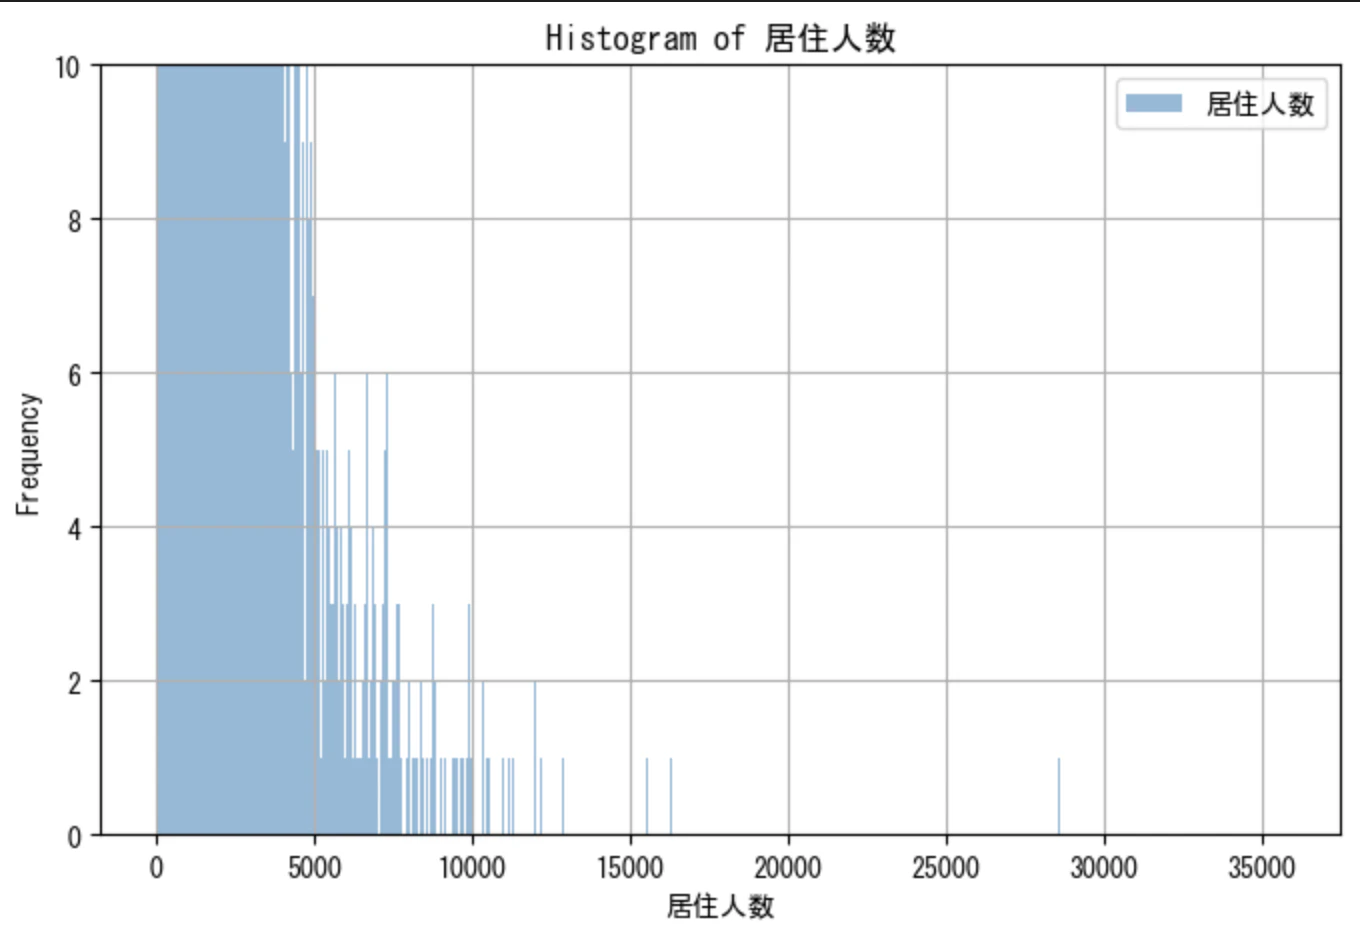
数件の値が飛び飛びになっていることが確認できました。
そこで、飛び値が1%程度と考え、対象列の99パーセンタイルの値を確認してみます。
columns = ["部屋の数", "寝室の数", "居住人数", "世帯人数"]
df = rawdata[columns].copy()

q99 = df.quantile(0.99)
print("各列の99パーセンタイル値:\n", q99)

df_list = []
for col in columns:
    # 99パーセンタイルを超える行を抽出し、リストに追加
    df_list.append(df[df[col] > q99[col]])

# 抽出したデータフレームを結合し、重複行を削除
filtered_df = pd.concat(df_list).drop_duplicates()

# 外れ値と判断された行の数を表示
print("99パーセンタイルを超えるユニークな行数:", len(filtered_df))
各列の99パーセンタイルの値を確認
各列の99パーセンタイル値:
居住人数    5805.830000
Name: 0.99, dtype: float64
99パーセンタイルを超えるユニークな行数: 640
期待どおり先ほどの飛び値が1%の範囲にあることが確認できました。
他の属性情報についても同様に1%程度外れ値があると考え、外れ値を除外したデータでpairplotを観察します。
# 外れ値を除外したデータでpairplotを観察する
g = sns.pairplot(raw_pair.drop(filtered_df.index), corner=True, hue='Price_rank', palette='RdYlGn')

# グラフのサイズを調整
g.fig.set_size_inches(10, 10)

# グラフを表示
plt.show()
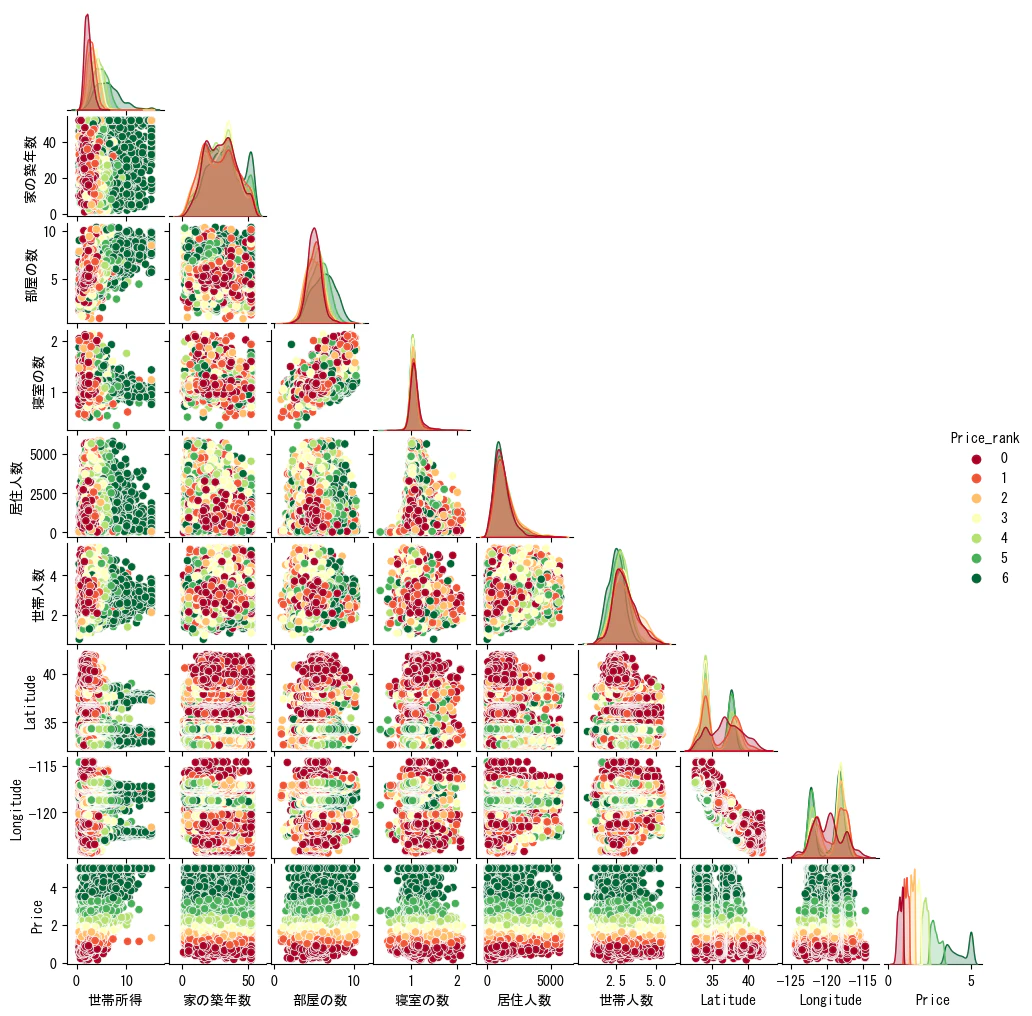
分析結果の考察
外れ値を取り除くことで、データの分布がより明確になることがわかりました。この外れ値は、1世帯あたりの平均居住者数が大きくなることが原因である可能性があります。
集合住宅と一軒家は、同じ環境条件でも価格評価の仕組みが異なります。本来は住居の種類に関する情報も分析に含めるべきですが、今回のデータセットにはその情報が含まれていません。
そこで、分析の目的を「主に一軒家の価格予測」に絞り込むことにします。この目的から考えると、集合住宅のデータは予測のノイズとなり、集合住宅のデータは「外れ値」の特性を持つと見なして分析から除外します。
まとめと次やること
一軒家の価格予測を課題として、集合住宅のような家屋は分析におけるノイズとして、それが1%あるものとしてを削りました。結果、よりはっきりと分布が確認できるようになりました。
緯度と経度の座標を使い、住宅価格別に色分けしてプロットしたところ、地図として正しいことが確認できました。このプロットから、海岸線に近い地域ほど住宅価格が高い物件が集中している傾向が見られました。
次回はこの外れ値を除いたデータに対して、海岸線という情報に着目しつつEDAを実施します。