
はじめに
この記事はデータ分析の定石というシリーズの1つになります。シリーズでは実データ分析をいくつかのフェーズに分けてまとめています。今回はそのうちの「特徴量エンジニアリングによる仮説検証」に焦点を当てています。
シリーズ全体の流れはこちらになります。
【実践】カリフォルニア住宅価格予測で学ぶ、データ分析の定石
特徴量エンジニアリング
特徴量は、目的変数に影響を与える属性のことです。 例えば、目的変数と正の相関関係にある属性は、その値が大きくなるにつれて目的変数の値も大きくなると推測できます。このような属性は、分析において有効な特徴量となり得ます。
一方、目的変数の値に関わらずランダムな値を取るような属性は、目的変数を予測するのに役に立たない、ノイズとなります。
また、属性間の関係性を調べることも重要です。 属性間に強い相関がある場合、一方の属性からもう一方の値を推測できるため、両方の属性を特徴量として使う必要はありません。このような場合は、どちらか一方を特徴量として採用すれば十分でしょう。
結論として、ある属性が有効な特徴量であるかどうかは、目的変数との相関、そして属性間の独立性という観点から判断できます。
このような関係性が既存のデータから明らかになることもありますが、常にそうとは限りません。そこで、特徴量エンジニアリングの出番です。このフェーズでは、有望な特徴量を作成し、モデルに投入する特徴量(選択特徴量)を選びます。
特徴量の作り方は、大きく分けて2つあります。
・既存の属性からの計算により、新たな特徴量を作成する
・ドメイン知識をもとに、データセットに含まれない情報を活用する
大切なのは、闇雲に特徴量を作らないことです。 むやみに作ると、分析が複雑になったり、ノイズが増えたりする可能性があります。EDA(探索的データ分析)で得られた仮説に基づいて特徴量を作成することが重要です。
本記事では、まず、既存の属性からの計算による特徴量を作成し、効果を観察します。その後、ドメイン知識を活用した特徴量を作成し、その効果を観察します。
それでは、分析に入りましょう。
特徴量の作成:既存の属性からの計算
これまでのEDAから、世帯所得が住宅価格に影響を与える主要な要因の一つであると仮説を立てました。そこで、世帯所得を利用して価格との相関がより明確になるような属性の作成し、特徴量として採用するべきか判断します。
data_temp=data.copy()
data_temp["_世帯所得"]=data["世帯所得"]
data_temp["log_世帯所得"]=np.log(data["世帯所得"])
data_temp['rank_世帯所得'] = pd.qcut(data["世帯所得"], q=10, labels=False)
data_temp["一人あたり_世帯所得"]=data["世帯所得"]/data["世帯人数"]
また、ある地点から海岸線までの距離も有望と仮説を立てました。今回は、その距離を海岸線からの直線距離として算出し、特徴量として採用するべきか判断します。
import math
import numpy as np
import pandas as pd

# 関数定義: 2点を通る直線と、ある点からの垂線距離を計算
def perpendicular_distance(point, line_point1, line_point2):
    """
    点と直線の垂線距離を計算する関数
    :param point: 距離を計算する点 (x0, y0)
    :param line_point1: 直線上の1点 (x1, y1)
    :param line_point2: 直線上のもう1点 (x2, y2)
    :return: 垂線距離
    """
    x0, y0 = point
    x1, y1 = line_point1
    x2, y2 = line_point2

    # 直線の係数 A, B, C を計算 (Ax + By + C = 0 の形)
    A = y2 - y1
    B = x1 - x2
    C = x2 * y1 - x1 * y2

    # 距離の公式: |A*x0 + B*y0 + C| / sqrt(A^2 + B^2)
    numerator = abs(A * x0 + B * y0 + C)
    denominator = math.sqrt(A**2 + B**2)

    # 分母が0になる場合(直線が点ではない場合)の処理
    if denominator == 0:
        return 0

    distance = numerator / denominator
    return distance


# 関数定義: データフレームの各点と直線との距離を計算
def cal_distance_line(data, region_lines_edge):
    """
    データフレームの各点と、指定された2点を通る直線との距離を計算する
    :param data: データフレーム
    :param region_lines_edge: 直線を定義する2点の座標のNumpy配列
    :return: 距離のリスト
    """
    line_p1 = tuple(region_lines_edge.T[0])
    line_p2 = tuple(region_lines_edge.T[1])

    distance_set = []
    for point in zip(data['Longitude'], data['Latitude']):
        distance = perpendicular_distance(point, line_p1, line_p2)
        distance_set.append(distance)

    return distance_set

# 各地域の直線からの距離を計算し、新しい列として追加
dist_col_names = ['Northline_dist','Southline_dist']
data_temp[dist_col_names[0]] = cal_distance_line(data_temp, region_north_lines_edge)
data_temp[dist_col_names[1]] = cal_distance_line(data_temp, region_south_lines_edge)

# 3つの直線からの距離のうち、最小値を新しい列 'Coast_dist' に格納
data_temp['Coast_dist'] = data_temp.loc[:, dist_col_names].min(axis=1)

# 中間生成された距離の列を削除
data_temp = data_temp.drop(dist_col_names, axis=1)
作成した属性を含めて散布図グラフを確認します。
# pairplotを作成し、Price_rankで色分け
g = sns.pairplot(data_temp, corner=True, hue='Price_rank', palette='RdYlGn')

# グラフ全体のサイズを調整
g.fig.set_size_inches(18, 18)

# グラフを表示
plt.show()
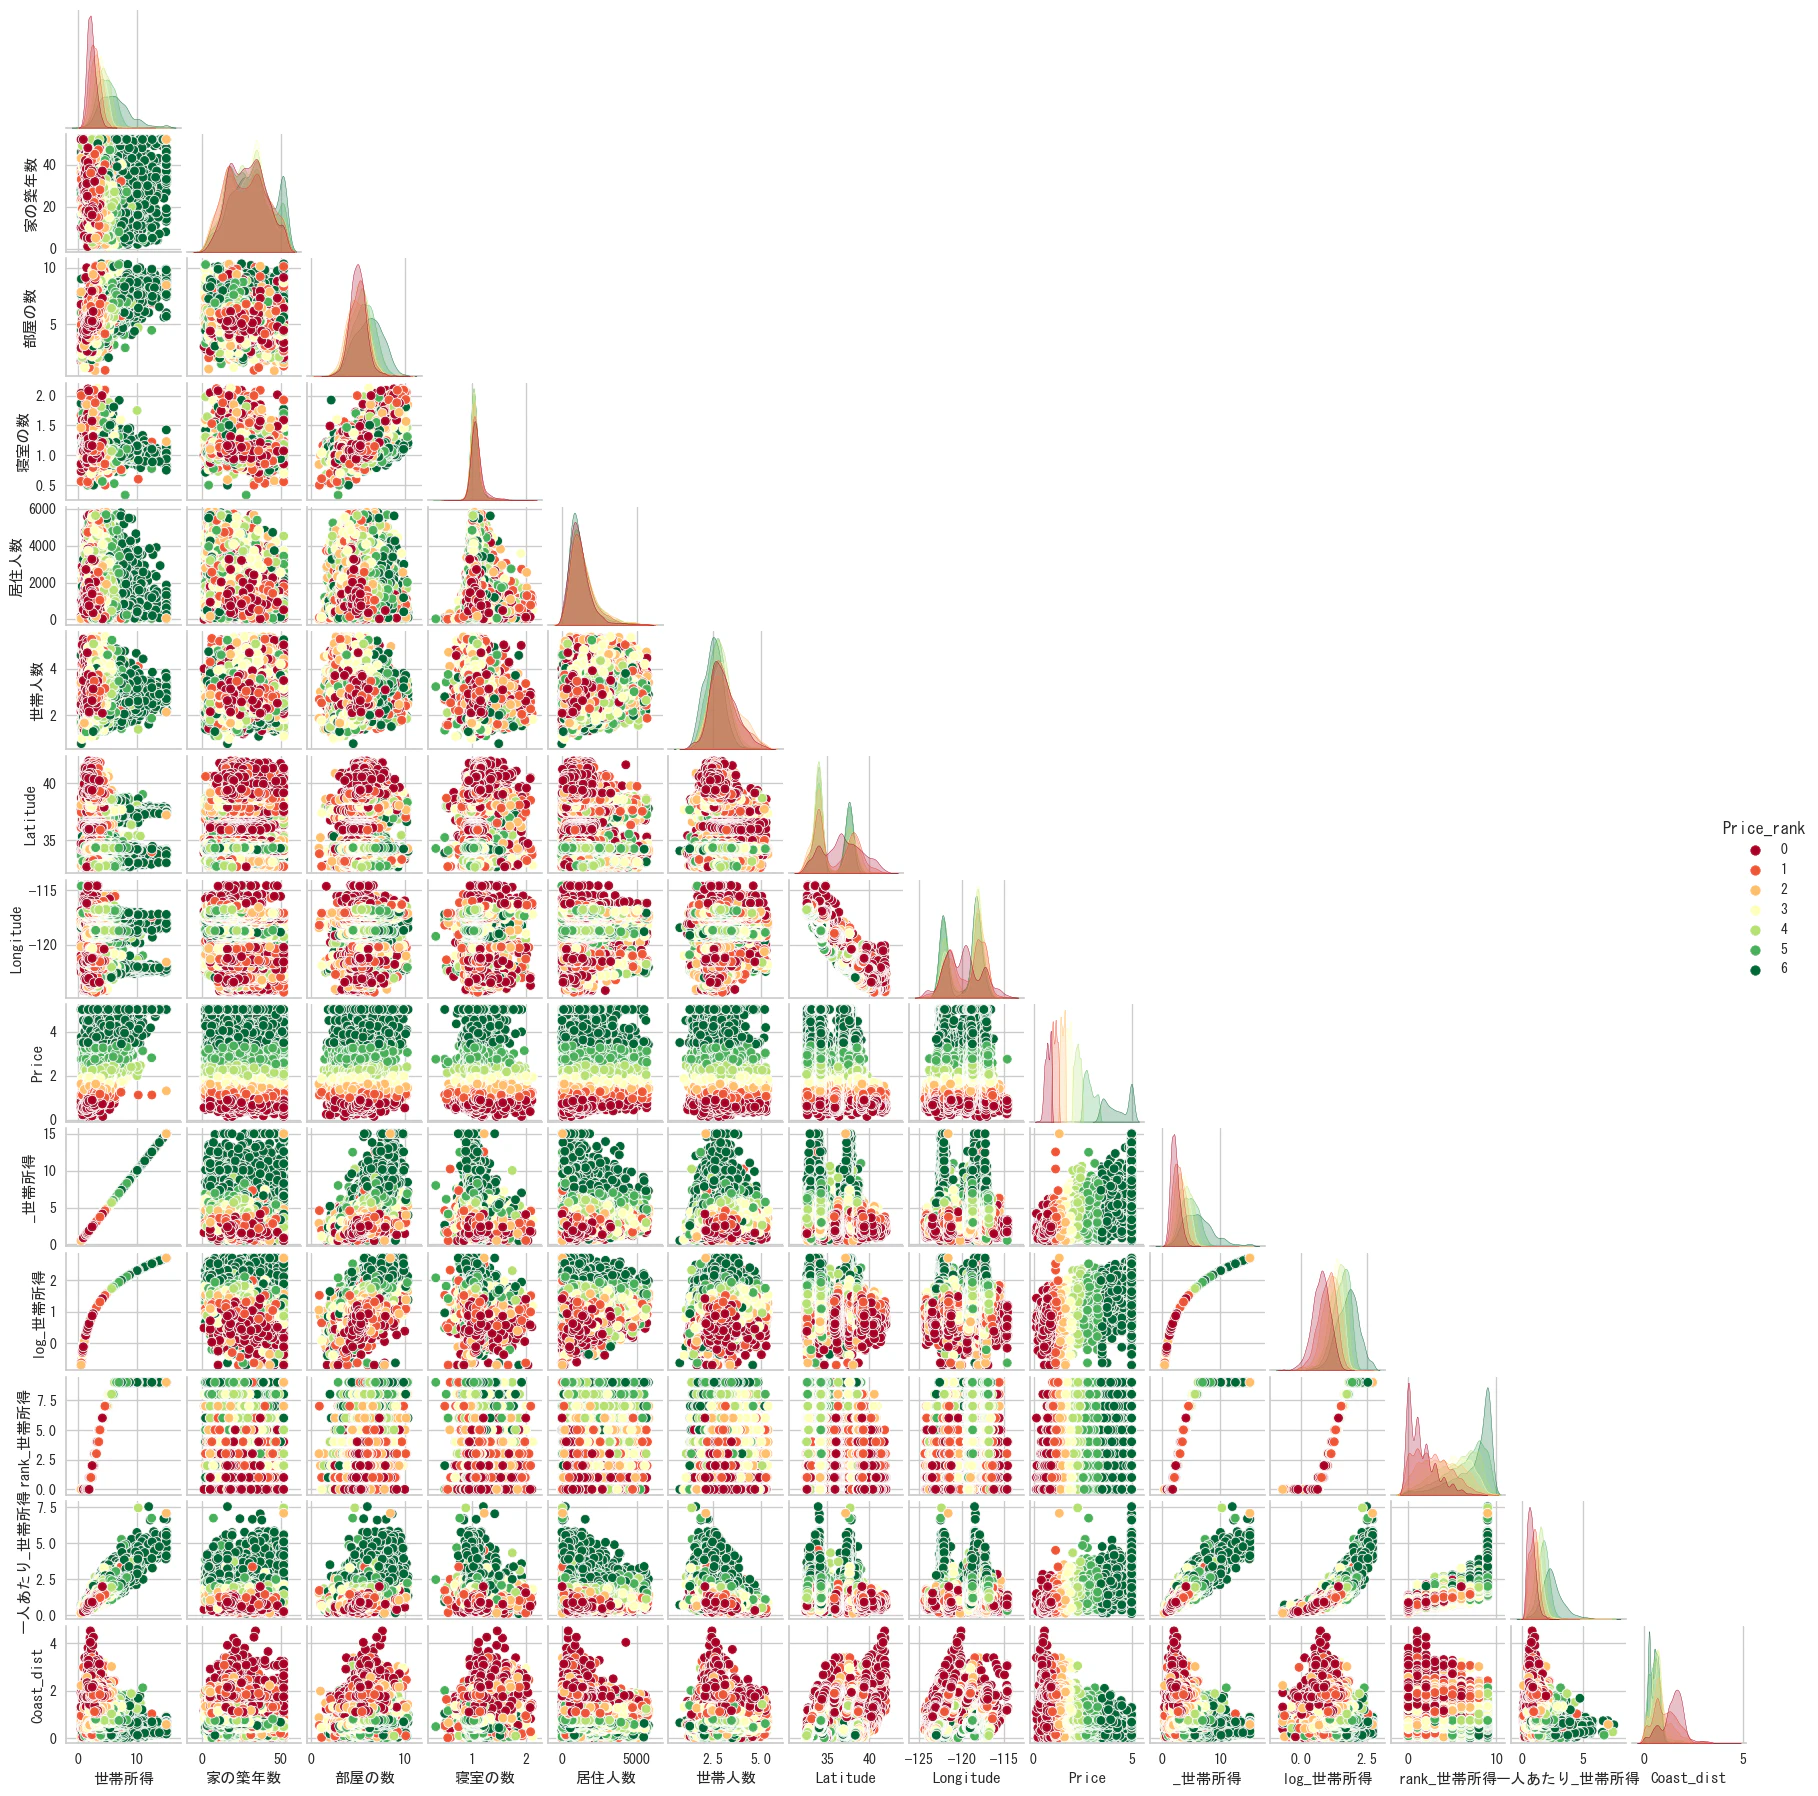
分析結果の考察
世帯所得(MedInc)
まず各属性の分布に注目します
一人あたり_世帯所得:世帯所得と住宅価格帯の分布が似ており、さらにピークが離れています。この特徴量は、住宅価格が高いにもかかわらず所得が低いという、高齢者や別荘地といったケースを過小評価しないように計算したものです。元の情報を保持しながらも、より目的変数に影響を与える属性だと考えられます。
他の属性:log_世帯所得、rank_世帯所得はピークが離れていますが、世帯所得の分布自体も変化しているため、これらの影響はまだはっきりしません。
次に、住宅価格(Price)と、それぞれの新しい特徴量の分布に着目します。
一人あたり_世帯所得: 元の世帯所得と同じ程度の相関が見られます。
rank_世帯所得: 相関が小さくなっています。これは、順位という情報だけでは、元の所得が持つ「価格を予測する力」を十分に捉えきれていないことを示唆します。
log_世帯所得: 右下にあったサンプル(価格が高いにもかかわらず所得が低い地域)が目立たなくなりました。これは、極端な外れ値の影響を弱める効果があり、モデルの予測精度を向上させる可能性があります。
海岸線からの距離(Coast_dist): この特徴量は、価格帯ごとの分布をヒストグラム上でより明確に分離させる効果があることが確認できました。特に、低価格帯の住宅が特定の範囲に偏って分布していることが読み取れるため、住宅価格を予測する上で非常に重要な特徴量であると判断できます。
特徴量選択と仮説検証
作成した新しい属性が、モデルにとって有効な特徴量になるか検証します。
具体的には、元のデータセットを基準に、新しい特徴量を一つずつ加えては、同じモデル(決定木回帰モデル)とパラメータで予測を実行し、その結果を比較します。このプロセスを通じて、どの特徴量が予測精度の向上に貢献するかを見極めます。
# 決定木回帰モデルを導入して比較する
from sklearn.tree import DecisionTreeRegressor
# 決定木モデルを可視化するためのモジュール
from sklearn import tree
# データを分割するためのユーティリティ
from sklearn.model_selection import train_test_split
# Notebook内に画像を直接表示させるモジュール
from IPython.display import Image
# 決定木回帰モデルの学習と評価を行う関数
def get_score_treeRegressor(val_data, feature_col, target_col='Price', min_sample_leaf=500):
    # 説明変数・目的変数をそれぞれ格納
    X = val_data[feature_col]
    y = val_data[target_col]

    # 訓練用・テスト用にそれぞれ分割
    X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=0)

    # 決定木モデルを構築するクラスを初期化
    regressor = DecisionTreeRegressor(min_samples_leaf=min_sample_leaf, criterion='squared_error')

    # 決定木モデルを生成
    regressor.fit(X_train, y_train)

    # スコアを計算
    result_train = regressor.score(X_train, y_train)
    result_test = regressor.score(X_test, y_test)

    # 重要度
    importance = get_importance_df(regressor,feature_col)
    return regressor, result_train, result_test,importance

def get_importance_df(regressor,feature_col):
    # 特徴量の重要度を取得
    importances = regressor.feature_importances_

    # 重要度をDataFrameにまとめて見やすくする
    importance_df = pd.DataFrame(
        {'feature': feature_col, 'importance': importances}
    ).sort_values('importance', ascending=False)
    return importance_df

# 比較する特徴量の組み合わせを定義
feature_col_set = []

# 1. 基本的な特徴量セット
feature_col = ['世帯所得', 'Latitude', 'Longitude', '家の築年数', '部屋の数', '居住人数', '世帯人数']
feature_col_set.append(feature_col)

# 2. 寝室の数を追加した特徴量セット
feature_col = ['世帯所得', 'Latitude', 'Longitude', '家の築年数', '部屋の数', '寝室の数', '居住人数', '世帯人数']
feature_col_set.append(feature_col)

# 3. 海岸線からの距離を追加した特徴量セット
feature_col = ['世帯所得', 'Coast_dist', '家の築年数', '部屋の数', '寝室の数', '居住人数', '世帯人数']
feature_col_set.append(feature_col)

# 4. 世帯所得を対数変換し、海岸線からの距離も加えた特徴量セット
feature_col = ['log_世帯所得', 'Coast_dist', '家の築年数', '部屋の数', '寝室の数', '居住人数', '世帯人数']
feature_col_set.append(feature_col)

# データをコピー
val_data = data1.copy()
result_set = []
importance_set= []
for f_col in feature_col_set:
    regressor, result_train, result_test,importance = get_score_treeRegressor(val_data, f_col)
    result_set.append([result_train, result_test])
    display(importance)
    importance_set.append(importance)

results_df = pd.DataFrame(result_set, columns=['正解率(train)', '正解率(test)'])
display(results_df)
結果
feature	importance
0	世帯所得	0.796432
5	世帯人数	0.136868
2	部屋の数	0.032016
1	家の築年数	0.017562
6	Latitude	0.009862
7	Longitude	0.007261
3	寝室の数	0.000000
4	居住人数	0.000000
feature	importance
0	世帯所得	0.664018
6	Coast_dist	0.195105
5	世帯人数	0.121291
1	家の築年数	0.014962
2	部屋の数	0.004624
3	寝室の数	0.000000
4	居住人数	0.000000
feature	importance
0	rank_世帯所得	0.639060
6	Coast_dist	0.203494
5	世帯人数	0.121455
1	家の築年数	0.032454
2	部屋の数	0.003538
3	寝室の数	0.000000
4	居住人数	0.000000
feature	importance
0	log_世帯所得	0.664018
6	Coast_dist	0.195105
5	世帯人数	0.121291
1	家の築年数	0.014962
2	部屋の数	0.004624
3	寝室の数	0.000000
4	居住人数	0.000000
feature	importance
0	一人あたり_世帯所得	0.832475
6	Coast_dist	0.145949
1	家の築年数	0.014866
2	部屋の数	0.006334
3	寝室の数	0.000375
4	居住人数	0.000000
5	世帯人数	0.000000
結果
正解率(train)	正解率(test)
0	0.601	0.579
1	0.656	0.640
2	0.651	0.643
3	0.656	0.640
4	0.682	0.670
分析結果の考察
1:位置情報の置き換え
緯度(Latitude) と 経度(Longitude) の代わりに、海岸線からの距離(Coast_dist) を特徴量として使用した結果、モデルの予測精度が訓練データとテストデータ双方で向上しました。このことから、住宅価格の予測において、海岸線からの距離が元の緯度経度情報よりも重要な特徴量であると考えられます。
2:世帯所得の変換
世帯所得を様々な形で変換した結果、一人あたり世帯所得が最も優れたパフォーマンスを示しました。これは、単純な世帯所得ではなく、世帯人数を加味した一人当たりの所得が、住宅価格の予測においてより有効な情報であることを示唆しています。
結論
これらの結果から、海岸線からの距離と、一人あたり世帯所得が、モデルの予測性能を向上させる上で特に効果的な特徴量であることがわかりました。元のデータに含まれる情報(緯度経度、世帯所得)を適切に変換・加工することで、モデルの予測精度を大きく改善できることが示されました。
選択特徴量の決定木の可視化
前のステップで最も良い精度が得られた特徴量を選択特徴量として、決定木回帰モデルを学習し、木の構造を可視化します。決定木を可視化することで、モデルがどのようなルールに基づいて住宅価格を予測しているのか、その内部構造が理解しやすくなります。
決定木のノード(分岐点)は、最も予測に影響を与える特徴量から順番に分岐していきます。これは、モデルがデータから学習したルールを示しています。
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree

# 特徴量セットを定義
feature_col = ['世帯所得', 'Coast_dist', '家の築年数', '部屋の数', '寝室の数', '居住人数', '世帯人数']

# 決定木モデルを学習
regressor, result_train, result_test,importance = get_score_treeRegressor(val_data, feature_col, min_sample_leaf=1000)

# 決定木を可視化
plt.figure(figsize=(25, 25))
plot_tree(regressor, filled=True, feature_names=feature_col, node_ids=True, impurity=True)
plt.show()
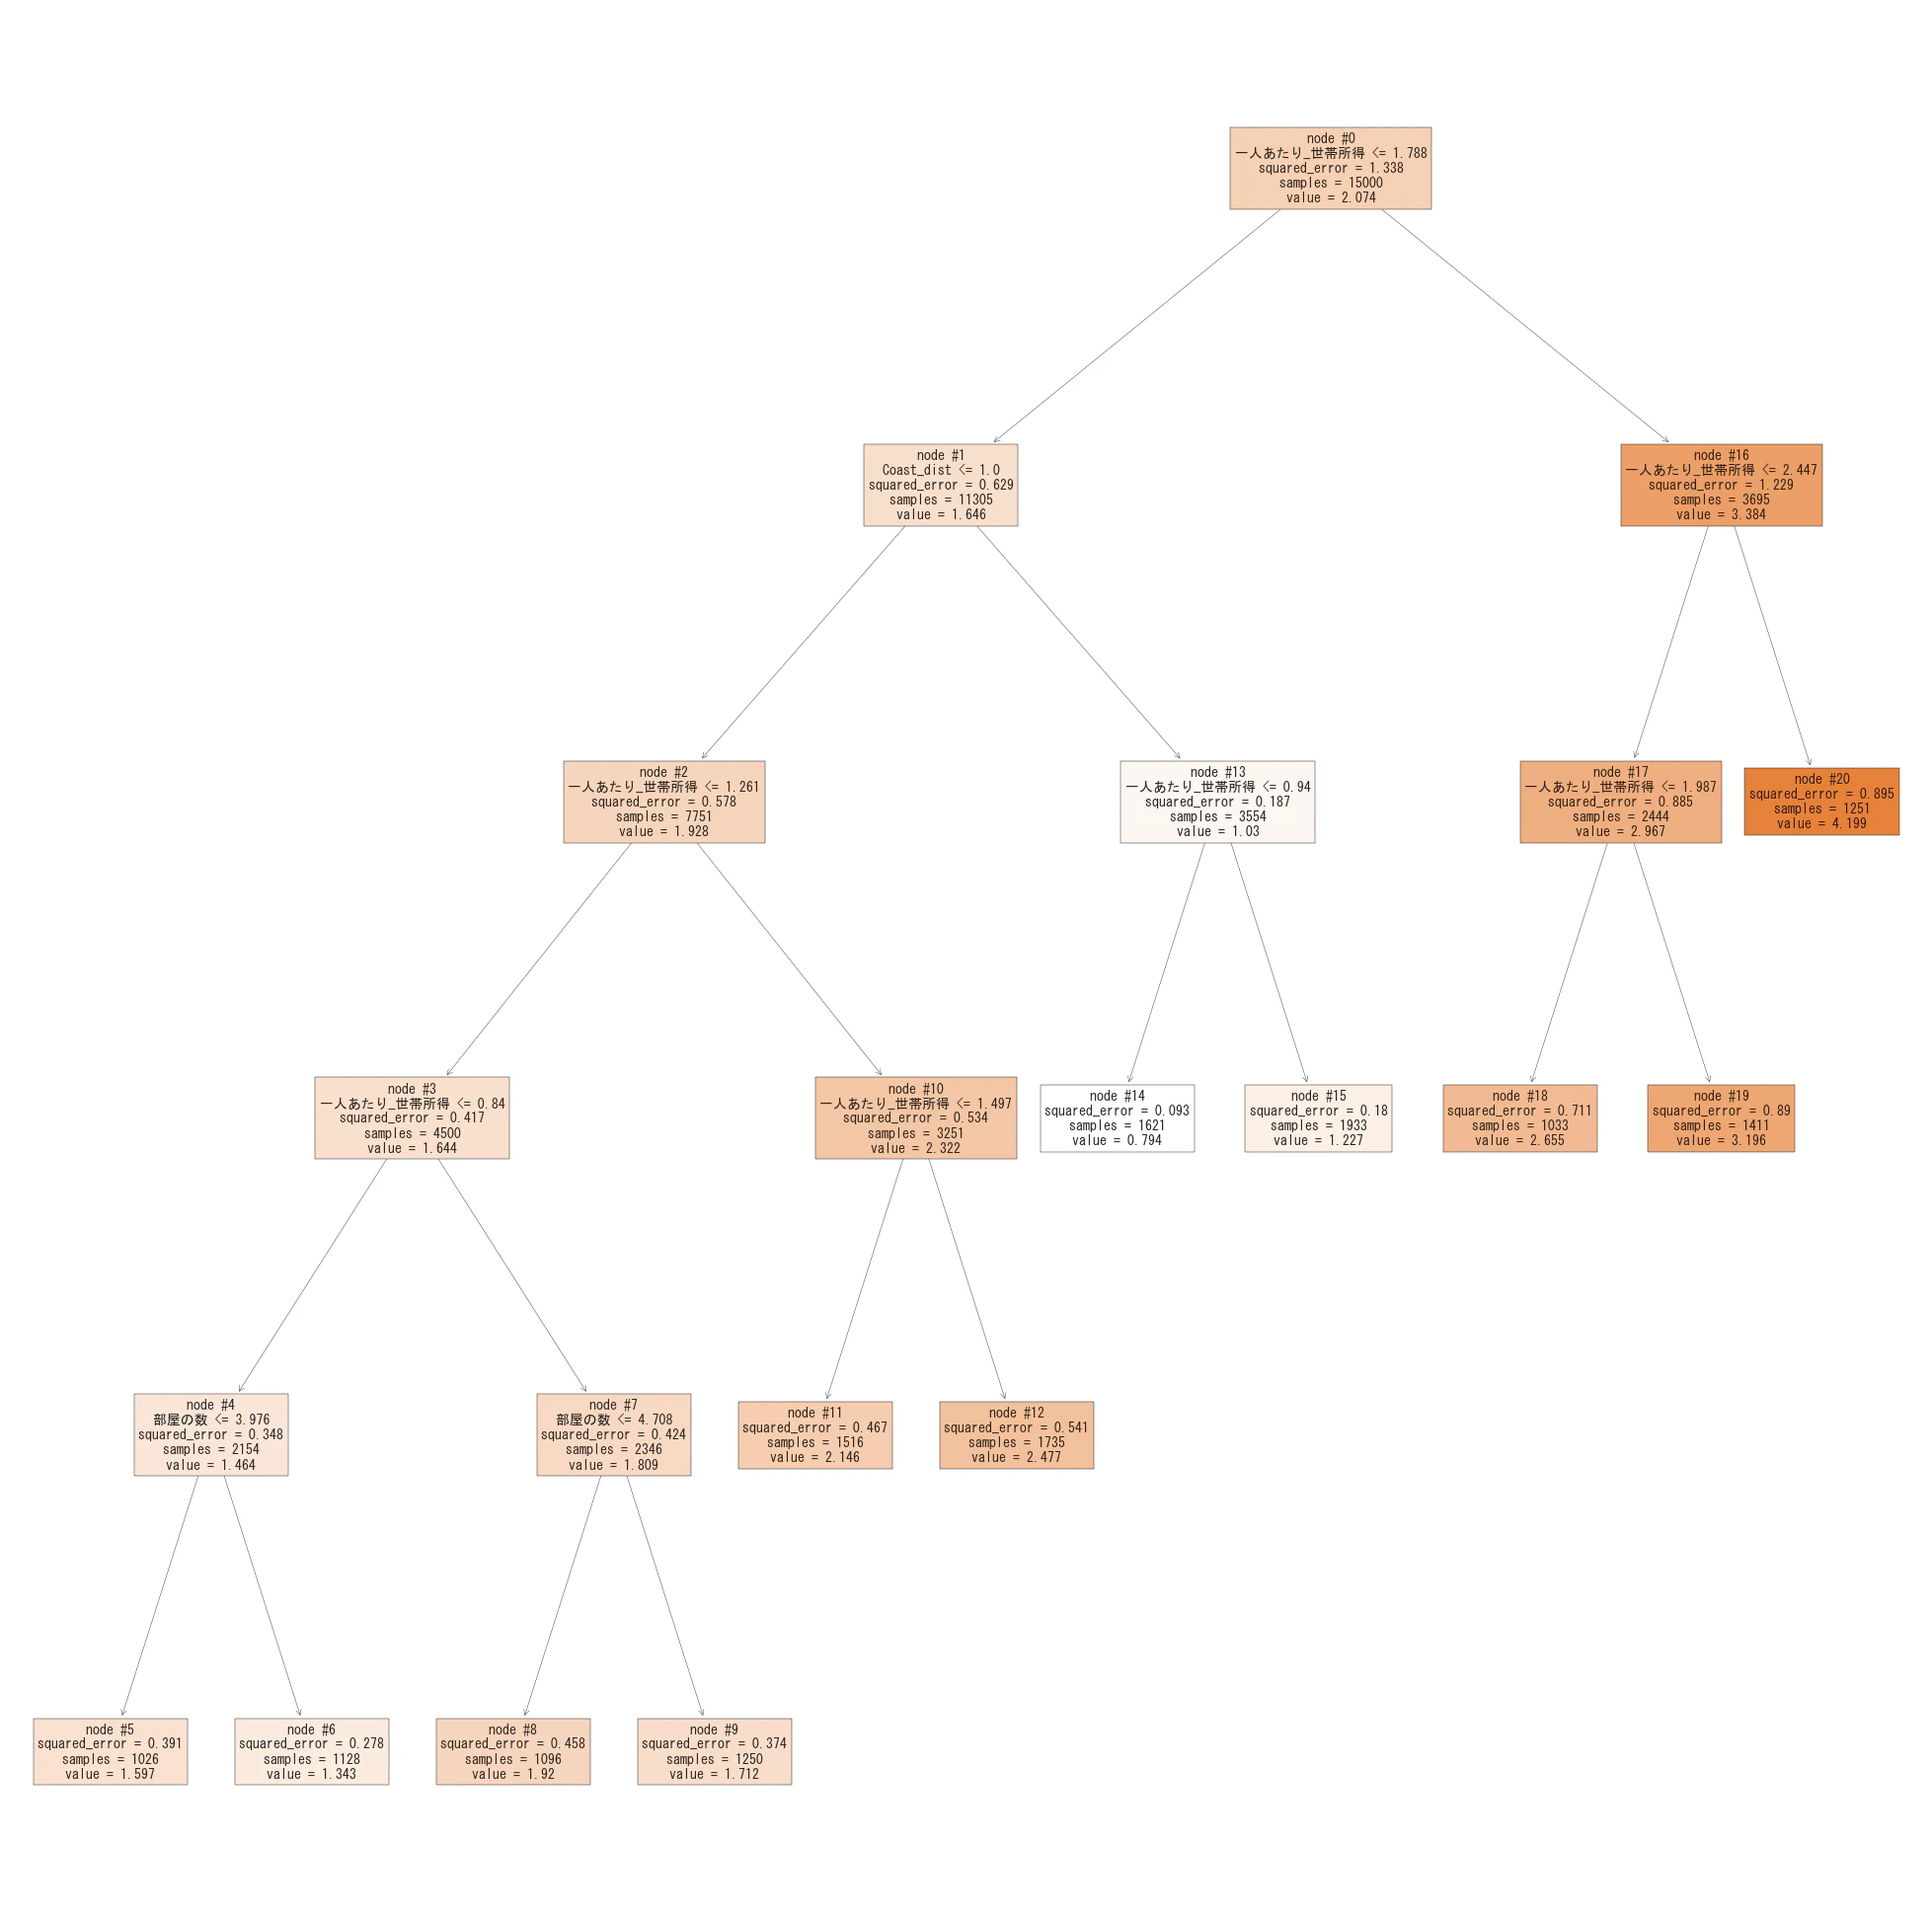
分析結果の考察
可視化された決定木を見ると、一番上のノードで'一人あたり_世帯所得'が最初に分岐に使われています。これは、住宅価格を予測する上で最も重要な特徴量だと判断したことを示します。
続いて、Coast_dist(海岸線からの距離)や'部屋の数'といった特徴量で分岐しています。このことから、モデルは世帯所得を主軸にしながらも、立地や物件の規模といった要因も考慮して価格を予測していることが読み取れます。
特徴量の作成:ドメイン知識の活用
既存の属性から得た選択特徴量により無事精度向上が期待できそうですが、もう少し頑張れないでしょうか。
幸い、今回の住宅価格予測という課題は住む家を選んだことがある人にとっては身近な課題でしょう。きっと住宅価格が駅近や犯罪の少なさ、都市部との近さにのような因子も影響しそうだと、仮説が立ちそうです。
今回は、これらの候補となる因子の中で今回のデータと関連づけられる都市部との近さに着目し、特徴量を作成します。
# Step 1: 主要都市の緯度経度を定義
# (ここでは代表的な都市の中心部を使用)
# 主要都市の緯度経度を定義
cities = {
    'Los_Angeles': (34.0522, -118.2437),
    'San_Francisco': (37.7749, -122.4194),
    'San_Diego': (32.7157, -117.1611),
    'Sacramento': (38.5816, -121.4944),
    'San_Jose': (37.3382, -121.8863),
    'Santa_Barbara': (34.4208, -119.6982),
    'Irvine': (33.6846, -117.8265)
}


# Step 2: 距離を計算する関数を定義 (ユークリッド距離)
def calculate_euclidean_distances(row):
    # 各住宅の緯度経度を取得
    home_location = np.array([row['Latitude'], row['Longitude']])

    # 各都市までの距離を計算し、辞書に格納
    distances = {}
    for city_name, city_location in cities.items():
        city_location_np = np.array(city_location)
        # ユークリッド距離の計算
        distance = np.sqrt(np.sum((home_location - city_location_np)**2))
        distances[f'euclid_dist_to_{city_name}'] = distance

    return pd.Series(distances)


from geopy.distance import geodesic
# Step 2: 距離を計算する関数を定義
def add_geodesic_distance(df, cities):
    """
    データフレームに、主要都市までの球面上の距離(geodesic)を追加する関数。
    """
    # 距離を格納するための空のリストを準備
    all_distances = []

    # 各行をタプルとして効率的にイテレート
    for row in df.itertuples():
        home_location = (row.Latitude, row.Longitude)

        distances = {}
        for city_name, city_location in cities.items():
            distance_km = geodesic(home_location, city_location).km
            distances[f'dist_to_{city_name}'] = distance_km

        all_distances.append(distances)

    # リストをDataFrameに変換して結合
    new_features = pd.DataFrame(all_distances, index=df.index)
    df_with_new_features = pd.concat([df, new_features], axis=1)

    return df_with_new_features


# `apply`メソッドを使って、関数をデータフレームの各行に適用
new_distance_features_euclidean = val_data.apply(calculate_euclidean_distances, axis=1)
#元のデータフレームに新しい特徴量を結合
data1 = pd.concat([val_data, new_distance_features_euclidean], axis=1)
def add_nearest_city_distance(df, cities):
    """
    データフレームに、最も近い主要都市までのユークリッド距離を追加する関数。

    Args:
        df (pd.DataFrame): 緯度と経度の列を含むデータフレーム。
        cities (dict): 主要都市名と緯度経度をタプルで持つ辞書。

    Returns:
        pd.DataFrame: 最寄りの主要都市までの距離の列が追加されたデータフレーム。
    """
    # 主要都市の緯度経度をNumPy配列に変換
    city_locations = np.array(list(cities.values()))

    # 各住宅の緯度経度をNumPy配列に変換
    home_locations = df[['Latitude', 'Longitude']].to_numpy()

    # 全ての住宅と全ての都市の間の距離を一括で計算
    # shape: (住宅数, 都市数) の2D配列が生成される
    distances = np.sqrt(np.sum((home_locations[:, np.newaxis, :] - city_locations[np.newaxis, :, :])**2, axis=2))

    # 各住宅に対して、最も近い都市までの距離(行の最小値)を抽出
    min_distances = np.min(distances, axis=1)

    # 新しい特徴量をDataFrameに変換
    nearest_distance_df = pd.DataFrame(min_distances, columns=['dist_to_nearest_city'], index=df.index)

    # 元のデータフレームに新しい特徴量を結合
    df_with_distance = pd.concat([df, nearest_distance_df], axis=1)

    return df_with_distance

data1=add_nearest_city_distance(data1,cities)
選択特徴量の決定木の可視化
作成した特徴量が有効かを前節に同様に確かめてくのが本来のステップです。
しかし、そのやり方は前節と同様でかなり冗長になるため、今回は雑な対応になりますが、そのステップを端折ります。その代わりに、これらが選択特徴量と一旦みなして、前節の特徴量に追記して、決定回帰木に投入したとき、前節の情報を書き換えうるかを観察し、選択特徴量として妥当だったか確認することにします。
# 特徴量セットを定義
feature_col = ['一人あたり_世帯所得','家の築年数', '部屋の数', '寝室の数', '居住人数', '世帯人数','Coast_dist','euclid_dist_to_Los_Angeles',
       'euclid_dist_to_San_Francisco', 'euclid_dist_to_San_Diego',
       'euclid_dist_to_Sacramento', 'euclid_dist_to_San_Jose',
       'euclid_dist_to_Santa_Barbara', 'euclid_dist_to_Irvine']

val2_data = data1.copy()
# 決定木モデルを学習
regressor, result_train, result_test,importance = get_score_treeRegressor(val2_data, feature_col, min_sample_leaf=1000)

# 決定木を可視化
plt.figure(figsize=(25, 25))
plot_tree(regressor, filled=True, feature_names=feature_col, node_ids=True, impurity=True)
plt.show()
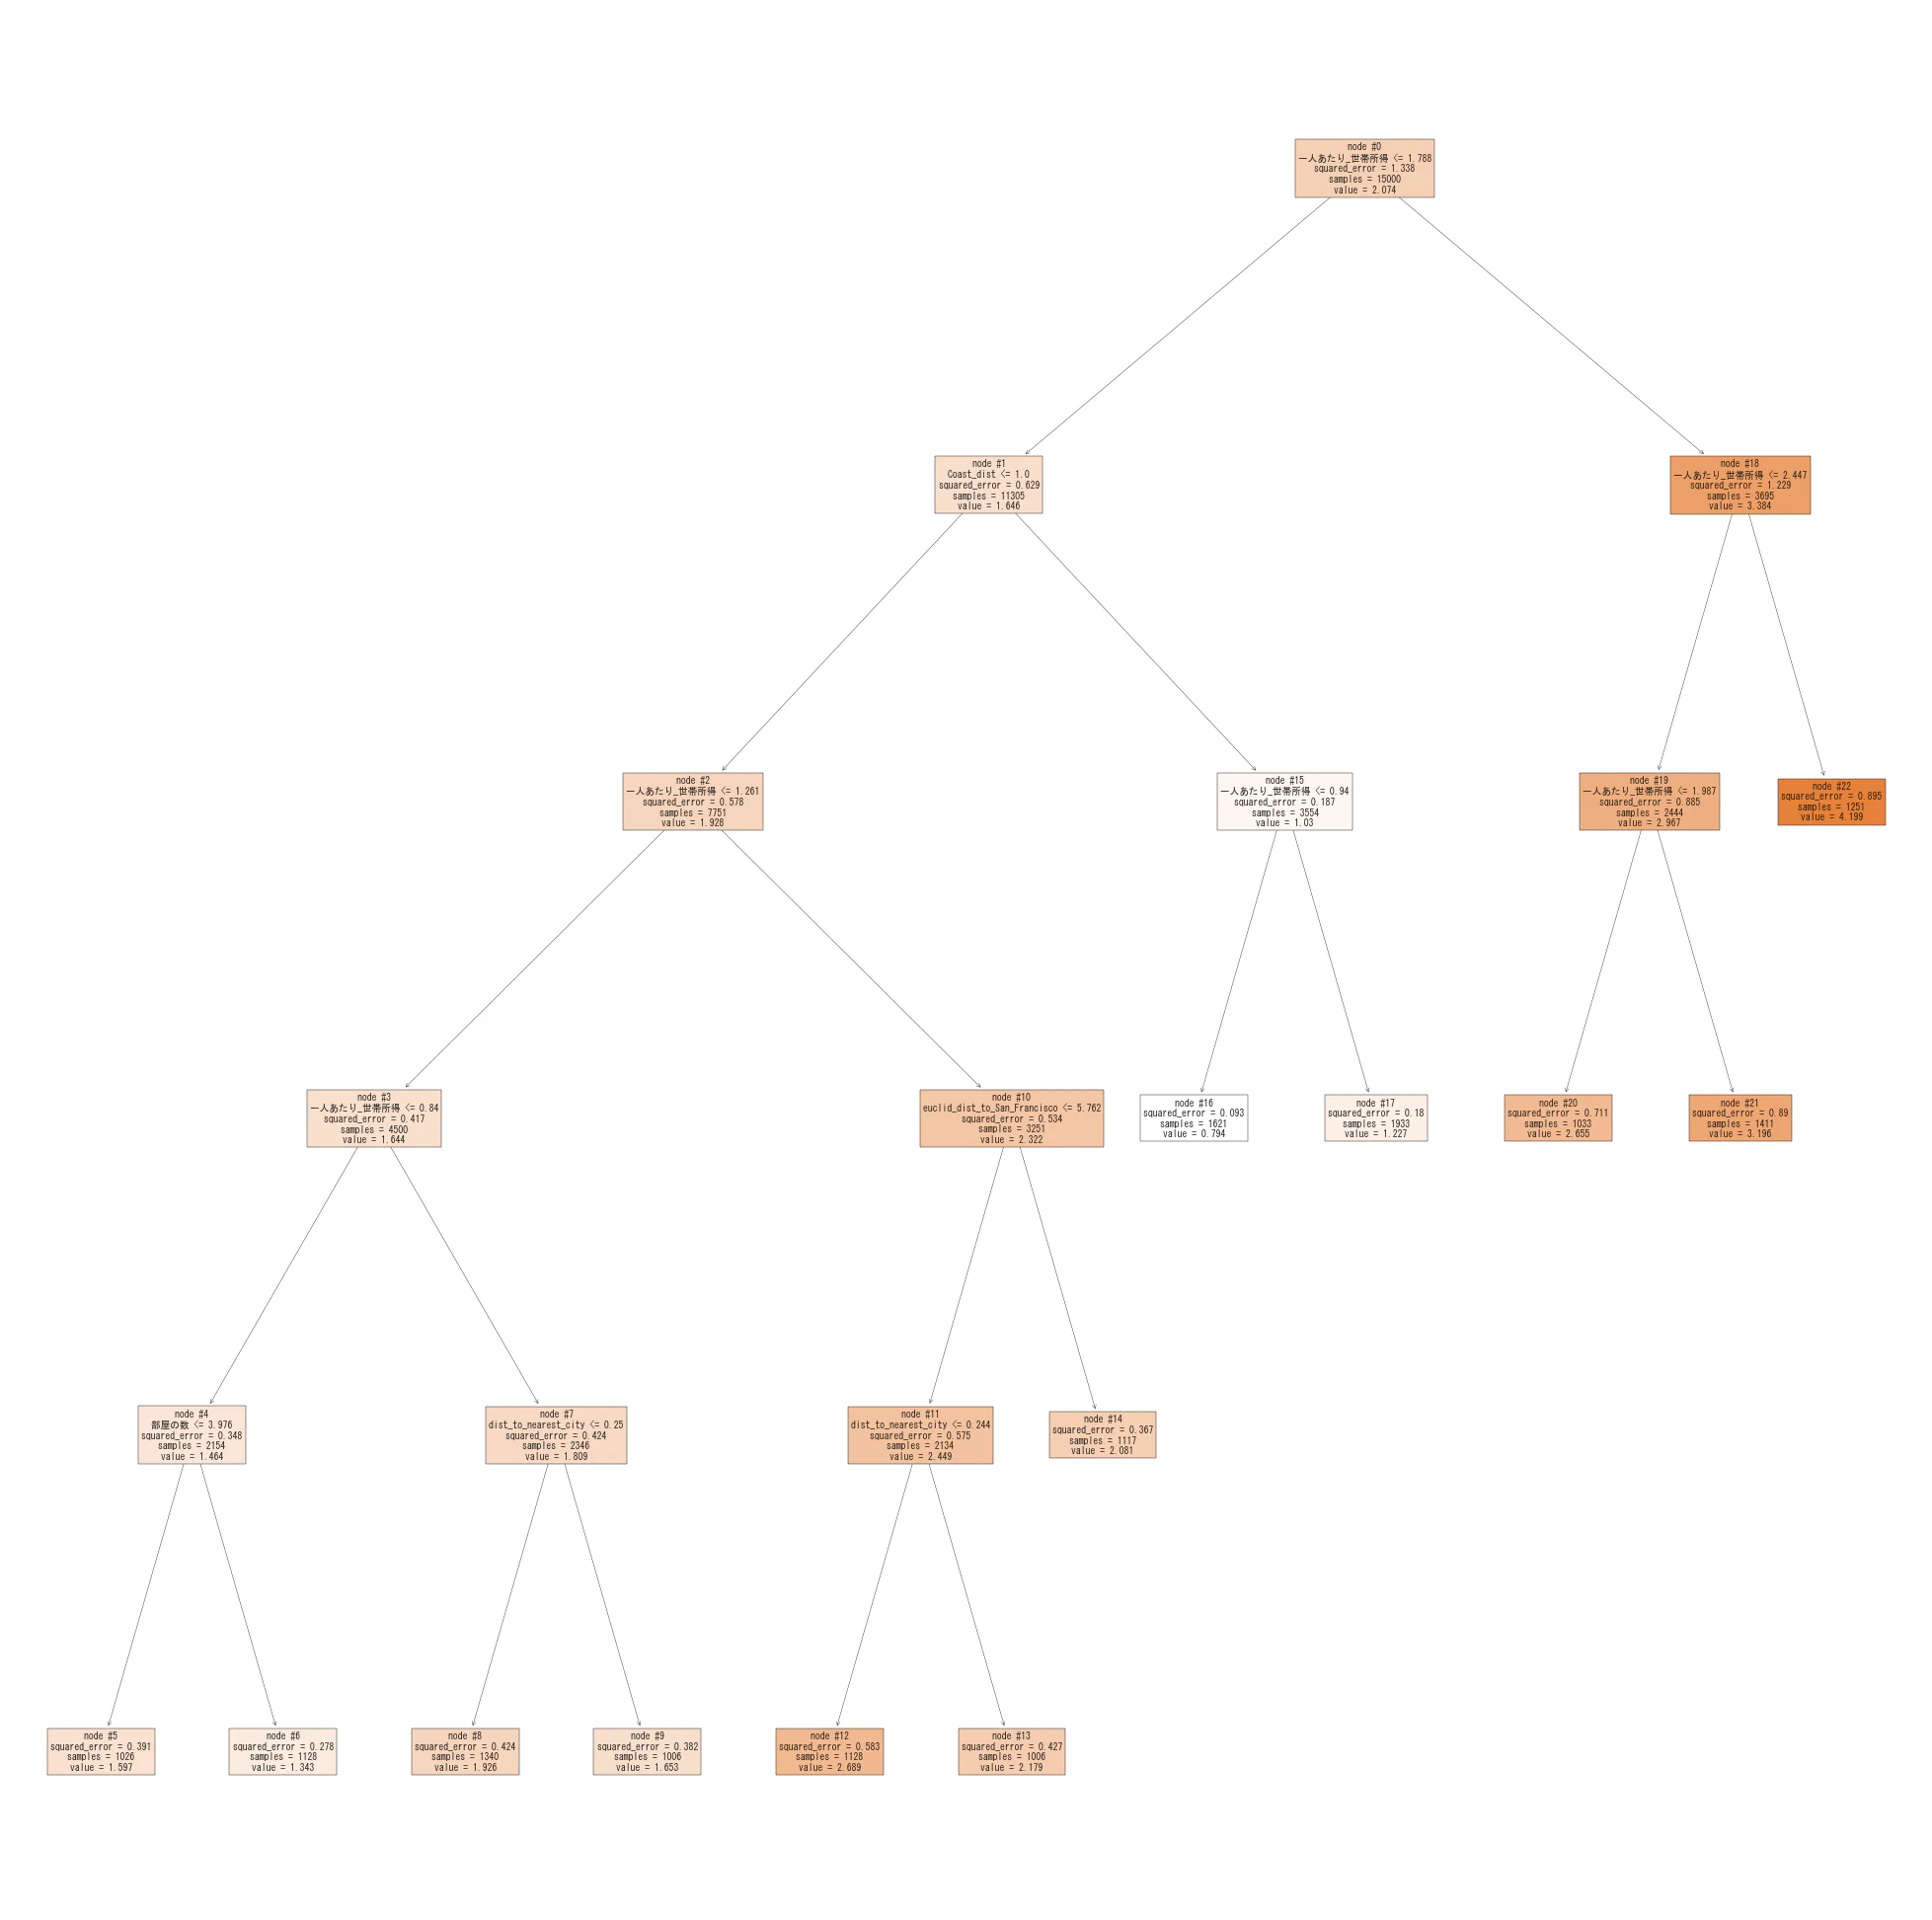
分析結果の考察
euclid_dist_to_San_Francisco:
サンフランシスコからの距離は、住宅価格への寄与が大きいことが分かりました。1990年当時、サンフランシスコの南に位置するシリコンバレーは、すでにテクノロジー産業の中心地として発展しており、高所得な技術者が多く集まっていました。この知識を踏まえると、モデルが「サンフランシスコからの距離」を重要な特徴量と判断したのは、この地域の高い住宅需要と経済的な要因を反映していると考えられます。
dist_to_nearest_city:
この特徴量は、住宅価格を予測する上で重要な要因であることが示されました。仮説として考えた、都市に近いほど住宅価格は高くなる傾向があり、この分析結果はそれを裏付けるものになっています。
これらのことから、都市からの距離は、モデルの予測精度を向上させるため、選択特徴量であると考えられます。
まとめと次やること
今回の記事では、特徴量エンジニアリングと仮説検証についてまとめました。
モデルの予測精度を向上させるには、単にデータを与えるだけでなく、仮説に基づいた新しい特徴量を作成し、その有効性を検証することが重要であることを、一人あたり世帯所得や海岸線からの距離といった特徴量から確認しました。
ここで、実データの分布から海岸線からの距離が特徴量として有効だと考えましたが、実はその背後に、都市部が海岸線に集まっているというより深い理由があると考えられます。実際、サンタバーバラ、サンディエゴ、サンフランシスコ、ロサンゼルスといった主要都市はすべて海岸線に面しています。そのため、海岸線からの距離が価格と相関しているのは、海岸線そのものの価値というよりも、都市部の住宅価格が高いという普遍的な要因を間接的に示していると言えます。
このことから、特徴量を作成において、既存の特徴量から計算で算出するのに加えて、ドメイン知識の活用こそ重要であると考えられます。
次の記事では、選択特徴量によるモデルの選択と評価に入ります。その際に、複数の機械学習モデルの性能を効率的に比較できるPythonのライブラリ「PyCaret」を利用します。これにより、最も優れた精度のモデルを簡単に見つけ出すことが可能になります。