

はじめに
Claude Codeには、モデルとは別に「effort」という設定があります。
low・medium・high・xhigh・maxの5段階です。
上げるほどよく考える代わりに、トークンを使います。
ただ、1段階上げるとトークンがどれくらい増えるのかは、調べてもあまり数字が出てきませんでした。
なので、同じ課題をeffortを変えて実行し、トークン量・時間・コストを測ってみました。
モデルはSonnet 5.5・Opus 5.5・Fable 5.2の3つです。
備忘録として残しておきます。
TL;DR
- 既定の
mediumからhighに上げると、出力トークンは1.2〜1.3倍でした(3モデルとも) -
xhighに上げると、mediumの2.3〜2.4倍になりました(3モデルとも) -
lowに下げると、Opus 5.5とFable 5.2は3割ほど減りました。Sonnet 5.5はほとんど変わりませんでした - トークン量と時間は、Opus 5.5のhighとFable 5.2のmediumがほぼ同じでした(15,534と15,002トークン、161秒と157秒)
- 換算コストは、Opus 5.5のxhighとFable 5.2のmediumが近いです(0.87ドルと0.96ドル)。Fable 5.2は単価が2倍です。同じコストなら、Opus 5.5は2段階上のeffortを使えます
- 軽い課題では、effortを上げてもトークンが増えない回がありました
- 増えるのは、thinking・ツール呼び出しの回数・自分でテストを書いて確かめる作業でした
- 今回の課題は、全部の設定で隠しテストに合格しました。effortによる品質の差は、今回の測定では分かりません
環境
| 項目 | 内容 |
|---|---|
| 実施日 | 2026年11月11日 |
| Claude Code | 2.1.322(macOS) |
| モデル | Claude Sonnet 5.5(claude-sonnet-5-5)、Claude Opus 5.5(claude-opus-5-5)、Claude Fable 5.2(claude-fable-5-2) |
| effort | low・medium・high・xhigh(maxは測っていません) |
| 回数 | 4課題×3モデル×4段階×各3回=144回 |
Claude Codeでは、3つのモデルとも既定のeffortはmediumです(Model configurationより)。
APIを直接呼ぶ場合の既定値は違います。
Opus 5.5はmedium、Sonnet 5.5とFable 5.2はhighです(Effortより)。
単価は次のとおりです(100万トークンあたり。Pricingより)。
| モデル | 入力 | 出力 | キャッシュの読み込み |
|---|---|---|---|
| Sonnet 5.5 | 2ドル | 10ドル | 0.10ドル |
| Opus 5.5 | 4ドル | 20ドル | 0.20ドル |
| Fable 5.2 | 8ドル | 40ドル | 0.20ドル |
やりかた
Claude Codeを-p(非対話モード)で起動しました。
--modelと--effortだけを変えて、同じ課題を実行しています。
claude -p "$(cat prompt.txt)" \
  --model claude-opus-5-5 \
  --effort high \
  --output-format stream-json --verbose \
  --safe-mode --strict-mcp-config --no-session-persistence \
  --tools "Bash,Read,Edit,Write,Glob,Grep" \
  --permission-mode acceptEdits --allowedTools "Bash(python3:*)"
-
--safe-modeと--strict-mcp-configを付けています。手元のCLAUDE.md・スキル・MCPサーバーを読み込ませない為です - 課題のフォルダは毎回コピーして、まっさらな状態から始めます
- 最後に出力される
resultのusageから、トークン数・ターン数・時間・換算コストを取りました
usageには次のような値が入っています。
thinkingに使ったトークンは、output_tokens_details.thinking_tokensに入っています。
{
  "input_tokens": 10,
  "cache_creation_input_tokens": 4048,
  "cache_read_input_tokens": 43391,
  "output_tokens": 1803,
  "output_tokens_details": { "thinking_tokens": 312 }
}
課題
課題は4つ用意しました。
どれもこの記事の為に作った小さなものです。
| 課題 | 種類 | 中身 |
|---|---|---|
| 知識の質問 | ツールなしの1問1答 | WebhookをSQSで非同期にするときの設定を4点説明させる |
| バグ修正 | 調査して直す | カート計算のコード(4ファイル)。原因の違うバグが2つ |
| 小さな実装 | 1関数を書く | 仕様書どおりにCSVパーサを実装する |
| 少し重い機能追加 | 複数ファイルの変更 | 在庫台帳(3ファイル)にロットと使用期限の機能を足す |
コーディングの3課題には、Claude Codeに見せない隠しテストを用意しました。
実行が終わったあとに流して、合否を記録しています。
数字の見方
- 表の数字は3回の中央値です。合計は、課題ごとの中央値を足したものです
- 「出力トークン」はthinkingを含みます
- 「換算コスト」はClaude Codeが返す
total_cost_usdです。APIの定価で計算した値で、プラン契約の場合の請求額ではありません
結果
4課題の合計
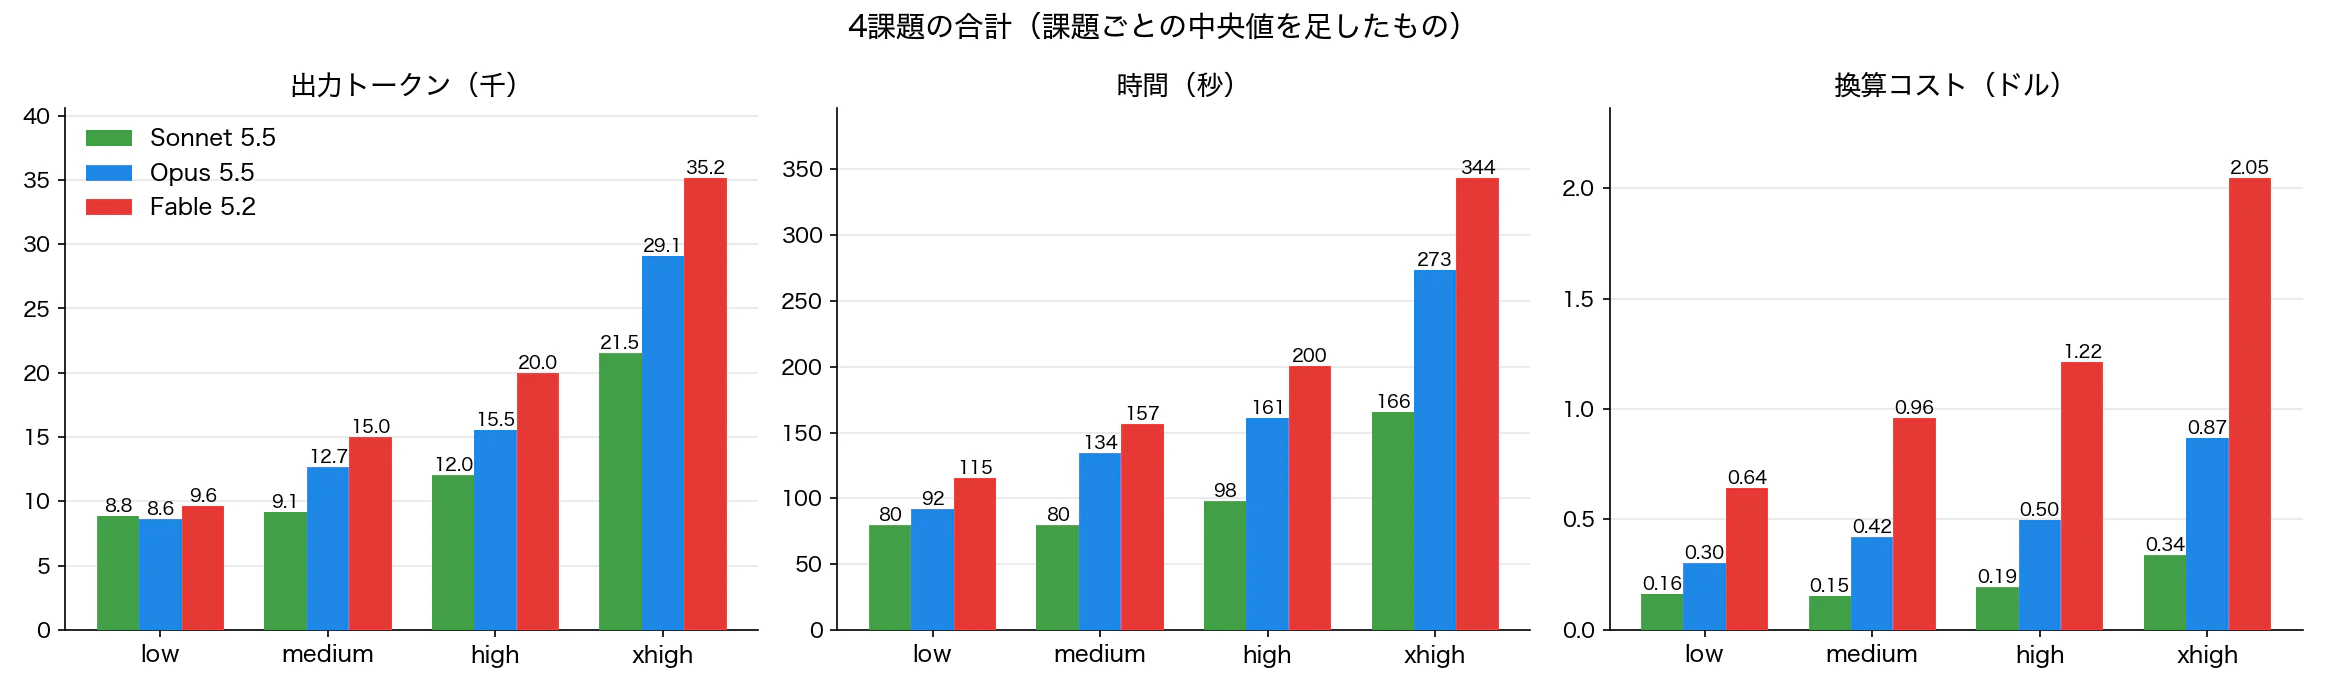
| モデル | effort | 出力トークン | うちthinking | 時間(秒) | 換算コスト(ドル) |
|---|---|---|---|---|---|
| Sonnet 5.5 | low | 8,822 | 516 | 80 | 0.163 |
| Sonnet 5.5 | medium | 9,140 | 902 | 80 | 0.154 |
| Sonnet 5.5 | high | 12,018 | 3,337 | 98 | 0.195 |
| Sonnet 5.5 | xhigh | 21,540 | 7,245 | 166 | 0.339 |
| Opus 5.5 | low | 8,621 | 264 | 92 | 0.301 |
| Opus 5.5 | medium | 12,687 | 1,775 | 134 | 0.423 |
| Opus 5.5 | high | 15,534 | 3,005 | 161 | 0.496 |
| Opus 5.5 | xhigh | 29,062 | 12,709 | 273 | 0.868 |
| Fable 5.2 | low | 9,636 | 1,770 | 115 | 0.644 |
| Fable 5.2 | medium | 15,002 | 1,204 | 157 | 0.960 |
| Fable 5.2 | high | 19,954 | 4,898 | 200 | 1.215 |
| Fable 5.2 | xhigh | 35,175 | 16,227 | 344 | 2.048 |
既定のmediumを1としたときの、出力トークンの倍率です。
| モデル | low | medium | high | xhigh |
|---|---|---|---|---|
| Sonnet 5.5 | 0.97 | 1.00 | 1.31 | 2.36 |
| Opus 5.5 | 0.68 | 1.00 | 1.22 | 2.29 |
| Fable 5.2 | 0.64 | 1.00 | 1.33 | 2.34 |
- highにすると、2〜3割増えました
- xhighにすると、2.3〜2.4倍になりました
- lowにすると、Opus 5.5とFable 5.2は3割ほど減りました。Sonnet 5.5はmediumとほぼ同じです
mediumからhighまでは緩やかですが、xhighで一気に増えます。
この増え方は、3つのモデルでほとんど同じでした。
xhighでは、出力トークンに占めるthinkingの割合も大きくなります。
Sonnet 5.5で34%、Opus 5.5で44%、Fable 5.2で46%でした。
Opus 5.5とFable 5.2で、近い結果になった組み合わせ
4課題の合計で、数字が近かった組み合わせを並べます。
| 見る項目 | Opus 5.5 | Fable 5.2 | 差 |
|---|---|---|---|
| 出力トークン | high:15,534 | medium:15,002 | Opusが4%多い |
| 時間 | high:161秒 | medium:157秒 | Opusが3%長い |
| 換算コスト | xhigh:0.868ドル | medium:0.960ドル | Fableが11%高い |
| 出力トークン | low:8,621 | low:9,636 | Fableが12%多い |
- トークン量と時間は、Opus 5.5のhighとFable 5.2のmediumがほぼ同じでした。Opus 5.5を1段階上げると、Fable 5.2の既定と同じくらいの量になります
- 換算コストは、Opus 5.5のxhighとFable 5.2のmediumが近いです。Opus 5.5のhighは0.496ドルで、Fable 5.2のlow(0.644ドル)より安く済みました
- lowどうしは、トークン量が近くなりました
近いのはトークン量・時間・コストの話です。
出てくる結果の質が同じかどうかは、今回の測定では分かりません。
課題ごとの出力トークン

| 課題 | モデル | low | medium | high | xhigh |
|---|---|---|---|---|---|
| 知識の質問 | Sonnet 5.5 | 2,627 | 2,761 | 3,610 | 4,615 |
| 知識の質問 | Opus 5.5 | 2,554 | 3,370 | 4,449 | 6,988 |
| 知識の質問 | Fable 5.2 | 2,482 | 2,114 | 3,870 | 6,156 |
| バグ修正 | Sonnet 5.5 | 1,085 | 1,170 | 1,092 | 2,439 |
| バグ修正 | Opus 5.5 | 1,444 | 2,121 | 1,803 | 3,033 |
| バグ修正 | Fable 5.2 | 1,227 | 1,320 | 1,101 | 2,384 |
| 小さな実装 | Sonnet 5.5 | 1,553 | 1,910 | 2,407 | 3,190 |
| 小さな実装 | Opus 5.5 | 1,404 | 1,800 | 2,416 | 4,851 |
| 小さな実装 | Fable 5.2 | 1,780 | 2,352 | 3,022 | 7,261 |
| 少し重い機能追加 | Sonnet 5.5 | 3,557 | 3,299 | 4,909 | 11,296 |
| 少し重い機能追加 | Opus 5.5 | 3,219 | 5,396 | 6,866 | 14,190 |
| 少し重い機能追加 | Fable 5.2 | 4,147 | 9,216 | 11,961 | 19,374 |
軽い課題では、effortを上げても増えないことがありました。
バグ修正では、3モデルともhighの方がmediumより少なくなっています。
知識の質問でも、Fable 5.2はmediumの方がlowより少ないです。
3回のばらつきも大きいです。
小さな実装のFable 5.2のmediumは、1,811〜4,836トークンでした。
軽い課題では、1段階の差より3回のばらつきの方が大きいです。
重い課題ほど、effortの差がはっきり出ました。
少し重い機能追加でのlow→xhighの倍率は、次のとおりです。
Sonnet 5.5が3.2倍、Opus 5.5が4.4倍、Fable 5.2が4.7倍でした。
時間と換算コスト
時間(秒)です。
| 課題 | モデル | low | medium | high | xhigh |
|---|---|---|---|---|---|
| 知識の質問 | Sonnet 5.5 | 22 | 23 | 28 | 36 |
| 知識の質問 | Opus 5.5 | 28 | 33 | 44 | 68 |
| 知識の質問 | Fable 5.2 | 27 | 23 | 41 | 62 |
| バグ修正 | Sonnet 5.5 | 16 | 14 | 13 | 23 |
| バグ修正 | Opus 5.5 | 20 | 28 | 20 | 34 |
| バグ修正 | Fable 5.2 | 20 | 20 | 19 | 33 |
| 小さな実装 | Sonnet 5.5 | 14 | 18 | 20 | 29 |
| 小さな実装 | Opus 5.5 | 16 | 19 | 27 | 48 |
| 小さな実装 | Fable 5.2 | 25 | 34 | 35 | 74 |
| 少し重い機能追加 | Sonnet 5.5 | 28 | 25 | 38 | 78 |
| 少し重い機能追加 | Opus 5.5 | 28 | 54 | 69 | 123 |
| 少し重い機能追加 | Fable 5.2 | 43 | 79 | 105 | 175 |
換算コスト(ドル)です。
| 課題 | モデル | low | medium | high | xhigh |
|---|---|---|---|---|---|
| 知識の質問 | Sonnet 5.5 | 0.028 | 0.029 | 0.038 | 0.048 |
| 知識の質問 | Opus 5.5 | 0.058 | 0.071 | 0.092 | 0.143 |
| 知識の質問 | Fable 5.2 | 0.106 | 0.091 | 0.161 | 0.253 |
| バグ修正 | Sonnet 5.5 | 0.031 | 0.031 | 0.027 | 0.051 |
| バグ修正 | Opus 5.5 | 0.071 | 0.097 | 0.077 | 0.118 |
| バグ修正 | Fable 5.2 | 0.113 | 0.125 | 0.106 | 0.196 |
| 小さな実装 | Sonnet 5.5 | 0.034 | 0.035 | 0.043 | 0.054 |
| 小さな実装 | Opus 5.5 | 0.051 | 0.065 | 0.082 | 0.158 |
| 小さな実装 | Fable 5.2 | 0.129 | 0.160 | 0.192 | 0.441 |
| 少し重い機能追加 | Sonnet 5.5 | 0.069 | 0.059 | 0.088 | 0.186 |
| 少し重い機能追加 | Opus 5.5 | 0.121 | 0.190 | 0.245 | 0.450 |
| 少し重い機能追加 | Fable 5.2 | 0.297 | 0.584 | 0.756 | 1.159 |
時間もコストも、出力トークンとほぼ同じ動きをしています。
effortを上げると、何が増えるのか
少し重い機能追加の課題で、中身を見てみます。
| モデル | effort | ターン数 | ツール呼び出し | 入力トークン合計 | 自分でテストを書いた回数 |
|---|---|---|---|---|---|
| Sonnet 5.5 | low | 7 | 6 | 43,805 | 3回中0回 |
| Sonnet 5.5 | medium | 3 | 2 | 29,591 | 3回中0回 |
| Sonnet 5.5 | high | 9 | 8 | 52,443 | 3回中0回 |
| Sonnet 5.5 | xhigh | 15 | 14 | 124,933 | 3回中3回 |
| Opus 5.5 | low | 3 | 2 | 29,810 | 3回中0回 |
| Opus 5.5 | medium | 8 | 7 | 73,403 | 3回中0回 |
| Opus 5.5 | high | 10 | 9 | 118,991 | 3回中1回 |
| Opus 5.5 | xhigh | 14 | 13 | 125,174 | 3回中3回 |
| Fable 5.2 | low | 3 | 2 | 35,525 | 3回中1回 |
| Fable 5.2 | medium | 9 | 8 | 56,592 | 3回中2回 |
| Fable 5.2 | high | 14 | 13 | 80,054 | 3回中3回 |
| Fable 5.2 | xhigh | 13 | 12 | 98,414 | 3回中3回 |
増えていたのは、次の3つです。
- thinking:考える量が増えます。xhighで特に増えました
-
ツール呼び出しとターン数:少ない設定では、2回のツール呼び出しで終わります。xhighでは12〜14回です。指示していないテストファイル(
test_lots.py)を自分で書いて確かめる回も増えました。xhighでは3モデルとも毎回書いています - 入力トークン:ターンが増えると、それまでの会話を毎回送り直すので入力も増えます。ただしほとんどがキャッシュの読み込みで、単価が安いのでコストへの影響は小さめです
バグ修正の課題でも、Opus 5.5とFable 5.2のxhighではファイルを読み直す回数が増えていました。
Readの呼び出しは、3回の合計で18回です(mediumは2〜6回)。
結果はどの設定でも合格
コーディングの3課題は、どのモデルのどのeffortでも隠しテストに合格しました。
108回中108回です。
lowでも全部通っています。
今回の課題では、effortを上げて増えたトークンは、結果の差にはなりませんでした。
考察
- 既定の
mediumから1段階上げるくらいなら、2〜3割増で済みます。検証が大事な作業でhighにするのは、トークンの面では気軽に選べるかなと思います - xhighにすると、トークンは一気に増えます。mediumの2.3〜2.4倍になりました。今回の課題は、xhighでなくても全部合格しました。増えた分は、確認の作業に使われていました
- lowにして減るかどうかは、モデルによります。Opus 5.5とFable 5.2は、3割ほど減りました。Sonnet 5.5は、mediumとほぼ同じでした
- 軽い作業では、effortを変えてもトークンはあまり変わりませんでした。差がはっきり出たのは、複数ファイルにまたがる機能追加でした
確かめていないこと
- 品質の差:コーディングの3課題は108回すべて隠しテストに合格しました。課題が易しく、effortによる正解率の差は測れていません。知識の質問は採点していません
- maxのeffort:測っていません
- 大きなリポジトリや長時間の作業:今回は数ファイルの小さな課題だけです。長いコーディング作業では、effortを上げると解ける割合が上がるという結果が、公式のOptimizing for cost and intelligenceに載っています
- 回数:各3回です。軽い課題の1段階の差は、ばらつきの範囲に入っています
-
effortの反映:
--effortが効いているかは、直接は確かめていません。起動時のログに値が出ない為です。thinkingのトークンがeffortに沿って増えていることから判断しています -
手元の設定を読み込んだ場合:今回は
--safe-modeで測りました。CLAUDE.mdやMCPサーバーを読み込む普段の使い方では、入力トークンがもっと多くなります - プラン契約での利用枠:利用枠の減り方が換算コストに比例するのかは確かめていません
おわりに
effortを1段階上げたときのトークンの増え方は、2〜3割でした。
一方で、xhighは2倍以上になるので、常用するかはよく考えた方がよいかなと思います。
課題によって結果は変わるので、自分の作業で一度測ってみるのが確実です。
claude -pに--output-format jsonを付ければ、同じやりかたで測れます。
少しでも皆さんのeffortを選ぶときの判断材料になれば幸いです。