
「長いプロンプトやソースコードを、テキストのまま Claude や Codex に渡す代わりに 画像にレンダリングして渡すとトークンが減って安くなる」という話を最近ちらほら見かけます。DeepSeek-OCR の論文あたりから盛り上がっているトピックで、 pxpipe などのツールもバズっていますが、「そんなうまい話ある?」と思った方も多いはず。
結論から言うと、条件付きで本当 と言えそうです。この記事では
- なぜ画像の方が安くなり得るのか (課金の仕組み)
- 各プロバイダ(Claude / OpenAI / Gemini / Qwen)の画像トークン計算式とモデル別コスト比較
- 既存研究・論文
- 実運用での落とし穴
- OSS ツール: pxpipe(プロキシ型)と ctx2img(CLI型)
をまとめてみます。
TL;DR
- 画像トークンはピクセル単位で課金され、画像内に何文字書いてあるかは無関係。テキストを密に詰め込むほど1トークンあたりの文字数が増える
- 実測で 60〜75% のトークン削減(=約3〜4倍圧縮)が現実的なライン。理論上は10倍以上詰め込めるかもしれない
- 可逆圧縮ではないので、ハッシュ値などの高エントロピー文字列は読み間違えられてしまう可能性がある
- 大量のテキストを密に詰め込んだ画像をうまく理解できるのは最新のフロンティア VLM だけ。モデル依存性が強い
1. なぜ安くなるのか
まずポイントとなるのは、Claude Code などのエージェントハーネスを用いて VLM に文字入り画像を渡したとき、モデルは画像を OCR してテキストに復元し、その復元テキスト分を再課金するわけではありません。画像はそのまま Vision Encoder で visual token(パッチ埋め込み) に変換され、そのコストは主に画像の縦横サイズで決まります。画像に何単語写っているかは課金に一切影響しません。
つまり:
- 1万語(英語で1.3万トークン超)のプロンプトをテキストで渡す → 1.3万テキストトークン
- 同じ内容を1枚の画像に詰め込んで渡す → 例えば 約3千画像トークン
モデルはその画像からテキストの大半を読み取れるのに、支払うのは画像トークン分+わずかな出力トークンだけとなり、この差の分だけお得になるというわけです。
テキストトークンは BPE (バイトペア符号化) の性質上、密なコード・JSON・ログでは 1〜2文字/トークン程度まで効率が落ちます。一方、5×8px のビットマップフォントで文字を敷き詰めた画像なら、後述の Claude の計算式で 1画像トークンあたり3文字以上(実測)を運べます。
2. 各プロバイダの画像トークン計算式
画像トークンの数え方はプロバイダごとに異なります。以下は2026年7月時点で各社ドキュメントと照合した計算式です(ctx2img が実装しているものをそのまま掲載)。
| プロバイダ | 計算式 | 上限 |
|---|---|---|
| Claude (Anthropic) |
ceil(w/28) × ceil(h/28)(28pxパッチ)≒ w×h/750
|
高解像度ティアで長辺 ≤2576px / ≤4,784 tok |
| OpenAI(gpt-4o/4.1/5 系, detail: high) | 短辺768pxに正規化後、70 + 140 × (512pxタイル数)
|
正規化後 ≤2048px |
| OpenAI mini 系(gpt-4.1-mini/5-mini) | ceil(w/32) × ceil(h/32) × 1.62 |
1,536パッチ |
| Gemini 3 |
media_resolution に応じた固定値: 280 / 560 / 1120 / 2240
|
— |
| Qwen3-VL | ceil(w/32) × ceil(h/32) + 2 |
16,384ブロック |
同じ 1568×728px のページ(pxpipe / ctx2img の Claude 向け標準ページサイズ)を渡したときの画像トークン数を比べると:
| プロバイダ | 画像トークン |
|---|---|
| Claude | 56 × 26 = 1,456 |
| OpenAI(タイル型) | 70 + 140×8 = 1,190 |
| OpenAI mini | 1,127パッチ × 1.62 ≈ 1,826 |
| Gemini 3 | 長辺1568px → 固定 2,240 |
| Qwen3-VL | 1,127 + 2 = 1,129 |
このページに 5×8px フォントで文字を敷き詰めると、約 313桁 × 91行 ≈ 2.6〜2.8万文字(半角) が入ります。同じ文字数をテキストで渡すと:
- 英語の散文(約4文字/トークン)なら 約7,000トークン → 画像の約 4.8倍
- 密なコード・ログ(実トラフィックで約1〜2文字/トークン)なら 1.4万〜2.8万トークン → 画像の約 10〜19倍
「ピクセルで課金される」性質上、内容が密であればあるほど画像が有利になるわけです。逆に言うと、スカスカな散文では逆ザヤになり得ます(後述)。
3. モデル別のトークン単価と実測コスト比較
入力トークン単価(1Mトークンあたり、2026年7月時点)
| モデル | 入力 | 出力 |
|---|---|---|
| Claude Fable 5 | $10.00 | $50.00 |
| Claude Opus 4.8 | $5.00 | $25.00 |
| Claude Sonnet 5 | $3.00($2.00 キャンペーン中) | $15.00($10.00) |
| Claude Haiku 4.5 | $1.00 | $5.00 |
| GPT-5 | $0.63 | $5.00 |
| GPT-5-mini | $0.13 | $1.00 |
| Gemini 3.1 Pro | $2.00(200k超は$4.00) | $12.00 |
| Gemini 3.5 Flash | $1.50 | $9.00 |
※ 価格は頻繁に変わるので必ず公式ページで確認してください。
実測例: 3.3万文字の設計ドキュメントを Claude に渡す
ctx2img リポジトリの実測値です。33,000文字の Markdown 設計書は、テキストだと 9,772トークン、1枚のセクションマップ画像にすると 2,550トークン(−74%)でした。これを各 Claude モデルの入力コストに換算すると:
| モデル | テキストで渡す | 画像で渡す | 差額 |
|---|---|---|---|
| Fable 5 | $0.0977 | $0.0255 | −$0.072 |
| Opus 4.8 | $0.0489 | $0.0128 | −$0.036 |
| Sonnet 5 | $0.0293 | $0.0077 | −$0.022 |
| Haiku 4.5 | $0.0098 | $0.0026 | −$0.007 |
削減率はどのモデルでも同じ74%ですが、削減額は単価の高いモデルほど大きい。そして皮肉なことに、後述の通り密な文字画像をまともに読めるのは単価の高いフロンティアモデルだけなので、「高いモデルで大量のコンテキストを食わせる」ユースケースほどこの手法が刺さります。
コーディングエージェント(Claude Code など)の実運用では、pxpipe がリクエスト全体で 請求額ベース 59〜70% 削減 を報告しています(全リクエスト・キャッシュ・出力トークン込みのend-to-end値)。
4. どこまで「読める」のか — 研究のまとめ
圧縮率と精度のトレードオフについては、この1年でいくつか報告が出ています。
- DeepSeek-OCR(arXiv:2510.18234): 圧縮率10倍未満なら 約97%の OCR 精度 を維持。"optical compression" という枠組みを最初に大きく示した論文
- LensVLM(arXiv:2605.07019): テキストQAタスクで 4.3倍圧縮時にフルテキスト同等の精度 を報告
- CodeOCR(arXiv:2602.01785): コード関連タスクの一部は 8倍圧縮まで実用的 に機能
- 一方で(arXiv:2603.09095)などは、数学や文字単位の正確さが要求されるタスクでは明確な限界 があることを示しています
まとめると、「要旨の理解・検索・QA は高圧縮でも保たれるが、一字一句の正確な再現(verbatim recall)は圧縮率に敏感」というのが現在のコンセンサスです。実運用ツールの設計もこの前提に沿っています。
5. 実運用での知見
また、pxpipe などのOSSツールが実トラフィックで数ヶ月運用して得た知見を公開しており、とても参考になります。
VLM は正確な OCR ではなく、時に不安定
画像はパッチ埋め込みになるのであって、文字単位で認識されるわけではありません。グリフごとの信頼度が存在しないため、ピクセルが曖昧なとき、モデルはエラーを出す代わりに言語事前分布から「それっぽい文字列」を補完します。読み間違いは例外ではなく、もっともらしい嘘として現れます。
高エントロピー文字列はテキストで補ったほう良い
密にレンダリングした12桁の16進文字列の完全一致読み取りは、Claude Fable 5 で 13/15、Opus 4.8 では 0/15(pxpipe 実測)。SHA・ID・シークレットなど一字も間違えられない値は画像に任せてはいけません。pxpipe / ctx2img はどちらも、正確な識別子を factsheet(テキスト)として画像に併走させる設計です。
モデル依存性が非常に強い
同じ画像でも、新規算術問題の正答率は Fable 5 で 100/100、Opus 4.8 で 93/100、Grok 4.5 で 82/100(pxpipe 実測)。モデルの世代が1つ違うだけで実用性が変わるため、対象モデルでの検証が必須です。
スカスカな散文は逆ザヤになる
散文は約3.5〜4文字/テキストトークンとすでに効率が良いので、画像化するとかえって高くつくことがあります。pxpipe は「画像化した方が安い場合だけ変換する」という安全策を実装しており、ctx2img も同様に、テキストの方が安ければ描画を拒否します。
日本語(CJK)は圧縮率が下がる
5×8px フォントで漢字は描けないため、CJK はより大きなグリフが必要になり、ASCII ほどの圧縮率は出ません(pxpipe も "CJK works but conservatively" と明記)。日本語ドキュメント主体のプロジェクトでは期待値を下げておきましょう。
6. pxpipe — プロキシとして透過的に圧縮する
pxpipe はこのアイデアを Claude Code のローカルプロキシ として実装したツールです。
npx pxpipe-proxy                                  # 127.0.0.1:47821 でプロキシ起動
ANTHROPIC_BASE_URL=http://127.0.0.1:47821 claude  # Claude Code を向ける
/v1/messages を横取りして、リクエスト内のかさばる部分 — システムプロンプト+ツール定義、古い会話履歴、巨大な tool_result — をリクエストがマシンを出る前に高密度 PNG に書き換えます。直近ターンとバイト正確性が必要な値はテキストのまま。プロンプトキャッシュも壊さないよう静的プレフィックスを保持します。
- 実測: 4.8万文字のシステムプロンプト+ツール定義が ≈2.5万テキストトークン → ≈2.7千画像トークン
- SWE-bench Lite パイロットで両アーム 10/10(リクエストサイズ −65%)
- end-to-end の請求額で 59〜70% 削減
ポイントは「アプリ側を一切変えずに透過圧縮する」という設計です。
7. ctx2img — CLI としてコンテキストを描画する
ctx2img は pxpipe の実証結果(ピクセル課金・8px 等幅フォントの可読性・識別子はテキスト併送・収益性ゲート)をもとにしつつ、より使いやすさ・有用度を向上したツールです。透過的にリクエストストリームを圧縮するのではなく、エージェントが意図的に・構造を保ったままコンテキストを摂取するための手段を提供します。
curl -fsSL https://raw.githubusercontent.com/h5i-dev/h5i-ctx2img/main/install.sh | sh

ctx2img paint <file|dir|->            # 任意のファイル・ディレクトリ → 高密度画像
echo "$PROMPT" | ctx2img paint        # プロンプトも stdin から読み込ませることができる
ctx2img paint src/auth -q "<task>"    # クエリで条件付け → 関連度を色で表現
ctx2img read F103 --lines 40:120      # 正確なテキストが必要な時のズームイン
特に大きいのが最後の3点です。
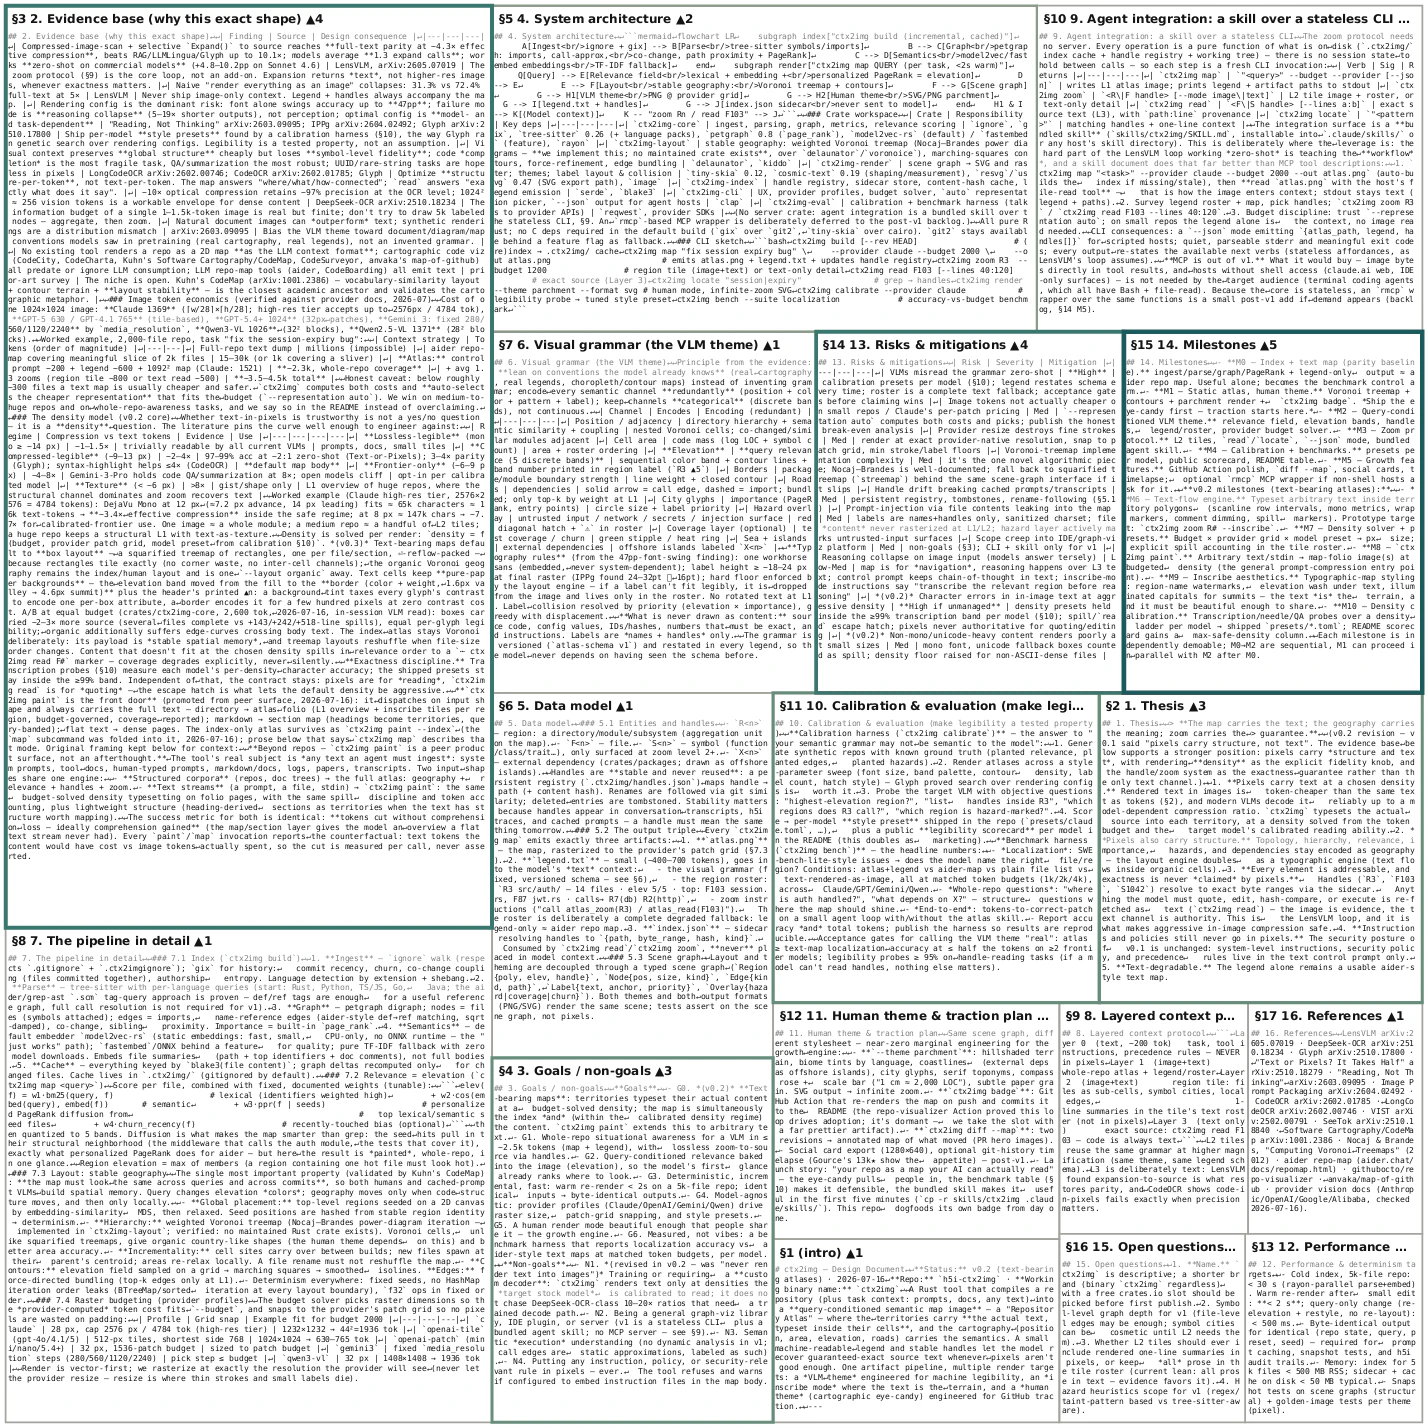
- 構造化テキスト・複数ファイルのディレクトリをタイル分割して敷き詰められる (記事冒頭の写真を参照)。 Markdown はセクションごと、リポジトリはモジュールごとに1つの箱になり、モデルは構造を空間的に読める。14ファイルの crate が 2.6k トークンの1タイルに収まる例も
-
検索語との関連度が枠の色に出る。
-q "auth session"のように渡すと、字句一致+埋め込み+personalized PageRank で関連度フィールドを計算し、各タイルの枠色・太さ・バンド番号が変わる。モデルは「どこを読むべきか」を1枚の画像から判断できる -
プロキシではなく CLI なので、エージェントの「スキル」としてそのまま使える。 Claude Code なら
cp -r skills/ctx2img ~/.claude/skills/を実行するだけ。プロキシを立てる必要も、API リクエストを書き換える権限も不要で、エージェント自身が「この大きなドキュメントは画像で読もう」と判断して呼び出せる
そして pxpipe 同様、毎回カウンターファクチュアルを出力し、テキストの方が安い場合は画像化を拒否します。
8. まとめ
| Q | A |
|---|---|
| 画像にするとトークンは減る? | 減る。 密なコンテンツで3〜4倍(実測)、理論上は10倍超 |
| なぜ? | 画像はピクセル寸法で課金され、文字数と無関係だから |
| 精度は落ちない? | 要旨理解・QA は 4〜10倍圧縮まで概ね維持(arXiv:2510.18234 ほか)。一字一句の再現は落ちるので、複雑な部分 (ハッシュ値など) はテキスト併送を要件等 |
| どのモデルでも使える? | No。 フロンティアモデル(Claude Fable 5 など)でのみ実用レベル。モデルごとの検証必須 |
| 何でも画像化すべき? | No。 散文は逆ザヤになり得る。収益性比較を必ず入れるべき |
「テキストを画像で渡す」は一発ネタではなく、課金モデルの非対称性を突いた、条件付きで再現性のある最適化です。プロキシで透過的にやりたいなら pxpipe、エージェントのスキルとして構造化コンテキスト(リポジトリ・ドキュメント・ディレクトリ)を画像化したいならぜひ ctx2img を試してみてください。