
こんにちは。コロンビア大学の博士課程でシステムセキュリティの研究をしている Koukyosyumei です。
最近開発している h5i という Rust 製 Web フレームワークの一環として、組み込み機器向けの小さな HTTP/1.1 サーバーを実装し、そのプロトコル処理部分を Lean 4 で形式検証しました。成果物は h5i-app-h1 として公開しており、以下のような特徴を持っています:
- Rust の
#![no_std]に対応し、ヒープアロケーションを使用しない - HTTP プロトコル処理部分は外部依存ライブラリなし
- 固定長バッファを使用して HTTP/1.1 のリクエストを処理
-
Content-LengthとTransfer-Encoding: chunkedに対応 - Rust の実装を Charon / Aeneas で Lean 4 に変換し、リクエストの解析、body のデコード、TCP の読み込み分割に依存しない動作などの正しさを形式検証
この記事では、そもそもなぜ組み込み機器に HTTP サーバーが必要なのか、HTTP/1.1 がどのように動作するのか、そして実際に何を Lean 4 で証明したのかを紹介します。
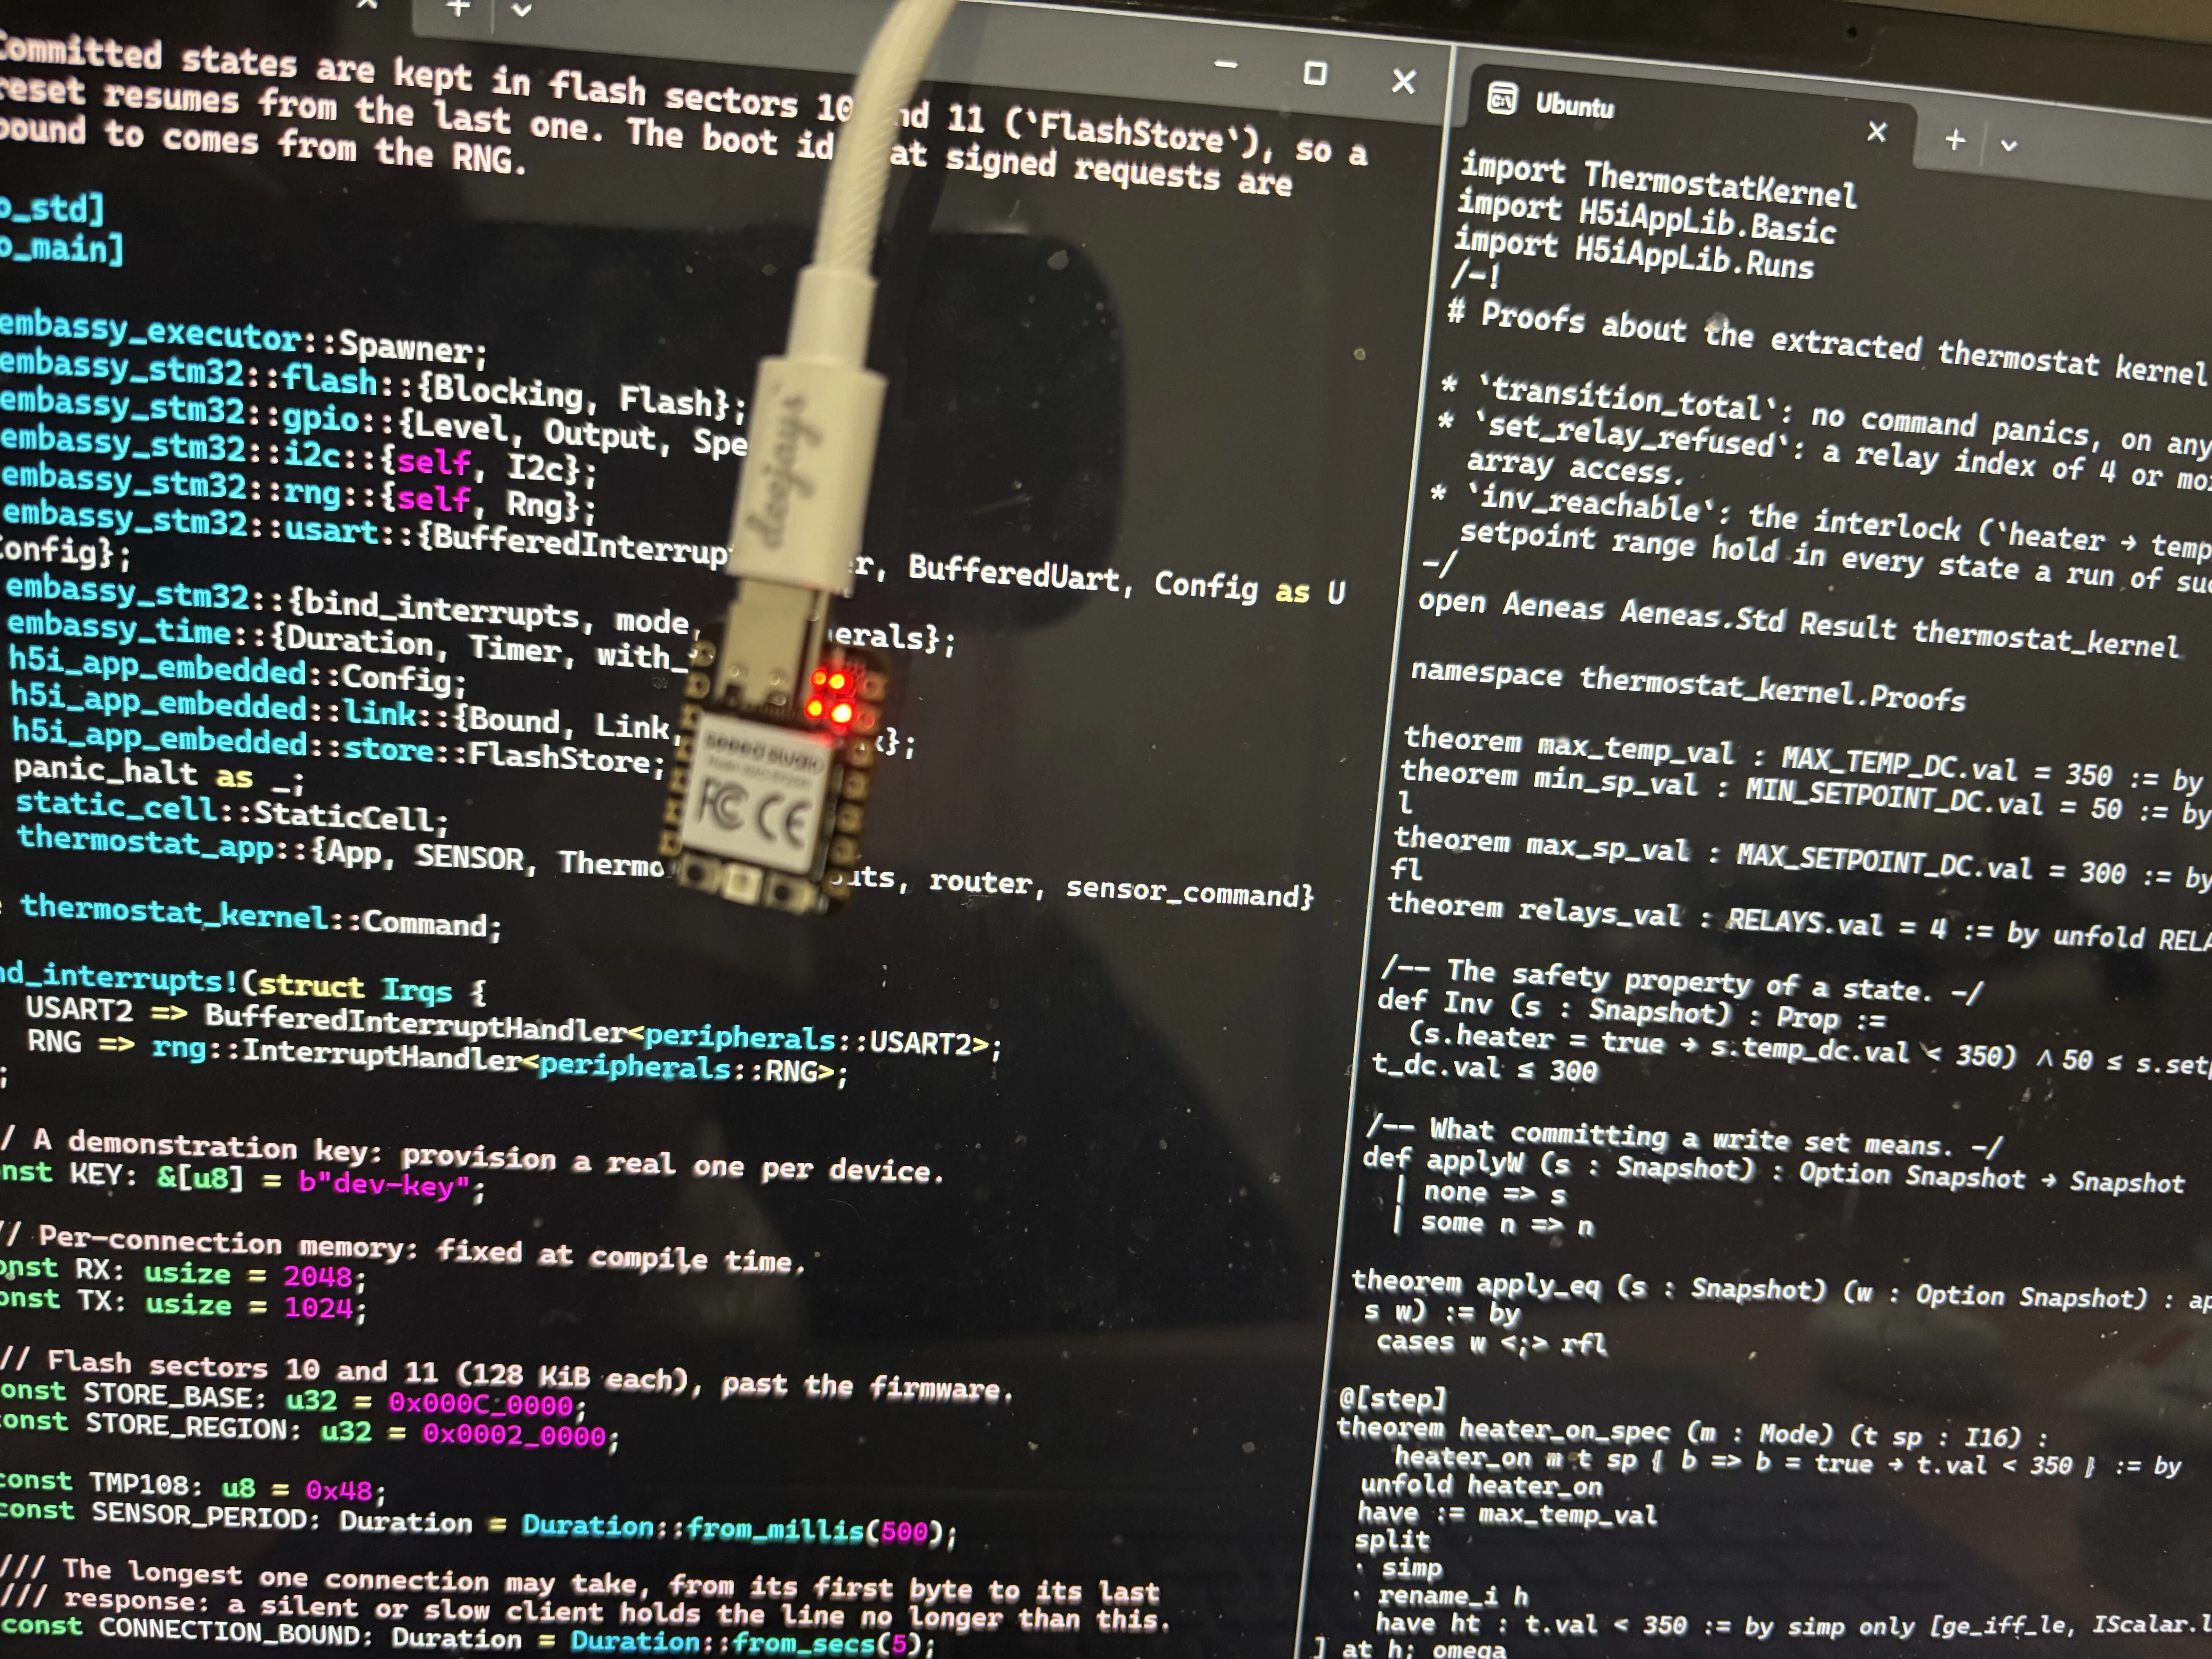
実際に、Rustで実装し、Lean 4で検証したプログラムをSeeed Studio XIAO RP2040で動かした例
1. 組み込み機器におけるHTTP サーバーの役割
例えば、自宅に温度センサーやサーモスタットを設置したとしましょう。現在の温度を確認したり、エアコンの設定温度を変更したりするには、どのようなインターフェースを用意すればよいでしょうか。
本体にディスプレイやボタンを付ける方法もありますし、専用のスマートフォンアプリを開発する方法もあります。クラウドサーバーを経由して操作することも可能でしょう。しかし、もっと単純な方法として、デバイス自身に小さな HTTP サーバーを動かし、ユーザーのブラウザから操作できるようにするという選択肢があります。
例えば、デバイスの IP アドレスが 192.168.1.42 なら、同じ LAN に接続したスマートフォンから http://192.168.1.42 にアクセスするだけで設定画面を開けます。
       スマートフォン / PC
      ┌──────────────────────┐
      │       Browser        │
      │                      │
      │   現在温度: 24°C     │
      │   設定温度: 22°C     │
      │   [ 設定を保存 ]     │
      └──────────┬───────────┘
                 │
              HTTP/1.1
              (Wi-Fi)
                 │
      ┌──────────▼───────────┐
      │    Microcontroller   │
      │                      │
      │    HTTP Server       │
      │         ↓            │
      │    制御ロジック      │
      │         ↓            │
      │    センサー / GPIO   │
      └──────────────────────┘
ブラウザ側で HTML、CSS、JavaScript を使って UI を表示し、デバイス側では HTTP リクエストに応答するだけです。例えば、以下のような API を用意できます。
GET  /                 Web UI を返す
GET  /api/temperature  現在の温度を返す
POST /api/temperature  設定温度を変更する
HTTP を使えば、専用アプリをインストールしなくてもブラウザからアクセスでき、既存の HTTP クライアントや curl などもそのまま利用できます。この構成では、デバイスの設定や状態確認のために専用アプリやクラウドサーバーを用意する必要がなく、インターネット接続がない環境でも利用できます。このような仕組みは、スマート家電のみならず、ネットワーク機器、3D プリンター、産業用コントローラー、センサーなどでも役立ちます。
一方で、組み込み機器には通常のサーバーとは異なる制約があります。例えば、マイコンによっては RAM が数十〜数百 KB 程度しかなく、OS やヒープアロケータが存在しないこともあります。このような環境では、一般的な Web サーバーをそのまま動かせるとは限らず、より最小限の機能に絞ったHTTPサーバーが必要になります。
2. モチベ
私は現在、Lean 4 による形式検証を統合した Rust 製 Web フレームワーク h5i を開発しています。h5i では、アプリケーションの重要なロジックを数学的に検証し、そのロジックを通常の Web サーバーだけでなく、組み込み機器や GPU など異なる環境でも再利用できる仕組みを目指しています。
通常のサーバーであれば、Axum、Hyper、Tokio といった成熟した Rust のエコシステムをそのまま利用できます。これらは多くの開発者に利用され、継続的に開発・テストされており、普通の Web アプリケーションであれば、HTTP サーバーを自作する理由はほとんどありません。
しかし、組み込み機器では話が変わります。例えば、動的メモリ確保が使えない場合、以下のようにあらかじめ固定長バッファを用意する必要があります。
let mut rx = [0u8; 2048];
let mut tx = [0u8; 1024];
そして、HTTP リクエストの受信、解析、レスポンスの生成を、この限られた領域で行う必要があります。このため、通常の Web サーバーとは異なる実装上の工夫が必要になりがちです。
もちろん、組み込み向けの優れた HTTP サーバーは既に存在します。特に picoserve は、非同期・no_std・ヒープアロケーションなしで動作する非常によくできた Rust 製 HTTP サーバーです。ただし、組み込み向け HTTP ライブラリは、Hyper のような一般的なサーバー基盤と比べると、ユーザー数や本番環境での利用実績が限られる傾向があります。
さらに h5i では、HTTP プロトコルを処理するコードそのものを Lean 4 で検証したいという目的がありました。既存の実装を形式検証することも可能ですが、その場合は既存コードの複雑な制御フローや、今回必要としていない機能まで理解してモデル化する必要があります。そこで、必要な HTTP/1.1 の機能だけを小さく実装し、最初から形式検証しやすい構造にした方がよいのではないかと考えました。こうして開発したのが h5iプロジェクトの一部である、h5i-app-h1 です。
3. HTTP/1.1 の仕組み
実装について説明する前に、HTTP/1.1 の仕組みを簡単に整理します。HTTP は、クライアントがリクエストを送信し、サーバーがレスポンスを返すプロトコルで、常 TCP 上で動作し、比較的単純なテキストベースのメッセージ形式を採用しています。
例えば、温度を取得するリクエストは以下のようになります。
GET /api/temperature HTTP/1.1
Host: device.local
最初の行には、HTTP メソッド、パス、HTTP バージョンが含まれています。 Host は接続先のホストを指定するヘッダーです。
サーバーは以下のようなレスポンスを返します。
HTTP/1.1 200 OK
Content-Type: application/json
Content-Length: 18

{"temperature":24}
Content-Type はレスポンスの形式、Content-Length は body のバイト数を指定します。実際の HTTP/1.1 では、行末には \r\n が使用され、ヘッダーと body は \r\n\r\n で区切られます。
Content-Length と chunked encoding
HTTP リクエストには body が含まれることもあります。例えば、設定温度を変更するリクエストは以下のようになります。
POST /api/temperature HTTP/1.1
Host: device.local
Content-Length: 2

22
この場合、サーバーはヘッダーの終わりからちょうど 2 バイトを body として読み取ります。
一方、HTTP/1.1 には Transfer-Encoding: chunked という仕組みもあります。これは、body 全体のサイズを最初に指定する代わりに、複数のチャンクに分割して送信する方式です。例えば先ほどの body は、次のようにも表現できます。
POST /api/temperature HTTP/1.1
Host: device.local
Transfer-Encoding: chunked

2
22
0
実際の body のバイト列は以下のようになります。
2\r\n22\r\n0\r\n\r\n
最初の 2 はチャンクサイズを 16 進数で表し、最後の 0 は body の終わりを示しています。ここで注意すべきなのは、TTP メッセージとして受信したバイト数と、アプリケーションに渡す body のバイト数が一致しないことです。上の例では、デコード後の body は 22 の 2 バイトですが、エンコードされた body は 12 バイトです。この違いを正しく管理しないと、次のリクエストを誤って処理する可能性があります。
TCP の read は HTTP リクエストの境界と一致しない
もう一つ重要なのが、TCP はメッセージ単位ではなく、バイトストリームを提供するという点です。例えば、クライアントが以下の HTTP リクエストを送信したとします。
POST /api/temperature HTTP/1.1\r\n
Host: device.local\r\n
Content-Length: 2\r\n
\r\n
22
サーバー側の read が必ずこのリクエスト全体を一度に返すとは限りません。例えば、以下のように分割される可能性があります。
Read 1: POST /api/temperature HTTP/1.1\r\nHo
Read 2: st: device.local\r\nContent-Len
Read 3: gth: 2\r\n\r\n22
逆に、一度の read で複数の HTTP リクエストがまとめて届くこともあります。HTTP/1.1 は persistent connection をサポートしており、一つの TCP 接続で複数のリクエストを処理できます。したがって、HTTP サーバーは以下を正しく管理しなければなりません。
- まだリクエスト全体が届いていない場合は、追加のデータを待つ
- リクエストが完成したら、正しい位置で処理を終了する
- 次のリクエストに属するバイト列を消さずに保持する
リクエスト境界の解釈が異なる HTTP コンポーネントを組み合わせると、HTTP Request Smuggling のような脆弱性につながることもあります。そこで、今回の実装ではこのような性質を Lean 4 で証明することにしました。
4. Rust による HTTP サーバーの実装
実装は大きく二つのコンポーネントに分かれています。h5i-app-h1 は HTTP リクエストの解析、body のデコード、レスポンスヘッダーの生成などを担当します。h5i-app-embedded は、その周囲で非同期 I/O、ルーティング、アプリケーションロジックなどを処理します。サーバーの処理を簡略化した Rust 風の疑似コードで示すと、以下のようになります。
let mut rx = [0u8; 2048];
let mut filled = 0;
let mut state = recv_start();

loop {
    // 受信済みデータを処理する
    let (next_state, action) =
        recv_step(state, &mut rx, filled, eof, &limits);

    state = next_state;

    match action {
        NeedRead => {
            // 追加のデータを受信する
            let n = socket.read(&mut rx[filled..]).await?;
            filled += n;
        }

        Ready(head, start, end, used) => {
            // HTTP リクエストが完成した
            let body = &rx[start..end];

            let response = handle_request(head, body);
            send_response(response).await?;

            // 次のリクエストに属するバイトを残す
            filled = carry(&mut rx, used, filled);
            state = recv_start();
        }

        Reject(status) => {
            send_error(status).await?;
            break;
        }

        Eof => break,
    }
}
上記の例は、説明用の疑似コードで、実際の実装では EOF、バッファの上限、エラー処理なども扱っています。
この設計では、recv_step 自身はネットワークからの読み込みを行いません。既に受信したバイト列を解析し、追加の読み込みが必要なのか、リクエストが完成したのか、エラーなのかを返すだけです。概念的には、次のような処理になります。
recv_step(buffer, state):

    if ヘッダーの解析が終わっていない:
        ヘッダーを解析する

        if データ不足:
            return NeedRead

        if 不正なヘッダー:
            return Reject

        body の framing を決定する

    body を読み取り、必要ならデコードする

    if データ不足:
        return NeedRead

    if 不正な body:
        return Reject

    return Ready(
        headers,
        body_start,
        body_end,
        request_end
    )
body_end と request_end の違い
ここで少し重要なのが、Ready が返す end と used の違いです。
-
start: デコード後の body の開始位置 -
end: デコード後の body の終了位置 -
used: HTTP メッセージ全体の終了位置
通常の Content-Length では end と used は一致します。しかし、chunked encoding では一致しません。例えば次のバイト列を考えます。
[ HTTP headers ][ 2\r\n22\r\n0\r\n\r\n ][ next request ]
                 ^                       ^
                start                   used

デコード後の body: "22"
                       ^
                      end
実装では、chunked encoding のデコードを同じ受信バッファ内で行うため、追加のメモリ確保が不要です。一方で、どこまで読み込み、どこまで書き換えたかを正確に管理する必要があります。今回の形式検証では、こうしたバッファ操作の正しさも証明しています。
5. Lean 4 による検証
h5i では、Rust の実装を Lean 4 に変換するために Charon と Aeneas を利用しています。全体の流れは以下のようになります。
      Rust implementation
               │
               ▼
             Charon
               │
               ▼
             Aeneas
               │
               ▼
       Extracted Lean 4 code
               │
               │ Correctness proof
               ▼
       Independent Lean spec
               │
               ▼
           Lean 4 proofs
ここで重要なのは、実際に使用する Rust の関数を Lean 4 に変換し、その関数が別途記述した仕様を満たすことを証明しています。
例えば、HTTP ヘッダー解析の仕様では、どのようなバイト列を受理し、どのようなヘッダー構造を返すべきかを定義します。そして、Rust の parse_head の変換結果がその仕様に一致することを証明します。Aeneas による変換では、失敗し得る Rust の操作も明示的に表現されるため、検証対象の関数で想定外の panic が発生しないことも示せます。
組み込み向け HTTP サーバーの実装に起因する脆弱性は過去にも数多く報告されており、このような形式検証による保証はとても重要であると考えています。例えば、組み込み向け Web サーバーとして知られる Mongoose では、2026年に Content-Length と Transfer-Encoding の解釈の不整合に起因する HTTP Request Smuggling の脆弱性(CVE-2026-73257)が報告されました。また、Weston Embedded の uC-HTTP では、HTTP ヘッダーの解析やバッファ長の管理に起因する複数のメモリ破壊脆弱性が報告されています(CVE-2023-24585、CVE-2023-45318 など)。このように、HTTP サーバーは一見単純でも、メッセージ境界の解釈やバッファの管理を誤ると、実際のセキュリティ脆弱性につながることがあります。
6. 実際に何を証明したのか?
ここからは、実際の Lean 4 の仕様を見ながら説明します。
今回の主な証明は、以下のファイルに含まれています。
- H1Spec.lean: HTTP ヘッダーの仕様
- H1Body.lean: chunked body の仕様
- H1Read.lean: body の読み込みとバッファ操作
- H1Recv.lean: HTTP リクエストの受信ループ
以下の Lean 風のコードは、実際の仕様を読みやすく整理した疑似コードです。正確な定義や証明の条件についてはリンク先をご参照ください。
6.1 HTTP リクエストの受信結果を仕様化する
まず、受信したバイト列に対して、HTTP サーバーが何を返すべきかを定義します。実際の実装では、H1Recv.lean に recvS という純粋関数が定義されています。この仕様は、概念的には以下のようになります。
-- 説明用に簡略化した仕様
def recvSpec (input : List Byte) : Decision :=
  match parseHeadSpec input with
  | .reject status =>
      .reject status

  | .incomplete =>
      .needRead

  | .done head =>
      decodeBodySpec head (input.drop head.len)
実際の recvS には、バッファ容量、ヘッダーサイズ制限、body サイズ制限、EOF の状態も渡されます。例えば Content-Length: n の場合、body の仕様は次のようになります。
-- ヘッダーの長さを h とする

if h + n > buffer_capacity:
    Reject(413)

if 受信済み body が n バイト未満:
    NeedRead

otherwise:
    payload = input[h .. h+n]
    start   = h
    end     = h+n
    used    = h+n
    Ready(...)
chunked encoding の場合は、後述する Spec.dechunk を使って、デコード後の payload と、実際に消費したバイト数を求めます。この仕様に対し、recv_step_spec という定理で、Rust から変換された recv_step が仕様通りに動作することを証明しています。
6.2 Chunked encoding のデコード結果が正しいこと
次に、chunked encoding を考えます。Rust の実装は、受信したバイトを一つずつ処理する状態機械になっています。しかし、その状態機械をそのまま Lean 4 に書き直した仕様では、実装と仕様が同じ間違いをしてしまう可能性があります。そこで、H1Body.lean では Spec.dechunk という別の抽象度の仕様を用意しています。戻り値は次の三種類です。
-- 実際の DR 型を簡略化
inductive DecodeResult where
  | more
  | reject (status : Nat)
  | done (payload : List Byte) (consumed : Nat)
例えば、次の入力を考えます。
4\r\nheat\r\n0\r\n\r\nNEXT
この場合、期待する結果は以下です。
payload  = "heat"
consumed = 14
remaining = "NEXT"
ここで consumed が 4 ではなく 14 であることが重要です。Rust 側の chunk_step はバイト単位で状態を更新します。一方、Lean の Spec.dechunk は body 全体の構造から結果を定義します。feed_dechunk という定理では、chunk_step を各バイトに順番に適用した結果と、Spec.dechunk の結果が一致することを証明しています。さらに、実際の Rust の body 読み込み関数がこの仕様と一致することを H1Read.lean で証明しています。
6.3 In-place decoding がバッファを壊さないこと
もう少し実装寄りの性質も証明しています。今回のサーバーは、追加のバッファを確保せず、受信バッファ内で chunked body をデコードします。そこで、以下の二つの位置を管理しています。
r = エンコードされた入力をどこまで読んだか
w = デコード後のデータをどこまで書いたか
このとき、少なくとも以下の不変条件が必要です。
$$
\mathrm{start} \leq w \leq r \leq \mathrm{filled}
$$
つまり、まだ読み込んでいないバイトを上書きしてはいけません。実際の ChunkInv はこれだけでなく、次のような性質も含みます。
ChunkInv(buffer, wire, state, r, w):

    start <= w <= r <= filled

    buffer[start .. w]
        = これまでにデコードされた payload

    buffer[r .. filled]
        = まだ処理していない wire bytes

    state
        = wire の処理済み prefix から得られる状態
この不変条件を使い、デコードループの各ステップで未処理領域が壊れないことを証明します。そして、デコードが完了した場合には、以下が成立します。
buffer'[start .. end] = decoded_payload

end  = start + decoded_payload.length
used = start + consumed_wire_bytes

start <= end <= used <= filled

buffer'[used .. filled]
    = buffer[used .. filled]
最後の条件が特に重要であり、HTTP リクエストの終了位置以降のデータが書き換わらないため、後続のリクエストが同じ受信バッファに含まれていても、そのデータを保持できます。また dechunk_local では、body の終わりが確定した後、その後ろに任意のバイト列を追加してもデコード結果が変わらないことを証明しています。
6.4 TCP の read 分割に結果が依存しないこと
先ほど説明した通り、TCP では同じバイト列がどのような単位で read されるかは保証されません。例えば、以下の二つのケースを考えます。
Case A:

Read 1: "POST /state HTTP/1.1\r\n"
Read 2: "Host: device.local\r\n"
Read 3: "Content-Length: 4\r\n\r\nheat"
Case B:

Read 1: "POST /state HTTP/1.1\r\nHost: device.local\r\nContent-Length: 4\r\n\r\nheat"
どちらも同じ HTTP リクエストなので、サーバーの結果は同じになるべきです。H1Recv.lean では、受信ループを抽象化した Drive というモデルを定義しています。これは recv_step が NeedRead を返した場合に、次の受信データをバッファに追加し、再び recv_step を呼び出す処理を表します。そして drive_split という定理で、以下の性質を証明しています。
二つの read 列を xs, ys とすると、
$$
\operatorname{flatten}(xs) = \operatorname{flatten}(ys)
$$
かつ、EOF に関する条件が一致する場合、
$$
\operatorname{observe}(\operatorname{Drive}(xs)) = \operatorname{observe}(\operatorname{Drive}(ys))
$$
が成り立ちます。ここで observe は、HTTP の処理結果とデコード済み payload を含む観測結果です。さらに、最終的な filled の値が一致することも証明しています。
6.5 次の HTTP リクエストを正しく保持すること
HTTP/1.1 では、複数のリクエストが同じ TCP 接続を使う場合があります。例えば、以下のようなバイト列を一度に受信した場合を考えます。
[ Request A ][ Request B ]
             ^
             used
Request A を処理した後、Request B のバイト列を残しておかなければなりません。実装では carry という関数を使い、used 以降のバイト列を受信バッファの先頭に移動するため、以下のような動作を期待します。
Before:

buffer = RequestA ++ RequestB
used   = length(RequestA)

After carry:

buffer'[0 .. newFilled] = RequestB
newFilled = filled - used
これを carry_spec で証明しています。さらに drive_next では、受信ループ全体と carry を組み合わせ、次のリクエストの初期状態が正しく構築されることを示しています。
数学的には、受信したバイト列を (L) としたとき、
$$
L_{\mathrm{next}} = L.\operatorname{drop}(\mathrm{used})
$$
が成り立つことに相当します。
6.6 HTTP Request Smuggling に関係する性質
HTTP/1.1 では、ヘッダーの解釈が曖昧になることがあります。例えば、以下のようなリクエストです。
Content-Length: 10
Transfer-Encoding: chunked
HTTP コンポーネントによって解釈するメッセージ境界が異なると、HTTP Request Smuggling の原因になることがあります。そこで h5i-app-h1 では、あえて受理する HTTP/1.1 の文法を制限し、以下のような状況を拒否します。
-
Content-LengthとTransfer-Encodingの同時指定 - 重複した
Content-Length - ヘッダー名と
:の間の空白 - 古い形式のヘッダー折り返し
- 不正な chunked encoding
Lean 4 の accept_wellformed では、受理したリクエストのヘッダー構造について代表的な条件を証明しています。
parseHead(input) = Done(head) ならば:

    HTTP/1.1 では Host がちょうど一つ

    count(Content-Length) <= 1

    count(Transfer-Encoding) <= 1

    Content-Length と Transfer-Encoding は共存しない

    Framing はヘッダーの内容と一致する
さらに H1Smuggle.lean では、HTTP ヘッダーを解釈する複数のパーサーをモデル化しています。これらは、改行コード、重複ヘッダー、空白の扱い、framing header の優先順位などが異なります。no_smuggling という定理では、h5i-app-h1 が受理するリクエストについては、モデル化したパーサー群が同じヘッダー長と framing を返すことを示しています。
6.7 HTTP レスポンスの生成も検証する
リクエストの受信だけでなく、レスポンスヘッダーを生成する処理についても検証しています。Lean 4 側では Spec.renderHead という仕様を定義し、ステータスコード、Content-Type、Content-Length などから期待するバイト列を生成します。例えば、次のようなヘッダーです。
HTTP/1.1 200 OK
Content-Type: application/json
Content-Length: 18
write_head_spec では、Rust のレスポンス生成関数が成功した場合、以下が成立することを証明しています。
written = Spec.renderHead(...)

returnedPosition = length(written)

outputBuffer[0 .. returnedPosition] = written

outputBuffer[returnedPosition ..]
    は変更されない
さらに、追加ヘッダーを書き込む write_field についても、フィールド名や値の妥当性、予約されたヘッダー名の拒否、バッファの非変更領域などを証明しています。
7. 実際に動かしてみる
h5i-app-h1 は HTTP プロトコル処理部分なので、実際の HTTP サーバーとして動かす場合には h5i-app-embedded を利用します。サンプルとして、温度を管理するサーモスタットの実装を用意しています。
git clone https://github.com/h5i-dev/h5i.git
cd h5i/examples/embedded

cargo run -p thermostat-host
起動後、別のターミナルから以下を実行できます。
curl http://127.0.0.1:8080/state
サーモスタットには、現在の温度や動作状態を取得する API などが実装されています。さらに、同じアプリケーションロジックを STM32F407 向けのファームウェアとしてビルドし、Renode 上で動作させるサンプルもあります。この構成では、マイコン側の HTTP 処理を UART 経由でホストの TCP ゲートウェイに接続しています。また、HTTP の処理だけでなく、サーモスタットの制御ロジックも別途 Lean 4 で検証しており、例えば、初期状態から到達可能な状態について、報告された温度が 35°C 以上の場合にはヒーターが無効になる、という安全性を証明しています。
8. 形式検証の限界
今回の Lean 4 の証明では、HTTP プロトコル処理の重要な部分をカバーし、具体的には、リクエストヘッダーの解析、chunked body のデコード、受信状態の遷移、リクエスト境界、バッファ操作、レスポンスヘッダーの生成などを検証しています。
しかし、HTTPサーバー全体の正しさを示したわけではなく、例えば、以下は検証の対象外、または外部の前提条件となっています。
- 実際のネットワーク I/O とドライバ
- 非同期ランタイムやタイムアウト処理
- ルーティングやアプリケーションハンドラー
- 一部のレスポンス処理
- ハードウェアとのインターフェース
- Charon / Aeneas の変換処理自体の正しさ
例えば drive_split の証明では、ネットワークから受信したバイト列が正しくバッファに追加されることを前提としており、これが現実の I/O 実装で守られているかについては、別途確認する必要があります。
9. まとめ
通常の Web アプリケーションを開発する場合、HTTP サーバーを自作する必要はほとんどありません。Rust には Axum や Hyper などの成熟した実装がありますし、組み込み向けにも picoserve のような優れたプロジェクトがあります。
しかし今回の h5i では、限られたメモリ環境で動作することに加え、HTTP プロトコルを処理する実装そのものを Lean 4 で検証したいという目的がありました。そのため、必要な機能に限定した HTTP/1.1 サーバーを自分たちで実装することにしました。
実装自体は、基本的にはバイト列の操作、整数のオフセット計算、状態遷移の組み合わせであり、こうした低レベルの処理に対して、実際の Rust コードと独立した仕様の対応を Lean 4 で証明することができました。
今後は、ネットワーク I/O などの trusted boundary をさらに小さくすることや、追加のプロトコル性質の検証、実機での動作確認などにも取り組みたいと考えています。h5i では、Web アプリケーションだけでなく、組み込みシステムなどでも形式検証を実用的に利用できるようにすることを目指しています。興味があれば、ぜひコードや証明を見ていただけるとうれしいです。