
初めに
データパイプラインを運用していると、「毎回テーブル全体を処理するのは無駄が多い」と感じたことはないでしょうか。数百万行のテーブルでも、実際に変更されるのは数パーセント程度というケースは珍しくありません。
Xplentyの CDC(Change Data Capture)Database Source は、まさにこの課題を解決するためのコンポーネントです。先行のパイプライン実行時からの「差分」だけを検出し、追加・更新されたレコード(Upsert)と削除されたレコード(Delete)を分離して出力します。これにより、処理時間とリソース消費を大幅に削減できます。
本記事では、CDC Database Source の仕組み、設定手順、ユースケース、そして運用上の注意点まで、実務で必要な情報を網羅的に解説します。
CDC Database Source の基本的な仕組み
CDC Database Source は「スナップショット比較方式」を採用しています。パイプラインを実行するたびに、ソーステーブルの現在の状態を前回保存したスナップショットと比較し、差分を検出します。
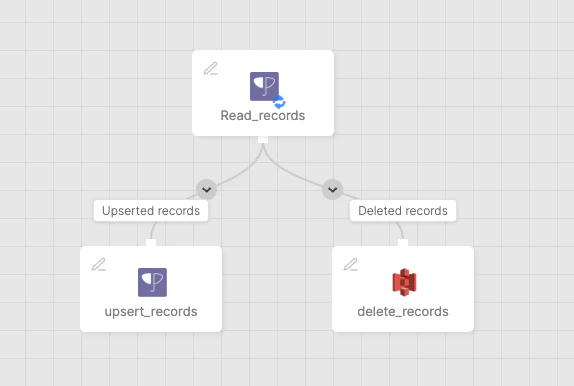
このコンポーネントは、常に 2 つの出力 を生成します。
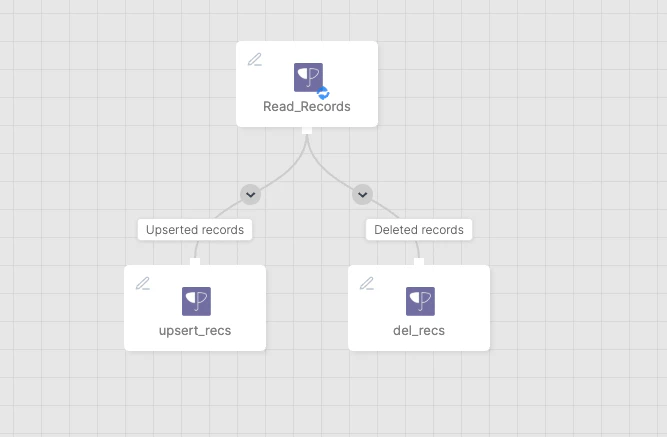
- Upserted records(追加・更新レコード):前回のスナップショットに存在しなかった新規行、または値が変化した既存行が含まれます。
- Deleted records(削除レコード):前回のスナップショットには存在していたが、現在のソーステーブルからは消えている行が含まれます。
これら 2 つの出力を、それぞれ異なるデスティネーションに送ったり、異なる変換ロジックで処理したりすることが可能です。
動作の流れは次のとおりです。
- 現在のテーブルとスナップショットを、指定した主キーで突合する
- 現在のテーブルにのみ存在する行 → 新規レコード(Upserted)
- 両方に存在するが値が変化している行 → 更新レコード(Upserted)
- スナップショットにのみ存在する行 → 削除レコード(Deleted)
なお、初回実行時はスナップショットが存在しないため、ソーステーブルのすべてのレコードが Upserted records として出力されます。これは正常な動作です。
CDC Sourceで知っておくべき概念
1. スナップショットの保存方式:File BasedとDatabase
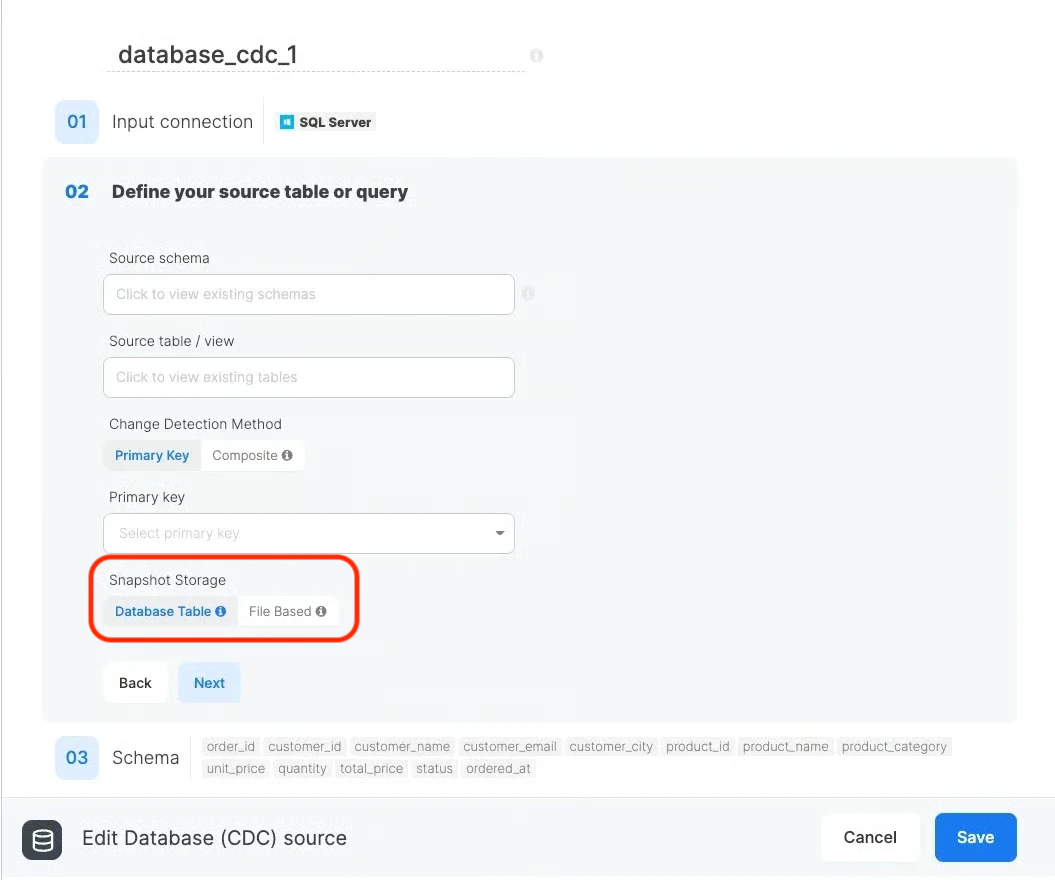
スナップショットの保存先は、コンポーネント設定画面の Snapshot Storage トグルで選択します。選択肢は「Database」と「File Based」の 2 種類です。
| 接続タイプ | File Based | Database |
|---|---|---|
| SQL Server | O | O |
| MySQL | O | X |
| PostgreSQL | O | X |
| Snowflake | O | X |
| その他のDB | O | X |
File Based ストレージ(全データベース対応)
スナップショットを Xplentyが管理するクラウドストレージ上に Parquet ファイルとして保存する方式です。ソースデータベースへの書き込み権限は不要で、読み取り権限のみで利用できます。
S3 接続などを別途設定する必要はなく、Xplentyの管理ストレージが自動的に使用されます。スナップショットファイルはパイプラインの実行が成功するたびに自動で上書きされるため、メンテナンスも不要です。
Database ストレージ(SQL Server 専用)
スナップショットをソースデータベース内にテーブルとして直接保存する方式です。変更検出のクエリがデータベース内部で SQL として実行されるため、処理効率が高いのが特長です。
ただし、この方式が利用できるのは SQL Server 接続の場合のみ です。また、ソースデータベースへの書き込み権限(CREATE TABLE および INSERT / DELETE)が必要になります。
スナップショットテーブルは、ソーステーブルと同じスキーマ内に自動的に作成されます。テーブル名の命名規則は以下のとおりです。
| 変更検出方式 | スナップショットテーブル名 |
|---|---|
| Primary Key | {テーブル名}_integrate_io_snapshot |
| Composite Hash | {テーブル名}_integrate_io_snapshot_composite |
接続タイプ別の対応状況
SQL Server を使用していて書き込み権限がある場合は Database ストレージを選ぶと、変更検出がデータベース内で完結するため最も効率的です。それ以外のケース(SQL Server 以外のデータベース、読み取り専用アカウント、本番 DB にテーブルを追加したくない場合など)は File Based ストレージを選択してください。
2. 変更検出方式:Primary KeyとComposite Hash
CDC Database Sourceには、変更を検出するためのロジックとして2つの方式が用意されています。
Primary Key 方式
テーブルに一意のキー列(id、customer_id、order_number など)がある場合に適した方式です。
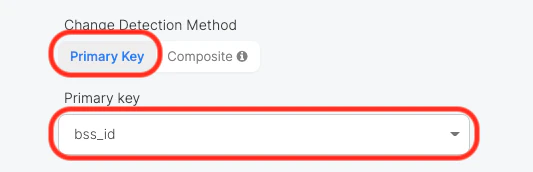
設定は、Change Detection Methodで「Primary Key」を選び、ドロップダウンからキー列を選択するだけです。
File Basedストレージと組み合わせる場合は、主キー以外の全列からMD5ハッシュが自動生成され、行の変更有無を効率的に判定します。
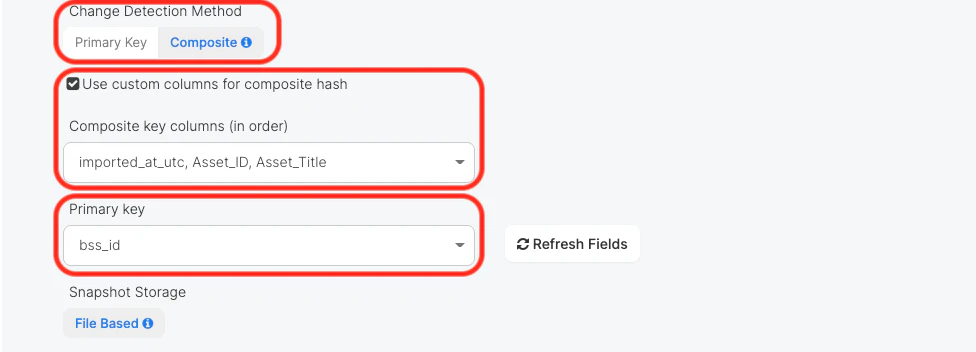
Composite Hash方式
テーブルに信頼できる一意キーがない場合や、特定の列の変更だけを追跡したい場合に適した方式です。
この方式では、指定した列(またはすべての列)の値からハッシュ値(フィンガープリント)を生成し、スナップショットに保存されたハッシュ値と比較して変更を検出します。
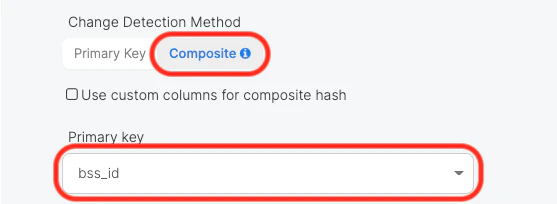
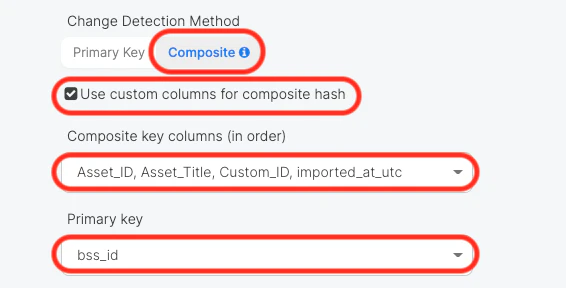
設定時のオプションは以下のとおりです。
| オプション名 | 有効化 | 機能 |
|---|---|---|
| Use custom columns for composite hash | チェックボックスの入れ | ハッシュ生成に使用する列を個別に指定できます。チェックを外すとすべての列が使用される |
| Composite key column | ドロップダウンボックスで複数のフィールドを選択 | 変更されたハッシュが「更新」なのか「削除+挿入」なのかを区別するための列です |
| Primary key(任意) | ドロップダウンボックスでキーフィールドを選択 | Compositeモードでも主キーを指定すると、更新と削除の区別がより正確になる |
主キーや Composite key column を指定しない場合、ハッシュ値が変化した行は Upserted と Deleted の 両方の出力 に現れる可能性がある点に注意してください。
ソースモード:Table モードと Query モード
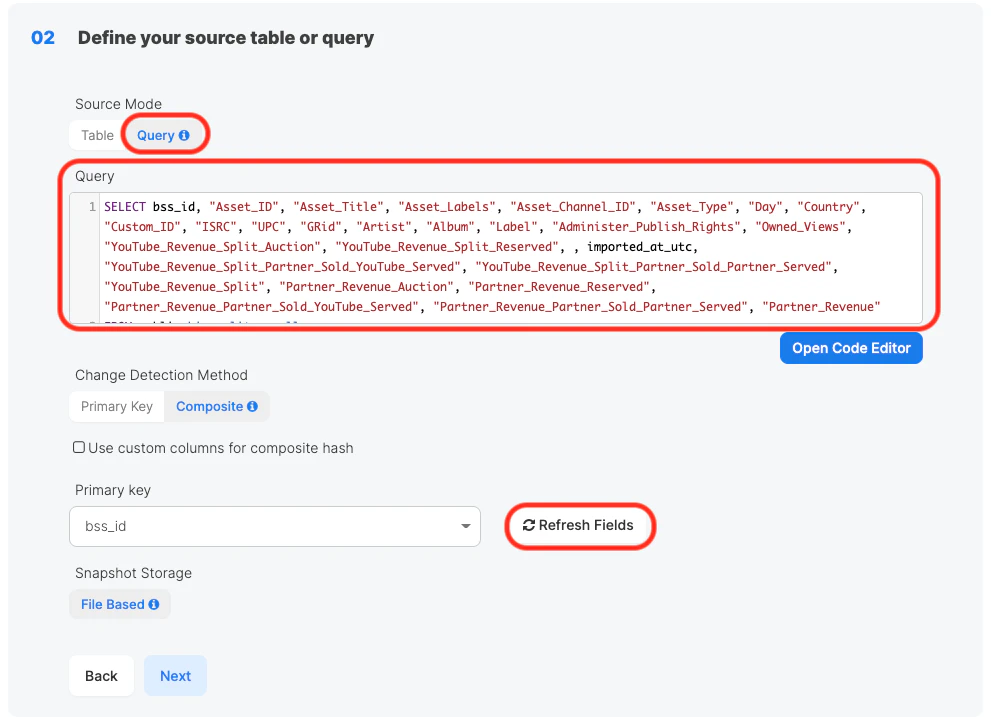
CDC Database Source では、データの取得方法として Table モード と Query モード の 2 つを選択できます。
| モード | 対応ストレージ | 使用条件 | 備考 |
|---|---|---|---|
| Table | Database / File Based | 単一テーブルの取得 | 特になし |
| Query | File Basedのみ | 複数テーブルの JOIN、複雑な WHERE 条件、列のエイリアス指定など | クエリの記述後、Refresh Fieldsのクリックが必要 |
設定手順のまとめ
CDC Database Source を設定する際の基本的な流れは以下のとおりです。
-
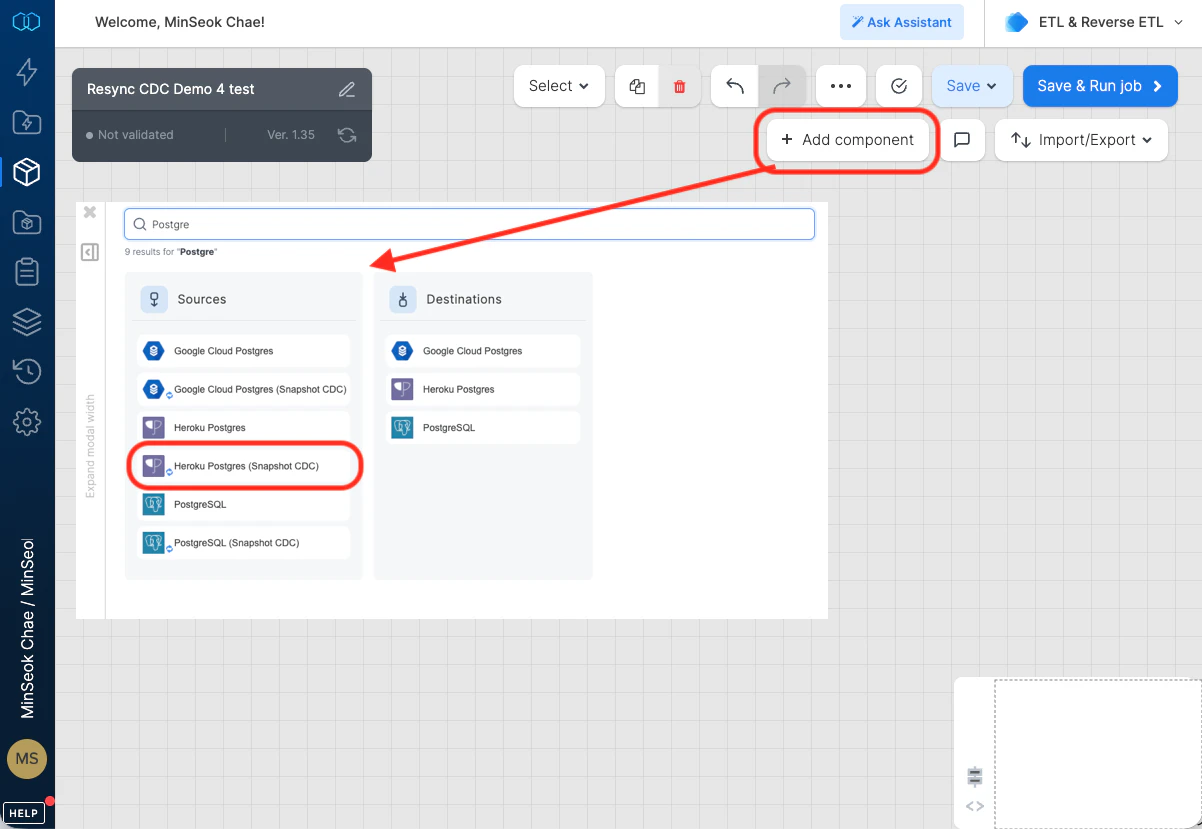
パッケージデザイナーで Database (CDC) Source コンポーネントを追加し、データベース接続を選択する
-
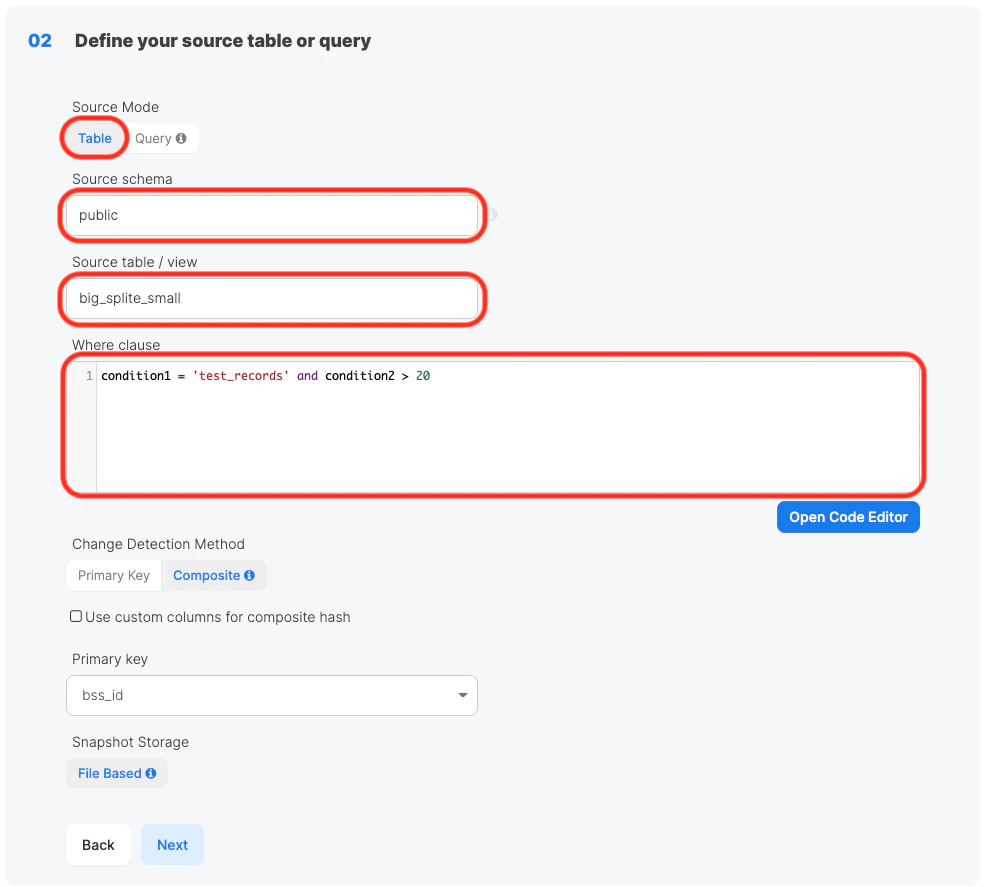
ソースモードを選択(Table または Query)
- Table モードの場合はスキーマとテーブルを選択
- Query モードの場合は SQL クエリを記述して Refresh Fields をクリック
- Table モードの場合はスキーマとテーブルを選択
-
変更検出方式を選択(Primary Key または Composite Hash)して検出パラメータを設定(主キー列の指定、カスタム列の選択など)
-
選択可能な場合、スナップショットの保存方式を選択(Database または File Based)
-
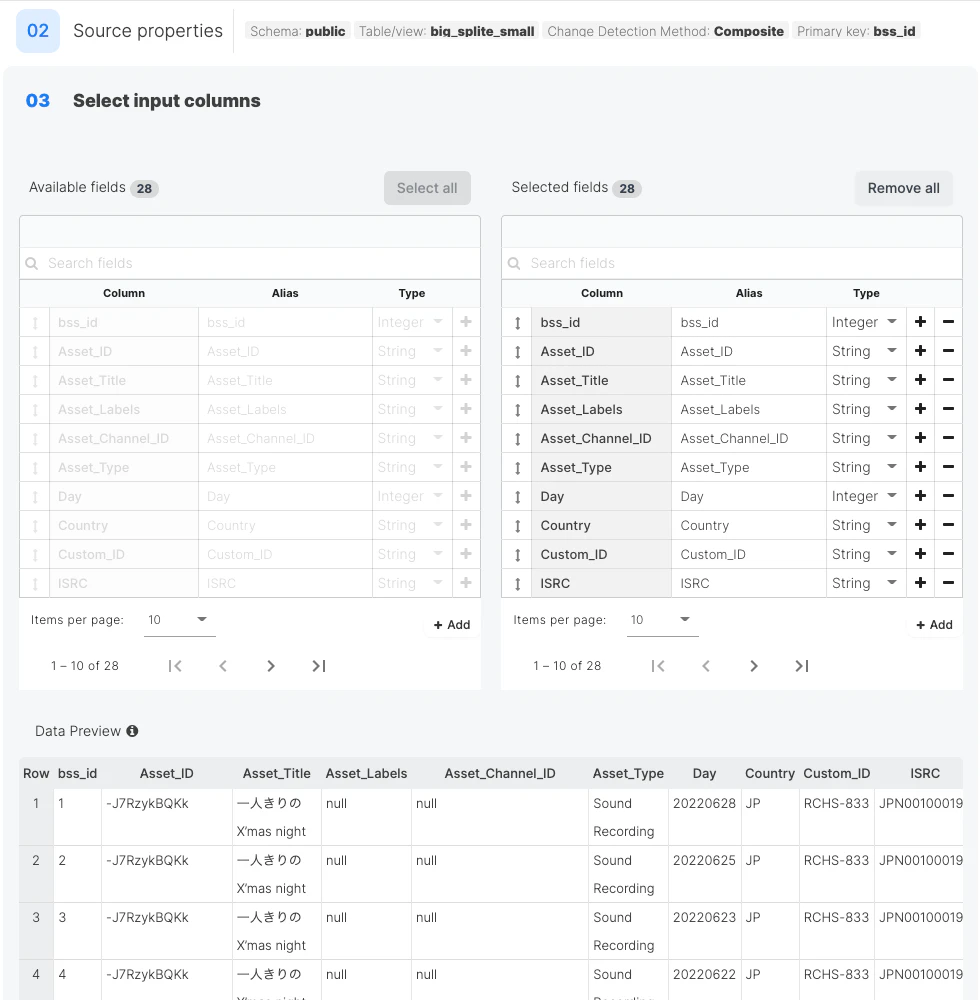
子コンポーネントに渡す入力列を選択
-
Upserted records 出力と Deleted records 出力を、それぞれ適切なデスティネーションや変換コンポーネントに接続
運用上のベストプラクティス
1. 変更検出方式の選び方
信頼できる一意キーがある場合は Primary Key 方式を使い、一意キーがない場合やキーの変更可能性がある場合は Composite Hash 方式を使用してください。Composite Hash 方式では、変更検出に不要な列(例:last_modified_timestamp のように頻繁に変わるが業務的に重要でない列)はハッシュ対象から除外すると、不要な差分検出を避けられます。
2. スナップショット保存方式の選び方
SQL Serverで書き込み権限があり、かつクエリ実行がデータベース内で完結する効率性を重視する場合はDatabaseストレージが最適です。それ以外のすべてのケースではFile Basedストレージを使用してください。
3. 削除レコードの取り扱い
デスティネーション側でレコードを物理削除するか、論理削除(ソフトデリート)にするかを事前に決めておきましょう。監査目的で削除レコードをアーカイブすることも検討してください。
4. Query モードの注意点
- クエリの結果セットに、各行を一意に識別できる列が含まれていることを確認してください
- クエリの末尾にセミコロン(
;)を付けないでください。システムが処理ロジックを追加するため、セミコロンがあるとエラーが発生する場合があります - 複数テーブルを JOIN する場合は、列名の曖昧さを避けるためにエイリアスを使用してください(例:
c.name AS customer_name) -
NOW()やRAND()のような非決定性関数をクエリに含めないでください。実行のたびに異なる値が返されるため、すべての行が「変更あり」と判定されてしまいます
5. 実行間で条件を変更しない(要注意)
Where 句やクエリの内容を実行間で変更すると、含まれる行のセットが変わるため、変更後の初回実行ですべての行が Upserted(または Deleted)として出力される可能性があります。条件変更が必要な場合は、初回は「全件差分」が出ることを想定した上で実行してください。
まとめ
CDC Database Sourceは、大規模データセットを扱うパイプラインの効率化に大きく貢献するコンポーネントです。スナップショット比較によって変更データだけを抽出し、Upserted recordsとDeleted recordsを分離して出力することで、後続の処理を柔軟に設計できます。
SQL ServerであればDatabaseストレージによる高効率な処理が可能であり、MySQL・PostgreSQL・Snowflake など他のデータベースでも File Based ストレージを通じて同等のCDC機能を利用できます。さらに、Query モードを活用すれば複数テーブルのJOIN結果に対しても差分検出が可能です。
まずは小規模なテストデータセットで動作を検証し、変更検出が期待どおりに機能することを確認した上で、本番環境への適用を進めてください。