
はじめに
LLMに「順を追って考えて」と指示しても、途中の計算や条件の読み取りを間違えることがあります。では、同じ問題を複数回解かせ、最後の答えを多数決で選んだらどうなるでしょうか。
今回は、複数の推論経路から回答を選ぶ Self-Consistency を説明します。
1. 紹介する論文
- タイトル:Self-Consistency Improves Chain of Thought Reasoning in Language Models
- 著者:Xuezhi Wangほか
- 発表会議:ICLR 2023
- 論文:arXiv
2. この論文を一言でいうと
1つの解答だけで判断せず、異なる解き方から得られた最終回答を集約する手法です。
3. 背景:CoTでも誤答する
Chain-of-Thought(CoT)promptingは、途中の推論を含む解答を生成させる方法です。
例えば、「本を5冊持っていて、父親と母親からそれぞれ2冊ずつもらう」という問題なら、正解は 5 + 2 + 2 = 9冊 です。しかし、一方の親からもらった本を見落とすと、5 + 2 = 7冊 になってしまいます。

4. 提案:モデルを変えず、生成と選択を変える
Self-Consistencyは、新しいモデルを学習する手法ではありません。同じモデルから複数の出力を生成し、回答の選び方を変えます。
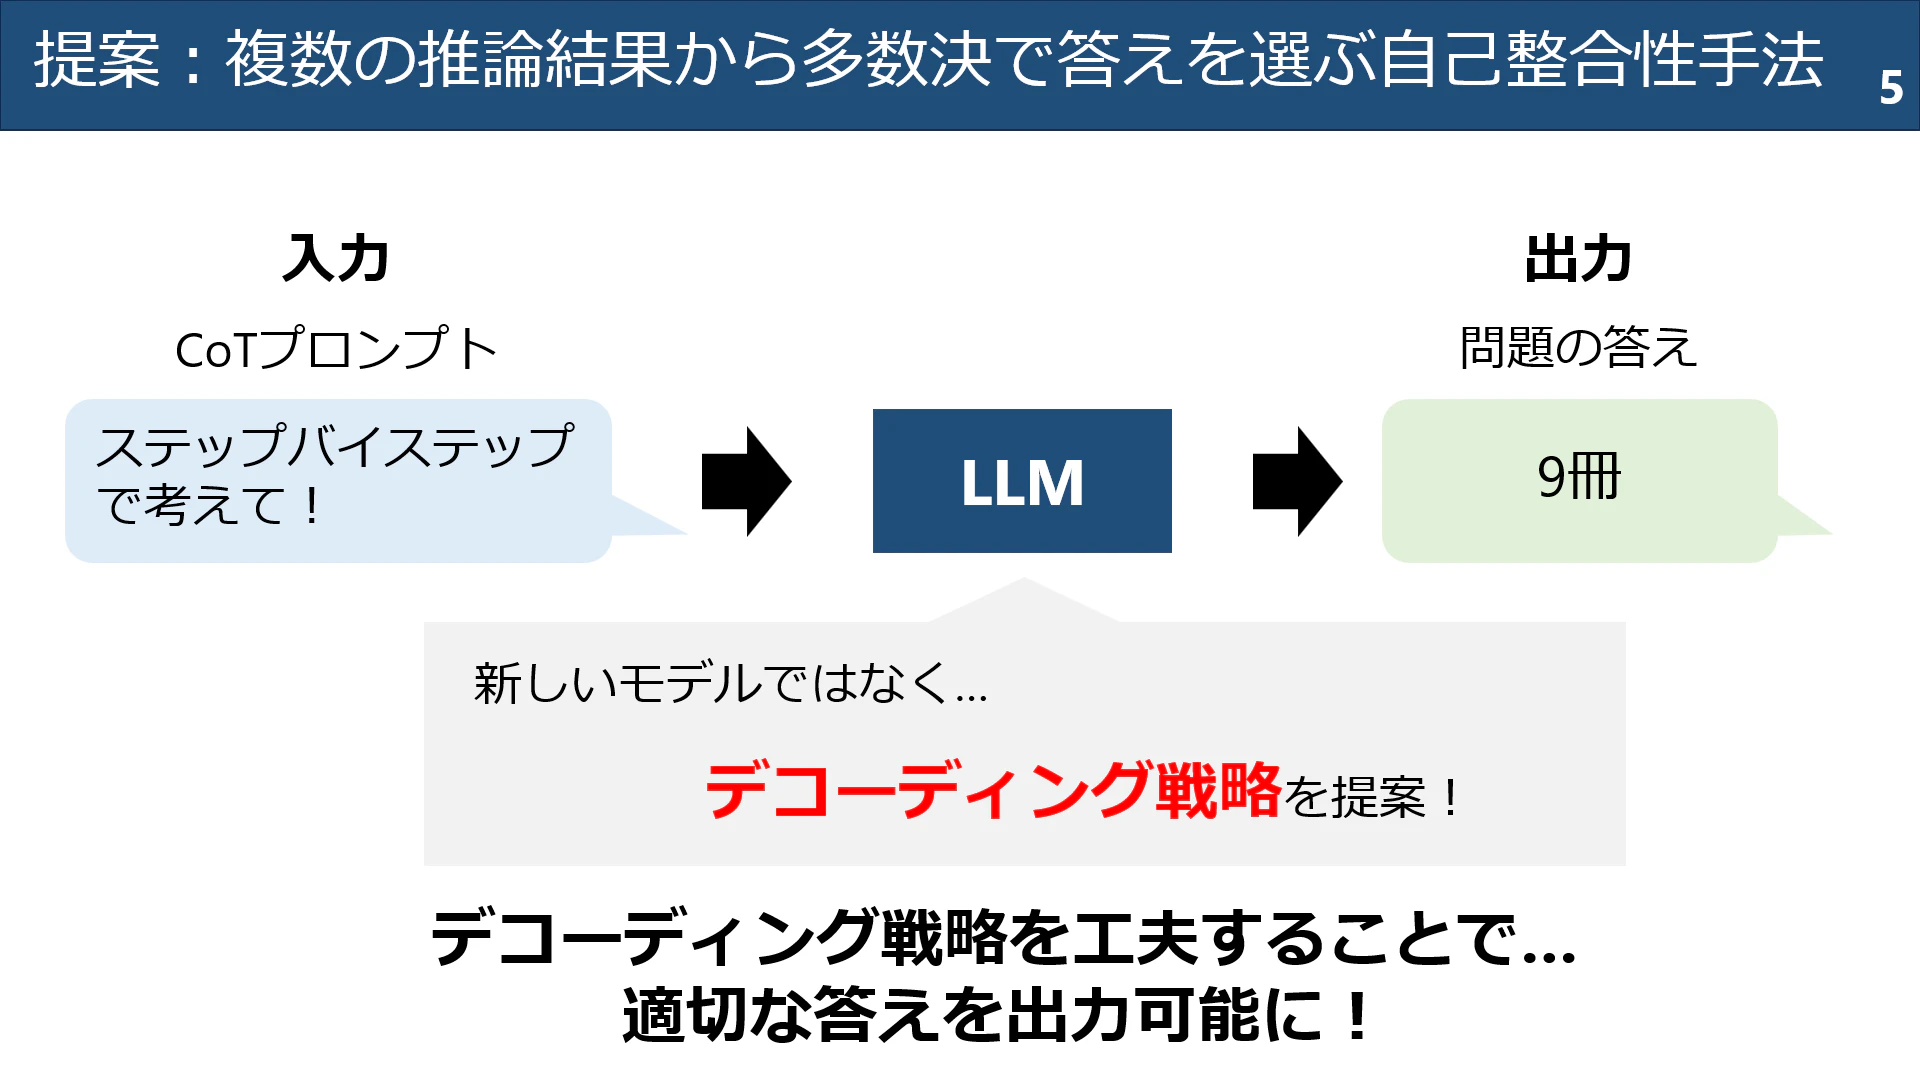
- CoTの例を含むプロンプトと問題を与える
- サンプリングを使い、複数の推論経路と最終回答を生成する
- 最終回答を取り出して、最も多く現れた答えを選ぶ
5. アニメーションで見る候補生成
まず、1つの出力を作る流れを見ます。LLMは、それまでに生成したトークンと入力を条件として、次のトークンの確率分布を計算します。サンプリングでは、その分布に基づいて次のトークンを選びます。
- 最初のトークンを選ぶ:図では「3」が選ばれます
- 続きのトークンを選ぶ:「3」を含む、それまでの文脈を使って「×」が選ばれます
-
さらに続きを生成する:「5」などを順に選び、説明用の式
3 × 5 = 15ができます - 同じ問題でもう一度生成する:次の生成では、別の選択を経て異なる経路になる場合があります
- 複数の出力がそろったら集約する:各経路から最終回答を抽出し、その出現回数を数えます

6. なぜ貪欲デコーディングだけでは足りないのか
貪欲デコーディングは、その時点で最も確率が高い次のトークンを選び続ける方法です。

各段階でもっとも確率が高い選択をしても、完成した回答が正しいとは限りません。また、同じ入力と条件で決定的な生成を繰り返しても、同じ回答が並ぶだけなら改善にはつながりません。
7. 異なる経路から同じ答えに到達する
サンプリングによって、同じ問題でも異なる解き方を得られる場合があります。
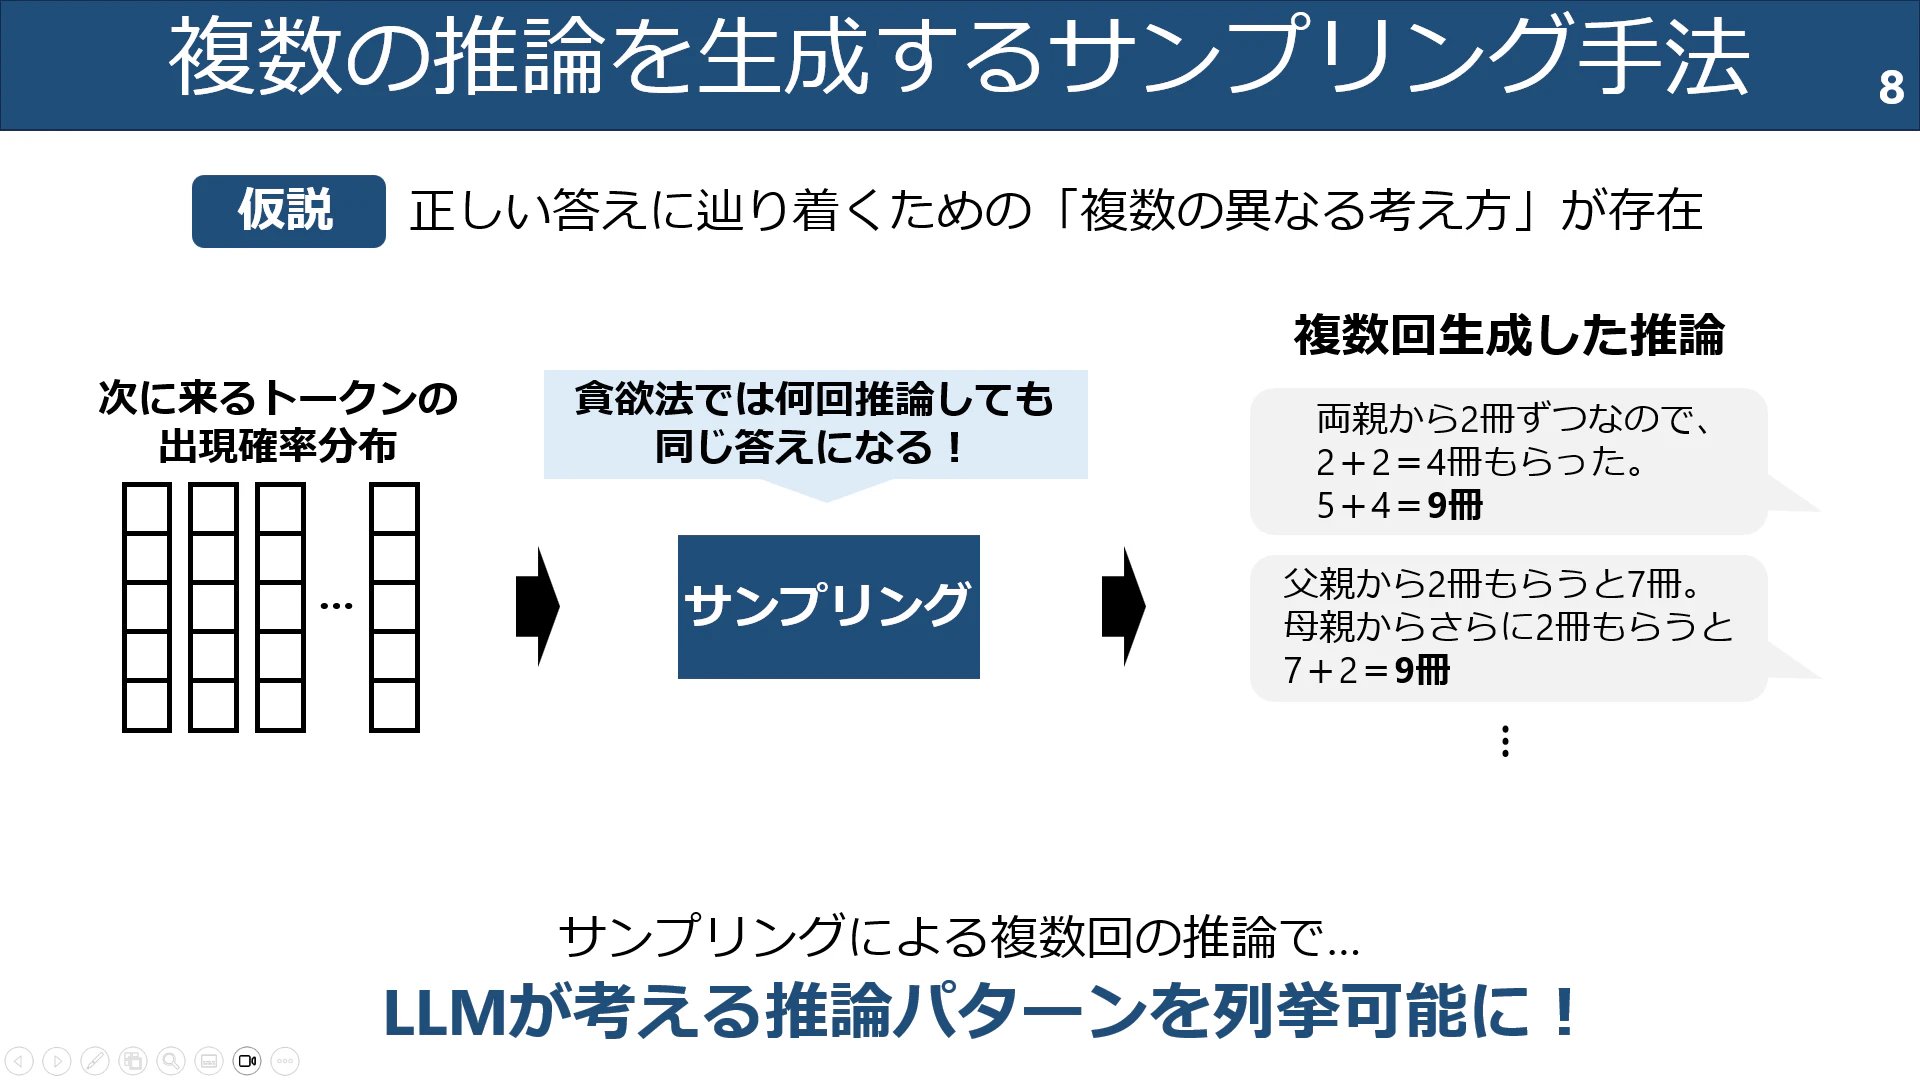
- もらった本は
2 + 2 = 4冊。元の5冊と合わせて5 + 4 = 9冊 - 父親からもらうと
5 + 2 = 7冊。母親からもらうと7 + 2 = 9冊
ここで求めているのは、単なる文章の言い換えだけでなく、回答に至る経路の多様性です。
8. 多数決を取る対象は「最終回答」
Self-Consistencyでは、解き方の文章全体を比較するのではなく、各出力から抽出した最終回答を比較します。
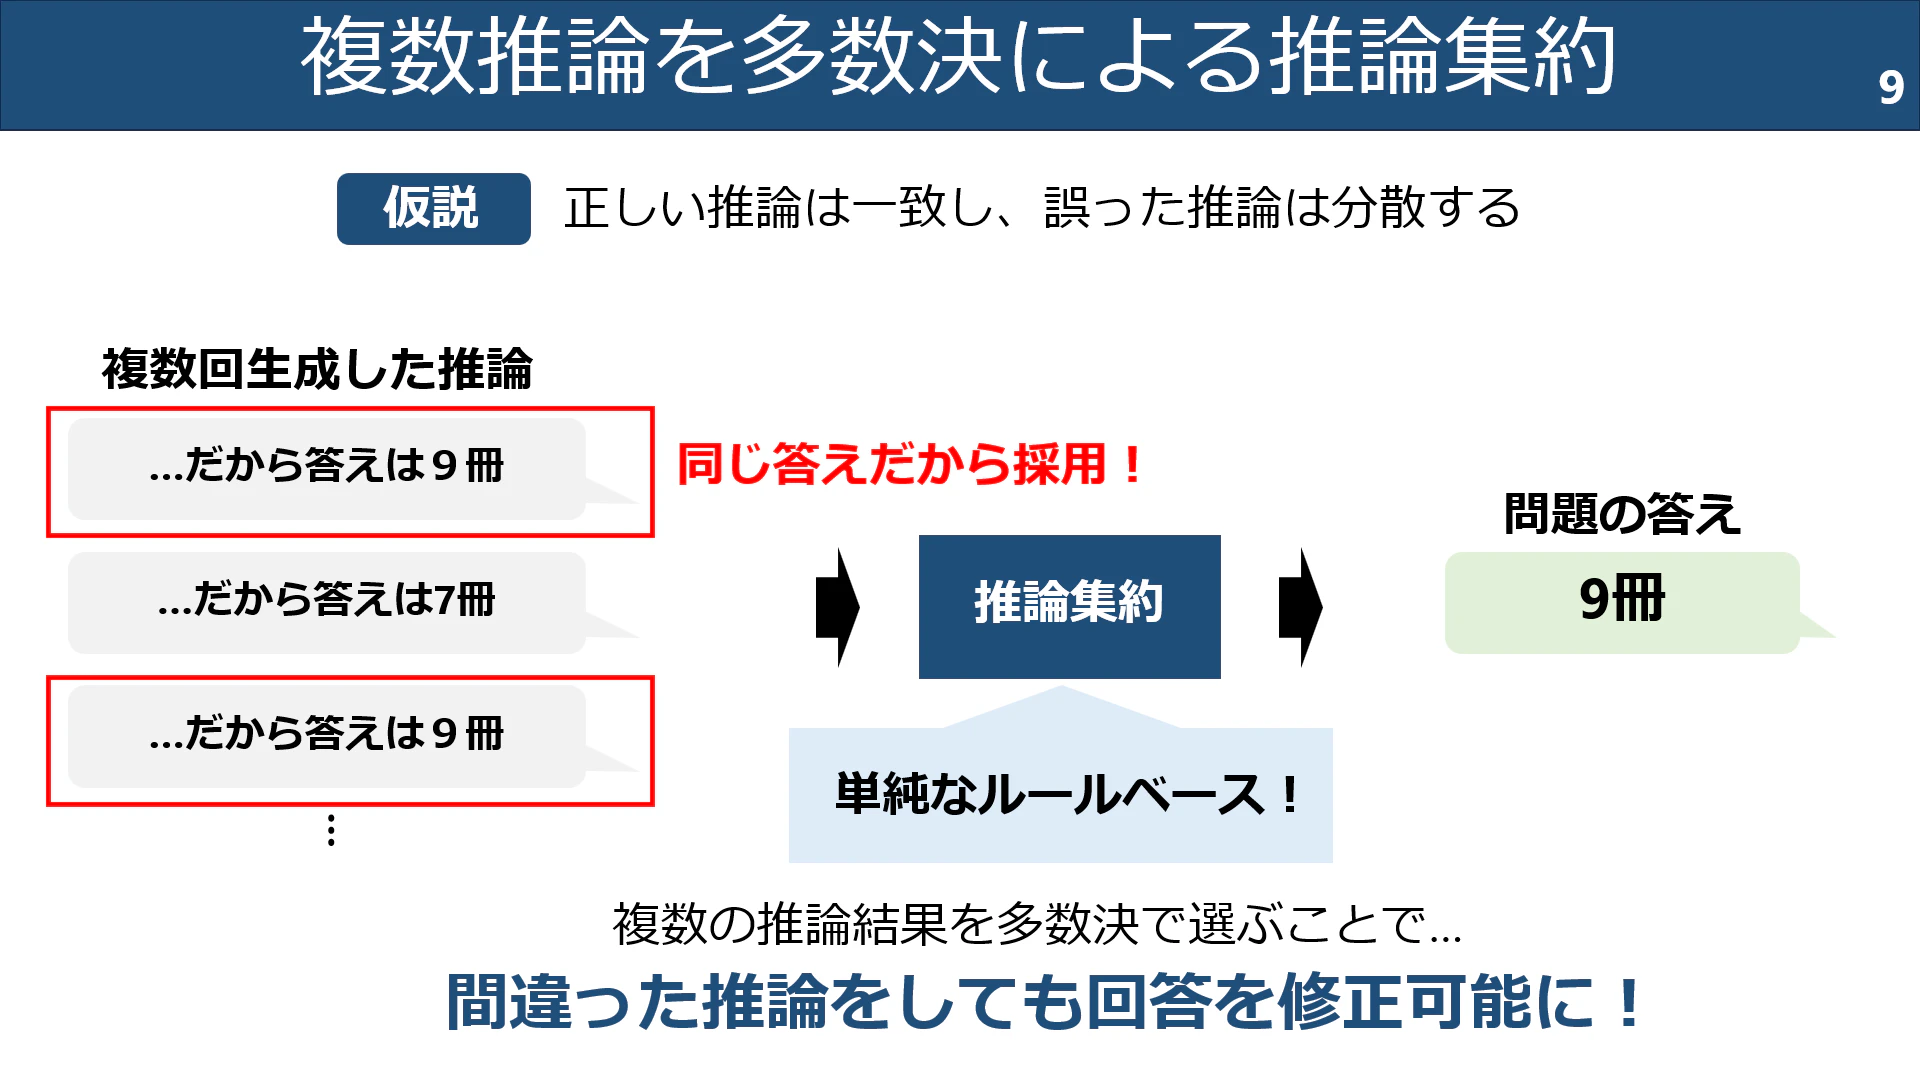
この手法の背景には、「異なる正しい解き方は同じ答えに到達しやすく、間違った解き方の答えは分散しやすい」という仮説があります。
ただし、図中の「正しい推論は一致し、誤った推論は分散する」は、常に成り立つ法則ではありません。複数の出力が同じ誤解をすれば、誤答に票が集まる場合もあります。
また、ここでいう多数決は「最も票が多い答えを選ぶ」操作です。過半数を得た回答が存在しなくても選べます。同票の場合の扱いは、実装時に決める必要があります。
9. 全体の流れを再確認

この図を左から読むと、「入力の工夫」だけでなく「出力の生成方法」と「回答の選択方法」までが手法に含まれることが分かります。
以降では、この変更が実際のベンチマークでどのくらい効果を持つかを見ていきます。
10. 何を評価したのか

前者は「複数回生成して集約すると、1回の貪欲生成より正解率が上がるか」、後者は「候補を作る方法や選び方を変えた場合はどうか」という問いです。
タスクと評価指標

資料では算術・常識・記号推論に分類しています。図中に「計11個」とありますが、掲載された主結果表の列は、算術6列、常識4列、記号2列の計12評価設定です。ARCを1つのベンチマーク群として数えるか、ARC-eとARC-cに分けるかで数え方が変わるため、ここでは評価対象の内訳に注目します。
比較に使ったモデル

UL2-20B、LaMDA-137B、PaLM-540B、GPT-3系で、CoTとSelf-Consistencyを比較しています。
モデルサイズや構造が異なる条件で効果を見る構成です。
11. 実験結果:算術推論
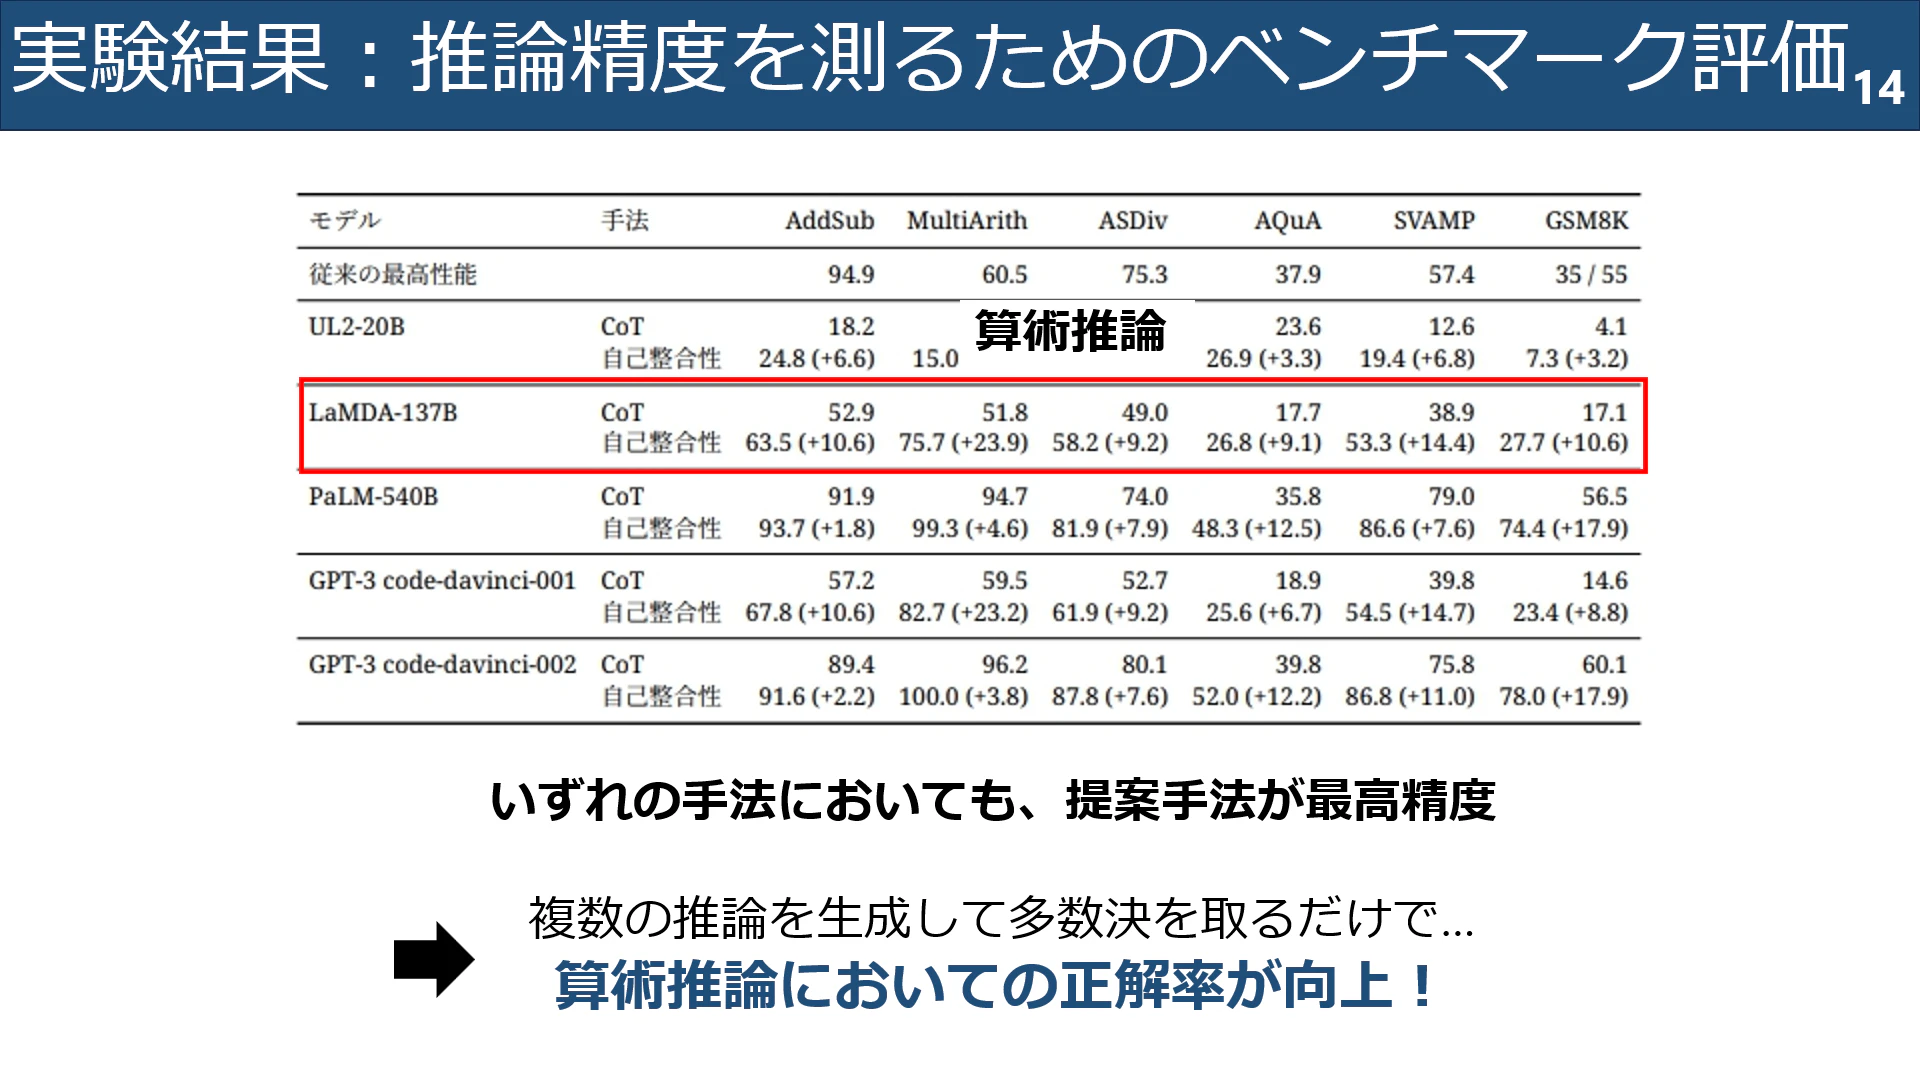
例えば、PaLM-540BのGSM8Kでは、CoTの56.5%に対しSelf-Consistencyは74.4%です。差は 17.9パーセントポイント です。「相対的に17.9%増えた」という意味ではありません。
| データセット | CoT+貪欲生成 | Self-Consistency | 差 |
|---|---|---|---|
| MultiArith | 94.7% | 99.3% | +4.6ポイント |
| AQuA | 35.8% | 48.3% | +12.5ポイント |
| SVAMP | 79.0% | 86.6% | +7.6ポイント |
| GSM8K | 56.5% | 74.4% | +17.9ポイント |
出典:原論文 Table 2。主な結果は、各試行で40出力をサンプリングし、10試行で平均した値です。
スライドの「提案手法が最高精度」は、同じモデルのCoTとの比較として読む必要があります。各行が、ほかの全モデルや既存手法より必ず高いという意味ではありません。
12. 実験結果:常識推論・記号推論

算術以外の評価でも改善が見られますが、モデルとタスクによって改善幅は異なります。
ここでは、改善しない例にも注目したいところです。例えばLetter (4)では、UL2-20Bが0.0%のまま、LaMDA-137Bも8.2%のままです。
候補を増やしても、必要な能力が十分にない場合には改善が限られることが分かります。どのタスクでも、回数を増やせば解けるようになるわけではありません。
13. 候補の生成条件を変えるとどうなるか
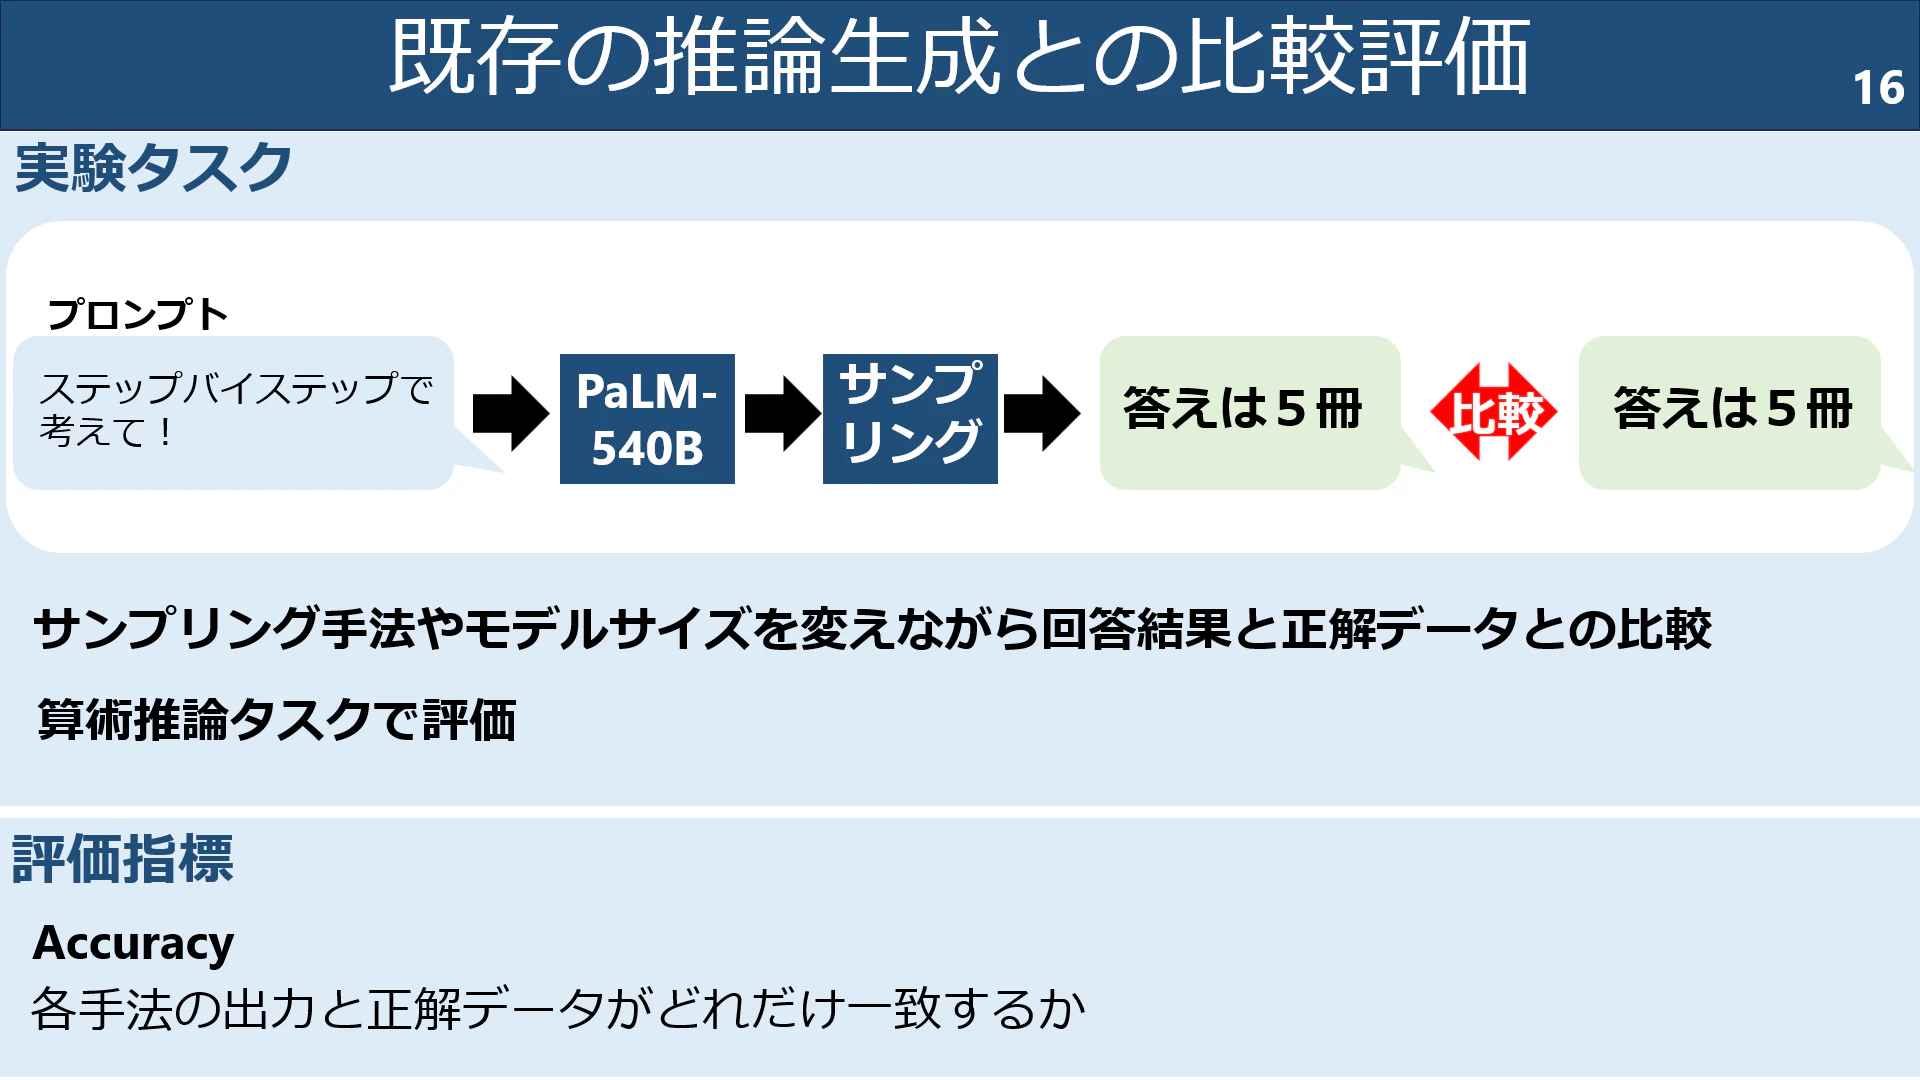
候補生成の設定やモデルサイズを変え、得られた最終回答を正解と比較します。
ここでは、どの方法で候補を生成するかに注目します。
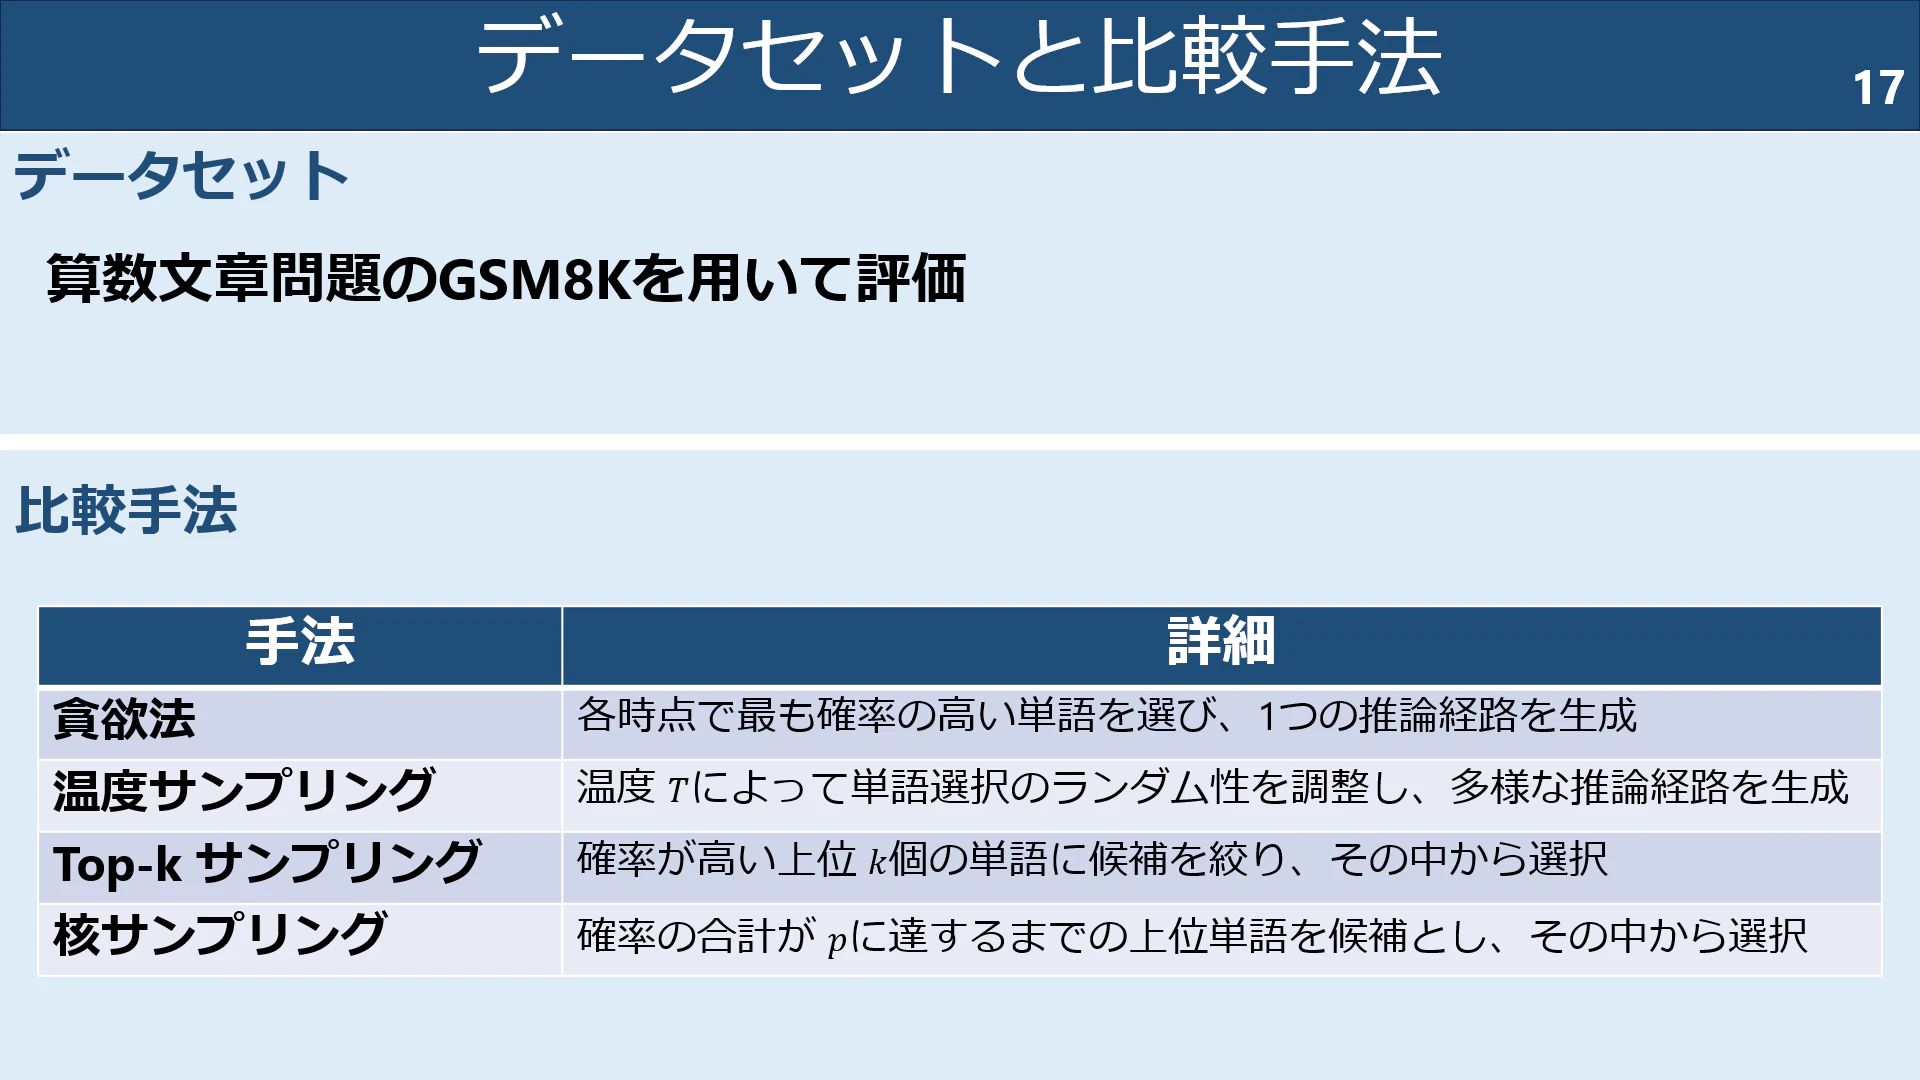
温度は確率分布の鋭さ、Top-kとTop-pは候補に含めるトークンの範囲に関係します。
- 貪欲法:最も確率が高いトークンを選びます
- 温度サンプリング:温度で確率分布の鋭さを調整し、そこから選びます
- Top-k:確率上位k個のトークンに候補を絞ります
- Top-p(核サンプリング):確率の累積和がp以上になるまで上位トークンを含め、その集合から選びます
これらは組み合わせることもできます。「ランダム性を高くすれば良い」というより、問題を解ける範囲で多様な経路を生成できるかが重要です。
経路数と正解率

左のグラフでは、多くの設定で経路数を増やすと正解率が改善しています。
左の横軸はサンプリングした経路数、縦軸は正解率です。温度や候補の絞り方が違っても、複数経路を集約する効果が見られます。一方、設定によって到達する正解率は違い、増やしたときの伸びも次第に小さくなっています。
図中の「設定に依存せず」は、試した複数の設定に対して効果が見られたという範囲で読むべきです。任意のパラメータで同じ性能になるという意味ではありません。
モデルサイズと正解率
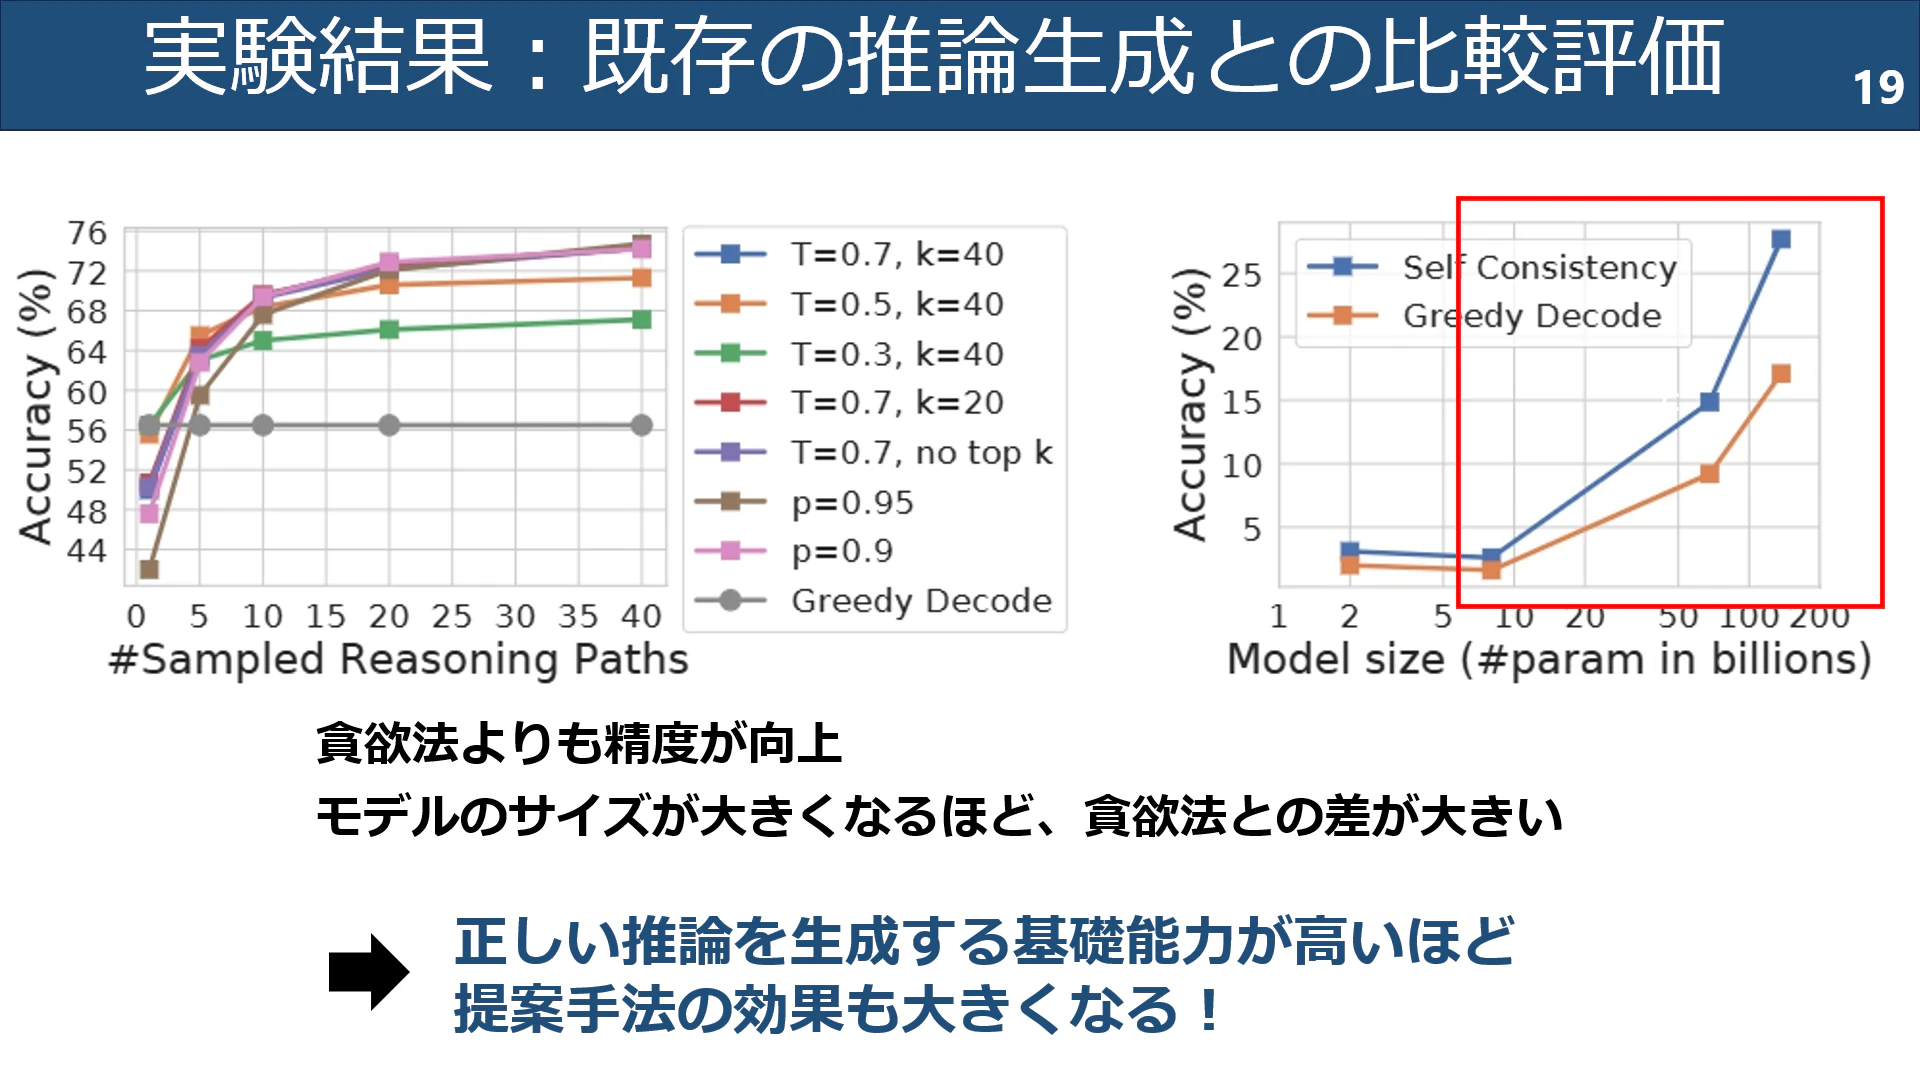
同じグラフの右側に注目したスライド。示された条件では、大きなモデルで貪欲生成との差が大きくなっています。
この結果は、モデル自体の解く能力と、生成した候補を集約する効果を合わせて考える必要があることを示しています。ただし、別のモデル系列や別タスクでも、サイズだけで改善幅が決まるとまでは言えません。
また、候補数を増やすほど生成処理は増えます。並列化で待ち時間を短くできても、総生成量が減るわけではないため、精度とコストを合わせて評価する必要があります。
14. 使うときの注意点
仕組みから考えると、実装時には次の点が課題になります。
- 多数派が誤答になる場合がある:同じモデルの出力なので、共通の誤解が複数候補に現れることがあります
-
回答の正規化が必要:
9、9冊、九冊を同じ回答として扱うかを決めます - 抽出失敗や同票への対応が必要:最終回答を取得できない出力をどう扱うかも、先に決めます
- 自由記述の一致判定が難しい:内容は同じでも表現が違う場合、文字列の一致だけでは集約できません
- 一致率は正解確率そのものではない:例えば候補の8割が同じ答えでも、それをそのまま「80%の確率で正しい」とは解釈できません
15. まとめ
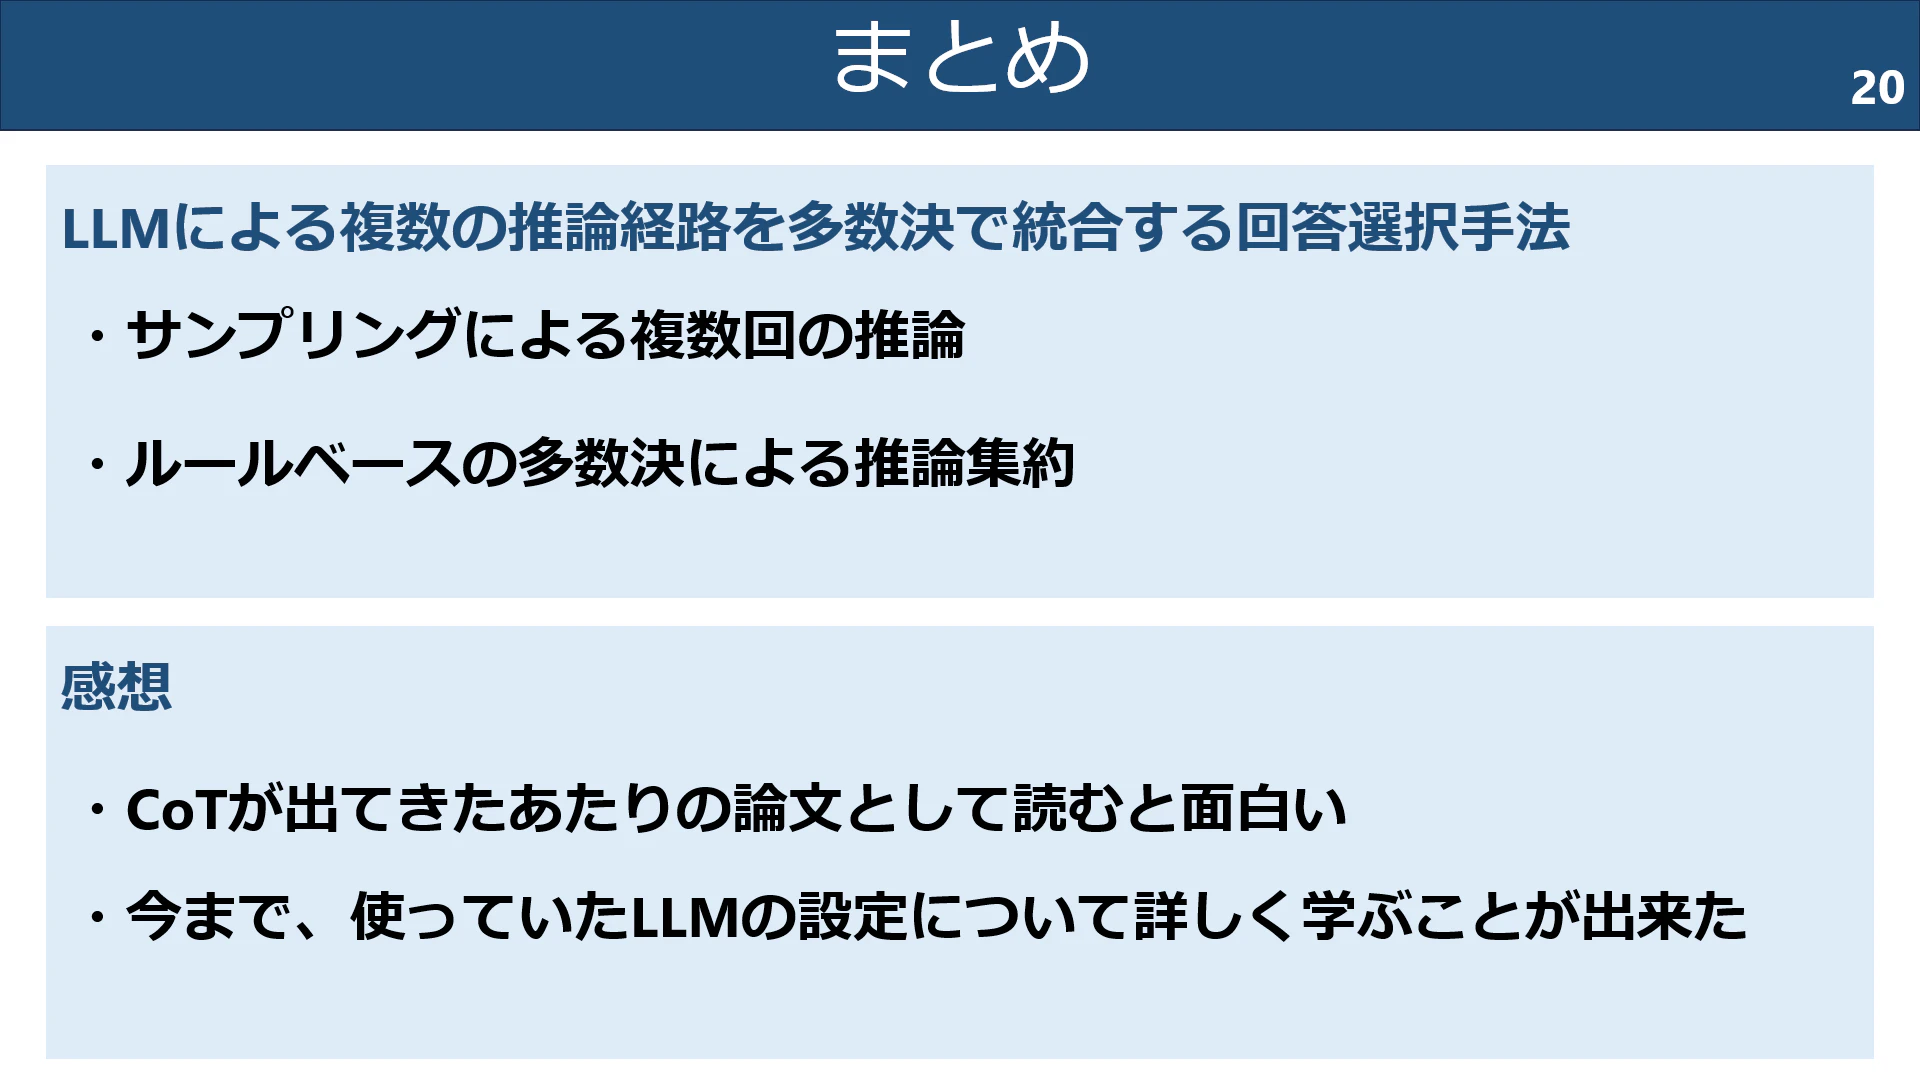
サンプリングで複数経路を生成し、最終回答を多数決で選ぶという2点が手法の中心です。
この論文の面白さは、モデルの学習方法を変えずに、生成と回答選択の方法によって精度を改善している点にあります。
特に候補生成は、「1回の出力の中で答えをたくさん書かせる」というだけではありません。同じ問題に対して複数の出力をサンプリングし、そこから最終回答を抽出して集約する、という一連の手順として理解すると分かりやすくなります。
ただし、複数回生成しても正しさが保証されるわけではありません。どのタスクに使うか、回答をどう比較するか、どの程度の生成コストを許容するかまで含めて考えたい手法です。
他に読んでほしい論文があればコメントください!
参考文献
- Xuezhi Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023.