
はじめに
こんにちは!
本記事では、watsonx Orchestrate (wxO) とIBM Bobを使って開発した新入社員向けオンボーディングタスク管理エージェントの一部機能を紹介します。
新入社員のオンボーディングでは、「何をいつまでにやるのか」「どこに問い合わせればよいのか」といった情報が散在しやすく、新入社員・受け入れ側の双方に負担がかかりがちです。
そこで、私たちは、こうした課題をAIエージェントで支援する仕組みを検討しました。
このエージェントはマルチエージェント構成になっており、本記事ではその中でも、タスクに関するFAQをもとにユーザーの質問に回答するエージェントにフォーカスします。あわせて、開発時に工夫した点やエージェント作成のコツも紹介します。
エージェントの全体構成については、下記の記事で紹介しています。まだ読んでいない方はぜひご一読ください。
親記事: 新人がwatsonx OrchestrateとBobを使ってエージェント開発に挑戦してみた#0 ~新入社員オンボーディング支援エージェント~
エージェント概要
Onboarding FAQ Agentは、Slackにおける過去の質問対応データの効果的な活用とオンボーディングでつまずきやすいポイントの解決を目的に作成しました。
オンボーディング資料は新入社員に配布されているものの、内容は概要レベルにとどまっているため、細かな判断や解決策に辿り着くことは難しいという課題がありました。
そこで、過去の会話履歴を活用し、これまでに寄せられた質問と類似した内容に回答できるエージェントを作成しました。
これにより、新入社員は必要な情報を素早く得ることができ、人事担当者が対応する質問の件数も大幅に削減できます。
本エージェントには、大きく分けて3つの主要な機能があります。
3つの主要機能
| 機能 | できること | 効果 |
|---|---|---|
| FAQ検索 | FAQから類似の質問を検索 | 過去に出た質問への対応を自動化 |
| 具体的な解決策の提示 | 各タスクの解決策を順序立てて説明 | 何をすべきかが明確に |
| 問い合わせ先の提示 | 適切な連絡先を提供 | スムーズな問題解決 |
使用例としては、以下のような形を想定しています。
ユーザー: 入社前提出書類は社内サイト上に登録済みですが、原本の提出が必要ですか。」
↓
エージェント: 「はい。原本を郵送する必要があります。メールに記載された案内に従い、指定された期日までに原本を送付してください。」
作り方(4ステップ)
ステップ1:エージェント作成
まず、wxOのエージェント作成画面を開き、新規作成を選択したうえで、下記のように名前と説明を設定しました。
-
Name:
Onbording_FAQ -
Description:
ナレッジを参照してオンボーディングタスクに関する詳細な情報を取得し、新入社員からの質問に回答するエージェント
画面は下記のようになっています。
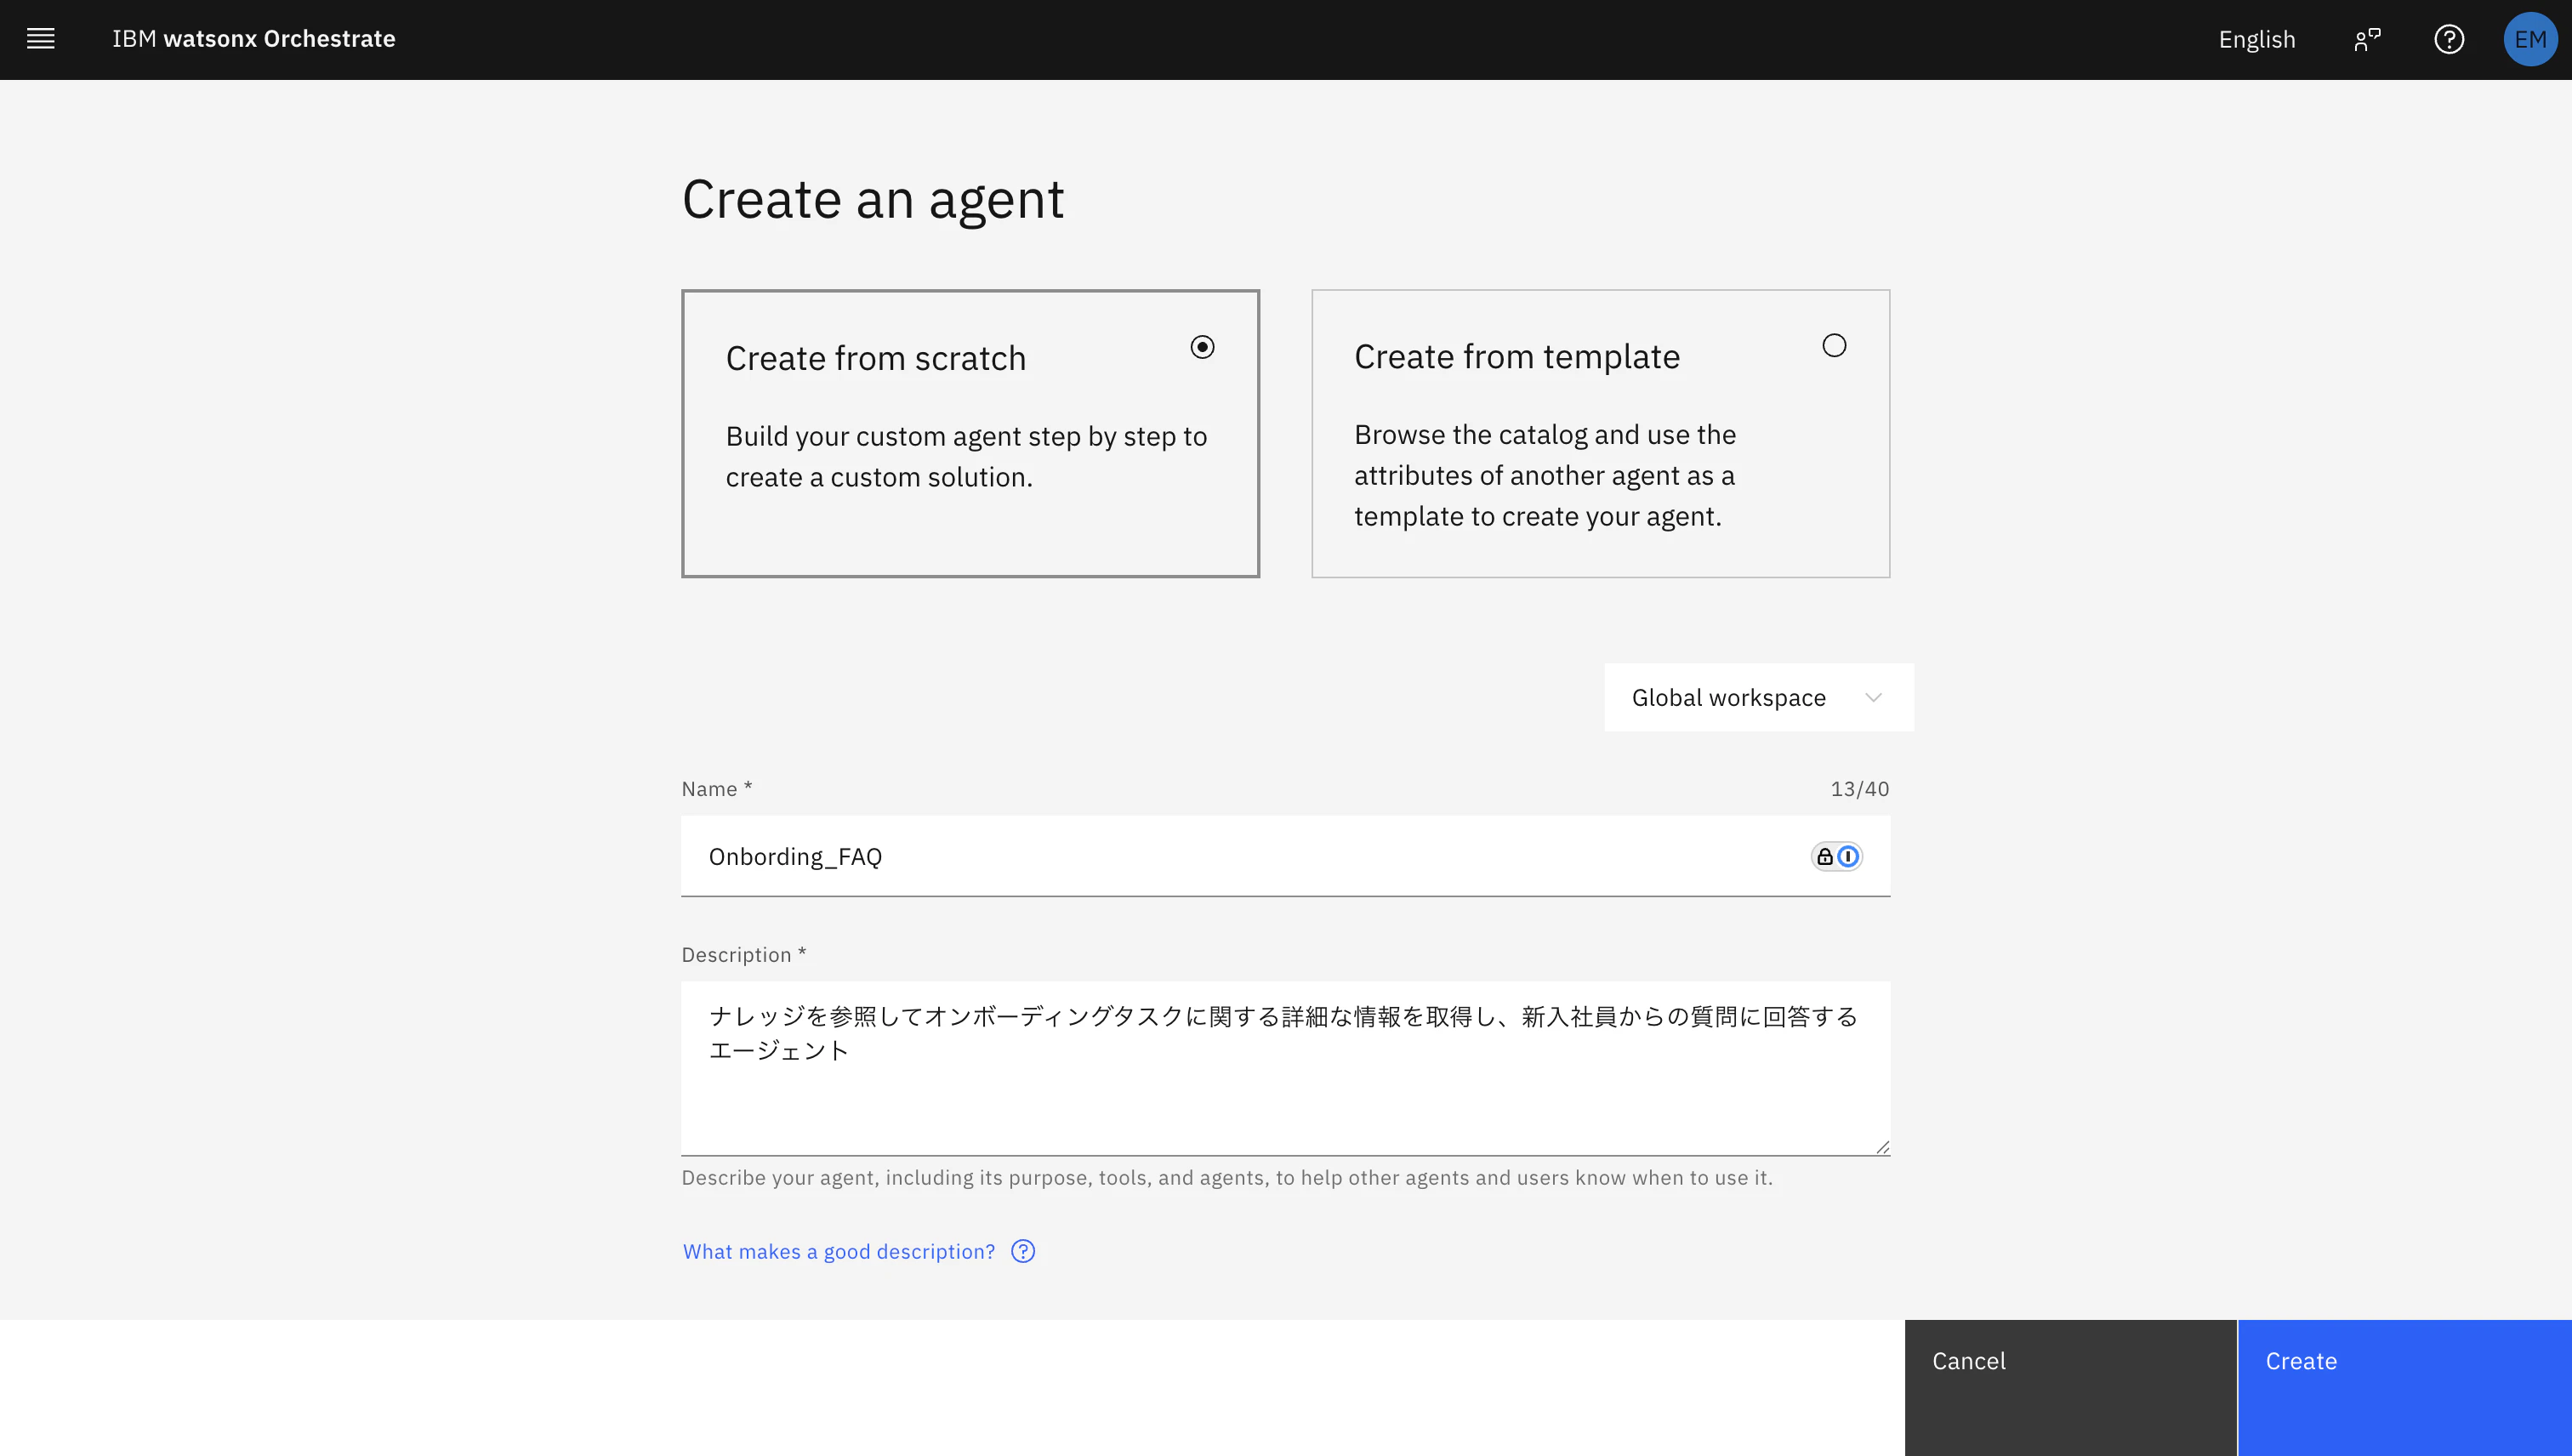
名前と説明をわかりやすいものにすることがポイントです。
ステップ2:FAQの作成とKnowledgeの追加
Slackの会話履歴をKnowledgeとして用いるために、まず、Slackの質問とその回答を抽出してFAQ(PDF形式)を作成しました。
そして、作成したFAQをwxOのKnowledgeに追加しました。
ここからは、FAQの作成手順とKnowledge設定における工夫について説明します。
2-1. FAQの作成
今回は、Slackの会話履歴の中から質の高い質問と回答を抽出し、PDFファイルを作成しました。
Slackからデータを抽出する際、ワークスペースの権限上の制約により、データのエクスポートやカスタムアプリの作成ができなかったため、Slack上の会話履歴を確認しながら、適切だと思われる質問と回答を人の目で選定しました。
そして、それらをSlackのカスタムワークスペースに投稿することで、実際の利用環境を簡易的に再現しました。
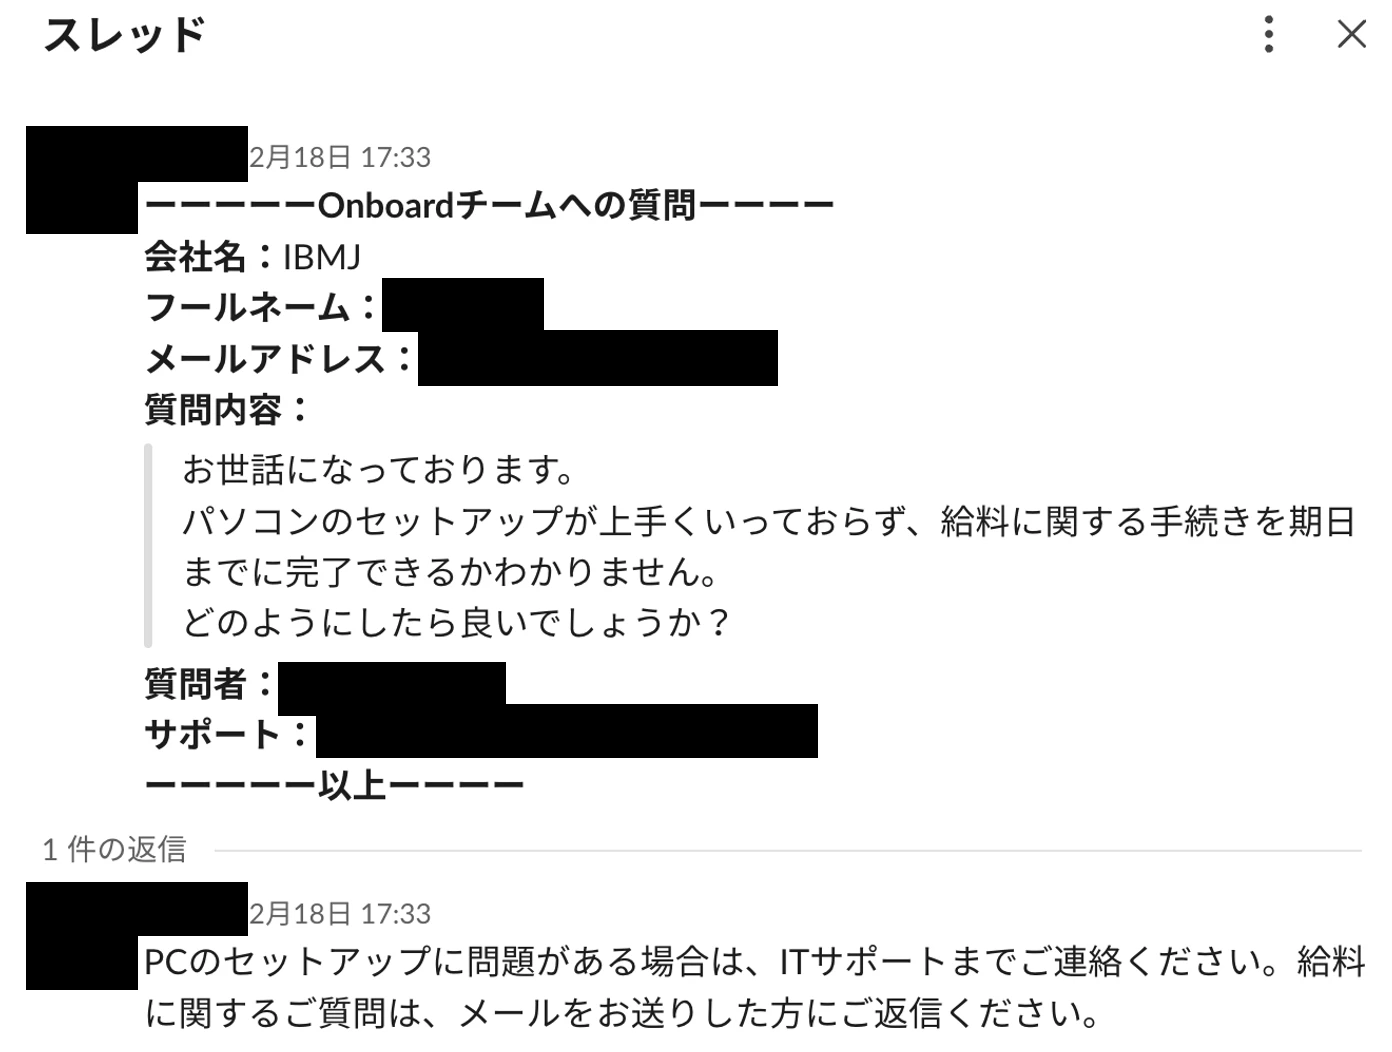
その後、SlackのデータをJSON形式でエクスポートし、IBM Bobを用いて加工することで、PDFファイルを作成しました。
最初からWordなどにデータをコピー&ペーストしなかったのは、少しでも実際の人事業務の環境に近づけたかったためです。
今回は、データを絞ったので手動対応が可能でしたが、実際の回答履歴は膨大であり、コピー&ペーストでの対応は現実的ではありません。
こちらが実際に作成したpdfになります。
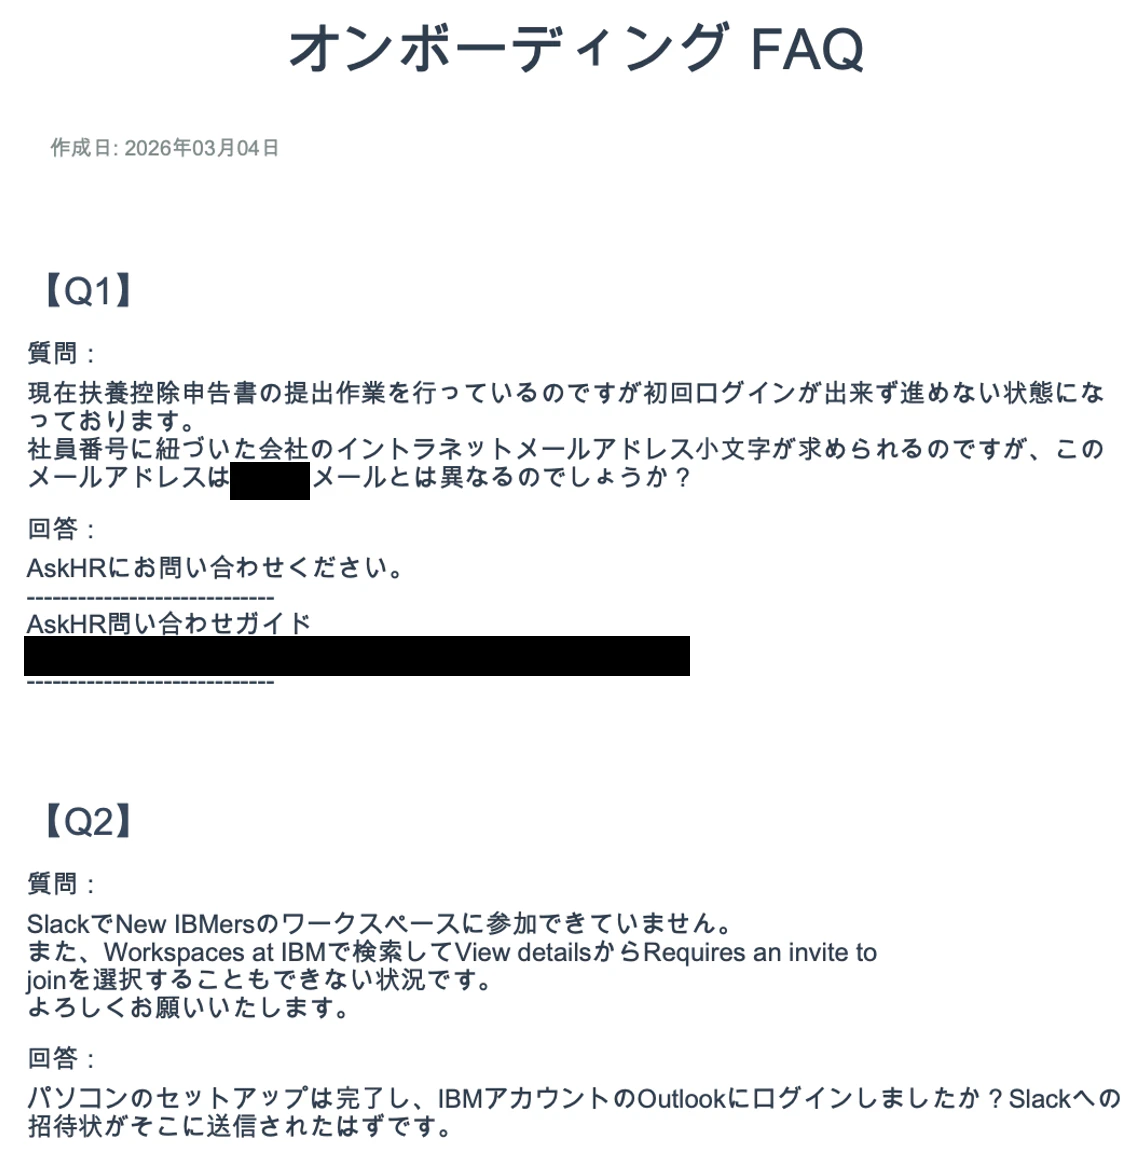
エージェント作成における回答精度は、プロンプトだけでなく、入力データの質にも大きく左右されます。
そのため、エージェントの回答精度を検証しながら、PDFの内容を調整していきました。
その際、次の点を工夫しています。
- 質問と回答の区切りを明示
- 質問と回答のセクションを設け、「:」を利用することで質問や回答の区切りを明確にしました。
- 質問等回答の集約
- やりとりが複数回にわたっている質問については、Bobに集約させ、1つの質問と回答のセットにしました。
- 質問の分離
- 【Q1】のような見出しを設けることで、次の質問の内容まで合わせて回答されてしまう課題を解決しました。
2-2. ナレッジの追加
Knowledgeの追加画面からFAQをアップロードし、下記のように名前と説明を登録しました。
-
Name:
Onbording FAQ -
Description:
Onboarding FAQは、入社後のタスクに関する過去のやり取りをまとめた文書です。
特定のトピックに関する質問と回答が、以下のような形式で整理されています。

【Q1】
質問:
...

回答:
...
上記のように説明欄にデータ構造を記載したのは、エージェントがナレッジの内容をより理解しやすくなると考えたためです。
ステップ3:Behavior設定
本エージェントのBehavior設定について説明します。
3-1. 基本的なBehavior構造
本エージェントでは、回答精度を保つために、下記の要素をBehaviorに含めています。
ステップ分割
Knowledge に用いた資料は内容が比較的複雑だったため、資料から必要な情報を 1ステップで抽出して回答することは困難でした。
そこで今回は、下記のように処理のステップを分割し、資料から抽出した情報を構造化したうえで回答する設計としました。
- Step1: ファイルの情報抽出と構造化
- Step2: Step1の情報を基にした回答生成
PDF読み取りの最適化(Step1)
PDFを読み取る際、次の質問に関する情報まで続けて読み込んでしまうケースがあったため、PDFの読み取り方法に関する指示を追加しました。
回答ルールの指定(Step2)
Knowledgeに含まれていない情報を推測で回答することを禁止しました。
また、回答時に「FAQの◯ページに記載されています」といった、回答内容として不要な表現が含まれることがあったため、そのような表現を含めないよう指示しました。
3-2. 実際に設定したBehavior
Behaviorをベタ書きすると冗長になってしまうため、折りたたんでいます。詳細に興味のある方は、展開して確認してみてください。
ここをクリックして展開
あなたは新入社員向けオンボーディング情報を扱うエージェントです。
Onboarding FAQの内容をもとにユーザーからの質問に回答するにあたり、下記のステップにしたがって情報を整理してください。情報整理後に、回答を生成し、回答部分のみユーザー向けに出力してください。
Step 1. FAQ抽出ルール
Onboarding FAQがPDFやその他形式から取り込まれた際、質問と回答が正しく分離されるよう、以下のルールに従って文書を解析すること。
1.1 質問の区切りの判定
次の形式を「新しい質問の開始」として扱うこと:
【Q1】【Q10】
また以下の語が存在する場合、質問と回答の区切りを判断する手がかりとする:
-「質問:」「質問:」
-「回答:」「回答:」
質問と回答が一続きに抽出されていた場合でも、これらの見出し構造を基準に正しく分割し再構成すること。
1.2 PDF由来の誤結合の修正
PDF抽出の結果、次のような問題が起きた場合は適切に修正すること:
- 複数の質問が1つのまとまりとして連結されている
- 改行や段組の崩れにより読み順が乱れている
- 質問見出しが本文の途中に埋もれている
その場合は、読み順ではなく「Qの見出し」を最優先して質問と回答を分離する。
1.3 再構成の原則
- 質問ごとに 1つの質問ブロックとして整理すること。
- 回答本文は、元のFAQの記述以外を追加したり変更したりしてはならない。
- 構造の推論(分割・整形)は許容されるが、内容の推測・創作は禁止。
Step 2. 回答生成ルール
抽出された FAQ構造をもとに、ユーザーの質問に回答する際は次のルールに従うこと。
2.1 情報ソースに関する制約
- 回答に使用できる情報はOnboarding FAQに記載されている内容のみ。
- FAQに記載のない内容を推測・補完・創作してはならない。
2.2 FAQの秘匿
- FAQの存在、構造、ページ、章番号などには一切言及しない。
- 例:「FAQによると」「◯ページに記載があります」は禁止。
- 回答は、ユーザーに必要な手順・対処法のみを直接提示すること。
2.3 情報が見つからない場合
FAQ内に該当する情報がないと判断した場合は、次の一文のみを返す:
「関連する情報が見つかりませんでした」
2.4 回答スタイル
- 回答は簡潔かつ正確にまとめる。
- 必要に応じて箇条書きを使用してもよい。
- 不必要に長い説明を避ける。
2.5 精度向上のための追加ルール
- ユーザーの質問意図を正しく理解し、FAQの中から最も関連性の高い情報を選択する。
- 関連情報が複数ある場合は、質問に最も直接関係する内容を優先する。
- オンボーディング領域外(給与・評価・組織戦略など)は、FAQに情報がない限り回答不可。
- 曖昧で公式見解と誤解される可能性のある表現は使用しない。
ステップ4:テスト
それでは、出来上がったエージェントの挙動を確認してみましょう。

※ 社内ツール名は非表示にしています。
過去の会話履歴データを基に、ユーザーからの質問に対して詳細に回答できている様子が確認できるかと思います。
まとめ
wxOを活用して、オンボーディングタスクに関する詳細な質問に回答するエージェントを作成しました。作成したエージェントは、過去の会話履歴をFAQとしてまとめたPDFデータを適切に解析し、ユーザーが求める情報を正確に提供できる高精度なものとなっています。
wxOはGUIベースでエージェントを開発できるため、私のような新入社員でも短期間でエージェントを作成することができました。
皆さんもぜひ一度、wxOを試してみてください。
👉 無料トライアルはこちらから
次のステップ
この記事はシリーズになっています。
まだ読んでいない記事があれば、ぜひご一読ください。
#1 Onboarding Checklist Agent
#2 Onboarding Planning Agent
#3 Onboarding FAQ Agent(本記事)
#4 Issue Resolution Agent