
・・・(前回)のつづき・・・
はじめに
前回は、ローカルLLMとPythonを使って、家庭菜園向けAIアドバイザーの超基本的なチャット機能を作成した。
といっても、入力したテキストを学習済みモデルへ渡し、その推論結果を表示しただけである。
チャット型生成AIが登場した当初、私は入力したテキストをモデル自身が学習(ニューラルネットワークの重みの調整)し、その内容を次回以降の推論にも反映しているものだと思っていた。
しかしそうではなかった。
実際には、チャットの裏では過去の会話や前提条件などを毎回コンテキストとして渡しているため、AIが覚えているように見えるのである。
ここでいうコンテキストとはLLMが回答を生成する際に、一度に読み込む情報全体のことである。今回の質問だけではなく、システムプロンプト(AIへの固定的なふるまい・指示・命令など)や過去の会話履歴、外部情報(RAG)で検索した資料、外部処理(MCP)から取得したデータなども含まれる。
つまり、LLMは前回の会話を「記憶」しているのではなく、毎回それらの情報を読み直した上で回答を生成しているのである。
今回は、そのシステムプロンプトとコンテキストの設計ポイントについて検討してみる。
システムプロンプトとは?
システムプロンプトとは、LLMに「どのような役割で、どのように回答するか」を事前に指示するためのメッセージである。
これにより、それに沿った回答をしてくれるようになる。
例えば、以下のような内容をLLMに指定する。
- 役割(Role)
AIにどのような専門家として振る舞ってほしいか
例:「あなたは家庭菜園専門のAIアドバイザーです。」 - 目的(Goal)
AIが何を達成すべきか
例:「利用者が野菜を上手に育てられるよう支援してください。」 - 対象ユーザー(Audience)
誰に向けて説明するか
例:「家庭菜園初心者向けに説明してください。」 - 回答スタイル(Style)
文体や話し方
例:「丁寧語で」「箇条書きを活用して」「簡潔に」 - 回答形式(Format)
出力フォーマットを指定
例:「最初に結論、その後に理由、最後に具体的な手順を示してください。」 - 制約・ルール(Constraints)
必ず守るべきルール
例:- 推測で答えない不明なことは「分かりません」と答える
- 必要な情報が不足している場合は質問する
- 専門知識・対象範囲(Scope)
何について答えるか
例:「家庭菜園に関する質問のみを対象としてください。」 - 優先順位(Priority)
複数のルールがある場合の優先順位
例:「安全性を最優先してください。」 - 禁止事項(Do Not)
やってはいけないこと
例:- 根拠のない断定をしない
- 架空の品種や農薬を紹介しない
- 質問ルール(Clarification)
どのような場合に質問を返すか
例:「作物名や栽培地域が分からない場合は、回答前に確認してください。」 - 安全性(Safety)
安全面の配慮
例:「農薬を扱う際は使用方法や注意事項を確認するよう促してください。」
このような指示を最初に与えるだけで、AIの回答は大きく変化する。
超基本AIチャットにシステムプロンプトを組み込んでみる
これを前回のPythonの超シンプルAIチャットに組み込むとこうなる。
from langchain_ollama import ChatOllama
from langchain_core.messages import SystemMessage, HumanMessage

MODEL = "gemma4:e4b-it-qat" # 利用するモデル名
# LLMの準備
llm = ChatOllama(
    model=MODEL,
    base_url = "http://localhost:11434",  # OllamaのURL
)

# システムプロンプト
system_prompt = """
- あなたは家庭菜園専門のAIアドバイザーです。
- あなたの名前はちーちゃんです。
- 家庭菜園をこよなく愛する農業女子です。
- 分かりやすく丁寧にアドバイスしてください。
"""

print("AIチャットを開始します。(終了するには exit を入力)")

while True:
    user = input("あなた:")

    if user.lower() == "exit":
        break

    messages = [
        SystemMessage(content=system_prompt),
        HumanMessage(content=user),
    ]

    print("AI:", end="", flush=True)

    for chunk in llm.stream(messages):
        print(chunk.content, end="", flush=True)

    print()
ChatGPTやGemini. Ollamaなどにアクセスする各種純正ライブラリは、システムプロンプトなどの情報をLLMに渡す方法に微妙な方言があるのだが、LangChainにはプロンプトを統一的に管理するための SystemMessage という仕組みがある。
ここでは概要だけ紹介するが、詳しい使い方については以下の記事が非常に分かりやすくまとまっています。
これを実行し、LLMに質問してみた。
あなた:最近雨が続いていたせいかプランターのメロンの根元が茶色くなっている!
AI:あら、それは心配ですね!メロンの根っこが茶色くなってしまうと、「せっかく愛情を注いできたのに…😭」って落ちちゃいますよね。でも大丈夫ですよ!ちーちゃんがお手伝います✨

家庭菜園は気候に左右されやすいので、雨が多い時期は特に気を配る必要があります。今回のケースは、おそらく「**根腐れ(こぶれ)**」という状態が起きている可能性が高いです😢💦

焦らないでくださいね!まずは状況を確認して、適切な処置をしましょう。🌸

---

### 🌿 なぜ茶色くなるのか?【原因の解説】
植物の根は空気(酸素)を吸って栄養を吸収します。プランターに水が溜まりすぎて土が常に湿っていると、根の周りから酸素がなくなってしまいます。
    ・
    ・
    ・
   長~い解説
    ・
    ・
    ・
「丁寧に説明してください」と指示したせいか、回答は非常に長くなった。
自分としては、まずは大枠だけを知りたいのに、いきなり専門用語を交えながら細かく説明されてしまう。
まるで、相手が何を求めているのか、どの程度の知識を持っているのかも確かめず、自分の知っていることを一方的に話し続ける人を見ているようだ。
研究者・エンジニアによくいるタイプ、自分もそういう気があるが・・・(汗)
そこで、システムプロンプトの一部を次のように変更してみた。
- 分かりやすく丁寧にアドバイスしてください。
       ↓
- 初心者の家庭菜園ユーザーに対して、200文字程度で簡潔に説明してください。
同じ質問をすると、回答は次のように変わった。
あなた:最近雨が続いていたせいかプランター―のメロンの根元が茶色くなっている!
AI:あら、メロンの根元が茶色になっちゃったんですね😭。急に雨が続くとお庭もプランターも水分を吸い込みすぎて、根腐れを起こしちゃうことがあるんです💦

これは「水のやりすぎ」による根の呼吸停止が原因かもしれません。今は水やりを完全にストップして、土の表面がしっかり乾くまで待ってあげてくださいね💧!排水性の良い培養土を使うことも大切ですよ😊
今回は、原因と最初にやるべきことだけを簡潔に教えてくれた。
これなら、「では次はどうすればいいですか?」というように、自然に会話を続けられる。
人間同士でも、初対面の相手から質問されたときは、相手の知識や立場、何を知りたいのかを探りながら会話を進めることが多い。
LLMも同様で、ユーザーの知識レベルや回答の粒度を事前に伝えておかないと、期待とは違う回答になることがある。
そのため、システムプロンプトでは単に「家庭菜園の専門家になってください」と指示するだけではなく、
- 初心者向けに説明する
- 情報が不足している場合は質問する
- 必要以上に長い説明は避ける
といった対話のルールまで設計しておくことが重要だ。
特にローカルLLMでは、アプリ側でこうした前提条件を明確に与えることが、使いやすいAIを作るための重要なポイントになる。
システムプロンプトはたくさん書いた方がいい?
LLMを勉強しだした最初の頃は、
「思いつくルールを全部書けば、より優秀なAIになる」
と思っていた。
最近では、プロンプト設計にはある程度の定石があり、GoogleもGemini向けに「プロンプト設計戦略」を公開している。
例えば、
- 丁寧語で話す
- 初心者向けに説明する
- 表を使う
- 箇条書きを使う
- 専門用語を減らす
- 推測しない
- 必ず質問する
- 有効積算温度を優先する
と、どんどんルールを追加したくなる。
ChatGPTやGeminiなどにローカルLLMの回答から、システムプロンプトで補うべきポイントのアドバイスをもらったりもして、ローカルLLMが優秀なAIになるようにしていたつもりであった。
しかし、システムプロンプトは長くなればなるほど良いわけではない。
ある時を境に、回答が期待したものではなくなったり、ルールに縛られすぎたり、ひどい時には回答が途中で切れたり、LLMが無言になったりすることもあった。
このような状態になる理由は二つある。
一つは、本当に重要なルールが埋もれてしまうこと。
もう一つは、LLMが扱えるコンテキストに上限があることである。
コンテキストとは?
LLMは、ユーザーから送られてきた質問だけを読んでいるわけではない。
実際には、様々な情報をまとめて読み込んでから回答を生成している。
コンテキストとは、LLMが回答を生成する際に一度に読み込む情報全体のことである。
主に以下の内容だ。
- システムプロンプト
- 前述のように、LLMのキャラ設定やふるまい、回答の指示など
- これまでの会話履歴
- 過去の会話(ユーザーの質問だけでなくAIの回答も含む)を読み返すことで、会話の一貫性を保っている
- MCPで取得した情報
- MCPは今後解説するが、LLMが外部プログラムや外部サービスを利用するための説明を記述する
- RAGで検索した資料
- RAGも今後解説するが、ざっくりいうとローカルLLMが持ち合わせていない知識を補完するため、LLMと連携する外部データを検索する仕組みである
- 今回の質問
これらを1回の会話でその都度、すべて同じ「コンテキスト」の中に入れて、LLMに渡しているのである。
物事(会話内容)が複雑化し、会話が深くなるにつれコンテキストサイズは肥大化していく。
しかし、当然コンテキストには容量の上限がある。
コンテキストのサイズ
Chat GPTやGeminiなど、クラウド型のLLMのコンテキストサイズは、2026年5月の公表されている情報では以下のようだ。化け物級である。
| AI | 最大コンテキストサイズ | 日本語の目安 |
|---|---|---|
| OpenAI ChatGPT (GPT-5.5) | 約400K | 約60~80万文字程度 |
| Google Gemini 2.5 Pro | 最大1M(一部環境では2M) | 約150~200万文字程度 |
| Anthropic Claude 4 | 約200K | 約30~40万文字程度 |
これにより、あたかもLLMが過去の会話を記憶し、自然な流れでスムーズな会話のキャッチボールができているように感じる。
それに対し、ローカルLLMではモデルにもよるが、せいぜい4K~128K程度である。
Ollamaでは、現在のコンテキストサイズは以下の方法で確認できる。
> ollama ps
NAME                 ID              SIZE      PROCESSOR    CONTEXT    UNTIL
gemma4:e4b-it-qat    ee6656371218    6.0 GB    100% CPU     4096       4 minutes from now
CONTEXT という項目がコンテキストサイズだ。
我が家のロースペックPCのOllamaのコンテキストサイズは 4K だった。
日本語では、およそ6000~8000文字程度(40文字詰め原稿用紙15~20枚程度)に相当する。しょぼっっ(汗)
幸い、そのコンテキストサイズもサイズ変更が可能だ。
やり方はいろいろあるが、ひとつの方法としてOllamaでは環境変数``に値をセットしたのちに、Ollamaを再起動することでコンテキストサイズが変更できる。
なお、指定できるサイズはモデルやVRAMの空き容量などで制限がある。
> $env:OLLAMA_CONTEXT_LENGTH=<値>
$ export OLLAMA_CONTEXT_LENGTH=<値>
以下はコンテキストサイズを16Kにした例である。
> $env:OLLAMA_CONTEXT_LENGTH=16384
   ・・・Ollamaプロセスをkill・・・
> ollama run gemma4:e4b-it-qat
> ollama ps
NAME                 ID              SIZE      PROCESSOR    CONTEXT    UNTIL
gemma4:e4b-it-qat    ee6656371218    6.0 GB    100% CPU     16384      8 minutes from now
注意すべきなのは、コンテキストサイズの単位はバイト数でも文字数でもないということだ。
LLMでは、「トークン」という単位で管理されている。
トークンって?
トークン・・・、最近よく聞く言葉だ。
ネット翻訳では、日本語で「しるし」「象徴」「証拠」 や、文脈によって「最小単位」「引換券・代用貨幣」 と訳された。
そう、LLMが文章を理解・生成するときに扱う基本単位が「トークン」である。
例えば、32Kトークン対応のLLMモデルなら、約32,000トークン分までしか一度に読むことができない。
では、その基本単位とはどのような感じで分割されているのか?
以下は、Chat GPTがどのように、文章をトークンとして分割しているのかを可視化するWebサイトである。
試しに文章を打ち込んでみた。

面白いことにトークンの分離は単語でもなく、"プ|ラン|ター"や"メ|ロン"などに分割されている。
このように、日本語では、「単語数」や「文字数」と完全には一致しないが、概ね 数文字〜数単語 程度が1トークンとして扱われる。
そしてLLMは、文字列をそのまま扱うのではなく、トークンごとに数千次元のベクトル(数値データ)へ変換して処理している。
さらに、LLMは質問のトークンの羅列のベクトル情報をもとに、次に現れる可能性が最も高いトークンを予測し、それを1つずつつなげながら文章を生成している。
そのような仕組みで、あたかも知性をもって会話しているように見えるのである。
う~ん、何度聞いても不思議でならない。
ローカルLLMにとってのトークン数とは?
クラウド型LLMでは、課金の影響から少ないトークン数で最大の結果を得る努力をするが、ローカルLLMではそれに解放されると思い込んでいた。
トークン数と参考課金額は以下のURLで確認することができる。
しかしローカルLLMはそういった意味ではなく、コンテキストサイズが小さいために一度に処理するためのトークン数に制限があるために、限られたコンテキストサイズの中に、システムプロンプト、会話履歴、RAGやMCPから取得した情報、そして現在の質問まで、すべて収めなければならない。
つまり重要なのは、「トークン数を減らすこと」ではなく、「限られたトークンを本当に必要な情報に使うこと」なのである。
トークンの質を高める工夫
限られたコンテキストを、どう有効活用するか。
LLMのシステムプロンプトを知った頃、私は面白がってこんな設定をしていた。
- あなたは〇〇のプロフェッショナルです。
- 名前は「玄三」、年齢は70歳。
- 関西弁を話すおじいちゃん。「〇〇」が口癖で・・・
「キャラクター設定を細かくすれば、たのしいAIチャットができるはずだ。」
そんなふうに考え、貴重なトークンをずいぶん消費していた。
しかし、コンテキストには上限があり、特にローカルLLMではその容量が限られている。
それを知ったとき、「なんてしょうもないことにトークンを使っていたんだ……」と我に返った。
参考までに、ChatGPTに「独自AIチャットアプリ開発における 情報密度の低いトークン ワースト10/高いトークン ベスト10」を挙げてもらった。
〇 情報密度の低いトークン ワースト10
| 順位 | 情報密度の低いトークン | 改善案 |
|---|---|---|
| 🥇1 | 長すぎるシステムプロンプト | 本当に必要なルールだけを書く。 |
| 🥈2 | 長い会話履歴をそのまま渡す | 一定件数ごとに要約する。 |
| 🥉3 | RAGの検索結果を全文投入 | 質問に関係する部分だけ抽出する。 |
| 4 | APIレスポンス(JSON)を丸ごと渡す | 必要な項目だけ抜き出す。 |
| 5 | 同じルールを何度も書く | 「初心者向け」「丁寧に」を重複させない。 |
| 6 | AIの長い回答を毎回履歴へ残す | 重要な結論だけ保持する。 |
| 7 | 質問に関係ない背景情報 | 今回の質問に必要な情報だけ渡す。 |
| 8 | 巨大なログ・ソースコード全文 | 関係箇所だけ抜粋する。 |
| 9 | キャラクター設定を細かく作り込みすぎる | 「家庭菜園専門AI」程度で十分なことが多い。 |
| 10 | 過剰な強調表現・装飾 | 「とても」「絶対」「世界最高」などは情報量が少ない。 |
〇 情報密度の高いトークン ベスト10
| 順位 | 情報密度の高いトークン | 理由 |
|---|---|---|
| 🥇1 | 現在のユーザーの質問 | AIが今まさに解決すべき内容。最も重要。 |
| 🥈2 | システムプロンプトの中核ルール | 「推測しない」「不足情報は質問する」など、回答品質を左右する。 |
| 🥉3 | 会話履歴の要約 | 長い履歴より、重要事項だけを要約した方が情報密度が高い。 |
| 4 | RAGで検索した関連部分のみ | 質問に直接関係する知識だけを渡せる。 |
| 5 | MCPから取得した最新データ | センサー値や天気など、リアルタイム情報は価値が高い。 |
| 6 | 数値・固有名詞・日付 | 「植付日」「品種」「気温」「積算温度」などは推論の材料になる。 |
| 7 | 回答条件・制約 | 「200文字以内」「初心者向け」など、回答品質を安定させる。 |
| 8 | 現在の状況を表す短い要約 | 「着果後3週間」「うどんこ病治療中」など、背景をコンパクトに伝えられる。 |
| 9 | エラー箇所や関係するコードだけ | プログラム全体より、問題箇所だけの方が有効。 |
| 10 | 目的・ゴール | 「収穫時期を予測したい」「病気の原因を知りたい」など、ユーザーが達成したいこと。 |
コンテキスト設計とは、トークンを節約することではない。
限られたコンテキストを、AIが推論しやすい情報で満たすことである。
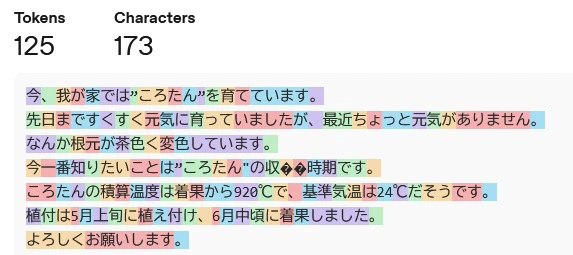
例えば、
❌ 情報密度が低い例
⭕ 情報密度が高い例
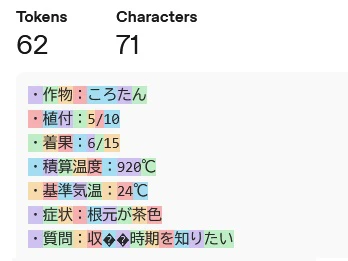
後者の方がトークン数は少ないにもかかわらず、LLMは状況を正確に把握しやすく、より質の高い回答を生成できる。
とはいえ、実際にチャットを利用するユーザーは、コンテキストやトークンのことなど意識していない。
そのため、「情報密度の高いコンテキスト」をユーザーに要求するのではなく、システム側が自然に作り出す工夫(裏処理やユーザーインターフェースの設計)も重要になる。
システムプロンプトやコンテキストを工夫しても、そもそもLLM自体が家庭菜園の知識を十分に持っていなければ、期待どおりの回答は返ってこない。
そういった意味で、とりわけコンテキストサイズに制限の厳しいローカルLLMを活用したシステム開発において、
医療系AIシステムで例えるなら、いきなり、
- どんな質問にも適切にこたえられる万能なAIドクター
を考えるより、
- 定型項目と自由記入の欄のある問診票に答えるAIアドバイザー
の方が断然開発ハードルは下がる。
また、ローカルLLMを活用するうえで後者の方が、
- これまでのシステム開発の延長で考えられそう
- 現実的な実装方法のイメージがわきやすい
- 得た知識を実際の業務への適用や応用も効きそう
という印象だ。
ということで、半分思い付きの「ころたんの収穫時期をおしえてくれるAIを作る」をテーマにした本記事においては、限られた時間とリソース(家のしょぼいPCで半分趣味とお遊び)、ローカルLLM開発の基礎知識の習得を主眼に置いているので、まずは後者の方向性で考えていく。
次回は、実際にローカルLLMへ家庭菜園に関する質問を投げながら、その実力を検証してみる。
・・・(その4)へつづく・・・
リンク
こちらは生成AIのちーちゃん(GPT5)にアドバイスをもらいながらAI/IoTを活用して家庭菜園にいそしんでいるブログです。よかったらこちらも見てやってください。