
概要
個人的な備忘録を兼ねたPyTorchの基本的な解説とまとめです。GPTタイプ (自己回帰型の言語モデル)の事前学習の演習で学んだことをまとめてみました。今回からはGPT2の構造を修正して、「GPTのLlama化」を演習してみたい。
Llama化シリーズで扱いたい内容例
- RMSNorm:今回
- SwiGLU:今回
- RoPE
- KVキャッシュ
今回の目的は生成内容よりもRMSNormとSwiGLUの実装にあります。一応、生成された文章について簡単に掲載しました。学習データそのままっぽいのが生成されているように見えますが、最初の文章はNGでした。

図1:生成結果のサンプル
シリーズの方針は3種類ありました。
- できるだけ同じコード進行
- できるだけ簡潔(細かい内容は割愛)
- 特徴量などの部分,あえて数値で記入(どのように変わるかがわかりやすい)
SwiGLUを始め様々な部品が追加されるので、コードの流れも初回からだんだん乖離しています。いよいよ今回からすべての方針を削除するときがきたようです。
演習用のファイル
-
トークナイザー: livedoor_tokenizer_10k.json
- LivedoorニュースコーパスのHOMMEカテゴリーをデータとしてbytelevel BPEで学習した8Kトークナイザー
-
学習データ:livedoorニュースコーパスのlivedoor-movieカテゴリー
-
事前学習済みモデル:movie_rms_swiglu_seq_256_bpe_10k.model
- 系列長256のモデル。seq_len=256で動作します。
-
コード: sample_42.ipynb
-
検証に利用したプロンプト:movie_prompt.csv
1. RMSNormとSwiGLUによる改良
GPT2タイプのモデル以降、基本構造を保ちつつ効率性を高めるために様々な改良が進んでいます。Llama2やLlama3でも導入された方法をいくつか取り入れて演習をしてみました。
自分が書いていてわかりにくくなるので第41回までの小型の自作GPTタイプのネットワークをGPT型と表現しています。
1.1 RMSNorm (Root Mean Square Normalization)
GPT型の層正規化層(LayerNorm(x))は、$x$の平均 $\mu$ と分散 $\sigma^2$、学習可能なパラメータ $\beta\in\mathbb{R}^{n}$ と $\gamma\in\mathbb{R}^{n}$ を使って、次のように計算されていました。
$$
\text{LayerNorm}(x) = \gamma \odot \frac{x-\mu}{\sqrt{\sigma^2 + \varepsilon}} + \beta
$$
ここから平均 $\mu$ の減算(re-centering)とバイアス項 $\beta$ を取り除いて簡略化した正規化層がRMSNorm (Root Mean Square Normalization・二乗平均平方根による正規化) です。$\mu = 0$ とおくと $\sigma^2 = \frac{1}{n}\sum_i x_i^2$ となり、分母は $x$ の二乗平均平方根 RMS$(x)$ になります。
$$
\text{RMSNorm}(x) = \gamma \odot \frac{x}{\sqrt{\frac{1}{n}\sum_{i}x_{i}^2 + \varepsilon}}
$$
計算を簡略化しても性能が変わらないことが Zhang and Sennrich (2019) によって報告されています1。計算効率が上がるけれど性能低下もほぼない、というのが導入の大きなメリットのようです。PyTorchにnn.RMSNormとして提供されています。GPT型の実装で登場しているLayerNormをRMSNormに置き換えれば完成です。
1.2 SwiGLU
Transformerブロックに登場するMLPを変更します。SwiGLUという名称から、GELUと似ているので活性化関数を置き換えるだけかと思っていました。甘かった😅 SwiGLUは活性化関数というよりもTransformerブロックに登場するMLP (FFN) 全体を置き換えるものでした😅

図2:MLPブロック(GPT型Transformer)
SwiGLUまでの発展の系譜を活性化関数のSwish関数から簡単にまとめてみました。
(1) Swish関数
Ramachandran el al. (2017)が提唱した活性化関数で、
$$
\text{Swish}(x) = x\cdot\sigma(\beta x)
$$
と定義されています。$\sigma$は鉄板のシグモイド関数、$\beta$は学習可能なパラメータです。この$\beta$を1に固定した
$$
\text{SiLU}(x) = x\cdot\sigma(x)
$$
はSiLU (Sigmoid Linear Unit) と呼ばれているようです。PyTochだとnn.SiLU( )です。

図3:SiLUのグラフ
(2) GLU (Gated Linear Unit)
Dauphin et al. (2017)が提唱したGLU (Gated Linear Unit)は、ゲート機構を持つ線形層です。
$$
\text{GLU}(x) =
\text{fc1}(x) \odot \sigma( \text{fc2}(x))
$$
fc1側で特徴量を抽出します。シグモイド関数の値域が 0〜1なので、その値を確率とみなして、fc2側で特徴量の通過確率を決めていると解釈できます。$\odot$は要素ごとの積を計算するという意味で利用しています。
(3) SwiGLU (Swish Gated Linear Unit)
GLUのシグモイド関数部分をSwish関数に置き換えた構造が SwiGLU となります。線形層を利用したネットワーク層の一つになっています。
$$
\text{SwiGLU}(x) =
\text{fc1}(x) \odot \text{Swish}( \text{fc2}(x))
$$
Noam Shazeer (2020) による提案で、理由はわからないですが同じステップでも損失が低い傾向があるようです。また、多くの実装ではSwish関数よりもβ=1としたSiLU (sigmoid linear unit)が使われているようです。実装上は、
$$
\text{SwiGLU}(x) =
\text{fc1}(x) \odot \text{silu}( \text{fc2}(x))
$$
のようになります。
🤔SiLU( )は値が無限大にまで発散しそうだから通過確率みたいな解釈がやや難しくなるな🤔
(4) SwiGLUを導入したFFNの実装
GPT型のTransformerブロックで利用したMLPは

図4:MLPブロック
という直線的なものでした。このネットワーク (MLP) を「Swish関数+ゲート構造」をもつ SwiGLU で書き換えてFFNと呼称しておきましょう。FFNをTransformerブロックで利用することになります。

図5:FFNブロック(SwiGLU+Linear)
図5の流れを式で書き表すと
$$
FFN(x)=W_{down}(SiLU(W_{gate}x)\odot W_{up}x)
$$
のようになります。
- $SiLU(x) = x\cdot\sigma(x)$
- SiLU側でゲートを表現している
- $W_{up}$側で特徴量の抽出
- $W_{down}$側で最終出力
Dropout層を追加してコード化したものが次の形です2。
class FFN(nn.Module):
    """SwiGLUの定義に従って書き下したバージョン"""
    def __init__(self, config):
        super().__init__()
        hidden = config.dim_feedforward
        self.w_gate = nn.Linear(config.d_model, hidden, bias=False)
        self.w_up   = nn.Linear(config.d_model, hidden, bias=False)
        self.w_down = nn.Linear(hidden, config.d_model, bias=False)
        self.activation = nn.SiLU()
        self.dropout = nn.Dropout(config.dropout)

    def forward(self, x):
        gate = self.activation(self.w_gate(x))    # ゲート側
        up   = self.w_up(x)                       # そのまま通過の特徴量
        return self.dropout(self.w_down(gate*up)) # 線形層で形状を整える出力
説明メモ
- GPTタイプではMLPブロックでLinear層を2つ、一方、SwiGLUバージョンのFFNブロックではLinear層を3つ使用しています。SwiGLUの効果を検証するときはFFNブロックの特徴量を2/3倍して、比較前後のパラメーター数揃える必要がありそうです。今回は実装メインなので細かい調整は割愛してしまいましょう😆
2. データ
livedoorニュースコーパスのlivedoor movieカテゴリーに分類されているテキストデータを使います。すでにHOMMEカテゴリー、ITカテゴリーで試したのでMOVIEカテゴリーで試してみます。映画カテゴリーはファイル数が800個超えているので他のカテゴリーよりやや学習時間がかかりそうです。
前処理
- 文頭から3行のURL、日付、タイトルの削除 (演習はこの状態で事前学習しました)
- ライセンス的に改変したデータをアップロードできないのが残念 😓
 😓
3. トークナイザー
ニュースコーパス全体を利用してトークナイザーを作成しました。学習したトークナイザーの特殊トークンと語彙数を確認しておきます😆
from tokenizers import Tokenizer

tokenizer_filename = "./tokenizer/livedoor_10k.json"  # 利用するトークナイザー
tokenizer = Tokenizer.from_file(tokenizer_filename)

print("特殊トークンID:")
print(f"<pad>: {tokenizer.token_to_id('<pad>')}")              # <pad>: 0
print(f"<eod>: {tokenizer.token_to_id('<eod>')}")              # <eod>: 1
print(f"<system>: {tokenizer.token_to_id('<system>')}")        # <system>: 2
print(f"<assistant>: {tokenizer.token_to_id('<assistant>')}")  # <assistant>: 3
print(f"<user>: {tokenizer.token_to_id('<user>')}")            # <user>: 4
print(f"size: {tokenizer.get_vocab_size()}")                   # size: 10,000
4. モデル設定と学習
GPT型を拡張するだけなので、基本的なコードの流れも今までと同様にできるはず!
- 準備 (4.1)
- ネットワークモデルの設定や定義 (4.2)
- Dataset・DataLoaderによるデータの読み込み (4.3)
- 誤差関数と誤差最小化の手法の選択 (4.4)
- 変数更新のループ (4.5)
- 検証 (4.6)
4.1 準備
利用するライブラリーを読み込みます。
import math
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import Dataset, DataLoader
from tokenizers import Tokenizer
from pathlib import Path


device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"{device=}")
利用するデータセットのディレクトリー、トークナイザー、学習したモデルの保存ファイル名を指定します。
data_dir = "./data/movie_texts/"     # 学習用データのディレクトリ
tokenizer_filename = "./tokenizer/livedoor_10k.json"  # 利用するトークナイザー
pretrain_filename = "model/movie_rms_swiglu_seq_256_bpe_10k.model"

# トークナイザー
tokenizer = Tokenizer.from_file(tokenizer_filename)
4.2 ネットワークモデルの設定や定義
ModelConfigクラスで、系列長、特殊トークンのID、バッチサイズなどの基本的な数値を定めます。GPT型にRMSNormとSwiGLUを導入したネットワークモデルを構成します。
4.2.1 モデルの設定
モデル設定のクラスです。ネットワーク層で利用される数値を一括して管理するクラスです。
class ModelConfig:
    def __init__(self, tokenizer):
        # モデル構造
        self.vocab_size = tokenizer.get_vocab_size()
        self.seq_len = 256   # 128トークンだとSFT時に少ない
        self.d_model = 256   # 512
        self.nhead = 8
        self.dim_feedforward = 4*self.d_model
        self.num_layers = 6
        self.dropout = 0.1

        # 特殊トークンID
        self.pad_token_id = tokenizer.token_to_id("<pad>")
        self.eod_token_id = tokenizer.token_to_id("<eod>")

        # 学習データに関する設定
        self.context_size = self.seq_len         # 学習できる長さ

        # 学習設定
        self.batch_size = 128
        self.learning_rate = 0.001  # これだとデフォルトと変わらない
        self.num_steps = 3500
        self.max_grad_norm = 1.0
        self.ignore_index = -100
        self.weight_decay = 0.01

    # 今回利用しない属性を追加・更新するメソッド
    def update(self, **kwargs):
        """渡されたキーワード引数で設定を動的に追加・更新する"""
        for key, value in kwargs.items():
            setattr(self, key, value)
ModelConfigクラスといっても、数値を並べてるだけのクラスです。系列長を表すseq_lenには注意が必要です。小さすぎると文章をうまく生成することができませんし、大きな数値だと、消費されるVRAMも巨大化します。簡易的な、指示チューニングまで考慮すると、256トークン以上は必要と思われます。事前学習して文章の生成結果を確認するだけなら、系列長のseq_len=128として、10分程度 (Colab T4) で学習も終了します。
4.2.2 Transformerブロック
GPT型Transformerブロックの2箇所を変更するだけです。
- LayerNormをRMSNormへ
- MLPブロックをFFNブロックへ
PyTorchのTransformerブロックを参考にCausalSelfAttentionクラスを作成しています。図6の構造を左から順番に並べるだけです。

図6:RMSNorm+SwiGLUのTransformerブロック
# (1) 因果マスク付きの自己注意
class CausalSelfAttention(nn.Module):
    def __init__(self, config):
        super().__init__()
        assert config.d_model % config.nhead == 0
        self.nhead = config.nhead
        self.head_dim = config.d_model // config.nhead

        # q,k,v をまとめて1個で表現
        self.qkv = nn.Linear(config.d_model, 3 * config.d_model, bias=False)
        self.proj = nn.Linear(config.d_model, config.d_model, bias=False)
        self.attn_dropout_p = config.dropout
        self.resid_dropout = nn.Dropout(config.dropout)

    def forward(self, x):
        bs, seq_len, d_model = x.shape
        q, k, v = self.qkv(x).split(d_model, dim=2)
        # (bs, seq_len, d_model -> (bs, nhead, seq_len, head_dim)
        q = q.view(bs, seq_len, self.nhead, self.head_dim).transpose(1, 2)
        k = k.view(bs, seq_len, self.nhead, self.head_dim).transpose(1, 2)
        v = v.view(bs, seq_len, self.nhead, self.head_dim).transpose(1, 2)

        # PyTorchのScaled Dot Product Attention
        # 条件が合えばFlashAttentionなどの高速実装が自動選択される
        y = F.scaled_dot_product_attention(
            q, k, v,
            attn_mask=None,
            dropout_p=self.attn_dropout_p if self.training else 0.0,
            is_causal=True,
        )

        y = y.transpose(1, 2).contiguous().view(bs, seq_len, d_model)
        y = self.resid_dropout(self.proj(y))
        return y

# (2) SwiGLUを利用したFFNブロック
class FFN(nn.Module):
    """SwiGLUの定義に従って書き下したバージョン"""
    def __init__(self, config):
        super().__init__()
        hidden = config.dim_feedforward
        self.w_gate = nn.Linear(config.d_model, hidden, bias=False)
        self.w_up   = nn.Linear(config.d_model, hidden, bias=False)
        self.w_down = nn.Linear(hidden, config.d_model, bias=False)
        self.activation = nn.SiLU()
        self.dropout = nn.Dropout(config.dropout)

    def forward(self, x):
        gate = self.activation(self.w_gate(x))    # ゲート側
        up   = self.w_up(x)                       # そのまま通過の特徴量
        return self.dropout(self.w_down(gate*up)) # 線形層でMLPと同様に形状を整える出力

# (3) Transformerブロック
class TransformerBlock(nn.Module):
    """RMSNormに差し替え """
    def __init__(self, config):
        super().__init__()
        # self.ln1 = nn.LayerNorm(config.d_model)  # LayerNorm → RMSNorm
        self.ln1 = nn.RMSNorm(config.d_model, eps=1e-6)
        self.attn = CausalSelfAttention(config)
        # self.ln2 = nn.LayerNorm(config.d_model)  # LayerNorm → RMSNorm
        self.ln2 = nn.RMSNorm(config.d_model, eps=1e-6)
        self.ffn = FFN(config)

    def forward(self, x):
        x = x + self.attn(self.ln1(x))     # Attention(RMSNorm(x)) + x
        x = x + self.ffn(self.ln2(x))      # FFN(RMSNorm(x)) + x
        return x
CausalSelfAttentionクラス、FFNクラスを作成してTransformerブロックを実装していきます。まあ、並べるだけなのですが...
説明メモ
- (1) 因果マスク付きの自己注意
よくある$W_q$、$W_k$、$W_v$のAttention Linear 3兄弟をまとめて作成する形になっています。-
self.qkvの部分についてです。Q,K,V用のLinearを一つのLinearで扱っています。3 * config.d_modelと3倍されている部分に注目してください。 -
self.qkv(x).splitの部分でQ,K,Vをヘッド数に応じた形で分割します。 - 注意機構の部分。ここはPyTorchの関数を使っています

-
is_causal=Trueによって「未来のトークンを利用しない」自己注意として動作させています。
-
- (2) SwiGLUを利用したFFNブロック
- Transformer層の出力に向けたネットワーク層となります。層を繰り返し使えるようにw_downと命名した全結合層の出力次元が
d_modelとなります。
- Transformer層の出力に向けたネットワーク層となります。層を繰り返し使えるようにw_downと命名した全結合層の出力次元が
- (3) Transformerブロック
- LayerNormをRMSNormに変更します。
- 名前もGPT型のMLPブロックを、FFNブロックへ改名しました。
4.2.3 GPTタイプのネットワークモデル
Transformerブロックが作成できたので、「埋め込み層、causalマスク付きのtransformerブロック、全結合層で次の単語予測」という形のネットワーク構造を作ればRMSNormとSwiGLUに修正した自己回帰型のモデルが完成となります。
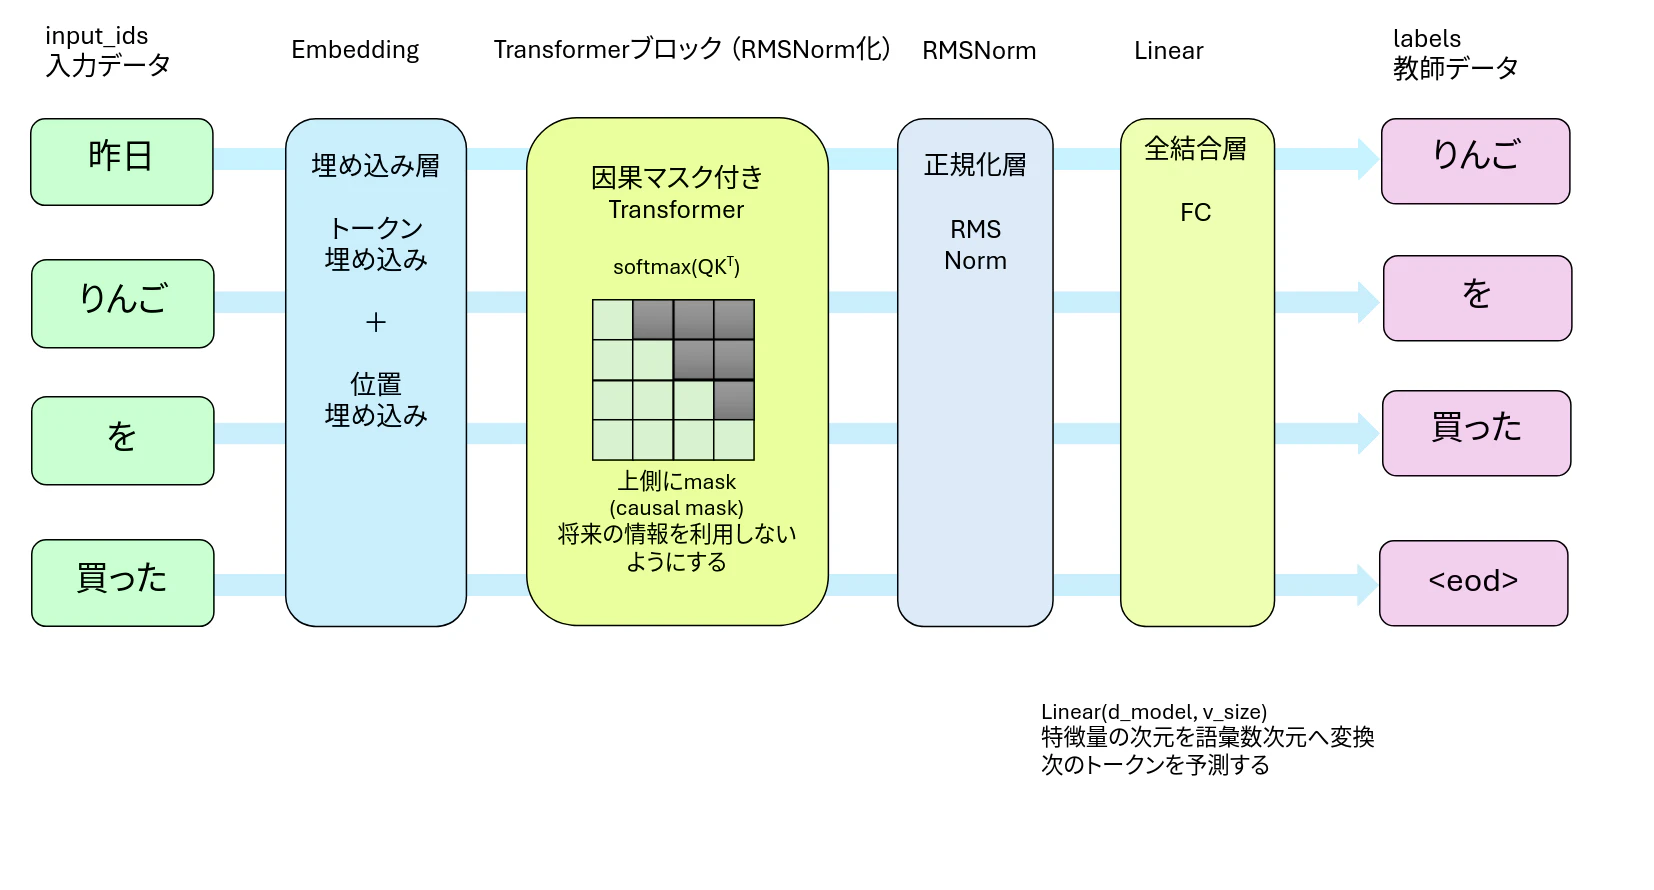
図7:自己回帰型のネットワーク構造
図7に従い順番にネットワーク層や作成したネットワークブロックを並べていきます。正規化層をRMSNormに変更する点に注意が必要です。
class DNN(nn.Module):
    def __init__(self, config: ModelConfig):
        super().__init__()
        self.config = config

        # (1) 埋め込み層
        self.token_embedding = nn.Embedding(num_embeddings=config.vocab_size, embedding_dim=config.d_model)
        self.pos_embedding = nn.Embedding(num_embeddings=config.seq_len, embedding_dim=config.d_model)
        self.dropout = nn.Dropout(config.dropout)

        # (2) transformerブロック
        self.transformer_blocks = nn.Sequential(*[TransformerBlock(config) for _ in range(config.num_layers)])

        # (3) 最後の出力に向けた正規化とFC層 最終的に単語数になる
        #self.layer_norm = nn.LayerNorm(config.d_model)
        self.layer_norm = nn.RMSNorm(config.d_model, eps=1e-6)
        self.fc = nn.Linear(config.d_model, config.vocab_size,bias=False)
        self.apply(self._init_weights)                    # 個別に初期化
        self.fc.weight = self.token_embedding.weight      # (4) 重み共有


        # 残差方向の出力層だけ 1/sqrt(2N) スケール
        std = 0.02 / math.sqrt(2 * config.num_layers)
        for pn, p in self.named_parameters():
            if pn.endswith("proj.weight") or pn.endswith("w_down.weight"):
                nn.init.normal_(p, mean=0.0, std=std)

    def _init_weights(self, module):
        if isinstance(module, nn.Linear):
            nn.init.normal_(module.weight, mean=0.0, std=0.02)
            if module.bias is not None:          # fc は bias=False なのでスキップ
                nn.init.zeros_(module.bias)
        elif isinstance(module, nn.Embedding):
            nn.init.normal_(module.weight, mean=0.0, std=0.02)
            if module.padding_idx is not None:   #  padding_idxは None なのでスキップ
                with torch.no_grad():
                    module.weight[module.padding_idx].zero_()


    def forward(self, x):
        bs, seq_len = x.shape
        positions = torch.arange(seq_len,device=x.device)

        tok_emb = self.token_embedding(x)
        pos_emb = self.pos_embedding(positions).unsqueeze(0)
        x = tok_emb + pos_emb           # トークン埋め込み+位置埋め込み
        x = self.dropout(x)
        x = self.transformer_blocks(x)  # 自己回帰型 transformer
        x = self.layer_norm(x)          # RMSNorm正規化
        logits = self.fc(x)             # NTP: 次のトークン予測
        return logits
説明メモ
- (1) トークンをベクトル化する
token_embeddingと、位置情報をベクトル化するpos_embeddingを足し合わせます。 - (2) Transformerブロック。nn.Sequentialを利用することで繰り返し処理をforward部分で記載せず、きれいに表現できます。
- (3) GPT型のLayerNormをRMSNormへ変更して、
RMSNorm→fcでvocab_size次元に射影。これが各位置での次トークンのスコア(logits)となります。 - (4) 重み共有 (weight tying)はそのまま残しました。
- その他の初期化部分もGPT型を踏襲しています。
モデルの確認
tokenizerを指定して、ModelConfigを使って設定を読み込みます。ModelConfigもモデル関連の部分と学習関連の部分に分割したほうがいいのかな🐾
config = ModelConfig(tokenizer)
model = DNN(config).to(device)
torchinfoで大まかな構造とパラメータ数を確認しました。
from torchinfo import summary

summary(
    model,
    input_size=(1, config.seq_len),        # (batch, seq_len)
    dtypes=[torch.long],                   # 埋め込みの入力は整数インデックス
    depth=2,
)
summary部分にひと工夫すれば、入出力形状も表示されるようです。
===============================================================================================
Layer (type:depth-idx)                        Output Shape              Param #
===============================================================================================
DNN                                           [1, 512, 10000]           --
├─Embedding: 1-1                              [1, 512, 256]             2,560,000
├─Embedding: 1-2                              [512, 256]                131,072
├─Dropout: 1-3                                [1, 512, 256]             --
├─Sequential: 1-4                             [1, 512, 256]             --
│    └─TransformerBlock: 2-1                  [1, 512, 256]             1,049,088
│    └─TransformerBlock: 2-2                  [1, 512, 256]             1,049,088
│    └─TransformerBlock: 2-3                  [1, 512, 256]             1,049,088
│    └─TransformerBlock: 2-4                  [1, 512, 256]             1,049,088
│    └─TransformerBlock: 2-5                  [1, 512, 256]             1,049,088
│    └─TransformerBlock: 2-6                  [1, 512, 256]             1,049,088
├─RMSNorm: 1-5                                [1, 512, 256]             256
├─Linear: 1-6                                 [1, 512, 10000]           2,560,000
===============================================================================================
Total params: 11,545,856
Trainable params: 11,545,856
Non-trainable params: 0
Total mult-adds (Units.MEGABYTES): 78.52
===============================================================================================
Input size (MB): 0.00
Forward/backward pass size (MB): 138.48
Params size (MB): 46.18
Estimated Total Size (MB): 184.67
===============================================================================================
SwiGLUの部分、パラメータ調整(2/3倍してパラメータ数を近づける作業)を行っていないので、Linear層1個分だけパラメータが増加します。
torchinfoによると🤔1000万パラメータとなります🤔 モデルサイズが10M、心配なくらい小さいです しかも、トークン埋め込みの部分に250万パラメータとかなりの部分を使っています。そういえば、トークン埋め込みと最終層の全結合層は重みを共有しているので、実質的な学習パラメータって、740万パラメータくらいかな?とても小さなモデルです。
大まかにみると、30%程度がトークン埋め込みパラメータとなり、文脈理解の部分は残りの70%に委ねられています。文脈理解度を上げるにはModelConfigのd_modelサイズを大きくする必要がありそうです。
4.3 Dataset・DataLoaderによるデータの読み込み
RandomGPTDatasetクラスもこれまで何度も登場している形です。日本語テキストを入力すると、開始位置をランダムに決めたcontext_sizeのIDベクトルを生成を担当するクラスとなります。ファイル毎に<eod>トークンを挿入して内容の切れ目を表現しています。
class RandomGPTDataset(Dataset):
    def __init__(
        self,
        data_dir,
        tokenizer,
        context_size=128,
        samples_per_epoch=10_000,
    ):
        self.context_size = context_size
        self.samples_per_epoch = samples_per_epoch
        eod_id = tokenizer.token_to_id("<eod>")
        filenames = sorted(Path(data_dir).glob("*.txt"))

        all_ids = []
        for filename in filenames:
            text = filename.read_text(encoding="utf-8")
            document_ids = tokenizer.encode(text, add_special_tokens=False).ids
            all_ids.extend(document_ids)
            all_ids.append(eod_id)

        self.ids = torch.tensor(all_ids, dtype=torch.long)

    def __len__(self):
        # 1 epochあたりに何個のランダム窓を学習するか
        # 10,000個(回?)がデフォルト値
        return self.samples_per_epoch

    def __getitem__(self, idx):
        # idxは使わず、毎回ランダムな開始位置を選ぶ
        start = torch.randint(
            low=0,
            high=len(self.ids) - self.context_size,
            size=(1,),
        ).item()

        x = self.ids[start:start + self.context_size]
        y = self.ids[start + 1:start + self.context_size + 1]

        return {"ids": x, "labels": y}

dataset = RandomGPTDataset(
    data_dir=data_dir,
    tokenizer=tokenizer,
    context_size=config.context_size,
    samples_per_epoch=5_000,
)

dataloader = DataLoader(
    dataset=dataset,
    batch_size=config.batch_size,  # メモリ足りない場合は小さくする
    shuffle=False,
    num_workers=0,
    pin_memory=torch.cuda.is_available(), # GPU使う時True
)
RandomGPTDatasetクラス部分で入力されるデータは毎回シャッフルされます。DataLoaderでのシャッフルはFalseでOKです。
4.4 誤差関数と誤差最小化の手法の選択
RMSNormの学習パラメータ $\gamma\in\mathbb{R}^{n}$のような各特徴量のスケールを調整するようなパラメータが更新されるときに、重み減衰によって「学習による更新 + 0方向へのweight decay」という形で、パラメータが更新されます。しかし $\gamma$ には「0に近づけたい」という明確な理由がないため、weight decayが不要な0方向へのバイアスとなり、$\gamma$ が適切な値を学習するのを妨げる可能性があります。
要するに、RMSNormの $\gamma$ をweight decayの対象から除外します。
# weight decayの設定
decay, no_decay = [], []
for name, param in model.named_parameters():
    if not param.requires_grad:
        continue
    if param.dim() >= 2:
        decay.append(param)      # Linearの重み、Embedding
    else:
        no_decay.append(param)   # RMSNormのgain。これは 0へ

optim_groups = [
    {"params": decay,    "weight_decay": config.weight_decay},
    {"params": no_decay, "weight_decay": 0.0},
]

# AdamWの設定を使う
optimizer = torch.optim.AdamW(optim_groups, lr=config.learning_rate, betas=(0.9, 0.95), fused=(device.type == "cuda"))
criterion = nn.CrossEntropyLoss(ignore_index=config.ignore_index)    # 今回ignore_indexを利用していないがSFT用につけておく
betasの2つ目、β₂=0.999がPyTorchのデフォルト値です。今回はLLMの慣例に従い0.95にしました。
4.5 変数更新のループ
ステップ数でループの管理をします。GPT編以降コードを使いまわしています。
# step数で管理するためのデータローダー関数
def infinite_loader(dataloader):
    while True:
        for batch in dataloader:
            yield batch

data_iter = infinite_loader(dataloader)  # step数で計測

# ---- 学習ループの設定 tqdmを使わないほうが断然シンプル
from tqdm import tqdm               # tqdmを使い進捗状況表示をしてみた
max_iters = config.num_steps        # step数
total_token = 0                     # 累積トークン数を初期化
pbar = tqdm(range(max_iters))
use_bf16 = torch.cuda.is_available() and torch.cuda.is_bf16_supported()  # flash attentionを利用の判定

# ---- ここから学習ループ
model.train()                       # trainモードを明示
for step in pbar:
    batch = next(data_iter)
    input_ids = batch["ids"].to(device, non_blocking=True)
    labels = batch["labels"].to(device, non_blocking=True)
    optimizer.zero_grad()
    # GPUが対応している場合は、bf16へ変更してflash attentionを使う
    with torch.autocast(device_type=device.type, dtype=torch.bfloat16, enabled=use_bf16):
        outputs = model(input_ids)                 # [batch, seq_len, vocab_size]
        loss = criterion(
            outputs.view(-1, config.vocab_size),   # [batch * seq_len, vocab_size]
            labels.view(-1),                       # [batch * seq_len]
        )
    loss.backward()
    torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=config.max_grad_norm)  # 勾配クリップ
    optimizer.step()

    # このstepのトークン数 (バッチサイズ×系列長)を加算
    total_token += input_ids.shape[0] * input_ids.shape[1]

    # set_postfixは辞書が引数になる
    pbar.set_postfix({"loss": f"{loss.item():.4f}", "tokens": f"{total_token/1e6:.2f}M"})
    if (step+1) % 500 == 0:
        tqdm.write(f"{step+1}-step:\tloss:{loss.item():.3f}\ttokens:{total_token:,}")
説明メモ
表示用の設定と形状変更で、複雑に見えますが、基本構造は初回から変わっていません
for ループ
    input_ids, labels:入力データと教師データ
    optimizer_zero_grad()
    outputs = model(input_ids)
    loss = criterion(outputs, labels)
    loss.backward()
    optimizer.step()
今回もlossが1を下回るくらいになるまで頑張って学習させます。学習データやモデル、語彙サイズの関係からなのか詳細は不明ですが、lossは0.5程度を下回ると思います。文章を全暗記するレベル感です。暗記していない場合はモデルの構造がおかしいということになります。要チェックです。
メモリーが足りないというときは系列長やバッチサイズを環境に合わせて調整してください。10〜15分程度で終了になると思います。
ループ中に検証データを利用して細かく制御したほうが望ましいのですが、今回も実装実験がメインのため細かい部分は削除しました。
4.5 検証
文章生成の関数は、最大確率となるトークンを繋いでいく素朴なGreedyタイプです。
@torch.inference_mode()
def generate_text(
    model,
    input_ids,
    max_new_tokens=config.seq_len,
    eos_token_id=None,
):
    model.eval()    # 評価モードへ
    generated = input_ids.to(device)
    seq_len = model.config.seq_len

    # greedyで単純に生成
    # eos_token_id or max_new_tokensまでで生成終了
    for _ in range(max_new_tokens):
        logits = model(generated[:, -seq_len:])                     # 単語上の確率を計算
        next_token = logits[:, -1, :].argmax(dim=-1, keepdim=True)  # 確率が最大のトークン選択
        generated = torch.cat([generated, next_token], dim=1)       # 予測idを追記
        # 終了判定
        if eos_token_id is not None and next_token.item() == eos_token_id:
            break

    return generated
id化された文字列input_idsを入力して、modelを使い、次のトークンを予測して、トークン追加を繰り返すだけです。文章生成終端IDのeos_token_idが予測されたら文章生成終了となります。eos_tokenとして、<eod>を利用します。
生成結果の例は冒頭の画像と同じです。
図8:生成された文章のサンプル
次回
RoPEと思ったのですが、KVキャッシュで生成速度の高速化を試みたいと思います。
参考にした書籍、サイト&論文
解説本を中心に勉強しました。論文は代表的なもののみ確認してみました。
-
斎藤 康毅 (2026)
『ゼロから作るDeep Learning ❻ ―LLM編』オライリー・ジャパン- とてもわかり易い。しかも多色刷りで図解が丁寧すぎ😆掲載されているコードもエディターのように色分けされていて、驚き

- とてもわかり易い。しかも多色刷りで図解が丁寧すぎ😆掲載されているコードもエディターのように色分けされていて、驚き
-
- thirtypowerさんによるZennでの解説書籍。GPTやLLaMAのPyTorchによる自作実装についてゼロから解説されています。自作LLMを勉強する上で非常に参考になりました。しかも、無料公開。とてもおすすめです

- thirtypowerさんによるZennでの解説書籍。GPTやLLaMAのPyTorchによる自作実装についてゼロから解説されています。自作LLMを勉強する上で非常に参考になりました。しかも、無料公開。とてもおすすめです
-
- 式の展開もあり、いつもながら参考にしています。見るたび内容が増えている。
-
RMSNorm
Zhang and Sennrich (2019) "Root Mean Square Layer Normalization", arXiv:1910.07467 -
Swish
Ramachandran et al. (2017) "Searching for Activation Functions", arXiv:1710.05941 -
GLU
Dauphin et al. (2017) "Language Modeling with Gated Convolutional Networks", arXiv:1612.08083 -
SwiGLU
Noam Shazeer (2020) "GLU Variants Improve Transformer", arXiv:2002.05202
目次ページ