
目次と前回の記事
Python のバージョンとこれまでに作成したモジュール
本記事のプログラムは Python のバージョン 3.13 で実行しています。また、numpy のバージョンは 2.3.5 です。
| リンク | 説明 |
|---|---|
| marubatsu.py | Marubatsu、Marubatsu_GUI クラスの定義 |
| ai.py | AI に関する関数 |
| mbtest.py | テストに関する関数 |
| util.py | ユーティリティ関数の定義 |
| tree.py | ゲーム木に関する Node、Mbtree クラスなどの定義 |
| gui.py | GUI に関する処理を行う基底クラスとなる GUI クラスの定義 |
AI の一覧とこれまでに作成したデータファイルについては、下記の記事を参照して下さい。
今回の記事の内容
前回の記事では、多腕バンディット問題(Multi-arm Bandit Problem)を解く様々なアルゴリズムの土台となる基底クラスを MAB_Agent という名前で定義し、MAB_Agent クラスを継承することで、探索に全振りした原始モンテカルロ法の近似を行う Random_MAB_Agent クラスをほんの数行で簡潔に定義できることを示しました。
今回の記事では活用に全振りしたクラスを定義し、以前の記事で数式を使って考察した、以下の 2 つの極端なアルゴリズム を実際にプログラムを動かしてグラフを描画し、数式で考えていた「探索と活用のトレードオフ(ジレンマ)」が、実際のデータとしてどのようにグラフに現れるかを視覚的にわかりやすく比較、解説します。
- 探索に全振りしたアルゴリズム(完全ランダムに引き続ける)
- 活用に全振りしたアルゴリズム(手元のデータを信じて最善と思われるスロットマシンを引き続ける)
なお、MAB_Agent クラスの詳細な仕様については前回の記事を参照して下さい。
活用に全振りした Greedy_MAB_Agent クラスの定義
強化学習における活用は、それまでのステップで得られた情報を元に、最も当たりやすいと考えられるスロットマシンを選択します。このような、その時点で得られている情報の中から最善なものを選択するアルゴリズムの事を「貪欲法(greedy algorithm)」 と呼びます。
そこで、活用に全振りしたアルゴリズムのクラスの名前を Greedy_MAB_Agent と名付けることにしました。下記は Greedy_MAB_Agent クラスの定義です。前回の記事で定義した Random_MAB_Agent クラスと同様に、共通処理を基底クラス(MAB_Agent)に任せることで、子クラス側では NAME 属性の設定と、select_arm メソッドの数行を書くだけで新しいクラスを簡単に定義できます。select_arm メソッドの処理の内容は以前の記事と同じなので、忘れた方は復習して下さい。
from ai import MAB_Agent, Random_MAB_Agent
import numpy as np

class Greedy_MAB_Agent(MAB_Agent):
    NAME = "貪欲法"

    def select_arm(self):
        maxcoin = max(self.slot["mean_coin"])
        bestarms = []
        for arm in range(self.mab.num):
            if maxcoin == self.slot["mean_coin"][arm]:
                bestarms.append(arm)
        return np.random.choice(bestarms)
参考までに貪欲法の Wikipedia の項目のリンクを下記に示します。
アルゴリズムの比較
以前の記事で詳しく考察したように、探索に全振りしたアルゴリズムと、活用に全振りしたアルゴリズムは、どちらも獲得コインの総数(目的関数)が「すべてのスロットマシンの当たりの平均確率 ($p_{mean} = 0.5$)に試行回数を掛け算した枚数」付近で低迷してしまいますが、「同じような低いスコアになってしまう理由」は、両者の間で全く異なります。
そこで、Random_MAB_Agent(探索全振り)と Greedy_MAB_Agent(活用全振り)の実装クラスを使って、実際に 1,000 回のシミュレーション(エピソード)を行い、各種のグラフの挙動を比較することで、その決定的な性質の違いを明らかにします。
複数エピソードの実行と保存
最初に 2 つのアルゴリズムに対して、以前の記事と全く同じ以下の条件を設定し、「総ステップ数が 1 万回」の大規模なシミュレーションをそれぞれ 1,000 回ずつ実行 します。
- スロットマシンの台数:3 台
-
各スロットマシンの当たりの真の確率:
[0.3, 0.5, 0.7]
合計で数千万回もの計算をループさせるため、筆者のパソコンでは実行結果が示すように 2 つのエージェントの合計で約 6 分もの待ち時間が発生しました。時間をかけて集めた実験データは JupyterLab を閉じると消えてしまうため、計算したデータを save メソッドを呼び出してファイルに保存しておくことにします。
データの保存先フォルダは、これまでの一連の記事と同様に、プログラムがある場所から一つ上の階層にある data フォルダ("../data/")を指定します。引数に渡すベース名1はシンプルに "random_agent" と "greedy_agent" とします。これにより、フォルダ内には自動的に拡張子 .pkl がつけられた、圧縮済みのデータファイルが保存されます。
下記はその処理を行うプログラムです。
p = [0.3, 0.5, 0.7]
random_agent = Random_MAB_Agent(p=p)
random_agent.play_episodes(stepnum=10000, episodenum=1000)
random_agent.save("../data/random_agent")
greedy_agent = Greedy_MAB_Agent(p=p)
greedy_agent.play_episodes(stepnum=10000, episodenum=1000)
greedy_agent.save("../data/greedy_agent")
実行結果
100%|██████████| 1000/1000 [02:40<00:00,  6.23it/s]
save completed.
100%|██████████| 1000/1000 [03:02<00:00,  5.48it/s]
save completed.
ファイルサイズの縮小
上記のプログラムを実行して保存される random_agent.pkl と greedy_agent.pkl のファイルサイズはいずれも 300 MB 以上のサイズになります。
今後様々なシミュレーションを行い、データを保存するたびにそのような巨大なサイズのファイルが作られると、保存したファイルの総サイズがすぐに数ギガバイトを超えてしまい、ハードディスクの容量を圧迫するという深刻な問題が発生します。
そこで、この問題を解決するために、保存するファイルのサイズを小さくする工夫を行なうことにします。
numpy のデータ型の変更
MAB_Agent クラスでは、データを numpy の ndarray に保存していますが、そのデータ型は64 ビット(8 バイト)の浮動小数点数型です。つまり、ndarray の 1 つの要素は 8 バイトのデータサイズになります。そのため、「エピソード数 × ステップ数」個の要素を持つ mean_coins_by_step 属性に記録された ndarray のデータサイズは 1000 × 10000 × 8 = 約 80 MB、「スロットマシンの台数 × エピソード数 × ステップ数」個の要素を持つ slotratio_by_step 属性に記録された ndarray のデータサイズは 3 × 1000 × 10000 × 8 = 約 240 MB という巨大なサイズになります。
numpy がサポートする他の浮動小数点数を表すデータ型には、16 ビット(2 バイト)の np.float16 と 32 ビット(4 バイト)の np.float32 があります。当然ですが、データのサイズを 64 ビットから 16 や 32 ビットに減らすとデータの精度(何桁までデータを正確に表現できるか)が以下のように低くなります。
- 64 ビットの浮動小数点数の精度:10 進数で約 16 桁
- 32 ビットの浮動小数点数の精度:10 進数で約 7 桁
- 16 ビットの浮動小数点数の精度:10 進数で約 3 桁
3 桁の精度があれば例えば 0.575 のように 0 以上 1 以下の数値を小数点以下第 3 桁まで正確に表現できる ため、得られたコインの枚数の平均を記録してアルゴリズム間で比較するという目的であれば十分な精度であると言えます。そこで、ndarray が記録するデータのデータ型を 16 ビット(2 バイト)の浮動小数点数型に変更して ndarray のデータサイズを 1/4 に減らすという工夫を行なうことにします2。
numpy のデータ型3は仮引数 dtype で指定することができます。16 ビットの浮動小数点数の場合は dtype="float16" を指定します。下記は、巨大な ndarray を記録する mean_coins_by_step と slotratio_by_step のデータ型を修正するプログラムです。
    def play_episodes(self, stepnum, episodenum):
        self.stepnum = stepnum
        self.episodenum = episodenum
        self.mean_coins_by_step = np.zeros((self.episodenum, self.stepnum),
                                            dtype="float16")
        self.slotratio_by_step = np.zeros((self.mab.num, self.episodenum, self.stepnum),
                                            dtype="float16")
    以下略
slot 属性など、1 エピソード分の結果を記録する変数には ndarray ではなく、python の list で記録されているので上記のような修正は行いません。また、それらのデータの要素の数は mean_coins_by_step と比較して 1 万(= ステップ数)分の一になるため、データ型を変更してもファイルサイズはほとんど変化しません。
上記の修正を行うことで、save メソッドで保存したファイルのサイズが約 300 MB から約 14 MB に大幅に減少することが確認できました4。以後はこの縮小したデータを用いて考察を行うことにします。なお、今回の記事の ai.py は上記の修正を行った後の内容です。
集計結果のまとめの表示と考察
グラフを表示する前に、まずは print_summary メソッドを呼び出してそれぞれの実験結果の統計データを文字(テキスト)で出力し、数値から読み取れる性質について考察します。
なお、前回の記事で説明したように、1 エピソードの集計結果を記録する属性は「最後に実行した(最新の)1 回分のエピソードのデータが上書きされて残る」仕様としたので、print_summary は 10,000 回のエピソードの中の、最終エピソードの結果を表示します。
random_agent.print_summary()
greedy_agent.print_summary()
実行結果
完全ランダム(原始モンテカルロ法の近似) の結果のまとめ
============================
総ステップ数 = 10000
最後に行われたエピソードの結果
得られたコインの総数  =  4952
得られたコインの平均  = 0.495
スロットマシン 0 (p=0.30)
  得られたコインの総数 =  1022
  レバーを引いた回数  =  3440
  得られたコインの平均 = 0.297
スロットマシン 1 (p=0.50)
  得られたコインの総数 =  1683
  レバーを引いた回数  =  3275
  得られたコインの平均 = 0.514
スロットマシン 2 (p=0.70)
  得られたコインの総数 =  2247
  レバーを引いた回数  =  3285
  得られたコインの平均 = 0.684
============================
1000 エピソードの結果
最終ステップのステップ当たりのコインの平均   = 0.500
最終ステップのステップ当たりのコインの標準偏差 = 0.005
スロットマシン 0 (p=0.30)
  最終ステップの当たりの確率の推測値の平均   = 0.300
  最終ステップの当たりの確率の推測値の標準偏差 = 0.00803
スロットマシン 1 (p=0.50)
  最終ステップの当たりの確率の推測値の平均   = 0.500
  最終ステップの当たりの確率の推測値の標準偏差 = 0.00876
スロットマシン 2 (p=0.70)
  最終ステップの当たりの確率の推測値の平均   = 0.700
  最終ステップの当たりの確率の推測値の標準偏差 = 0.00802

貪欲法 の結果のまとめ
============================
総ステップ数 = 10000
最後に行われたエピソードの結果
得られたコインの総数  =  3000
得られたコインの平均  = 0.300
スロットマシン 0 (p=0.30)
  得られたコインの総数 =  3000
  レバーを引いた回数  = 10000
  得られたコインの平均 = 0.300
スロットマシン 1 (p=0.50)
  得られたコインの総数 =     0
  レバーを引いた回数  =     0
  得られたコインの平均 = 0.000
スロットマシン 2 (p=0.70)
  得られたコインの総数 =     0
  レバーを引いた回数  =     0
  得られたコインの平均 = 0.000
============================
1000 エピソードの結果
最終ステップのステップ当たりのコインの平均   = 0.559
最終ステップのステップ当たりのコインの標準偏差 = 0.154
スロットマシン 0 (p=0.30)
  最終ステップの当たりの確率の推測値の平均   = 0.057
  最終ステップの当たりの確率の推測値の標準偏差 = 0.11764
スロットマシン 1 (p=0.50)
  最終ステップの当たりの確率の推測値の平均   = 0.162
  最終ステップの当たりの確率の推測値の標準偏差 = 0.23385
スロットマシン 2 (p=0.70)
  最終ステップの当たりの確率の推測値の平均   = 0.341
  最終ステップの当たりの確率の推測値の標準偏差 = 0.34983
最後のエピソードのまとめから読み取れる性質の比較と考察
下記は「最後に行われた 1 エピソードの結果」をまとめた表です。
| 完全ランダム(探索に全振り) | 貪欲法(活用全振り) | |
|---|---|---|
| 得られたコインの総数 | 4952 | 3000 |
| 得られたコインの平均 | 0.495 | 0.300 |
| コインの総数(スロット 0) | 1022 | 3000 |
| 引いた回数(スロット 0) | 3440 | 10000 |
| コインの平均(スロット 0) | 0.297 | 0.300 |
| コインの総数(スロット 1) | 1683 | 0 |
| 引いた回数(スロット 1) | 3275 | 0 |
| コインの平均(スロット 1) | 0.514 | 0.000 |
| コインの総数(スロット 2) | 2247 | 0 |
| 引いた回数(スロット 2) | 3285 | 0 |
| コインの平均(スロット 2) | 0.684 | 0.000 |
完全ランダムの場合は、3 台のスロットマシンがほぼ均等に(約 3,333 回ずつ)選ばれています。その結果、大数の法則が働き、獲得コインの平均値(0.297 / 0.514 / 0.684)はスロットマシンの真の確率(0.3 / 0.5 / 0.7)へほぼ正確に収束しています。また、トータルの平均値(0.495)も、全台の平均確率である 0.500 へほぼ正確に収束しています。
一方、貪欲法のスコアは 0.300 という無残な結果になっています。内訳を見ると、最も当たりの確率が低いスロット 0(確率 0.3)だけを 1 万回すべて引き続け、他の 2 台は 1 回も触っていません。これは、「1 万ステップの最初に、たまたまスロット 0 で当たりが出た」ことが原因です。貪欲法の AI は「最初にたまたま当たりが出たスロット 0 こそが最高の当たり台だ」と勘違いし、目の前の利益を追い求めるあまり、一生スロット 0 だけを引き続ける思考停止のループ(まちぼうけ現象)に陥ってしまったのです。
なお、今回のシミュレーションでは最終エピソードでたまたま最も当たる確率が低いスロット 0 で最初に当たりを引いていますが、もちろん逆に最高の当たり台で最初に当たりを引くこともあり、その場合の貪欲法のスコアは 0.700 という最高のスコアになります。つまり、貪欲法は運が良ければ最高のスコアを得ることができるが、逆に運が悪いと最低のスコアになってしまうという、ハイリスクハイリターンな戦法 であると言えます。
1,000 エピソードのまとめから読み取れる性質の比較と考察
次に、下記の 1,000 回のエピソードを重ね合わせた最終ステップ(1 万回目)の集計データを比較します。なお、標準偏差は小数点以下第 4 桁で四捨五入しました。
| 完全ランダム (探索に全振り) |
貪欲法 (活用に全振り) |
|
|---|---|---|
| ステップ当たりのコインの平均 | 0.500 | 0.559 |
| ステップ当たりのコインの標準偏差 | 0.005 | 0.154 |
| 当たりの推測値の平均(スロット 0) | 0.300 | 0.057 |
| 当たりの推測値の標準偏差(スロット 0) | 0.008 | 0.118 |
| 当たりの推測値の平均(スロット 1) | 0.500 | 0.162 |
| 当たりの推測値の標準偏差(スロット 1) | 0.009 | 0.234 |
| 当たりの推測値の平均(スロット 2) | 0.700 | 0.341 |
| 当たりの推測値の標準偏差(スロット 2) | 0.008 | 0.350 |
上記の表から、「ステップ当たりのコインの平均」はどちらのアルゴリズムもスロットマシンの当たりの平均である 0.5 とほぼ同じ値になることがわかります。なお、貪欲法の場合が 0.559 のように 0.5 より少し大きな値になる理由については以前の記事を参照して下さい。
完全ランダムの場合の各スロットマシンの当たりの推定値は、いずれもスロットマシンの真の当たりの確率とほぼ等しくなります。また、標準偏差が 0.005 のような非常に小さい値になることから、ほぼすべてのエピソードですべてのスロットマシンの当たりの確率を極めて高い精度で推定できていることがわかります。これは、すべてのスロットマシンが均等に約 3,000 回以上も選択された結果、大数の法則が働いたからです。
一方、貪欲法での各スロットマシンの当たりの推定値は、いずれも真の当たりの確率よりも大幅に小さな値になります。これは、最初に当たりが出たスロットマシンだけが選択され続けるため、それ以外のスロットマシンはエピソードを通じて一度も当たりがでず、当たりの推定値が必ず 0 と推定されてしまうからです。その結果、当たりの推定値は 0 または真の当たりの確率のいずれかの値が計算されることになり、平均が真の当たりの確率から大幅に減ります。また、当たりの推定値として 0 または真の当たりの確率という 2 つの異なる数値が計算されることから、ブレを表す標準偏差も 0.1 以上の大きな値になります。
print_summary で表示されるような、数値を並べた表は直観的にわかりづらいという問題があります。そこで、2 つのアルゴリズムの性質の違いを、様々なグラフを用いて考察することで、異なる視点から視覚的に明らかにしていくことにします。
累積報酬の推移の比較
2 つのアルゴリズムの最後のエピソードデータを元に、ステップ数(時間)の経過とともに獲得コインの総数がどう積み上がっていったかという「累積報酬の推移」を可視化します。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_cumulative_reward()
greedy_agent.draw_cumulative_reward()
実行結果
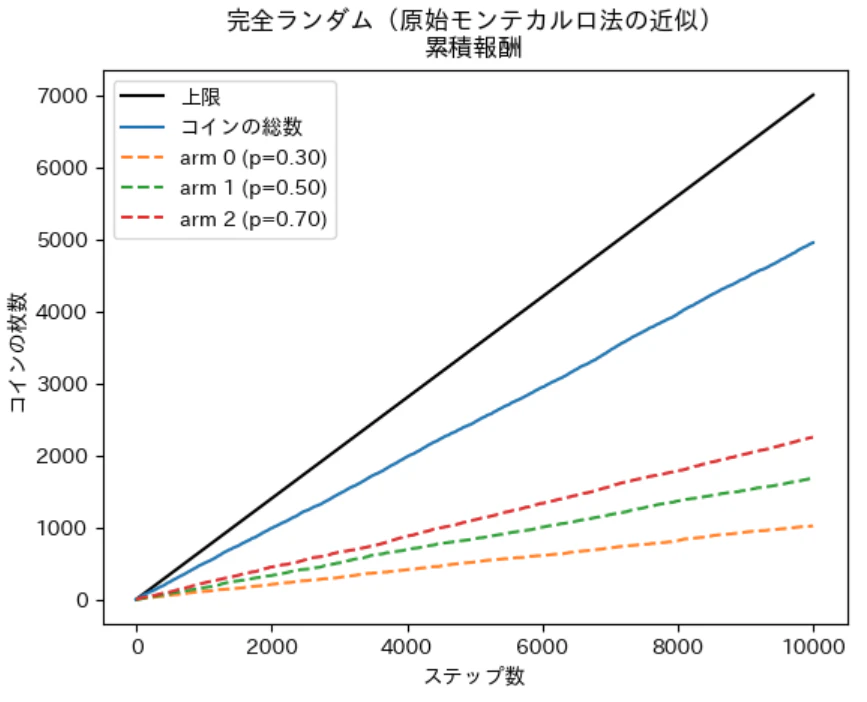

グラフから読み取れる貪欲法の性質
貪欲法の出力グラフを注意深く観察することで、このアルゴリズムには下記のような特性があることがわかります。
-
完全に重なる「コインの総数」と「スロット 0」のグラフ
水色の「コインの総数」の実線と、オレンジ色の「スロットマシン 0」の点線が、スタート直後からゴールまで完全にぴったりと重なり合っています。 これは、1 万ステップの処理の最初から最後まで、AI がスロット 0 のレバーしか選択していなかった証拠です。 -
消えた「スロット 1」と、底を這う「スロット 2」
グラフ上には、緑色の「スロットマシン 1」の点線が見当たらず、赤色の「スロットマシン 2」の点線が一番下の「枚数 0」の底辺に張り付いているように見えます。これも AI が「スロット 0」だけをえこひいきし続けた結果、「スロット 1」と「スロット 2」がどちらも 1 回もレバーを引かれず、獲得枚数 0 枚のまま グラフが完全に重なり合ってしまったため です。その結果、「スロット 1」の緑色のグラフが、その後で描画された「スロット 2」の赤色のグラフで完全に覆い隠されて完全に見えなくなっています。
このように、グラフ化をしてみることで、事前の実験(探索)をさぼった貪欲法が、最初の当たを引いたスロットマシンに執着し、他のスロットマシンを完全に無視するという性質が一目で明らかになりました。
ステップ当たりの累積報酬の推移の比較:収束するゴールの違い
2 つのアルゴリズムの最後のエピソードデータを元に、「1 ステップあたりに稼いたコインの平均枚数」が、時間の経過(ステップ数)とともにどう変化していったかを可視化します。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_cumulative_reward_per_step()
greedy_agent.draw_cumulative_reward_per_step()
実行結果


実行結果から下記のことがわかります。
- 完全ランダム(探索全振り): スタート直後の激しいブレが収まった後は、すべてのスロットマシンの平均確率である 0.5 のラインへに収束する
- 貪欲法(活用全振り): 完全ランダムよりもさらに低い位置にある、スロット 0 の真の実力である 0.3 のラインへ収束する
グラフから読み取れる性質の対比と考察
累積報酬のグラフでは右肩上がりに伸びていたため実力差が見えにくかったですが、この「1 回あたりの平均値」に変換したグラフを並べることで、2つのアルゴリズムが犯している致命的な弱点がグラフからはっきりとわかるようになります。
-
完全ランダムの限界
どれだけステップ数を重ねてデータ(経験)を蓄積しても、それをその後のマシン選択に全く活かしていません。そのため、グラフの線は神様の上限(0.7)に向かって右肩上がりに成長することなく、「当たりの平均(0.5)」に完全に固定されたまま水平に這い続けます。 -
貪欲法の自滅
最終エピソードにおける貪欲法は、最初にスロット 0 で当たりを引いてしまったせいで、最悪のハズレ台である「スロット 0」を一生引き続けることになっています。そのため、1 ステップあたりの獲得コインは、全体の平均確率である 0.5(水色のグラフ)を大きく下回る、スロット 0 の真の確率である 0.3 にぴったり張り付いてしまいます。
事前の実験(探索)をさぼって目の前の利益に飛びついた結果、完全ランダムよりも圧倒的に損をして自滅してしまうことがあるという貪欲法の欠点が、この 2 枚のグラフの差として明らかになりました。
スロットマシンの選択回数の推移の比較:行動の偏りの可視化
2 つのアルゴリズムの最後のエピソードデータを元に、時間の経過(ステップ数)とともに「それぞれのスロットマシンが何回選ばれたか」という累積選択回数の推移を比較します。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_selectnum()
greedy_agent.draw_selectnum()
実行結果

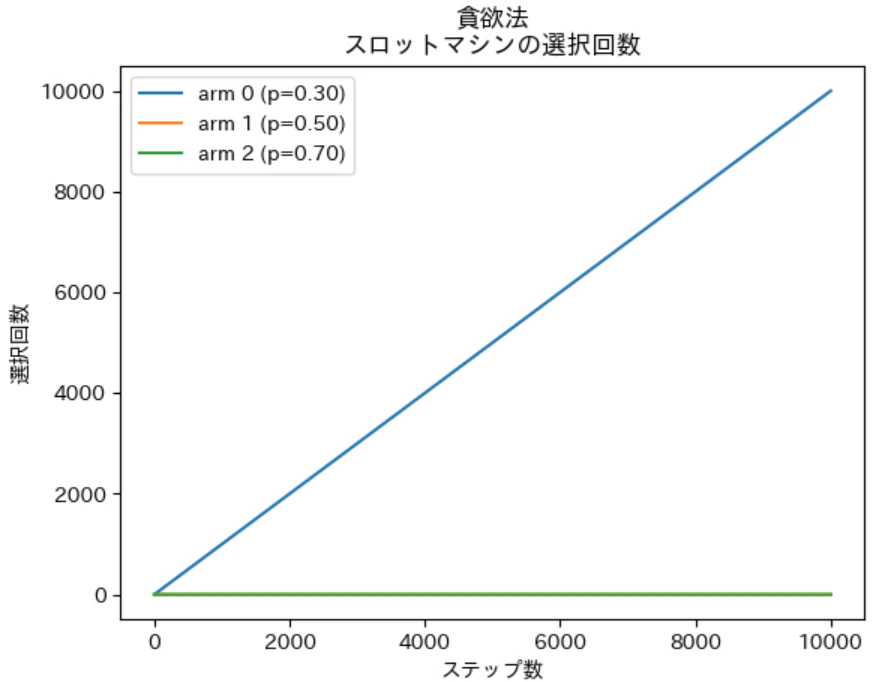
実行結果から下記のことがわかります。
- 完全ランダム(探索全振り): すべてのスロットマシンのグラフがほぼ一直線上に重なり合い、均等に右肩上がりへ伸びていく
- 貪欲法(活用全振り): 水色の「スロット 0」の 1 本だけが急角度で右肩上がりに独走し、それ以外は完全に底辺の 0 に張り付いたまま水平を維持する
グラフから読み取れる性質の対比と考察
これまでの数値分析や数式による考察で言及してきた、「完全ランダムは全員を平等に扱う」という特徴と、「貪欲法は最初の体験を盲信する」という対照的な行動特性が、グラフの線の傾きとして視覚化されました。
-
完全ランダム(探索全振り)
3 本の線が完全な横並びの一本の直線に見えるのは、AIが「えこひいき」を一切行わず、1 万ステップの最後まで全ての台を常に確率 $(\frac{1}{3})$ で平等に選び続けたからです5。 -
貪欲法(活用全振り)
「スロット 0」だけが「えこひいき」されて選択され続けた結果、水色の「スロット 0」だけが総ステップ数と同じ「1 万回」に向かってまっすぐ伸びていきます6。
過去にどれだけ有望なデータが集まろうとも情報を一切活用しない完全ランダムと、たった 1 回の当たりの経験で思考停止して未知の可能性を閉ざしてしまう貪欲法という、両者が持つ極端な割り当ての弊害(トレードオフ)が、この極端な直線の形に現れています。
スロットマシンの当たりの確率の推定値の推移の比較
2 つのアルゴリズムの最後のエピソードデータを元に、時間の経過(ステップ数)に伴って、AI が頭の中で見積もっている「各マシンの当たりの確率の推定値(標本平均)」がどう変化したかを比較します。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_estimated_odds_of_arm()
greedy_agent.draw_estimated_odds_of_arm()
実行結果


実行結果から下記のことがわかります。
- 完全ランダム(探索全振り):すべてのスロットマシンの推定値が、黒い点線で描かれた「真の当たりの確率(0.3, 0.5, 0.7)」へと収束していく
- 貪欲法(活用全振り): 水色の「スロット 0」だけが真の確率(0.3)に収束し、それ以外の 2 台は完全に底辺の 0 に張り付いたまま水平を維持する7
グラフから読み取れる性質の対比と考察
このグラフから、貪欲法が「間違った選択を一生続けてしまうことがある」ことの原因が視覚的にはっきりとわかります。貪欲法が自滅する原因は、特定の 1 台以外の推定値が完全にあてにならず、そのようなあてにならないデータを元に選択を行っているからです。
-
完全ランダム(探索全振り)
すべてのスロットマシンを完全平等に引き続けた結果、十分な実験データ(標本)が集まります。これにより、大数の法則の数学的な恩恵を最大限に受けて、すべてのスロットマシンの当たりの確率の推定値が、真の当たりの確率へとほぼぴったり重なっていきます。答えがほぼ 100 % 見えている状態を作れているのが完全ランダムの強みですが、その正確な推定値を全く活用していないという致命的な弱点があります。 -
貪欲法(活用全振り)
最初に当たりを引いた「スロット 0」だけをえこひいきして引き続けたため、「スロット 0」の確率(0.3)だけは正しく学習されますが、残りの「スロット 1」と「スロット 2」は一度もレバーを引かれないため確率の推定値が初期値の 0.0 のまま全く変化しません。
貪欲法の AI の中では「スロット 0 = 確率 0.3」「スロット 1 = 確率 0」「スロット 2 = 確率 0」と記録されているため、貪欲法のルール(一番高い数値を選ぶ)に従うと、必然的に確率 0.3 の「スロット 0」を選び続けるしかなくなります。「本当はもっと当たるスロットマシン(確率 0.7)があるかもしれないのに、それを確かめるための 1 回の実験(探索)すら拒んで目の前のコインに飛びついたせいで、一生ハズレ台に縛られ続ける」という貪欲法の致命的な弱点が、この底に張り付いた 2 本の直線によって明らかになりました。
10 エピソードのステップ当たりの累積報酬の推移の比較:安定とギャンブルの可視化
ここまでは最後に実施された 1 回きりの偶然の産物である 1 エピソードの結果 をグラフ化しました。ここからは 複数回のエピソードの集計結果をグラフ化することで、偶然に左右されないアルゴリズムの本質的な性質を可視化 して比較することにします。
最初に 10 回分のエピソード(各 1 万ステップ)の「ステップ当たりの獲得コイン」の推移を重ね合わせたグラフを描画します。これにより、それぞれのアルゴリズムが持つ「結果の安定性(リスクの激しさ)」を一目で比較できるようになります。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_cumulative_rewards(10)
greedy_agent.draw_cumulative_rewards(10)
実行結果
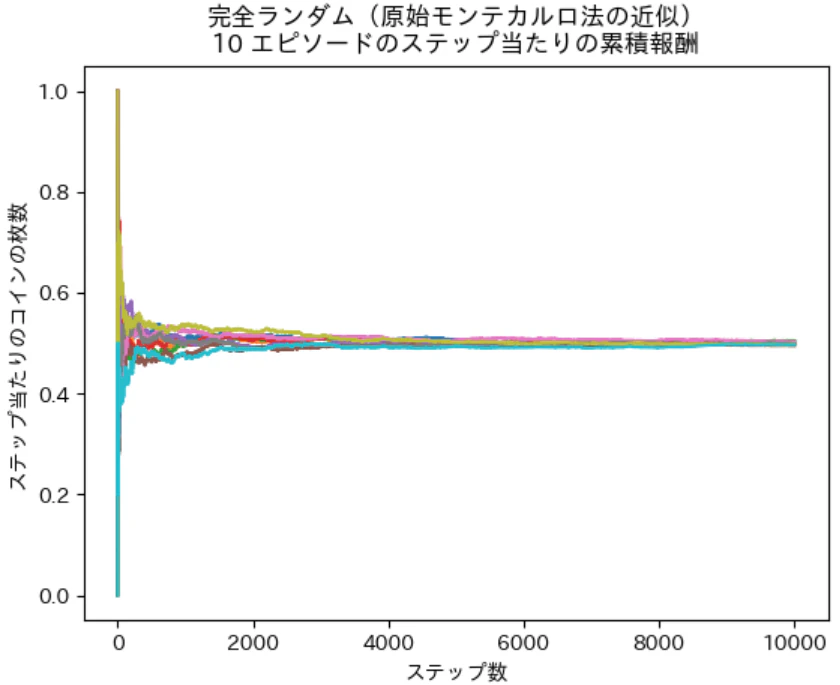
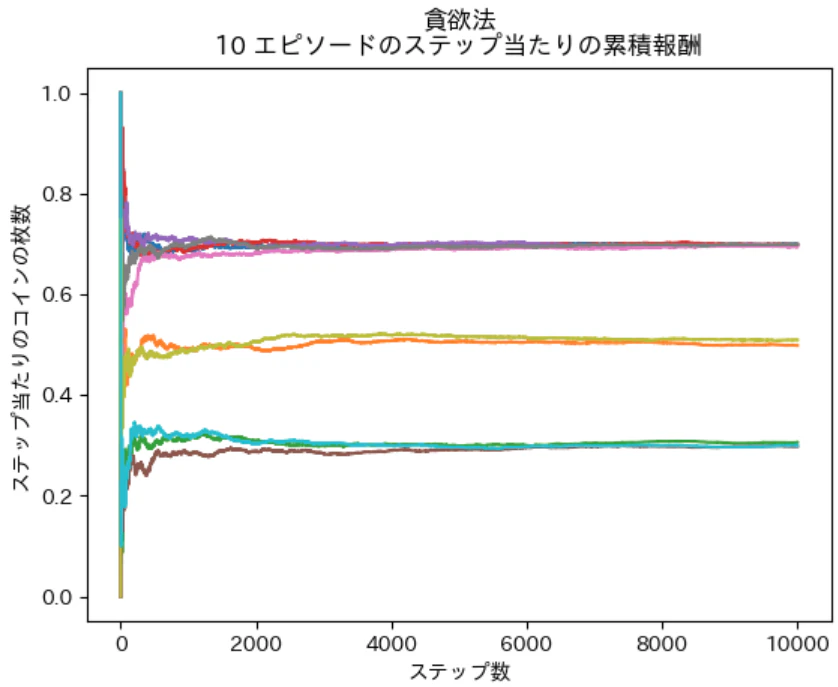
実行結果から下記のことがわかります。
- 完全ランダム(探索全振り):スタート直後のブレが収まった後は、10 本全ての折れ線グラフが 1 本の太い束のようになり、平均確率である 0.5 のラインへ収束する
- 貪欲法(活用全振り):10 本のグラフが 1 本の束にならず、3 つのスロットマシンの真の確率である 0.3、0.5、0.7 の 3 箇所に分かれて収束する
グラフから読み取れる性質の対比と考察
この 10 本の重ね合わせのグラフを観察すると、「完全ランダムは低品質だがブレない安定型(ローリスク・ローターン)」であり、「貪欲法は一か八かのギャンブル型(ハイリスク・ハイリターン)」であるという、両者の決定的なリスク特性の違いが明らかになります。
-
完全ランダム(探索全振り)
何回勝負(エピソード)をやり直したとしても、1 万ステップという十分な試行回数さえあれば、必ず最終スコアは全体の平均確率 0.5 付近へと収束します。大数の法則によって運・不運の要素が完全に消し去られ、「いつでも確実に(平均である)0.5 の実力を安定して発揮する」というブレの少ない性質 が、綺麗に重なり合った線によって明らかになりました。一方で、神の視点で得られる最高のスコアを表す 0.7 には遠く及ばないことから、得られる成果が低品質である ことも明らかになりました。 -
貪欲法(活用全振り)
10 本の線が 3 つのゴールに分かれて張り付いており、最初期(データ不足の段階)に、どのスロットマシンで当たりを引いたかという 「運」だけで最終的に得られるスコアが決まります。運良くスロット 2(確率 0.7)を引ければ神様と同じ最高得点を稼ぎ続けますが、運悪くスロット 0(確率0.3)に引っかかれば最悪のロースコアに縛られ続けます。つまり、「運が良ければ大儲け、悪ければ大爆死」という、結果が全く安定しない危険(ハイリスク・ハイリターン)な戦略 であることが視覚的に明らかになりました。
どれだけステップ数を増やして 1 万回レバーを引かせたとしても、事前の探索をサボった貪欲法は、結果がエピソードごとの運に完全に依存してしまいます。極端な割り当てがもたらす運任せの戦略が、この 3 つのゴールに分裂したグラフによって明らかになりました。
ステップ当たりの累積報酬の平均の推移の比較:成長しないことの証明
1,000 エピソードという膨大な実験データを集計した、2 つのアルゴリズムの「実力の真実(期待値の推移)」を検証します。
それぞれの実力の変化がはっきりと伝わるように、個別に表示したグラフと、2 つのグラフを同じ画面で直接対決させた「重ねて表示」したグラフを同時に描画しました。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
agent_list = [random_agent, greedy_agent]
random_agent.draw_mean_cumulative_reward_by_step()
greedy_agent.draw_mean_cumulative_reward_by_step()
MAB_Agent.compare_mean_cumulative_reward_by_step(agent_list)
実行結果
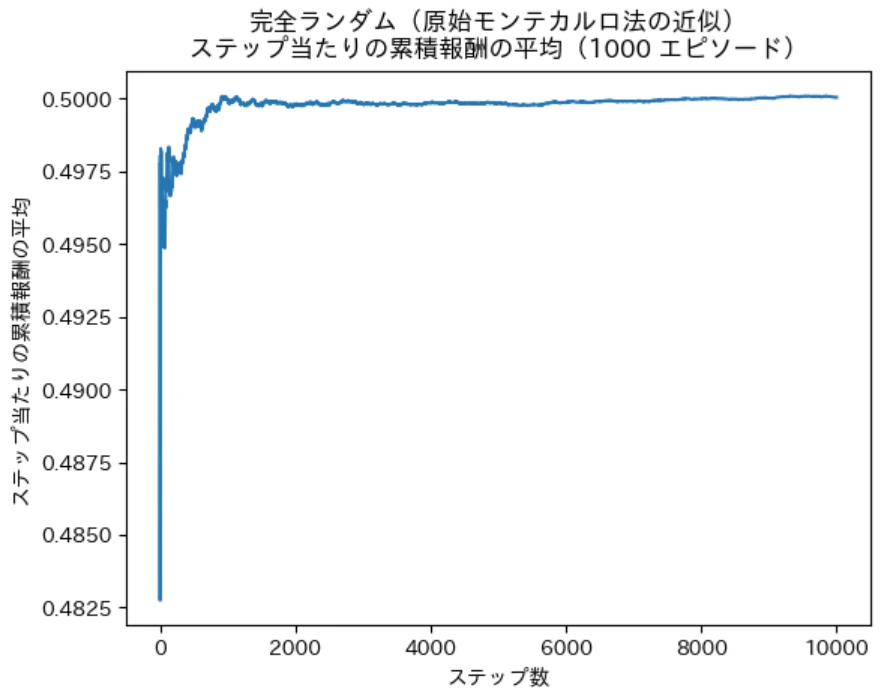


実行結果から下記のことがわかります。
- 完全ランダム(探索全振り):スタート直後のブレが収まった後は、すべてのスロットマシンの平均確率である 0.500 に向かって一直線に水平に収束する
- 貪欲法(活用全振り):完全ランダムと同様に、序盤以降は右肩上がりに成長することなく、0.559 という平均確率より少し高い値で完全に水平に収束する
- 両者を重ねた比較グラフ:どちらのグラフもスタート直後のブレが収まった後は、まったく傾き(成長)のない「綺麗な 2 本の水平な直線」となって並ぶ
先ほど print_summary メソッドで出力した 最終ステップの数値データ(0.500 と 0.559) が、ただの偶然の一点ではなく、1 万ステップの道のりのほぼ全てで完全に固定されていた ことが視覚的に明らかになりました。
グラフから読み取れる性質の対比と考察
2 つの重ね合わせのグラフを観察すると、強化学習の核心である「探索と活用のバランスの重要性」と、片方に全振りしたアルゴリズムが抱える どれだけ時間(ステップ数)をかけても、AI の実力が「1 ミリも成長しない」 という致命的な欠陥が明らかになります。
このグラフで最も注目すべきは、どちらのグラフもばらつきが落ち着いた後は、傾きが完全にゼロの水平な直線である という事実です。
-
完全ランダム(探索全振り)「経験を活用しない無策」
1 万回レバーを引く中で、中盤の 3,000 回目であっても、終盤の 9,000 回目であっても、AI の頭の中には各スロットマシンの真の確率(0.3, 0.5, 0.7)がほぼ正確に推測できています。それにも関わらず、その莫大な「経験」を次の選択に一切活かさず、完全なランダム(あてずっぽう)で引き続けているため、実力は平均の 0.5 から永遠に向上しません。 -
貪欲法(活用全振り)「マグレ当たりの限界値」
貪欲法が完全ランダムの 0.500 を僅かに上回る 0.559 という数値を叩き出している理由は、以前の記事で数学的に証明した「優秀な台ほど最初の 1 回でマグレ当たりを引きやすい」という特性によるものです。しかし、事前の探索を一切拒絶して最初から目の前のコインに飛びついたせいで、1,000 回中何百回かは最悪のハズレ台(0.3)を選択し続けてしまいます。その結果、トータルの期待値は神様の視点で得られるスコアの上限の 0.7 からは程遠い、0.559 という中途半端な値で頭打ちになってしまいます。
多腕バンディット問題の本質は、「限られた時間(ステップ数)の中で、いかに神様の上限 0.7 に向かって、グラフの波形を右肩上がりに成長させられるか」 にあります。どれだけ試行回数を増やして学習させても、実力が水平に這ったまま一生進化しない この 2 つのアルゴリズムは、強化学習の方策(作戦)として致命的な欠陥を抱えていることが、重ね合わせた水平線のグラフによって明らかになりました。
ステップ当たりの累積報酬の標準偏差の推移の比較
平均値の推移の比較グラフによって、2 つのアルゴリズムが成長せずに特定の値で頭打ちになることが実証されました。しかし、平均の折れ線グラフからは、その裏側に隠された「結果のブレ幅(リスク)」の大きさを読み取ることはできません。
そこで、1,000回 のエピソードデータを集計し、各自の「標準偏差の推移」を個別に表示したグラフと、2つのグラフを同じ画面で重ねて表示することで直接対決させた比較グラフを同時に描画します。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_std_cumulative_reward_by_step()
greedy_agent.draw_std_cumulative_reward_by_step()
MAB_Agent.compare_std_cumulative_reward_by_step(agent_list)
実行結果
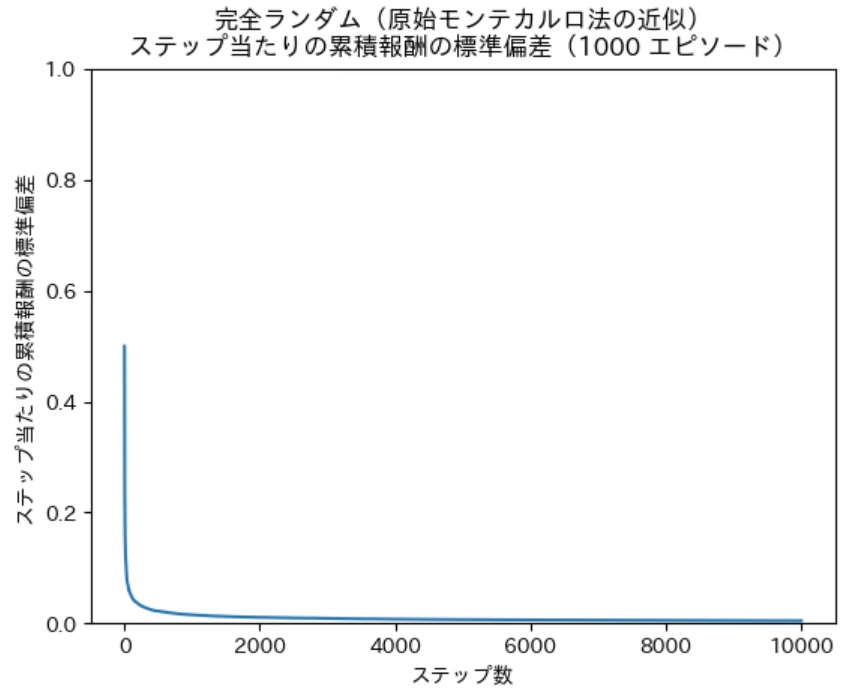
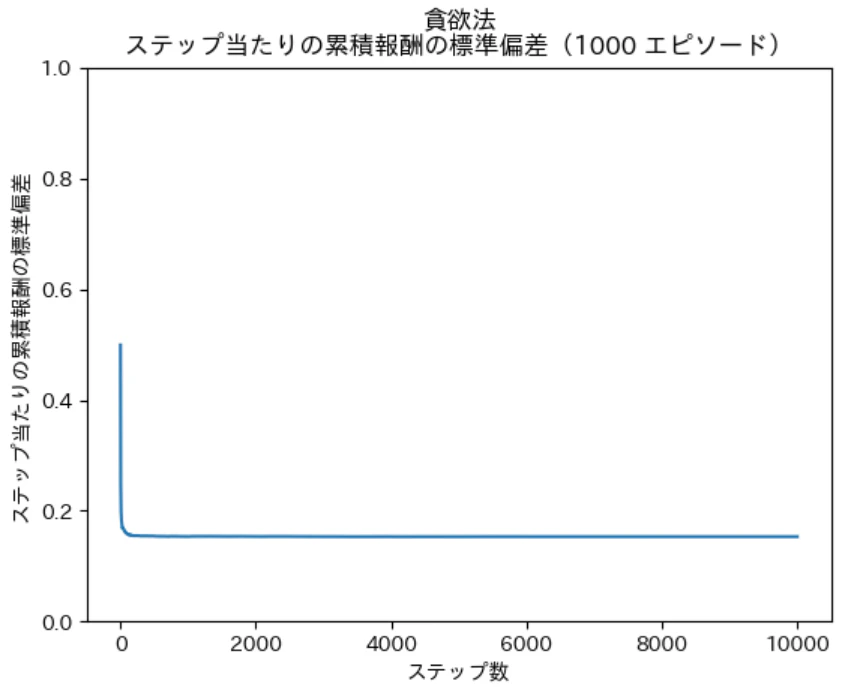

実行結果から下記のことがわかります。
- 完全ランダム(探索全振り):スタート直後から驚異的な勢いでグラフの線が急降下し、限りなく 0(底辺)に向かって収束していく
- 貪欲法(活用全振り):スタート直後から驚異的な勢いでグラフの線が急降下する点は同じだが、0.15 付近の高い位置で収束する
- 両者を重ねた比較グラフ:スタート地点から最終ステップに至るまでのすべてにおいて、完全ランダムの方が圧倒的に標準偏差が小さい(安定している)
2 つの標準偏差が先ほど print_summary メソッドで出力した最終ステップの数値データ(0.005 と 0.154)に向かって収束していく様子が視覚的に明らかになりました。
グラフから読み取れる性質の対比と考察
この標準偏差の比較グラフを観察すると、「大数の法則によって不確実性を解消する完全ランダム」と、「運の偏りをリセットできずにリスクを全く解消できない貪欲法」の対照的な構造が明らかになります。
標準偏差とは、1,000 回シミュレーションをやり直したときに「それぞれの結果(獲得コインの平均)がどれくらいバラついている(散らばっている)か」という、不確実性(リスク)を表す数値です。2 つのアルゴリズムの標準偏差の違いは、先ほどの「10 エピソードの重ね合わせ」のグラフの挙動がそのまま反映されています。
-
完全ランダム(探索全振り)大数の法則による絶対的な安定
完全ランダムの場合は、1 万ステップという十分な時間をかければ、1,000 回中 1,000 回すべての実験(エピソード)において、獲得コインの平均枚数が全員同じ 0.500 という値にほぼ完全に収束します。エピソード間で結果の数値に「差(ブレ)」がほとんど生じないため、バラつきを表す標準偏差は限りなく 0(最終的には 0.005)に向かって綺麗に消滅していくのです。 -
貪欲法(活用全振り):初期の勘違いを一生引きずる「リスクの固定」
一方、貪欲法は事前の探索を行わないため、1,000 回実験すると、ある回はスロット0(確率0.3)を、ある回はスロット2(確率0.7)のように異なるスロットマシン選択し続けます。つまり、最終結果が 0.3、0.5、0.7 という異なる 3 つの値に散らばってしまいます。どれだけ試行回数を増やして 1 万回までレバーを引かせ続けたとしても、思考停止のループに陥った AI は途中で別の台を試して軌道修正することが不可能なため、このエピソード間の巨大なブレが全く解消されずに固定化されます。その結果、3 つのゴールへの散らばり具合を計算した標準偏差は、0.154 という高い値を改善することができず、グラフは水平に這い続けることになります。
平均値の推移だけを見れば「貪欲法(0.559)の方がランダム(0.500)より少しマシ」に見えるかもしれません。しかし、この標準偏差を並べて比較することで、貪欲法が「完全ランダムよりも圧倒的に結果の予測がつかない、運任せで非常にリスクが高いハイリスクな戦略である」 という実態がグラフから明らかになりました。
特定のステップでのステップ当たりの累積報酬のヒストグラムの比較
シミュレーションの進行(0、9、99、999、9,999 ステップ目)に合わせて、1,000 回のエピソードのデータがどのように広がっているかという「分布の形状の変化」を可視化します。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_histogram_of_cumulative_reward_by_step()
greedy_agent.draw_histogram_of_cumulative_reward_by_step()
実行結果
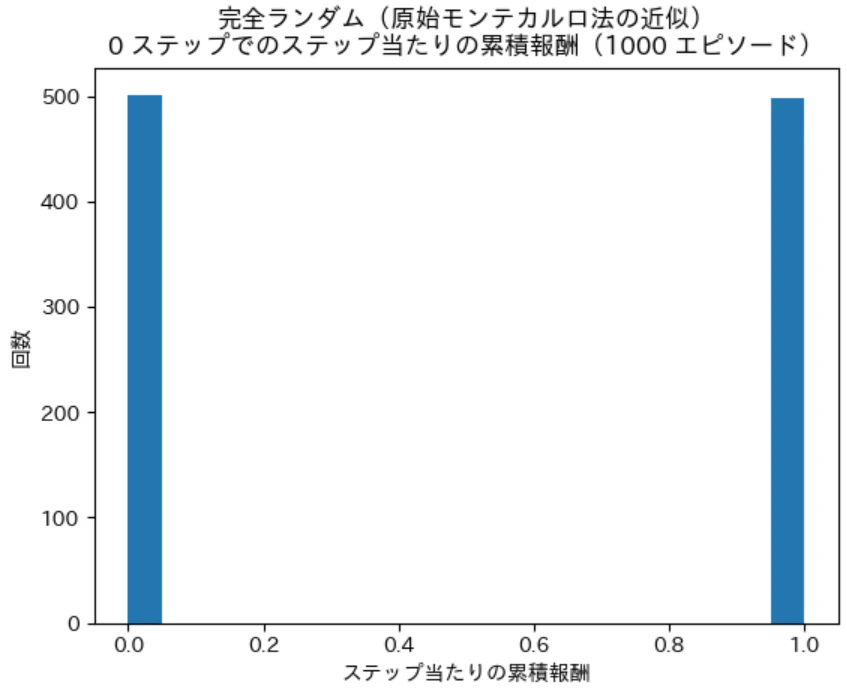


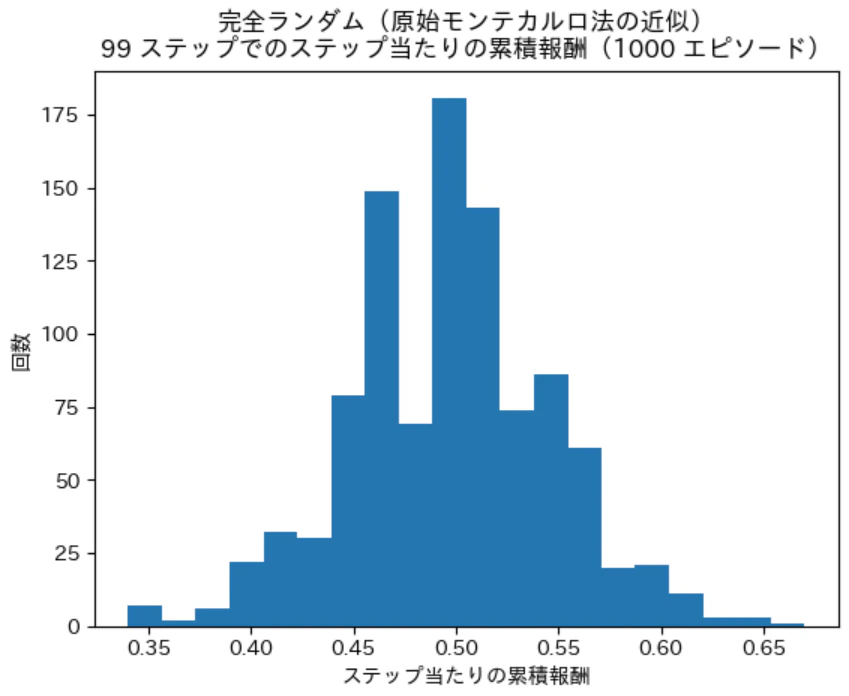

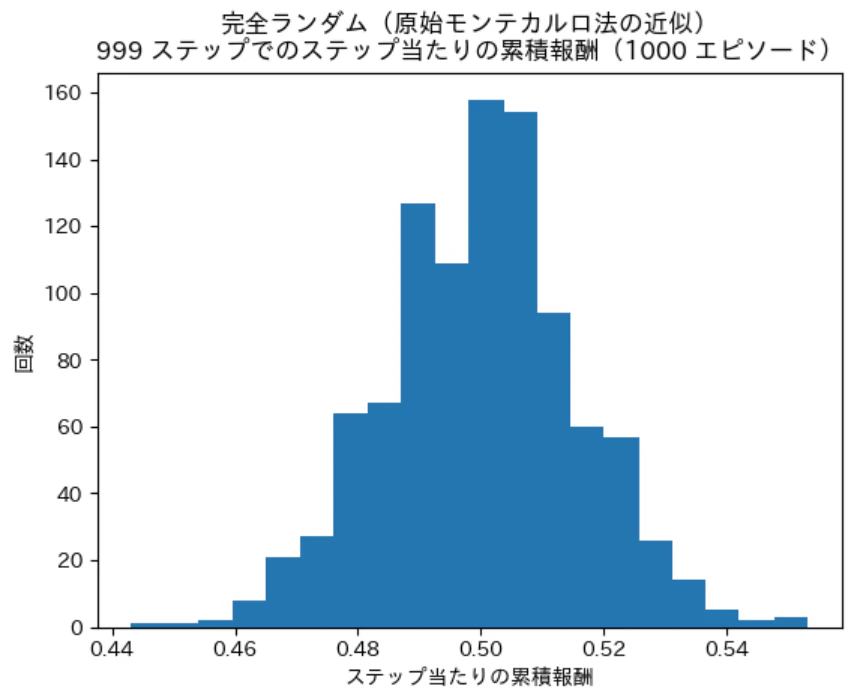
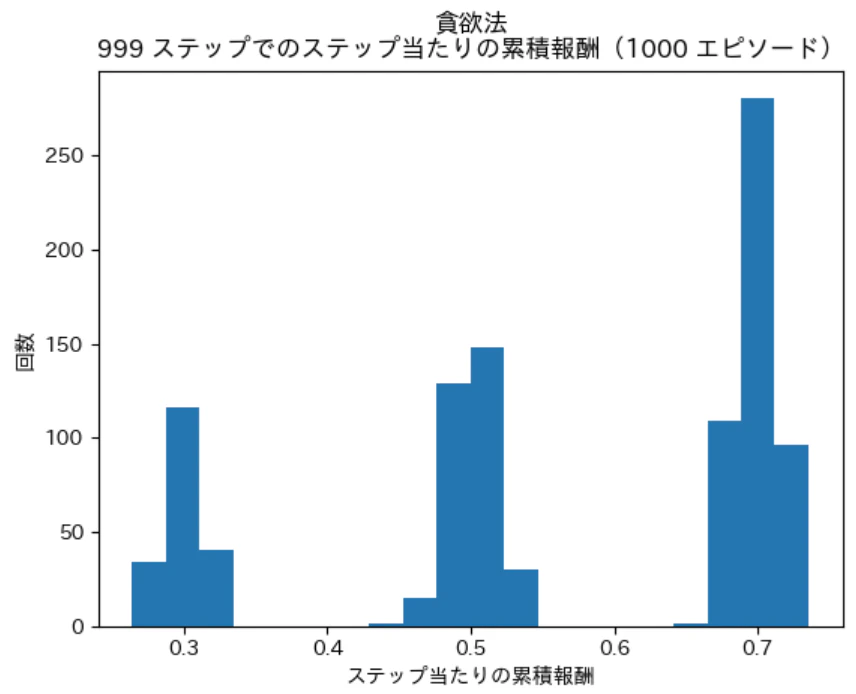
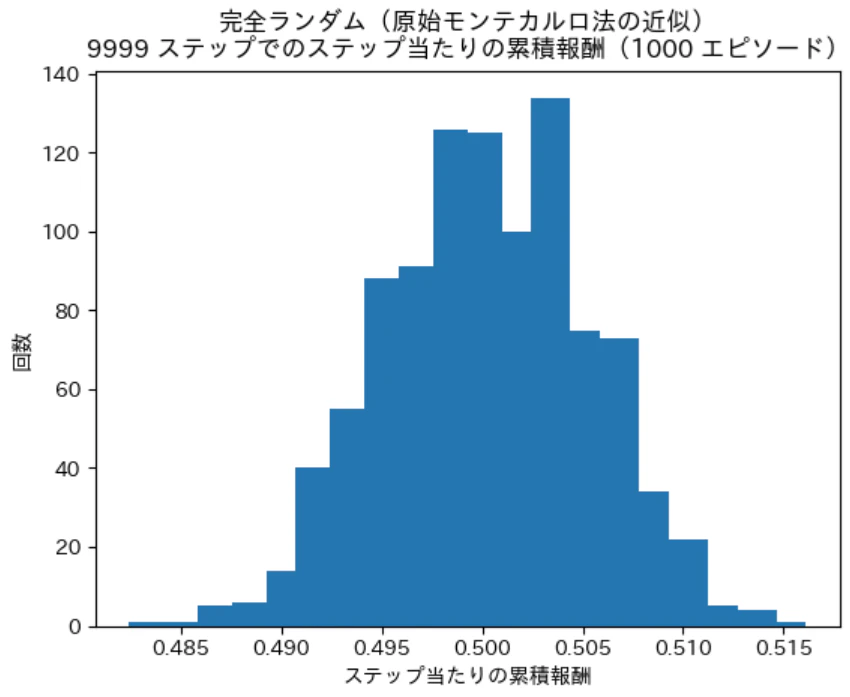

実行結果から下記のことがわかります。
- 完全ランダム(探索全振り): ステップ数(試行回数)が増えるにつれて、データの広がりが狭まり、中央の 0.5 を中心とした 1 つの綺麗な釣り鐘型の山(正規分布)へと凝縮されていく
- 貪欲法(活用全振り): ステップ数が増えるとデータが 1 つにまとまることはなく、0.3、0.5、0.7 の 3 箇所を中心とした「3 つの独立した釣り鐘型の山(正規分布)」がくっきりと分裂して出現する
完全ランダムのグラフは 99 ステップ以降はほとんど形状が変わらないように見えるかもしれませんが、実際には横軸の範囲がステップ数が増えるにつれて狭まっています。横軸のスケール(倍率)を同じにしてグラフを描画すると、ステップ数が増えるにつれてグラフの幅が確実に狭まっていきます。
一方、貪欲法のグラフは 99 ステップ以降はいずれも横軸の範囲が 0.3 ~ 0.7 でスケールが固定されます。そのため、ステップ数が増えると 3 つの釣り鐘型の山が狭まっていきます。なお、ステップ 9999 のグラフが釣り鐘型状に見えない理由は、ヒストグラムの階級(一つ一つのグラフ)の幅が広いからです。階級の幅は階級の数を増やす(仮引数 bins に代入する数値)ことで狭めることができるので、興味がある方はステップ 9999 の階級の幅を狭めたヒストグラムを描画してみて下さい。なお、階級の幅を狭めると逆にステップ数が小さい場合のヒストグラムの形状がでこぼこになって安定しなくなります。そのため、どのようなヒストグラムでも安定して綺麗な描画できるような、ベストな階級の幅が存在するわけではありません。
グラフから読み取れる性質の対比と考察
この分布の推移の違いは、確率論おいて最重要とされる 中心極限定理の現れ方と、事前の探索をサボったアルゴリズムが抱えるリスクの構造 を表しています。
-
完全ランダム(探索全振り):中心極限定理による単一正規分布への収束
完全ランダムのグラフが 1 つの釣り鐘型(正規分布)に変形していく根拠は、以前の記事で詳しく解説した「中心極限定理」 です。すべての台を均等に引き続けるため、ステップ数が多くなればなるほど、獲得報酬の平均値(標本平均)のばらつき方は「全台の平均確率 0.5」を中央とした左右対称の単一の正規分布へと綺麗に収束していきます。 -
貪欲法(活用全振り)3 箇所への正規分布の分裂
貪欲法ではステップ数をどれだけ 1 万回、10 万回と増やしたとしても、1 つの正規分布に統合されることは絶対にありません。その理由は、データ不足のまま走り出した AI が一生同じスロットを引き続けるという 「まちぼうけ現象(思考停止のループ)」がエピソードごとに発生しているから です。-
最初の当たりの当選確率はほぼ平等
まだ白紙状態の第 0 ステップでは、3 台のスロットマシンが完全に同じ確率($\frac{1}{3}$)当てずっぽうに選ばれます。最初のレバーで当たりが出る確率はどの台も大きく変わらないため、1,000 回のエピソードを回すと、約 1/3(約 333 回)ずつの均等な割合で「スロット 0」、「スロット 1」、「スロット 2」のいずれかが最初のえこひいきの対象に選ばれます。 -
選ばれた台の実力に応じた正規分布の形成
一度えこひいきのループに入ると、AI はその台のレバーしか引かなくなります。その結果、3 種類のエピソードの分布は下記のような性質を持つようになり、最終ステップ(9,999 ステップ目)のヒストグラムには、3 つのスロットマシンの実力をそのまま反映した 「3 つの独立した正規分布の山」が横に並ぶことになります。- 「スロット 0」に縛られた約 333 回のエピソード群の分布は、真の確率 0.3 を平均とする正規分布へ収束する
- 「スロット 1」に縛られた約 333 回のエピソード群の分布は、真の確率 0.5 を平均とする正規分布へ収束する
- 「スロット 2」に縛られた約 333 回のエピソード群の分布は、真の確率 0.7 を平均とする正規分布へ収束する
-
事前の実験(探索)をサボった貪欲法は、1 万回ものチャンスがあっても最初の選択を修正する機会を自ら放棄しているため、全体の約 1/3 の確率で 3 つの正規分布のいずれかの山に捕まったまま生涯を終えてしまいます。前節で目撃した「標準偏差(リスク)が 0.154 から全く減らずに高止まりしていた現象」の正体が、まさにこの 3 本の山へ完全に引き裂かれた分布の形 によって明らかになりました。
ステップ当たりの累積報酬の平均からのブレの比較:信頼区間の収束と固定
平均値を中心として、1,000 回のエピソードのデータがどれだけの範囲に広がっているかという「信頼区間(不確実性の広がり)」の推移を視覚化します。データの分布が正規分布に従う場合は、sigmul=3(平均 ± 3σ)の範囲に約 99.7%、sigmul=2(平均 ± 2σ)の範囲に約 95.4% のデータが収まることになります8。このグラフによって、ほとんど(99 % 以上)のデータがどのような範囲に収まるかが直観的に理解できるようになります。
完全ランダム(探索全振り)におけるこのグラフの詳細な読み解き方については、前回の記事を参照して下さい。
random_agent.draw_ci_of_cumulative_reward_by_step()
greedy_agent.draw_ci_of_cumulative_reward_by_step()
実行結果


実行結果から下記のことがわかります。
- 完全ランダム(探索全振り):ステップ数が進むにつれて半透明の帯(ブレの範囲)が急速に細くなり、中央の 0.5 に向かって一本の線のように収束する
- 貪欲法(活用全振り):データのバラつき(標準偏差)が大きすぎるため、デフォルトの「平均 ±3σ」では塗りつぶしの範囲がグラフの縦軸の上限である 1 を完全に突き抜けてしまい、画面のほぼ全体がブレ幅の色で塗りつぶされてしまう
そこで、貪欲法に対してのみ、標準偏差の倍率を sigmul=2(正規分布の場合にデータが約 95.4% 収まる範囲)に抑えてグラフを再描画します。これにより、不確実性の帯をグラフの枠内に完全に収めて観察できるようになります。
greedy_agent.draw_ci_of_cumulative_reward_by_step(sigmul=2)
実行結果

実行結果から下記のことがわかります。
- 最序盤のブレが引いたあとも、半透明の帯の上下幅は一切狭まることなく、広い厚みを持ったまま最終ステップまで 完全に並行な太い帯 となる
グラフから読み取れる性質の対比と考察
前節の「標準偏差の推移」や「ヒストグラムの分裂」で導き出した統計的な結論を、この塗りつぶしグラフ(信頼区間)の挙動の違いによって再確認することができます。
-
完全ランダム(探索全振り):数学的な不確実性の消滅
試行回数(ステップ数)を増やすほど、大数の法則によって平均値のブレ(標準偏差)がゼロに向かって抑え込まれていきます。最終ステップ付近では、ほぼ 100%(99.7%)のデータが 0.485 〜 0.515 という極めて狭い範囲に凝縮されるため、視覚的にも「帯が急速に潰れて細くなる」という収束の形が現れます。 -
貪欲法(活用全振り):初期の運の偏りによる「リスクの固定化」
前節のヒストグラムで観察した通り、貪欲法は 1,000 回実験すると 0.3、0.5、0.7 の 3 つの異なる正規分布の山へと完全にデータが分裂します。どれだけステップ数を 1 万回 まで増やそうとも、AI 自身に間違いを途中で修正する能力(探索機能)がないため、この「3 本の山のバラ散らばり具合」はリセットされずに固定化されます。そのため、全体の平均値である 0.559 を中心に ±2σ(約 95.4% のデータが収まる範囲。σ = 0.154)を計算して塗りつぶすと、0.25 ~ 0.85 の範囲の「上下幅が約 0.6 もある極太の帯」が狭まることなく最後まで水平に伸び続ける ことになります。
どれだけ学習の時間を増やして長くレバーを引かせても、事前の探索をサボった貪欲法は、いつまでたっても「次にゲームを始めたときに、AIがハズレ台を掴んで爆死しているか、当たり台を掴んで無双しているか」の予測が全くつかない(リスクが一切減少しない)ことが、この太い帯のまま伸び続けるグラフによって明らかになりました。
スロットマシンの当たりの確率の推測値の平均からのブレの比較:信頼区間の収束と固定
AI が頭の中で見積もっている「各スロットマシンの当たりの確率の推定値」が、真の確率を中心としてどれだけの範囲に広がっているかという「信頼区間(不確実性の広がり)」の推移を視覚化します。また、具体的なブレ幅(標準偏差)の数値の減り方をはっきりと捉えるために、その推移グラフもあわせて描画しました。
random_agent.draw_ci_of_estimated_odds_of_arm()
random_agent.draw_std_estimated_odds_of_arm()
greedy_agent.draw_ci_of_estimated_odds_of_arm()
greedy_agent.draw_std_estimated_odds_of_arm()
実行結果
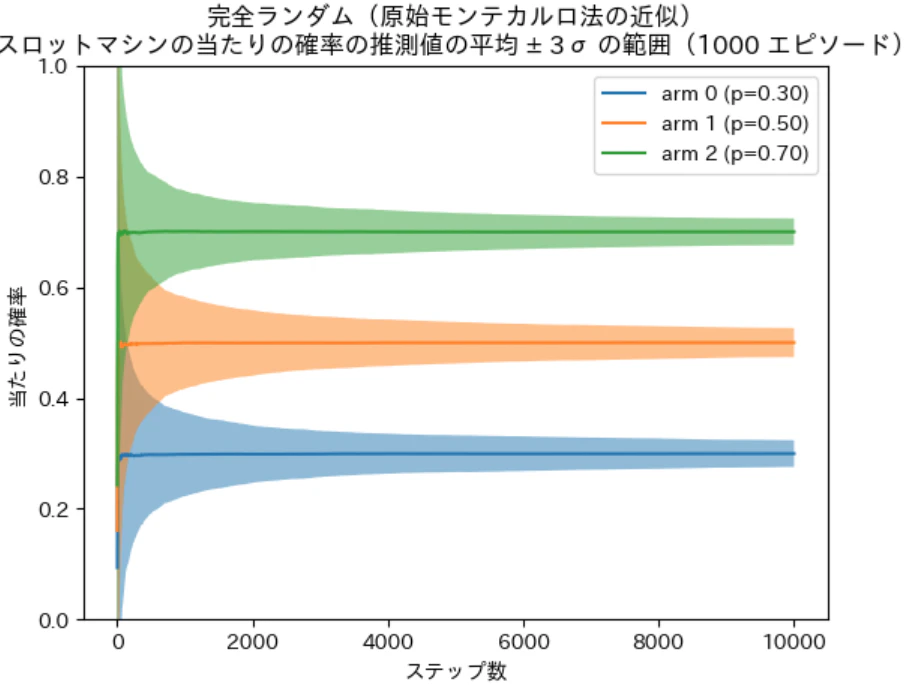


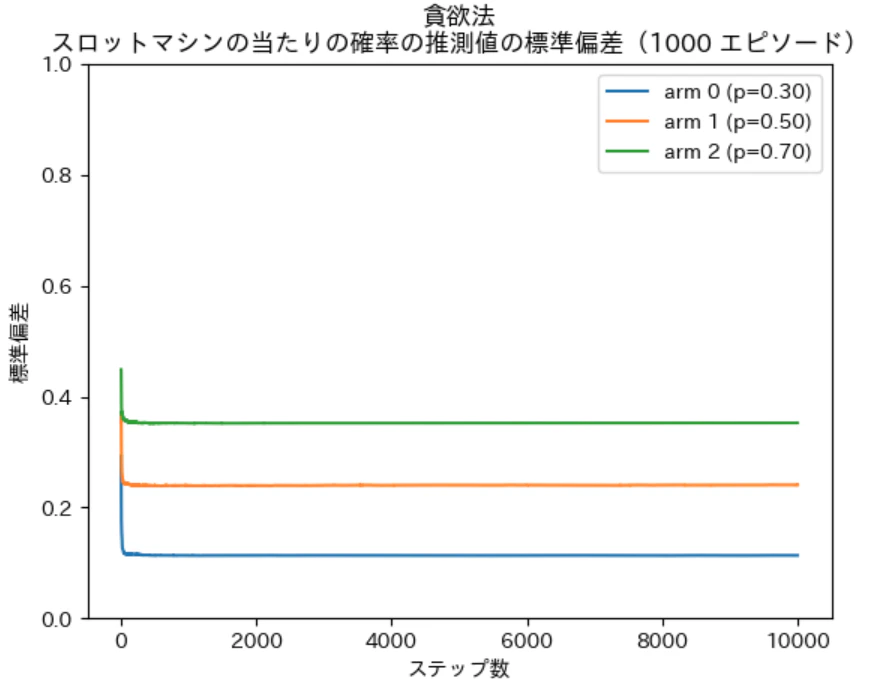
実行結果から下記のことがわかります。
- 完全ランダム(探索全振り):ステップ数が進むにつれて、3 台すべてのスロットマシンの半透明の帯(ブレの範囲)が急速に細くなり、中央の真の確率(0.3, 0.5, 0.7)に向かって収束する。もう一方のグラフでも、標準偏差(ブレ幅)の数値が 0 に向かって急降下していく様子が確認できる
- 貪欲法(活用全振り):データのバラつき(標準偏差)が大きすぎるため、デフォルトの「平均 ± 3σ」で色を塗ると、3 台のスロットマシンの半透明の帯が画面全体で重なり合い、何が起きているのか判別できないグラフになる
そこで、貪欲法に対してのみ、各スロットマシンの帯が重なり合わずに独立して観察できるよう、標準偏差の倍率を限界まで絞り込んだ sigmul=0.2(約 15 %のデータだけが収まる範囲)に指定してグラフを再描画することにします。
greedy_agent.draw_ci_of_estimated_odds_of_arm(sigmul=0.2)
実行結果

実行結果から下記のことがわかります。
- 最序盤のブレが引いたあとも、3 台すべてのスロットマシンの半透明の帯の上下幅は、最終ステップに至るまで完全な並行の帯を維持する
標準偏差の倍率を 0.2 まで落とした帯には、全体のわずか 15 %のデータしか含まれませんが、ここで本質的に重要なのはデータの網羅率ではなく、「どれだけステップ数を増やしても、ブレ幅の帯が一切狭まらず、完全に並行なままである」 というグラフの形状そのもの にあります。
グラフから読み取れる性質の対比と考察
この各スロットマシンの当たりの確率の推定値に関する信頼区間の挙動は、先程示した最初に当たりが出たスロットマシンだけを選択し続けるという「貪欲法での活用の歪み」が、1,000 回のエピソード全体でどのように固定化されているかを表しています。
-
完全ランダム(探索全振り)
完全ランダムの場合は、すべてのマシンを平等に 1 万ステップの最後まで引き続けます。1 台あたりの試行回数(標本数)が約 3,333 回まで地道に積み上がっていくため、大数の法則によってすべての台の標準偏差(ブレの度合い)は 確実にゼロへと収束 していきます。時間が経てば経つほど、AI がスロットマシンの真の実力を完璧に把握していく様子が収束の帯に表れています。 -
貪欲法(活用全振り)
一方、貪欲法のブレの幅が完全な並行のまま全く変化しない理由は、1,000 回のエピソードを回した時に、それぞれのスロットマシンの当たりの確率の推定値が以下のように、「真の確率」か「完全なゼロ」かの 2 通りになるからです。-
最初にそのスロットマシンで当たりを引いた場合(確率約 1/3):
AI はその台を神台だと盲信し、残りの 1 万ステップすべてでそのスロットマシンのレバーだけを引き続けます。そのスロットマシンだけは十分に試行されるため、大数の法則によって、そのスロットマシンの推定値だけは「真の確率(0.3 / 0.5 / 0.7)」へと正しく収束します。 -
最初に別のスロットマシンで当たりを引いた場合(確率約 2/3):
AI は別のスロットマシンを選択し続けるため、このスロットマシンは一度も当たりを引くことがありません。そのため、このスロットマシンの当たりの推定値は最後のステップまで初期値である 0 のまま変化しません。
-
最初にそのスロットマシンで当たりを引いた場合(確率約 1/3):
つまり、1,000 回のエピソード全体で「あるスロットマシンの当たりの確率の推定値」を集計すると、約 33.3 %の回では「真の確率」になり、残り約 66.6 %の回では「一律で 0」という極端なバラつき方をします。
従って、その平均値はおおむね以下の近似式で求めた値になります。
$$\text{当たりの推定値の平均}\approx \frac{\text{真の確率}+0+0}{3}=\frac{\text{真の確率}}{3}$$
実際に、print_summary で確認した貪欲法の最終ステップの推定値の平均は、「スロット 0」(真の確率0.3)が 0.057 ($\approx 0.1$)9、「スロット1」(真の確率0.5)が 0.162($\approx 0.16$)、「スロット2」(真の確率0.7)が 0.341($\approx 0.23$)と、理論上の近似値(真の確率の約 1/3)に近い数値を示しています。
例えどれだけレバーを引く総数を 1 万回から 10 万回へ引き伸ばしたとしても、別のスロットマシンで当たりを引いてしまうとそのエピソードでのそのスロットマシンの標本数は全く増えません。大数の法則を働かせるために必要な試行回数が不足するため、エピソード間での「真の確率か、それとも 0 か」という大きなブレは、ステップ数をどれだけ増やしても永久に薄まることなく維持され続けます。
このグラフから、事前の探索不足により特定の選択肢のみが試行され、他が未探索のまま固定されるという貪欲法の致命的な欠点が明らかになりました。
今回の記事のまとめ
今回の記事では、共通の土台である MAB_Agent クラスを「継承」することで、活用に全振りした Greedy_MAB_Agent(貪欲法)をわずか数行のシンプルなコードで実装しました。
そして、探索に全振りした「完全ランダム」と、活用に全振りした「貪欲法」という、真逆の性質を持つ 2 つの極端なアルゴリズムを多角的な視点からグラフ化し、その決定的な違いを明らかにしました。2 つのアルゴリズムが犯している致命的な弱点は、以下のような 2 つのアルゴリズムの相反する性質によるものです。
-
完全ランダム(探索全振り):
すべてのスロットの実力をほぼ完璧に見抜ける(不確実性ほぼゼロ(標準偏差が 0.005)にできる)ものの、途中で得られた経験を次の行動に一切活かさないため、獲得コインの期待値は $p_{mean} = 0.5$ から一向に成長しない。 -
貪欲法(活用全振り):
事前の実験を全く行わないため、最初に当たりが出たスロットマシンを最善だと考えて思考停止して依存する「まちぼうけ現象」が発生する。その結果、全体の 1/3 の確率で最悪のハズレ台を引き続けるという、運任せで非常にブレ幅が大きい(標準偏差が 0.154)リスクの高い戦略になってしまう。
多腕バンディット問題(強化学習)の目的関数を最大化するためには、「探索」と「活用」のどちらか片方に偏るのではなく、両者をいかにバランスよく、そして適切な順番で組み合わせるかが極めて重要である という本質が、今回のグラフによる視覚化を用いた分析によって明らかになりました。
極端な 2 つのアルゴリズムの失敗例を学んだところで、次回の記事からは、いよいよこのトレードオフのジレンマを解決するための「真の強化学習アルゴリズム」の解説を行います。
まずはその手始めとして、最もシンプルながら強力な能力を持つ ε-greedy法(イプシロン・グリーディ法)を紹介します。基本は貪欲に利益を追い求めつつ、たまに(きまぐれに)探索を混ぜるという作戦によって、グラフの水平線の壁がどのように打ち破られ、神様の視点の上限(0.7)に向かって右肩上がりに進化していくかを、今回と同様にグラフで視覚化しながら説明する予定です。
本記事で入力したプログラム
今回の記事で実装したクラスは ai.py に保存することにします。
| リンク | 説明 |
|---|---|
| marubatsu.ipynb | 本記事で入力して実行した JupyterLab のファイル |
| ai.py | 本記事で更新した ai_new.py |
次回の記事
近日公開予定です
-
ファイル名の中で拡張子を除いた部分のことを「ベース名」と呼びます ↩
-
numpy のデータ型を 16 ビットの浮動小数点数にしてデータサイズを減らすという工夫は、ディープラーニング(深層学習)で実際に良く用いられる手法です ↩
-
gzip による圧縮は、データの内容によって圧縮率が異なります。そのため、
random_agent.pklは約 14 MB に、greedy_agent.pklはさらにその約半分の約 7 MB のサイズになりました ↩ -
上記のグラフでは水色の「スロット 0」の選択回数が他よりもわずかに多いように見えますが、これはエピソード内でのランダムな乱数のブレ(確率のゆらぎ)にすぎません ↩
-
先ほどのグラフと同様に、オレンジ色の「スロット 1」のグラフは緑色の「スロット 2」のグラフと完全に重なっているため、オレンジ色の「スロット 2」のグラフが隠れて完全に見えなくなっています ↩
-
グラフの y 軸の最小値を 0 としたためグラフの y 軸とグラフの下枠が重なり合っています。そのため、わかりづらいかもしれませんが、その上にオレンジ色の「スロット 1」と緑色の「スロット 2」のグラフが重なって表示されています ↩
-
分布が正規分布に従わなくても、よほど特殊な分布でない限り 99 % 以上のほぼすべてのデータがこの範囲に収まると考えて問題はありません ↩
-
0.1 の半分くらいの値になる理由は、スロット 0 で最初に当たりが出る確率が、厳密には 1/3 よりも小さな値になるからです。スロット 2 の値が 0.23 より大きな 0.341 になる理由も同様で、スロット 2 で最初に当たりが出る確率が 1/3 よりも少し大きな値になるからです ↩