
はじめに
AWSの運用監視領域は、ここ数年「リソースを監視してメトリクス・ログ・トレースを貯める」から「あらゆるデータを集約・正規化して、それらを使って意思決定する」フェーズへの移行が進んでいます。
AWS re:Invent 2025 のセッション『[NEW LAUNCH] What's new with Amazon CloudWatch(COP363)』でも、"data to decisions faster/simpler/more autonomously"(データから意思決定へ、より速く・簡単に・より自律的に)という方向性が明確に打ち出されました。
本記事では、AWS re:Invent 2025のセッション、および2025年11月〜12月のアップデートに基づき、我々がどのように設計思想の更新をすべきかについて解説をします。
直近のアップデート一覧
| リリース日 | 機能 | アップデート | メリット |
|---|---|---|---|
| 2025/09/17 | Logs Centralization | クロスアカウント・クロスリージョンログ集約(一元化) | コンプライアンスとデータの保全 |
| 2025/11/5 | CloudWatch Database Insights - Enhanced Anomaly Detection | オンデマンド分析で異常検知能力が向上(OS、DB、SQLの各レベルで異常を検出して正常時と比較して問題を指摘) | 見える化、解決手順の提示により解決時間の短縮 |
| 2025/11/11 | CloudWatch Composite Alarms - Threshold-based Alerting |
AT_LEAST関数による柔軟なアラート設定 |
「4個中2個以上」「全体の50%以上」といった条件指定によりアラートラッシュを軽減、サーバーが増えても設定変更不要 |
| 2025/11/19 | CloudWatch Logs Insights - Scheduled Queries | ログ分析クエリを定期実行、クエリ結果をS3に保存 or SNS/EventBridge経由で通知 | 週次レポートを自動生成 |
| 2025/11/19 | CloudWatch RUM - Mobile Support (iOS & Android) | iOSとAndroidアプリも監視対象となり画面の表示速度、クラッシュ、API応答時間の表示やAppHangを検出 | ウェブもモバイルも1つのダッシュボードで監視 |
| 2025/11/20 | CloudWatch Application Map - Enhanced Discovery | 計測してないサービスを自動検出し、複数アカウントをまたいで全体マップを表示 | システム全体を見渡すことができる |
| 2025/11/21 | CloudWatch Application Signals - GitHub Action & MCP Server | GitHub Issuesでメンション、遅延の特定や計測設定のコードまで記述 | AWSコンソールを開かずGitHubで完結 |
| 2025/11/21 | CloudWatch In-Console Agent Management on EC2 | EC2のコンソールからワンクリックでエージェント導入 | 全環境で同じ監視を保証 |
| 2025/11/21 | CloudWatch Database Insights - Cross-Account Cross-Region Monitoring | 複数アカウント・複数リージョンのDBを一画面で見える化 | 本番・検証・開発を横断して状況把握 |
| 2025/11/21 | CloudWatch Container Insights - Neuron UltraServers Support | 大規模ML用のNeuron UltraServersに対応し、複数EC2を束ねた論理サーバーとして監視 | ML環境のパフォーマンスがまとめて見える化 |
| 2025/11/21 | CloudWatch Container Insights - Sub-Minute GPU Metrics | EKSで動くAI/MLワークロードを対象にGPUメトリクスを秒単位で取得可能 | GPUの使い方、パフォーマンスの見える化 |
| 2025/11/26 | CloudWatch Logs Deletion Protection | ロググループに削除保護をかける | 監査ログや本番ログの誤削除防止 |
| 2025/11/30 | CloudWatch Incident Reports - Five Whys Analysis | チャットベースでのなぜなぜ分析 | 「なぜこうなった?」を明確にして障害報告のベースを自動作成 |
| 2025/12/2 | CloudWatch Unified Data Management | 運用、セキュリティ、監査のログを1箇所に集約、S3 TablesでIceberg形式に自動変換、分析までをパイプライン化 | ログのサイロ化や重複を防ぎ、ETLパイプラインの作成の手間が減少 |
| 2025/12/2 | CloudWatch Pipelines | AWSリソースに加えてサードパーティのログを自動で収集、データ加工までを一括して行う | 従来、KinesisとLambdaで組んでたETLが不要となり処理コストが低減 |
| 2025/12/2 | CloudWatch Facets | ロググループを意識せずにログソース、アプリ名、リージョンで絞り込み | 「どのロググループだっけ?」が不要でField Indexesを活用することで最大10,000ロググループにまたがるクエリを実現 |
| 2025/12/2 | CloudWatch GenAI Observability - AgentCore Evaluations | AIエージェントの品質を13項目で自動評価、CloudWatchダッシュボードで一元管理 | AI品質を継続的に測定 |
| 2025/12/5 | CloudTrail Events in CloudWatch | CloudWatchコンソールから直接CloudTrailイベントのCloudWatch Logs保存の設定が可能 | 証跡を作成せずにCloudWatch Logsへイベントを配信 |
| 2025/12/30 | CloudTrail Lake Data Import | CloudTrail Lakeの過去データを簡単取り込み | 運用ログと監査ログを一緒に分析、過去のコンプライアンスデータや長期トレンドを分析可能 |
アップデートから見る CloudWatch の進化の2つの方向性
データ観点→ログ/イベントのライフサイクルをCloudWatchで完結
- 集める、守る、整える、探すという運用基盤としてのエンハンスメント
- Unified Data Store / Pipelines / Facets / Logs Centralization / Deletion Protection など
運用観点→運用プロセス(検知〜切り分け〜修正〜振り返り)の自動化
- Composite Alarm / Cross-Account Cross-Region Monitoring / In-Console Agent Management など
運用の現場における課題
こんなことで困っていませんか?
-
データサイロと重複
- CloudTrail, VPC, WAFなどがSecurity/Ops/Audit が複数のデータストアに分散・重複
-
複雑な運用とMTTR増大
- 複雑なETLパイプライン管理のオーバーヘッドと、手動連携による復旧遅延
-
コスト非効率
- 同一データの重複保存や転送コスト、複数のツール運用コストが発生
課題解決のための CloudWatch のアプローチ

(1) Ingestion(Unified Data Store)
収集・キュレーション・保管・分析を単一プラットフォームで実現するための仕組み

Unified Data Storeの仕組み
Collection
データソースとして以下を選択することが可能です。
- AWSサービスログ
- サードパーティコネクタ(CrowdStrike、Okta、GitHub、M365など)
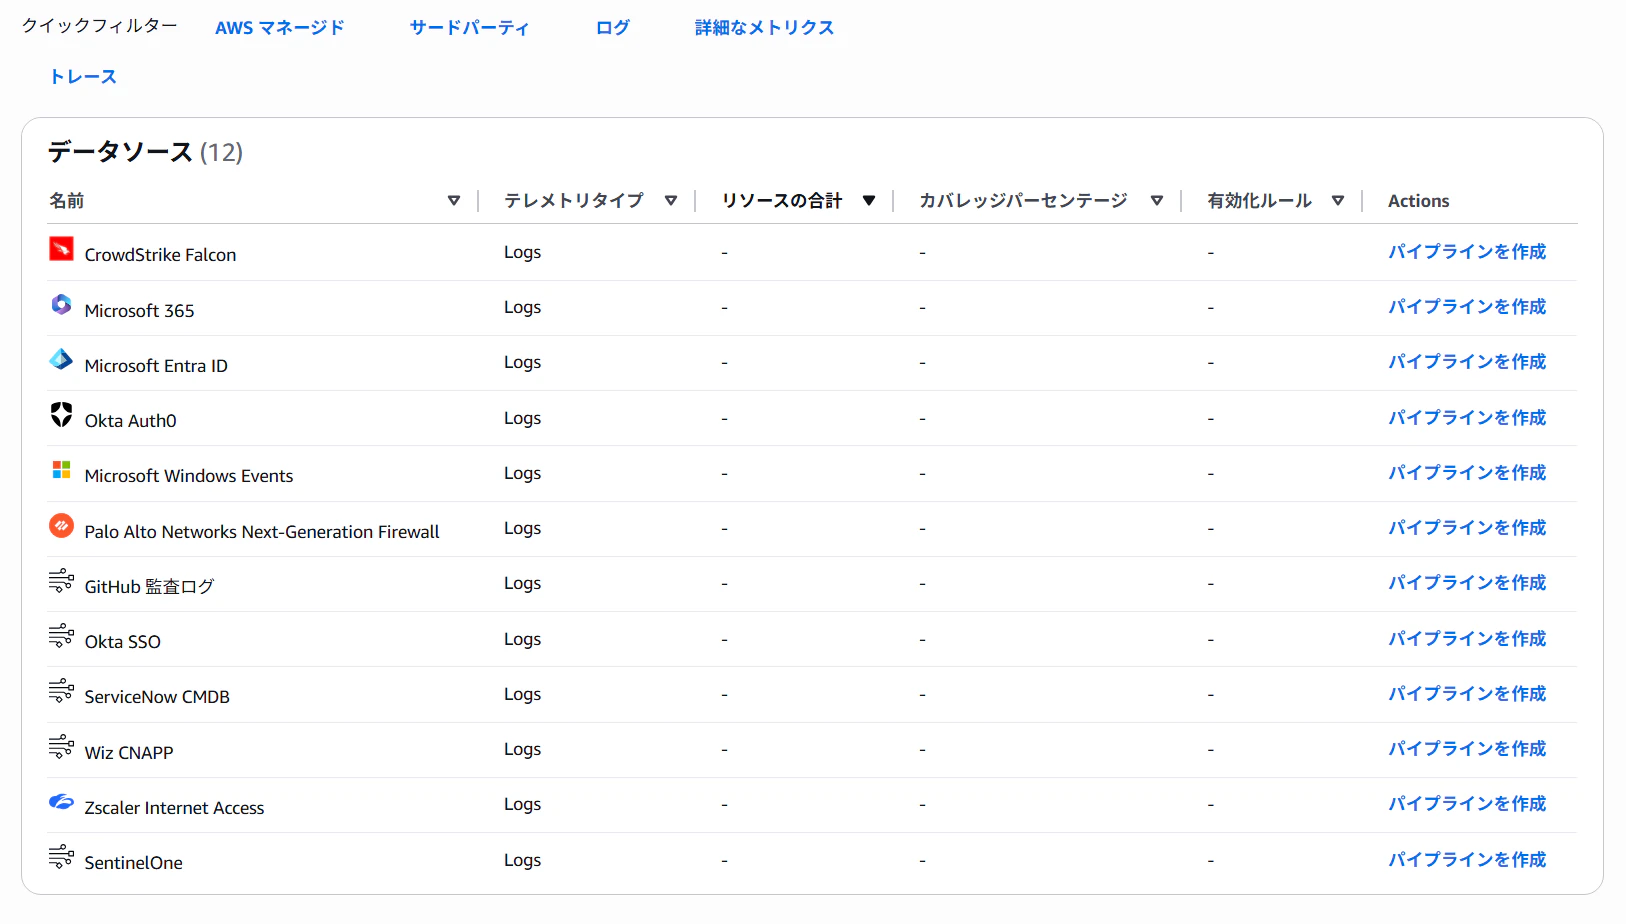
- カスタムログ(CloudWatchカスタムログ、S3)
Curation
- コードレスでログ変換・エンリッチメント処理を実行
- 標準スキーマへ整形(OCSFなど)
- Grok(正規表現ベースのログパースパターン)プロセッサによるカスタムパース
- メタデータ追加(Account ID、Application Name等)
- 自動スキーマ検出
- ログソースごとのスキーマ自動抽出
- Field Indexes
- リクエストID、トランザクションIDなどクリティカル属性をインデックス化
Storage
- クロスアカウント・クロスリージョン集約(単一アカウントへの統合管理)
- データソース別の保持期間設定
- Apache Iceberg対応(S3 Tablesとの統合によるオープンフォーマットサポート)

- 2つのログクラス
- Standard(標準ログクラス):リアルタイム性のある監視
- Infrequent Access(頻度アクセスログクラス:コンプライアンス向けアクセス頻度の低いログ
Analytics
- S3 Tables統合によるAthena、Redshift、EMR、SageMaker Unified Studioからのインプレースクエリ
- Log Facetsによるクエリ実行前のフィールド分布可視化
- 最大 10,000 のロググループを対象にクエリ(機能/設定条件により、選択可能なロググループ数が拡張)
- 自然言語クエリ生成、自動分析
設計におけるメリット
- ✅ データ重複削減:同一ログの複数コピー不要(コスト削減)
- ✅ ETL不要:Kinesis/Lambda変換パイプラインの構築・運用負荷解消、コスト削減
- ✅ Iceberg互換:Spark/Trino等のOSSクエリエンジンも利用可能
- ✅ スキーマ管理:データソース別にフィールドインデックス自動生成
CloudWatch Pipelines
特徴
CloudWatch Pipelinesは、「収集(Collection)」と「キュレーション(Curation)」の2つのフェーズにまたがってデータの「入口」から「構造化」までを担う基盤機能です。
パイプラインの中でログイベントを変換/解析/加工する処理ユニットをプロセッサと呼びます。定義した順に逐次適用されます。
-
パーサ(Parser)
生ログを構造化フィールドに変換します。
例:OCSF/CSV/JSON/Grok/key-value/VPC Flow Logs/Route 53 Resolver logs など -
トランスフォーマ(Transformation)
フィールドを追加/コピー/削除/移動/フラット化などして形式を整えます。
例:add_entries/copy_values/delete_entries/move_keys/flatten など -
文字列操作(String)
値の大文字小文字変換、トリム、置換など、文字列を加工します。
プロセッサ利用に“個別の処理課金”は基本なく、ログ取り込み課金がベースです。また、CloudWatchの機能としてS3 Tables で参照すること自体に対して追加料金はかかりません(S3 Tables側のストレージ料金は別途必要)。Athena などの分析サービスのクエリやデータ転送は別途料金がかかります。従来のETLアーキテクチャーと比較して、設計次第で運用負荷やコストを下げられる可能性があります。
制約
- 1パイプラインあたり 最大20プロセッサまで。
- パーサプロセッサは各パイプラインで最大1つ、かつ先頭に配置する必要があります。
(2) AI Operations
Investigations
CloudWatch の中に組み込まれた生成AI機能で、システムのテレメトリ(メトリクス、ログ、トレースなど)をスキャンし、インシデントに関連するデータや根本原因の仮説を提示するトラブルシュートするアシスタント。スコープとして、AWS環境内の CloudWatch データを対象とします。
- コンソール全体統合
CloudWatch Alarms をはじめ80以上のAWSサービスから「Investigate」ボタンで起動可能です。 - エンドツーエンドガイド
アラームから原因解析まで自動分析します。 - 自動相関分析
リソース依存関係とテレメトリの相関性を自動検出します。
AWS DevOps Agent(プレビュー)との違い
DevOps Agentは、インシデントの解決と予防を自律的に行うフロンティアエージェント。リソースのトポロジーや関係性を学習し、オブザーバビリティツール、ランブック、コードリポジトリ、CI/CDパイプラインと連携して、テレメトリ・コード・デプロイデータを横断的に相関分析する。
Incident Report Generation
Investigationsの結果をもとに、Amazon Correction of Errors(CoE)形式に沿ったインシデントレポートの自動生成を行います。
特徴
- 自動データ収集
調査から得られたテレメトリ(メトリクス、ログ、トレース、変更履歴など)の自動で収集します。 - Five Whys分析
収集した情報(アラーム、ログ、変更履歴など)をインプットにして、①直接的な原因、②背景、③設計・運用の欠陥、④プロセス上の欠陥、⑤組織・仕組みの欠陥について、仮説を提示します。 - 定型インシデントレポート出力
- Summary(要約):何が起きたか/影響は何か
- Impact(影響):影響時間、影響対象、SLO違反など
- Timeline(時系列):検知、一次対応、復旧、恒久対応
- Root Cause/Five Whys(原因):AIの叩き台 + 人が確定
- Corrective Actions(是正処置):再発防止タスク(優先度付き)
- Lessons Learned(学び):プロセス改善、監視改善、設計改善など
(3) GenAI Observability
Model Invocations
Bedrock モデル呼び出しのオブザーバビリティ。モデルごとの呼び出し回数、レイテンシ、トークン数、呼び出しのスロットリングなどをリアルタイムにダッシュボードに表示して可視化。
Bedrock Agentcore Observability(プレビュー)
AIエージェントの実行状況を CloudWatch で可視化するための機能です。AIエージェントがいつ、何をして、どこで遅くなり、失敗したかをメトリクス、ログ、トレースを自動的に収集して、運用時の障害解析やパフォーマンス改善、監査のために利用できます。
まとめ
2025年のCloudWatchは「データ統合」「AI Operations」「GenAI Observability」という3つの軸で大きく進化を遂げました。特にUnified Data StoreとPipelinesは、現場の課題「ログのサイロ化」「ETLパイプライン運用負荷」を解決する有効な機能といえるのではないでしょうか?
若干、CloudWatch のマネジメントコンソールが複雑になってきた印象はありますが、最新機能を前提に設計思想を更新することが重要なのではないでしょうか。