PDFからエクセルへの転記をラクしたい!
小売業で働くYasuと申します。スーパー銭湯♨大好きで、最近はボートレースにもはまりつつあります。
私が担当している業務に、「契約書の管理」というものがあります。業務内容を簡単に時系列で説明すると、下記のような感じになります。
 契約内容にもとづき、各お取引先に進捗報告を依頼
各お取引先から進捗報告がGmailで返信(エクセルまたはPDF)
エクセルで届いた報告書は、アクセスで集計表に自動転記。
PDFで届いた報告書は、手入力で転記。
1つの報告書につき、転記する項目が18個あり、時間もかかるうえに打ち間違いもしょっちゅう スキャンされたPDFなので、エクセルのデータ取得機能も使えず
 なんとか、時短+精度向上ができないものか考え、手始めに 「自動+手動」 のツールをつくってみました!

報告書の一例
赤枠で囲っている箇所が、集計表に転記したい箇所です。

集計表
この集計表に転記し、一元化しています。

使い方
報告書PDFをチャットボットに添付します。「プロンプトに沿って、抽出して」と入力。
添付するPDFは1枚でも複数枚でも対応可能です。

あらかじめ指定しているプロンプトに従い、下記のような返答が返ってきます。

返ってきた文面をすべてコピーし、エクセルに値貼り付けし、仮置きします。すると、
1行目に各項目、2行目にPDF1つ目、3行目にPDF2つ目、4行目にPDF3つ目が貼り付きます。

「データ」タブ→「区切り位置」機能を使用し、項目ごとに分割します。


集計表エクセルに値貼り付けし、完成です。

作り方
たいした手順はありませんが、作り方を紹介します。プロンプト内の項目名を変更すれば、他のPDFにも対応できると思います。
| 使用したもの | 用途 |
|---|---|
| Dify(チャットボット) | プロンプトの入力 |
| Gemini2.5 flash | PDFから必要データを抽出 |
チャットボットのプロンプトに下記をコピペ( ChatGPTと相談しながら作成しました)
以下の帳票データから必要項目を抽出してください。
出力は必ず「タブ文字(\t)のみ」で区切ってください。
スペースは禁止します。
CSVではなくTSV形式で出力してください。
【重要ルール】
・区切りは必ずタブ(Tabキー)
・スペース区切り禁止
・JSON禁止
・説明禁止
・日付の表記はyyyymmdd
・1行目:項目名
・2行目:値
【項目】
対象部門
取引先名称
契約内容欄の最初5桁又は6桁のコード
契約書No
入金予定日
契約期間開始
契約期間終了
計算期間開始
計算期間終了
割り戻し金(税抜き)上部
消費税8%
8%合計
割り戻し金(税抜き)下部
消費税10%
10%合計
割戻し金合計(税抜)
消費税
税込金額
と、ここまで 自動+手動 でのツールを作成してきました。実際に使用してみると、入力間違いはなくなったが、手作業の工程が多く、さほどラクになっていない!という結果でした。

PDFからエクセルへの転記をもっとラクしたい!
次にチャレンジするのは、完全自動化のツールづくりです。Googleドライブに報告書PDFを投函し、ボタン1クリックでスプレッドシートに転記されるのが理想!
ただ、まだまだ私の知識不足で完成には至っていません。最終工程のスプレッドシートへアウトプットするところでつまずいていますので、そこに至るまでの工程を掲載しておこうと思います。
Makeのシナリオ

フローチャート
Google Driveのファイルを取得し、HTTPリクエストを経由してJSON形式に加工し、Googleスプレッドシートに書き込むまでの流れです。

作り方(ステップ1)
GoogleDrive内に報告書PDFを保管する
まず、GoogleDrive内に報告書PDFを保管するフォルダを作成しておきます。ここでは、フォルダ名「割り戻し金確認書PDF保管」で作成しました。指定フォルダからPDFを検索するモジュールとして、GoogleDrive(Watch Files in a Folder)を使用します。
作り方(ステップ2)
PDFファイルをダウンロードする
ステップ1で検索したPDFファイルをダウンロードするためにGoogle Drive(Download a File)を使用します。

作り方(ステップ3)
スキャンPDFから文字情報を抽出する
ステップ2でダウンロードしたスキャンPDFは画像データなので、OCR APIを使用し画像から文字を抽出するという作業を実施します。

作り方(ステップ4)
文字列の文字情報をJSON形式に整形する
ステップ3で抽出した文字は、まだ文字列のままです。ここでは、文字列情報をDifyに送り、AIでJSON形式に整形させます。

作り方(ステップ5)
JSON文字列を項目別データに変換する
ステップ4で得られたJSON文字列をMakeで扱える項目データに変換します。今回、ここが ボトルネック となっている箇所です。1つ前のモジュールのBody contentへのプロンプトを何度も修正しましたが、解決に至っておりません

作り方(ステップ6)
項目別データをスプレッドシートに書き込む
項目データを指定したシート・列に書き込んでいきます。(未完成)

おわりに
現状は、JSONモジュールに項目別データがインプットできていないというところが解決できておりません。このツールが完成すれば、確実に月初の集約業務がラクになります。あきらめずに最後まで完成させ、再度記事の投稿をしたいと思います。
6/16(火)追記、完成しました!
あきらめずにchatGPTとキャッチボールを繰り返しているうちに、なんとか完成にこぎつけました!上記で紹介した記事からの修正点を掲載いたします。
修正点①
項目別にデータを読み込ませるために、JSONモジュールのData structureを新しく作成しなおしました。

下記のように、1項目ずつText設定を実施しています。

修正点②
更に、確実にOCR形式で読み込ませるために、Difyのプロンプトをかなり細かく指示するように変更しました。
プロンプトを表示
あなたはOCR帳票から情報を抽出するアシスタントです。
最重要ルール
出力は有効なJSONオブジェクトのみとする。
禁止事項
説明文の出力
補足文の出力
コメントの出力
Markdown形式の出力
JSON前後への文字追加
表形式での出力
箇条書きでの出力
回答の1文字目は必ず「{」とする。
回答の最後の1文字は必ず「}」とする。
出力形式
{
"対象部門":"",
"取引先名称":"",
"契約内容欄コード":"",
"契約書No":"",
"入金予定日":"",
"契約期間開始":"",
"契約期間終了":"",
"計算対象期間開始":"",
"計算対象期間終了":"",
"報告形式":"",
"割り戻し金_税抜_上部":"",
"消費税8":"",
"8%合計":"",
"割り戻し金_税抜_下部":"",
"消費税10":"",
"10%合計":"",
"割り戻し金合計_税抜額":"",
"割り戻し金合計_消費税":"",
"割り戻し金合計_税込金額":""
}
対象部門の抽出ルール:-対象部門が複数ある場合は、最初に出現する対象部門のみ出力する
契約内容欄コードの抽出ルール:
- 「内訳」または「契約内容」の付近にある行を確認する
- 「契約内容」の右側または直後にある、最初の5桁または6桁の数字を抽出する
- 例:「945624 2/1-7/31 ピップ株)」のような行がある場合、先頭の「945624」を契約内容欄コードとして出力する
- 契約書Noとは混同しない
- 契約書Noが「2000449827」のような長い数字の場合、それは契約内容欄コードではない
抽出ルール
存在しない項目は空文字("")を設定する
推測は禁止
OCR結果に存在しない情報は出力しない
日付は YYYYMMDD 形式で出力する
金額はカンマを除去し数字のみで出力する
数値が不明な場合は空文字とする
契約内容欄コードは契約内容欄に記載された5桁または6桁の数字を出力する
対象部門は「対象部門」の下に記載されている部門番号と部門名をそのまま出力する
報告形式は「途中経過報告」または「確定報告」のうち選択されている方を出力する
OCRテキスト以外の情報は使用しない
サンプル値は出力しない
出力形式の項目名は変更しない
OCRテキスト
以下のOCRテキストのみを根拠として抽出すること。
{{text}}
修正点③
次に、2枚つづりのPDFの1枚目しか読み取らないという問題が発生しました。これに対しては、HTTP(JSON)のBody contentに記載するプロンプトを下記のように修正し、PDFを2枚読み取る設定にしました。

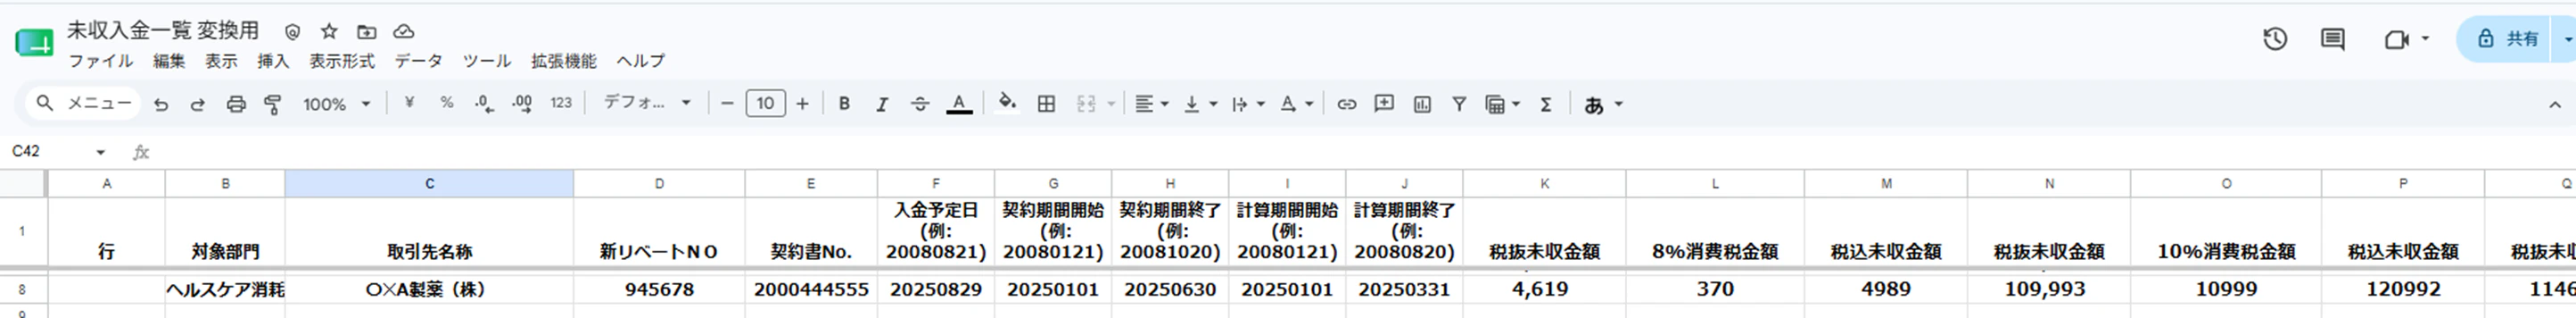
完成したスプレッドシート
ついに、PDFをGoogle driveに投函し、Makeを1クリックするだけで、下記のようにスプレッドシートに記入されるようになりました!