
はじめに
2026年9月27日、AWS for Industries ブログに「Building AI-augmented B-pillar DFMEA on AWS: Architecture, multi-agent orchestration, and implementation」という記事が公開されました。
自動車のBピラー(前席と後席の間の柱)を題材に、DFMEA(設計段階で故障モードとその影響を洗い出すレビュー)をマルチエージェントで支援する構成を解説した記事です。
シリーズ前編では、手作業のB-pillar DFMEAは潜在故障モードの40〜60%を見落とすと主張していました。
材料・工程・故障メカニズム・影響の因果連鎖をオントロジーとして持たせれば、AIは過去文書のパターン照合ではなく推論ができる、という立場です。
構成を読んで最初に気になったのはコストでした。この記事では次の3点を扱います。
NeptuneとOpenSearch Serverlessが高い
- 元記事の構成をそのまま作ると、何もしなくてもいくらかかるか
- どこを残し、どこを削れば個人でも試せる規模になるか
- 軽量化しても、オントロジーで検証するという核の部分は再現できるか
実装はGitHubに公開しています。
元記事の構成
元記事は6つのレイヤーで構成されています。
- フロントエンドと認証: Amazon S3+Amazon CloudFront(OAC)、Amazon Cognito、Amazon API Gateway REST、AWS WAF、AWS Lambda から AWS Step Functions を起動
- AWS Step Functions: 取り込み→抽出→MLによる事前スクリーニング(ランダムフォレスト、Isolation Forest)→専門エージェント4つ→分析エージェントがPDFを出力。HITL(人による承認)ゲートが4つ
- 非同期取り込み: 署名付きURLでS3へアップロードし、Amazon EventBridge 経由で Amazon Textract がOCR
- WebSocket: API Gateway WebSocket で進捗を通知し、接続IDは Amazon DynamoDB に保存
- Amazon Bedrock AgentCore: 専門エージェントをそれぞれ AgentCore Runtime で動かし、MCP経由で DynamoDB・Amazon Bedrock Knowledge Bases・Neptune・S3 にアクセス
- データ: AWS KMS、DynamoDB、S3、Amazon OpenSearch Serverless(Knowledge Bases のベクトルストア)、Amazon Neptune
オントロジーは Amazon Neptune に置き、SPARQLで引きます。更新経路は3つあります。
- JSON-LDをN-Quadsに変換して一括ロード
- Amazon A2I を使った人手承認のキュレーション
- AIAG・VDA・ISOの四半期ごとの取り込み
レビュー開始時にオントロジーのバージョンを固定する(version-pinning)仕組みも入っています。
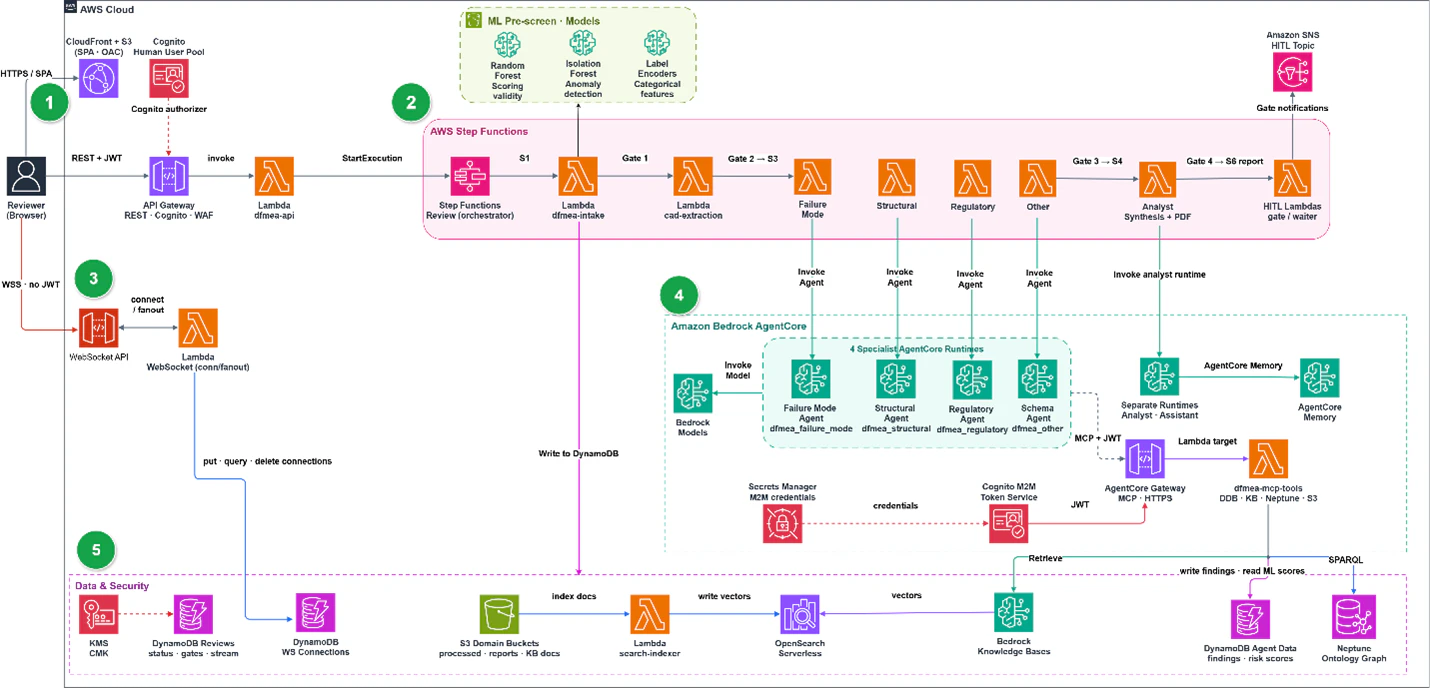
© 2026, Amazon Web Services, Inc. or its affiliates. All rights reserved.
元記事の中心は「オントロジースレッド」と呼ばれる考え方でしょう。
エージェントが出した故障モードは有効なIRI(オントロジー上の識別子)に解決できなければならず、因果連鎖は Neptune 上でたどれなければならず、矛盾が出たらオントロジーを優先して解決する、というルールです。
なお、元記事には記述の食い違いがいくつかあります。
- 本文は「専門4+分析1」のエージェント構成、結論は「チャット、オーケストレーター、GAP検出3つの5エージェント」
- 図の説明は「SPARQLクエリ7段階」、表はS1〜S6の6段階
- 結論に編集用の「[JD1]」が残っている
- GitHubリポジトリがあると書かれているものの、本文にURLがない
そのまま作ると常時課金が重い
元記事の構成には、使っていない時間も課金されるサービスが含まれています。
us-east-1 の料金を2026年9月28日に AWS Price List API と料金ページで確認しました。
| サービス | 最小構成 | 月額の目安(730時間) |
|---|---|---|
| Amazon Neptune Database | db.t4g.medium 1台($0.093/時間) | 約$68(ストレージ・I/O別) |
| Amazon OpenSearch Serverless(クラシック) | 最低1 OCU(インデックス0.5+検索0.5、冗長化なし) | 約$175 |
この2つだけで、何もしなくても月$240前後になります。ほかにも AWS Secrets Manager(シークレット単位)、AWS KMSカスタマー管理キー(キー単位)、WAF が月額で積み上がります。構成全体の正確な総額までは計算していません。
公平のために補足します。
- Neptune には新規利用者向けに30日間750時間の無料トライアルがあります
- OpenSearch Serverless の料金ページには、NextGenコレクションは最小OCUがなく、10分アイドルでゼロになると記載されています。
- 構成次第で OpenSearch 部分は下げられます
とはいえ「記事を読んで試しに動かしてみる」段階で、Neptune を常時起動しておくのは気が進みません。
そこで、元記事の核を残したまま常時課金を外す方針で作り直しました。
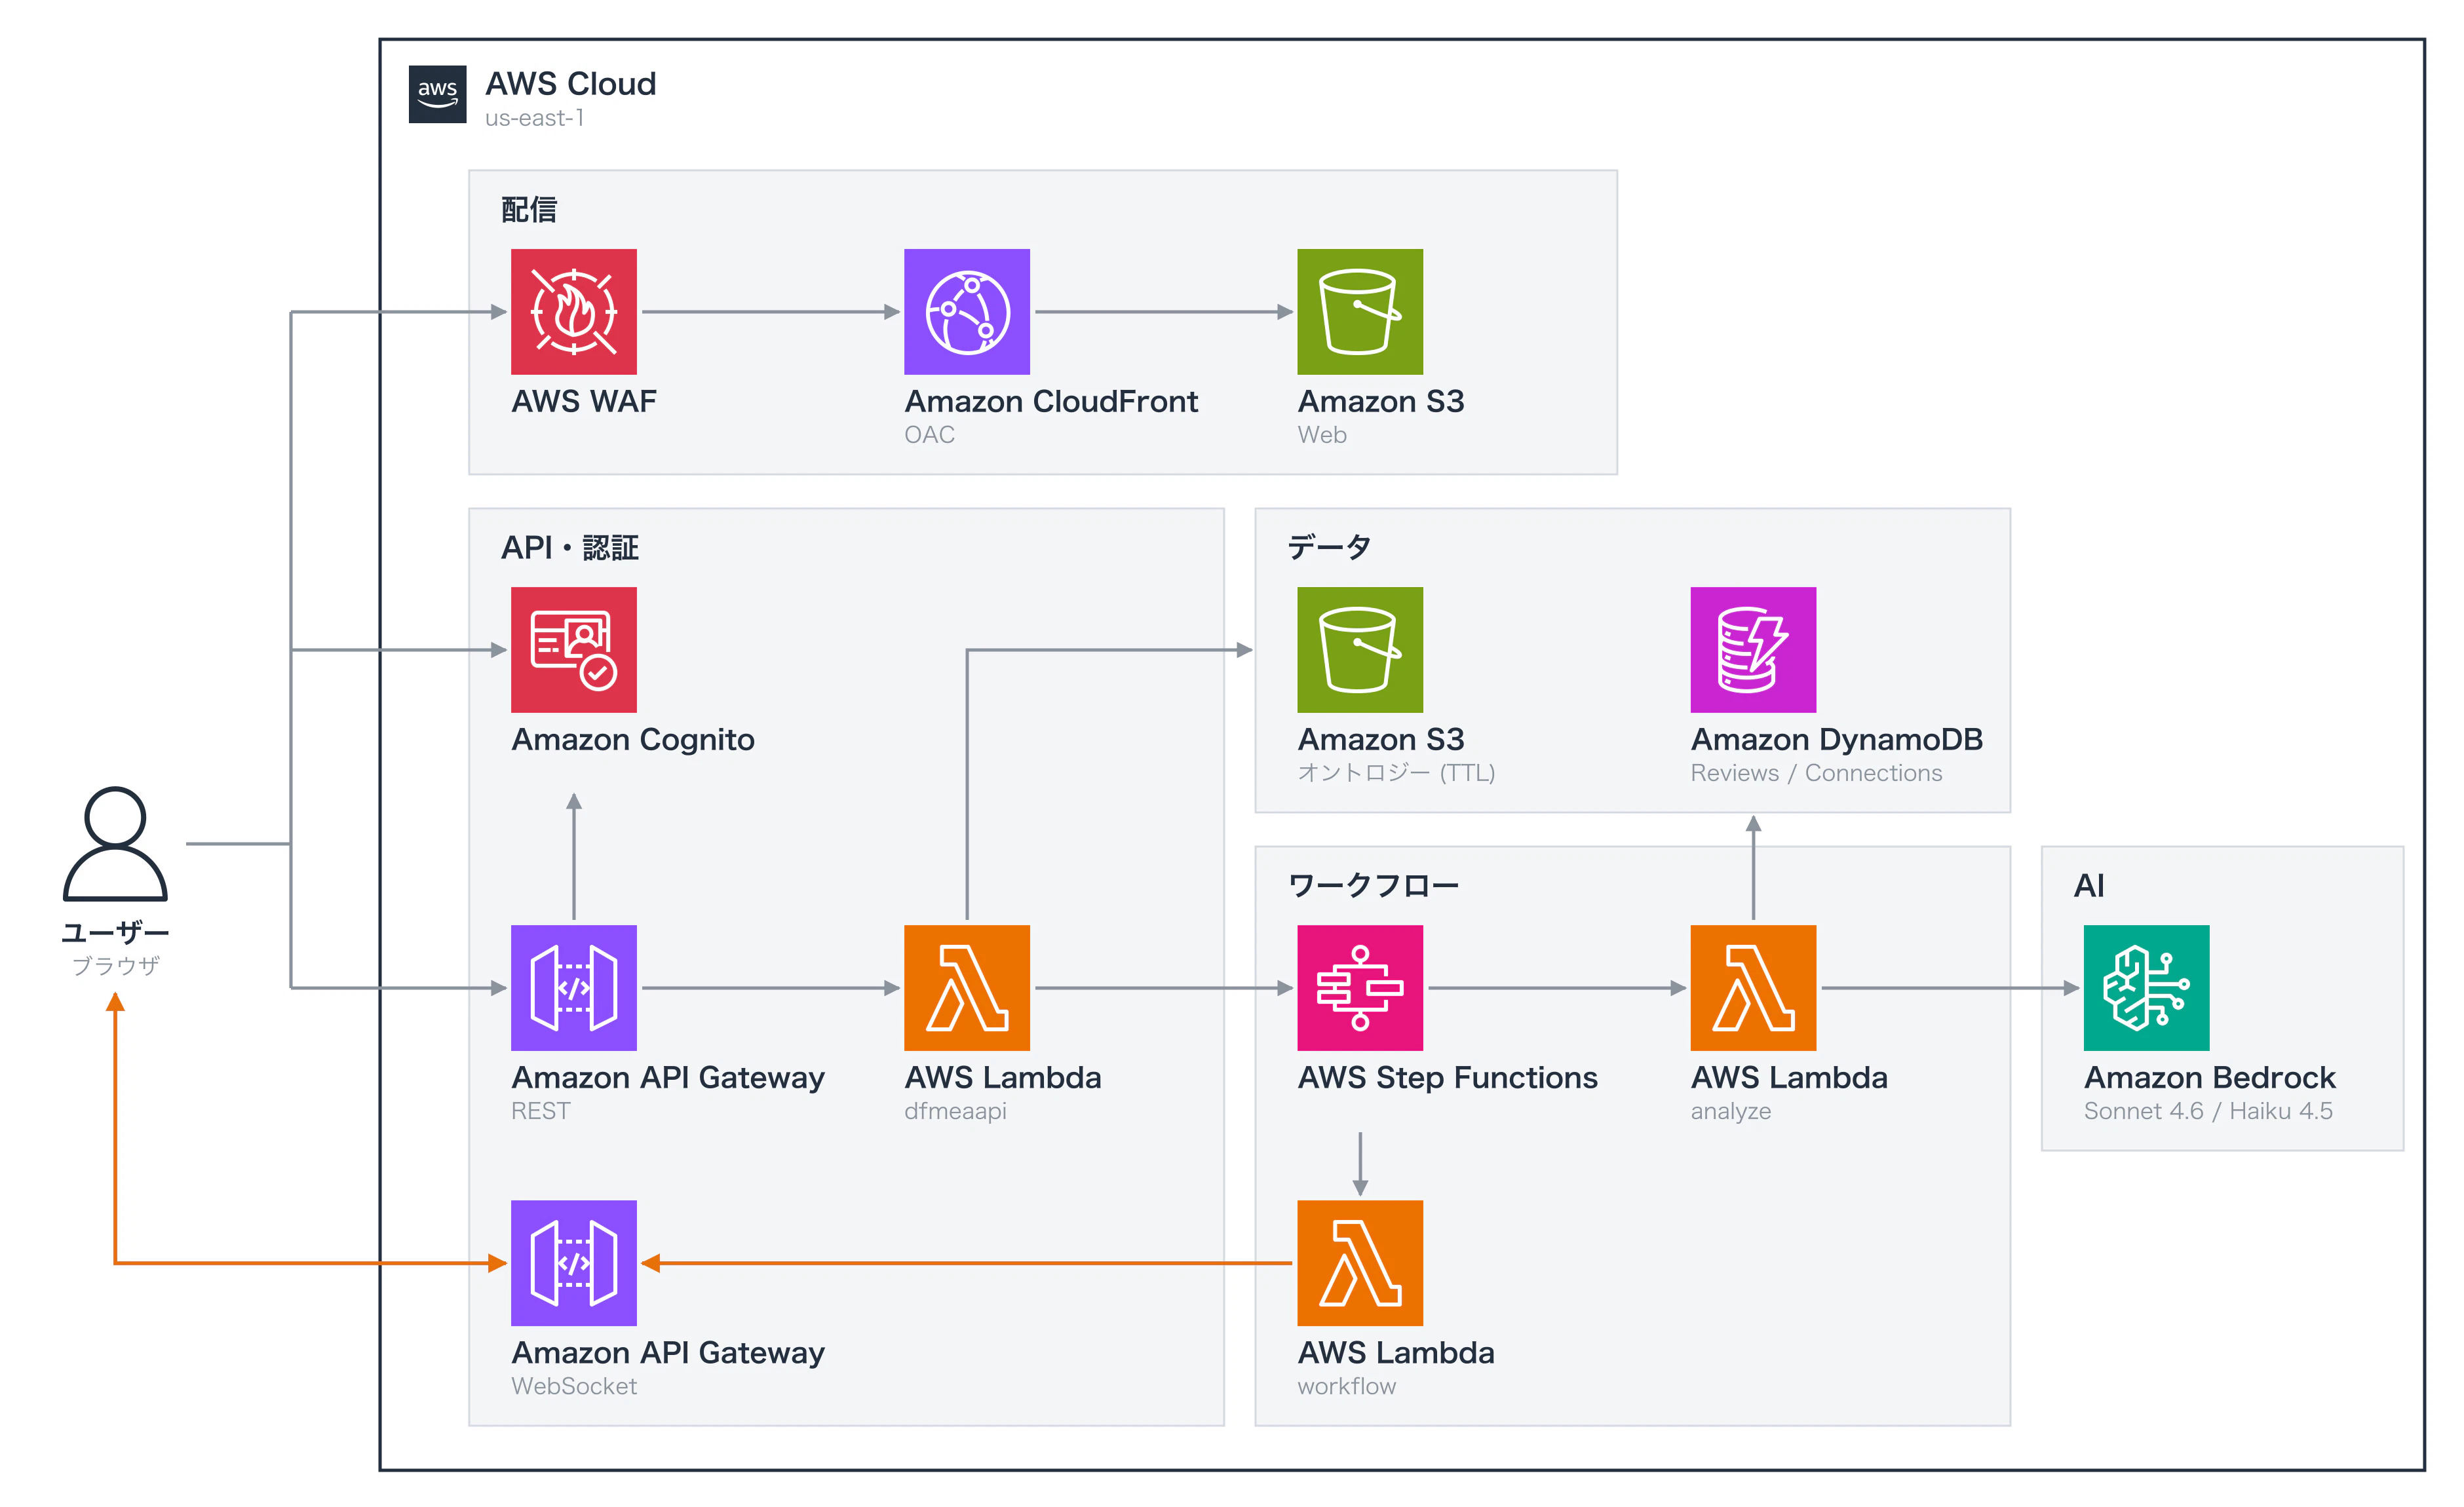
残したもの、削ったもの
ブログどおりに残した部分
フロントエンド・Cognito・WAF・WebSocketは元記事どおりにしました。
- React(Vite+TypeScript)を S3+CloudFront(OAC)で配信
- AWS WAF は CommonRuleSet と、IPごと5分1000リクエストのレート制限
- Amazon Cognito はセルフサインアップ無効、Liteプラン、SRP認証
- API Gateway REST(Cognitoオーソライザー)→ Lambda dfmeaapi → Step Functions StartExecution
- API Gateway WebSocket は $connect でIDトークンを検証し、接続を DynamoDB に保存して進捗イベントをpushします。取りこぼしは GET events?after=seq で補完します
置き換えた部分
- オントロジー: Neptune の代わりに、S3上のTTLファイル(バージョニング有効)を rdflib で読みます
- エージェント: Strands Agents SDK の「Agents as Tools」で、分析エージェント(Claude Sonnet 4.6)と専門エージェント2つ(故障モード、構造。Claude Haiku 4.5)を構成しました。AgentCore Runtime は使わず、Lambda 上で実行します
- HITL: 4ゲートを1か所に減らし、レビュー単位で承認か却下を選ぶ形にしました
- データ: DynamoDB は Reviews と Connections の2テーブルです。
- 所見は DynamoDB に置き、ステート間ではIDだけを渡します
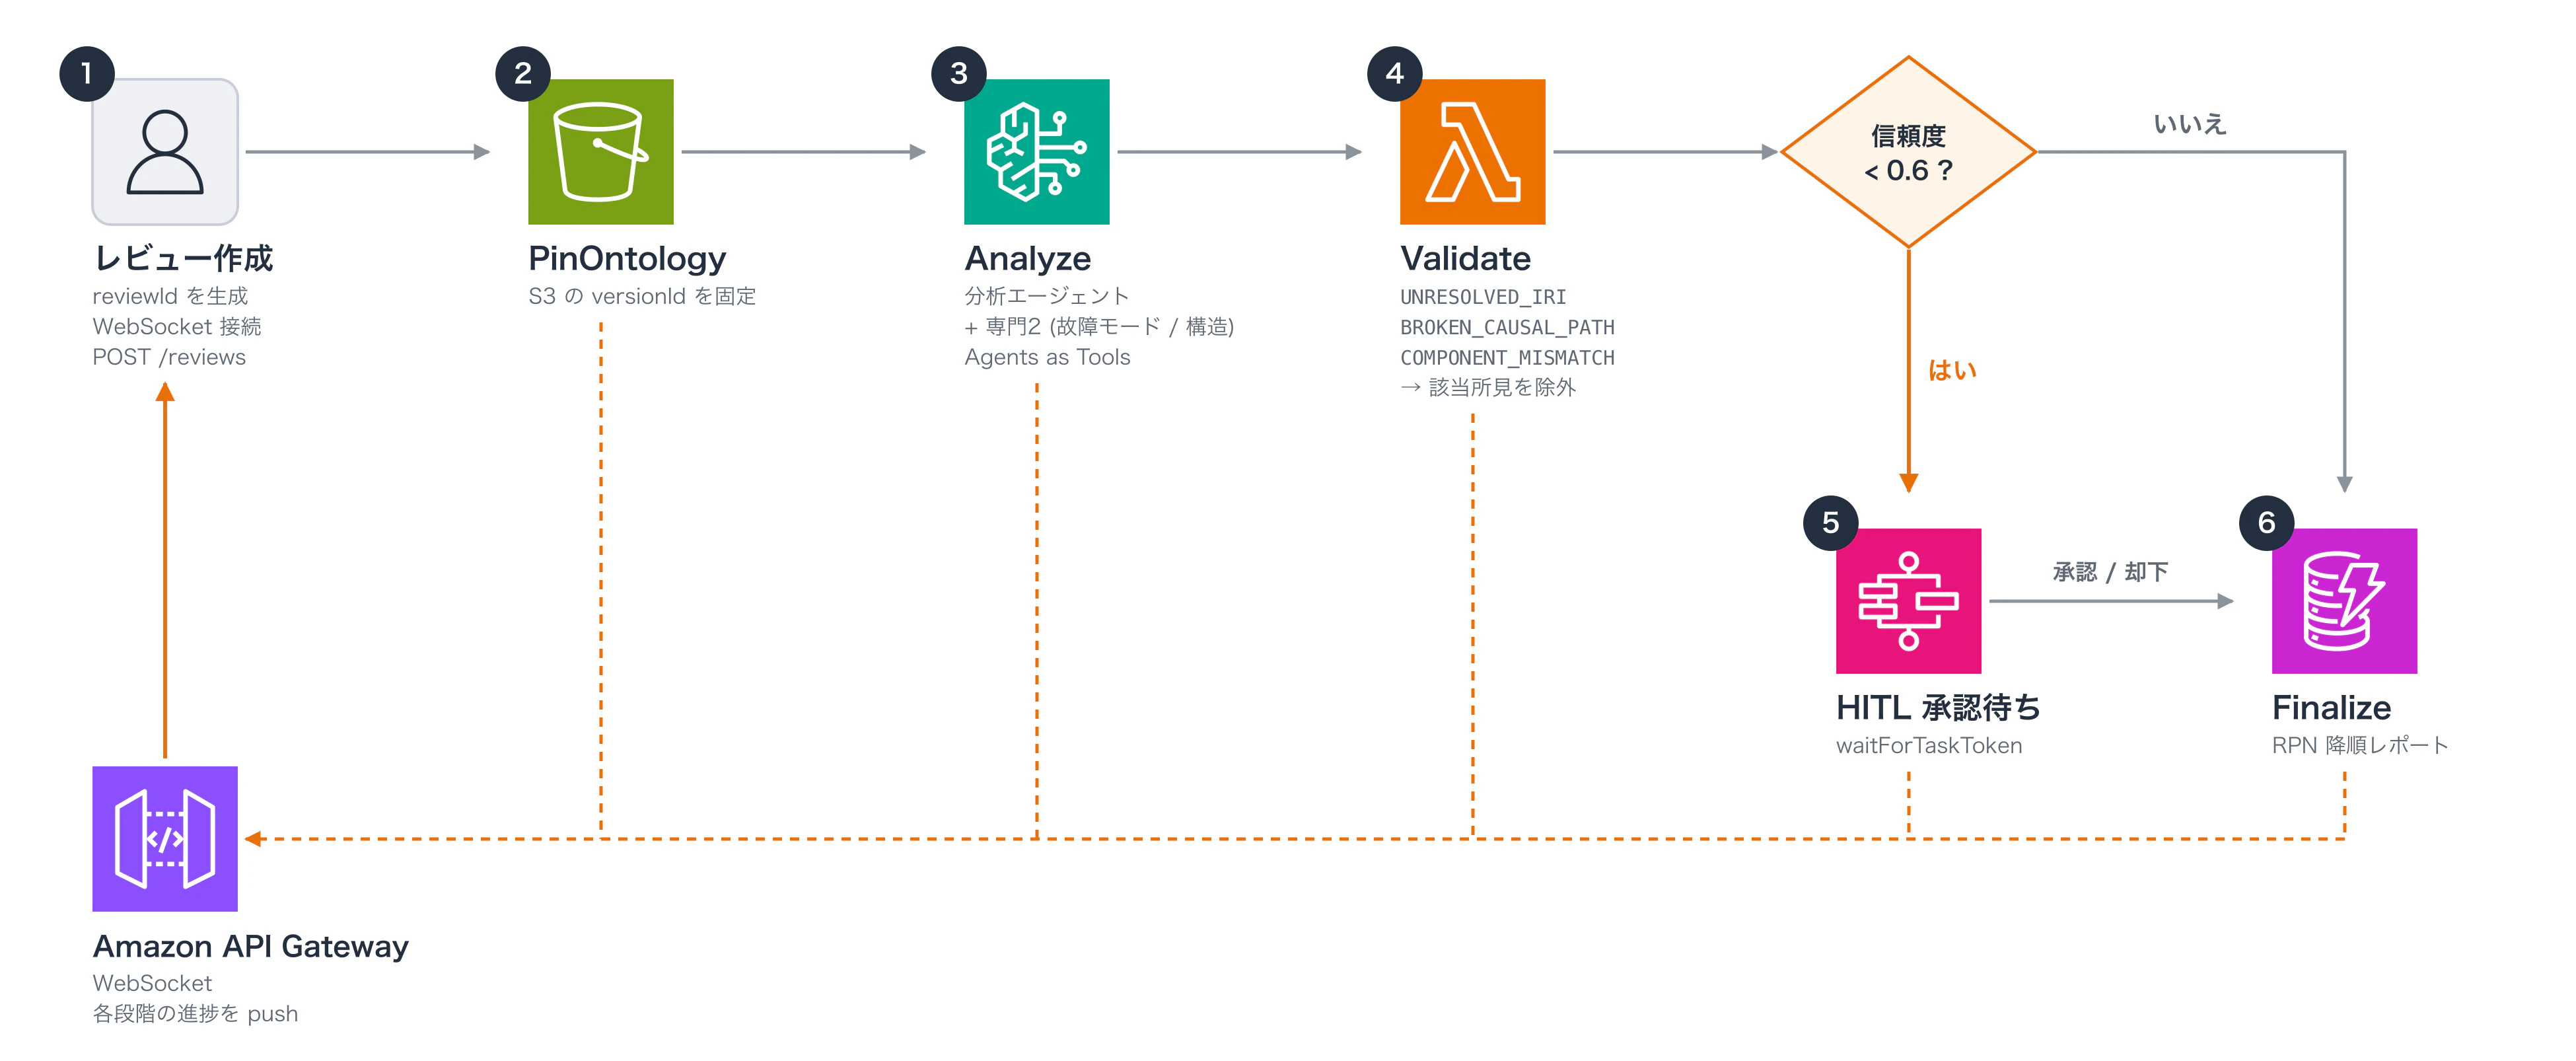
Step Functions(Standard)のステートは次の流れです。
- PinOntology: 使うオントロジーのバージョンを固定
- Analyze: エージェントが所見を生成
- Validate: オントロジーで所見を検証
- HitlGate: 信頼度0.6未満の所見があれば waitForTaskToken で最大24時間停止
- Finalize: レポートを確定
全タスクに Catch を付け、失敗時は NotifyFailure に流します。
省略した部分
- Amazon Textract、Amazon A2I、Amazon SageMaker、MLによる事前スクリーニング
- SQSによるA2A通信、四半期ごとの規格取り込み
- OpenSearch Serverless と Bedrock Knowledge Bases
- AWS Secrets Manager、AWS KMSカスタマー管理キー
オントロジーは約58ノードです。
22MnB5(ホットスタンプ用の鋼材)、ホットスタンプ、オーステナイト化→水素吸収→水素脆化→HAZ遅れ破壊→シートベルトアンカー引き抜け、スポット溶接の残留応力などを入れました。
デモ用に簡略化したもので、実データではありません。
オントロジー検証は LLM ではなくコードで判定する
元記事の「オントロジースレッド」を再現するために、Validate ステートでは LLM を使わず、コードで決定的に判定しています。
これをやる理由は以下の3種類です。
- UNRESOLVED_IRI: 所見のIRIが期待するクラス(部品、故障モード、影響、原因)に解決できない
- BROKEN_CAUSAL_PATH: 原因→故障モード→影響の隣接ペアに、オントロジー上の直接の辺がない
- COMPONENT_MISMATCH: その故障モードが、対象の部品で起きると定義されていない
判定の中心部分は次のとおりです(backend/src/dfmea/ontology/validate.py から抜粋)。
chain = cause_path + [fm, effect]
for i in range(len(chain) - 1):
    if not edge_ok(store, chain[i], chain[i + 1], first=(i == 0)):
        return _result("rejected", BROKEN_CAUSAL_PATH, f"no direct edge {chain[i]} -> {chain[i + 1]}")

if (URIRef(fm), DFM.occursAt, URIRef(comp)) not in store.graph:
    return _result("rejected", COMPONENT_MISMATCH, f"{fm} does not occurAt {comp}")
弾かれた所見は捨てずに、レポートの別枠に表示します。
実際に弾かれた例
動かしてみると、LLM の所見は実際に弾かれました。
- 因果パスに、オントロジー上に存在しない辺(InsufficientQuenchRate → HAZDelayedFracture)が含まれていた所見が BROKEN_CAUSAL_PATH で除外されました
- 中国語で実行したレビューでは、5件中3件が COMPONENT_MISMATCH で除外されました。別の部品で起きる故障モードを、対象部品の所見として出していました
LLM の出力をオントロジーの辺で機械的に照合するという元記事の考え方は、Neptune を使わない構成でも役割を果たしています。
バージョン固定を確かめる
元記事の version-pinning は、S3のバージョニングで再現しました。
PinOntology ステートで、その時点のTTLファイルの versionId と sha256 を DynamoDB に記録し、以降のステートは必ずその versionId を読みます。
head = aws.s3().head_object(Bucket=bucket, Key=key)
version_id = head["VersionId"]
store = OntologyStore.from_s3(aws.s3(), bucket, key, version_id)
確認は次の手順で行いました。
- オントロジー1.0.0でレビューを開始し、HITLゲートで止める
- 止まっている間に、S3上のTTLを新バージョン(1.1.0)に差し替える
- 承認してレビューを完了させる
- 新しいレビューを開始する
結果、止めていたレビューは1.0.0のまま完了し、次のレビューは1.1.0を使いました。
途中でオントロジーを更新しても、進行中のレビューの判定基準は変わりません。
4言語に対応する
日本語・英語・アラビア語(右から左に書くRTL)・中国語簡体字の4言語に対応しました。
対象は3つです。
- UI
- AI出力(根拠と推奨対策を、レビュー作成時に選んだ言語で生成)
- オントロジーのラベル
アラビア語と中国語の訳は、ネイティブの方に確認してもらっていません。
実測値
1回のレビューの実測値です。
- 分析: 42〜55秒
- エンドツーエンド: 約50〜74秒
- トークン数: 2.4万〜5.3万
- 中国語を指定した1回だけ、202秒かかりました
セキュリティ面の確認結果です。
- 未認証のREST・WebSocketは401
- 別ユーザーのレビューを取得すると404
テストは pytest が63件、CDK の jest が7件です。
まだ確かめていないこともあります。
- Throttling時のリトライと、HITLの24時間タイムアウトは単体テストのみで、実環境では試していません
- 1レビューあたりのドル建てコストは計測していません
冒頭の問いへの答え: アイドル時は約$7/月
冒頭で心配したコストに戻ります。軽量版を何もせず置いておいたときの費用は 約$7/月 です。
内訳は WAF の WebACL が$5、ルール2本が$2です。
それ以外はほぼゼロです。
- DynamoDB オンデマンド
- AWS Lambda、AWS Step Functions、Amazon API Gateway
- Amazon Cognito(Liteプラン)
- CloudFront・S3(少量)
元記事の構成では Neptune と OpenSearch Serverless(クラシック)の最小構成だけで月$240前後かかる見込みでした。
常時起動のリソースを外したことで、アイドル時の費用はほぼWAFの分だけになりました。
使うときだけ Bedrock のトークン代などの従量課金が乗ります。
削除手順
試し終わったら、CDKのスタックをまとめて削除します。
cd infra && npx cdk destroy DfmeaSiteDeploy DfmeaBackend DfmeaWeb DfmeaWaf
DynamoDB テーブル、S3 バケット、ロググループ、Cognito の User Pool はすべて削除される設定(RemovalPolicy.DESTROY)にしてあります。
最後まで読んでいただきありがとうございました。