
はじめに
AWSのブログで、GitHub ActionsからAgentCore Evaluationsを呼んでエージェントの品質ゲートを作る記事が出ていました。
実案件でも dev → stg → prd と環境を上げながらAgentCoreを使っているので、「昇格のタイミングで評価して、ダメなら止める」を dev と stg の2環境で試してみました。
やってみたところ、平均点だけで合否を決めると間違った回答が通ってしまったり、GitHub の設定次第で評価を通さずにマージできてしまったりと、いくつかハマりどころがあったので、その辺りも含めて書いていきます。
検証に使ったリポジトリはこちらです。
作った仕組み
エージェントを dev から stg へ上げるときに AgentCore Evaluations で採点して、点が低ければ stg へマージできないようにする仕組みです。エージェントは検証用の小さなものを使っています。
| 項目 | 内容 |
|---|---|
| エージェントの実行基盤 | Strands Agents + AgentCore Runtime(コンテナ) |
| モデル | jp.anthropic.claude-haiku-4-5-20251001-v1:0 |
| リージョン | 東京(ap-northeast-1) |
| IaC | CDK(TypeScript) |
| CI/CD | GitHub Actions(公開リポジトリなので無料)、AWS へは OIDC |
| 評価 | AgentCore Evaluations の on-demand 評価 |
AWS 側の構成はこんな感じです。
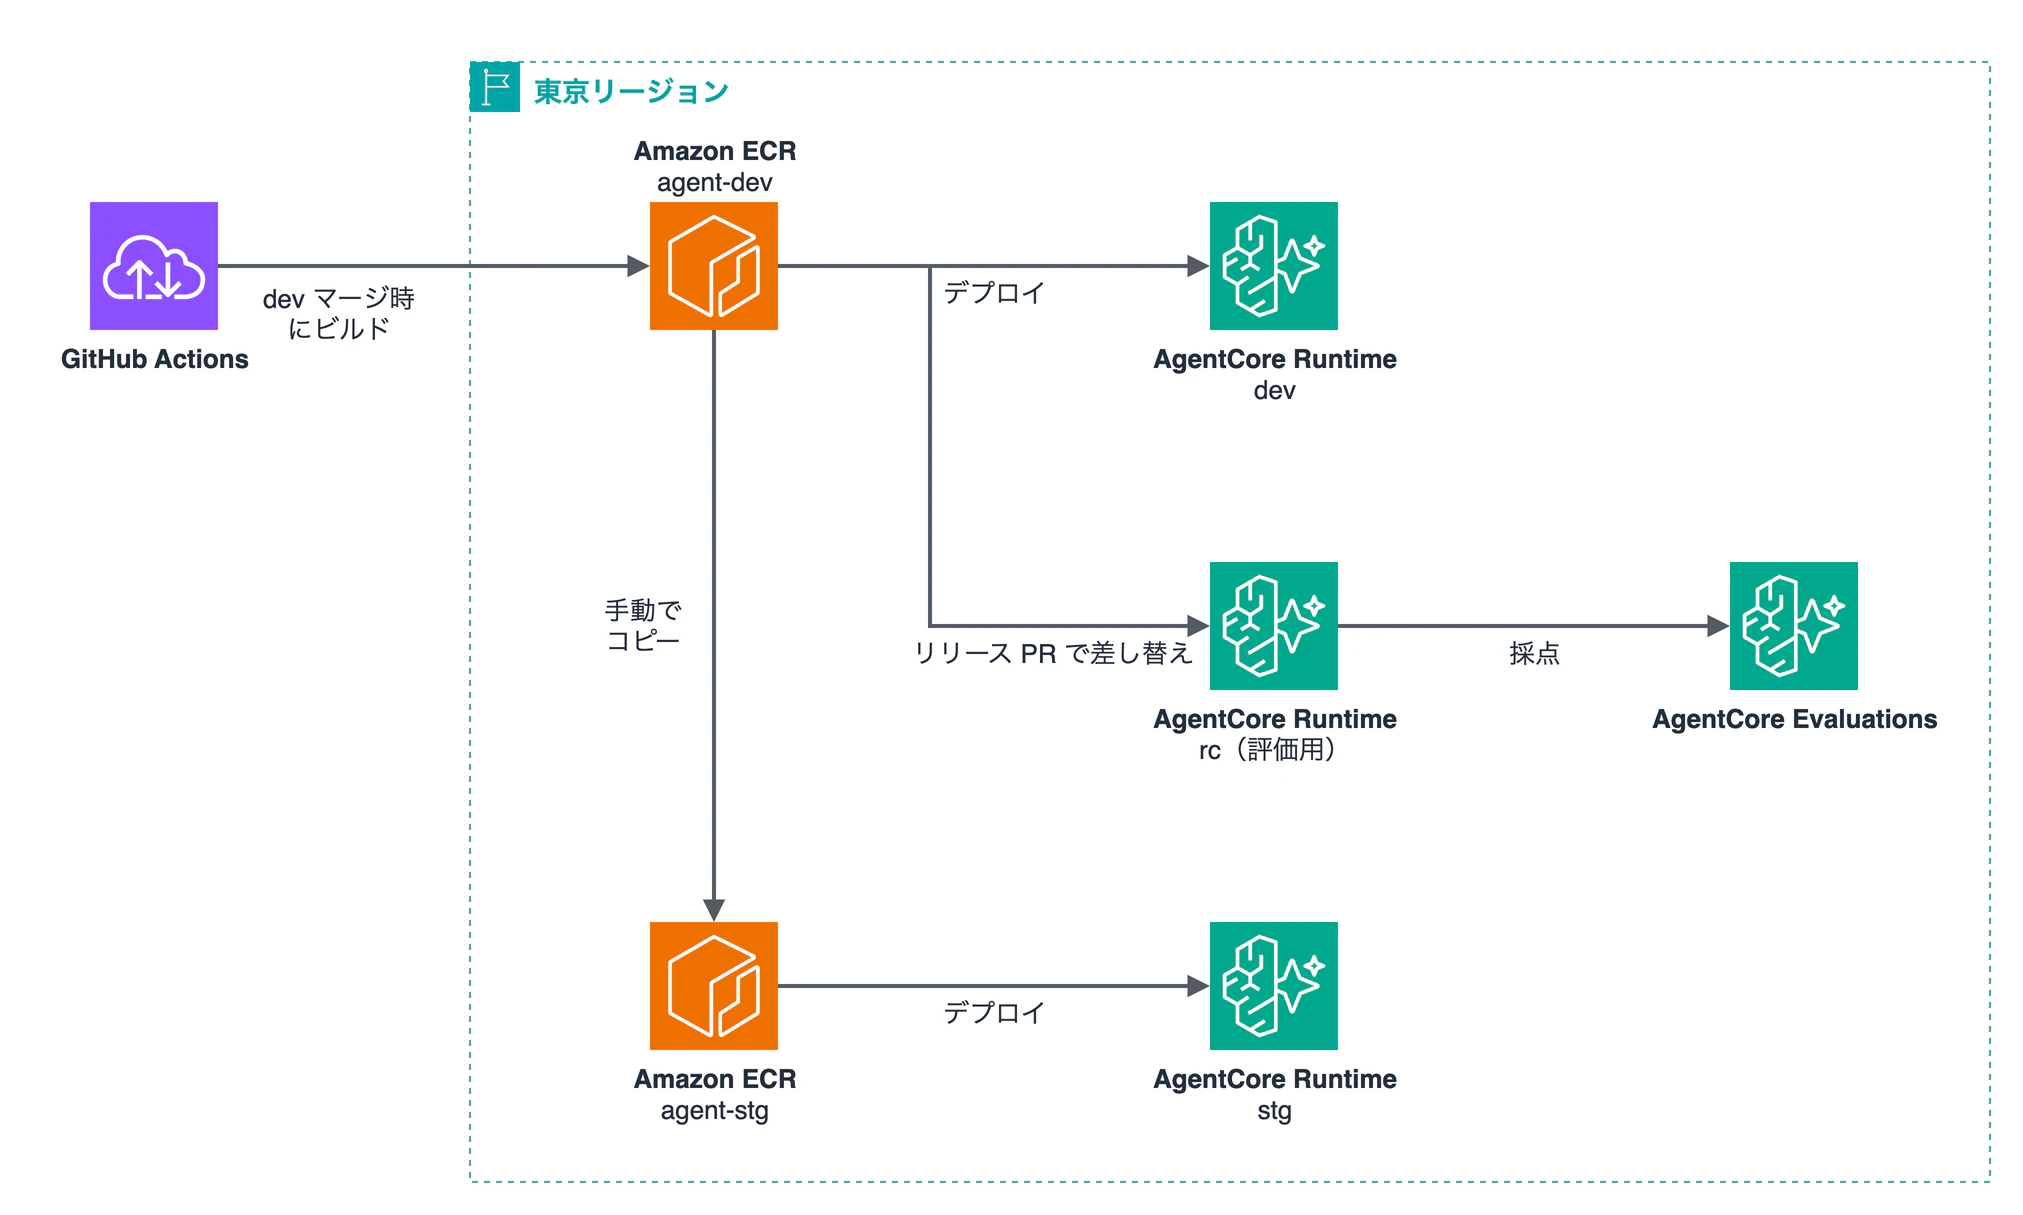
IAM ロールや Bedrock、CloudWatch は省いて、コンテナイメージの流れだけを描いています。
実案件では環境ごとにAWSアカウントを分けていますが、今回は1アカウントの中で ECR リポジトリ・Runtime・IAM ロールを環境ごとに分けて真似ています。
全体の流れ
| 契機 | 走るもの | 自動か |
|---|---|---|
| feature → dev の PR | lint・単体テスト・cdk synth・docker build
|
自動 |
| dev へのマージ | テスト → ビルド → dev へデプロイ | 自動 |
| release/* → stg の PR | rc Runtime にイメージを差し替えて評価。不合格ならマージ不可 | 自動 |
| stg へのデプロイ | 評価済みのイメージをコピーしてデプロイ | 手動 |
PRが大量に来たらどうするのか
ブログの構成はPRごとに評価を回す形です。ただ実案件だとPRはたくさん来るので、毎回10分待って、しかもLLMの判定が揺れて無関係に落ちる...となると、誰もゲートを信用しなくなりそうです。
そこでLLM評価は数の多い feature → dev では回さず、数の少ないリリースPRだけに載せることにしました。
さらに、dev から stg に直接PRを出すのではなく、dev のある時点を release/<日付> として切り出してからPRにしています。dev にPRを出す形だと、リリースPRを開いている間に dev へマージが入るたびに評価が走り直してしまうからです。release ブランチは切った時点で固定されるので、評価は1回で済みます。
イメージは一度だけビルドする
評価したものと stg に載るものが同じでないと、評価の意味がありません。そこでビルドは dev へのマージ時の1回だけにして、あとはそのイメージを運ぶ形にしました。
ポイントは ECR のタグです。コミットのSHAをタグにすると、release を切ったり stg にマージしたりするたびにSHAが変わって、どのイメージか分からなくなります。そこで agent/ フォルダの中身から決まるハッシュをタグにしました。
git rev-parse HEAD:agent
中身が同じなら、どのブランチ・どのコミットで計算しても同じ値になります。ECR はタグの上書きを禁止(IMMUTABLE)にしているので、同じタグが別物を指すこともありません。
| 段階 | イメージの置き場所 | 使う Runtime |
|---|---|---|
| dev へのマージ時にビルド | dev の ECR | dev |
| リリースPRで評価 | dev の ECR(そのまま参照) | rc |
| 手動で昇格 | dev の ECR → stg の ECR へ digest ごとコピー | stg |
stg への適用は、Actions の画面から手動で起動します。
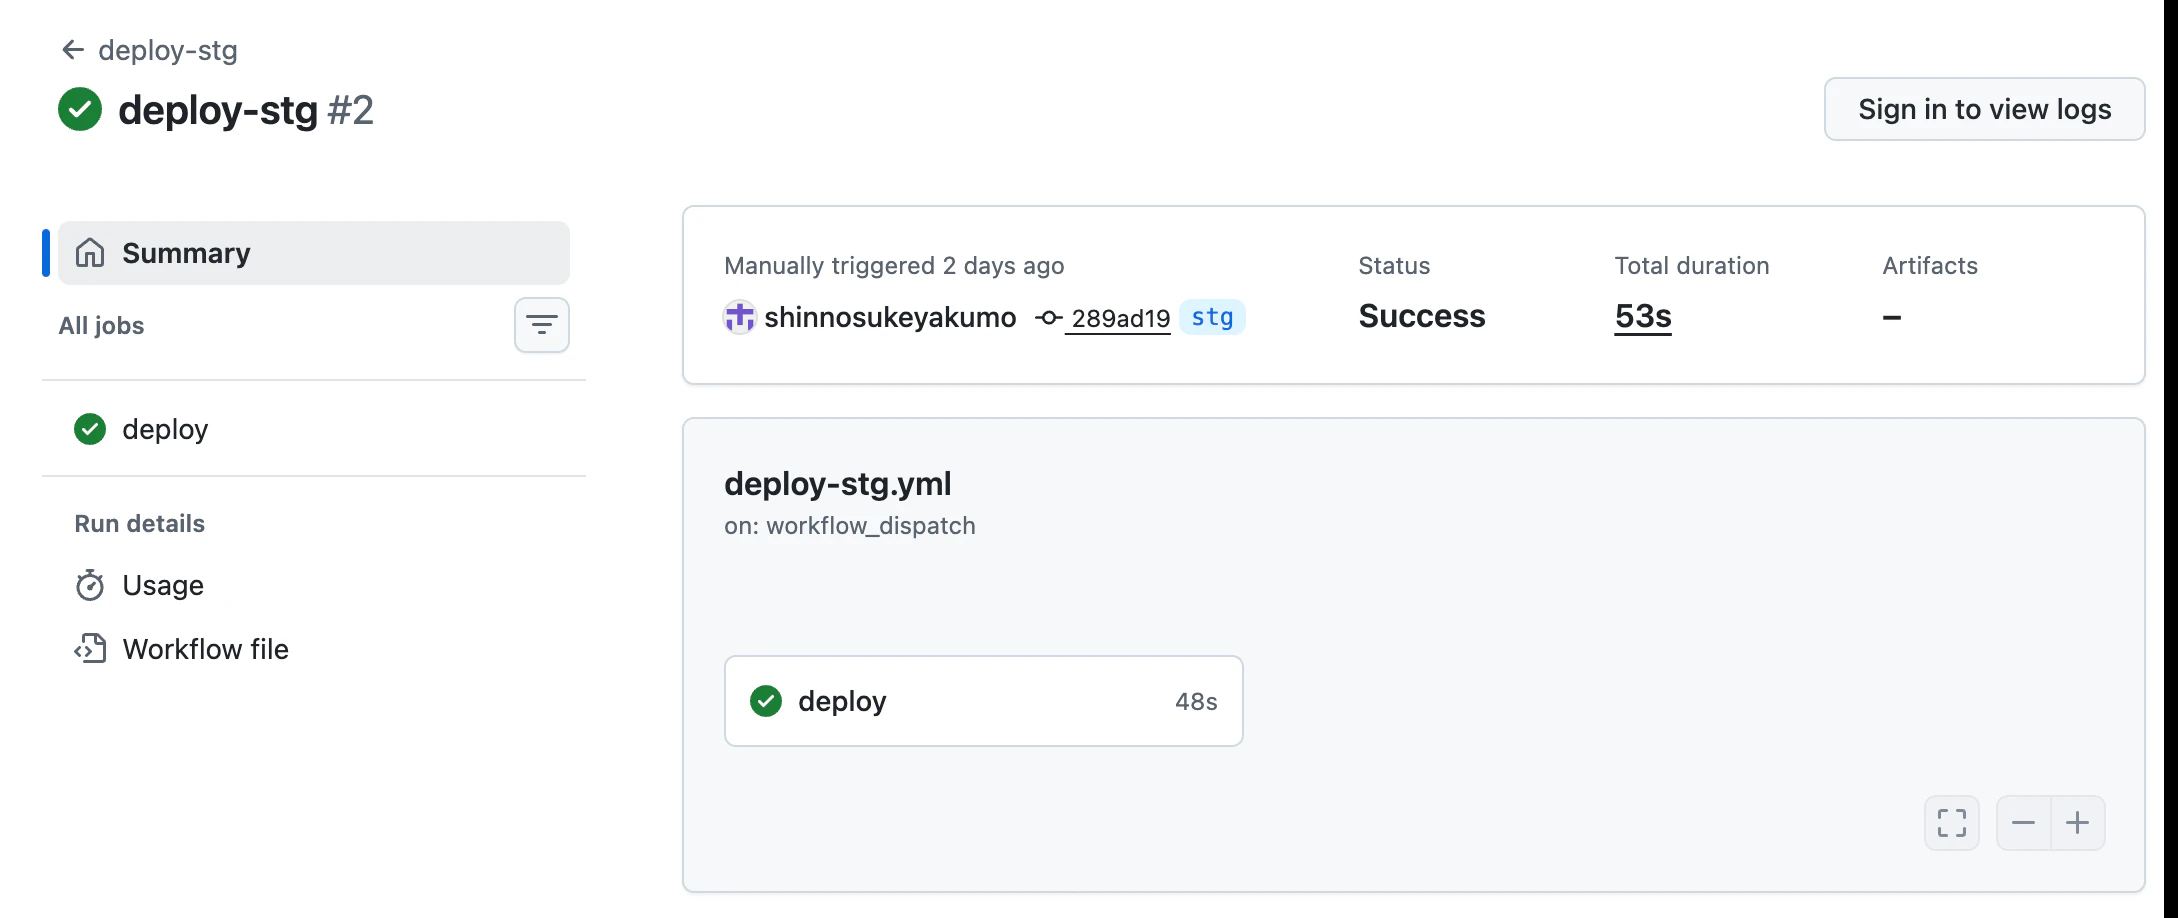
実際に stg へ上げたあと、dev と stg の ECR で digest が一致する(sha256:7288f3…)ことを確認できました。
やってみる
評価スクリプト
評価は bedrock-agentcore SDK(1.24.1)の EvaluationClient.run を使っています。1問1セッションでエージェントを呼び、スパンが CloudWatch に届くのを待ってから、正解(expected_response と expected_trajectory)付きで採点します。
ref = ReferenceInputs(
    expected_response=case.get("expected_response"),
    expected_trajectory=case.get("expected_trajectory"),
)
results = client.run(
    evaluator_ids=evaluators,
    session_id=session_id,
    agent_id=runtime_id,
    reference_inputs=ref,
)
評価器は、ブログと同じ4つに TrajectoryInOrderMatch を足した5つです。TrajectoryInOrderMatch はLLMを使わずに「期待した順にツールを呼んだか」をプログラムで判定するので、揺れません。
| 評価器 | 見ているもの | 判定 |
|---|---|---|
| GoalSuccessRate | ユーザーの目的を果たせたか | LLM |
| Correctness | 正解と核心が一致するか | LLM |
| ToolSelectionAccuracy | ツールの選び方 | LLM |
| ToolParameterAccuracy | ツールに渡した引数 | LLM |
| TrajectoryInOrderMatch | 期待した順にツールを呼んだか | プログラム |
評価用の問いは、ツール(検索・在庫確認・送料計算)を呼んで答える問いが7問と、範囲外の問いが1問の計8問です。どれも正解を用意しておき、それぞれ3回ずつ、計24セッションを流します。
評価用の rc Runtime を差し替える
リリースPRの評価は、評価専用の rc Runtime にリリース候補のイメージを差し替えてから行います。ここは cdk deploy ではなく、AgentCore の UpdateAgentRuntime API でイメージだけを替えています。
cdk deploy を使うと、GitHub Actions の評価用ロールに CDK のロール(どのスタックでもデプロイできる強いロール)を渡すことになるからです。APIなら、権限を「rc Runtime の更新」と「rc の実行ロールの PassRole」だけに絞れます。
control.update_agent_runtime(
    agentRuntimeId=runtime_id,
    agentRuntimeArtifact={"containerConfiguration": {"containerUri": new_uri}},
    **{k: current[k] for k in CARRY_OVER if current.get(k) is not None},
)
UpdateAgentRuntime はイメージ以外の設定(実行ロール・ネットワーク・環境変数など)も全部渡し直す必要があるので、今の設定を取得してそのまま渡しています。
eval-gate のワークフロー
on:
  pull_request:
    branches: [stg]

concurrency:
  group: rc-runtime
  cancel-in-progress: false

jobs:
  evaluate:
    steps:
      - name: release/* からの PR か確かめる
        run: |
          if [ "$HEAD_REPO" != "$GITHUB_REPOSITORY" ] || [[ "$HEAD_REF" != release/* ]]; then
            echo "::error::stg へは release/* からの PR だけを受け付ける"
            exit 1
          fi
      # ... OIDC で評価用ロールを引き受ける
      - run: uv run python eval/deploy_rc.py --image-tag ${{ steps.tag.outputs.tag }}
      - run: uv run python eval/run_eval.py --runtime-name michikusa_rc --expected-image-tag ${{ steps.tag.outputs.tag }}
最初のステップでは、release/* ブランチからのPRかどうかを確かめています(理由はハマったポイントの節に書きました)。
結果はPRにコメントされます。
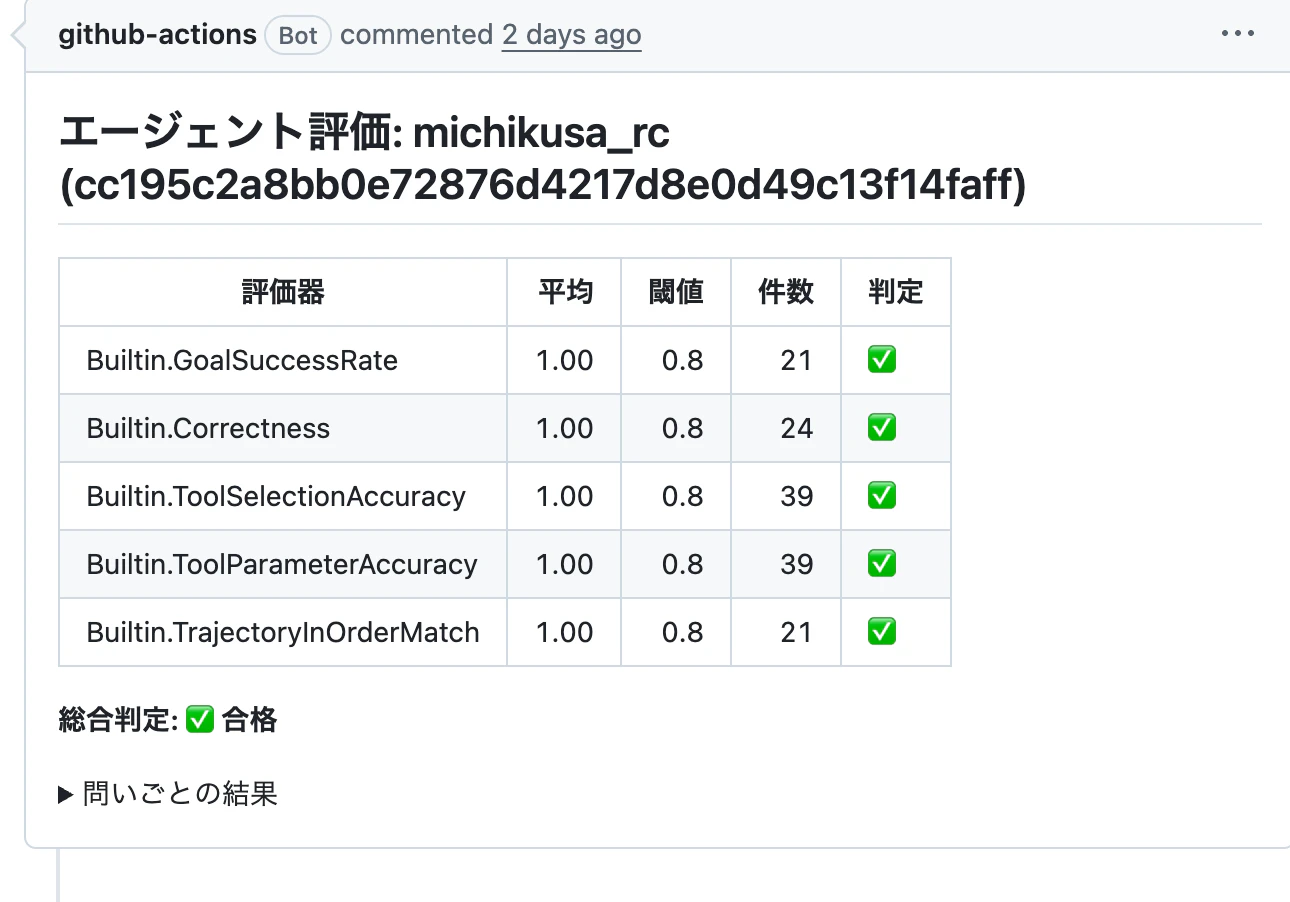
わざと劣化させて試してみる
仕組みが本当に劣化を止められるかを確かめるため、わざとエージェントを壊して流してみました。結果を見る前に、どうなるかの予測を書いておいています。
1巡目:平均点で判定してみる
最初は、ブログと同じように評価器ごとの平均が0.8以上なら合格、という判定にしていました。
ちなみにブログのサンプルコードは、評価器ごとに最高点で判定していたので、そこは平均に変えています。最高点だと、悪い回答が混ざっても隠れてしまうからです。
| 実験 | 壊した内容 | 予測 | 結果 |
|---|---|---|---|
| 変更なし(3回) | なし | 合格 | 3回とも合格 |
| R1 | 北海道・沖縄の送料を1,200円 → 500円に | すり抜ける | すり抜けた |
| R2 | プロンプトから「必ずツールで確かめる」を消す | 止まる | 振る舞いが変わらず |
| R3 | 在庫ツールの説明を「価格を調べる」に書き換える | 止まる | 振る舞いが変わらず |
R1 は予測どおりすり抜けました。北海道への送料を聞く1問だけが3回とも誤答(Correctness 0)になったのですが、24件中3件の失点なので Correctness の平均は0.875。閾値0.8を超えてしまいます。
1,980円の本を北海道に送る場合、送料は500円です。合計金額は2,480円となります。
送料を700円少なく案内するのは業務上かなりまずいのですが、平均には埋もれてしまうんですよね...
R2 と R3 は、Haiku 4.5 がツールの名前や戻り値から推測して正しく動いてしまい、そもそも回答が変わりませんでした。劣化を仕込むなら、回答が実際に変わることを先に確かめておく必要がありますね。
判定を直す
1巡目を受けて、判定に3つ足しました。
| 対策 | 中身 |
|---|---|
| 重要な問いの最低ライン | 送料・在庫などの重要な問いは、1試行でも Correctness が1.0未満なら不合格 |
| 範囲外の問いを外す | 範囲外の問いは GoalSuccessRate の対象から外す(理由は後述) |
| 採点不能を分ける | スパンが揃わず採点できなかったものは「不合格」ではなく「採点不能」として別扱い |
def critical_violations(runs, critical):
    out = []
    for run in runs:
        if not run.case.get("critical"):
            continue
        for r in run.results:
            floor = critical.get(r["evaluatorId"])
            if floor is not None and r.get("value") is not None and r["value"] < floor:
                out.append(f"{run.case['id']}#{run.trial} {r['evaluatorId']}={r['value']:.2f}")
    return out
2巡目:リリースブランチ+rc Runtime で試す
| # | 試したこと | 結果 | 所要 |
|---|---|---|---|
| V1 | 送料1問の誤り(R1と同じ) | 不合格で止めた | 4分57秒 |
| V2 | 正常なリリース → マージ → 手動で stg | 合格、digest も一致 | 4分52秒 |
| V3 | リリースPRを開いたまま dev にマージ | 評価は走り直さなかった | - |
| V4 | dev から stg へ直接PR | 評価の前に失敗、マージ不可 | - |
| V5 | 送料ツールをエージェントから外す | 不合格で止めた | 13分18秒 |
| V6 | 正常なリリース(rc を戻す) | 合格、rc は11秒で差し替わった | 4分22秒 |
前回すり抜けた送料の誤りも、重要な問いの最低ラインで止まるようになりました。
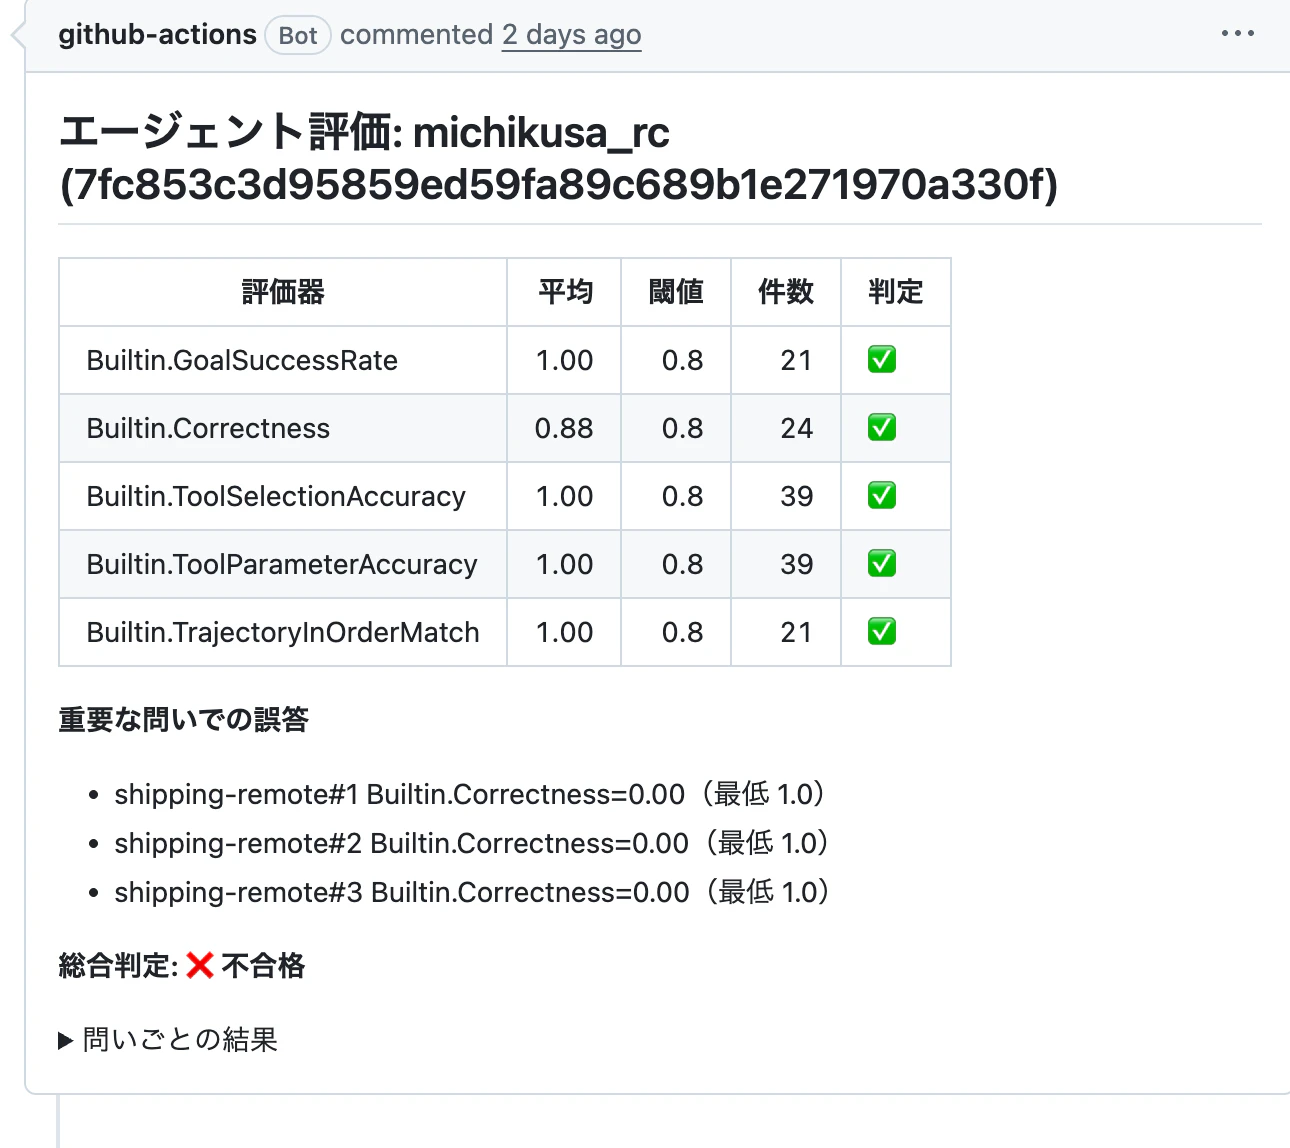
Correctness の平均は0.88で閾値を超えているのに、重要な問いの最低ラインに掛かって不合格になっています。
ハマったポイント
必須チェックは skipped を合格として扱う
最初は eval-gate のジョブに if: を付けて、release/* からのPRのときだけ評価するようにしていました。
jobs:
  evaluate:
    if: startsWith(github.head_ref, 'release/')
ところが条件に合わないPRではジョブが skipped になり、GitHub のブランチ保護の必須チェックは skipped を合格として扱います。つまり dev から stg へ直接PRを出すと、評価を通らずにマージできてしまう状態でした。
ジョブには if: を付けず、最初のステップで条件外を exit 1 で明示的に失敗させる形に直しています。V4 で dev から stg へ直接PRを出したところ、評価に入る前に止まりました。
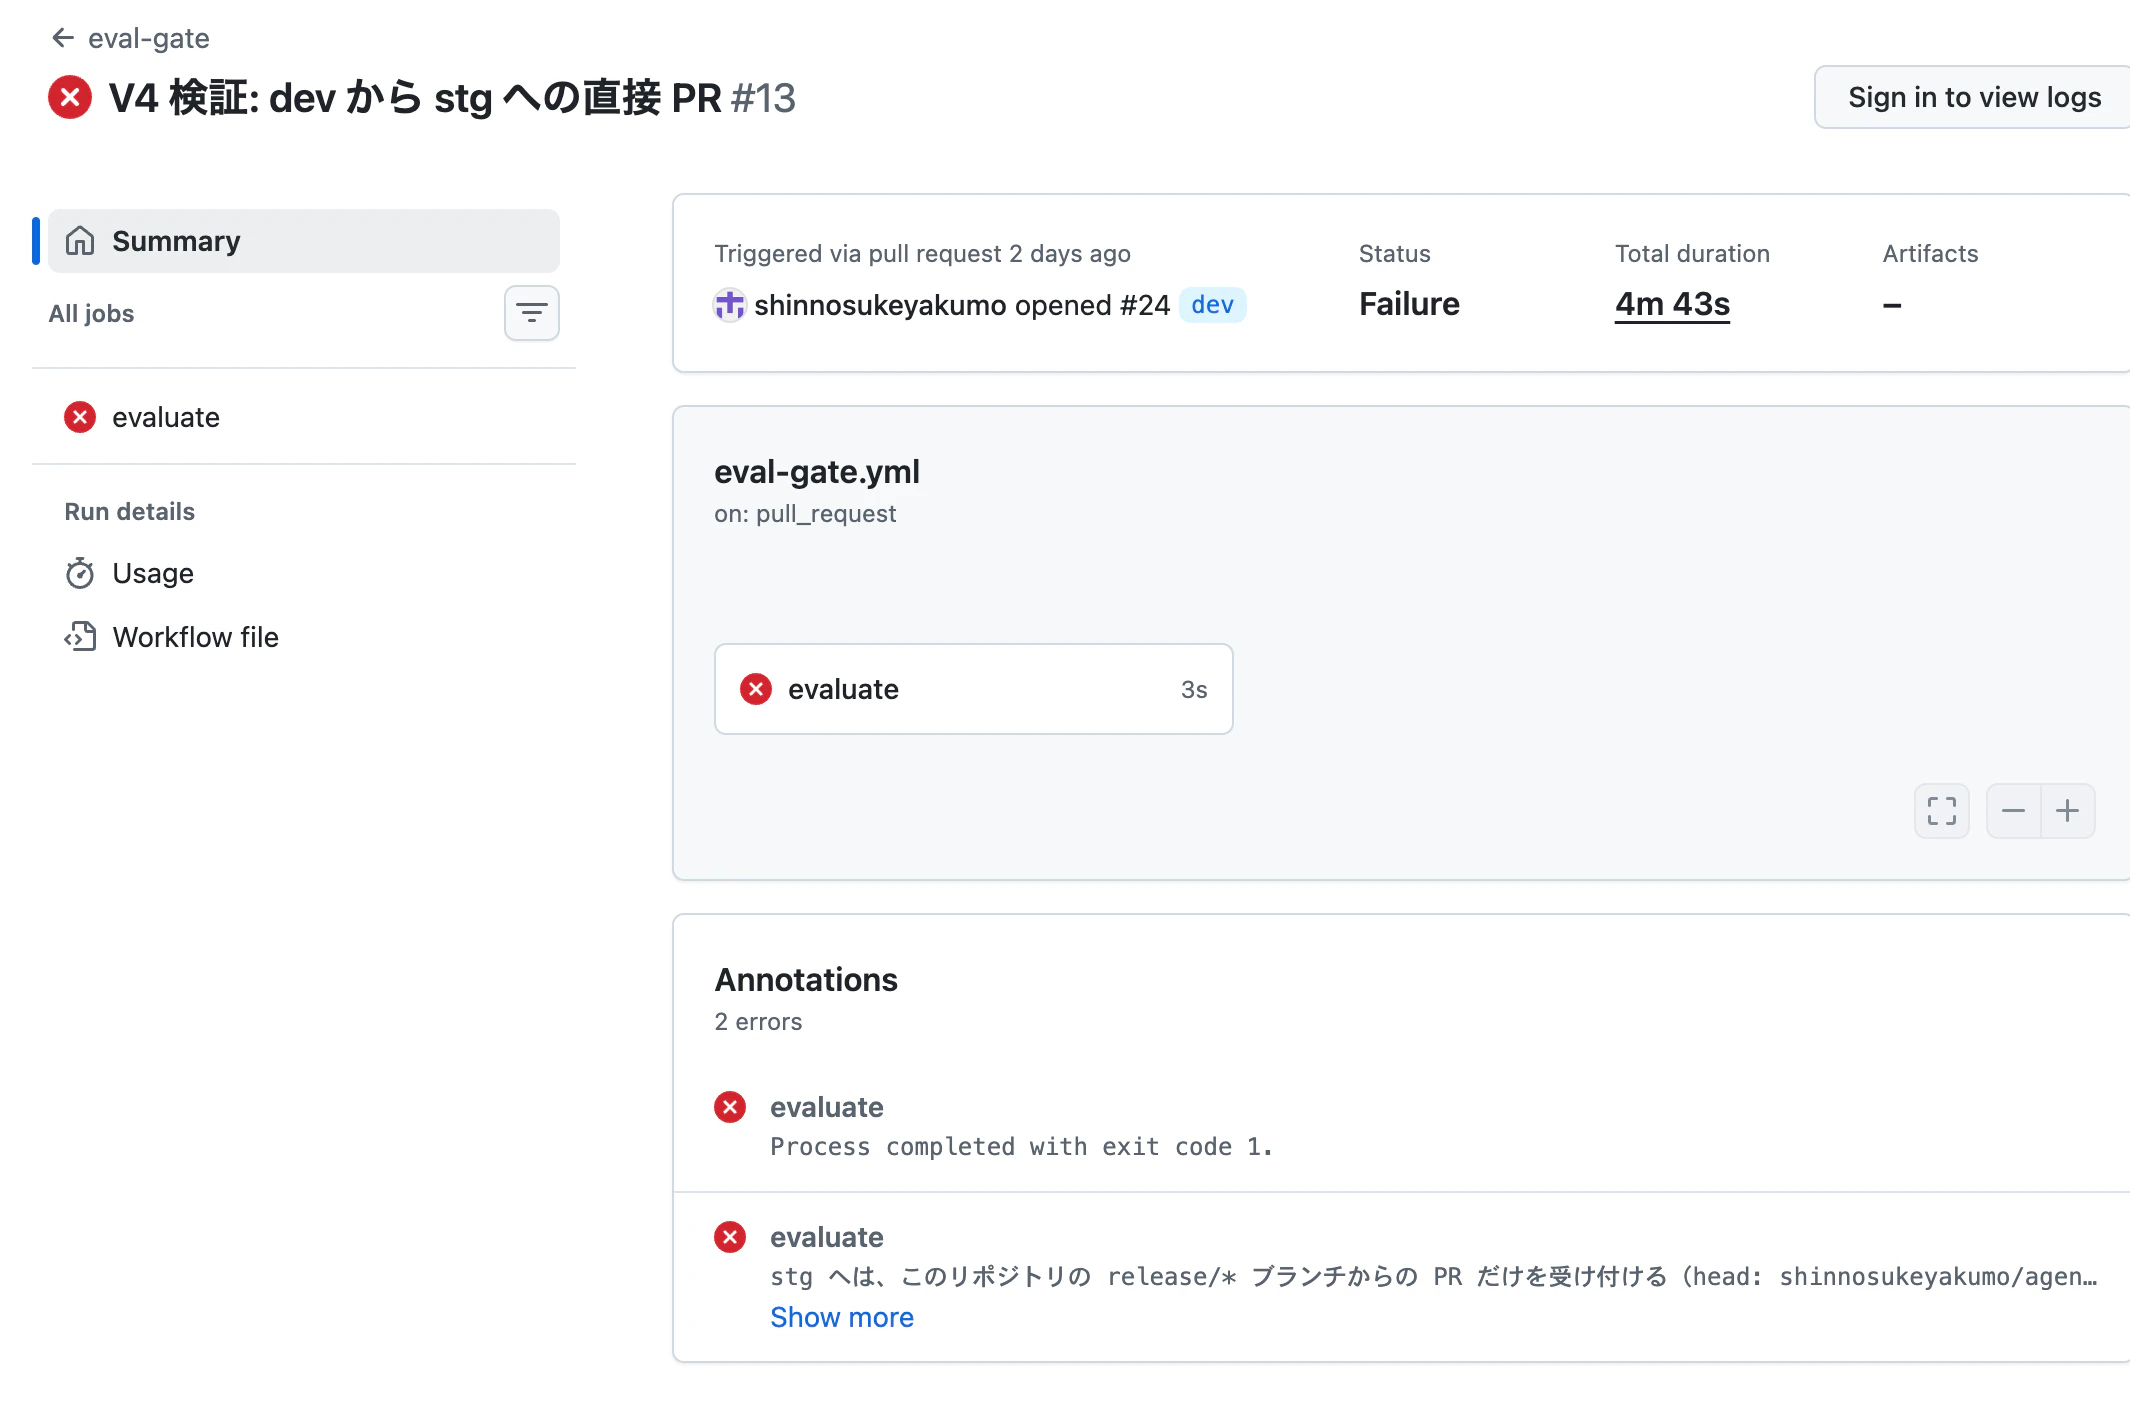
ジョブ自体は3秒で落ちていますが、全体で4分43秒かかっているのは、rc Runtime を使う評価が終わるのを待っていたからです。
スパンが届く前に採点するとエラーになる
1巡目の R2・R3 は、最初は評価で落ちたように見えていたのですが、ログを見ると採点の前にエラーで落ちていただけでした。
ValidationException: Provided input contains 6 log event(s) but no span documents.
ValidationException: Provided input has no spans to evaluate.
スパンが CloudWatch に届ききる前に Evaluate を呼ぶと、この2種類のエラーが返ります。ログイベントだけ先に届いた場合と、スパンが一部だけ届いた場合です。
このエラーは「取り込み待ち」として再試行するようにしました。それでも揃わない場合は、点が低くて落ちた場合と区別できるように「採点不能」として扱っています。
GoalSuccessRate は答えの正しさを見ていない
範囲外の質問(「ポイントカードはありますか?」)に正しく「分かりかねます」と答えた回答を、GoalSuccessRate は 18試行中14回0点にしました。ユーザーの目的は果たせていない、という判定です。
一方で、R1 の誤った送料案内は 3回とも満点でした。
| 回答 | 正誤 | GoalSuccessRate |
|---|---|---|
| 送料500円 | 誤り | 3回とも満点 |
| ポイントカードは分かりかねます | 正しい(拒否) | 18回中14回0点 |
名前から「タスクの成功率」っぽく見えますが、実際は「ユーザーが満足しそうか」に近いものを測っています。範囲外の問いを含めると点数がこの問いの揺れに引っ張られる(0.88〜0.96)ので、2巡目では対象から外しました。外したあとは、正常な版の回(V2・V6)で1.00に揃いました。
ツールを呼ばないとツール系の評価器は結果を返さない
送料ツールを外した V5 では、ゲートに24分かかりました。
エージェントがツールを1回も呼ばないと、ToolSelectionAccuracy と ToolParameterAccuracy は結果を返しません(SDK は No tool span IDs found を出してスキップします)。完了待ちの条件にツール系を入れていたので、永遠に揃わない結果を待ち続けていました。ツールを呼ばないこと自体は Trajectory 系の評価器で拾えるので、完了条件からは外しています。
GitHub OIDC の sub が ID 入りになっていた
GitHub Actions から AWS のロールを引き受けるところで、Not authorized to perform sts:AssumeRoleWithWebIdentity になりました。
新しく作ったリポジトリは、OIDC トークンの sub が ID入りの形式になっていました。
gh api repos/<owner>/<repo>/actions/oidc/customization/sub
# {"use_default":true,"use_immutable_subject":true,"sub_claim_prefix":"repo:owner@123/repo@456"}
信頼ポリシーを従来の repo:owner/repo:... で書いていたので一致しなかったわけです。ID入りのほうが、同じ名前でリポジトリを作り直されても信頼しないので安全です。
時間と費用
| 項目 | 値 |
|---|---|
| feature → dev のテスト | 約30秒 |
| dev へのデプロイ(テスト込み) | 1分20秒〜4分 |
| eval-gate(8問×3回) | ふだん4〜5分、取り込み遅れで最大13分 |
| rc の差し替え | 約11秒 |
費用は、Cost Explorer の2026-10-11時点の表示で、東京リージョンの Claude Haiku 4.5 が10/8に1.56ドル、10/9に0.74ドルでした。ゲートを十数回回した2日間の分です。Amazon Bedrock AgentCore の行は0ドルと表示されていて、Evaluations の課金がどう計上されるかはまだ確認できていません。料金表から試算すると、組み込み評価器の採点はゲート1回で1〜2ドル程度になりそうです。
さいごに
GitHub Actions と AgentCore Evaluations で、評価に通ったものだけを stg に上げる仕組みは作れました。リリースPRだけで評価を回し、評価したイメージをそのまま stg に運ぶ形にすれば、PRが大量に来ても評価の回数は増えません。
ただ、評価器ごとの平均だけで合否を決めると、送料の問いのように1問だけ間違えた場合は平均に埋もれて通ってしまいます。重要な問いには問いごとの最低ラインを持たせるのと、評価器は名前ではなく何を測っているかを確かめてから使うのが大事だと感じました。
宣伝
その1
新潟支部ではオンラインのLT会を11月に開催します!
ぜひ参加ください!
その2
技術書展で本書きます!
こちらもぜひ!

参考