
はじめに
こんにちは。KDDIアジャイル開発センターの溝渕です。
ここ 2 か月ほど、Claude Code での個人開発を進めながら、精度を極力下げずにトークンの消費を抑える仕組みづくりと効果の計測に挑戦してました。
8月の約 1 か月の計測で、かなりトークン消費を抑える効果が得られたので、どういう仕組みで実現したのか紹介したいと思います。
この記事で分かること
- 常駐コンテキストを仕組みで抑える方法
- CLAUDE.md など毎回読み込まれる場所に置くのを避けつつ、必要な時に読む仕組みを組み上げる方法
- メモリの常駐分を索引 1 行に絞る手法
0. 前提情報
- Claude Code は定額プラン、プロンプトキャッシュは 1 時間 TTL
- 使用している推定値は、8月末時点のトークン集計(期間 2026-07-23〜08-27 の 36 日・238 セッション)で、ファイルの文字量からトークン数へ換算したもの(おおむね 1 字 ≒ 0.5 トークンの換算に相当)。
- 実測値は8月の usage 値(再読倍率 50.8 倍・キャッシュ読み出し 65.5%・34,125 リクエスト)。
- この記事において、以下用語が何を指すか
- 置いてある知識: プロジェクトに書き溜めた知識(設計・運用文書 + メモリの中身 + Skills の中身)
- 常駐コンテキスト: 毎回の応答に必ず読み込まれる量
1. 何に困っていたのか
- CLAUDE.md がルールで肥大化し、毎回読み直すコストがトークン消費を増やしていた。
Claude Code は、会話のたびにそれまでのコンテキストを丸ごと送り直します。
プロンプトキャッシュが効くので読み直しの単価は通常の 0.1 倍ですが、ゼロではありません。
必要なものが読み直されるのは仕方ないにしても、常に使うわけでもないルールまで読み直されることを避けたかったのです。
読み直される量 = コンテキストに入っている量 × その後のリクエスト数
常駐コンテキストは最初に読み込まれているため、その後の全セッションの全リクエストで読み直されてしまいます。
私のプロジェクトの実測では、1 か月のリクエストが 34,125 回、コンテキストに入れた 1 トークンは平均 50.8 回読み直され、キャッシュからの読み直しがコスト全体の 65.5% を占めていました。
※コストは以下項目について、単価比で重み付けしたトークン量で比較しています。
- input
- キャッシュ書き込み
- キャッシュ読み出し
- output
つまり常駐コンテキストは、1 トークン削るだけで月 3 万回以上の読み直しがまるごと無くなる、削り甲斐が最も大きい場所です。
問題は、だからと言って何を削ればいいのかという点です。
ルールが日常的に増えている状況でした。
設計判断の手順、文書の置き場所、テスト記録の書き方、ワークフローの処理と確認手順……と、決めごとが増えるたびに CLAUDE.md へ書くことで、そのルールを使わないセッションでも毎回読み直されます。
以前は、起動時に約 10K トークンを読み込む外部フレームワークも入れていました。
後で集計したところ、設計・運用文書 440 万字にもなっていました。
2. どう解決しようと考えたのか
一言でいうと、必要な情報を、必要になった時だけ読み込む を実現できないかと考えました。
そのために、いつ、どのファイルを読むのかという索引を常駐コンテキストとし、必要な場面が来た時だけ読み込むようにしてみました。
何をきっかけに読むかは、場所ごとに次のとおりです。
| 場所 | 読むきっかけ | どう読まれるか |
|---|---|---|
| CLAUDE.md のトリガー表 | 作業の種類(例: メモリへ書こうとしたとき) | 表の行に当てはまる作業を始めたら、その行が指すルールファイルを開く |
| 実装知識の索引 | 会話や作業に出てきたキーワード(例: 翻訳・多言語) | 索引でキーワードが一致した行のファイルを開く |
| メモリの索引 | 「いつ使うか」の条件(例: ステージングするとき) | 条件に当てはまったら、リンク先のメモを開く |
| Skills | 説明文と、依頼の内容 | 依頼が説明文に合う Skills の中身を読み込む(/名前 で直接呼ぶこともできる) |
※どれもプログラムがキーワードを照合しているわけではありません。
毎回読み込まれる索引の条件を Claude が読み、今の作業が当てはまると判断した時にファイルを開きます。
改善後、1 か月の計測でわかったこと
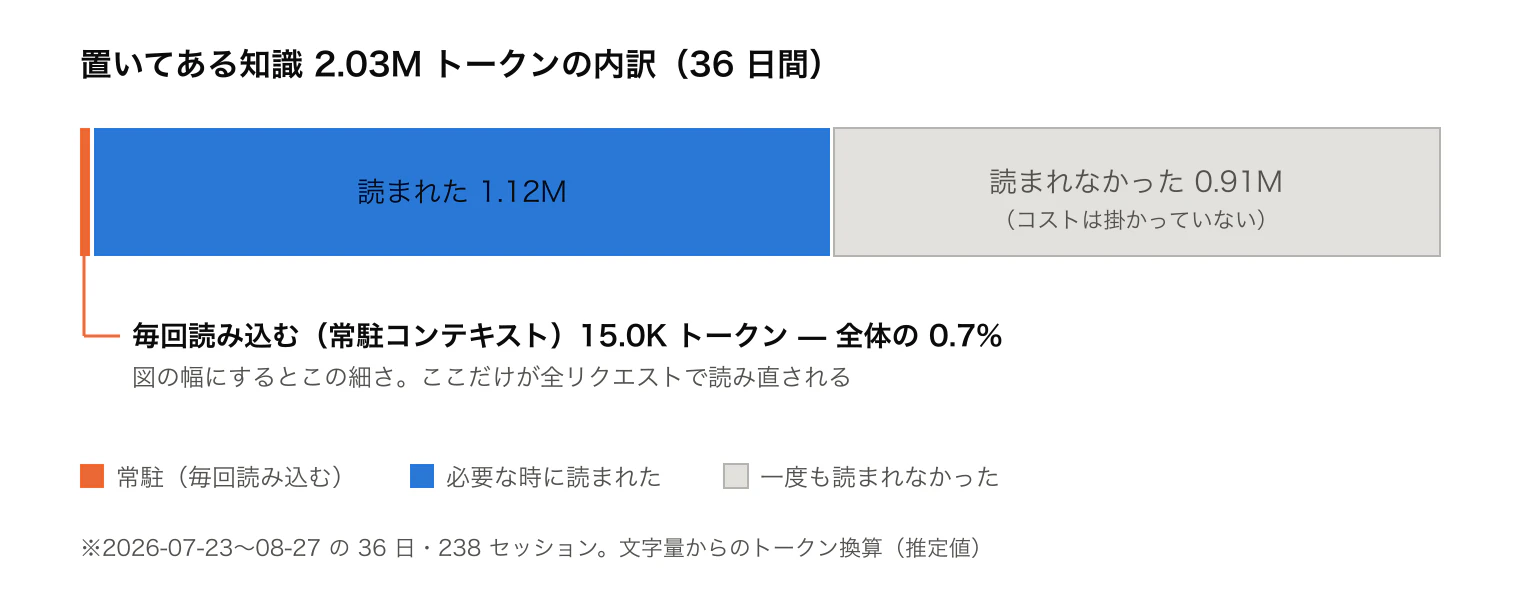
約半分は一度も読まれていませんが、その分のコストは掛かっていません。
改善前は、常駐コンテキストだったため、使われないのに毎回読み込まれている=トークン消費、コスト増大に繋がっていました。
以下は 1 例になります。
改善前(詳細ルールを CLAUDE.md に全文書いていた頃):
## メモリの書き方
- 学びが出た瞬間に書く。作業の締めへ先送りしない。
- それを生んだ実装コミットに同梱する。索引行も同じコミットに入れる。
- 単独でコミットしてよいのは、対応する作業コミットが無いときだけ。
- (以下、背景・例外・効き目の測り方が続く)
改善後(トリガー表 + 基本ルールだけを残す):
## メモリの書き方
**詳細ルール**: `docs/Rules/Memory_Rules.md`(必要な時だけ読み込む)

| トリガー | 読み込みタイミング |
|---------|-------------------|
| メモリへ書こうとしたとき | 自動読み込み |

**基本ルール**: 学びが出た瞬間に書く / 実装コミットに同梱する
必要な時だけ読み込む置いてある知識も、読み込んだ瞬間はファイルのサイズがそのまま掛かります。
1 ファイルが太ると、常駐コンテキストに置いていなくても高くつきます(後述のどこでつまずいたのかで説明します)。
節約できた料金の概算(参考値)
CLAUDE.md をトリガー表に分けたことで、常駐コンテキストは 36.4K → 15.0K トークンに減りました。この差分(21.4K トークン)を、モデル別の使用比率で配分して毎月の金額に換算してみました。
| モデル | 使用率 | 使用トークン(改善後) | 使用トークン(改善しなかった場合) |
|---|---|---|---|
| Opus | 81.0% | 4,186 万 | 1 億 158 万 |
| Fable | 14.8% | 764 万 | 1,854 万 |
| Sonnet | 4.2% | 216 万 | 523 万 |
| 合計 | 100% | 5,165 万 | 1 億 2,535 万 |
(表の「使用トークン」はキャッシュ読出・書込の単価差を織り込んだ入力換算トークン。1 か月ぶんの見積もり)
| モデル | 金額(改善後) | 金額(改善しなかった場合) | 差額(節約額) |
|---|---|---|---|
| Opus | $209.3(¥32,441) | $507.9(¥78,723) | $298.6(¥46,282) |
| Fable | $76.4(¥11,839) | $185.4(¥28,730) | $109.0(¥16,891) |
| Sonnet | $4.3(¥668) | $10.5(¥1,622) | $6.1(¥953) |
| 合計 | $290.0(¥44,948) | $703.7(¥109,075) | $413.7(¥64,126) |
結論: CLAUDE.md を分けたこの 1 点だけで、月あたり約 $413.7(約 ¥64,126) の節約になった計算です。改善しなかった場合の月額 $703.7(¥109,075)に対して、約 41% の削減です。
※ 前提条件(この試算がどういう条件で成り立つか)
- 1M コンテキストのモデル(Fable・Opus・Sonnet の 5 系)を使用
- モデルの使用比率は 2026-08 の実測(入力換算トークンベース)
- 1 か月のターン数 31,554・セッション数 166 も 2026-08 の実測値
- セッションはおおよそ 1M の半分(500K トークン)に達したところで
/clearする、という目安を置く。/clear直後のターン(月 166 回、セッション数と同数)はキャッシュ書き込み単価、それ以外のターン(月 31,388 回)はキャッシュ読み出し単価で、差分 21.4K トークンが発生するとして計算した - 単価は Anthropic 公式価格表(2026-06-24 時点)。$1 = ¥155 で換算
- CLAUDE.md を分けた分だけの試算(メモリ・Skill・外部フレームワークの節約分は含まない)。セッション数・ターン数は実測だが、
/clearのタイミング(1M の 50%)は実測ではなく仮定
3. トークン削減のための取組み対象
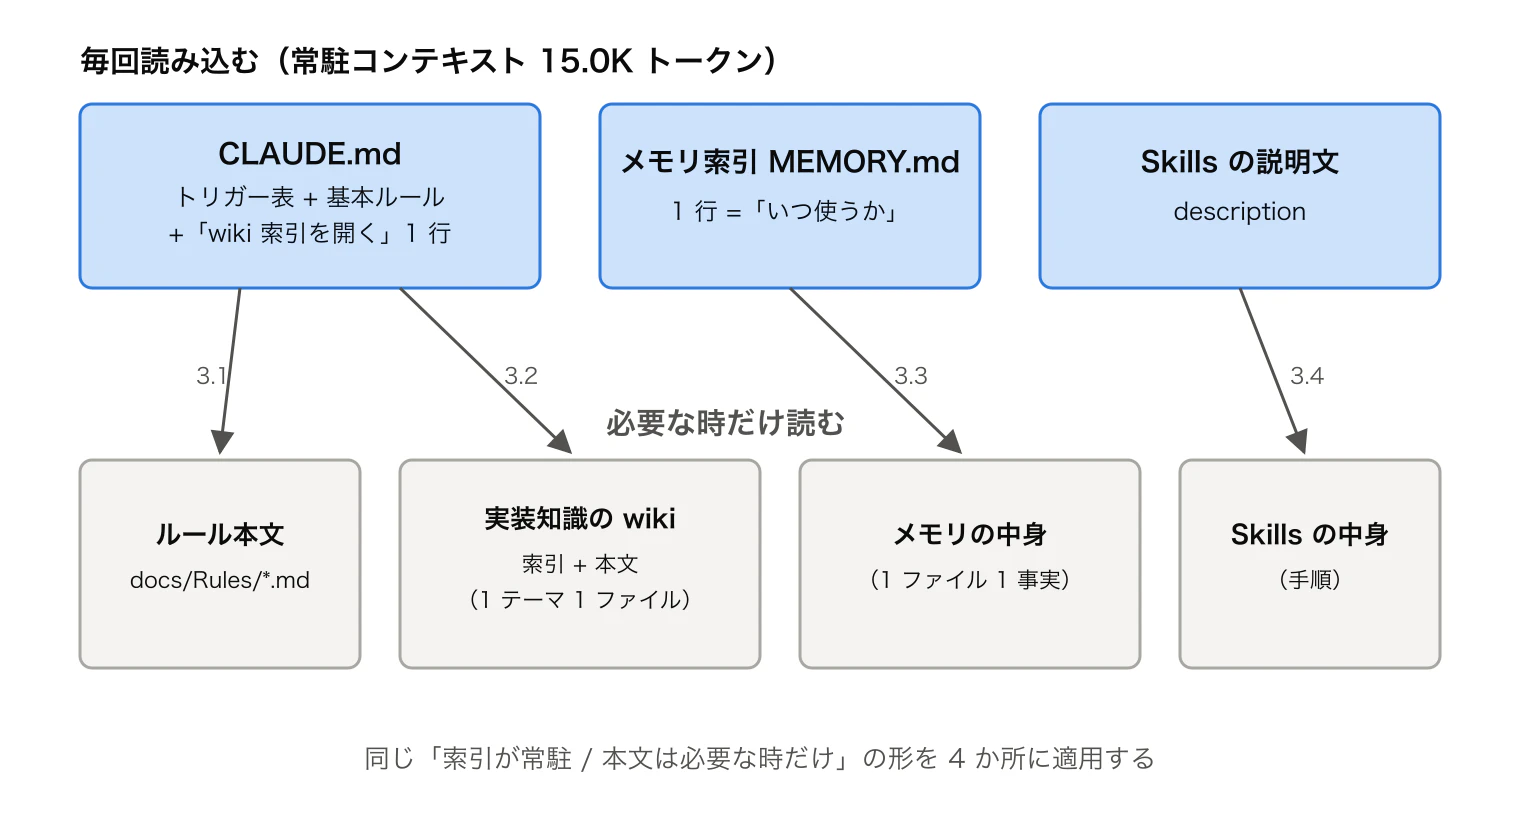
手を入れたのは次の 4 か所と、棚卸しのための見張りです。図の上段が「毎回読み込むもの」、下段が「必要な時だけ読むもの」に当たります。
| 対象 | 毎回読み込むもの | 必要な時だけ読むもの | 節 |
|---|---|---|---|
| CLAUDE.md | トリガー表と基本ルール 3〜5 行 | ルール本文 docs/Rules/*.md
|
3.1 |
| 実装知識の wiki | CLAUDE.md の「索引を開く」1 行 | 索引 1 つと、1 テーマ 1 ファイルの本文 | 3.2 |
| 自動メモリ | 索引 MEMORY.md(1 行 = いつ使うか) |
1 ファイル 1 事実の内容 | 3.3 |
| Skills | 説明文 description(31 本 → 21 本へ削減) |
手順の本文 | 3.4 |
| 見張り | 減らす方向の判定(定期の棚卸し用) | — | 3.5 |
3.1 CLAUDE.md の内容をどうしたか
トリガー表と基本ルール 3〜5 行だけ にしました。
Claude Code はプロジェクト直下の CLAUDE.md を毎セッション読み込むので、ここが常駐コンテキストの本丸です。
詳細ルールは docs/Rules/*.md へ出し、CLAUDE.md は トリガー&読み込みタイミング の形の表を 7 つだけにしました。
- 設計判断
- 文書
- 作業台
- テスト記録
- 画像素材の確認
- 外部ツール連携
- Skills 設計
それぞれ「詳細ルール: docs/Rules/XXX.md」と記し、トリガーが発火したときに読み込む対象を指定しています。
記載例は以下です(画像素材の確認の表。文面は短くしています)。
## 画像素材の確認
**詳細ルール**: `docs/Rules/Asset_Verification_Rules.md`(必要な時だけ読み込む)

| トリガー | 読み込みタイミング |
|---------|-------------------|
| アイテムの定義を新しく追加したとき | 自動読み込み |
| テクスチャを作成・差し替えしたとき | 自動読み込み |

**基本ルール**:
- 追加したら、一括生成のデバッグ操作で描画を確かめる
- テクスチャのファイル名は定義名と一致させる
最初にルール 3 本(文書・テスト記録・Skills 設計)を外へ出した直後の変化は次のとおりです。
| 出す前 | 出した直後 | 減った量 | |
|---|---|---|---|
| 文字数 | 10,129 字 | 6,528 字 | 3,601 字(約 36%) |
| 行数 | 393 行 | 207 行 | 186 行(約 47%) |
※2026-09-02 時点で CLAUDE.md は 8,852 字・302 行、7 本のルール本文はその外にあります。
3.2 実装知識はどこから読ませるのか
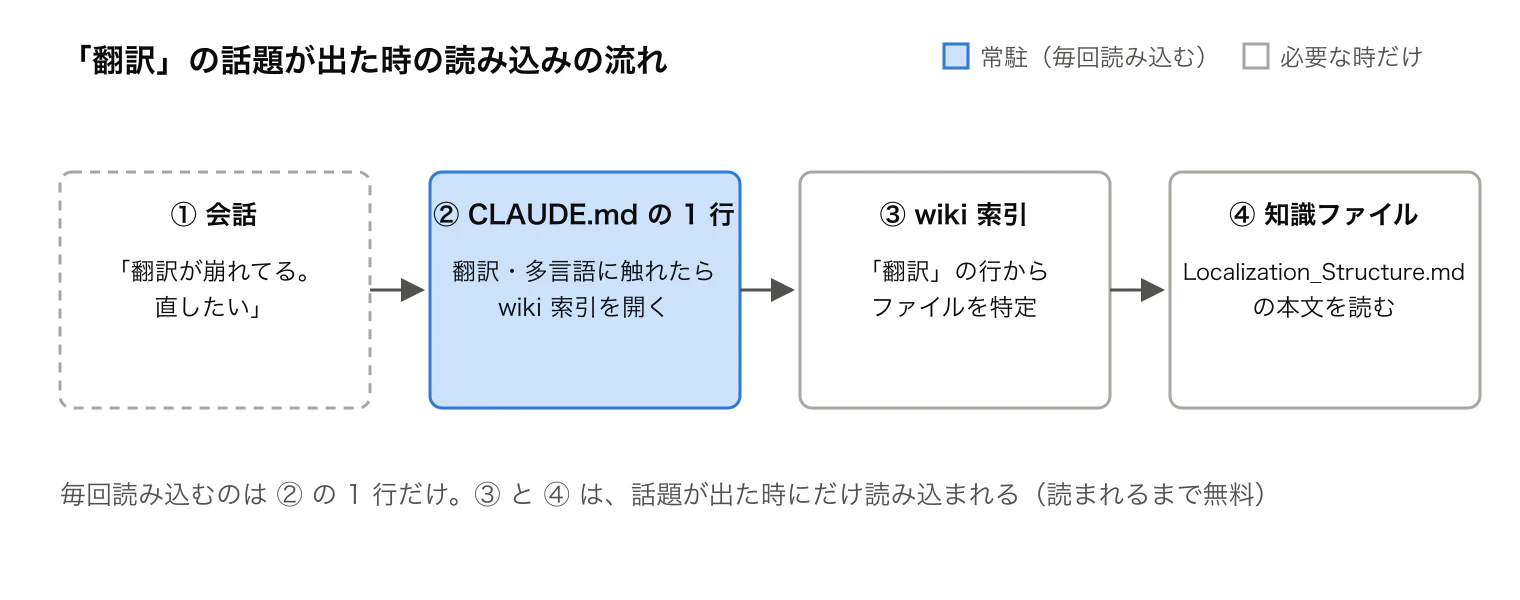
索引の 1 枚から です。実装知識(外部依存の仕様・設定ファイルの種別ごとの落とし穴・命名規則など)は wiki 形式で 1 テーマ 1 ファイルで別途保存し、「まず索引を開き、索引で見つけたファイルだけを開く」という順で読ませます。
- CLAUDE.md には「この話題(キーワード群)に触れたら、まず wiki の索引を開く」の 1 行だけ
- 索引は「トリガーキーワード → ファイル」の対応表のみ。各ファイルは先頭のメタデータに
triggers(検索キーワード)とrelated(関連リンク)を持つ
| トリガーキーワード | ファイル |
|---|---|
| 翻訳, 多言語, ローカライズ, 日本語化 | Conventions/Localization_Structure.md |
| 設定ファイルの種別名, 参照の宙吊り | Types/XXX.md |
索引そのものも常駐コンテキストに置いていないのがポイントです。
話題が出た時だけ索引を読み、索引から実際の知識が書かれたファイルを読みます。
毎回読み込むのは索引を開くための条件だけです。
3.3 自動メモリの索引をどう書くのか
「いつ使うか」の条件文 1 行だけ を書きます。
Claude Code の自動メモリは、索引ファイル(MEMORY.md)が毎セッション全文読み込まれ、内容のファイルは索引から必要な時に開かれます。
つまり 索引だけが常駐コンテキスト ということです。
※知識、ルールが増えると MEMORY.md が 1 行ずつ増えるので、運用していくとここが一番増えやすい場所でもあります。
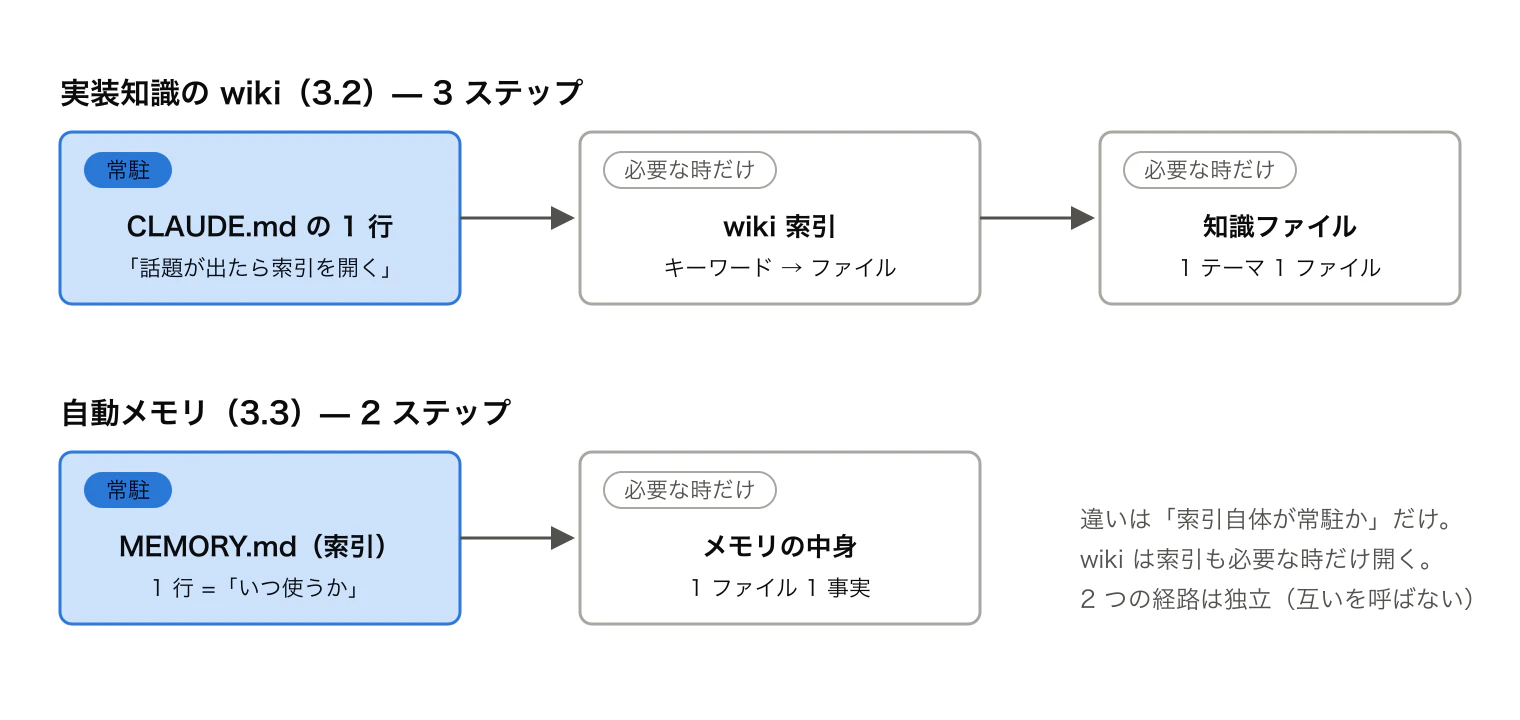
3.2 の wiki と形は同じ(索引が常駐 / 内容は必要な時だけ)ですが、索引自体が常駐しているかどうかが違います。
wiki は索引ファイルも必要な時だけ開く 3 ステップ、メモリは索引(MEMORY.md)自体が常駐しているので索引を開くステップが要らず 2 ステップで済みます。
2 つの経路はお互いを呼び出さない独立したものです。
運用は 3 つの決まりで縛りました。
| 決まり | 内容 |
|---|---|
| 索引行は「いつ使うか」だけ |
- [題名](file.md) — いつ使うか の 1 行。内容の要約を書かない。読んで「内容を開くべきか」を決められればよい |
| 中身は 1 ファイル 1 事実 | 1 語直すのに全文を読む必要がある内容は分割する。内容には「この学びが効いていることをどう機械で確かめるか」の行を置く |
| 状態情報は書かない | 「マージ済み」「作業中」のような状態は GitHub が持つ。索引に書くと毎回読み直される上に、すぐ古くなる |
索引行は以下のようになります。
- [git add -A は禁止](fb_no_git_add_all.md) — ステージングするとき。ファイル単位で列挙する
- [FAIL が同一再現したら先に鮮度を疑う](project_yyy.md) — ソース → DLL → デプロイ先 → ログを遡る
索引行が指す先のファイルは、例えば次のような内容です(fb_no_git_add_all.md の記載例。文面は短くしています)。
---
name: fb-no-git-add-all
description: git add -A を使わず、ステージングはファイル単位で列挙する
metadata:
  type: feedback
---

`git add -A` / `git add .` は使わない。ステージング対象はファイル単位で列挙する。

**Why**: 一括ステージングで生成物や無関係な変更が混入したコミットができ、レビュー差し戻しになったことがある。
**How to apply**: コミット前に `git status` で変更一覧を確認し、対象ファイルだけを `git add <パス>` で列挙する。
**効き目の確認**: 直近コミットに意図しないファイルが含まれていないことを `git log --stat -1` で見る。
3 つの決まりとの対応はこうなります。
- 事実はこの 1 件だけ(1 ファイル 1 事実)。内容を直すときも、この短いファイルを開くだけで済み、無関係な事実まで読み込まない
- 末尾に「この学びが効いていることをどう機械で確かめるか」の行を置いている
- 「対応済み」「作業中」のような状態情報は無い。いつ使うかは索引行が、何をするか・なぜかは本文が持つ
後述 3.5 の機械が見張るのは、1 行の長さと知識ファイルとの対応関係だけです。
検査スクリプトが、下記項目を RED / GREEN で返します。
- 索引 1 行の上限(120 字)
- 索引のリンク先が実在すること
- 置いてある知識のファイルが索引に載っていること(載っていないと思い出されない)
- 索引に本文が混ざっていないこと
- 進捗語が含まれていないこと
内容の質(条件文になっているか)は、月次の棚卸しで RED になっているものを確認し、軽くするか統合するかといった整理をします。
3.4 Skills の軽量化
ここでは単純に、Skills の棚卸しをしました。
使われない Skills を削除し、本数そのものを減らすことで、常駐コンテキストを減らしました。
※Claude Code の Skills(手順のパッケージ)は、内容は起動した時だけ読まれますが、description(説明文)は毎回常駐コンテキストに入ります。
さらに、削除対象になったものから 2 つの決まりを作りました。
-
テンプレート専用の Skills を作らない。内容が雛形だけの Skills は、説明文の常駐コストと誤起動のリスクを払って得るものが無い。Skills が使う雛形は既存 Skills の
templates/へ移動しました。※もし、Skills で使わないけど必要なテンプレートがあれば、Skills としてではなくルールにするのが良いですね。 - 使われない Skills は削る。4 つの起動経路(スラッシュコマンド / 自動起動 / サブエージェント / 手順からの参照)で起動回数を数え、2 か月連続で 0 の Skills だけを削除・統合・知識への移し替えの整理をしました。
3.5 増え続けないようにどう見張るのか
これは 定期の棚卸しで、減らす方向の判定だけを持たせています。
上の 4 か所は、放っておくと指示やルールは増え、索引内容は伸び、Skills は増えます。
- 索引の機械検査を回し、RED は棚卸しの中で直す。
- Skills の起動回数を数え、削る候補を判定する。
- 常駐コンテキストの合計(CLAUDE.md + メモリ索引 + Skills の説明文)を記録し、増え方を見る。
判定は「削る / 必要な時だけ読む側へ移す / 残す」の 3 択で、増やす判定は入れていません。
これは日常の作業で勝手に増えるので、棚卸しは減らす方向だけにしています。
4. 常駐コンテキストの増加をどれだけ抑えられたか
常駐コンテキストは、全ての知識量の 0.7% に収まりました。
もし詳細ルールを CLAUDE.md に書いたままなら 1.8%(2.4 倍)になっていました。
以下は推定値(2026-08-27 のトークン集計。36 日・238 セッション。文字量からの換算)です。
| 項目 | トークン量 | 備考 |
|---|---|---|
| 置いてある知識(文書 + メモリの中身 + Skills の中身) | 2.03M トークン | プロジェクトに書き溜めた量 |
| 36 日で実際に読まれた量 | 1.12M トークン | 読まれなかった 0.91M にはコストが掛かっていない |
| 常駐コンテキスト | 15.0K トークン(全体の 0.7%) | CLAUDE.md 4.3K + メモリ索引 5.9K + Skills 説明文 30 件 3.8K + 外部フレームワークの残骸 1.1K(消し忘れのゴミ、後述) |
| 常駐コンテキストの読み直し | 15.0K × 31,554 ターン = 473M トークン(キャッシュ読み出し全体の 4.5%) | 常駐コンテキストの 1 トークンは 1 か月に約 3 万回読み直される |
| ルール本文が読み込まれた回数 | 238 セッション中 42 回(21.4K トークン) | 本文を CLAUDE.md に書いていたら、常駐コンテキストは 15.0K → 36.4K トークン(2.4 倍) |
| メモリ | 索引 5.9K トークン(常駐)/内容 100K トークン(108 ファイル、常駐させない) | 毎回読み込むのは索引の 5.9K だけ。内容まで常駐させていたら毎回 100K トークン以上を読み込むことになる。実際に開かれたのは 36 日で 98K トークン分(87 回) |
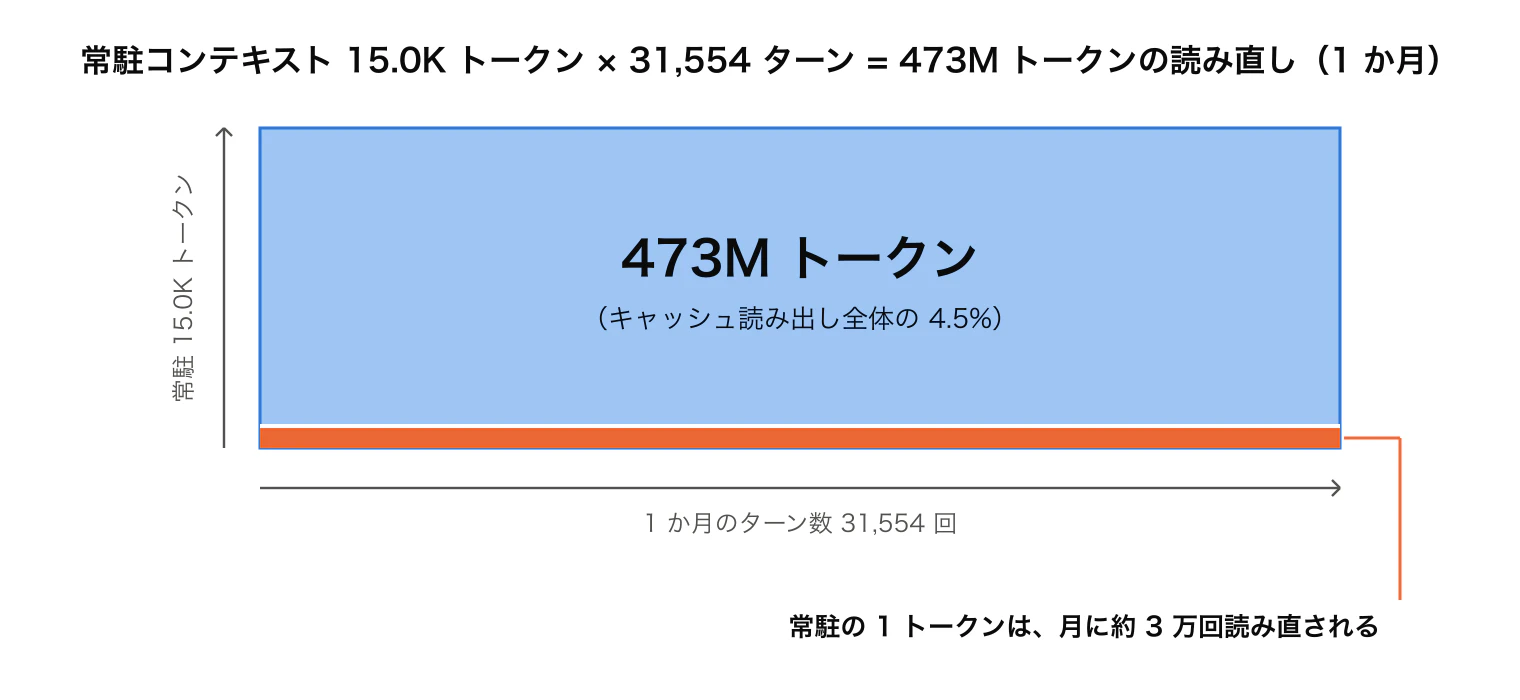
※usage 値の実測(2026-08)では、再読倍率 50.8 倍、キャッシュ読み出しがコストの 65.5%、月 34,125 リクエストでした。1. 何に困っていたのか の「1 トークン削るだけで月 3 万回以上の読み直しがまるごと無くなる」の根拠はここです。
4.1 前後で比べられた1例
このプロジェクトでは以前、起動時に約 36KB(≒ 10K トークン)を読み込む外部フレームワーク(汎用のフラグ・ルール集)を入れていました。
「毎回読み込むコストに見合う場面が無い」と判断して外しています。
常駐コンテキストは、今の 15.0K の上に 10K が乗っていた計算です。
※なお、外し方が完全ではなかったため、1,061 トークンの残骸として常駐コンテキストに残り続け、36 日で 33.5M トークンの読み直しを生んでいました。完全に無駄な消費でした。
外すという判断は正しかったのに残骸を見逃したのは、常駐コンテキストの内訳を数える仕組みが無かった からです。3.5 の定期の棚卸しは、こういう失敗を防ぐために用意しました。
4.2 棚卸しをしなかったらどうなるか
常駐コンテキストに置いていなくても、読まれることがあるとトークンを消費します。
私のプロジェクトでは、期間中の 1 回の読み込みで最大級だったのは、静的検証 Skills の中身 22.5K トークンでした(3 回読まれて計 66K トークン)。
原因は検証ルールのカタログが手順と同じファイルに同居していたためで、手順だけを残して約 2.1K トークンにし、カタログを references/ へ分けて出しました。あわせて書き方のガイドも新規に references/ へ追加しています(分離したカタログと合わせて約 22.7K トークン)。
必要な時だけ読み込む形は「読まれるまで無料」にしますが、当然読まれるとコストになるので、参照先の内容も仕分けが必要、という例です。
5. どこでつまずいたのか
| つまずき | 何が起きるか | 対処 |
|---|---|---|
| 必要な時だけ読むファイルが増える | 読んだ瞬間にファイルのサイズ分が入る。22.5K トークンの Skills の中身を 3 回読んで 66K。 | 内容は「手順」だけにし、カタログ・雛形・参照資料は references/ templates/ へ仕分けした。 |
| 索引に進捗を書く | 当初「マージ済み」「作業中」といった状態情報を索引に持っていたため、状態が変わるたびにプロンプト先頭のキャッシュ済み部分(索引)が書き換わり、キャッシュが無効化されて書き込み単価が再発生していた。 | 進捗は GitHub で管理し、索引は「いつ使うか」の条件だけ。進捗語は機械検査で WARN。 |
| 索引に指示を書く | 「〜に注意」は読んでも判断できず、中身を開かないと使えない。索引の意味が無い。 | 目の前の対象を見た瞬間に決められる具体化した条件文へ言い換えた。 |
| 索引にあるのに誰も開かない置いてある知識 | 索引にあっても使用されないなら、誰も開かない行は無駄な常駐コンテキスト。 | 棚卸しで参照ゼロの置いてある知識を削除・統合し、索引行ごと消す。 |
| 外したつもりの残骸 | 本体を外してもコマンドとエージェントの説明文が残り、1,061 トークンが 36 日で 33.5M トークン読み直される | 常駐コンテキストの内訳を定期的に数える。「使った実績ゼロ」を機械で出し、棚卸し対象として整理。 |
6. 自分のプロジェクトで始めるには
-
CLAUDE.md をトリガー表に分ける。 詳細ルールを
docs/Rules/へ出し、CLAUDE.md には「トリガー → 読み込みタイミング」の表と基本ルール 3〜5 行だけを残す。分ける目安は「このルールを使わないセッションが半分以上あるか」
| トリガー | 読み込みタイミング |
|---------|-------------------|
| メモリへ書こうとしたとき | 自動読み込み |
※全体の形は「2. どう解決しようと考えたのか」と「3.1 CLAUDE.md の内容をどうしたか」の記載例を参照してください。
- 知識を 1 テーマ 1 ファイルへ分割し、キーワード索引を作る。 外部依存の仕様や落とし穴など、繰り返し参照する知識をテーマごとに 1 ファイルへまとめ、「トリガーキーワード → ファイル」の索引を 1 枚作る。索引自体も常駐には置かず、CLAUDE.md には「この話題に触れたらこの索引を開く」の 1 行だけを残す
| トリガーキーワード | ファイル |
|------------------|---------|
| 翻訳, 多言語, ローカライズ, 日本語化 | Conventions/Localization_Structure.md |
※流れは「3.2 実装知識はどこから読ませるのか」の図を参照してください。
-
メモリの索引ファイルを 1 本作る。 メモリは知識の wiki と違い、索引ファイル(例:
MEMORY.md)自体を常駐させてよい。1 行 = リンク + 「いつ使うか」の条件文、中身は 1 ファイル 1 事実にする。※索引には進捗と要約を書かない ※wiki の索引との違いは「3.3 自動メモリの索引をどう書くのか」の図を参照してください。 -
索引の長さと対応を機械検査する。 1 行の上限チェック・リンク切れ・索引漏れ・進捗語を RED / GREEN で返すスクリプトを、hook か定期の棚卸しで回す。減らす方向にだけ動かす。増やす判定は都度判断か、棚卸しに入れるなら次のような材料が考えられます。
- ほぼ毎回のセッションで開かれている置いてある知識は、常駐コンテキストへ戻す候補にする(毎回ファイルを開く往復の方が高くつくため)
- その場面が来たのに読まれず、手直しが出たルールは、基本ルールに 1 行足す候補にする
- どちらも会話記録から「その場面で読まれたか」を数えて判定する
-
減ったかどうかを文字数で確かめる。 1〜4 に着手する前に、毎回読み込まれる次のファイルを
wc -mで数えておき、変更後にもう一度数える。トークン数への正確な換算は難しいので、文字数が減っていれば十分な確認になる
| 対象 | 見るファイル |
|---|---|
| CLAUDE.md | プロジェクト直下の CLAUDE.md
|
| メモリ索引 |
.claude/memory/MEMORY.md(自動メモリを使っている場合) |
wc -m CLAUDE.md .claude/memory/MEMORY.md
※ Skills の説明文(description)も毎回読み込まれますが、複数ファイルの一部だけを合算する必要があり wc -m では数えにくいため、この簡易チェックの対象からは外しています。
付録 A. 常駐コンテキストの内訳
| 常駐コンテキスト | 2026-08-27 の推定トークン | 棚卸し後の現在値 |
|---|---|---|
| CLAUDE.md(トリガー表 + 基本ルール) | 4.3K | 8,852 字・302 行(ルール本文 7 本は必要な時だけ読み込む) |
| メモリ索引 | 5.9K | 12,908 字・152 行(置いてある知識 129 ファイルは必要な時だけ読み込む) |
| Skills の説明文 | 3.8K(30 件) | 21 件 |
| 外部フレームワークの残骸 | 1.1K | 0 件(外し済み) |
| 合計 | 15.0K | — |