

前回、日本語の手書き作業日報を最安帯のマルチモーダルLLM3つに読ませて比較したところ、Gemini 3.1 Flash-Lite が満点で圧勝という結果になりました。
この記事に対して、@Rambosan さんの記事(Mistral OCR 4 を .NET デスクトップアプリから EntraID 認証で呼び出す構成の解説。実務目線の検証が参考になります)で「汚い日本語の手書き文字はGeminiが圧勝」と引用いただきました。あわせて「活字の複雑な帳票×自然言語抽出は Mistral OCR 4 が強い」という実務所感も書かれています。
Mistral OCR 4 は、Mistral AI社が2026年6月に発表したOCR特化モデルです。「OCR性能でGPT-5.5やGeminiを凌駕」という触れ込みで話題になりました。表・数式・署名・バウンディングボックスまで取れる構造化抽出が売りで、170言語対応。そして Azure AI Foundry からもデプロイできます。
そこで今回は、この Mistral OCR 4 を前回とまったく同じ条件(同じ画像・同じスキーマ・同じ採点基準)のベンチマークにかけて、「OCR特化モデルは日本語の手書き帳票を読めるのか」を確かめます。
せっかくなので、Microsoftアカウントの新規作成から Mistral OCR 4 のAPI疎通まで、Azureをゼロから構築する全手順も記録しました。
この記事でやること
- Microsoftアカウント+Azure無料アカウントの新規作成
- Azure AI Foundry プロジェクト作成
- mistral-ocr-4-0 のデプロイ(→ちょっとした罠がありました)
- APIキーで疎通(EntraID不要)
- 手書き作業日報ベンチマーク(前回と同一条件)
料金の目安:Mistral OCR 4 はページ単位の課金で OCR が $4/1,000ページ、構造化抽出(Document AI / annotation)を使うと $5/1,000ページです(Mistral公式の料金表・2026年7月時点。Azure側の料金ページにはまだ OCR 4 の行が載っていません)。
1. Microsoftアカウント+Azure無料アカウントの作成
Azureが初めての場合、azure.microsoft.com/free から無料アカウントを作ります。「無料で始める」を押すと、Microsoftアカウントのサインインを求められるので、持っていなければここで新規作成します。
メールアドレスを入れて確認コードを受け取ります。パスワードレス(コード認証のみ)で作れました。
アカウントができたらAzureのサインアップに戻り、氏名・国・電話番号確認とクレジットカード登録を済ませます(無料トライアルでもカード登録は必須です。勝手に課金はされません)。
サインアップが終わるとAzureポータルに入れます。この時点で30日間有効の無料クレジットが付与されています。
2. Azure AI Foundry プロジェクトを作る
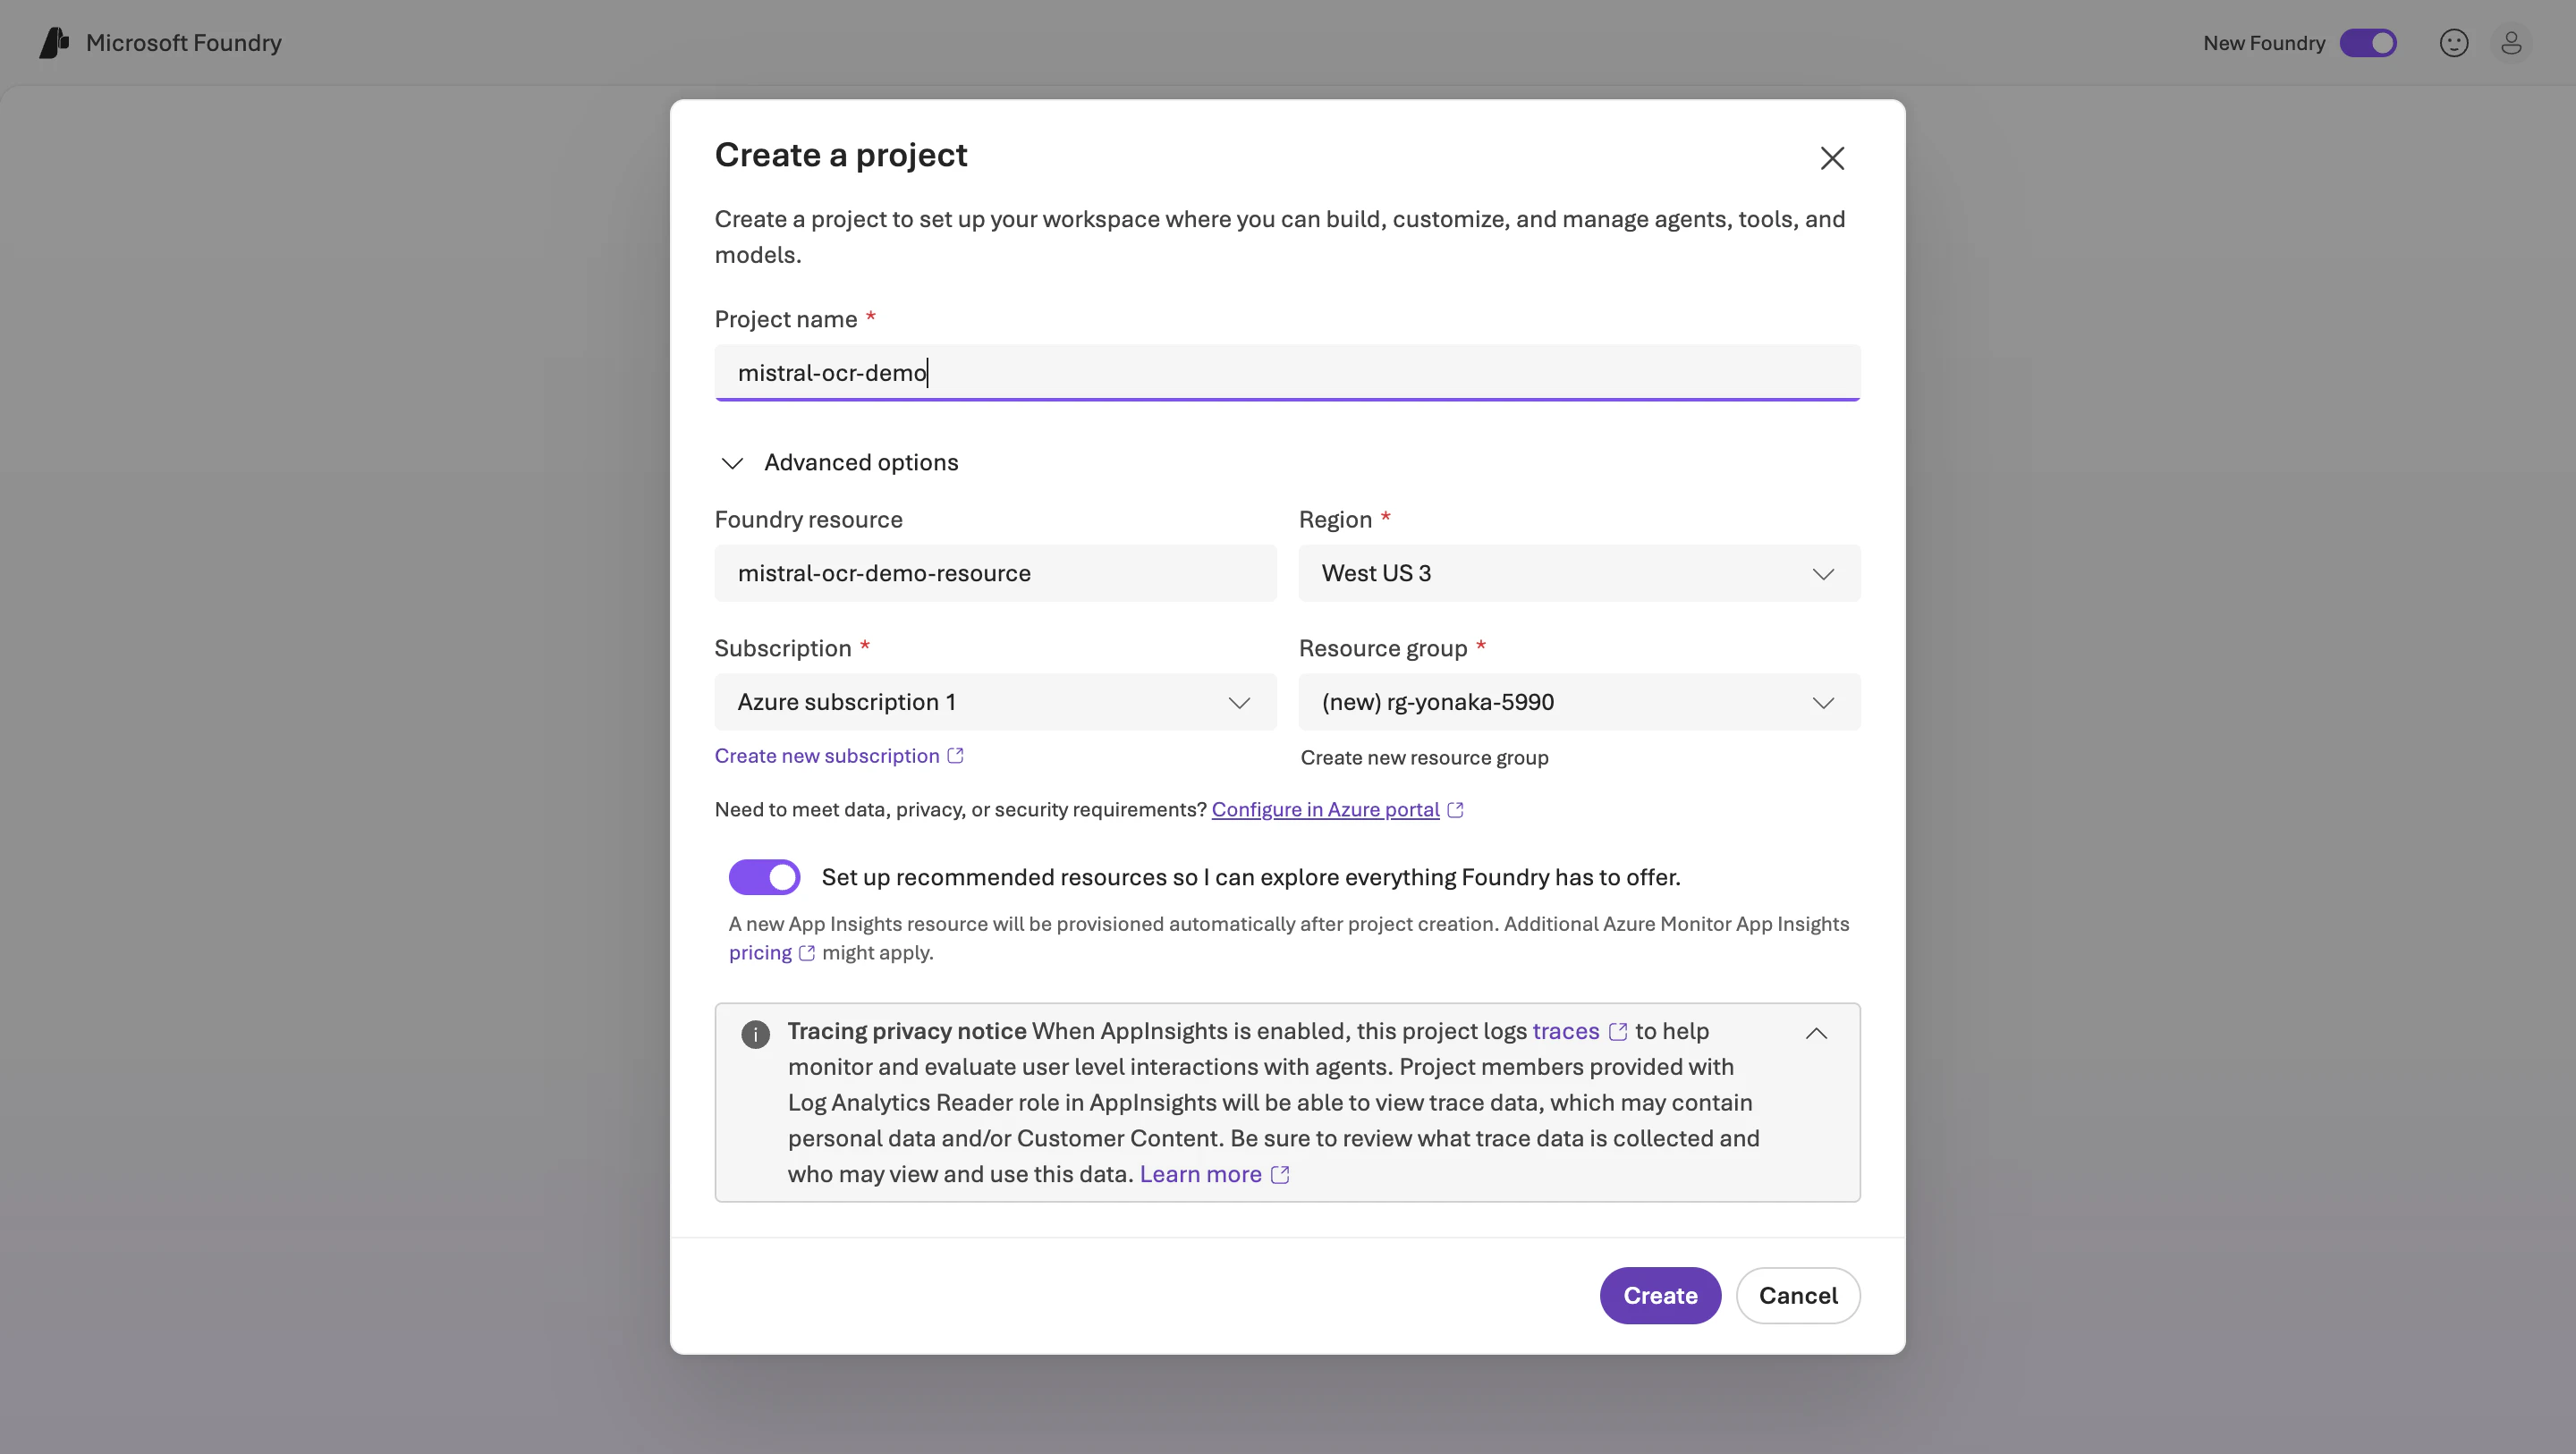
AIモデルのデプロイは Azure AI Foundry(旧 Azure AI Studio)から行います。ai.azure.com にアクセスして、プロジェクトを新規作成します。今回は mistral-ocr-demo という名前で、リージョンは West US 3 にしました(Mistral OCR 4 が利用可能なリージョンから選びました)。
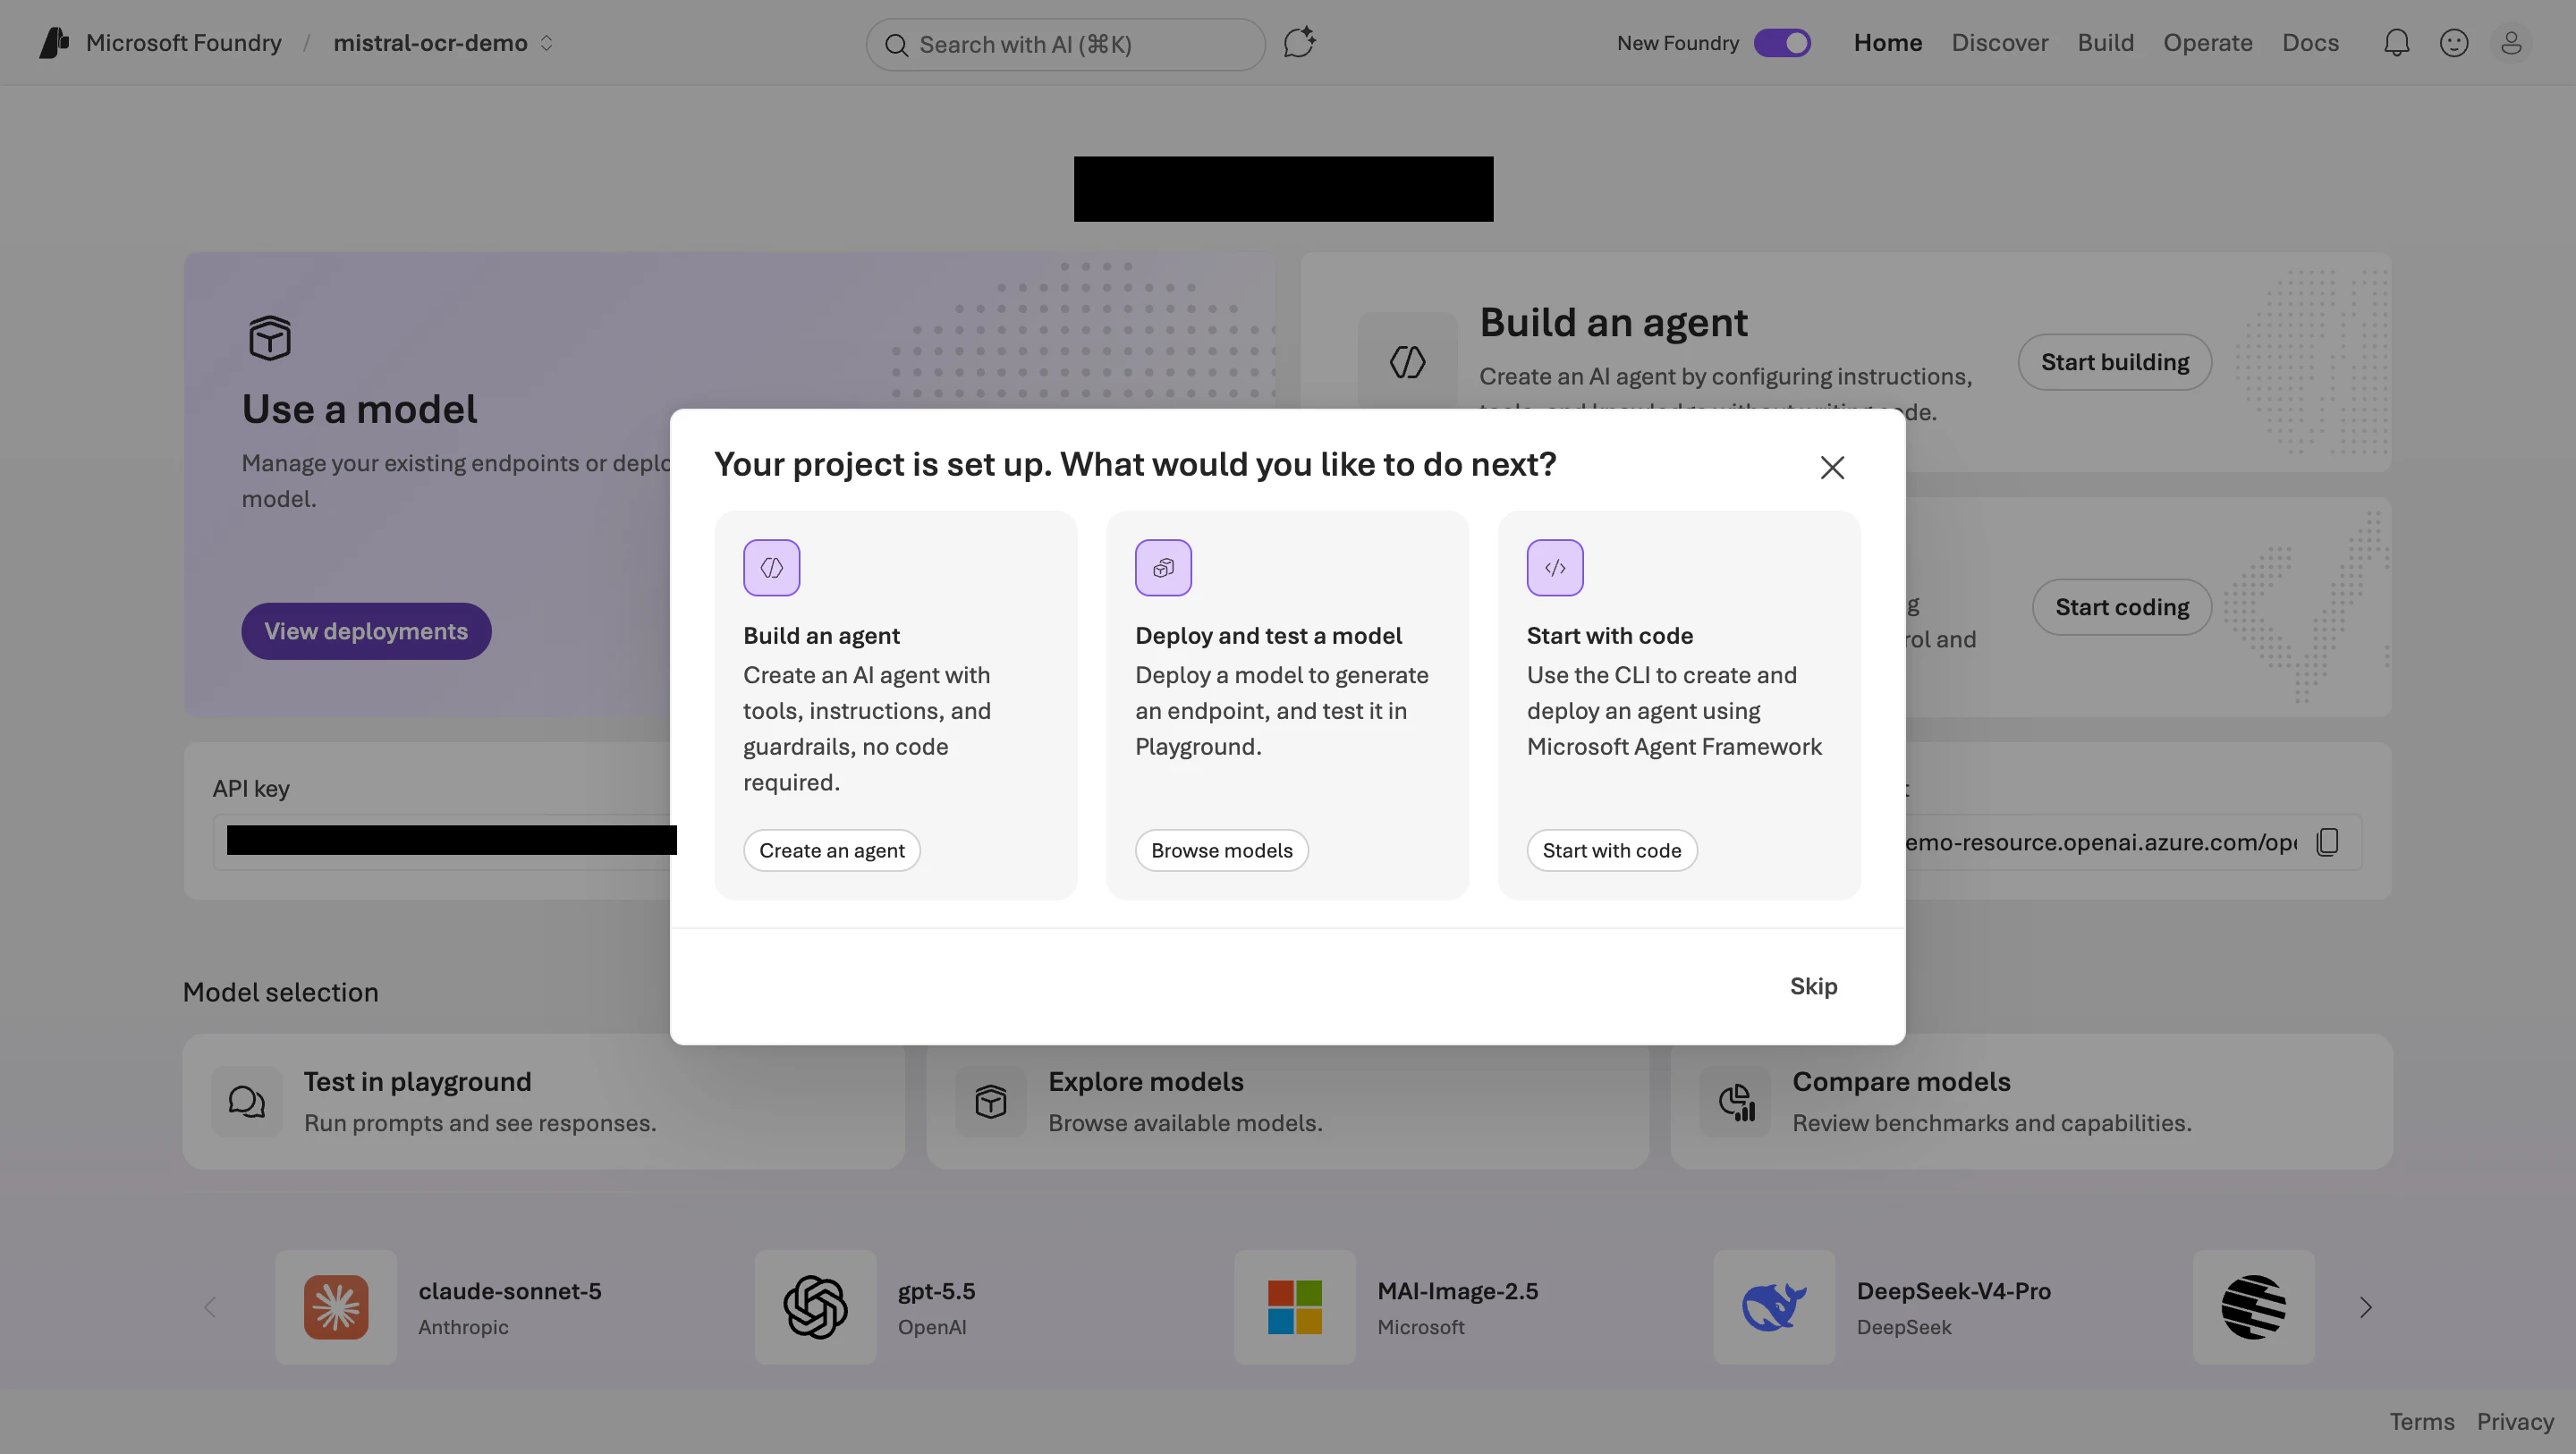
プロジェクトができると、エンドポイントやキーが確認できるホーム画面に入ります。
3. mistral-ocr-4-0 をデプロイする(→つまずきポイント)
モデルカタログで「mistral」と検索すると mistral-ocr-4-0 が出てきます。
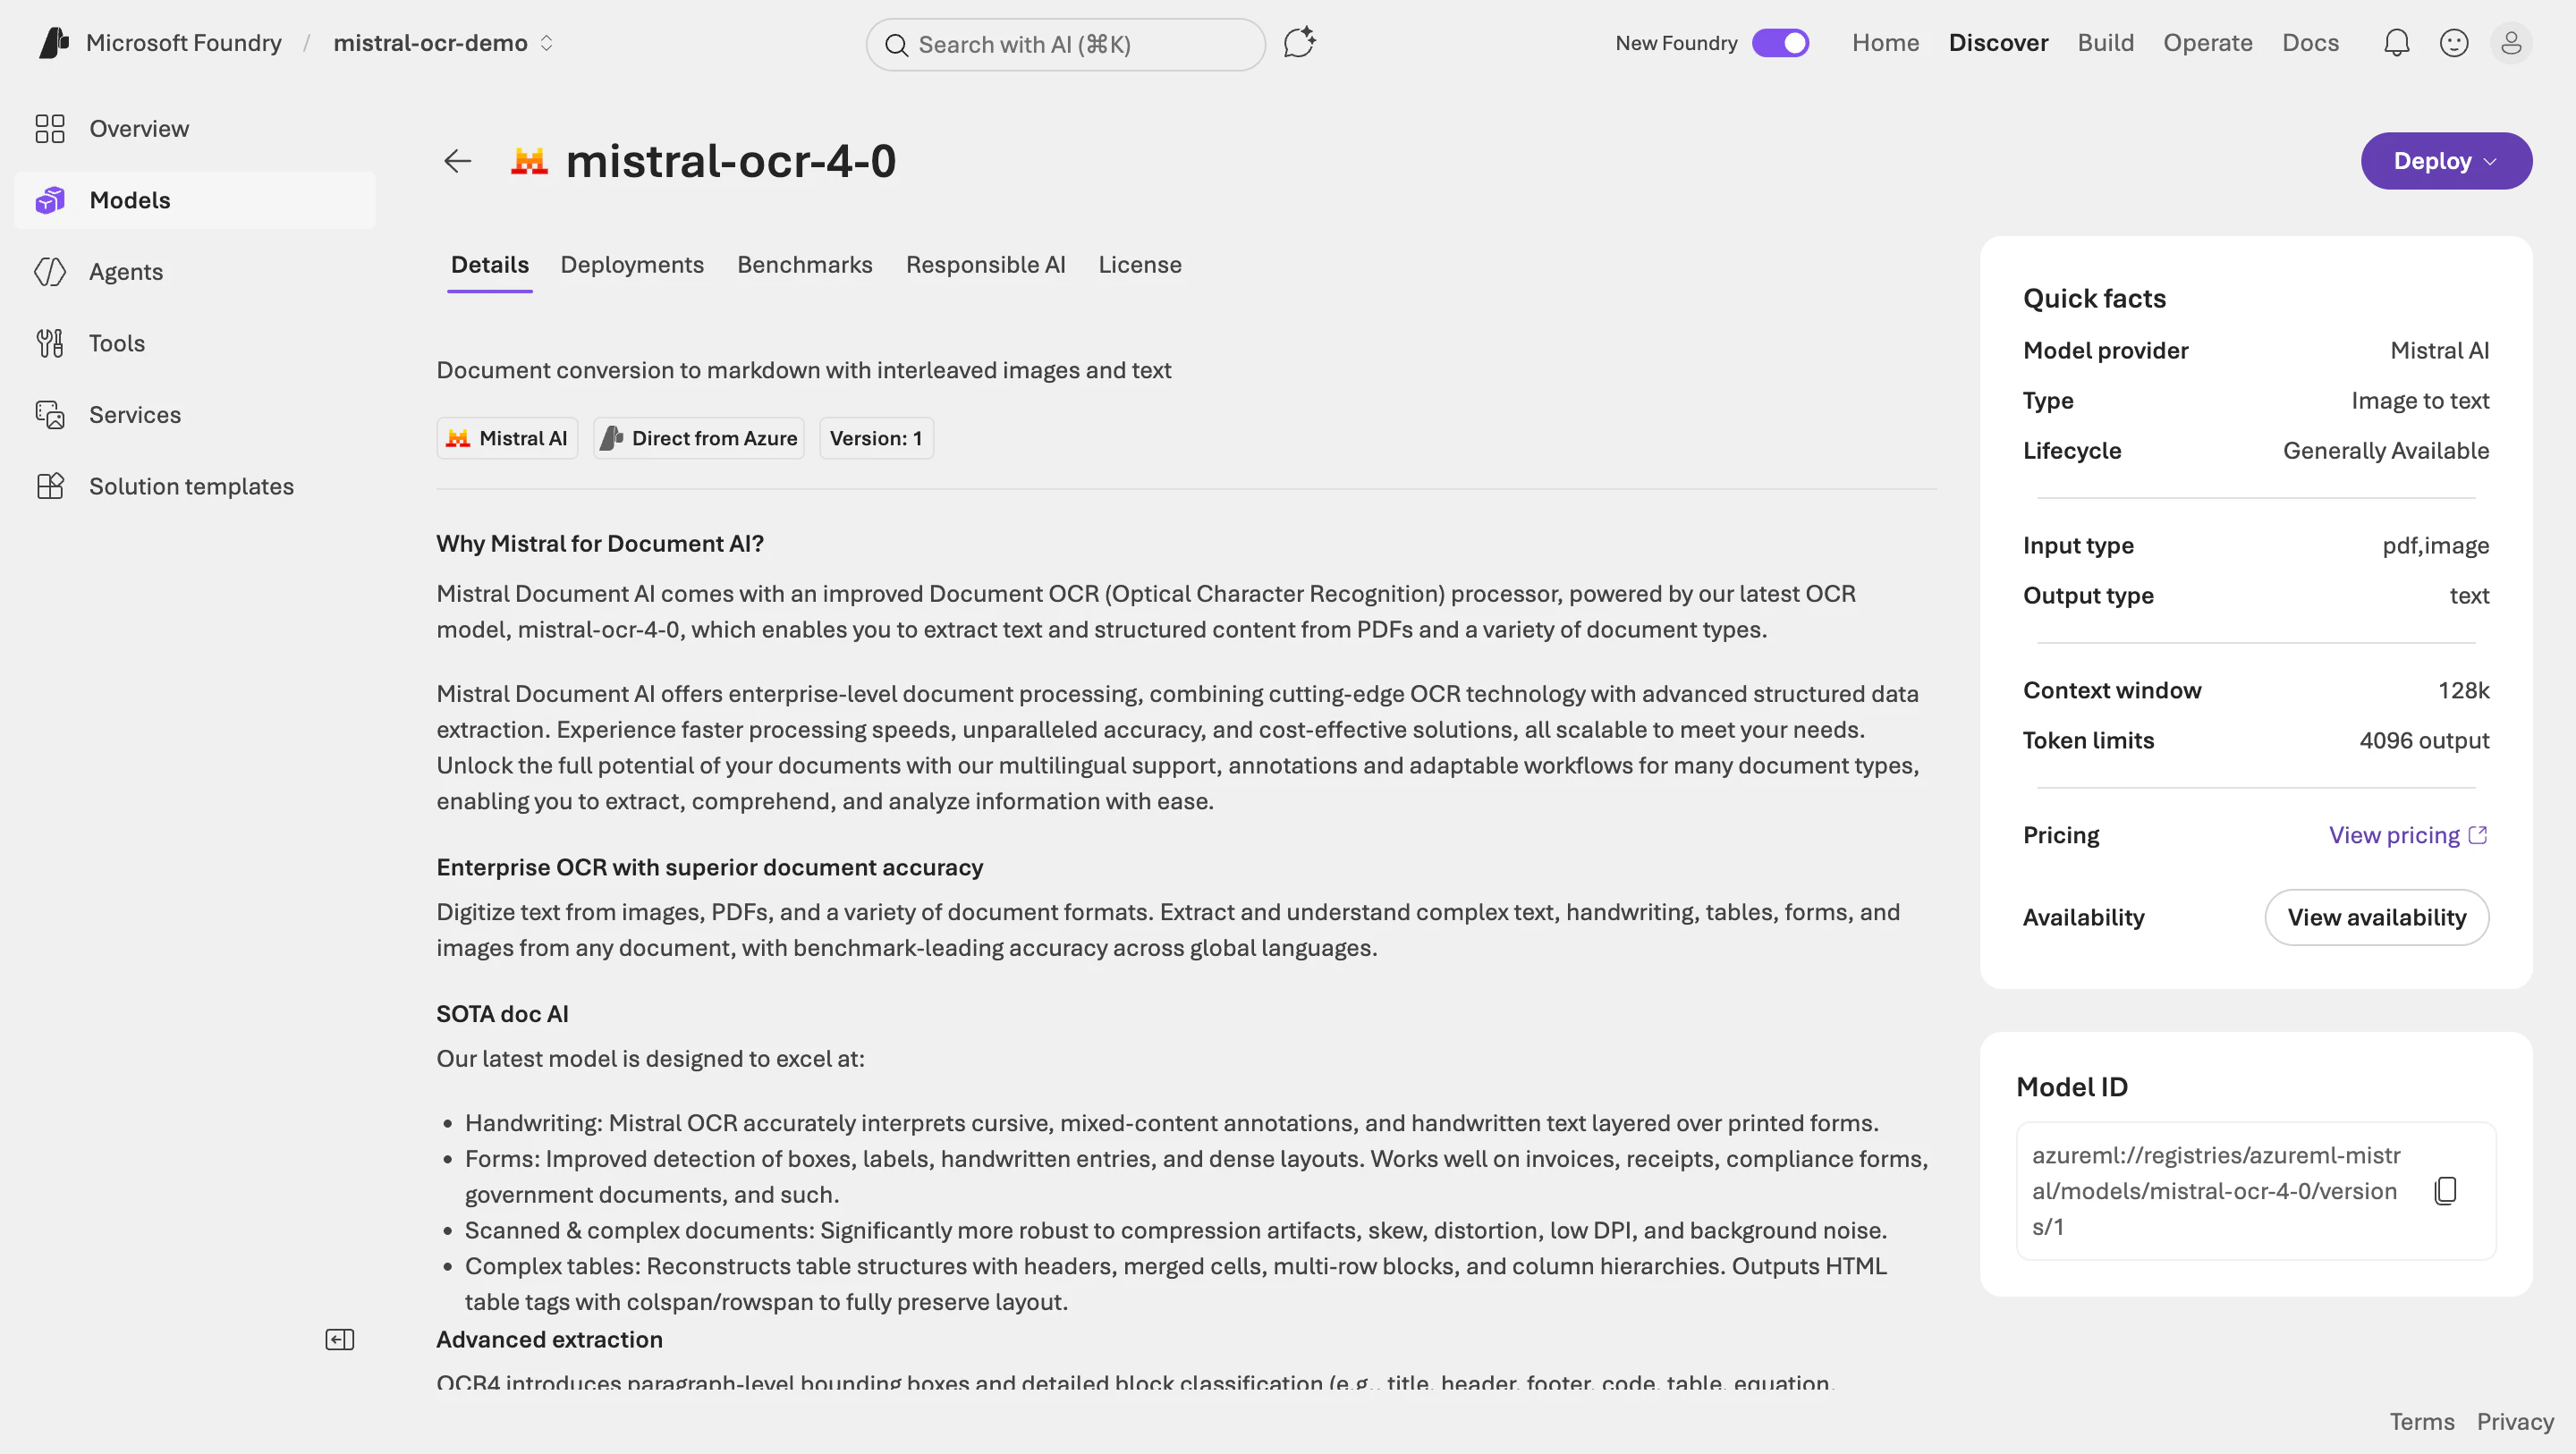
「Deploy」を押せば終わり……かと思いきや、ここでつまずきました。
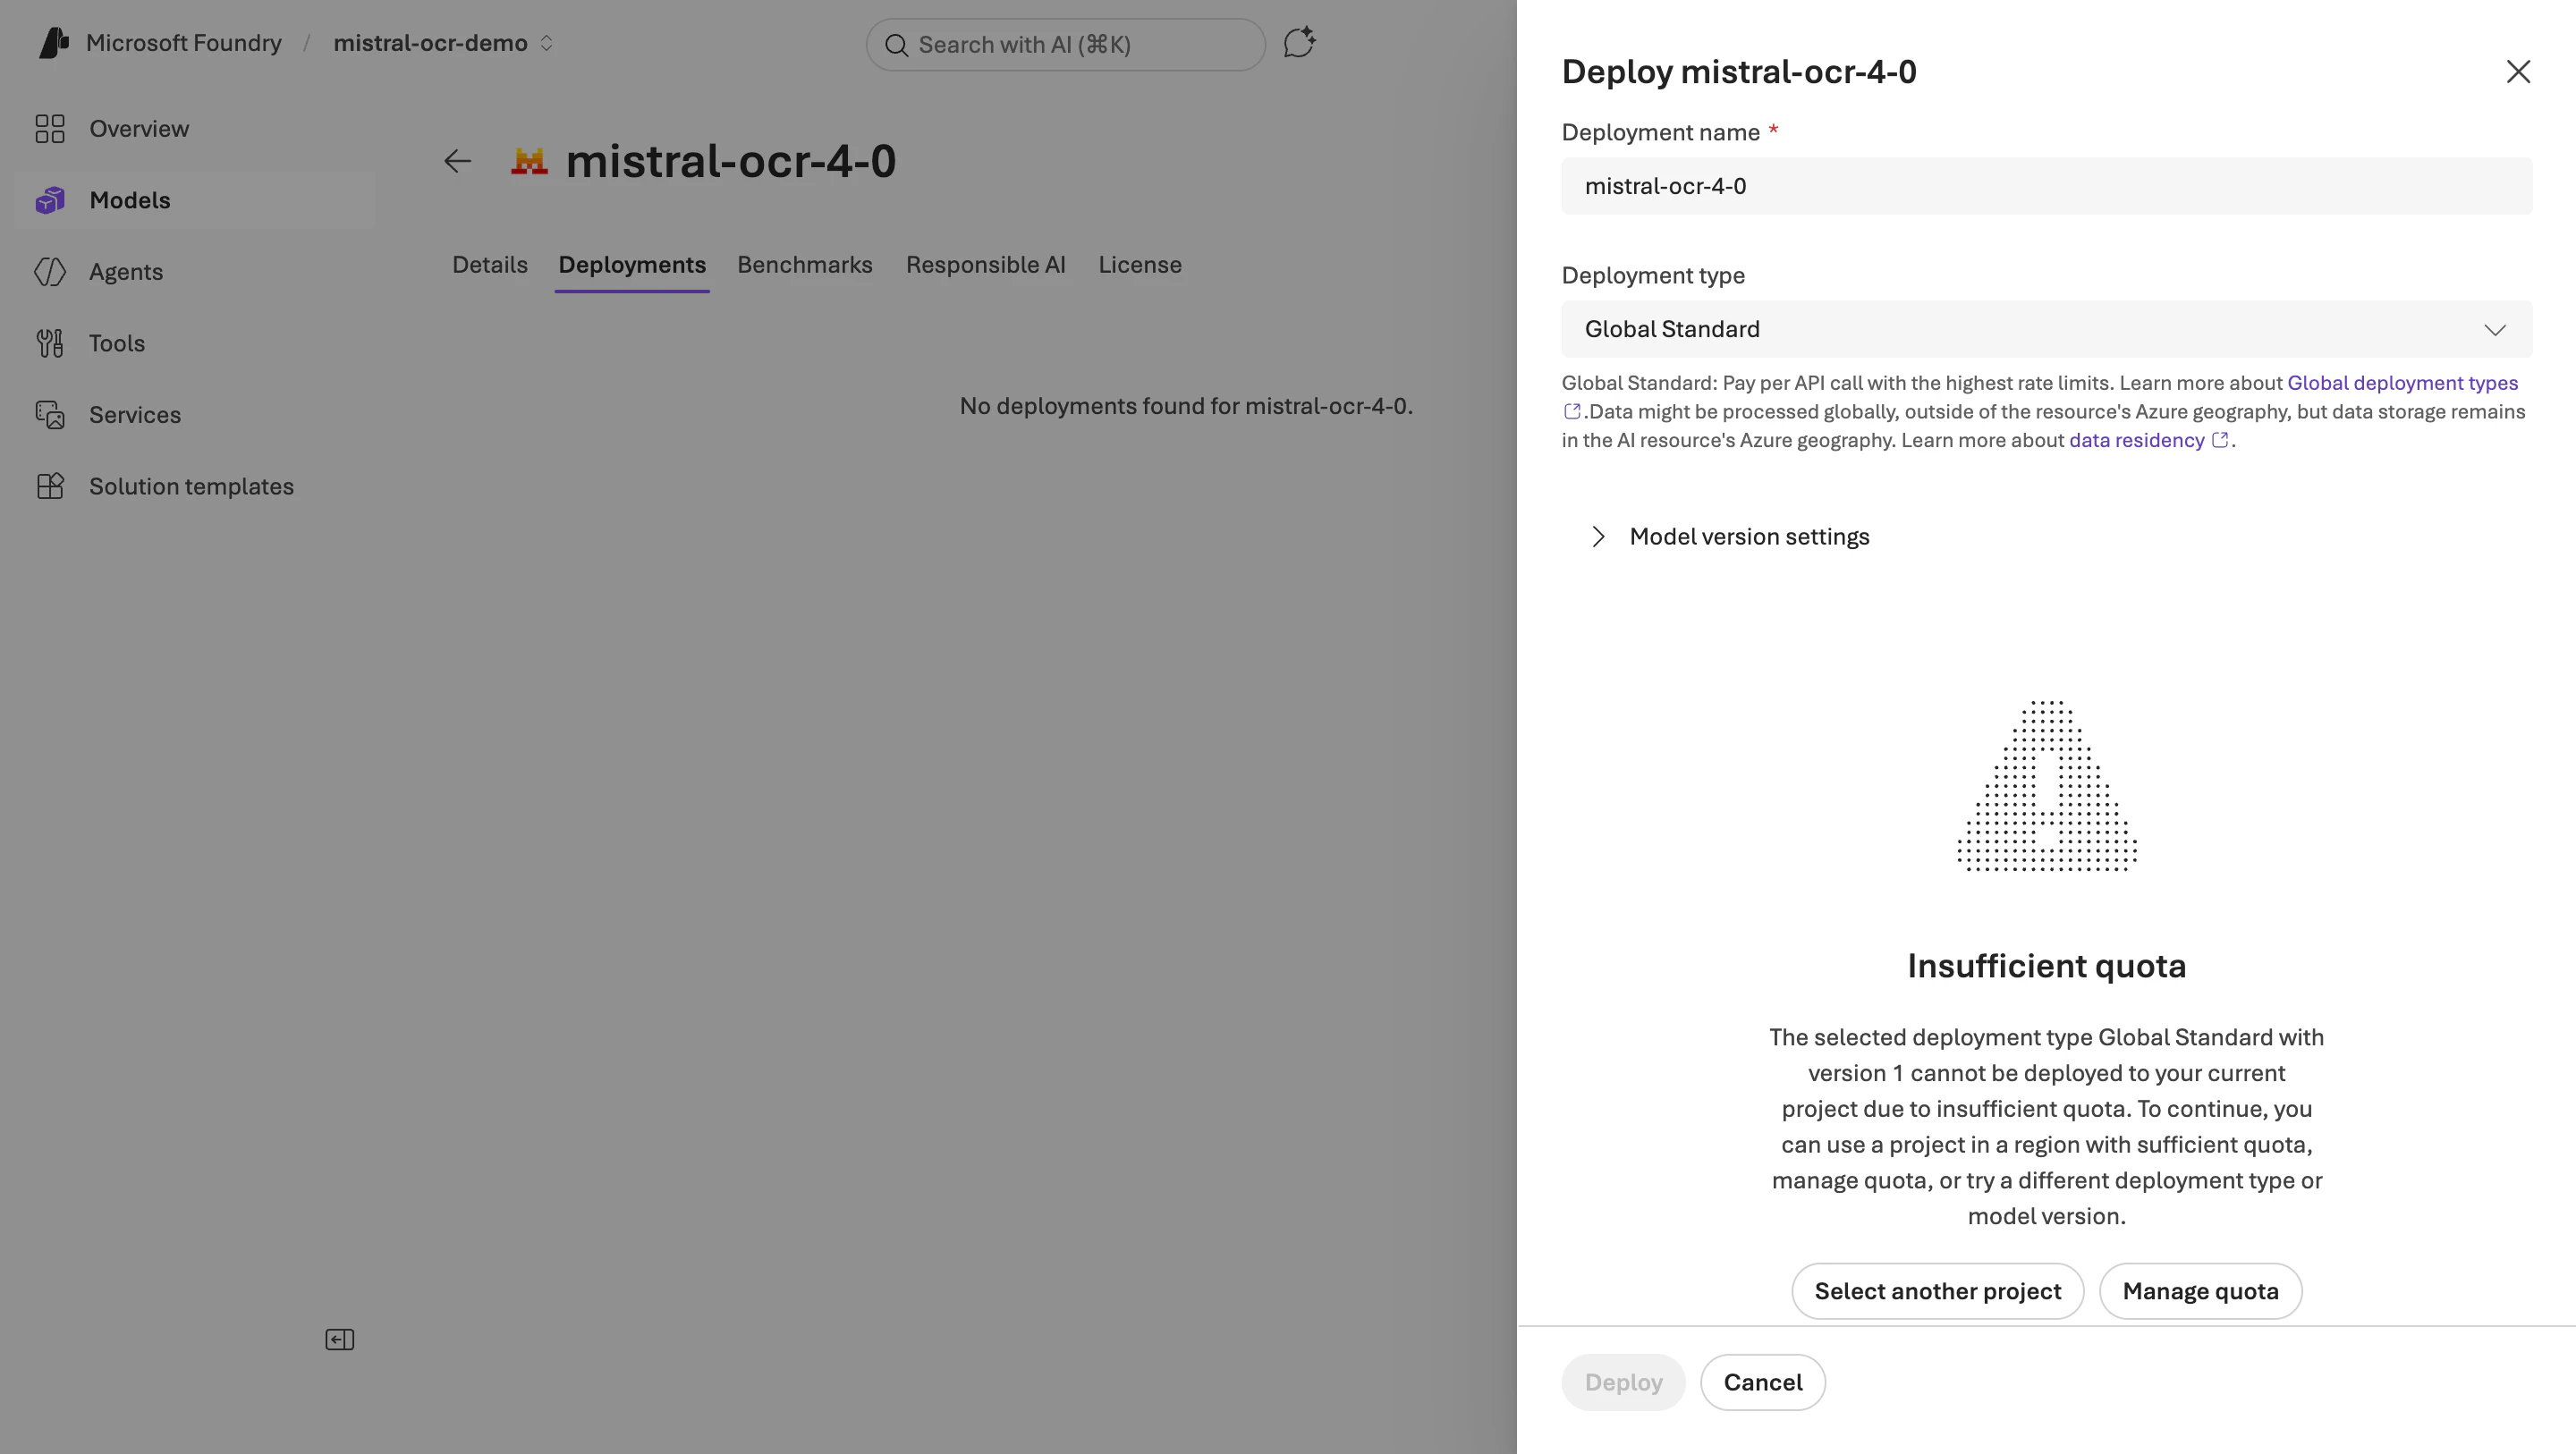
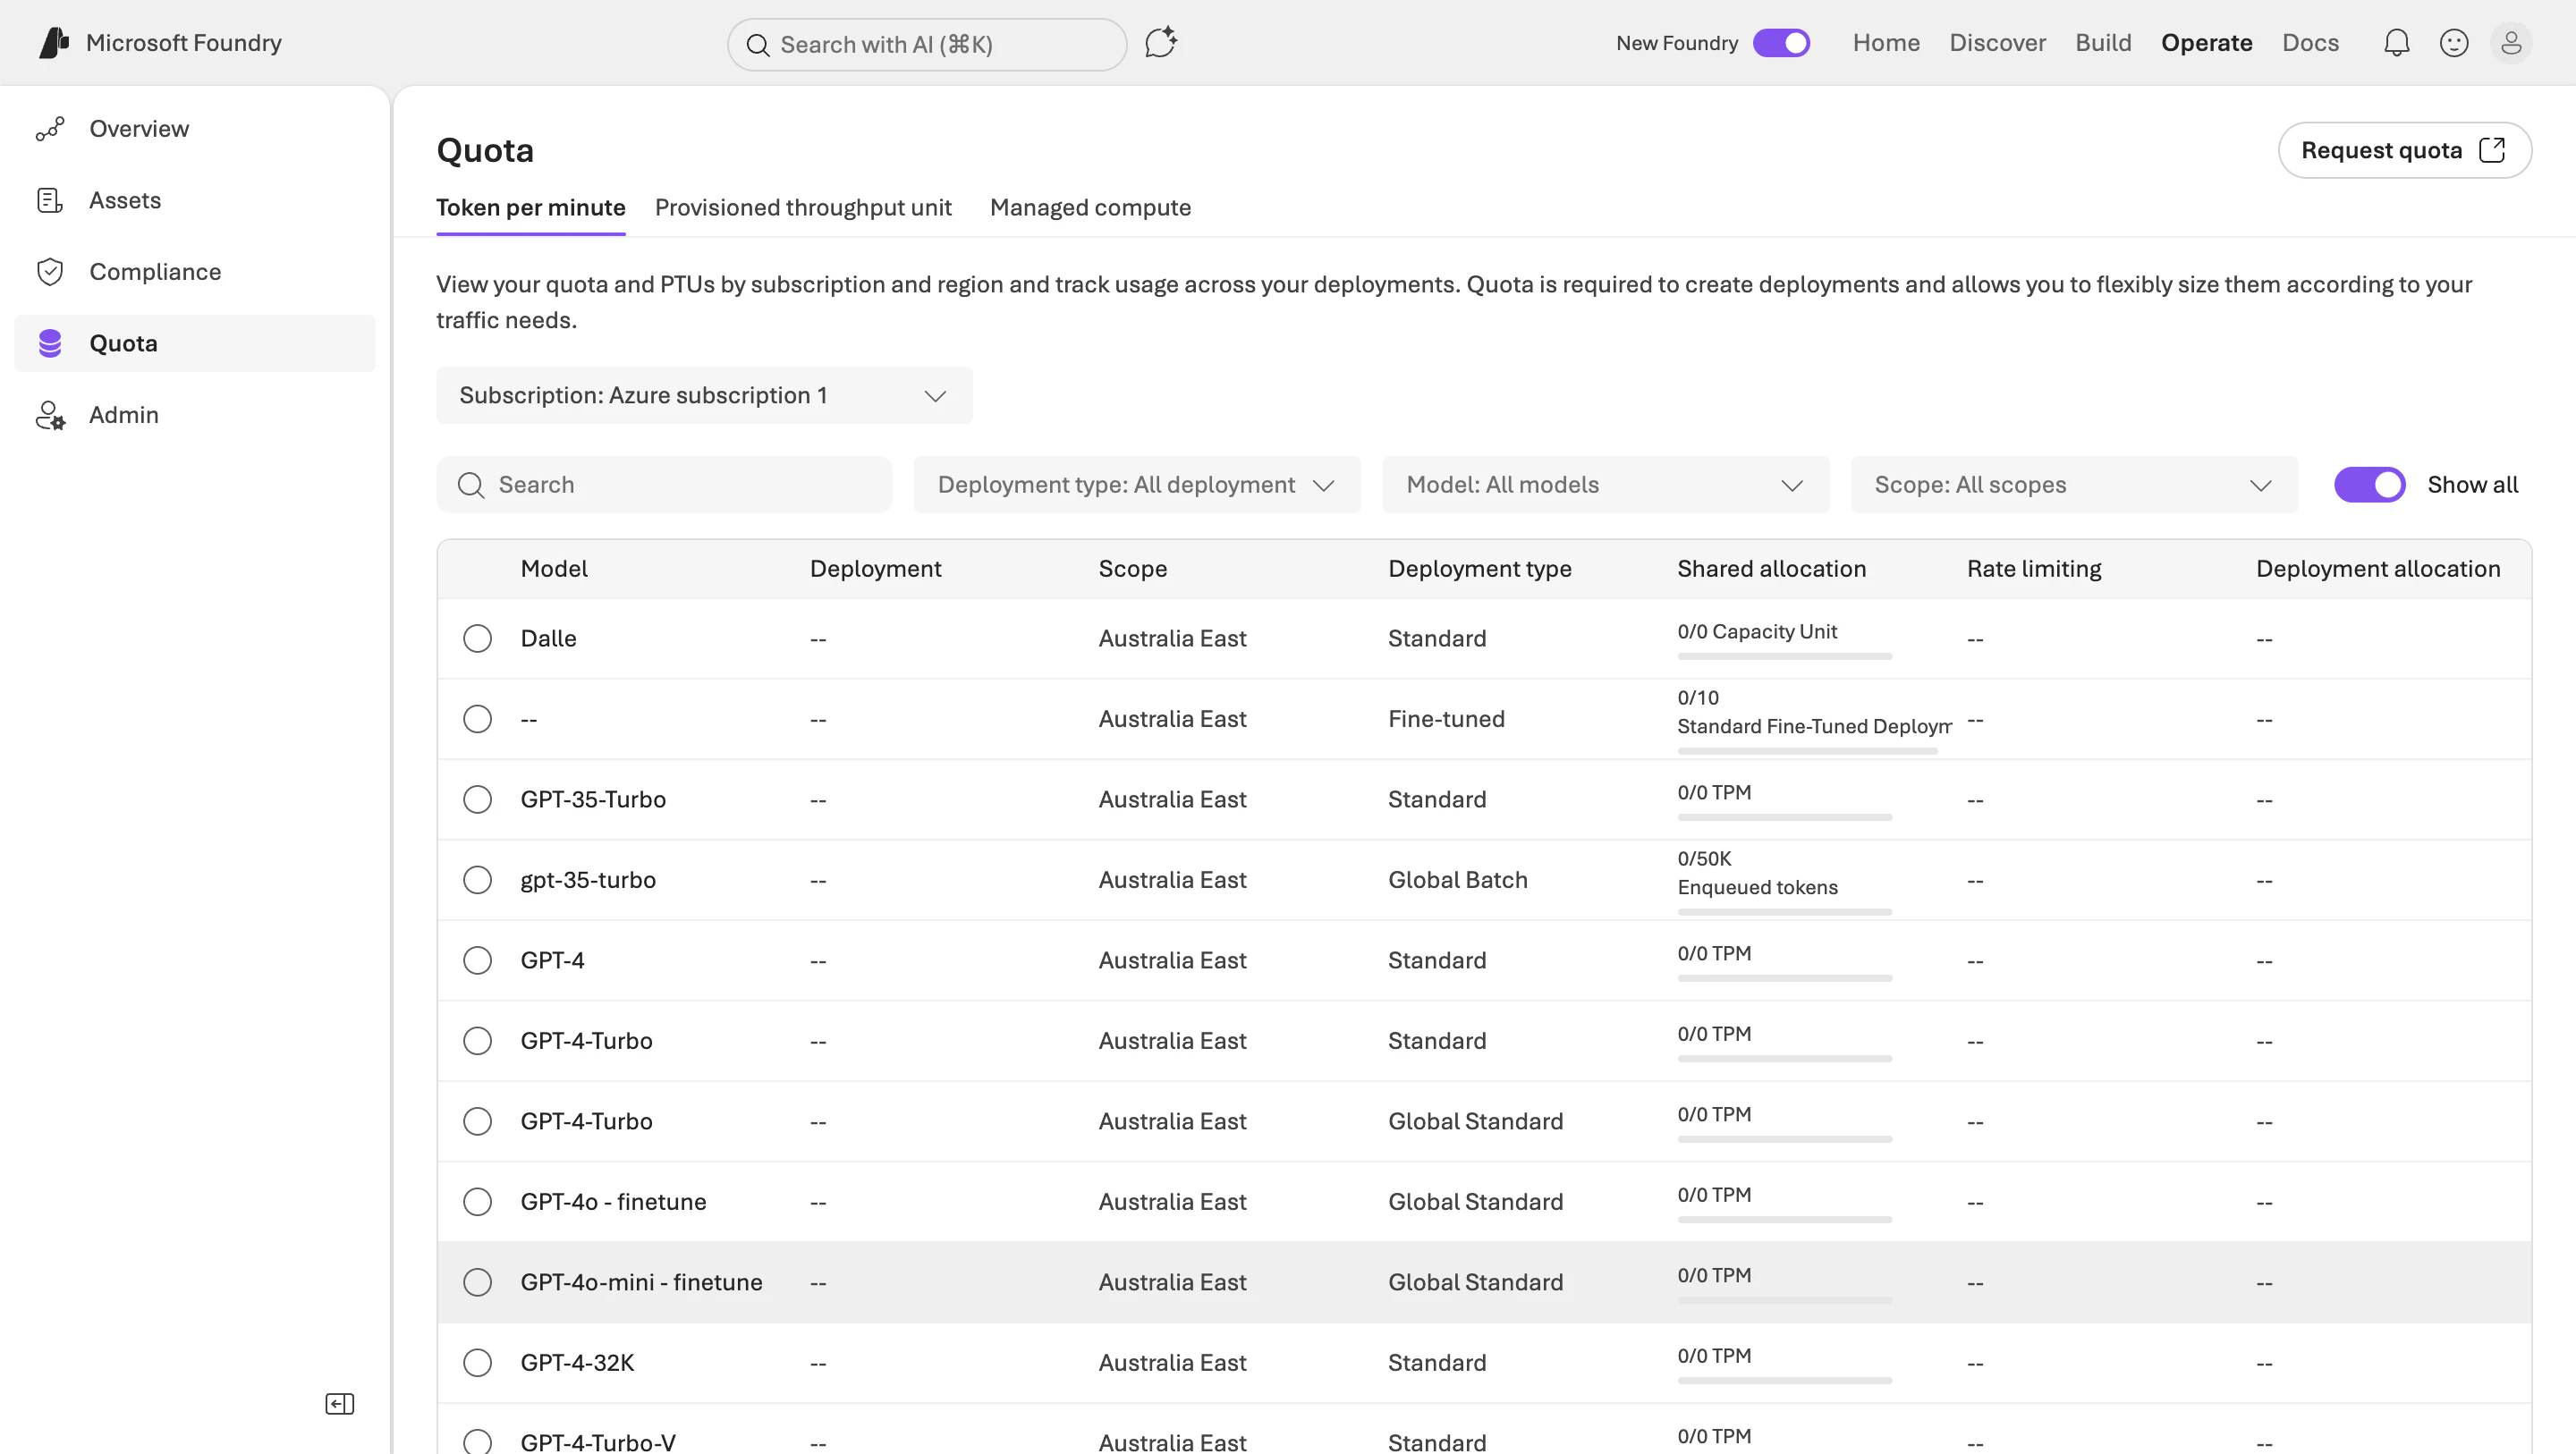
注意:無料トライアルのサブスクリプションは、モデルのquota(TPM)が全モデル 0 になっていて、1つもデプロイできません。
quota管理画面を見ると、Mistralに限らず GPT系もPhi系も、利用可能枠がすべて「0 / 0」。無料クレジットが残っていても関係ありません。
解決策:従量課金にアップグレードする
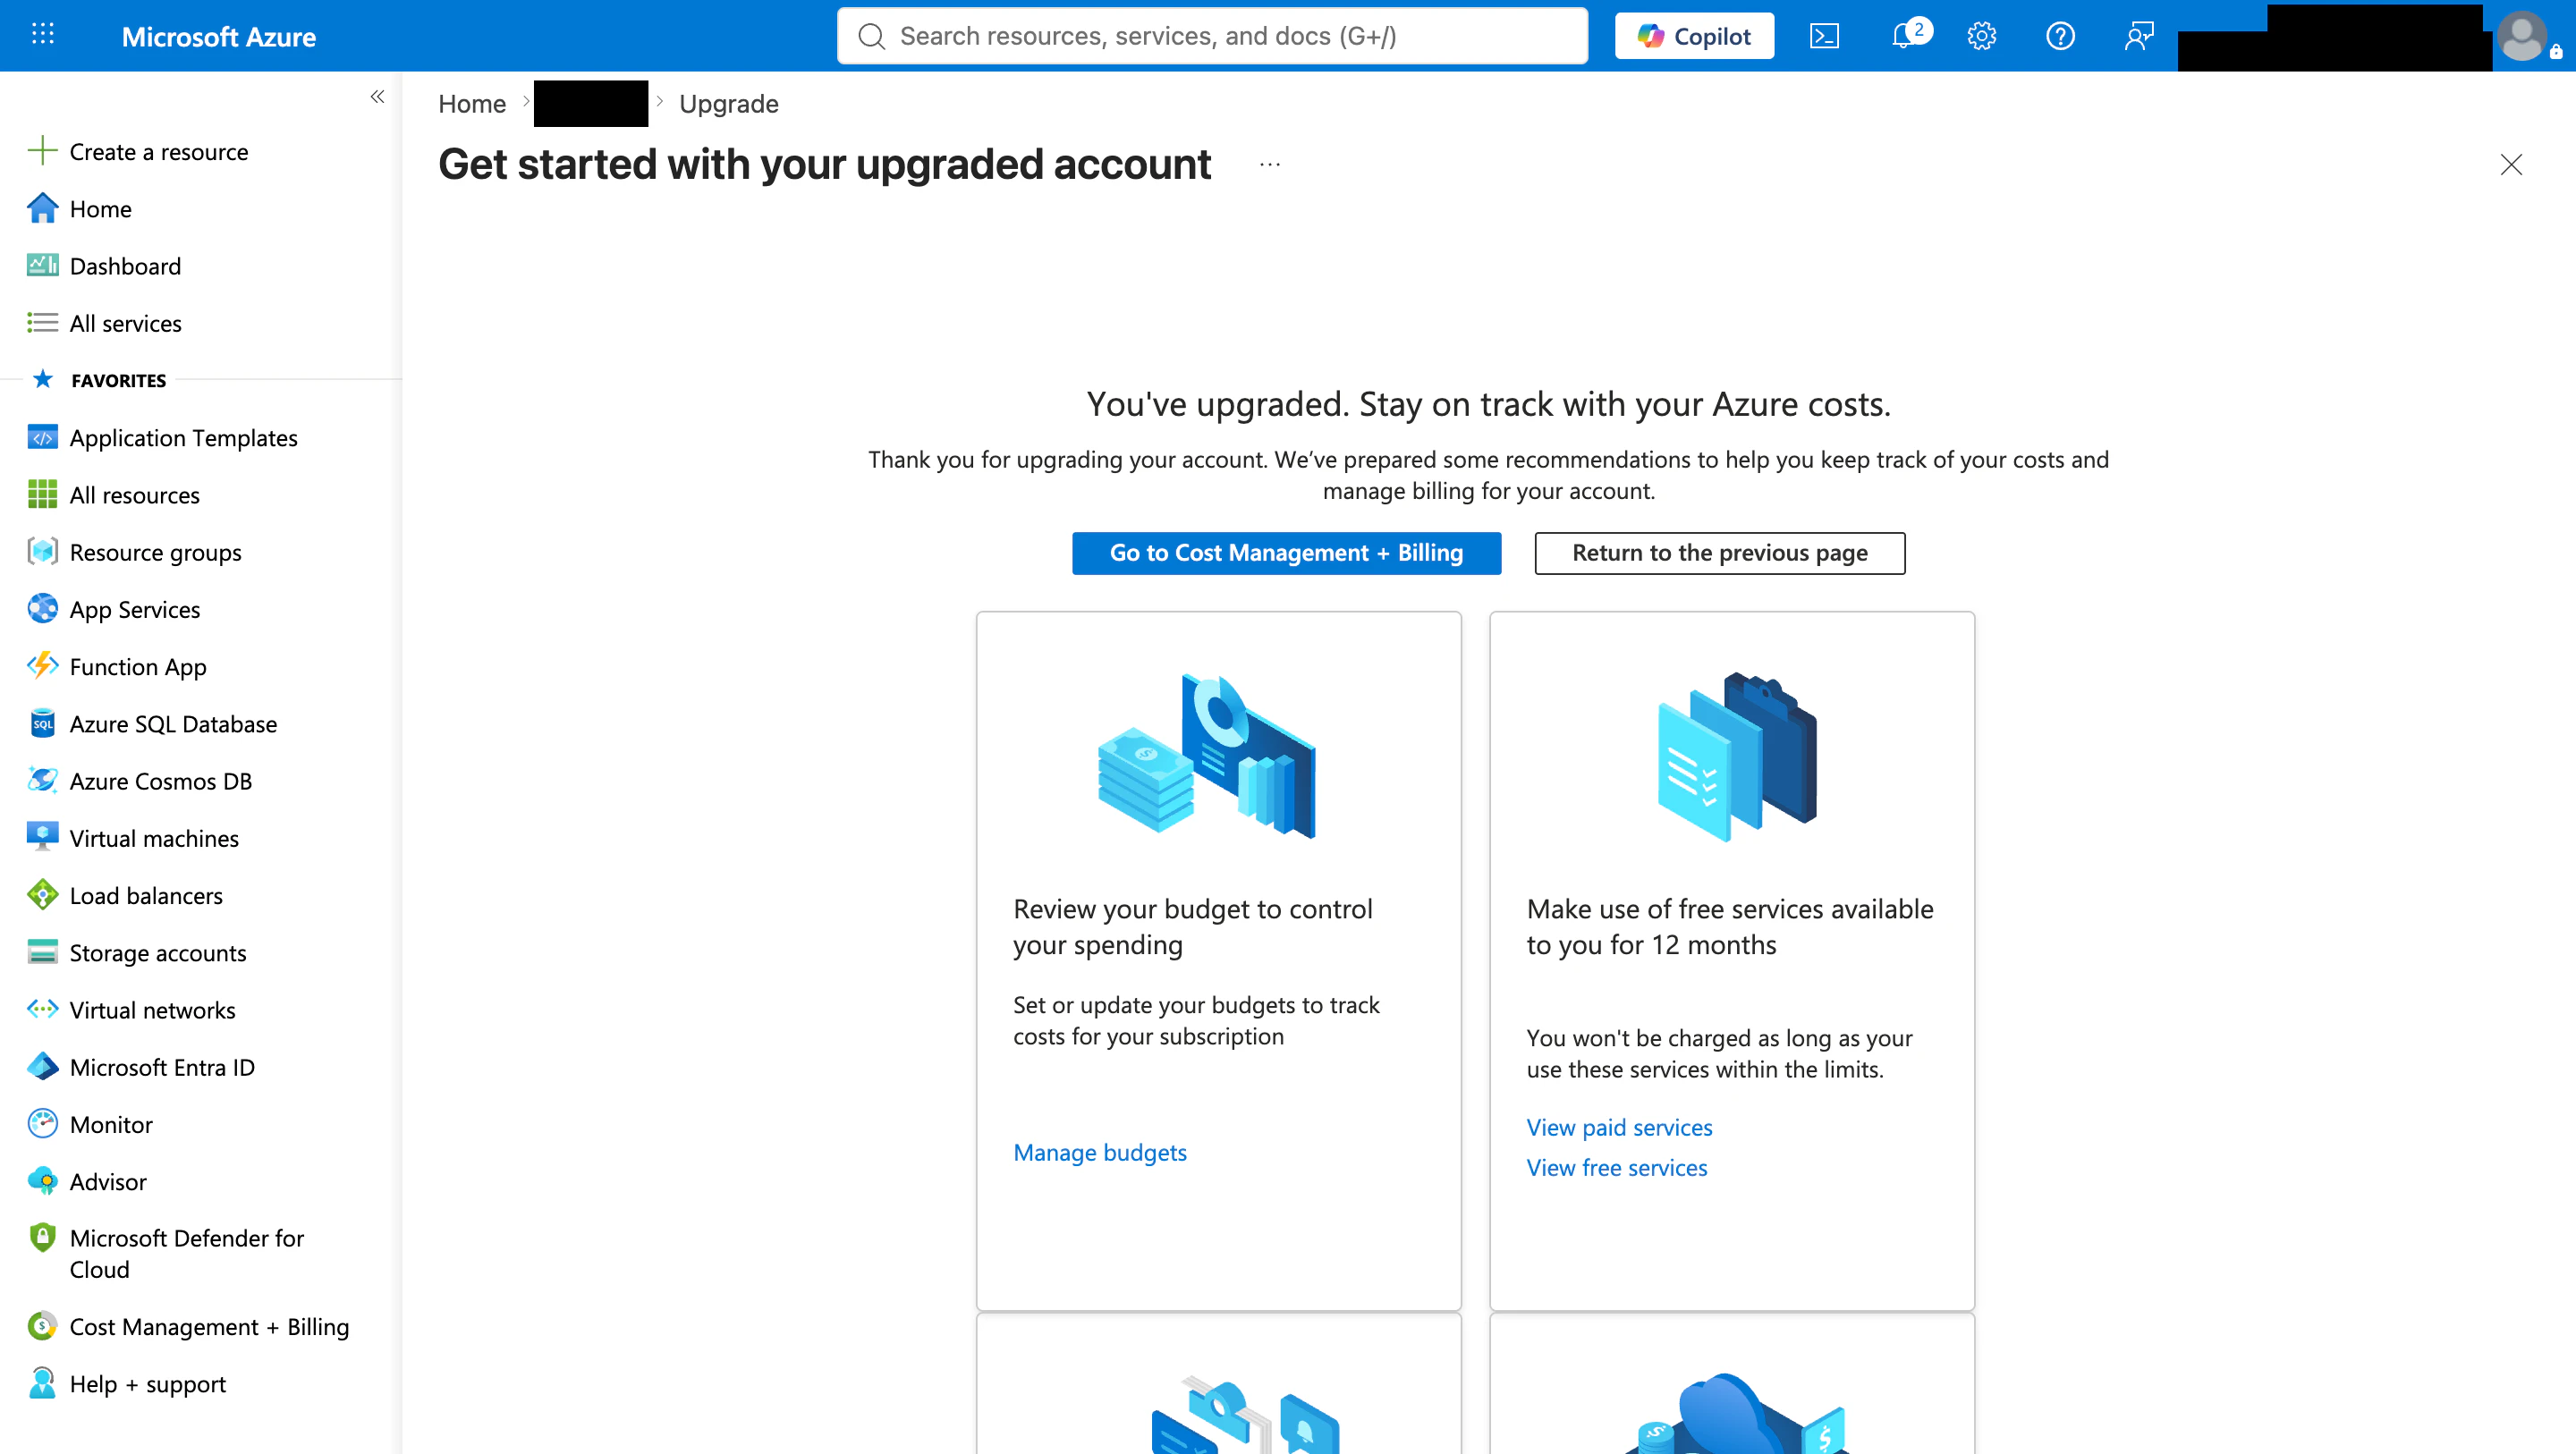
サブスクリプションを無料トライアルから従量課金制(Pay-As-You-Go)にアップグレードすると、quotaが付与されてデプロイできるようになります。
- 無料クレジットは失われません(30日の期限内はクレジットが優先消費され、実課金はクレジット切れ後)
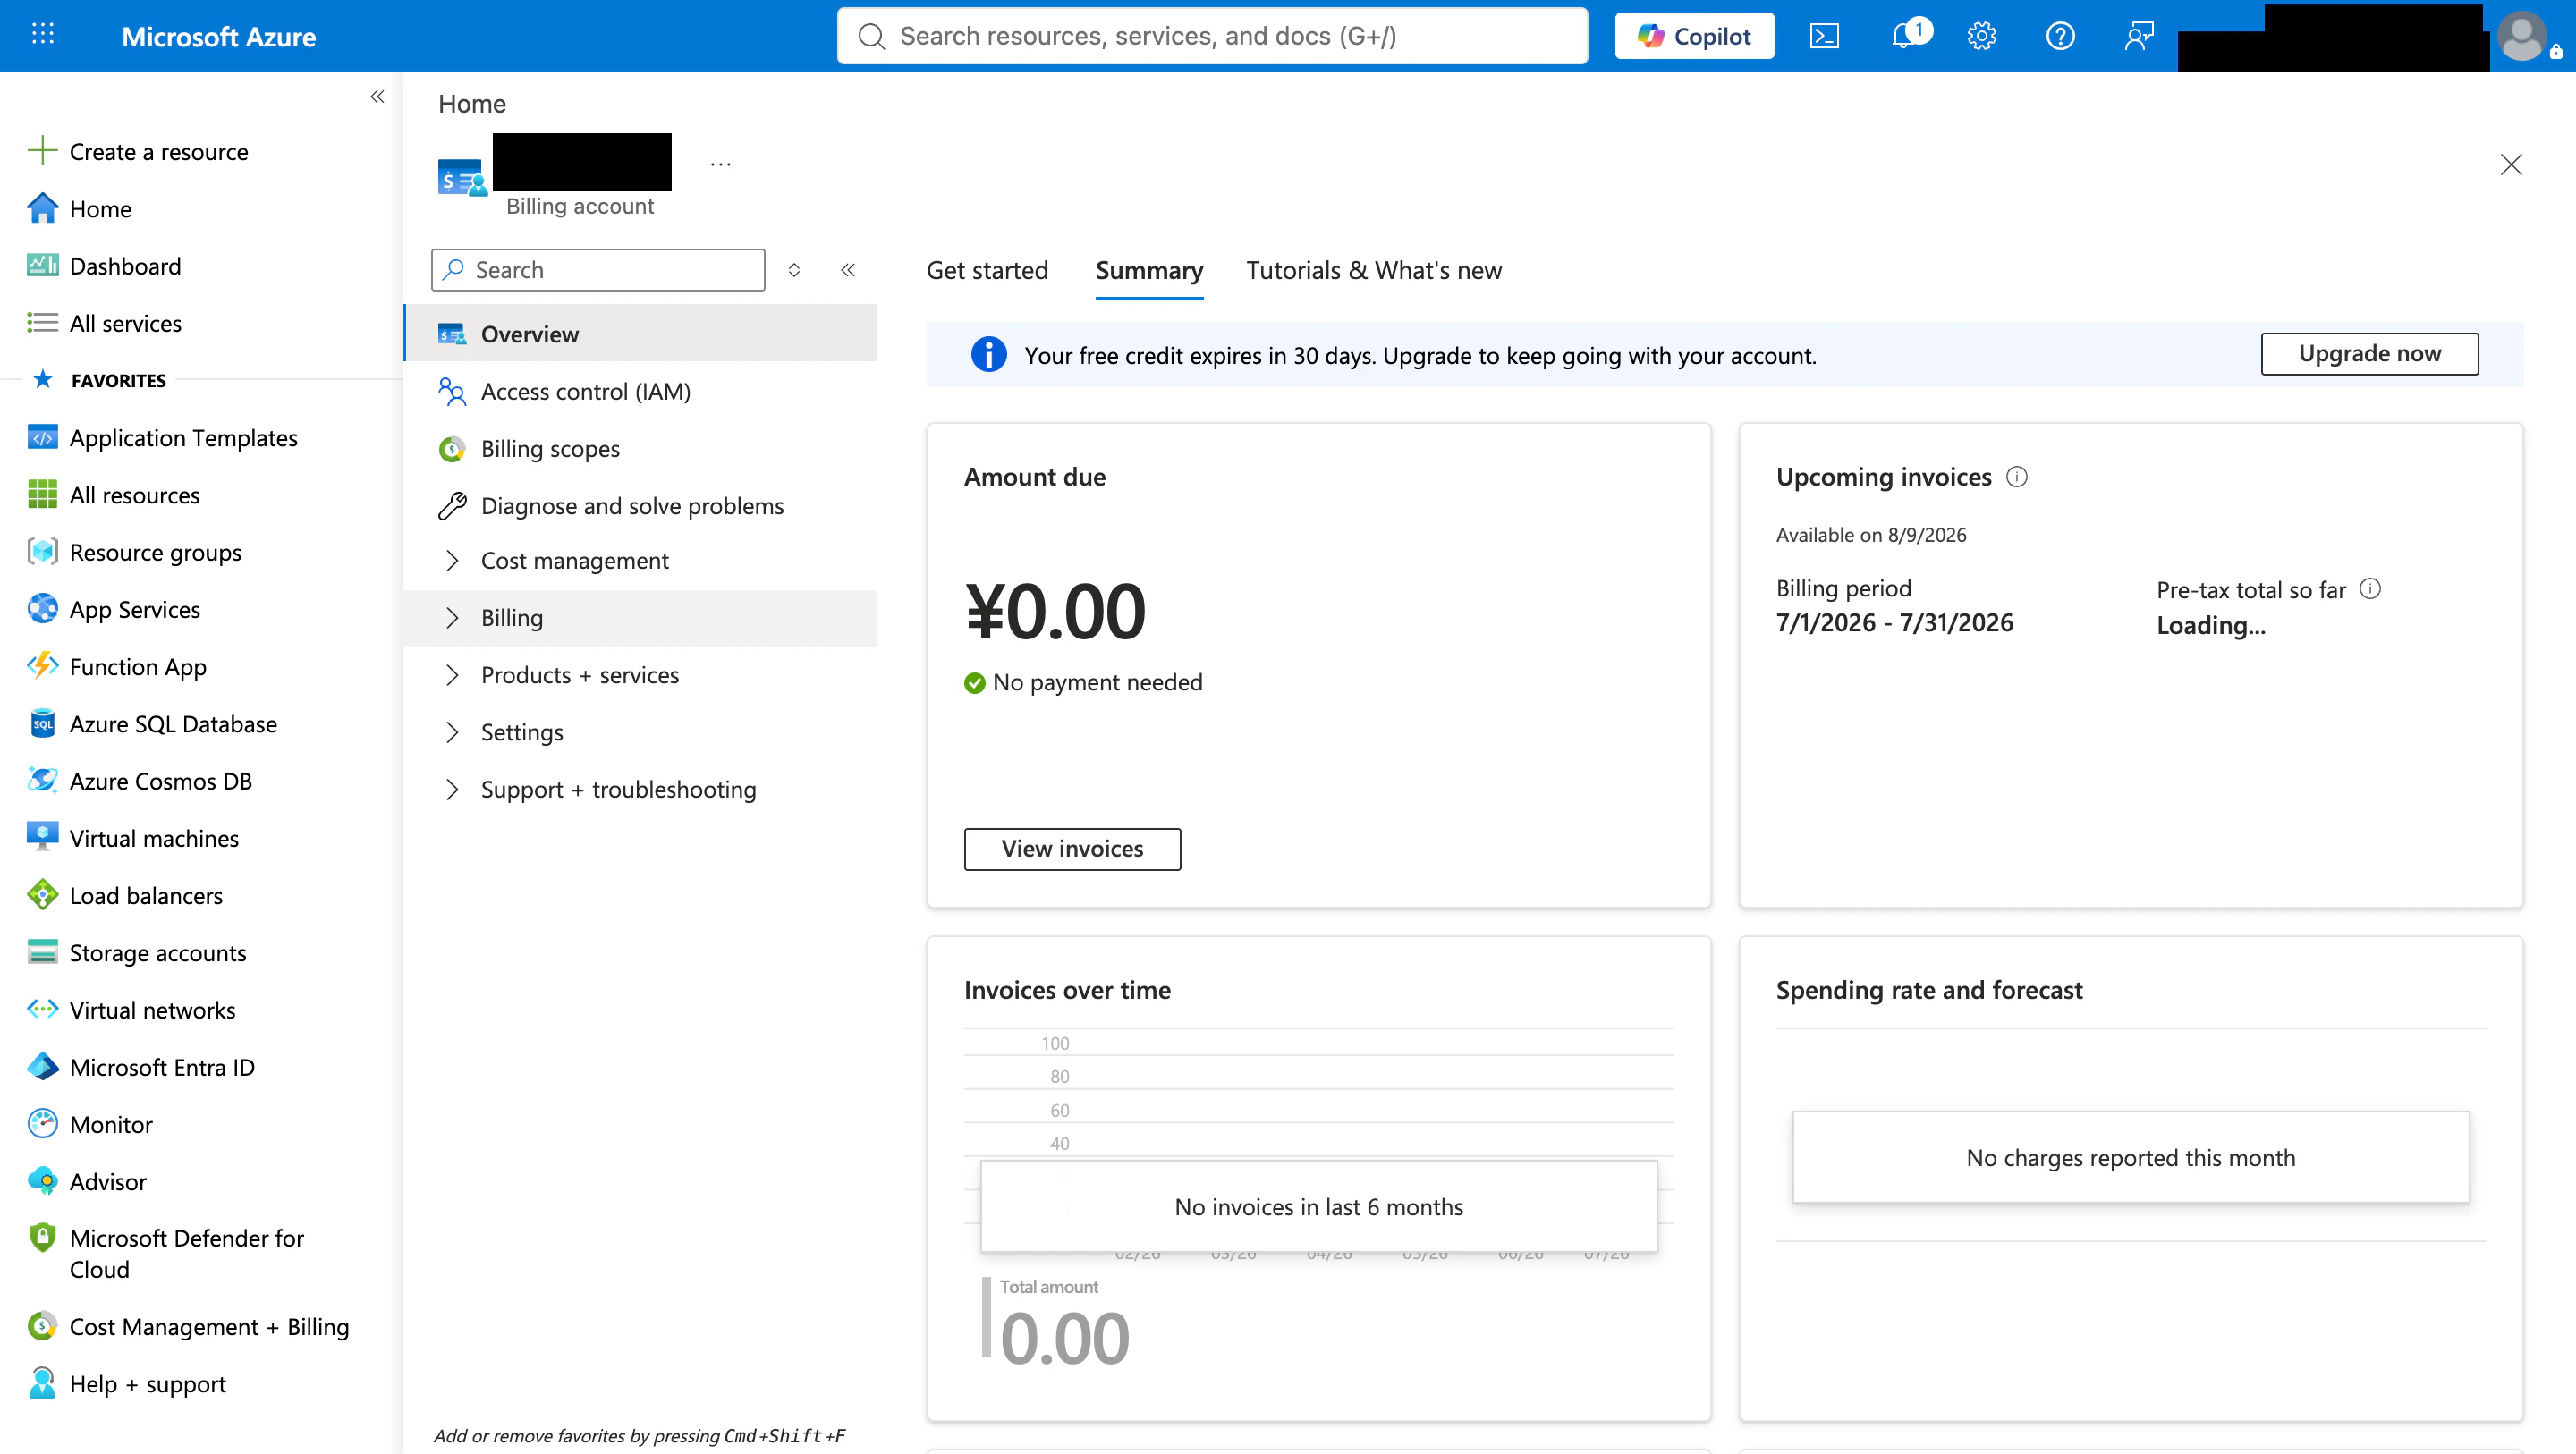
- アップグレードのボタンはサブスクリプション画面には見当たらず、「Cost Management + Billing」→ 課金アカウント → Summaryタブ の「Upgrade now」バナーから行けました
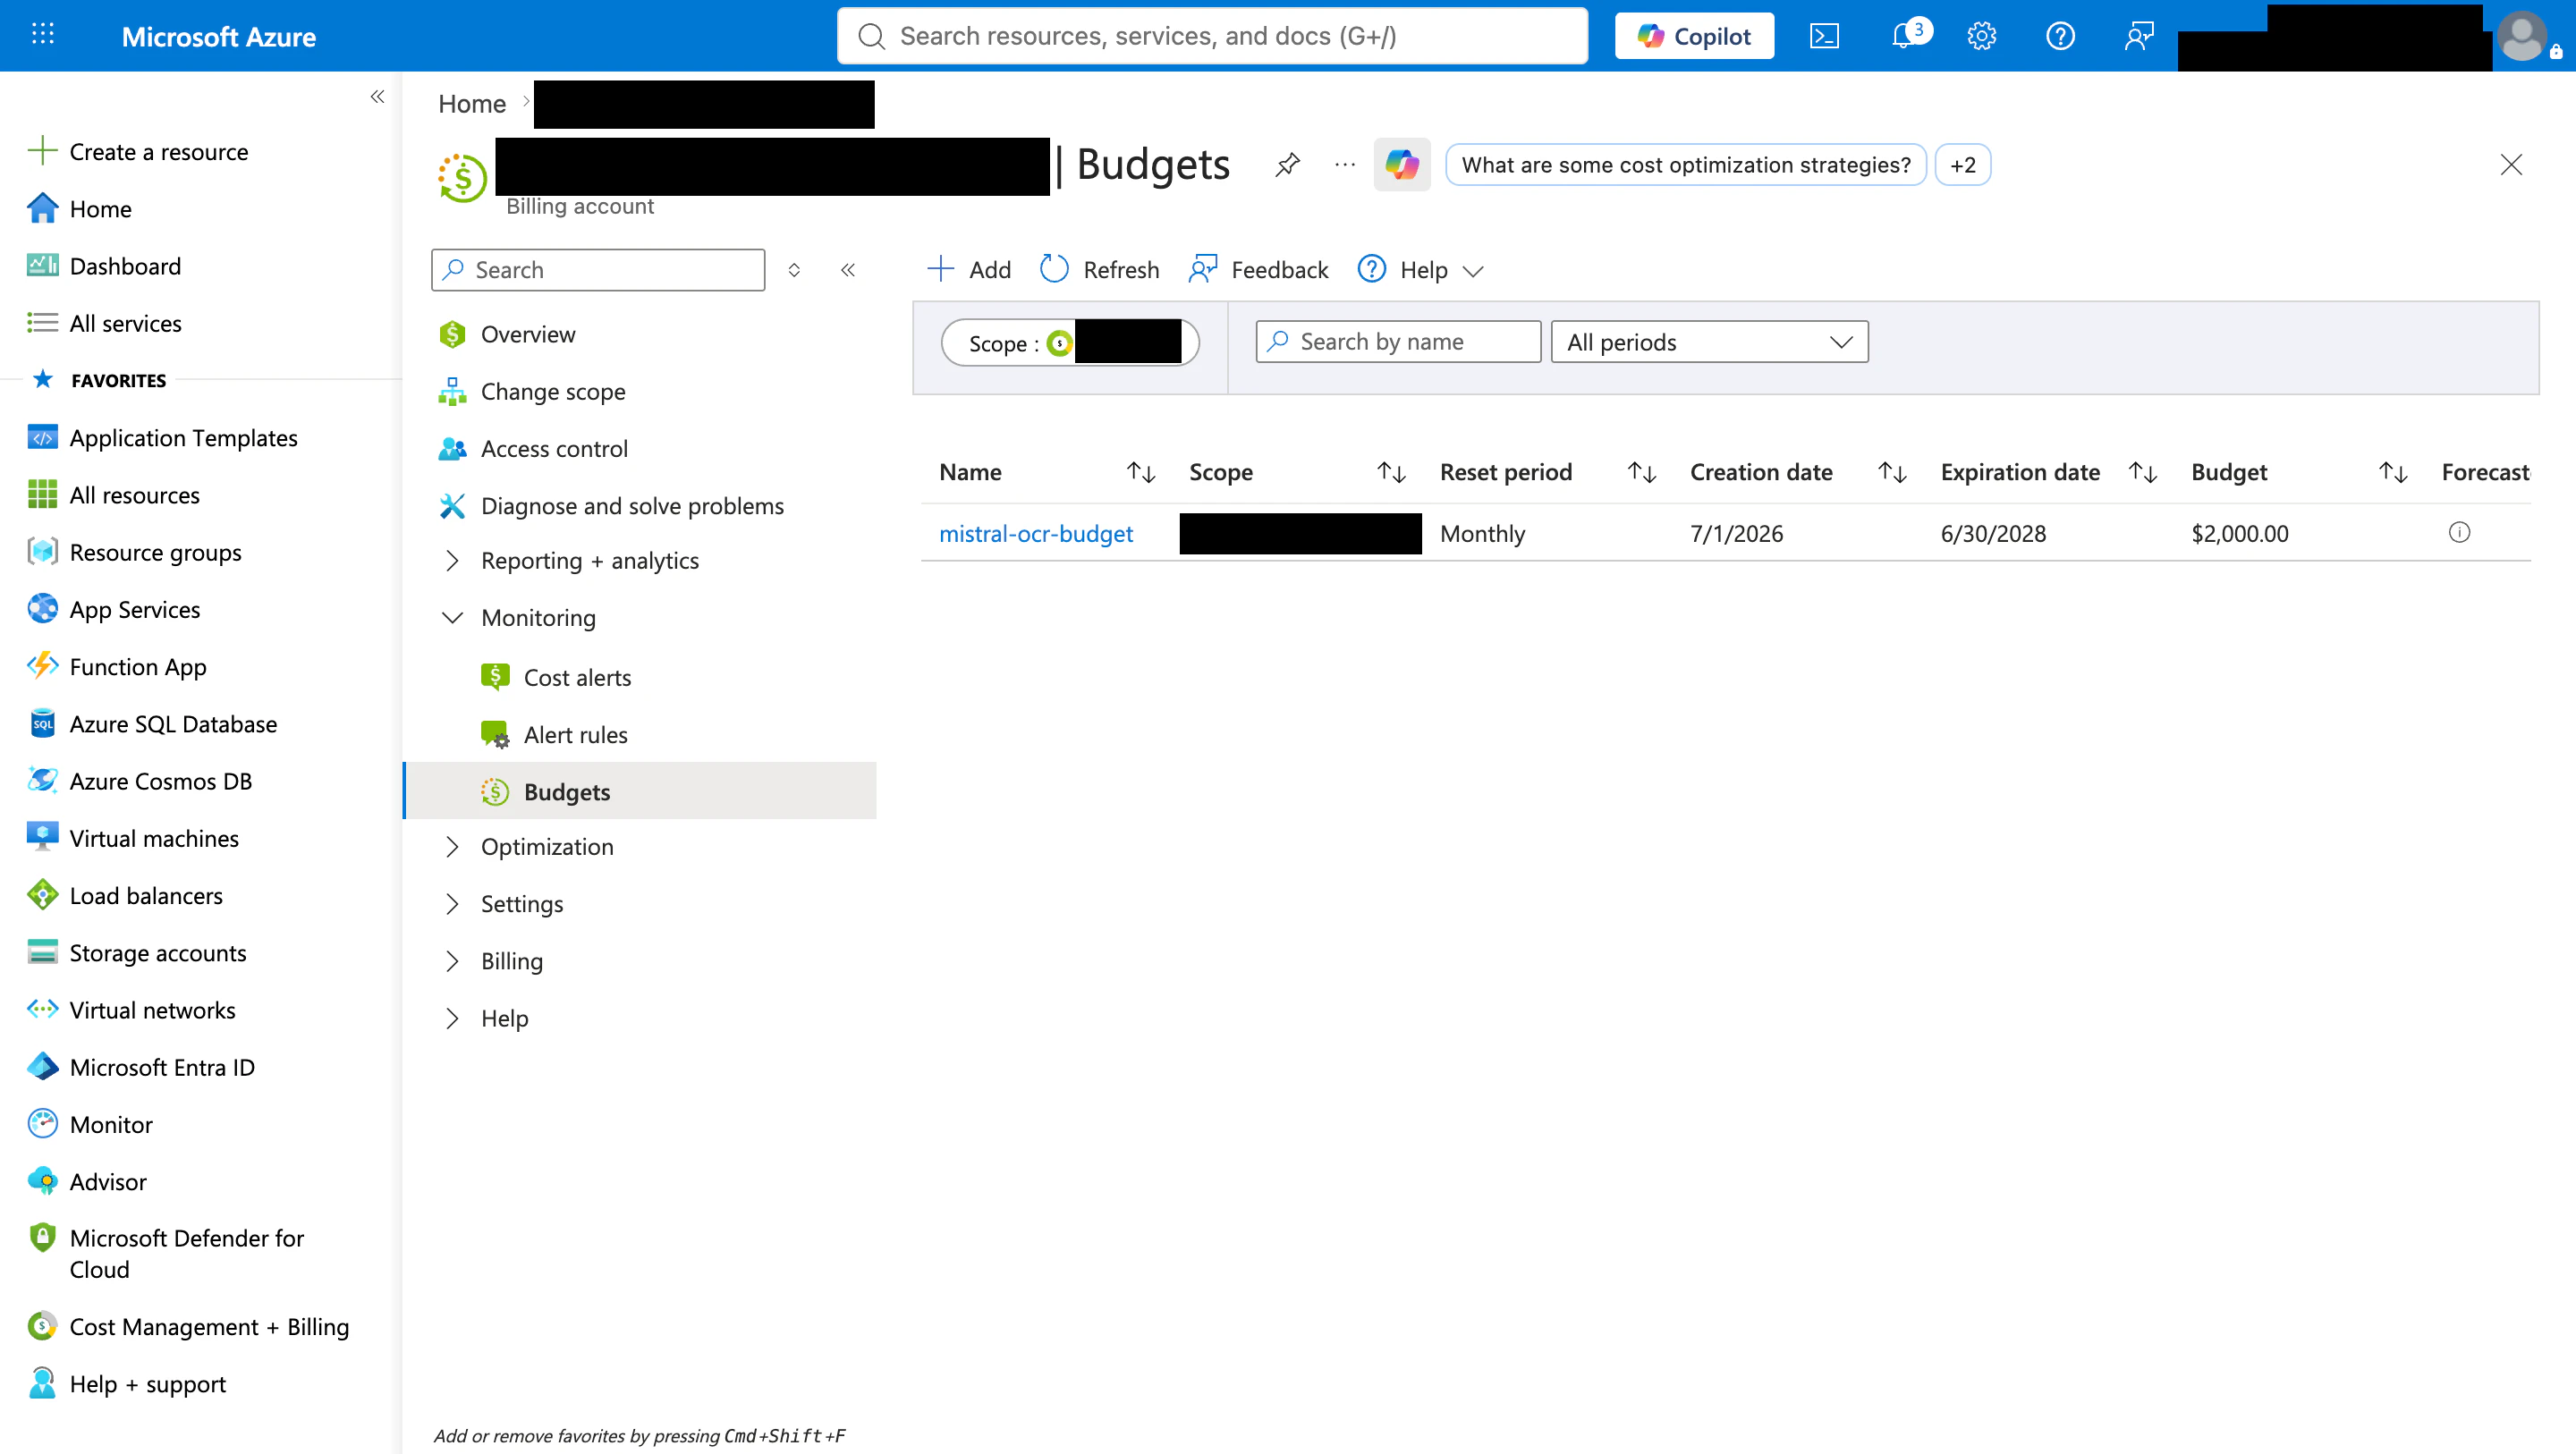
アップグレードすると実課金の可能性が生まれるので、あわせて予算アラートを設定しておくと安心です。Cost Management の「Budgets」から、月額の上限と通知しきい値(例:50%でメール)を決めます。
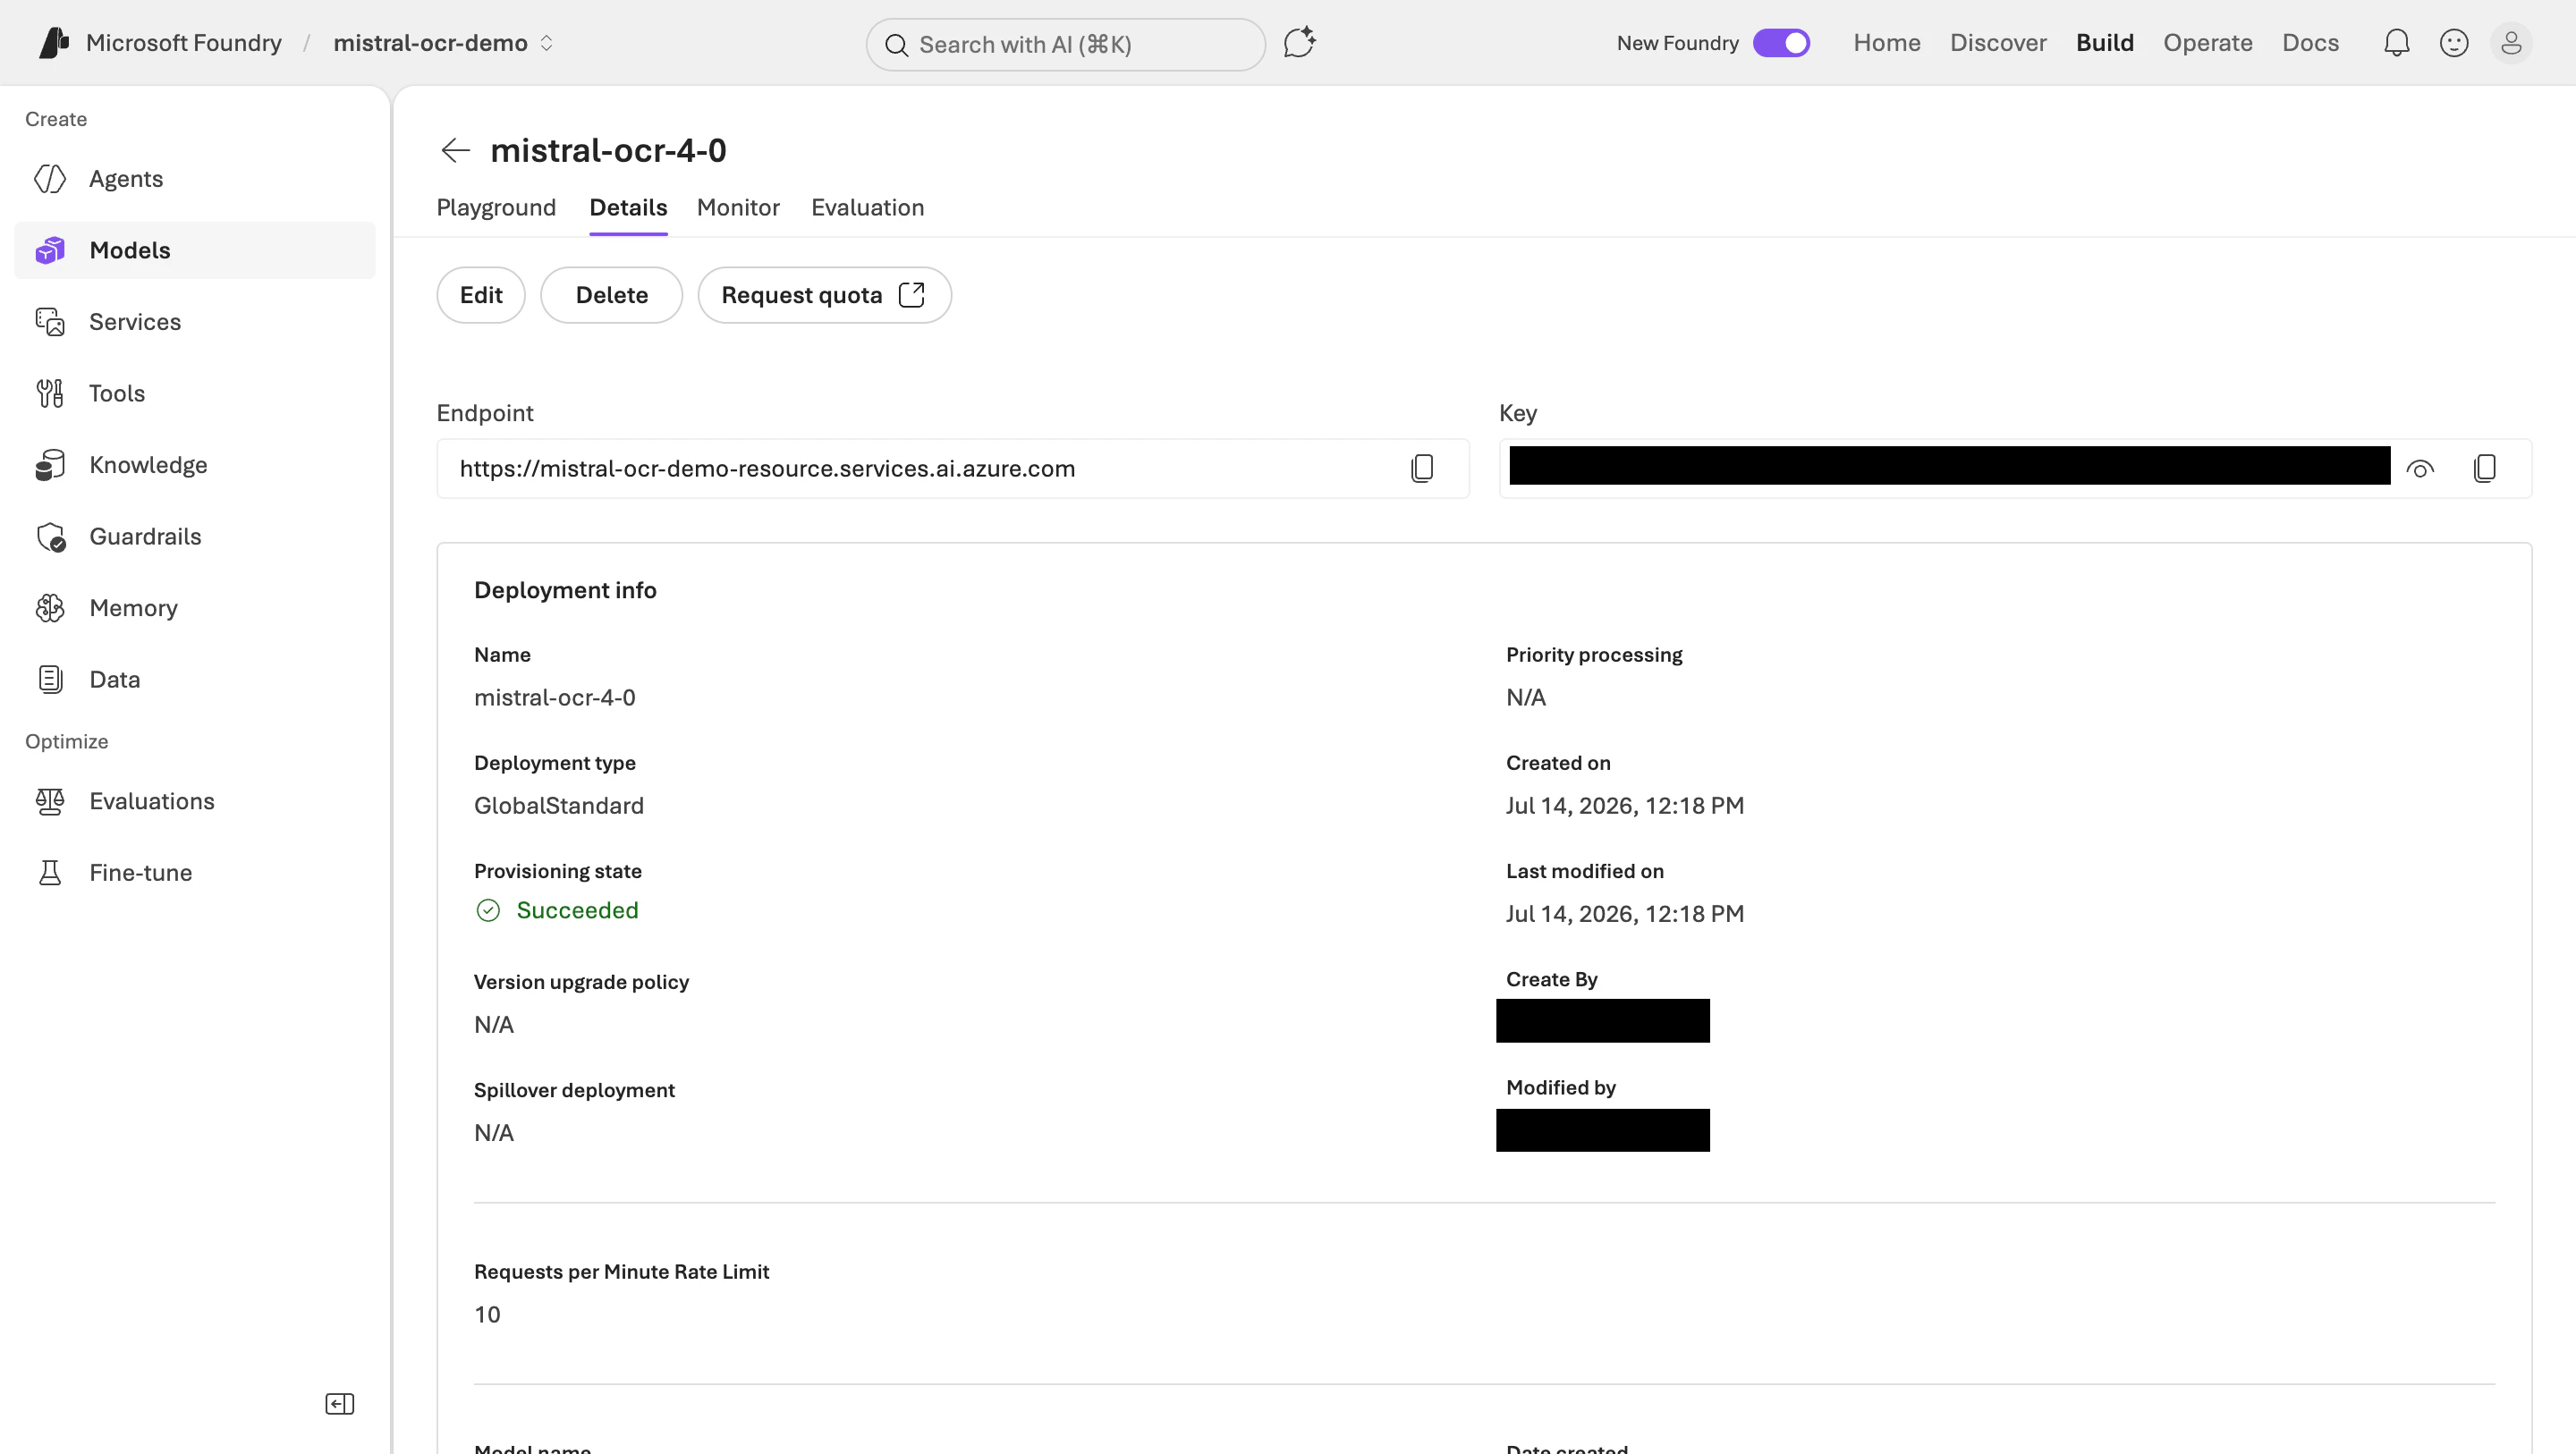
あらためてデプロイすると、今度は成功しました。デプロイの種別は GlobalStandard です。
4. API疎通 ― APIキーだけで呼べる
デプロイ詳細画面に表示されるエンドポイントとAPIキーで、すぐに呼び出せます。認証は Authorization: Bearer <APIキー> を付けるというシンプルなもの。
冒頭で紹介した @Rambosan さんの記事は、業務のデスクトップアプリにAPIキーを埋め込めないという要件からEntraID認証を構成されていますのでそちらもぜひご覧ください。サーバーサイドやバッチ処理でキーを安全に管理できるなら、APIキーだけで動くので検証はすぐ始められます。
curl -s "https://<リソース名>.services.ai.azure.com/providers/mistral/azure/ocr" \
  -H "Authorization: Bearer $AZURE_MISTRAL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-ocr-4-0",
    "document": {"type": "image_url", "image_url": "data:image/jpeg;base64,..."}
  }'
レスポンスはこんな構造です。pages[].markdown に、レイアウトをmarkdownとして保持したテキストが入ってきます。
{
  "pages": [{"index": 0, "markdown": "# 作業日報\n\n...", "images": [...], "tables": [...]}],
  "model": "mistral-ocr-4-0",
  "document_annotation": null,
  "usage_info": {"pages_processed": 1}
}
5. ベンチマーク ― 前回とまったく同じ条件で
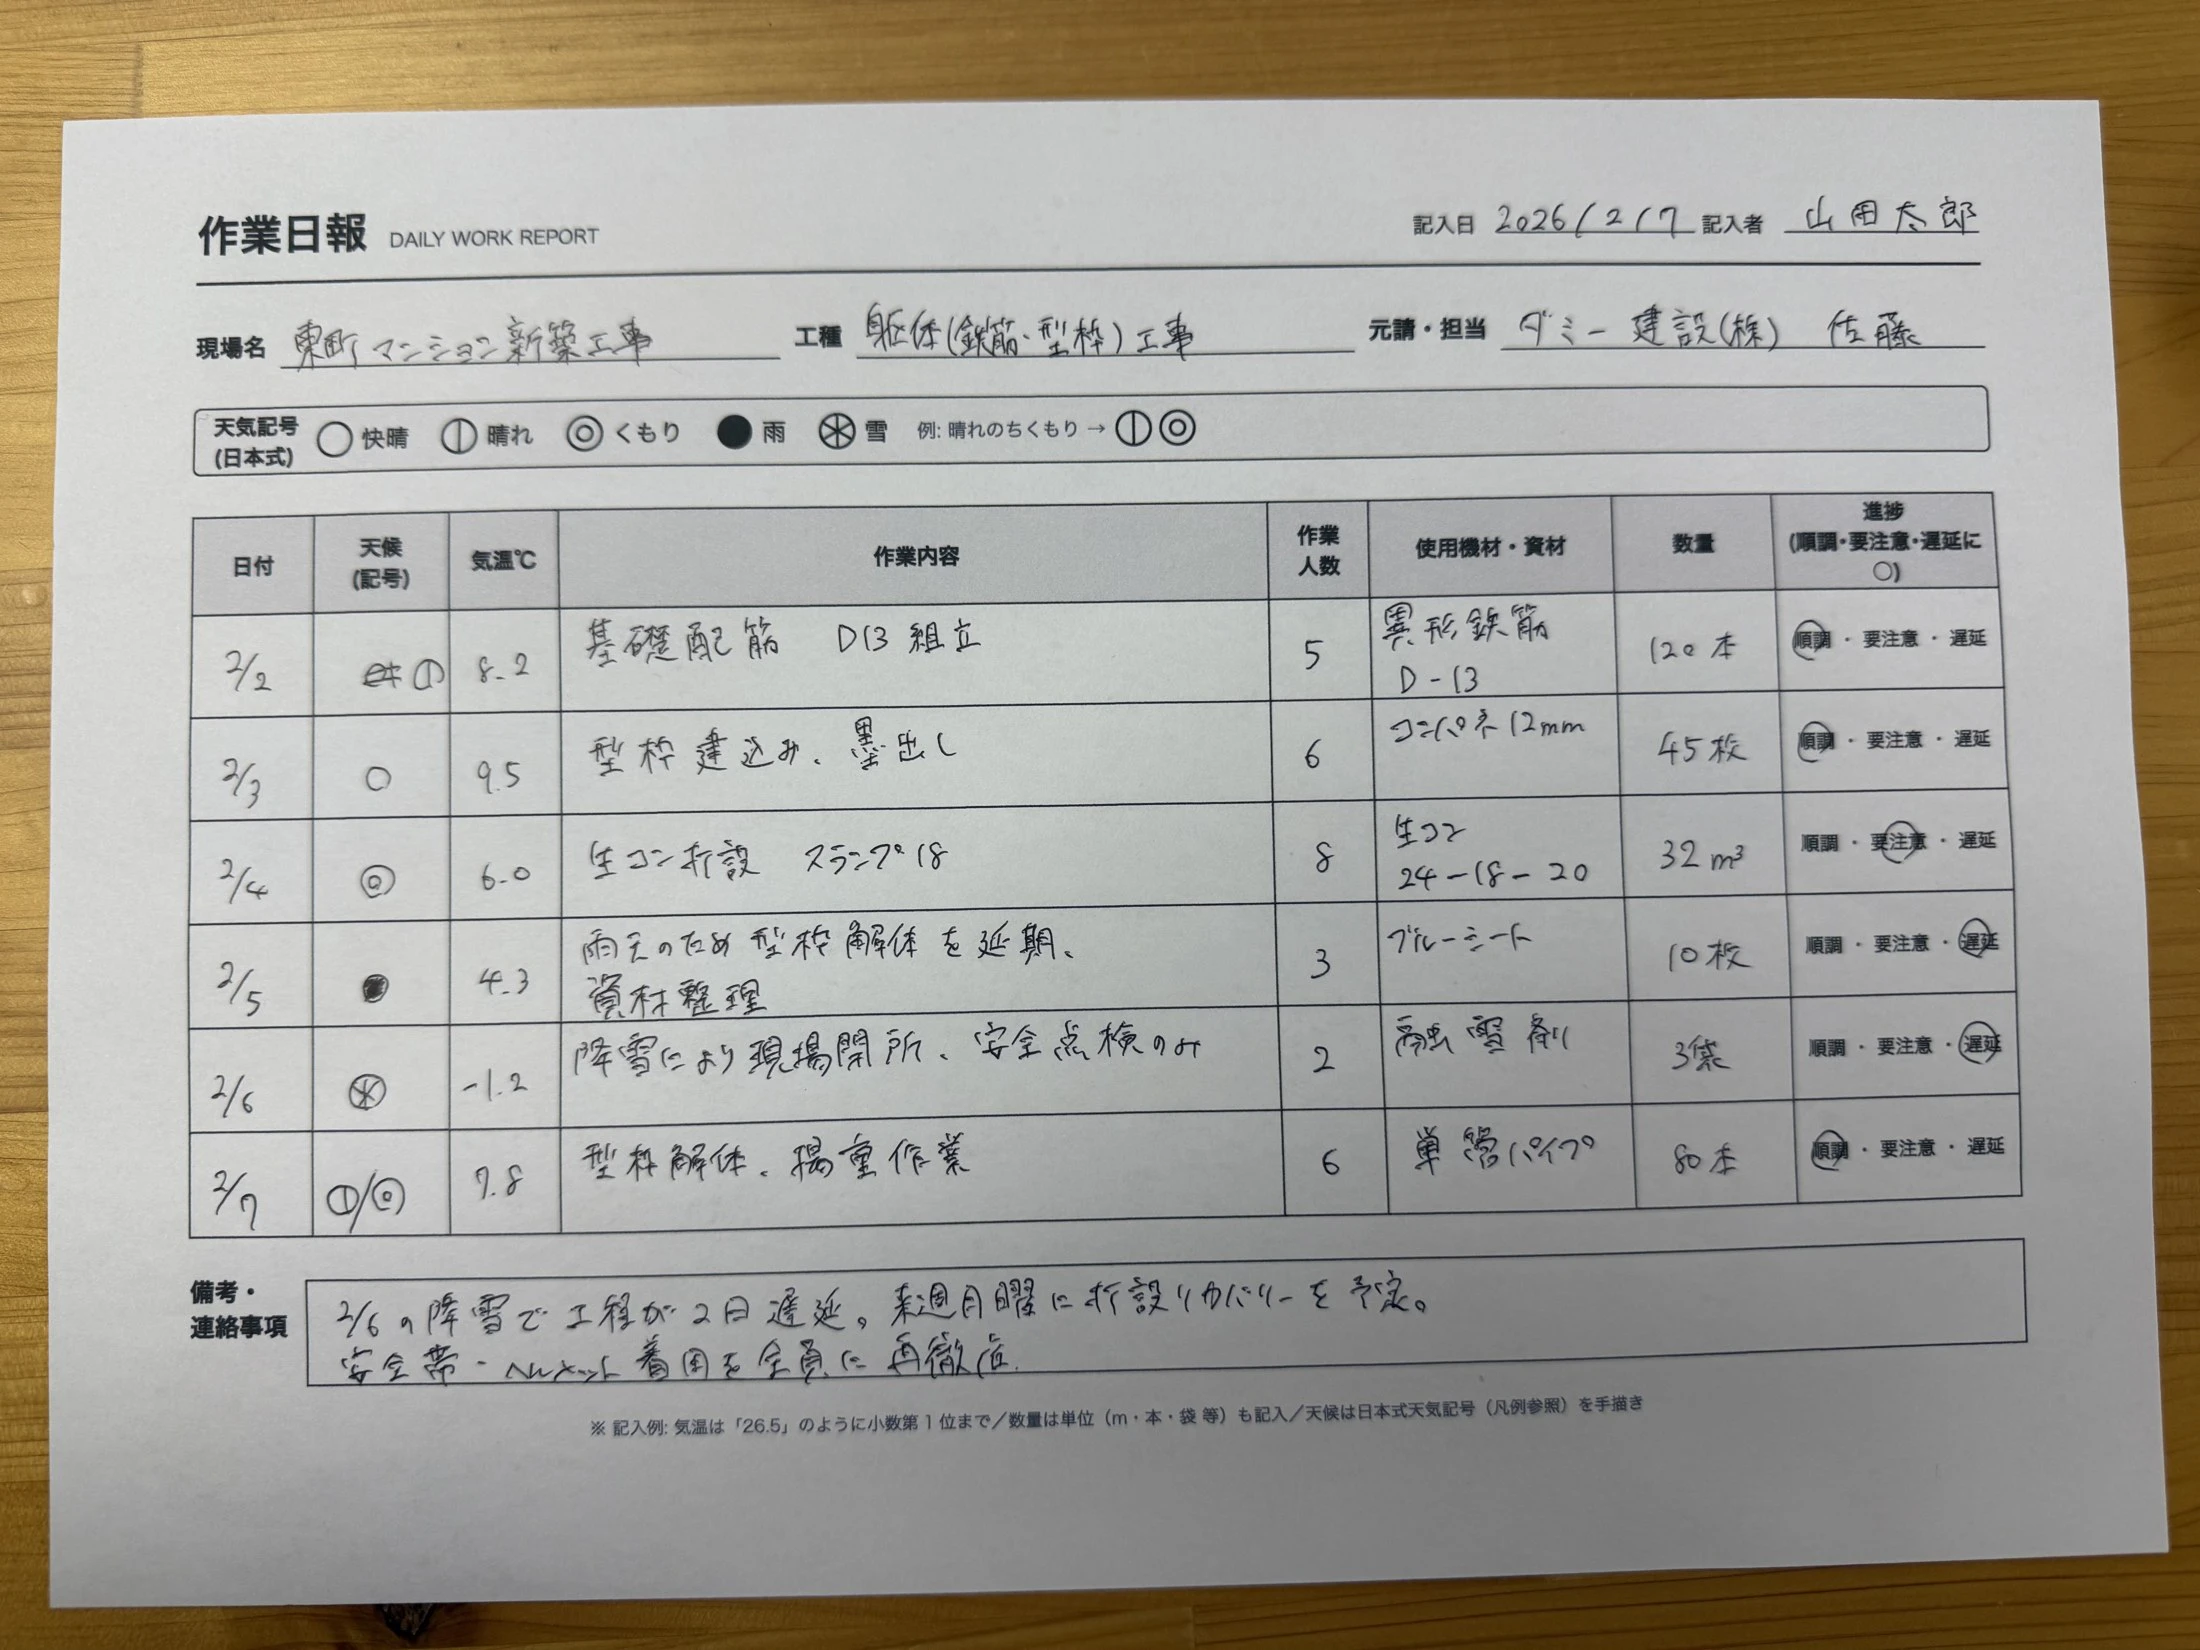
読ませるのは前回と同じく、建設現場の手書き作業日報(記載内容はすべて架空)です。日本式天気記号、気象庁の区切り表記(/=のち)、二重線の訂正跡、○囲みの進捗欄など、OCRの実力差が出るよう"難所"を仕込んであります。詳細は前回の記事をご覧ください。
Mistral OCR にプロンプトはない ― 指示はスキーマのdescriptionに書く
前回の3モデルはchat APIなので「天気記号を名称に変換して」とプロンプトで指示しました。Mistral OCR 4 のAPIにchat型のプロンプトはありません。構造化抽出は document_annotation_format にJSONスキーマを渡す方式で、指示は各フィールドの description に埋め込みます。前回のプロンプトと同じ内容(天気記号の変換規約・訂正の扱い)をdescriptionに書いて、条件を揃えました。
WEATHER_DESC = (
    "日本式天気記号を天気の名称に変換: ○=快晴/○に縦棒=晴れ/◎=くもり/●=雨/結晶マーク=雪。"
    "記号間の区切りは移り変わり(気象庁表記): 『/』=『のち』、『|』=『時々(一時)』。"
    "例: 晴れの記号/くもりの記号 → 『晴れのちくもり』。"
    "二重線などの訂正がある場合は訂正後の記入を採用。"
)

body = {
    "model": "mistral-ocr-4-0",
    "document": {"type": "image_url", "image_url": f"data:image/jpeg;base64,{b64}"},
    "document_annotation_format": {
        "type": "json_schema",
        "json_schema": {"name": "work_report", "schema": SCHEMA, "strict": True},
    },
}
スキーマ本体(SCHEMA)と採点コードは前回と同一です。採点も同じく、正解データとのフィールド単位の突き合わせ(全48項目+ヘッダ5項目)で行いました。
結果 ― 総合70%、4モデル中3位
| モデル | ヘッダ | 天候 | 全項目 | 総合 | 秒 | 1,000枚あたり |
|---|---|---|---|---|---|---|
| Gemini 3.1 Flash-Lite | 5/5 | 6/6 | 48/48 | 100% | 5.0 | $1.53 |
| GPT-5.4 mini | 5/5 | 5/6 | 45/48 | 94% | 5.1 | $5.11 |
| Mistral OCR 4 | 3/5 | 3/6 | 34/48 | 70% | 10.4 | $5.00 |
| GPT-5.4 nano | 1/5 | 3/6 | 24/48 | 47% | 6.3 | $1.38 |
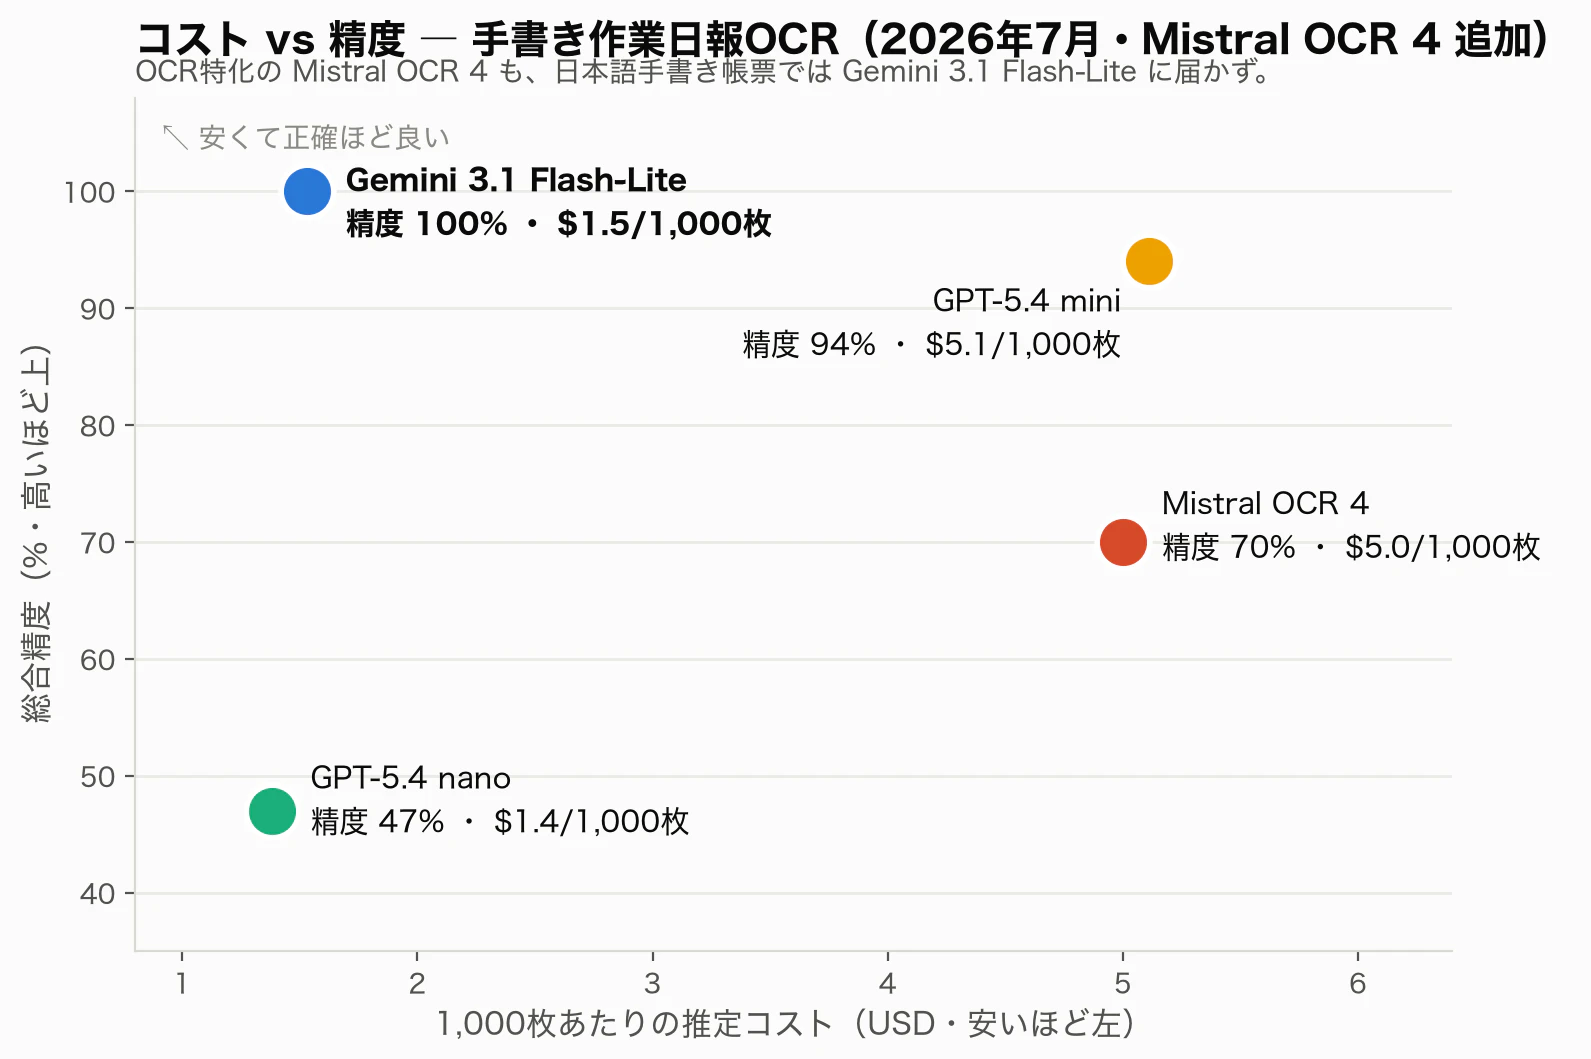
「OCR特化モデルだから帳票に強いはず」という予想は、日本語の手書き帳票に関しては外れました。Rambosanさんの「手書きはGemini」という所感は、私のベンチマークでも追認された形です。
内訳を見ていくと、単にMistral OCR 4が劣っているわけではなく、得意・不得意が見えた結果でした。
良かった点:表の構造保持は4モデルで最も丁寧
構造化抽出とは別に素のOCR(annotationなし)も走らせたところ、pages[].markdown には8列×6行の表がmarkdownテーブルとして完全に再現されていました。天気記号も無理に解釈せず記号のまま保持します。「レイアウトを崩さず文書をmarkdown化する」という点に関しては、OCR専用モデルの利点が見えました。
|  日付 | 天候 (記号) | 気温℃ | 作業内容 | 作業 人数 | 使用機材・資材 | 数量 | 進捗 |
| --- | --- | --- | --- | --- | --- | --- | --- |
|  2/2 | ☉ | 8.2 | 基礎配筋 D13 組立 | 5 | 異形鉄筋 D-13 | 120本 | ... |
弱点1:「○で囲む」形式は全滅
進捗欄は「順調・要注意・遅延」のどれかを丸で囲む形式です。素のOCRは3択を全行そのまま出力(どれが囲まれているか判定せず)、構造化抽出は全行「順調」に倒しました。正解は2/4が「要注意」、2/5と2/6が「遅延」。遅延を順調と報告してしまうので、実務ではかなり危険な落とし方です。
弱点2:手書きの崩し字・記号の意味解釈
- 天気記号の区別が不安定:快晴(○)を「晴れ」、晴れ(○に縦棒)を「快晴」と取り違え。「晴れ/くもり=晴れのちくもり」の組合せも「晴れ」止まり。面白いのは、素のOCRでは記号自体(⏱◎)は取れているのに、構造化抽出の段階で規約変換に失敗している点です
- 手書き固有名詞の誤読:「ブルーシート」→「ブルーミート」、「融雪剤」→「雨水暖かい」、「東町」→「柴町」など14件/48項目
弱点3:前回のGPT-5.4 miniと同じ場所で、同じように間違えた
2/6の作業内容「降雪により現場閉所」を「現場開所」と誤読しました。実は前回、GPT-5.4 mini もまったく同じセルで閉→開の誤読をしています。「複数モデルで読ませてクロスチェックすれば安心」とは言い切れない実例になりました。人の目によるチェック(human-in-the-loop)は、やはり外せません。
結論 ― 使い分けの指針
- 日本語の手書き帳票を読むなら、引き続き Gemini 3.1 Flash-Lite。最安帯で満点、Mistral OCR 4 の1/3以下のコストです
- Mistral OCR 4 の土俵は活字文書の構造化(表・レイアウト保持・markdown化)。手書きの意味解釈を求めるモデルではありませんでした。Rambosanさんの「活字の複雑な帳票はMistralが強い」という所感とも整合します
- チェック式・丸囲み式の欄は要注意。どのモデルでも精度が落ちやすいポイントですが、Mistral OCR 4 は特に苦手でした
前回と同じ締めになりますが、モデルは数か月で入れ替わります。この数字も2026年7月時点のスナップショットとして、実際に使う帳票で測り直すことをおすすめします。
なお、検証が終わったら Azure のリソース(デプロイとプロジェクト)は消しておきましょう。従量課金にアップグレードした場合は、予算アラートも忘れずに。
私たちPROMPT-X(プロンプトX)は、こうした「現場の困りごとをAIとデータで解く」開発を、地方拠点から全国のプロジェクトで手がけています。未経験からの参加も歓迎しています。
- 地方から、全国レベルの開発に挑戦しませんか? → 採用情報