

はじめに
Azure AI Foundry の Evaluation 機能には、ToolSelection や TaskAdherence といった組み込み評価器(Built-in Evaluators)が用意されています。汎用の品質チェックには便利ですが、SOC アラート調査の自動化のようにドメイン固有の「良さ」の定義を持つシステムでは、これだけでは不十分です。
筆者が運用する AI 駆動のアラート調査システム(Planner → Executor → Analyzer のマルチエージェント構成)で組み込み評価器を実行したところ、以下の問題に直面しました。
- ToolOutputUtilization が 0% — ツール結果データが評価器の期待する形式で渡らず、全件が評価不能
- TaskAdherence が 15% — エージェント間連携の「タスク」は組み込み評価器の想定と合わない
- CustomerSatisfaction が 95% — 機械間連携のエージェントにユーザー満足度は無意味
Overall score 41〜45% という数字が出ましたが、これは長期間安定して稼働し、アナリストによる出力レビューでも大きな問題が出ていない実態とは整合しません。原因は「評価基準がこのシステムの品質定義と合っていない」ことでした。
本記事では、Foundry の カスタム Rubric 評価器を使って、SOC エージェントの品質を自分たちの基準で測定する方法を解説します。
本記事の内容は 2026年8月時点の Azure AI Foundry ポータルの動作に基づいています。UI や機能は変更される可能性があります。
本記事で扱う範囲
本記事では以下のフローを順に説明します。
- カスタム Rubric 評価器の設計と作成
- 本番トレース(Existing traces)を使った評価の実行
- 評価結果の読み方
- Existing traces 使用時の
tool_callsエラーとその回避策
評価対象は KQL クエリを生成する Planner エージェントですが、同じ手法は Analyzer など他のエージェントにも適用できます。
1. なぜ Rubric 評価器か
Foundry のカスタム評価器には Rubric / Prompt / Code の3タイプがあります。
| タイプ | 方式と向いている場面 |
|---|---|
| Rubric | 複数の採点次元を judge モデルが1〜5で採点し、重み付き平均で総合スコア(0〜1)を算出。品質の多面的な評価に適する |
| Prompt | 単一のプロンプトで採点または分類。シンプルな合否判定に適する |
| Code | Python で決定的なチェック。JSON 形式検証などに適する |
SOC エージェントの品質は「KQL が正しいか」「調査ステップの意図に合っているか」「スキーマ取得ツールを適切に使ったか」など複数の観点から総合的に判断されるものであるため、次元別に採点できる Rubric が適しています。

2. Rubric 評価器の作成
2.1 生成プロンプトの設計
Evaluator catalog → Create evaluator を開き、以下を設定します。
-
Evaluator name:
soc-planner-kql-quality(任意) - Evaluator type: Rubric
- Auto-generate rubric: オン
- Model: ルーブリックを生成するためのモデル(採点に使う judge モデルとは別)
- Target agent: 評価対象のエージェントを選択(Optional だが、選択するとインストラクションが生成コンテキストに含まれる)
ここで指定する Model はルーブリックを生成するためのモデルであり、評価実行時に応答を採点する judge モデルとは別です。judge モデルは評価作成時の Field mapping で指定します。
最も重要なのは Prompt 欄です。ここに書いた内容に基づいてルーブリックが自動生成されます。単に「品質を評価して」ではなく、採点してほしい観点を具体的に列挙してください。以下は Planner 向けの例です。
このエージェントは、SOCアラート調査自動化システムの一部である。
Orchestratorから渡されたアラート情報と調査ステップに基づき、KQLクエリを生成する。
テーブル構造が不確かな場合はスキーマ取得ツールで最新のテーブル・スキーマ情報を取得してからクエリを作成する。応答は人間ではなく後続のエージェント(QueryExecutor)が機械的に処理する。

以下の観点で応答を採点するルーブリックを作成すること:

1. KQLの正しさ(最も重要): 構文的に妥当で、そのまま実行可能であること。
   減点対象は (a) 実行先のテーブル体系に存在しないテーブル名・カラム名の使用、
   (b) カラムの型に合わない演算、(c) 構文エラー、
   (d) 実行先に対応しない記法の混在、である。
   標準テーブルの一般的なカラムは実在するものとして扱うこと。
   評価データにツール結果が含まれていないことのみを理由に減点してはならない。
2. 実行先の適切な使い分け: query_target.type に従い、Log Analytics と MDE を
   正しく選択し、それぞれの記法を取り違えないこと。
3. 調査ステップとの整合: 各クエリが調査ステップの意図に合致し、purposeで述べた
   内容を実際に取得すること。フィルタ順序が目的を損なわないこと。
4. 結果解釈の前提の妥当性: 0件を「事象の不在」と断定せず、
   データ未取得やセンサー未対応の可能性を考慮していること。
5. スキーマ取得ツールの適切な使用。
6. クエリ効率: 時間範囲の限定、必要カラムへの絞り込み、集約による結果量の抑制。
7. 出力フォーマット: 後続処理が解析できる規定フォーマットで返すこと。
   ただしこの観点の重みは低く設定すること(後段の処理で装飾は除去されるため)。

これは機械間連携のエージェントであるため、会話的な丁寧さやユーザー満足度は
評価対象にしないこと。
ポイントは以下の3点です。
- 最重要の観点を明示する(「最も重要」と書くと、自動生成で重み 8〜10 が割り当てられる)
- 減点対象を具体的に列挙する(曖昧だと judge モデルの採点が安定しない)
- 不要な減点を明示的に禁止する(「ツール結果の不在のみを理由に減点してはならない」)。特にこの3点目は、後述するデータ構造の制約から、記載しないと全件が一律に低く評価されることになる
2.2 Context の設定(Optional)
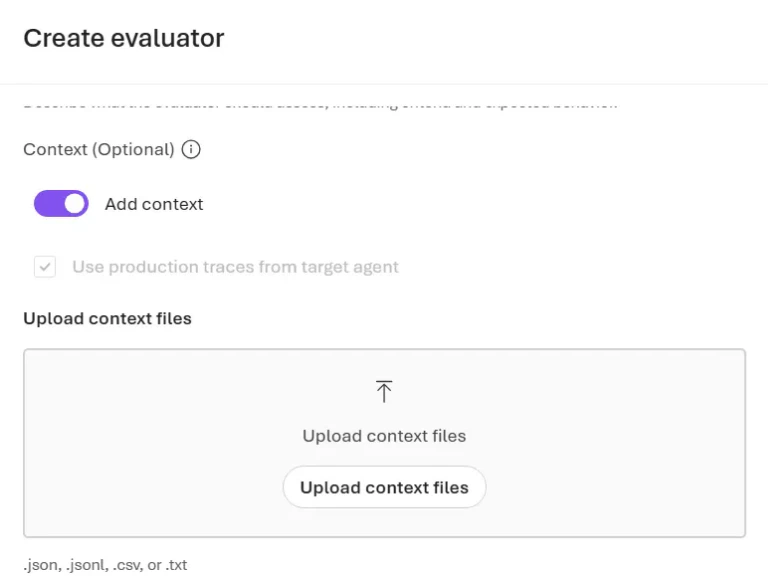
Use production traces from target agent にチェックを入れると、指定した日付範囲の本番トレースが生成コンテキストに含まれます。実際の使われ方に即したルーブリックが生成されるため、特に理由がなければオンにしてください。
Upload context files は必須ではありませんが、カスタムテーブルのスキーマ一覧(テーブル名とカラム名の .csv)を渡すと、judge モデルが標準テーブル以外のカラムについても実在するかどうかを判定できるようになります。
2.3 Advanced options

- Evaluation level: Turn / Conversation — 自動判定され、作成後は変更不可
- Category: Quality / Safety / Agents — 自動判定され、作成後は変更不可
Category に Agents が含まれると、評価実行時に tool_calls データが必須入力になります。 Prompt にツール使用の観点を書くと Agents が付きやすくなります。これが後述の tool_calls エラーの根本原因になるため、注意してください。Category は作成後に変更できないので、問題が発生した場合は評価器を作り直す必要があります。
2.4 生成結果の手直し
Generate rubric を押すと、プロンプトに基づいて次元(Dimension)が自動生成されます。

生成されたルーブリックは必ず以下の3点を確認してください。
1. 抜けている次元はないか
特に「出力フォーマット」や「ツール使用」は、トレースから自動生成した場合に「すでにできていること」とみなされ、評価次元として生成されないことがあります。プロンプトで列挙した観点と突き合わせ、抜けていれば追加してください。
2. 重みの配分
自動生成では最重要の1次元だけが重み 8〜10、残りは 1〜6 になります。最も大きい重みが、本当に最重要な次元(Planner なら KQL の正しさ)に付いているか確認し、違っていれば入れ替えます。
3. 説明文の具体性
「クエリが適切である」程度の抽象度では judge モデルの採点が安定しません。「実在するテーブル・カラムのみを参照し、型に合わない演算がない」のような、judge モデルが判定できる表現に書き換えてください。
2.5 Pass score threshold
各次元は 1〜5 で採点され、重み付き平均が 0〜1 に正規化されます。全次元が3点(平均的な品質)なら 0.6、4点なら 0.8 に相当します。
初回は 既定の 0.5 のまま実行し、結果の分布を見てから調整することをお勧めします。自分が「これは不合格にすべき」と判断する出力のスコアを確認し、その境界に閾値を置くのが最も納得感のある決め方です。
3. 評価の実行(Existing traces)
評価器が作成できたら、Evaluations → Create new evaluation から評価を実行します。
3.1 Target

Agent を選択し、評価対象のエージェントとバージョンを指定します。
3.2 Scope
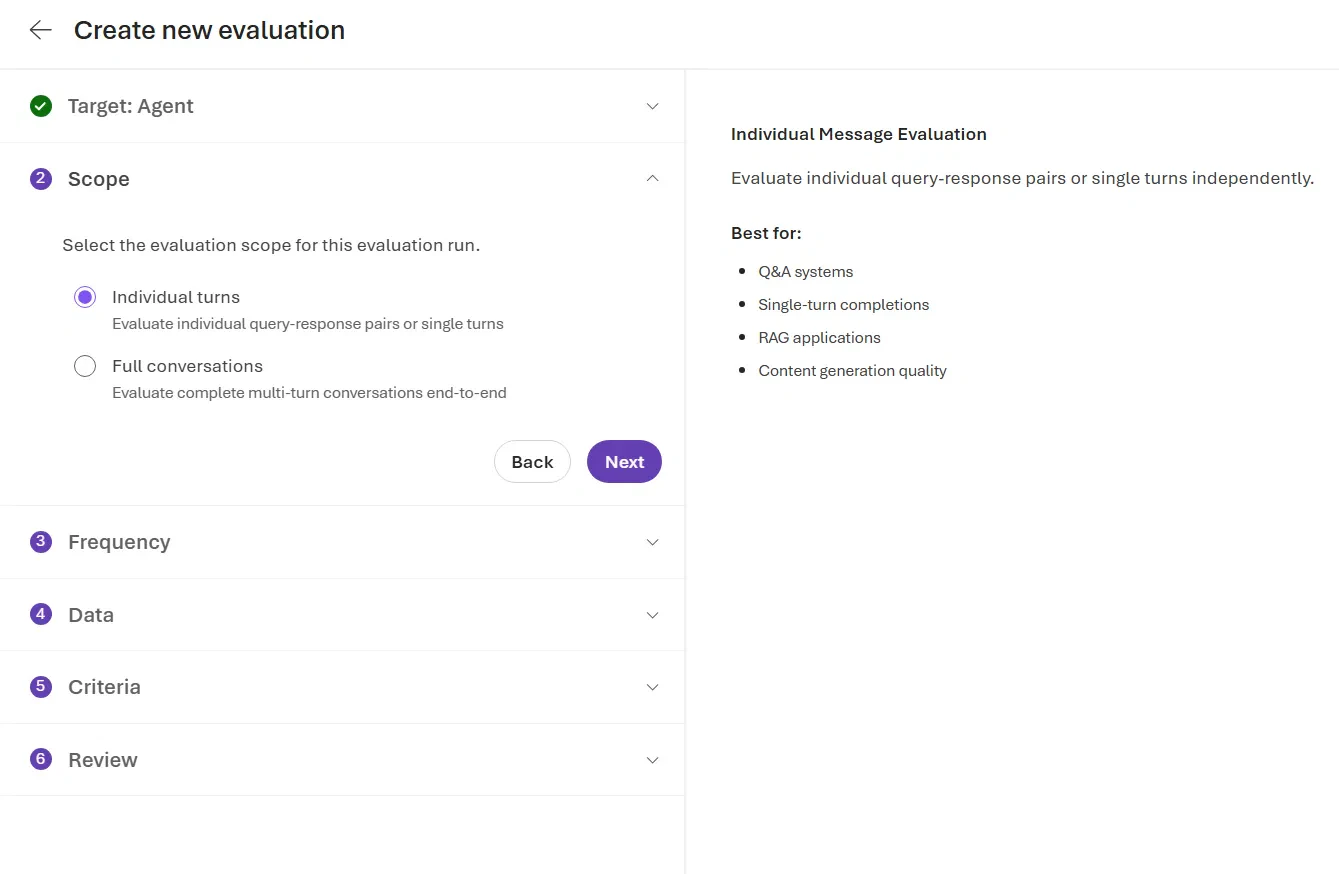
Planner は「アラート情報 → KQL」という単発の入出力なので、Individual turns を選択します。
3.3 Frequency

初回検証では One time で実行します。ルーブリックが安定したら Recurring に切り替えて継続監視に移行できます。
3.4 Data
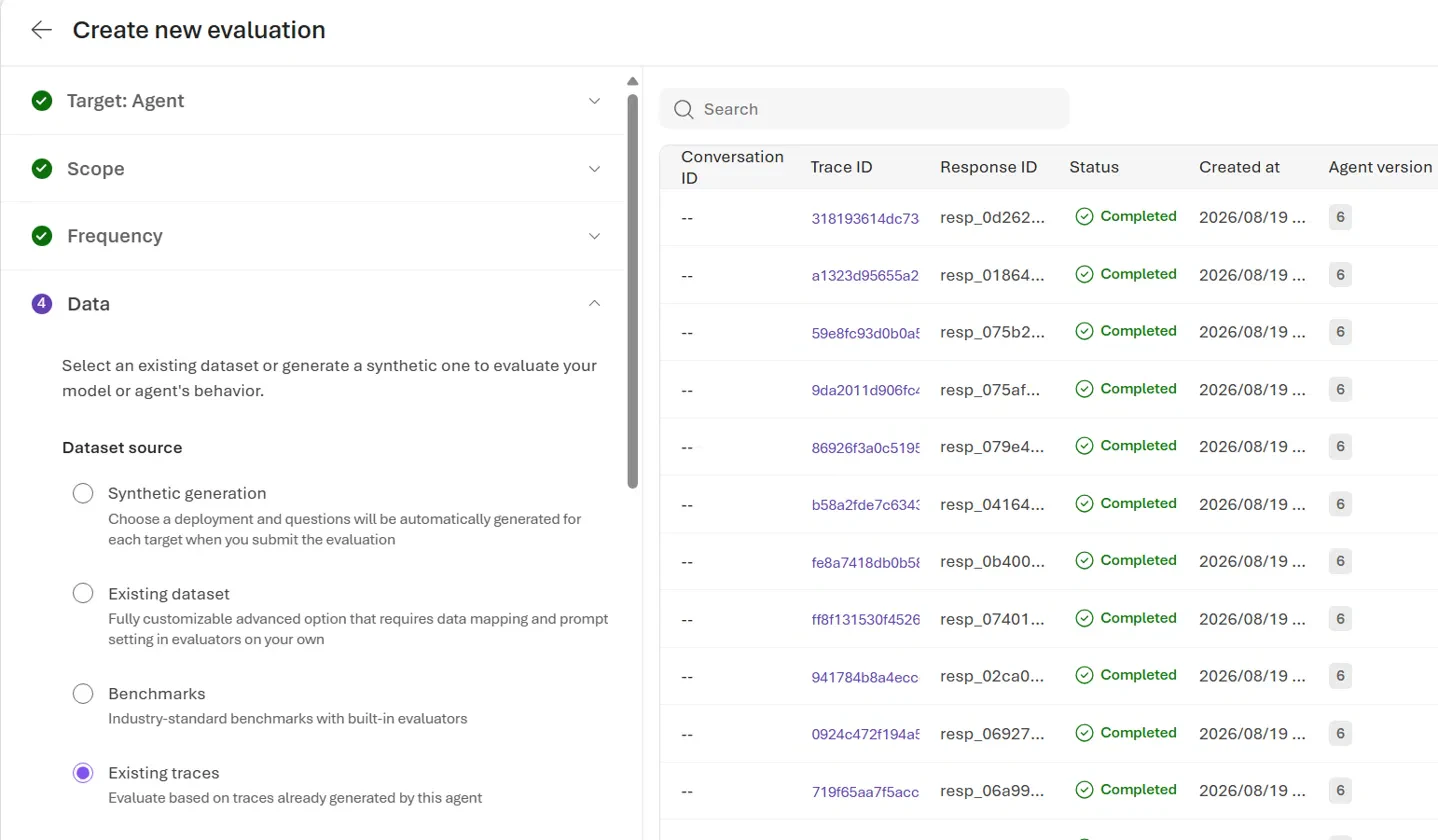
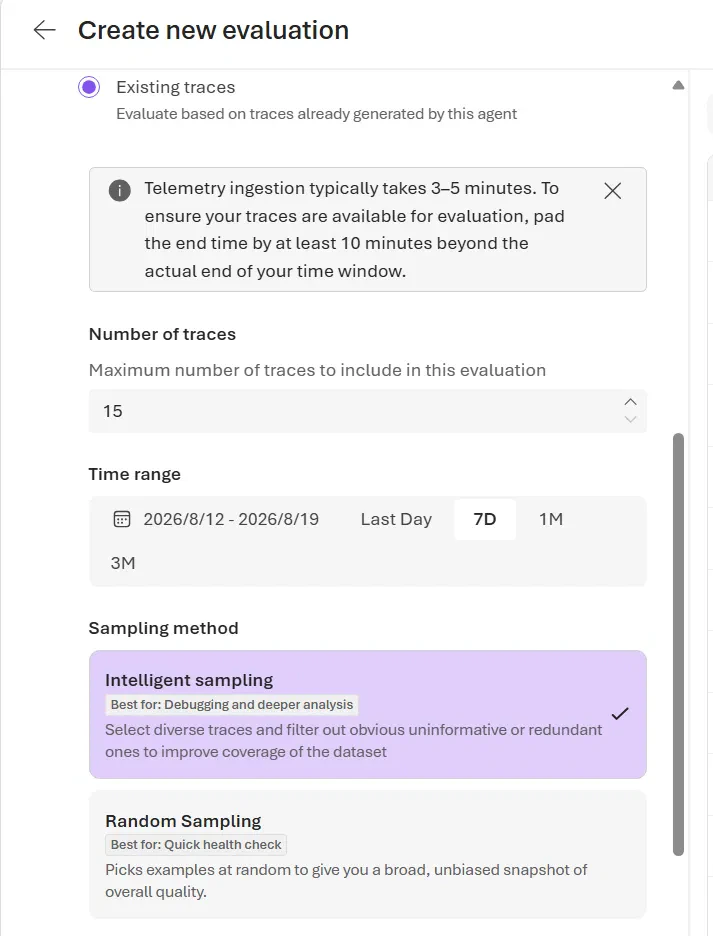
Existing traces を選択すると、指定したエージェントの本番トレースが評価対象になります。
- Number of traces: 15(評価の仕組みが期待通り動作するかを確認するための件数。品質を統計的に判断するにはより多くの件数が必要)
- Time range: 直近 7 日間
- Sampling method: Intelligent sampling(多様なトレースを自動選択)
Existing traces を使うには、Foundry プロジェクトのマネージド ID に、接続された Application Insights リソースとリンク先の Log Analytics ワークスペースの両方に対して Log Analytics Reader ロールが付与されている必要があります。権限がないと Unable to query Application Insights due to insufficient permissions エラーで失敗します。
3.5 Field mapping
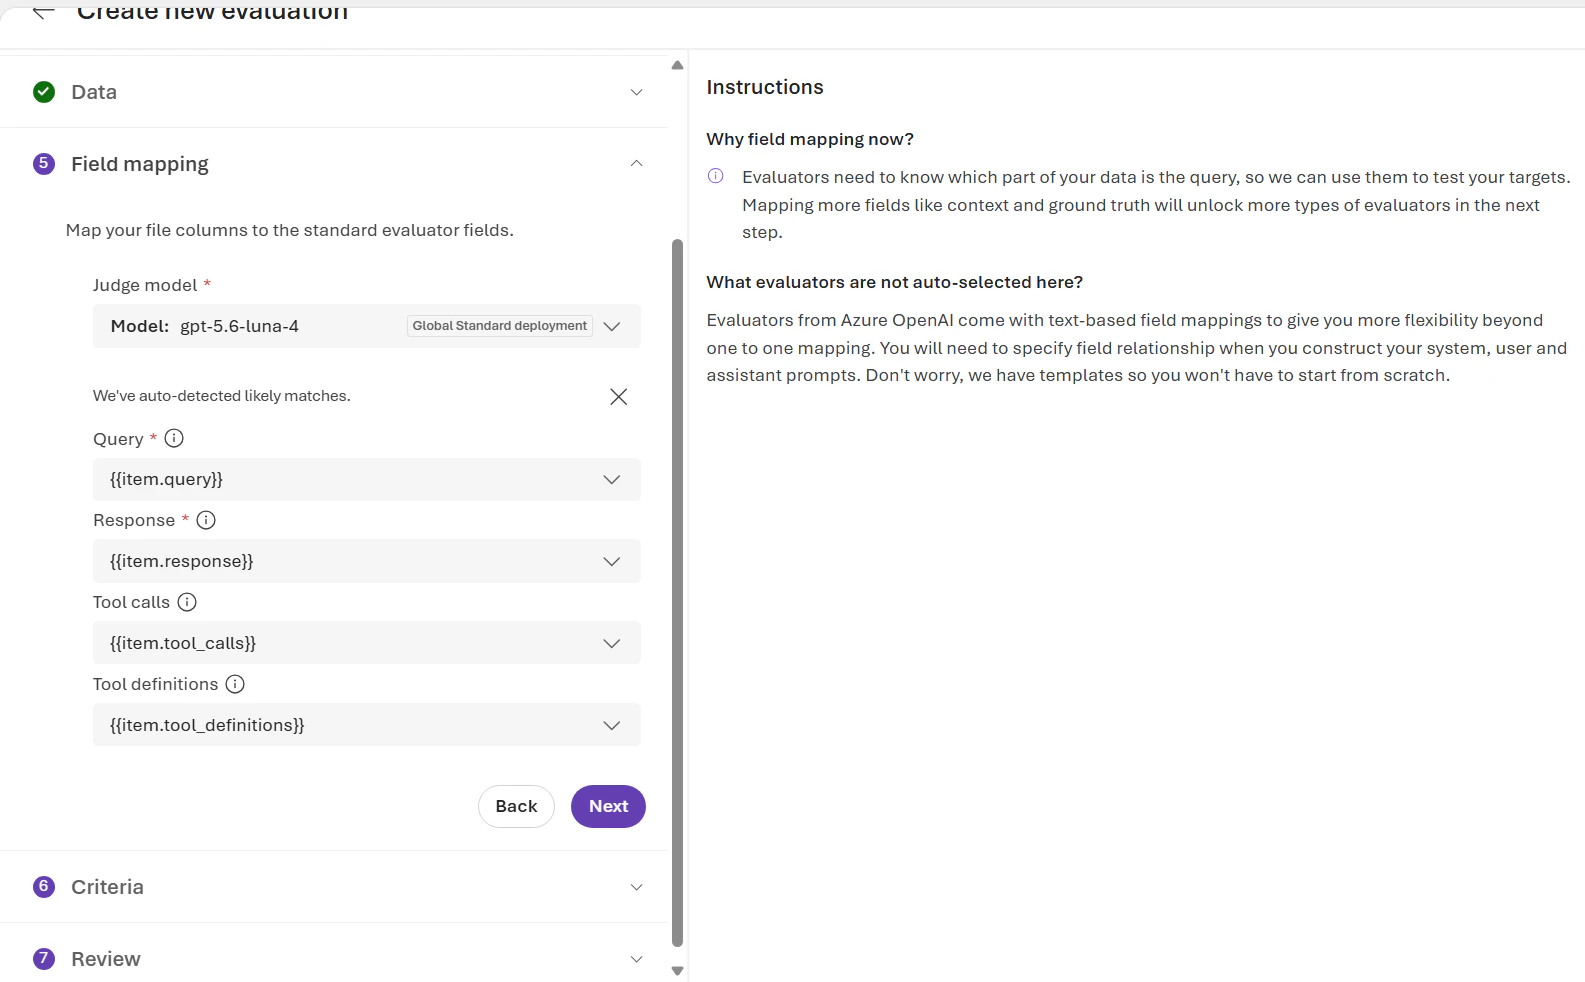
ここが最も注意が必要な箇所です。
| フィールド | 設定値 | 説明 |
|---|---|---|
| Query | {{item.query}} |
エージェントへの入力 |
| Response | {{item.response}} |
エージェントの出力 |
| Tool calls | {{item.tool_calls}} |
ツール呼び出しの記録 |
| Tool definitions | {{item.tool_definitions}} |
ツール定義 |
Tool calls のマッピングは、データセットに実際に tool_calls 列が存在する場合のみ有効です。 ドロップダウンに {{item.tool_calls}} が表示されても、データに列がなければ実行時にエラーになります。この問題の詳細と回避策は5章で説明します。
Judge model はこの Field mapping 画面で指定します。これが応答を実際に採点する judge モデルであり、評価器作成時にルーブリックを生成したモデルとは別です。移行前後の比較や継続的な品質モニタリングを行う場合、すべての評価実行で同じ judge モデルを使うことが前提になります。モデルが異なるとスコア差が「エージェントの差」なのか「judge モデルの差」なのか判別できなくなります。
3.6 Criteria

作成した Rubric 評価器を選択します。組み込み評価器を併用することもできますが、ToolSelection や ToolCallAccuracy は tool_calls データの有無に依存するため、初回はカスタム評価器1本に絞るのが安全です。
3.7 Review & Submit
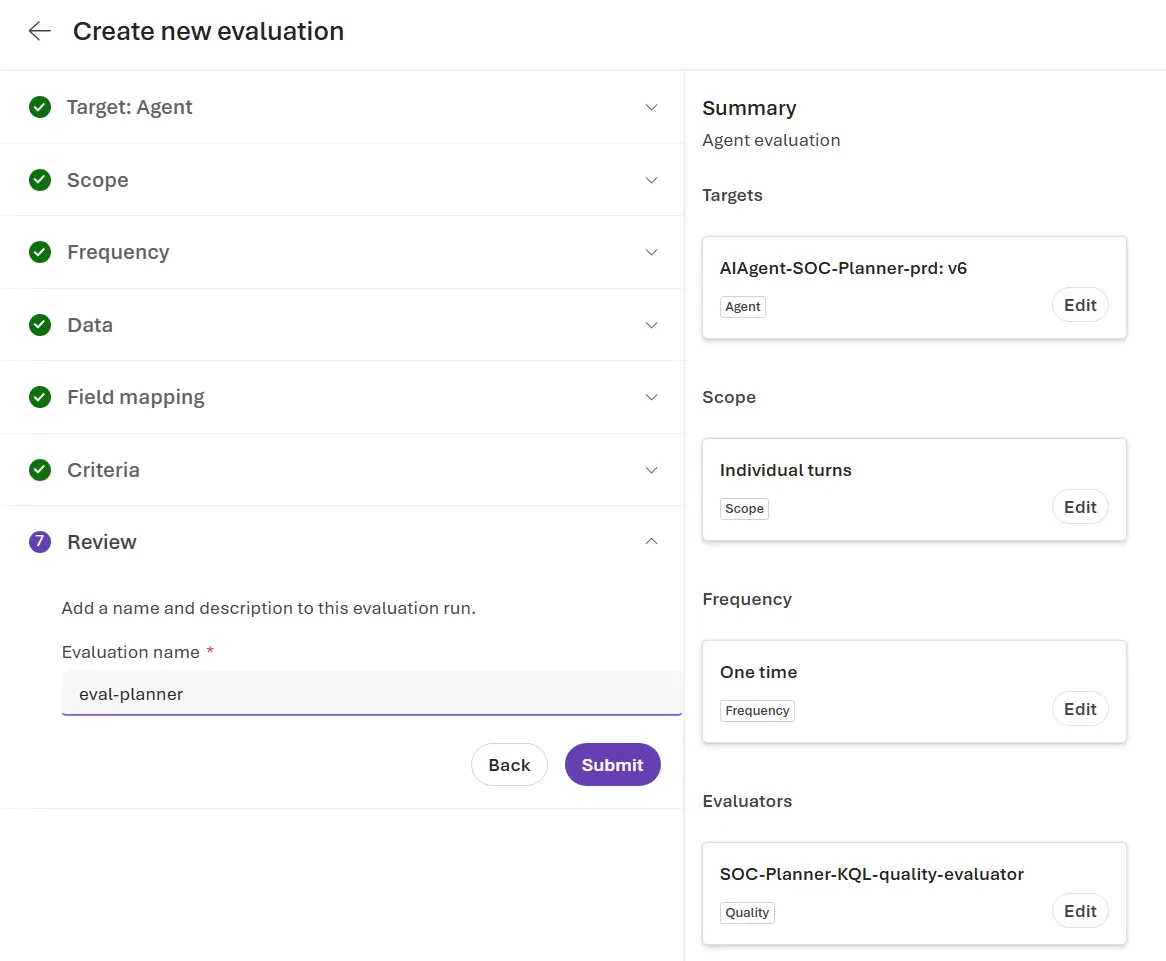
設定を確認し、Submit で実行します。15件で 10〜15 分程度で完了します。
4. 結果の読み方
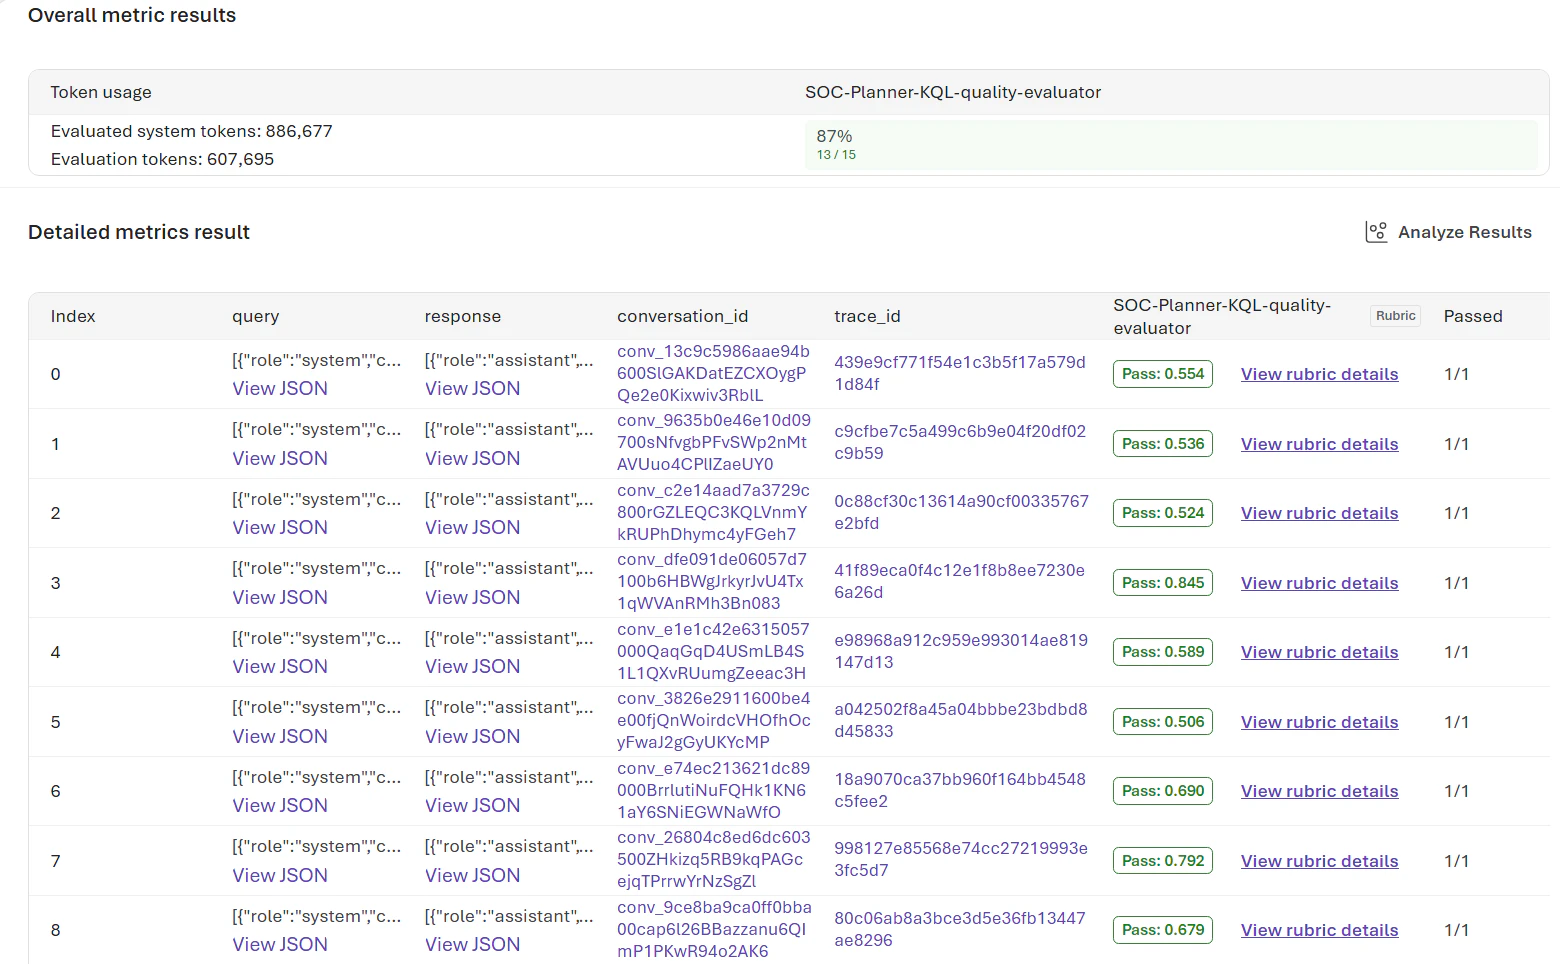
各行の View rubric details を開くと、次元ごとのスコア・Pass/Fail・評価理由が確認できます。
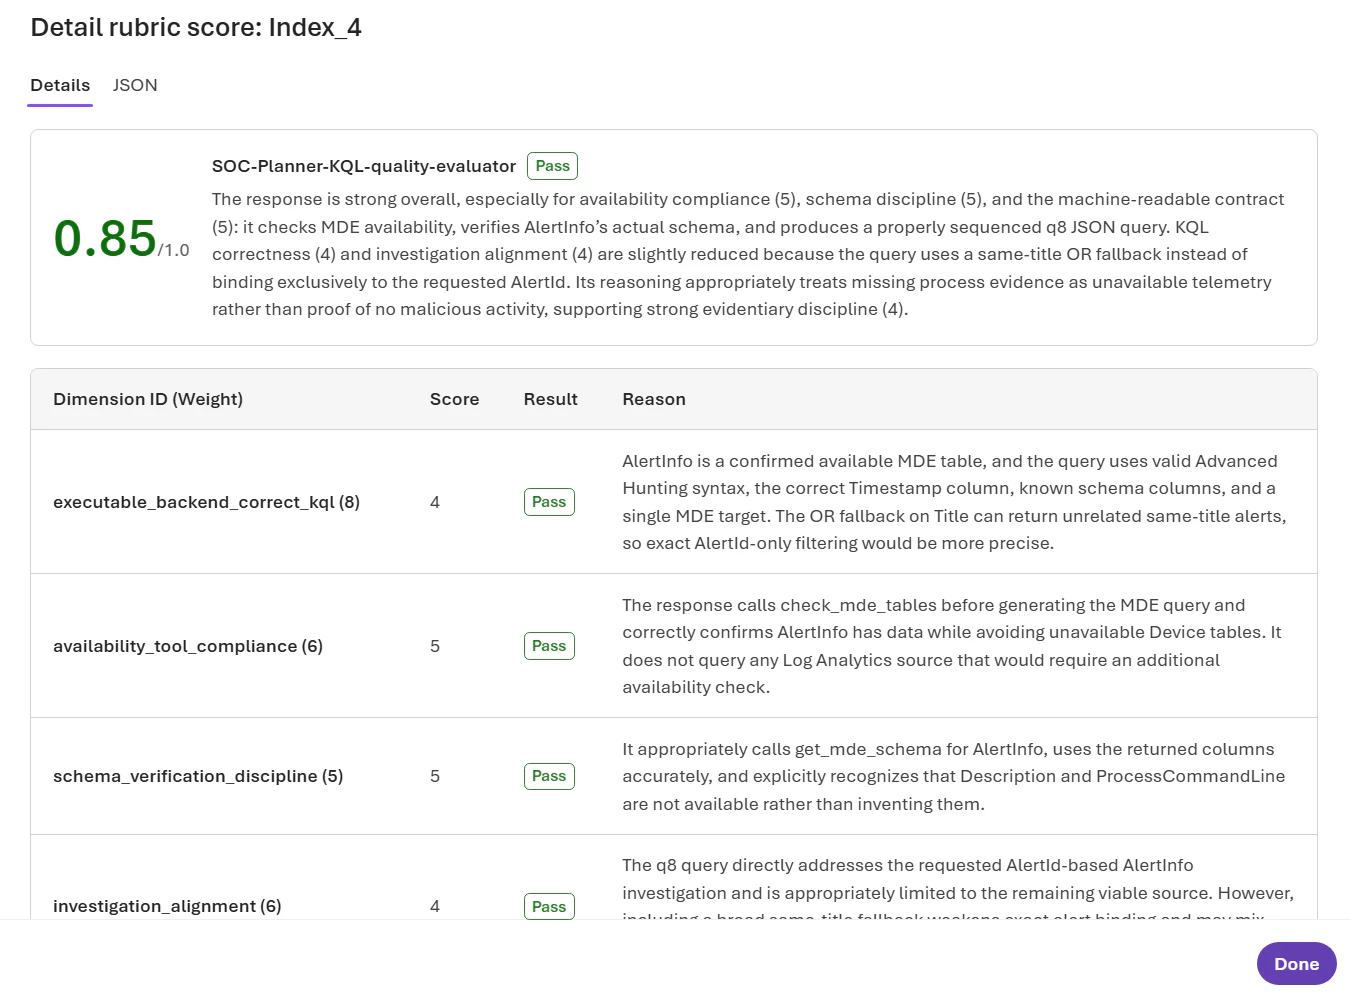
読み方のポイント
Overall score ではなく次元別スコアを見る
Overall score は全次元の重み付き平均であるため、1つの次元が極端に低いと総合スコア全体が低くなります。また、重みの小さい次元の低スコアが、重みの大きい次元の高スコアによって打ち消されることもあります。次元別に確認することで「どこが良くてどこが悪いか」を把握できます。
judge モデルによる評価理由の記述が最も有用
スコア自体よりも、judge モデルがなぜそのスコアを付けたかという評価理由の記述が重要です。「q1 はユーザーで絞り込んでから DistinctUsersOnIP を計算しており、IP の組織内利用状況を測定できない」のような具体的な指摘は、そのままプロンプト改善の材料として使えます。
「評価器の問題」と「エージェントの問題」を切り分ける
特定の次元が全件で一律に最低点(1点)になっている場合、それはエージェントの品質ではなく評価データの欠損や基準の不備を疑ってください。筆者の環境では machine_readable_output_contract が全15件で1点でしたが、理由は「Markdown コードフェンスで囲まれている」だけで、後段の Logic Apps がフェンスを除去するため実害はありませんでした。
5. tool_calls エラーとその回避策
5.1 問題
Existing traces をデータソースに使う場合、以下のエラーが発生することがあります。
INVALID VALUE: (UserError) Missing inputs for line 1: 'data.tool_calls'
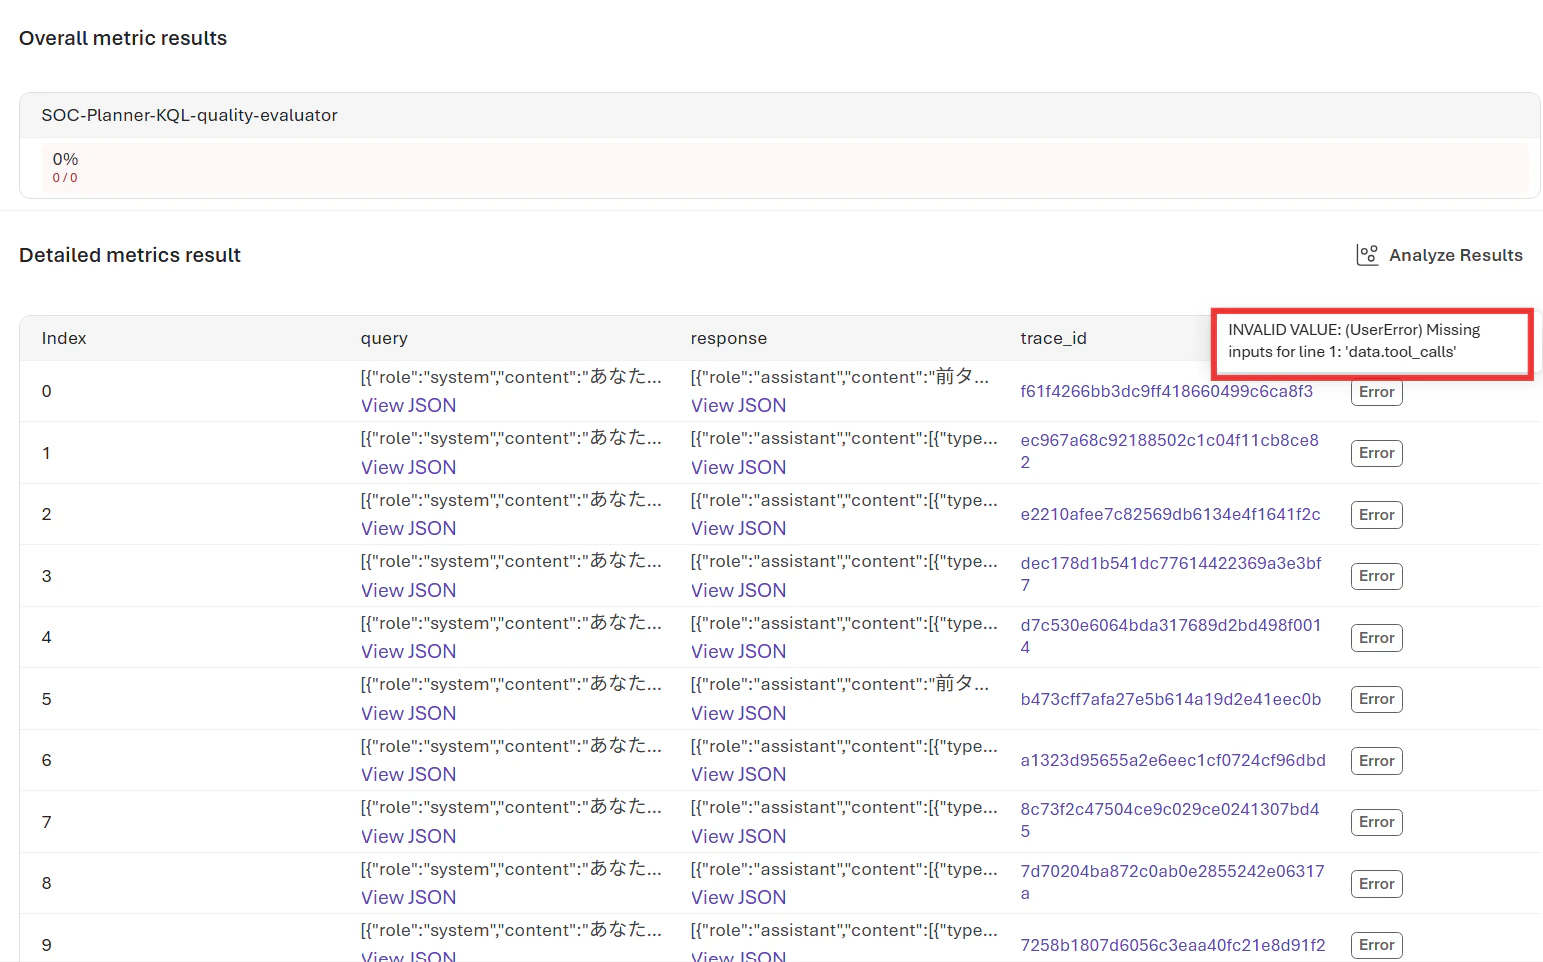
これは評価器が tool_calls を必須入力として要求しているのに、トレースから自動生成されたデータセットにその列が存在しないために発生します。
5.2 原因
Category に Agents が含まれる Rubric 評価器は、内部的に tool_calls を必須入力とします。Field mapping で Not available に設定しても、この要件は評価器の定義側で固定されているため解消しません。
Existing traces から自動生成されるデータセットの列構成は時期やバージョンによって異なり、tool_calls 列が含まれないことがあります。筆者の環境でも、以前成功したときのデータには tool_calls 列が存在していましたが、別の時期に生成したデータには含まれていませんでした。
5.3 回避策: tool_calls 列を手動で追加する
自動生成されたデータセットをダウンロードし、response 内の assistant メッセージから tool_call ブロックを抽出して tool_calls 列として追加します。
Step 1: データセットをダウンロード
Data → Datasets 一覧から、Existing traces で自動生成されたデータセットを開き、右上の Download からダウンロードします(JSONL 形式)。この時点では tool_calls 列が存在しないことを確認できます。
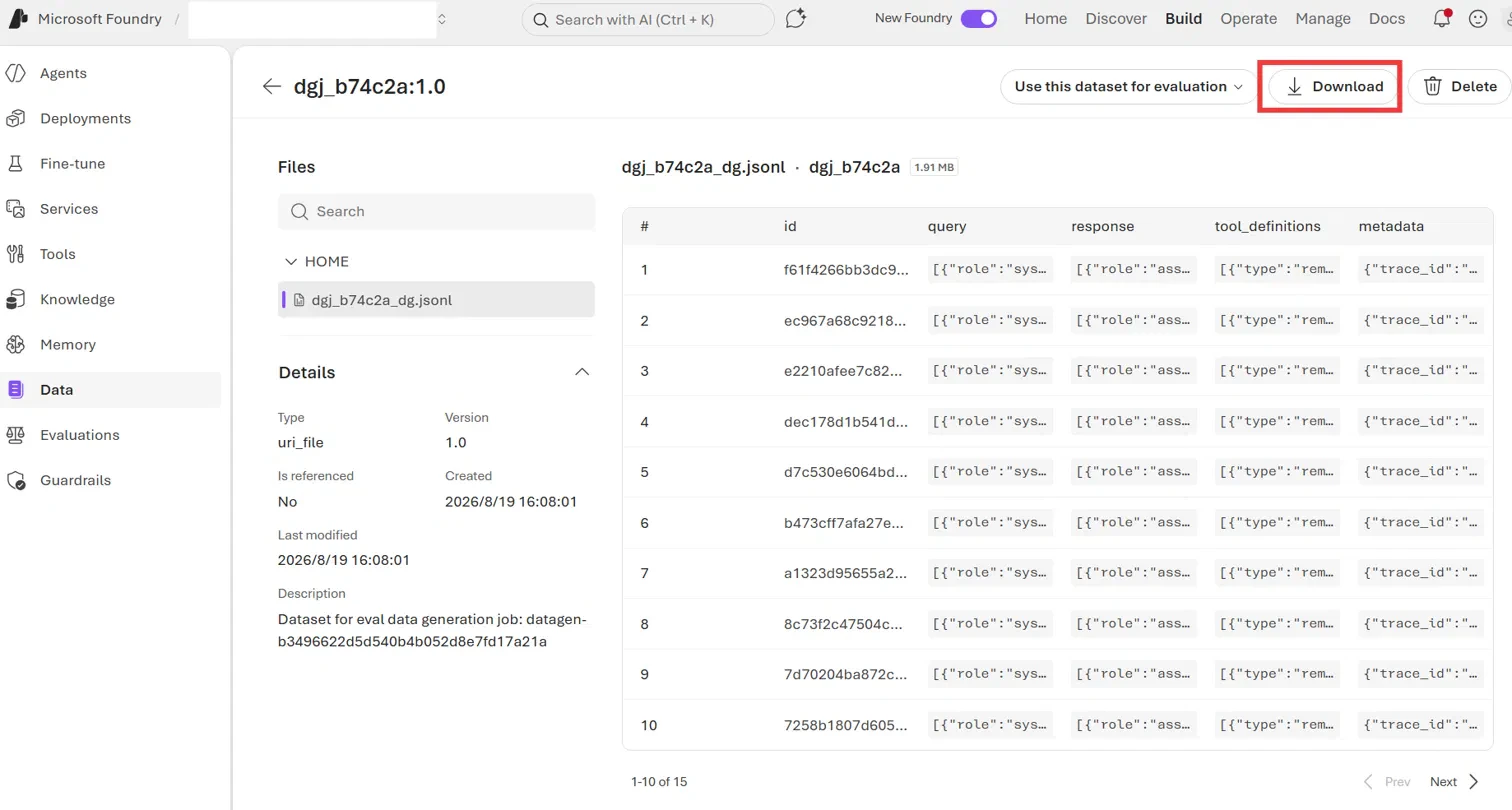
Step 2: Python スクリプトで tool_calls 列を追加
response 内の assistant メッセージから type: "tool_call" のブロックを抽出します。Python の実行環境がない場合は、Azure Cloud Shell(Azure ポータル上部のターミナルアイコン)に Python が標準で入っているため、ブラウザだけで完結できます。あるいは生成 AI にファイルを渡して変換を依頼する方法もあります。
import json

SRC = 'downloaded_dataset.jsonl'       # ダウンロードしたファイル名に合わせる
DST = 'dataset_with_toolcalls.jsonl'

with open(SRC, encoding='utf-8') as f, open(DST, 'w', encoding='utf-8') as out:
    for line in f:
        row = json.loads(line)
        calls = []
        for m in row.get('response') or []:
            if not isinstance(m, dict) or m.get('role') != 'assistant':
                continue
            content = m.get('content')
            if not isinstance(content, list):
                continue
            blocks = [c for c in content
                      if isinstance(c, dict) and c.get('type') == 'tool_call']
            if blocks:
                calls.append({'role': 'assistant', 'content': blocks})
        row['tool_calls'] = calls
        out.write(json.dumps(row, ensure_ascii=False) + '\n')
スクリプト中の c.get('type') == 'tool_call' は、データの実際の型名に合わせて変更してください。データによっては tool_use や function_call の場合もあります。変換前に1行を View JSON で開いて確認することをお勧めします。
Step 3: 変換後のファイルをアップロード
新しい Evaluation の作成に進み、Data ステップで Existing dataset を選択 → Upload new dataset をクリックし、変換後のファイルをアップロードします。
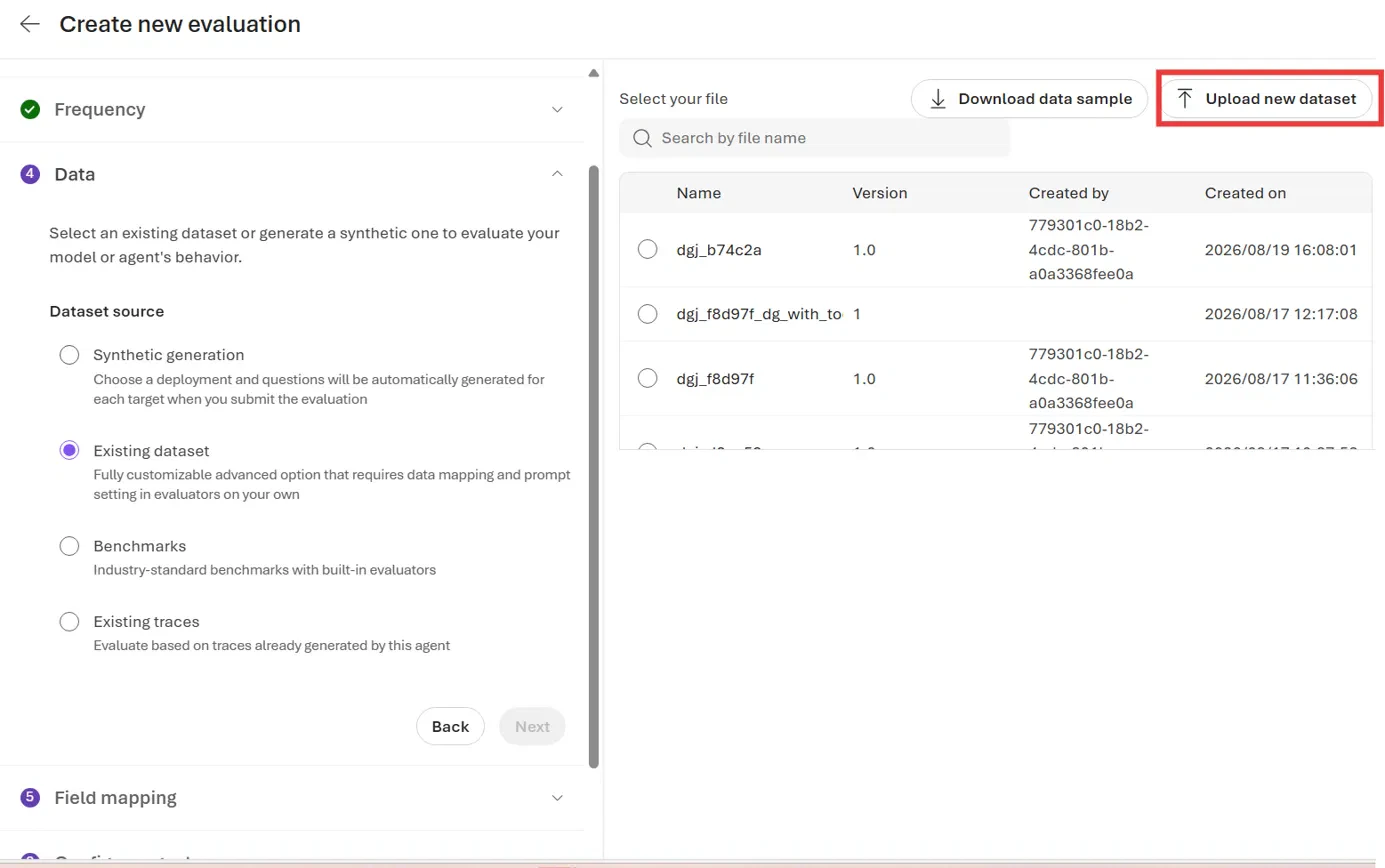
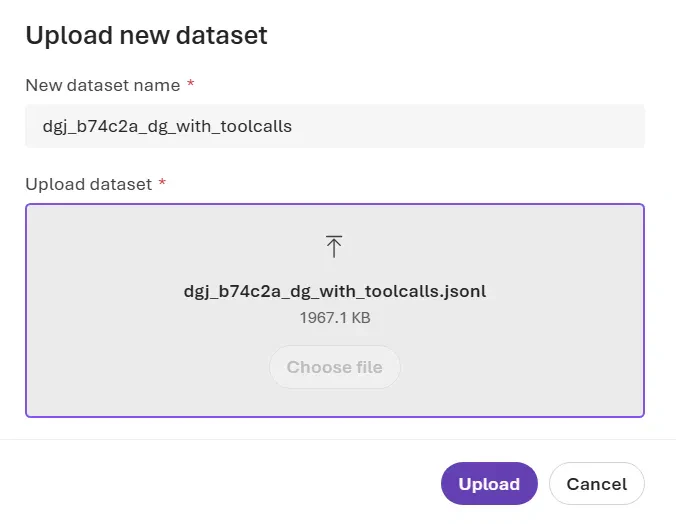

Step 4: Field mapping で tool_calls を含む4項目をマッピング
アップロードしたデータセットに tool_calls 列が含まれているため、Available fields に tool_calls が表示されます。以下の4項目をマッピングします。Context や Ground truth は Not available のままで構いません。

| フィールド | 設定値 |
|---|---|
| Query | {{item.query}} |
| Response | {{item.response}} |
| Tool calls | {{item.tool_calls}} |
| Tool definitions | {{item.tool_definitions}} |
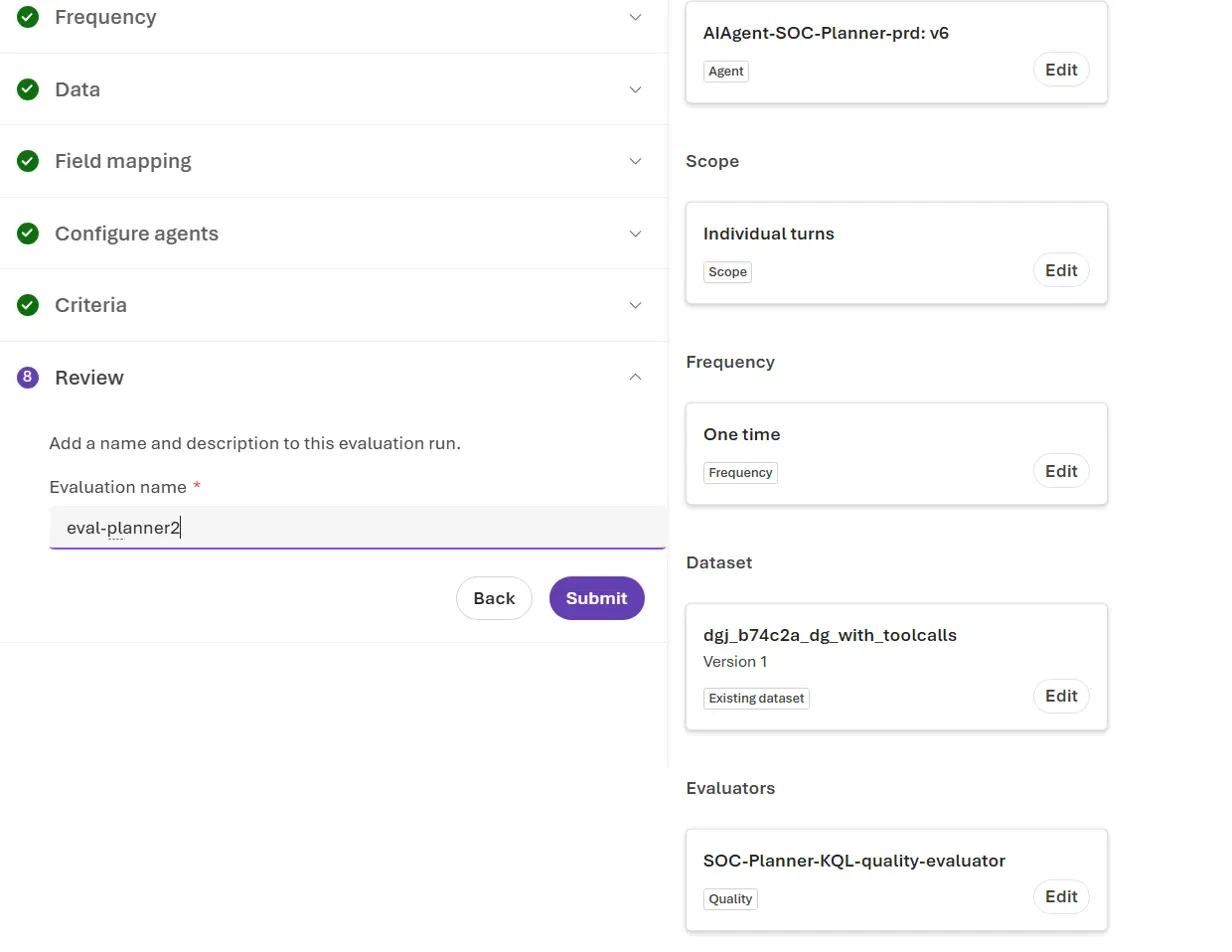
Step 5: Review & Submit
Dataset 欄が変換後のデータセット名(xxx_with_toolcalls など)になっていること、Data source が Existing dataset になっていることを確認し、Submit で実行します。
5.4 副次的な効果
この変換には、tool_calls エラーの解消以外にも重要な効果があります。
Existing traces のデータセットには、ツール呼び出し(type: "tool_call")だけでなく、ツールの戻り値(role: "tool" のメッセージ)も response 内に含まれていることがあります。これが含まれていると、judge モデルはスキーマ取得ツールの結果(テーブルの HasData 状況など)を実データで確認できるため、「ツール結果が確認できないため未検証」という理由による一律の減点がなくなります。
筆者の環境では、ツールの戻り値を含むデータで評価を実行したところ、Overall score が 0.30〜0.35 → 0.51〜0.67 に改善し、15件中13件が pass になりました。以前の低いスコアの大部分は、エージェントの品質ではなく評価データの欠損に起因していたことになります。
6. 得られた知見
6.1 組み込み評価器 vs カスタム Rubric 評価器
| 観点 | 組み込み評価器 | カスタム Rubric 評価器 |
|---|---|---|
| セットアップ | 選ぶだけ | プロンプト設計と手直しが必要 |
| ドメイン適合性 | 汎用(SOC 固有の観点は測定できない) | 自分たちの品質定義で測定できる |
| 診断能力 | 総合スコアのみ | 次元別スコアと評価理由 |
| データ依存性 |
tool_calls 等が必須の評価器が多い |
入力要件を自分で制御できる |
| 移行前後の比較 | 基準が固定(自分たちの品質改善と連動しない) | 基準を更新しながら比較できる |
6.2 評価パイプライン構築で学んだこと
1. 最初の評価は「評価パイプライン自体のデバッグ」になる
最初の数回は、エージェントの品質ではなく評価環境のセットアップ問題(権限不足、データ欠損、次元定義の不備)の解決に費やされます。これは無駄ではなく、本番の品質測定に入る前に評価パイプライン自体を信頼できる状態にするために必要な工程です。
2. 低いスコアの原因を「エージェント」と「評価環境」に切り分ける
特定の次元が全件で一律に最低点になっている場合、まず疑うべきは評価データの欠損や次元定義の不備です。筆者の環境では、ツールの戻り値がデータに含まれていなかったために最重要次元が一律に低く評価され、Overall score が 0.30 まで低下していました。データの問題を解決したところ、同じ次元のスコアが 3〜4 点に上がりました。
3. ルーブリックの説明文に「減点してはならない条件」を明示する
judge モデルは「手元にない情報 = 未検証 = 減点」という判断をしがちです。評価データの構造上避けられない情報の欠損については、「この理由のみで減点してはならない」と明示的に記載しないと、全件が一律に低く評価されます。
4. 実害のない減点は重みを下げて対処する
後段の処理で吸収される問題(Markdown コードフェンスなど)は、次元を削除するのではなく重みを下げて監視を継続するのが安全です。削除すると将来の挙動変化を検知できなくなり、重みが再計算されるため過去の評価実行とのスコア比較もできなくなります。
5. ルーブリック生成モデルと judge モデルを区別する
評価器作成時に選ぶ Model はルーブリック(次元構成)を生成するためのもので、一度ルーブリックを生成すればその後の評価結果には影響しません。一方、評価作成時の Field mapping で指定する judge モデルは毎回の採点に使われるため、変更するとスコアが変わります。移行前後の比較を行う場合は judge モデルの統一が必須です。
まとめ
Azure AI Foundry のカスタム Rubric 評価器は、ドメイン固有のエージェント品質を多面的に測定し、改善すべきポイントを次元別に特定できるツールです。ただし、Existing traces を使う場合のデータ構造の問題や、Category による必須入力の制約など、実運用で注意が必要な点がいくつかあります。
本記事が、同様のエージェント品質評価に取り組む方の参考になれば幸いです。