
1.はじめに
本ポートフォリオでは、以前Google Cloud(GKE)で構築した「Go×Pythonによる非同期OCRバックエンド基盤」をベースに、AWS(EKS)環境への完全リプレイスおよびアーキテクチャの最適化を行いました。
基本方針
-
非同期パイプラインによる負荷分離
「Go言語による高速なリクエスト受付(API)」と「Python/PyTorchによる重い画像解析(EasyOCR)」の2つの役割を、Amazon SQS を介して完全に分離(疎結合化)。 -
AWSマネージドサービスの活用
GCPからAWSへの移行に伴う仕様差を考慮し、EKS、S3、SQS、IRSAによる権限管理、AWS Load Balancer Controllerなど、AWSのインフラ機能へ適正に置き換えました。
本記事では、Terraformによるインフラ自動化(IaC)から、Helmを用いたコンテナワークロード管理、KEDAによるイベント駆動オートスケーリングの実装まで、構築の全容を詳細に解説します。
| ◆構成 |
|---|
| 1.はじめに |
| 2.技術スタックとシステム構成 |
| 3.APIサーバー(Go) |
| 4.推論サーバ(python) |
| 5.Terraformによるインフラ自動化 |
| 6.Helmによるワークロード管理 |
| 7.デプロイ手順 |
| 8.おわりに |
2.技術スタックとシステム構成
2-1. 技術スタック
本システムでは、以下の技術スタックを採用しています。
GCP基盤での設計思想である 「疎結合」「非同期バッファリング」「イベント駆動型オートスケール」 をそのまま継承し、AWS環境への置き換えを実施しました。
| カテゴリ | 技術・ツール | 用途 |
|---|---|---|
| Frontend API | Go (Standard) | HTTPリクエスト受付、Amazon S3への画像および構造化JSONログのアップロード、SQSメッセージ送信 |
| Inference Engine | Python (EasyOCR) | Amazon SQSからのメッセージ受信、S3からの画像ダウンロード、文字認識処理、結果のS3保存 |
| Messaging (Buffer) | Amazon SQS | Go-Python間の通信を仲介するメッセージキュー。スパイク負荷をバッファリングし、推論サーバーを保護 |
| Autoscaling | KEDA | SQSの未処理メッセージ数を検知し、Podを高速にイベント駆動スケール |
| Infrastructure | Amazon EKS | コンテナオーケストレーション基盤 |
| IaC | Terraform | VPC、NAT Gateway、EKS、SQS、S3、IAMロールなどのAWSインフラリソースのコード管理(IaC) |
2-2. 主要ライブラリ
新アーキテクチャで採用した主要ライブラリ・ツールです。
| 対象 | ライブラリ | 採用理由 |
|---|---|---|
| Go | aws/aws-sdk-go-v2 | AWSの推奨するSDK v2。S3への高速なオブジェクト書込み及びSQSへの軽量なメッセージ送信 |
| Python | EasyOCR | PyTorchベースで精度が高く、日本語・英語に標準対応 |
| Python | psutil | OCR推論時のCPU負荷をノンブロッキングで計測し、分析用の構造化ログに出力 |
| K8s | KEDA (AWS SQS Scaler) | SQSのキュー滞留数に応じてod数を 1〜最大5 Pod までイベント駆動で高速にスケールさせる |
| AWS / K8s | IRSA (IAM Roles for Service Accounts) | OIDC認証を介してPod単位で安全にS3/SQSへのアクセス権限を付与する |
2-3. ディレクトリ構成
インフラの自動構築(Terraform)からアプリケーションのデプロイ(Helm)まで、リポジトリのルートから一元管理できるクリーンなディレクトリ構成を採用しています。
コードの全容は、👉 GitHubリポジトリ にて公開しています。
.
├── terraform/      # AWSインフラ自動化(VPC, EKS, IAM, S3, SQSの定義)
├── helm/           # Kubernetesワークロード管理(KEDA, Ingress, 各種マニフェスト)
├── go/             # フロントエンドAPI(Go / Gin:リクエスト受付・SQSキュー登録)
└── python/         # 推論エンジン(Python / EasyOCR / PyTorch:非同期OCR処理ワーカー)
2-3. システム構成
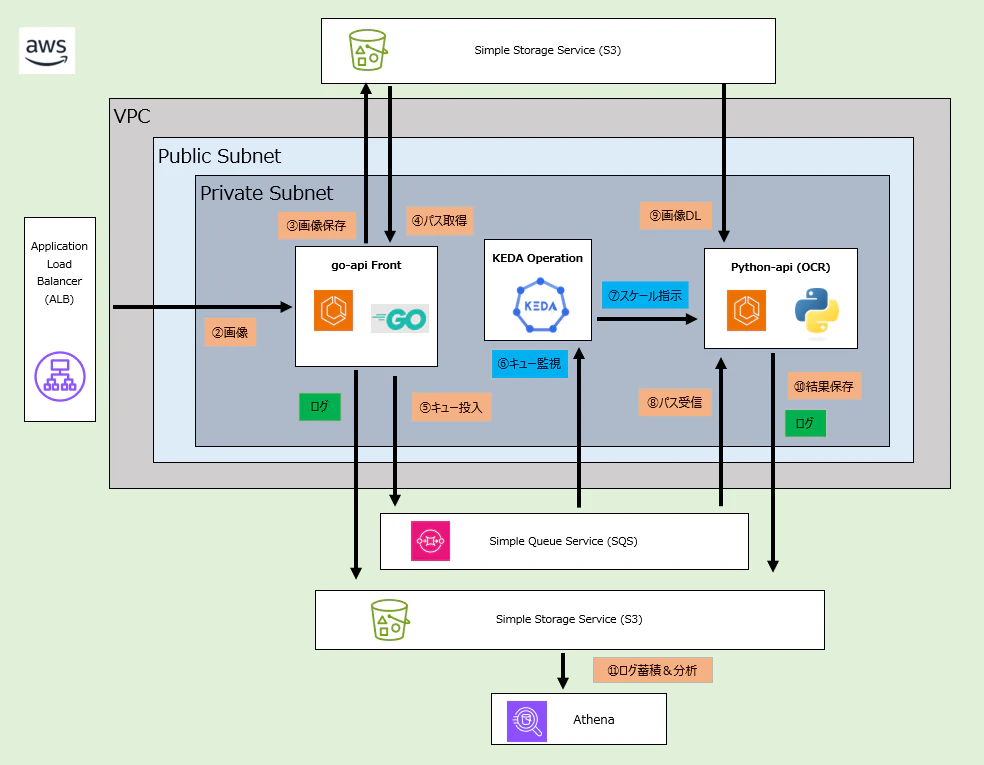
3.APIサーバー(Go)
本システムの玄関口となるGo APIサーバー(uploadHandler)は、クライアントからの画像アップロードを受け付け、AWSのマネージドサービス(S3/SQS)へ迅速にタスクを委譲(非同期化)します。
これにより、背後の重いOCR処理に影響されない極めて高い応答性能(低レイテンシー) を実現しています。
🔄 処理シーケンスと計測ロジック
単にタスクをキューイングするだけでなく、処理性能の分析(S3アップロード時間)と構造化ログの出力を同時に行い、可観測性を確保しています。
📁 ソースファイル構成
Goアプリケーションはファイル分割し、以下の様な構成をとっています。
| ファイル名 | 概要 |
|---|---|
| main.go | サーバーの起動とAWS初期化 |
| handlers.go | メインロジック(ハンドラー)の実行 |
| types.go | データ構造(構造体)の定義 |
3-1.types.go
システム全体の 可観測性(Observability) を支えるため、S3保存やコンテナの標準出力で共通利用する構造化ログの型を定義しているファイルです。
./go/type.go
package main

// ProcessLogPayload はS3出力および標準出力(コンテナログ)で共通利用する構造化ログの定義です。
type ProcessLogPayload struct {
	RequestID     string  `json:"request_id"`        // ユニークなリクエストID
	Step          string  `json:"step"`              // ログが記録されたフェーズ(GoAPI受付等)
	DurationStart int64   `json:"duration_start_ms"` // 処理開始からS3への画像書き込み完了までのミリ秒
	DurationEnd   int64   `json:"duration_end_ms"`   // 処理開始からSQSへのキュー投入完了までのミリ秒
	CPUUsage      float64 `json:"cpu_usage"`         // 処理中に計測された平均CPU使用率
	PodName       string  `json:"pod_name"`          // 処理を実行したKubernetesのPod名
	Expected      string  `json:"expected"`          // 検証用の期待値メタデータ
	Status        string  `json:"status"`            // 処理ステータス(SUCCESS / ERROR等)
}
3-2. handlers.go
クライアントから送られた画像リクエストを検証し、S3への保存とSQSへのキュー投入を連続して実行します。
ポイント
-
処理時間の計測
リクエスト受付からAWS処理(S3/SQS)完了、および構造化ログ出力直前までの時間を計測し、「Go APIの総処理時間」を算出・可視化します。 -
オンメモリでのストリーム転送
クライアントから受信した画像ファイルを、マルチパートフォームのストリームのまま直接S3へ流し込むことで、メモリ消費を抑えます。 -
疎結合な非同期パイプライン
画像をS3に保存した直後、そのURLとメタデータ(RequestIDや期待値)をSQSへ即座に送信し、重い解析は後続のPythonワーカーに委譲して即座に応答します。
./go/handlers.go
package main

import (
	"encoding/json"
	"fmt"
	"log"
	"net/http"
	"os"
	"path/filepath"
	"strings"
	"time"

	"github.com/aws/aws-sdk-go-v2/aws"
	"github.com/aws/aws-sdk-go-v2/service/s3"
	"github.com/aws/aws-sdk-go-v2/service/sqs"
	"github.com/aws/aws-sdk-go-v2/service/sqs/types"
	"github.com/shirou/gopsutil/v4/cpu"
)

// uploadHandler はフロントエンドからの画像アップロードを受け付け、S3保存とSQSキュー投入を行います。
func uploadHandler(w http.ResponseWriter, r *http.Request) {
	startTime := time.Now()

	// CPUストップウォッチのリセット
	_, _ = cpu.Percent(0, false)

	// 絶対時刻を「秒.ミリ秒」の文字列として生成
	goRequestTime := fmt.Sprintf("%f", float64(startTime.UnixNano())/1e9)

	if r.Method != http.MethodPost {
		http.Error(w, "POSTメソッドのみ受け付けます", http.StatusMethodNotAllowed)
		return
	}

	podName := os.Getenv("POD_NAME")
	if podName == "" {
		podName = "local-aws-container"
	}

	requestID := r.FormValue("request_id")
	expectedText := r.FormValue("expected")

	if requestID == "" {
		requestID = fmt.Sprintf("req-%d", startTime.UnixNano())
	}

	// クライアントから送信された実際の画像ファイルを取得
	file, header, err := r.FormFile("image")
	if err != nil {
		http.Error(w, "ファイルの取得に失敗しました: "+err.Error(), http.StatusBadRequest)
		return
	}
	defer file.Close()

	ext := filepath.Ext(header.Filename)
	if ext == "" {
		ext = ".png"
	}
	fileName := fmt.Sprintf("uploads/%s%s", requestID, ext)

	reqCtx := r.Context()

	// 画像をS3バケットへアップロード
	_, err = s3Client.PutObject(reqCtx, &s3.PutObjectInput{
		Bucket: aws.String(bucketName),
		Key:    aws.String(fileName),
		Body:   file,
	})
	if err != nil {
		log.Printf("❌ S3画像書き込み失敗: %v\n", err)
		http.Error(w, "S3画像書き込み失敗", http.StatusInternalServerError)
		return
	}

	// S3画像書き込み完了までの期間をミリ秒で計測
	durationStart := time.Since(startTime).Milliseconds()
	realS3Path := fmt.Sprintf("s3://%s/%s", bucketName, fileName)

	// メッセージを後続のPython Workerへ送るためSQSへキュー投入
	_, err = sqsClient.SendMessage(reqCtx, &sqs.SendMessageInput{
		QueueUrl:    aws.String(queueURL),
		MessageBody: aws.String(realS3Path),
		MessageAttributes: map[string]types.MessageAttributeValue{
			"request_id": {
				DataType:    aws.String("String"),
				StringValue: aws.String(requestID),
			},
			"expected": {
				DataType:    aws.String("String"),
				StringValue: aws.String(expectedText),
			},
			"go_request_time": {
				DataType:    aws.String("String"),
				StringValue: aws.String(goRequestTime),
			},
		},
	})
	if err != nil {
		log.Printf("❌ SQS送信失敗: %v\n", err)
		http.Error(w, "SQS送信失敗", http.StatusInternalServerError)
		return
	}

	// SQS送信完了(処理全体の終了)までの期間をミリ秒で計測
	durationEnd := time.Since(startTime).Milliseconds()

	// 処理終了直後の平均CPU使用率を取得
	percent, _ := cpu.Percent(0, false)
	var cpuVal float64
	if len(percent) > 0 {
		cpuVal = percent[0]
	}

	// 構造化ログの生成とS3への保存
	payload := ProcessLogPayload{
		RequestID:     requestID,
		Step:          "go",
		DurationStart: durationStart,
		DurationEnd:   durationEnd,
		CPUUsage:      cpuVal,
		PodName:       podName,
		Expected:      expectedText,
		Status:        "SUCCESS",
	}

	jsonData, err := json.Marshal(payload)
	if err == nil {
		logFileName := fmt.Sprintf("logs/go/%s_log.json", requestID)
		_, s3LogErr := s3Client.PutObject(reqCtx, &s3.PutObjectInput{
			Bucket: aws.String(bucketName),
			Key:    aws.String(logFileName),
			Body:   strings.NewReader(string(jsonData)),
		})
		if s3LogErr != nil {
			log.Printf("⚠️ 警告: S3へのログファイル出力に失敗しました: %v\n", s3LogErr)
		}

		// コンテナ標準出力(CloudWatch/集約用)
		fmt.Println(string(jsonData))
	} else {
		log.Printf("❌ ログのJSON変換失敗: %v\n", err)
	}

	w.WriteHeader(http.StatusOK)
	w.Write([]byte("画像アップロード & パイプライン投入 成功!\n"))
}
3-3. main.go
Webサーバーの起動、環境変数の読み込み、およびAWS SDK v2クライアントの初期化を担当するプログラムです。
自動監視(ヘルスチェック)への対応生存確認用のURL(/healthz)により、Kubernetes/ロードバランサーが「Go健康状態」を自動チェックできる様になります。
./go/main.go
package main

import (
	"context"
	"log"
	"net/http"
	"os"

	// AWS SDK v2

	"github.com/aws/aws-sdk-go-v2/config"
	"github.com/aws/aws-sdk-go-v2/service/s3"
	"github.com/aws/aws-sdk-go-v2/service/sqs"
)

// グローバルに共有するAWSクライアントと設定情報
var (
	s3Client   *s3.Client
	sqsClient  *sqs.Client
	bucketName string
	queueURL   string
)

func main() {
	ctx := context.Background()
	log.Println("🚀 AWS版 Go(front) Webサーバーの初期化を開始します...")

	// 環境変数の読み込み
	bucketName = os.Getenv("AWS_S3_BUCKET")
	queueURL = os.Getenv("AWS_SQS_QUEUE_URL")

	// AWS SDKの初期設定ロード
	cfg, err := config.LoadDefaultConfig(ctx)
	if err != nil {
		log.Fatalf("❌ AWS設定の読み込みに失敗: %v", err)
	}
	s3Client = s3.NewFromConfig(cfg)
	sqsClient = sqs.NewFromConfig(cfg)

	// ヘルスチェック用エンドポイント(NLB・Kubernetes用)
	http.HandleFunc("/healthz", func(w http.ResponseWriter, r *http.Request) {
		w.WriteHeader(http.StatusOK)
		w.Write([]byte("OK"))
	})

	// フロントエンドのアップロード受付エンドポイント
	http.HandleFunc("/upload", uploadHandler)

	log.Println("🎉 Webサーバーがポート8080で待機中...")
	if err := http.ListenAndServe(":8080", nil); err != nil {
		log.Fatalf("サーバー起動失敗: %v", err)
	}
}
4.推論サーバ(python)
Pythonワーカー(main.py)は、Go APIサーバーが送信したAmazon SQSメッセージをトリガーに動作する、非同期の機械学習(OCR)推論エンジンです。
コンテナ起動時のオーバーヘッド削減、キューの滞留時間計測、Kubernetes環境での安全なPodの縮退(シャットダウン) への対応処理も実装しています。
🔄 処理シーケンスとライフサイクル
モデルの事前ロードによる高速化や、シグナル検知によるグレースフルシャットダウン(安全停止)など、クラウドネイティブな処理を実装しています。
📁 ソースファイル構成
ファイル分割し、以下の様な構成をとっています。
| ファイル名 | 概要 |
|---|---|
| config.py | 基盤設定・リソース初期化 |
| aws_service.py | AWS操作・入出力共通処理 |
| main.py | 実行制御・ライフサイクル管理 |
4-1.config.py
環境変数の集約、boto3クライアント(S3/SQS)の生成、および機械学習モデルの事前準備を担当するファイルです。
ポイント
-
環境依存の排除とフォールバック
各種S3バケット名やSQSのURLを環境変数から一元管理。安全なデフォルト値を設定することで、本番環境とローカル開発環境での動作切り替えを容易にしています。 -
重い機械学習モデルのプレロード
起動時に日本語・英語の文字認識モデルをメモリ上に一度だけロード(gpu=FalseによるCPU駆動)。メッセージ受信後のOCR推論を高速化し、初期化オーバーヘッドを排除しています。 -
プロセス単位のCPU監視機能
psutilライブラリを活用し、このPythonプロセス自身の純粋なCPU使用率(%)を取得する関数(get_cpu_usage)を実装。精密なパフォーマンス計測の土台を作っています。
./python/config.py
import os
import sys
import boto3
import easyocr
import psutil

# 環境変数の読み込みとデフォルト値
QUEUE_URL = os.environ.get("AWS_SQS_QUEUE_URL")
IMAGE_BUCKET = os.environ.get("AWS_S3_IMAGE_BUCKET", "keda-test-raw-images-2026-yourname")
METADATA_BUCKET = os.environ.get("AWS_S3_METADATA_BUCKET", "keda-test-metadata-2026-yourname")
POD_NAME = os.environ.get("POD_NAME", "local-python-container")
AWS_REGION = os.environ.get("AWS_REGION", "ap-northeast-1")

# AWSクライアントの初期化
SQS_CLIENT = boto3.client('sqs', region_name=AWS_REGION)
S3_CLIENT = boto3.client('s3', region_name=AWS_REGION)

# EasyOCRモデルの初期化
print("[Python Worker] EasyOCRモデルを初期化中 (日本語/英語)...", flush=True)
READER = easyocr.Reader(['ja', 'en'], gpu=False)
print("[Python Worker] EasyOCRの準備が完了しました。", flush=True)

# プロセスモニター
PROCESS_MONITOR = psutil.Process(os.getpid())
PROCESS_MONITOR.cpu_percent(interval=None)  # 初期化

def get_cpu_usage():
    """現在のPythonプロセスの実際のCPU使用率(%)を計測"""
    try:
        return PROCESS_MONITOR.cpu_percent(interval=None)
    except Exception as e:
        print(f"⚠ CPU使用率の計測に失敗: {e}", file=sys.stderr, flush=True)
        return 0.0
4-2.aws_service.py
AWS(S3 / SQS)との直接的な通信およびデータ入出力(I/O処理)をカプセル化した共通関数ファイルです。
ポイント
-
インメモリデータ転送による成果物・ログの永続化
OCRの解析テキスト(.txt)や構造化ログ(.json)をローカルディスクに保存せず、メモリ上でバイトデータに変換(.encode('utf-8'))して直接 S3 にput_object転送する高効率な設計です。 -
障害時の即時リトライ(可視性タイムアウトの制御)
処理中にエラーが発生した場合、change_message_visibilityを用いてメッセージの可視性タイムアウトを即座に0にリセットします。これにより、別ワーカーが1秒も無駄にせず即座に再処理(リトライ)を引き継げる堅牢性を確保しています。
./python/aws_service.py
import os
import sys
import time
import json
from config import S3_CLIENT, SQS_CLIENT, METADATA_BUCKET, QUEUE_URL

def download_image_from_s3(s3_path):
    """S3から画像をローカルにダウンロード"""
    path_without_scheme = s3_path.replace("s3://", "")
    parts = path_without_scheme.split("/", 1)
    bucket_name, key_name = parts[0], parts[1]
    local_filename = os.path.basename(key_name)

    S3_CLIENT.download_file(bucket_name, key_name, local_filename)
    print(f"[Python Worker] ダウンロード完了: {os.path.abspath(local_filename)}", flush=True)
    return local_filename

def save_result_to_s3(s3_path, detected_text):
    """EasyOCRが解析したテキストを成果物保存用バケットに保存"""
    original_filename = os.path.basename(s3_path)
    base, _ = os.path.splitext(original_filename)
    result_filename = f"results/{base}_result.txt"

    log_content = (
        f"Timestamp: {time.strftime('%Y-%m-%d %H:%M:%S')}\n"
        f"FileName: {s3_path}\n"
        f"Status: SUCCESS\n"
        f"DetectedText:\n{detected_text}\n"
    )

    S3_CLIENT.put_object(
        Bucket=METADATA_BUCKET,
        Key=result_filename,
        Body=log_content.encode('utf-8'),
        ContentType='text/plain; charset=utf-8'
    )
    print(f"[Python Worker] 成果物をS3に保存しました: s3://{METADATA_BUCKET}/{result_filename}", flush=True)

def save_log_to_s3(request_id, log_payload):
    """AWS上の階層に構造化JSONログを保存"""
    log_filename = f"logs/python/{request_id}_log.json"
    try:
        json_data = json.dumps(log_payload)
        S3_CLIENT.put_object(
            Bucket=METADATA_BUCKET,
            Key=log_filename,
            Body=json_data.encode('utf-8'),
            ContentType='application/json'
        )
        print(json_data, flush=True)
    except Exception as e:
        print(f"⚠ S3へのログファイル出力に失敗しました: {e}", file=sys.stderr, flush=True)

def reset_visibility(receipt_handle):
    """エラー時にメッセージの可視性タイムアウトを0にリセット"""
    if not receipt_handle:
        return
    try:
        SQS_CLIENT.change_message_visibility(
            QueueUrl=QUEUE_URL,
            ReceiptHandle=receipt_handle,
            VisibilityTimeout=0
        )
        print("[Python Worker] エラーのため可視性タイムアウトを0にリセットしました。", flush=True)
    except Exception as err:
        print(f"⚠ 可視性リセット失敗: {err}", file=sys.stderr, flush=True)
4-3.main.py
常駐型イベントループの制御、終了シグナルの監視、および業務ロジックの実行順序を統括する、アプリケーションの「脳」にあたるメインプログラムです。
ポイント
-
グレースフルシャットダウン(安全停止)の実装
signalモジュールを活用し、Kubernetes(KEDA等)のオートスケール縮退時にインフラから送られる終了合図(SIGTERM)を検知。処理中のOCRタスクを中断させず、キリの良い着地点(処理完了)まで安全に遂行してから自動終了(sys.exit(0))する堅牢なプロセス管理を行っています。 -
リソース効率の最適化
SQSのロングポーリング(WaitTimeSeconds=10)による効率的な待機に加え、キューが空(メッセージなし)で返ってきた直後には time.sleep(0.1) のウェイトを入れる二重の安全設計を採用。常駐プログラムにありがちな無駄な連続リクエストや、予期せぬCPUの空回りを徹底的に防止しています。 -
例外発生時のフォールトトレランス
処理中に予期せぬエラーが発生した場合でも、一時ファイル(画像)の確実なクリーンアップ、SQSメッセージの可視性タイムアウトの即時リセット、および「FAILED」ステータスの構造化ログ出力するエラーハンドリングを実装しています。
./python/main.py
import os
import sys
import time
import signal
from config import QUEUE_URL, POD_NAME, READER, get_cpu_usage
from aws_service import (
    SQS_CLIENT, download_image_from_s3, save_result_to_s3,
    save_log_to_s3, reset_visibility
)

shutdown_requested = False

def receive_sigterm(signum, frame):
    global shutdown_requested
    print("[Python Worker] 終了シグナルを検知しました。現在の処理が完了次第停止します。", flush=True)
    shutdown_requested = True

def process_message():
    receipt_handle = None
    local_filename = None
    request_id = f"gen-py-{int(time.time()*1000)}"
    go_request_time = time.time()
    expected_text = ""
    s3_path = ""

    try:
        response = SQS_CLIENT.receive_message(
            QueueUrl=QUEUE_URL, MaxNumberOfMessages=1, WaitTimeSeconds=10, MessageAttributeNames=['All']
        )
    except Exception as e:
        print(f"SQSからの受信エラー: {e}", file=sys.stderr, flush=True)
        return False

    if 'Messages' not in response:
        return False

    message = response['Messages'][0]
    receipt_handle = message['ReceiptHandle']
    s3_path = message['Body']

    # 属性の取得
    attrs = message.get('MessageAttributes', {})
    request_id = attrs.get("request_id", {}).get("StringValue", request_id)
    expected_text = attrs.get("expected", {}).get("StringValue", "")
    go_request_time_str = attrs.get("go_request_time", {}).get("StringValue", None)
    if go_request_time_str:
        go_request_time = float(go_request_time_str)

    print(f"\n[Python Worker] 受信成功! RequestID: {request_id}", flush=True)

    # CPU計測の初期化
    get_cpu_usage()
    duration_start = int((time.time() - go_request_time) * 1000)

    try:
        # ダウンロードとOCR処理
        local_filename = download_image_from_s3(s3_path)
        print(f"[Python Worker] EasyOCRで解析中: {local_filename} ...", flush=True)

        ocr_results = READER.readtext(local_filename, detail=0)
        detected_text = " ".join(ocr_results).strip()

        cpu_val = get_cpu_usage()
        save_result_to_s3(s3_path, detected_text)

        # ファイル削除とメッセージ削除
        if local_filename and os.path.exists(local_filename):
            os.remove(local_filename)
        SQS_CLIENT.delete_message(QueueUrl=QUEUE_URL, ReceiptHandle=receipt_handle)

        duration_end = int((time.time() - go_request_time) * 1000)
        is_match = 1 if expected_text and expected_text in detected_text else 0

        # 成功ログの保存
        log_payload = {
            "request_id": request_id, "step": "python", "duration_start_ms": duration_start,
            "duration_end_ms": duration_end, "cpu_usage": cpu_val, "pod_name": POD_NAME,
            "expected": expected_text, "detected": detected_text, "is_match": is_match, "status": "SUCCESS"
        }
        save_log_to_s3(request_id, log_payload)
        return True

    except Exception as e:
        print(f"[重大エラー] エラーが発生: {e}", file=sys.stderr, flush=True)
        if local_filename and os.path.exists(local_filename):
            os.remove(local_filename)

        reset_visibility(receipt_handle)

        # エラー時もFAILEDログをS3に残す(推奨改善案)
        log_payload = {
            "request_id": request_id, "step": "python", "duration_start_ms": duration_start,
            "duration_end_ms": int((time.time() - go_request_time) * 1000), "cpu_usage": get_cpu_usage(),
            "pod_name": POD_NAME, "expected": expected_text, "detected": f"ERROR: {str(e)}", "is_match": 0, "status": "FAILED"
        }
        save_log_to_s3(request_id, log_payload)
        return False

def main():
    signal.signal(signal.SIGTERM, receive_sigterm)
    signal.signal(signal.SIGINT, receive_sigterm)
    print("[Python Worker] 起動しました。ループを開始します。", flush=True)

    while not shutdown_requested:
        if process_message():
            continue
        time.sleep(0.1)

    print("[Python Worker] 安全にシャットダウンを完了しました。", flush=True)
    sys.exit(0)

if __name__ == "__main__":
    main()
5.Terraformによるインフラ自動化
インフラの構築には Infrastructure as Code(IaC) を採用し、Terraformを用いて全リソースをコード管理しています。
📁 ソースファイル構成
| ファイル名 | 概要 |
|---|---|
| providers.tf | クラウド事業者(AWS)およびリージョンの定義 |
| main.tf | ネットワーク基盤(VPC)、S3、SQS、ECRの構築 |
| eks.tf | EKSクラスターおよびノードグループの構築 |
| iam.tf | IAMロールとIRSAの定義 |
| albc.tf | AWS Load Balancer Controller用リソースの構築 |
| output.tf | デプロイ結果の出力 |
5-1.providers.tf
Terraformが操作する対象(AWS)と、リソースを構築するリージョンを指定する設定ファイルです。
./terraform/providers.tf
provider "aws" {
  region = "ap-northeast-1" # 東京リージョン
}
5-2.main.tf
概要
データの保管場所(S3)、通信キュー(SQS)、コンテナレジストリ(ECR)、およびEKSを配置するネットワーク基盤(VPC)を定義しています。
ポイント
-
インメモリ処理を支えるストレージ分離:
画像保管用(raw_images)とログ・成果物保存用(metadata)の2つのS3バケットを完全分離して作成。 -
スパイク負荷を吸収する高効率キュー:
アプリケーション側の例外ハンドリング(可視性タイムアウトの制御)と調和する、Amazon SQS(ロングポーリング10秒設定)を配置。 -
AWS ALB Controllerと連動するVPC設計:
冗長性を確保するため、2つの可用性ゾーン(1a / 1c)にサブネットを分散配置。
また、ロードバランサーが全自動で正しく作られるための「目印(専用タグ)」をサブネットに設定しています。
./terraform/main.tf
# ----------------------------------------------------
# データの保管と通信(S3バケット / SQSキュー)
# ----------------------------------------------------
resource "aws_s3_bucket" "raw_images" {
  bucket        = "keda-test-raw-images-2026-yourname"
  force_destroy = true
}

resource "aws_s3_bucket" "metadata" {
  bucket        = "keda-test-metadata-2026-yourname"
  force_destroy = true
}

resource "aws_sqs_queue" "image_queue" {
  name                      = "keda-test-image-queue"
  delay_seconds             = 0
  max_message_size          = 262144
  message_retention_seconds = 86400
  receive_wait_time_seconds = 10
}

# ----------------------------------------------------
# コンテナイメージの保管場所(ECR)
# ----------------------------------------------------
resource "aws_ecr_repository" "go_app" {
  name                 = "keda-test-go-app"
  image_tag_mutability = "MUTABLE"
  force_delete         = true
  image_scanning_configuration { scan_on_push = true }
}

resource "aws_ecr_repository" "python_app" {
  name                 = "keda-test-python-app"
  image_tag_mutability = "MUTABLE"
  force_delete         = true
  image_scanning_configuration { scan_on_push = true }
}

# ----------------------------------------------------
# EKS用のネットワーク基盤(VPC / Subnet)
# ----------------------------------------------------
resource "aws_vpc" "eks_vpc" {
  cidr_block           = "10.0.0.0/16"
  enable_dns_support   = true
  enable_dns_hostnames = true
  tags                 = { Name = "keda-test-eks-vpc" }
}

resource "aws_internet_gateway" "igw" {
  vpc_id = aws_vpc.eks_vpc.id
  tags   = { Name = "keda-test-igw" }
}

resource "aws_subnet" "public_1" {
  vpc_id                  = aws_vpc.eks_vpc.id
  cidr_block              = "10.0.1.0/24"
  availability_zone       = "ap-northeast-1a"
  map_public_ip_on_launch = true
  tags = {
    Name                                      = "keda-test-public-1",
    "kubernetes.io/role/elb"                  = "1",
    "kubernetes.io/cluster/keda-test-cluster" = "shared"
  }
}

resource "aws_subnet" "public_2" {
  vpc_id                  = aws_vpc.eks_vpc.id
  cidr_block              = "10.0.2.0/24"
  availability_zone       = "ap-northeast-1c"
  map_public_ip_on_launch = true
  tags = {
    Name                                      = "keda-test-public-2",
    "kubernetes.io/role/elb"                  = "1",
    "kubernetes.io/cluster/keda-test-cluster" = "shared"
  }
}

resource "aws_route_table" "public_rt" {
  vpc_id = aws_vpc.eks_vpc.id
  route {
    cidr_block = "0.0.0.0/0"
    gateway_id = aws_internet_gateway.igw.id
  }
  tags = { Name = "keda-test-public-rt" }
}

resource "aws_route_table_association" "public_1" {
  subnet_id      = aws_subnet.public_1.id
  route_table_id = aws_route_table.public_rt.id
}

resource "aws_route_table_association" "public_2" {
  subnet_id      = aws_subnet.public_2.id
  route_table_id = aws_route_table.public_rt.id
}
5-3.eks.tf
概要
システムの司令塔となる EKSクラスター(コントロールプレーン) と、実際にコンテナアプリケーション(Pod)が動作する マネージドワーカーノード(データプレーン) を構築しています。
ポイント
-
KEDAの自動増減(スケール)機能
KEDA(Kubernetes Event-driven Autoscaling)によるイベント駆動型の高速なPod急増にインフラ層が追従できるような、ノードの自動スケーリング設定を 「最小1台 〜 最大7台(希望数5台)」 とバッファを広めに持たせています。 -
IRSA(Pod用IAM)のための認証基盤の構築
AWSリソースとKubernetesのServiceAccountを安全に紐付けるため、OIDC(OpenID Connect)プロバイダーを合わせて定義しています。
📌 【補足】インスタンス選定と権限について
-
パソコンのパワー(スペック)について:
スケーリング状況の把握のため小さめで安価なサーバー(t3.small)を複数台並べていますが、本来は大きめのサーバー(m5.large以上)を選定が望ましい。 -
アクセス権限について:
テストのスムーズ化のため今回はサーバーに管理者権限を付与していますが、本来はアプリごとに必要最低限の権限を付与するのが望ましい。
./terraform/eks.tf
# ----------------------------------------------------
# EKS クラスターコントロールプレーン
# ----------------------------------------------------
resource "aws_iam_role" "eks_cluster_role" {
  name = "keda-test-eks-cluster-role"
  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Action    = "sts:AssumeRole"
      Effect    = "Allow"
      Principal = { Service = "eks.amazonaws.com" }
    }]
  })
}

resource "aws_iam_role_policy_attachment" "eks_cluster_policy" {
  policy_arn = "arn:aws:iam::aws:policy/AmazonEKSClusterPolicy"
  role       = aws_iam_role.eks_cluster_role.name
}

resource "aws_eks_cluster" "eks" {
  name                      = "keda-test-cluster"
  role_arn                  = aws_iam_role.eks_cluster_role.arn
  enabled_cluster_log_types = ["api", "audit", "authenticator", "controllerManager", "scheduler"]

  vpc_config {
    endpoint_private_access = true
    endpoint_public_access  = true
    subnet_ids              = [aws_subnet.public_1.id, aws_subnet.public_2.id]
  }
  depends_on = [aws_iam_role_policy_attachment.eks_cluster_policy]
}

# ----------------------------------------------------
# EKS ワーカーノードグループ(Managed Node Group)
# ----------------------------------------------------
resource "aws_iam_role" "node_role" {
  name = "keda-test-eks-node-role"
  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Action    = "sts:AssumeRole"
      Effect    = "Allow"
      Principal = { Service = "ec2.amazonaws.com" }
    }]
  })
}

resource "aws_iam_role_policy_attachment" "node_AmazonEKSWorkerNodePolicy" {
  policy_arn = "arn:aws:iam::aws:policy/AmazonEKSWorkerNodePolicy"
  role       = aws_iam_role.node_role.name
}

resource "aws_iam_role_policy_attachment" "node_AmazonEKS_CNI_Policy" {
  policy_arn = "arn:aws:iam::aws:policy/AmazonEKS_CNI_Policy"
  role       = aws_iam_role.node_role.name
}

resource "aws_iam_role_policy_attachment" "node_AmazonEC2ContainerRegistryReadOnly" {
  policy_arn = "arn:aws:iam::aws:policy/AmazonEC2ContainerRegistryReadOnly"
  role       = aws_iam_role.node_role.name
}

# 検証用(実運用ではIRSAによる最小特権を推奨)
resource "aws_iam_role_policy_attachment" "node_AmazonAdministratorAccess" {
  policy_arn = "arn:aws:iam::aws:policy/AdministratorAccess"
  role       = aws_iam_role.node_role.name
}

resource "aws_eks_node_group" "nodes" {
  cluster_name    = aws_eks_cluster.eks.name
  node_group_name = "keda-test-node-group"
  node_role_arn   = aws_iam_role.node_role.arn
  subnet_ids      = [aws_subnet.public_1.id, aws_subnet.public_2.id]
  instance_types  = ["t3.small"]

  scaling_config {
    desired_size = 5 # EasyOCR(Python)用にリソースを多めに確保
    max_size     = 7 # KEDAのスパイクに備えて最大数を広げる
    min_size     = 1
  }
}

# ----------------------------------------------------
# OIDCプロバイダー (IRSA:ServiceAccount連携用の認証基盤)
# ----------------------------------------------------
data "tls_certificate" "eks" {
  url = aws_eks_cluster.eks.identity[0].oidc[0].issuer
}

resource "aws_iam_openid_connect_provider" "eks" {
  client_id_list  = ["sts.amazonaws.com"]
  thumbprint_list = [data.tls_certificate.eks.certificates[0].sha1_fingerprint]
  url             = aws_eks_cluster.eks.identity[0].oidc[0].issuer
}
5-4.iam.tf
概要
アプリケーション(GoやPython)や、自動でサーバーの台数を調整する管理者(KEDA)が、安全にAWSのデータ(S3)やメッセージ(SQS)にアクセスするための「通行証(アクセス権限)」 を定義しています。
ポイント
-
IRSA(IAM Roles for Service Accounts)による強固なセキュリティ
EKSのOIDCプロバイダーを介して、KubernetesのServiceAccountとAWS IAMロールを1対1で紐付ける事で、コンテナ内にAWSアクセスキーは不要となります。 -
Pod単位での厳格な権限分離
Goアプリ(API/キュー登録)とPythonアプリ(Worker/推論処理)に対して、必要なS3/SQSの操作(閲覧・書き込み・削除)のみをピンポイントで許可。 -
KEDA専用の最小権限ロールの定義
イベント駆動オートスケールを司る KEDAが、安全にSQSキューの滞留数(メッセージ数)を監視できるよう、キュー属性の取得のみに絞った専用ロールを割り当てています。
./terraform/iam.tf
#####################################################################
## Go/PythonアプリがSQSとS3にアクセスする権限に関する設定
#####################################################################
resource "aws_iam_policy" "app_sqs_s3" {
  name        = "keda-test-app-policy"
  description = "Policy for Go/Python apps to access SQS and S3"

  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Effect = "Allow"
        Action = [
          "sqs:SendMessage",
          "sqs:ReceiveMessage",
          "sqs:DeleteMessage",
          "sqs:GetQueueUrl",
          "sqs:GetQueueAttributes",
          "sqs:ChangeMessageVisibility"
        ]
        Resource = aws_sqs_queue.image_queue.arn
      },
      {
        Effect = "Allow"
        Action = [
          "s3:PutObject",
          "s3:GetObject",
          "s3:ListBucket"
        ]
        Resource = [
          aws_s3_bucket.raw_images.arn,
          "${aws_s3_bucket.raw_images.arn}/*",
          aws_s3_bucket.metadata.arn,
          "${aws_s3_bucket.metadata.arn}/*"
        ]
      }
    ]
  })
}

# 現在実行中のAWSアカウントIDを動的に取得する
data "aws_caller_identity" "current" {}

resource "aws_iam_role" "app_role" {
  name = "keda-test-app-execution-role"

  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        # 1. EKS(OIDC)からの認証を許可
        Effect    = "Allow"
        Principal = { Federated = aws_iam_openid_connect_provider.eks.arn }
        Action    = "sts:AssumeRoleWithWebIdentity"
        Condition = {
          StringEquals = {
            "${replace(aws_eks_cluster.eks.identity[0].oidc[0].issuer, "https://", "")}:sub" = [
              "system:serviceaccount:keda-test-apps:go-app-sa",
              "system:serviceaccount:keda-test-apps:python-app-sa"
            ]
          }
        }
      }]
  })
}

resource "aws_iam_role_policy_attachment" "app_execution" {
  policy_arn = aws_iam_policy.app_sqs_s3.arn
  role       = aws_iam_role.app_role.name
}

#####################################################################
## KEDA(本体)がSQSキューの深さを監視するための権限に関する設定
#####################################################################
resource "aws_iam_policy" "keda_operator_sqs" {
  name        = "keda-operator-sqs-policy"
  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Effect   = "Allow"
      Action   = ["sqs:GetQueueAttributes", "sqs:GetQueueUrl"]
      Resource = aws_sqs_queue.image_queue.arn
    }]
  })
}


# KEDAオペレーター用 IAMロール (keda_operator)
resource "aws_iam_role" "keda_operator" {
  name = "keda-test-operator-role"

  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        # 1. EKS(OIDC)からの認証を許可
        Effect    = "Allow"
        Principal = { Federated = aws_iam_openid_connect_provider.eks.arn }
        Action    = "sts:AssumeRoleWithWebIdentity"
        Condition = {
          StringEquals = {
            "${replace(aws_eks_cluster.eks.identity[0].oidc[0].issuer, "https://", "")}:sub" = "system:serviceaccount:keda:keda-operator"
            "${replace(aws_eks_cluster.eks.identity[0].oidc[0].issuer, "https://", "")}:aud" = "sts.amazonaws.com"
          }
        }
      }]
  })
}

resource "aws_iam_role_policy_attachment" "keda_operator" {
  policy_arn = aws_iam_policy.keda_operator_sqs.arn
  role       = aws_iam_role.keda_operator.name
}
5-5.albc.tf
概要
Kubernetesのリソース(IngressやService)と連動して、AWSのロードバランサー(ALB / NLB)を自動で作成・管理するためのコンポーネント 「AWS Load Balancer Controller」 が使用するIAMロールとポリシーを定義しています。
ポイント
-
公式ポリシーの動的インポートによる保守性の向上
本コードでは、data "http"ブロックを使用してGitHub上のAWS公式最新ポリシーを動的に取得し、Terraformにインポートしています。これにより、手動による記述ミスを排除し、コードの保守性を大幅に高めています。 -
インフラ連携用IRSAの厳格な定義
コントローラーが安全にAWS上のALBなどを操作できるよう、kube-system名前空間内のaws-load-balancer-controllerに対してのみ、この強力な操作権限を引き受け(AssumeRole)られるよう信頼関係を制限しています。
./terraform/albc.tf
# ----------------------------------------------------
#  AWS Load Balancer Controller(ALB制御)用の設定
# ----------------------------------------------------
data "http" "lb_controller_policy" {
  url = "https://raw.githubusercontent.com/kubernetes-sigs/aws-load-balancer-controller/main/docs/install/iam_policy.json"
}

resource "aws_iam_policy" "aws_load_balancer_controller" {
  name        = "AWSLoadBalancerControllerIAMPolicy"
  description = "Policy for AWS Load Balancer Controller in EKS"
  policy      = data.http.lb_controller_policy.response_body
}

data "aws_iam_policy_document" "lb_controller_assume_role" {
  statement {
    actions = ["sts:AssumeRoleWithWebIdentity"]
    effect  = "Allow"

    condition {
      test     = "StringEquals"
      variable = "${replace(aws_eks_cluster.eks.identity[0].oidc[0].issuer, "https://", "")}:sub"
      values   = ["system:serviceaccount:kube-system:aws-load-balancer-controller"]
    }

    condition {
      test     = "StringEquals"
      variable = "${replace(aws_eks_cluster.eks.identity[0].oidc[0].issuer, "https://", "")}:aud"
      values   = ["sts.amazonaws.com"]
    }

    principals {
      identifiers = [aws_iam_openid_connect_provider.eks.arn]
      type        = "Federated"
    }
  }
}

resource "aws_iam_role" "lb_controller" {
  name               = "keda-test-aws-load-balancer-controller"
  assume_role_policy = data.aws_iam_policy_document.lb_controller_assume_role.json
}

resource "aws_iam_role_policy_attachment" "lb_controller" {
  role       = aws_iam_role.lb_controller.name
  policy_arn = aws_iam_policy.aws_load_balancer_controller.arn
}
5-6.output.tf
概要
Terraformによるインフラ構築が完了した際、後続のHelmデプロイやアプリ設定で必要となる「重要なアクセス先URL」や「IAMロールの識別番号(ARN)」を画面に一覧出力するファイルです。
ポイント
生成されたSQSの接続URL、ECRのイメージ保存先、各種アプリやKEDA用ServiceAccountのIAMロールARN等を確認できるようにし、インフラとアプリケーション間の連携(Helmへの値の渡し込み)をスムーズにしています。
./terraform/outputs.tf
output "sqs_url" {
  value       = aws_sqs_queue.image_queue.id
  description = "後続処理で利用するAWS SQSキューのURL"
}

output "ecr_go_app_url" {
  value       = aws_ecr_repository.go_app.repository_url
  description = "Goフロントエンド用ECRリポジトリURL"
}

output "app_execution_role_arn" {
  value       = aws_iam_role.app_role.arn
  description = "Go/PythonアプリのServiceAccountに割り当てるIAMロールARN"
}

output "keda_operator_role_arn" {
  value       = aws_iam_role.keda_operator.arn
  description = "KEDAオペレーターに割り当てるIAMロールARN"
}

output "eks_vpc_id" {
  value       = aws_vpc.eks_vpc.id
  description = "EKSクラスターを配置したVPCのID"
}

output "aws_load_balancer_controller_role_arn" {
  value       = aws_iam_role.lb_controller.arn
  description = "AWS Load Balancer Controllerに割り当てるIAMロールARN"
}
6.Helmによるワークロード管理
Kubernetes上へのアプリケーション(Go/Python)のデプロイや、KEDAによるオートスケーリング、ロードバランサー(Ingress)の設定には Helm を採用し、マニフェストのテンプレート化と一元管理を行っています。
📁 ソースファイル構成
| ファイル名 | 概要 |
|---|---|
| Chart.yaml | Helmチャートの名称やバージョンを定義するファイル |
| values.yaml | 共通利用するAWSアカウント等の環境変数定義 |
| templates/keda-settings.yaml | アプリやKEDAが使用する各種ServiceAccountと、AWS権限(IRSA)の連携定義 |
| templates/keda-python-apps.yaml | Pythonワーカーのデプロイ(Deployment)と、KEDAの自動伸縮(ScaledObject)の定義 |
| templates/keda-frontend-lb.yaml | 外からのアクセスを受け付ける窓口(Ingress/ALB)と、通信のルーティング定義 |
6-1.values.yaml
各Kubernetesマニフェストのテンプレート内で共通して参照する、AWSアカウントIDや構築リージョンなどの Helm専用パラメータ(変数) を一元管理するファイルです。
./helm/values.yaml
# AWS 共通設定
aws:
  accountId: "999999999999" # ご自身のアカウントIDに書き換えてください
  region: "ap-northeast-1"
6-2.keda-settings.yaml
概要
システム専用の分離された実行空間(Namespace)を作成し、AWSリソースへ安全にアクセスするための認証(ServiceAccount)、およびユーザーからのリクエストを受け付けるGoアプリケーション(フロントエンド)のデプロイを定義しています。
ポイント
-
HelmによるIRSA(IAMロール)の動的バインド
Terraform側で作成したAWS IAMロールのARNを、Helmの変数機能を用いて KubernetesのServiceAccountへ動的にアタッチ しています。 -
Go言語の特性を活かした軽量なリソース設計
フロントエンドのGoアプリのコンテナに対し、軽量・高速に動作するGoのメリットを活かした最適なリソースの割り当て(Requests/Limits)を行っています。 -
環境変数によるコンテナへの動的設定注入
Goアプリが利用する「SQSキューのURL」や「S3バケット名」を環境変数(env)経由で注入し、アプリケーションコードとインフラ環境を疎結合に保っています。
./helm/templates/keda-settings.yaml
apiVersion: v1
kind: Namespace
metadata:
  name: keda-test-apps
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: go-app-sa
  namespace: keda-test-apps
  annotations:
    eks.amazonaws.com/role-arn: "arn:aws:iam::{{ .Values.aws.accountId }}:role/keda-test-app-execution-role"
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: python-app-sa
  namespace: keda-test-apps
  annotations:
    eks.amazonaws.com/role-arn: "arn:aws:iam::{{ .Values.aws.accountId }}:role/keda-test-app-execution-role"
---
# ==========================================
# Goアプリ(フロントエンド)のデプロイ定義
# ==========================================
apiVersion: apps/v1
kind: Deployment
metadata:
  name: go-app
  namespace: keda-test-apps
  labels:
    app: go-app
spec:
  replicas: 1
  selector:
    matchLabels:
      app: go-app
  template:
    metadata:
      labels:
        app: go-app
    spec:
      serviceAccountName: go-app-sa
      containers:
      - name: go-app
        image: "{{ .Values.aws.accountId }}.dkr.ecr.{{ .Values.aws.region }}.amazonaws.com/keda-test-go-app:latest"
        env:
        - name: POD_NAME
          valueFrom:
            fieldRef:
              fieldPath: metadata.name #
        - name: AWS_SQS_QUEUE_URL
          value: "https://sqs.{{ .Values.aws.region }}.amazonaws.com/{{ .Values.aws.accountId }}/keda-test-image-queue"
        - name: AWS_S3_BUCKET
          value: "keda-test-raw-images-2026-yourname" #
        ports:
        - containerPort: 8080
        resources:
          requests:
            cpu: "100m"
            memory: "128Mi"
          limits:
            cpu: "200m"
            memory: "256Mi"
---
6-3.keda-python-apps.yaml
概要
重い画像解析(OCR処理)を担当するPythonアプリケーション(ワーカー)のデプロイ定義と、Amazon SQSのメッセージ滞留数に基づいてPod数をダイナミックに自動増減させる KEDA(ScaledObject / TriggerAuthentication) のスケーリングルールを定義しています。
ポイント
-
ワークロードの特性に応じたリソース設計
EasyOCRを駆動させるPythonワーカーには、コンテナ起動時や推論時のバッファを考慮して 「Requests: 1GiB / Limits: 2GiB」 と十分なメモリリソースを割り当てています。 -
KEDAによるスケーリング機能
SQSキューの滞留数(queueLength: "5")をトリガーに設定。画像リクエストが5件増えるごとにPythonワーカーのPodを自動で最大5台まで高速スケールアウトさせ、負荷減少後にはスケールダウンする機敏なインフラ追従機能を実現しています。 -
KEDA本体の認証分離(最小特権の徹底)
TriggerAuthenticationを用いて、KEDAがSQSを監視する際の認証に (IRSA) を採用しています。アプリ層の権限(python-app-sa)を使い回すのではなく、iam.tfで定義した「KEDAオペレーター専用の監視ロール」を利用させることで、コンポーネント間の境界線を守っています。
./helm/templates/keda-python-apps.yaml
# ==========================================
# Pythonアプリ(ワーカー)のデプロイ定義
# ==========================================
apiVersion: apps/v1
kind: Deployment
metadata:
  name: python-app
  namespace: keda-test-apps
  labels:
    app: python-app
spec:
  #
  replicas: 1
  selector:
    matchLabels:
      app: python-app
  template:
    metadata:
      labels:
        app: python-app
    spec:
      serviceAccountName: python-app-sa #
      containers:
      - name: python-app
        image: "{{ .Values.aws.accountId }}.dkr.ecr.{{ .Values.aws.region }}.amazonaws.com/keda-test-python-app:latest"
        env:
        - name: POD_NAME
          valueFrom:
            fieldRef:
              fieldPath: metadata.name #
        - name: AWS_SQS_QUEUE_URL
          value: "https://sqs.{{ .Values.aws.region }}.amazonaws.com/{{ .Values.aws.accountId }}/keda-test-image-queue"
        - name: AWS_S3_IMAGE_BUCKET #
          value: "keda-test-raw-images-2026-yourname"
        - name: AWS_S3_METADATA_BUCKET #
          value: "keda-test-metadata-2026-yourname"
        resources:
          requests:
            cpu: "500m"
            memory: "1Gi"
          limits:
            cpu: "1000m"
            memory: "2Gi"
---
# ==========================================
# Pythonアプリ専用:SQSのキュー数と連動させる自動増減ルール
# ==========================================
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: python-app-sqs-autoscaler
  namespace: keda-test-apps
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: python-app #

  minReplicaCount: 1
  maxReplicaCount: 5
  cooldownPeriod: 10

  triggers:
    - type: aws-sqs-queue
      metadata:
        queueURL: "https://sqs.{{ .Values.aws.region }}.amazonaws.com/{{ .Values.aws.accountId }}/keda-test-image-queue"
        queueLength: "5" #
        awsRegion: "{{ .Values.aws.region }}"
      authenticationRef:
        #
        name: keda-aws-sqs-auth
---
# ==========================================
# KEDAにIRSAの権限(WebIdentity)を使うよう指示する認証パーツ
# ==========================================
apiVersion: keda.sh/v1alpha1
kind: TriggerAuthentication
metadata:
  name: keda-aws-sqs-auth
  namespace: keda-test-apps #
spec:
  podIdentity:
    provider: aws
    identityOwner: keda
---
6-4.keda-frontend-lb.yaml
概要
インターネットの世界から、システムの受付窓口である「Goアプリ」へ安全にアクセスできるようにするため、「AWSのロードバランサー(外の窓口:Ingress)」を全自動で作り、アプリへ通信を安全に引き渡す「内線の仕組み(内部通信:Service)」 を定義しています。
ポイント
-
IPターゲットモード(
target-type: ip)による高効率ルーティング
アノテーションにtarget-type: ipを明示することで、AWS Load Balancer Controllerに対して 「ALBからPodのIPアドレスへ直接トラフィックをルーティングする」 よう指示しています。 -
インターネット公開設定の明示
scheme: internet-facingを指定し、パブリックインターネットからのリクエストを受け付ける外向きのALBとして機能させています。 -
疎結合な内部通信(ClusterIP)の採用
Kubernetes標準の内部通信サービスであるClusterIPを採用。コンテナのIPがPodの再起動等で動的に変わっても、サービス名(go-app-service)を介して安全に通信が維持される仕組みを構築しています。
./helm/templates/keda-frontend-lb.yaml
# ==========================================
# Goアプリ(フロントエンド)用の内部通信用サービス定義
# ==========================================
apiVersion: v1
kind: Service
metadata:
  name: go-app-service
  namespace: keda-test-apps #
spec:
  type: ClusterIP #
  ports:
    - port: 8080      #
      targetPort: 8080 #
      protocol: TCP
  selector:
    app: go-app #
---
# ==========================================
# インターネット公開用のロードバランサー(ALB)定義
# ==========================================
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: keda-frontend-alb
  namespace: keda-test-apps
  annotations:
    #
    kubernetes.io/ingress.class: alb
    alb.ingress.kubernetes.io/scheme: internet-facing # インターネット経由のアクセスを許可
    alb.ingress.kubernetes.io/target-type: ip        # EKSのPodへ直接トラフィックを流す(推奨)
spec:
  ingressClassName: alb #
  rules:
    - http:
        paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: go-app-service #
                port:
                  number: 8080
7.デプロイ手順
本システムをAWS(EKS)環境へデプロイし、イベント駆動オートスケール(KEDA)を有効化するまでの全手順です。手動による設定漏れを防ぎ、誰でも環境を完全再現できるよう、インフラのプロビジョニングからマニフェストの適用まで、Linux環境のコマンドベースで解説します。
7-1. 環境変数の設定
インフラの構築およびアプリケーションのデプロイで共通して使用するAWSの認証情報と識別子を環境変数に定義します。
# AWS認証情報とリージョンの設定
export AWS_ACCESS_KEY_ID="あなたのAWSアクセスキー"
export AWS_SECRET_ACCESS_KEY="あなたのAWSシークレットキー"
export AWS_DEFAULT_REGION="ap-northeast-1"

# 各種マニフェストのテンプレートで使用するAWSアカウントID
export MY_AWS_ACCOUNT_ID="あなたのAWSアカウントID"
7-2. TerraformによるAWSインフラの構築
インフラ自動化(IaC)を実行し、ネットワーク(VPC)、EKSクラスター、S3、SQS、およびIRSAに必要な各種IAMロールをプロビジョニングします。
# Terraformのソースコードが配置されているディレクトリへ移動
cd terraform/

# 初期化(AWSプロバイダーやプラグインの自動ダウンロード)
terraform init

# 実行計画の確認(構築・変更される全AWSリソースを事前にレビュー)
terraform plan

# インフラの自動構築(EKSクラスターのプロビジョニングを含め、完了まで約10〜15分かかります)
terraform apply -auto-approve

# 構築完了後、画面に出力された「Outputs」の各ARNやURLの値をメモ(後続のHelmデプロイで使用)

# プロジェクトのルートディレクトリに戻る
cd ../
7-3. イメージのビルド・リネーム・プッシュ
開発したGoアプリ(フロントエンド)とPythonアプリ(OCRワーカー)のコンテナイメージをビルドし、先ほどTerraformで作成した Amazon ECR(Elastic Container Registry)リポジトリへアップロードします。
7-3-1. Goアプリ(フロントエンド)
# Goアプリのソースコードがあるディレクトリへ移動
cd go/

# イメージのビルドからECRプッシュまでを自動実行するスクリプトを叩く
./cmd_docker_go

# ルートディレクトリに戻る
cd ../
スクリプト内容(./go/cmd_docker_go)
#!/bin/bash

# エラーが発生したらその時点でスクリプトを停止させる安全設定
set -e

# 変数の設定確認
echo ${AWS_DEFAULT_REGION}
echo ${MY_AWS_ACCOUNT_ID}

#---------------------------------------------------------------------------------------
#① AWS ECRへのログイン認証
#---------------------------------------------------------------------------------------
aws ecr get-login-password --region ${AWS_DEFAULT_REGION} | docker login --username AWS --password-stdin ${MY_AWS_ACCOUNT_ID}.dkr.ecr.${AWS_DEFAULT_REGION}.amazonaws.com

#---------------------------------------------------------------------------------------
#② Goアプリのビルドとプッシュ
#---------------------------------------------------------------------------------------
# Goのソースコードがあるディレクトリに移動して実行
echo "--- 1. go イメージの ビルド  ---"
docker build -t keda-test-go-app .

echo "--- 2. go イメージの リネーム ---"
docker tag keda-test-go-app:latest "${MY_AWS_ACCOUNT_ID}.dkr.ecr.${AWS_DEFAULT_REGION}.amazonaws.com/keda-test-go-app:latest"


echo "--- 3. go イメージの push ---"
docker push "${MY_AWS_ACCOUNT_ID}.dkr.ecr.${AWS_DEFAULT_REGION}.amazonaws.com/keda-test-go-app:latest"
7-3-2. Pythonアプリ(OCRワーカー)
# Pythonアプリのソースコードがあるディレクトリへ移動
cd python/

# イメージのビルドからECRプッシュまでを自動実行するスクリプトを叩く
./cmd_docker_python

# ルートディレクトリに戻る
cd ..
スクリプト内容(./python/cmd_docker_python)
#!/bin/bash

# エラーが発生したらその時点でスクリプトを停止させる安全設定
set -e

#---------------------------------------------------------------------------------------
#② pythonアプリのビルドとプッシュ
#---------------------------------------------------------------------------------------
# pythonのソースコードがあるディレクトリに移動して実行
echo "--- 1. python イメージの ビルド  ---"
docker build -t keda-test-python-app .


echo "--- 2. python イメージの リネーム ---"
docker tag keda-test-python-app:latest "${MY_AWS_ACCOUNT_ID}.dkr.ecr.${AWS_DEFAULT_REGION}.amazonaws.com/keda-test-python-app:latest"


echo "--- 3. python イメージの push ---"
docker push "${MY_AWS_ACCOUNT_ID}.dkr.ecr.${AWS_DEFAULT_REGION}.amazonaws.com/keda-test-python-app:latest"
7-4. アプリケーションのデプロイ (Helm)
構築したEKSクラスターへローカル環境から安全に接続できるよう認証を通し、外部通信を司る AWS Load Balancer Controller と、本システムのコア機能であるイベント駆動オートスケーラー KEDA、および自作アプリケーションを一括でデプロイします。
7-4-1. 連携用の環境変数を設定
Terraformの実行完了後、ターミナルに出力された「Outputs」の実際の値を、以下の環境変数に代入して後続スクリプトへ連携させます。
###################################
# Terraform実行結果に基づく変数設定
###################################

# ① 出力結果「aws_load_balancer_controller_role_arn」の値を設定
ALBC_ARN="arn:aws:iam::${MY_AWS_ACCOUNT_ID}:role/keda-test-aws-load-balancer-controller"

# ② 出力結果「keda_operator_role_arn」の値を設定
KEDA_ARN="arn:aws:iam::${MY_AWS_ACCOUNT_ID}:role/keda-test-operator-role"

# ③ 出力結果「eks_vpc_id」の値を設定
EKS_VPC_ID="vpc-0856608d649994725"
7-4-2. デプロイスクリプトの実行
マニフェストとデプロイ用スクリプトが格納されている helm/ ディレクトリへ移動し、一括インストール用の自動化スクリプトを実行します。
# helm ディレクトリに移動
cd helm/

# 各種コントローラーの導入から自作アプリの展開までを一括デプロイ
./cmd_helm
スクリプト内容(./helm/cmd_helm)
###################################
# 実行
###################################
echo "--- 1. Helmリポジトリの登録と更新 ---"
helm repo add eks https://aws.github.io/eks-charts
helm repo add kedacore https://kedacore.github.io/charts
helm repo update

echo "--- 2. EKS への接続設定 ---"
# 1. AWS EKS クラスターの接続情報を自動生成して保存します
aws eks update-kubeconfig --name keda-test-cluster --region ${AWS_DEFAULT_REGION}

echo "--- 3. KEDAのインストール ---"
#------------------------------------------------------
helm install keda kedacore/keda \
  --namespace keda \
  --create-namespace \
  --set serviceAccount.operator.annotations.'eks\.amazonaws\.com/role-arn'="$KEDA_ARN" \
  --set crds.install=true


echo "--- 4. AWS Load Balancer Controllerのインストール ---"
#------------------------------------------------------
helm install aws-load-balancer-controller eks/aws-load-balancer-controller \
  -n kube-system \
  --set clusterName=keda-test-cluster \
  --set vpcId=$EKS_VPC_ID \
  --set serviceAccount.create=true \
  --set serviceAccount.name=aws-load-balancer-controller \
  --set serviceAccount.annotations.'eks\.amazonaws\.com/role-arn'="$ALBC_ARN"

# コントローラーが完全に起動するまで45秒待機する
echo "AWS Load Balancer Controllerの起動を待機中(45秒)..."
sleep 45

echo "--- 5. 自作アプリのデプロイ ---"
#------------------------------------------------------
helm install keda-test-release . \
  -n keda-test-apps \
  --create-namespace \
  --set aws.accountId="${MY_AWS_ACCOUNT_ID}" \
  --set aws.region="${AWS_DEFAULT_REGION}"
7-5. デプロイの確認コマンド
各コントローラーとアプリケーションのデプロイ完了後、以下のコンポーネントがKubernetes上で正常に稼働しているかをターミナルから確認します。
# 1. 外部公開用URL(ALBのDNS名)の確認
# ※「ADDRESS」の欄にAWSのALBエンドポイント(〜.amazonaws.com)が表示されれば、インターネット経由の疎通準備は完了です
kubectl get ingress -n keda-test-apps

# 2. 【最重要】KEDAによるHPA(水平Podオートスケーラー)の自動生成確認
# ※「TARGETS」の欄に「0/5(現在のキュー滞留数 / スケールトリガー値)」のようにメトリクスが正常に表示されているか必ず確認します
kubectl get hpa -n keda-test-apps

# 3. アプリケーションPodの起動ステータス確認
# ※GoアプリとPythonアプリのPodが「STATUS: Running」かつ「READY: 1/1」になっていることを確認します
kubectl get pod -n keda-test-apps
7-6. クリーンアップ(リソースの完全削除)手順
検証を終えた後、以下の手順で構築した全リソースを完全にクリーンアップします。
# helm ディレクトリへ移動
cd helm/

# 1. 自作アプリケーションの削除(連動するALBやNamespace等のAWS/K8sリソースが安全に自動解体されます)
helm uninstall keda-test-release -n keda-test-apps

# 2. AWS Load Balancer Controller の削除
helm uninstall aws-load-balancer-controller -n kube-system

# 3. KEDA オレペーター本体の削除
helm uninstall keda -n keda

# プロジェクトのルートを経由してterraformディレクトリへ移動
cd ../terraform/

# 4. TerraformによるAWSインフラ基盤の完全一括削除(確認入力をスキップして自動解体します)
terraform destroy -auto-approve
8.おわりに
本プロジェクトでは、以前構築した【GCP版・非同期OCR基盤】のシステムアーキテクチャをベースに、AWS(EKS)環境への完全移行(リプレイス) を達成しました。AWS特有のクラウドネイティブな仕様に深く触れながら、一連のハンズオンを通じて、より実践的なインフラ設計の知見を強固にすることができました。
現在は基本的な疎通確認(画像からのテキスト抽出)まで無事に完了した段階です。今後は詳細な負荷試験を実施し、KEDAによるコンテナのダイナミックな増減挙動(オートスケーリング)の最適化・チューニングを進めていく予定です。
今後の展望
以下の機能拡張も今後に取り組んでいく予定です。
-
GitHub ActionsによるCI/CDの導入
コンテナイメージのビルド・プッシュやHelmによるデプロイをパイプライン化し、コードの修正から環境反映までを完全自動化。 -
オブザーバビリティ(可観測性)の強化
Prometheus / Grafana を導入し、Podがスケールする軌跡、OCR処理のボトルネック、SQSの滞留遅延などをリアルタイムで可視化・分析。
最後までお読みいただきありがとうございました。今回構築したインフラコード(Terraform)やマニフェスト(Helm)は、以下のリポジトリにてすべて公開しています。