

ECS Fargateでメモリ使用率が単調増加していた話 ――「床」と「ピーク」は別の原因だった
はじめに
ECS Fargate で動かしている内部 API で、メモリ使用率が日単位で単調増加し、さらに夜間のバッチ処理で巨大なスパイクが乗るという問題がありました。結果としてアラーム閾値の 80% を恒常的に超え、数週間おきに手動でタスクを再起動して対処する運用になっていました。
調査から対策まで進めたもので、本記事はその記録です。結果的に 2 段階の対策が必要になり、1 段目だけでは問題が半分しか解けていなかったというのが、いちばん共有したいところです。
業務システムの話なので、アプリ名・エンドポイント名・件数などは伏せています。対象のアプリは本記事では app-a と呼びます。メモリ使用率の数値とグラフだけは実測そのままです。
本記事で扱う内容は次のとおりです。
- ECS Fargate 上のアプリでメモリ使用率が単調増加したときの切り分け方
- 改修前 → 対策1 適用後 → 対策2 適用後の CloudWatch グラフの変化(実データ)
- CloudWatch の
MemoryUtilizationを AWS CLI で取得してグラフ化する手順 - 「処理中のピーク」と「処理が終わっても残る床」は別の原因で別の対策が要るという話
- uvicorn の
--limit-max-requestsによるワーカーの定期リサイクル
app-a の役割
app-a は、外部システムと社内のデータ基盤をつなぐ仲介 API です。外から受け取った設定を、社内側の各コンポーネントに配って回る「橋渡し」役を担当します。
主な責務は次の 3 つです。
| 責務 | 内容 |
|---|---|
| 設定の受け取り | 外部システムから「どの対象の、どの項目を、どの周期で報告するか」という設定を受け取る |
| 設定の配信 | 受け取った設定をメッセージブローカー経由で配信先のエージェントへ届ける |
| 設定の永続化と通知 | 設定を PostgreSQL に保存し、下流のコンポーネントにバージョン更新を通知する |
エンドポイントはいくつかありますが、今回問題になったのは設定の一括登録を行う 1 本(以下、一括登録 API)です。
このエンドポイントは、夜間のバッチ時間帯に、数万件規模の設定をまとめて 1 リクエストで受け取ります。リクエストボディは数 MB あり、今回の問題はこのエンドポイントで起きていました。
インフラ基盤
app-a は ECS Fargate 上で動いています。構成は次のとおりです。
| 項目 | 値 |
|---|---|
| 起動タイプ | Fargate |
| タスク CPU / メモリ | 1024 (1 vCPU) / 2048 MiB |
| 希望タスク数 | 2 |
| コンテナ内のプロセス構成 | uvicorn (FastAPI) 3 ワーカー |
| ロードバランサ | ALB 2 本(外部向け / 内部向け)、idle_timeout は 300 秒 |
| 永続化 | Aurora PostgreSQL |
| キャッシュ | ElastiCache Redis |
ポイントは、タスクのメモリ枠が 2048 MiB で固定だということです。Fargate はタスク定義で決めた枠を超えると OutOfMemoryError でタスクが落ちます。そして CloudWatch の MemoryUtilization は、この 2048 MiB に対する割合を返します。
つまり 1% ≒ 20.5 MiB です。この換算はあとで何度も使います。
アラームは MemoryUtilization の Average が **80%(= 1638 MiB)**を 2 期間(5 分 × 2)連続で超えたら発報する設定でした。
症状:メモリ使用率の単調増加と巨大なスパイク
CloudWatch から実データを取る
まずは事実を押さえます。AWS CLI で日次の最小値・最大値を取得します。
aws sso login --profile <profile>

aws cloudwatch get-metric-statistics \
  --namespace AWS/ECS \
  --metric-name MemoryUtilization \
  --dimensions Name=ClusterName,Value=<cluster> Name=ServiceName,Value=<service> \
  --start-time 2026-07-01T00:00:00Z \
  --end-time   2026-09-24T00:00:00Z \
  --period 86400 \
  --statistics Minimum Maximum Average \
  --profile <profile> \
  --query 'sort_by(Datapoints,&Timestamp)[].[Timestamp,Minimum,Maximum,Average]' \
  --output text
日次の **Minimum(床)**と **Maximum(ピーク)**を分けて見るのが重要です。両者は別の現象を表しているからです。
- 床(日次 Minimum) … 処理が終わっても解放されずに残っている量。これが増え続けると、いつかタスクのメモリ枠を使い切る
- ピーク(日次 Maximum) … 一括処理の最中だけ上がって、終わると戻る量
改修前:CloudWatch のグラフ
まずは対策前(2026-07-24 〜 08-01)の実際の CloudWatch グラフです。5 分粒度で最小・最大・平均を重ねています。
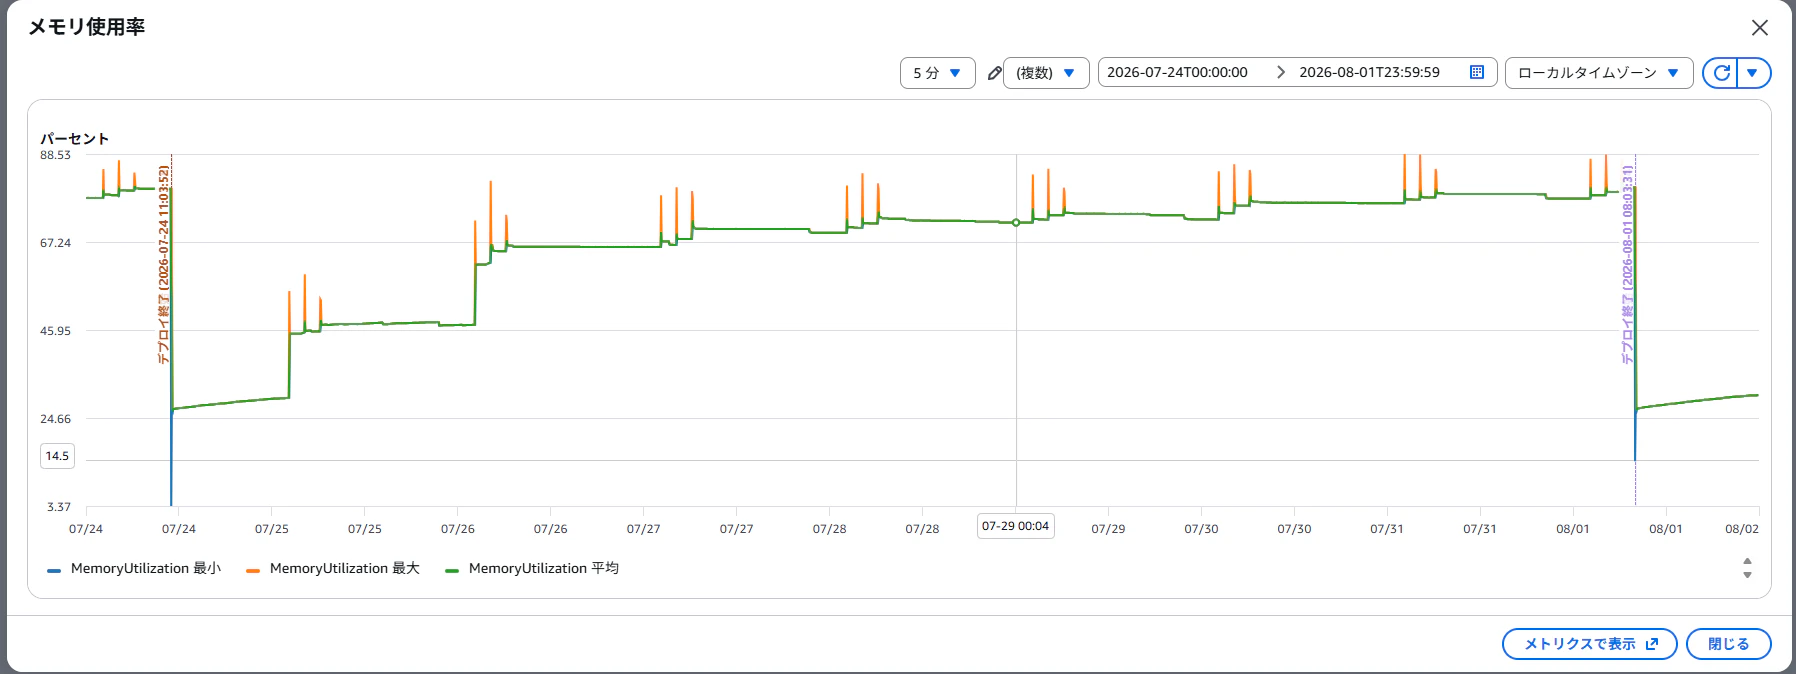
このグラフだけで、問題の全体像がほぼ説明できます。
- 緑(平均)が階段状に単調増加している。 一括処理のたびに一段上がり、次の処理までは完全に平坦。つまり上がった分がまったく戻っていない
- オレンジ(最大)が一括処理のたびにヒゲとして突き出し、y 軸の上限 88.53% まで達している。 アラーム閾値 80% を毎日超えている
- 青(最小)がグラフ下端まで垂直に落ちているのは 2 回だけ。 07-24 11:03 と 08-01 08:03 の「デプロイ終了」の縦線がそれで、タスクを入れ替えない限り下がらないことを示している
「階段の段(= 床の上昇)」と「ヒゲ(= ピーク)」が同じ時刻に起きているので一見ひとつの現象に見えますが、この 2 つは別の原因でした。
85 日間で俯瞰する
同じデータを日次に丸めて、2026-07-01 〜 09-23 の 85 日間で見てみます。まず**床(日次 Minimum)**です。
水平な直線がアラーム閾値 80% です。鋸歯(のこぎり)状の形になっています。
谷が 0% まで落ちている日は、タスクを入れ替えた日(手動再起動またはデプロイ)です。つまりこのグラフは「上がり続ける → 閾値に近づく → 人が再起動する → また上がり始める」というサイクルをそのまま描いています。約 2〜3 週間に 1 回、人が再起動しないと落ちる状態でした。
なお右端の 78 日目(2026/09/16)以降だけが完全に平坦です。ここに至るまでに 2 段階の対策が必要でした。
次に**ピーク(日次 Maximum)**です。
8月上旬には **98.9%(= 2025 MiB / 2048 MiB)**まで達しています。タスクのメモリ枠 2048 MiB まで残り 23 MiB で、OOM でタスクが落ちる一歩手前でした。
そして 49 日目(2026/08/18)を境に、ピークが 88% → 44% へ垂直に落ちているのが見て取れます。これが対策1 のリリース日です。
1日の中の動きを見る
--period 3600 にして 1 日の中の動きを見ると、原因がさらにはっきりします。
aws cloudwatch get-metric-statistics \
  --namespace AWS/ECS --metric-name MemoryUtilization \
  --dimensions Name=ClusterName,Value=<cluster> Name=ServiceName,Value=<service> \
  --start-time 2026-08-17T00:00:00Z --end-time 2026-08-18T00:00:00Z \
  --period 3600 --statistics Minimum Maximum \
  --profile <profile> \
  --query 'sort_by(Datapoints,&Timestamp)[].[Timestamp,Minimum,Maximum]' --output text
対策前(2026-08-17、UTC)の抜粋です。
| 時刻 (UTC) | Minimum | Maximum |
|---|---|---|
| 08:00〜16:00 | 68.2% | 68.2% |
| 17:00 | 68.2% | 88.5% |
| 18:00 | 70.0% | 70.1% |
| 19:00 | 70.0% | 87.6% |
| 20:00 | 70.8% | 70.8% |
| 21:00 | 70.7% | 87.1% |
| 22:00 | 72.1% | 72.2% |
バッチ時間帯以外はまったく動かず、一括処理のときだけ +20 ポイント(約 416 MiB)跳ね上がり、終わると戻る。ただし完全には戻らず、1 日で +4 ポイント積み残す。
この「跳ねる分」と「積み残す分」は、まったく別の原因でした。
原因の切り分け
ピークの原因:全件を一度にメモリへ載せていた
一括登録 API の実装は、数万件分の既存設定を一度に取得し、全グループ分の配信メッセージをまとめて組み立てていました。
リクエストボディが数 MB でも、そこから展開される ORM オブジェクトと配信ペイロードは数百 MiB になります。これがそのままピークになっていました。
床の原因:SQL 文が毎回変わっていた
こちらのほうが厄介でした。
WHERE 句が IN (:1, :2, :3, ...) の形だったため、対象件数の数だけ束縛変数が並びます。件数が変われば SQL 文の文字列そのものが変わるので、DB ドライバが接続ごとに持つプリペアドステートメントキャッシュに「別のクエリ」として積まれていきます。
本番のリクエスト件数は日々変動する(そして増えている)ので、キャッシュは永久に積まれ続けます。
切り分けのため、該当クエリだけを件数を変えながら 60 回呼ぶ実験をしました。
| 条件 | メモリ増加 |
|---|---|
| 件数を変えながら 60 回(現行実装) | +21 → +25 → +27 → +31 MiB(止まらない) |
| 件数を固定して 60 回(対照) | +1 MiB |
件数を固定すると増えない。増加の原因は「SQL 文が件数によって変わること」だと確定しました。
同じ原因で、件数が 32,767 件を超えると必ず 500 エラーになることも分かりました。PostgreSQL の束縛変数の上限が 32,767 個だからです。本番のリクエストボディは日々増え続けていたので、放っておけばいずれ一括登録が丸ごと失敗するところでした。
対策1:アプリ実装の変更
対策1 では、ピークと床の両方にアプリ側から手を入れました。
ピーク対策:グループ単位のチャンク処理 + flush
全件一括をやめ、グループ 200 個ずつに分割してループさせ、チャンクごとに flush して解放するようにしました。
分割するだけでは不十分でした。session.add / merge したオブジェクトは flush するまで session が強参照を持ち続けるため、autoflush=False の設定だと暗黙の flush も走りません。チャンクごとに明示的に flush を呼んで初めて、ピークが 630 MiB → 380 MiB に下がりました(12 サンプルすべてで再現)。
なお commit はループの外で 1 回だけです。途中で失敗したときに登録が中途半端に残らないようにするためです。
床対策:IN を = ANY(配列) に変える
WHERE 句を書き換えました。
-- 変更前:件数の数だけ束縛変数が並ぶ。件数が変わると SQL 文も変わる
SELECT * FROM devices WHERE device_id IN (:1, :2, :3, ... , :30000);

-- 変更後:束縛変数は配列 1 個だけ。SQL 文は件数によらず一定
SELECT * FROM devices WHERE device_id = ANY(:ids);
これで SQL 文が一定になり、プリペアドステートメントキャッシュは 1 エントリで済みます。副次的に束縛変数 32,767 個の上限も消えるので、件数上限の問題も同時に解決しました。
検証結果
本番と同じ cpu 1024 / メモリ 2048 の ECS タスクを dev に用意し、本番相当の件数・ボディサイズの負荷で比較しました。
| 指標 | 変更前 | 変更後 |
|---|---|---|
| 1 リクエストの所要時間 | 60〜175 秒 | 26〜28 秒 |
| 処理中のピーク(処理前比) | +125〜281 MiB | +51〜58 MiB |
| 同一ワーカーの床の上がり方 | +43 MiB/回 | +17 MiB/回 |
| 32,767 件を超えるリクエスト | 500 | 200 OK |
リリース後の実測
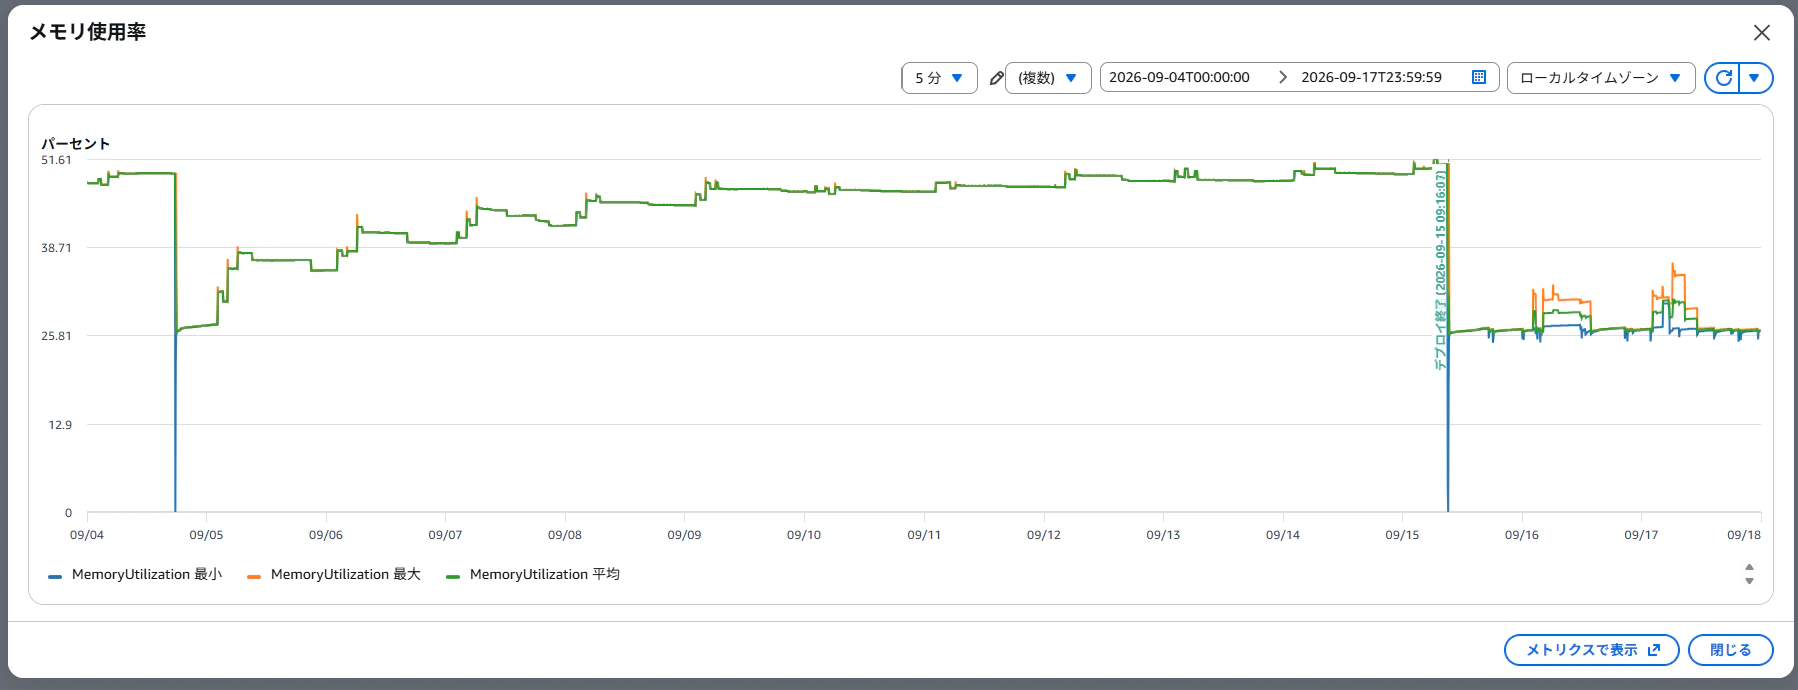
2026-08-18(グラフの 49 日目)にリリースしました。上の 2 枚目のグラフでピークが垂直に落ちているのがこれです。
CloudWatch のグラフ(2026-09-04 〜 09-17)です。
効いたこと
- オレンジ(最大)のヒゲが消えた。 最大が平均とほぼ重なっており、一括処理中のスパイクが無くなっている
- y 軸の上限が 88.53% → 51.61% に下がった。 CloudWatch が実測値から自動で決める縦軸の上限なので、最大値が下がったことを表している
- アラーム(80%)は鳴らなくなった
| 日付 | 床(日次 min) | ピーク(日次 max) | ピーク幅 |
|---|---|---|---|
| 2026-08-17(変更前) | 68.2% (1396 MiB) | 88.5% (1812 MiB) | +20.3 pt |
| 2026-08-25(変更後) | 49.1% (1005 MiB) | 50.7% (1038 MiB) | +1.6 pt |
日次 max が 88〜99% から 44〜52% へ下がり、ピークは完全に消えました。
効かなかったこと
- 緑(平均)の階段状の単調増加は、まったく止まっていない。 09/04 のタスク入れ替え直後の 26.5% から、09/15 には 50% 近くまで、**11 日間で約 24 ポイント(約 490 MiB)**上がり続けている
- グラフ右端の 09-15 09:16 の縦線(デプロイ終了)で床が 26% に戻っているのは、次の対策をリリースした瞬間であって、自然に下がったわけではない
つまり対策1 で下がったのはピークだけで、「いつか閾値に届く」という構造は残ったままでした。閾値に到達するまでの時間が数週間に延びただけです。
この時点では「アラームが鳴らなくなった」ので、一度は解決したつもりになっていました。床のグラフを引き続き追っていなければ見落としていたところです。
対策2:ワーカーの定期リサイクル
しかし、床の単調増加は止まりませんでした。
| 期間 | 床の傾き | 1日あたり |
|---|---|---|
| 2026-07-03 〜 07-23(対策前) | +1.77 %/日 | 約 +36 MiB/日 |
| 2026-08-19 〜 08-26(対策1の後) | +1.52 %/日 | 約 +31 MiB/日 |
| 2026-08-28 〜 09-03(対策1の後) | +2.03 %/日 | 約 +42 MiB/日 |
| 2026-09-05 〜 09-14(対策1の後) | +1.40 %/日 | 約 +29 MiB/日 |
依然として +30〜40 MiB/日 で上がり続けています。閾値に到達するまでの時間が延びただけで、いつか手動再起動が必要になる構造は変わっていません。
残っていたのはアロケータ側の保持分
対策1 で SQL 文キャッシュの分は消えましたが、残った +17 MiB/回 は SQL 文とは無関係の、アロケータ(glibc malloc)側が OS に返さずに保持している分でした。
これはアプリのコードでは解放できません。一括処理で大量に確保・解放を繰り返すとヒープが断片化し、RSS の床が下がらなくなる、という典型的な現象です。
先行して MALLOC_ARENA_MAX=2 も試しましたが、実サービスでは効果が無かったため撤去しています。
対策:--limit-max-requests でワーカーを入れ替える
アプリのコードから解放できないため、ワーカープロセスを定期的に作り直して解放します。uvicorn には、指定したリクエスト数を処理したらワーカーを入れ替える機能があります。
# 変更前
CMD [ "uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8000", "--workers", "3"]

# 変更後
CMD [ "uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8000", "--workers", "3", "--limit-max-requests", "2000"]
数値の根拠は本番のアクセスログ実測です。
- 本番のリクエスト数:1 万数千 req/日(大半はヘルスチェック)
- ワーカーあたり:約 5,000 req/ワーカー/日
-
2000にすると **約 9 時間周期(1 日 8 回前後)**で入れ替わる
リスニングソケットは親プロセスが保持して子プロセスに継承させるため、ワーカー入れ替え中も残りのワーカーが accept を継続します。スループットは落ちません。
応答時間への影響はない
--limit-max-requests の実装は uvicorn のメインループ(0.1 秒周期)での数値比較のみで、リクエストごとのコストがありません。dev で同一設定を 2 本ずつ並行させて 7 時間 73 サイクル測った結果がこちらです。
| アーム | 設定 | n | 平均 | p50 |
|---|---|---|---|---|
| A1 | なし | 65 | 23.3s | 23s |
| B1 | あり | 63 | 28.2s | 28s |
| A2 | なし | 64 | 31.2s | 31s |
| B2 | あり | 67 | 33.6s | 33s |
ペア内のばらつき(なし 7.91s / あり 5.33s)がペア間の差(3.62s)より大きく、A1 < B1 < A2 < B2 と交互に並んでいます。設定ではなく Fargate のホスト個体差が実体です。
床の傾きの検証
同じ A/B 構成で、アイドル時の床をサイクル数に回帰させました。
| アーム | 設定 | 傾き (MiB/サイクル) | 95%CI | 床の推移 |
|---|---|---|---|---|
| A1 | なし | +3.998 ± 0.762 | [+3.237, +4.760] | 590 → 915 |
| A2 | なし | +6.119 ± 0.798 | [+5.322, +6.917] | 590 → 965 |
| B1 | あり | −0.334 ± 1.517 | [−1.850, +1.183] | 589 → 434 |
| B2 | あり | −0.899 ± 1.050 | [−1.949, +0.151] | 590 → 499 |
B の信頼区間はゼロを含みます。ペア内の差(なし 2.1 / あり 0.6 MiB/サイクル)に対してペア間は約 5 MiB/サイクル離れているので、増加が止まったのはフラグの効果であってホスト個体差ではないと言えます。
ワーカー入れ替えの瞬間、切断される keep-alive 接続に乗っていたリクエストが 502 になりうるのは事実です。ALB は非冪等リクエストをリトライしません。
ただし本番の実リクエストは毎秒 1 件未満と低く、dev では数百回の入れ替えに対し数十万件のヘルスチェックでエラー 0 件でした。リリース後は ALB の HTTPCode_Target_5XX_Count を監視し、増えるようなら limit を上げて入れ替え頻度を下げる運用にしています。
結果
2026-09-15(グラフの 77 日目)に対策2 をリリースしました。1 枚目のグラフの右端が平坦になっているのがそれです。
CloudWatch のグラフ(2026-09-11 〜 09-24、1 分粒度)です。
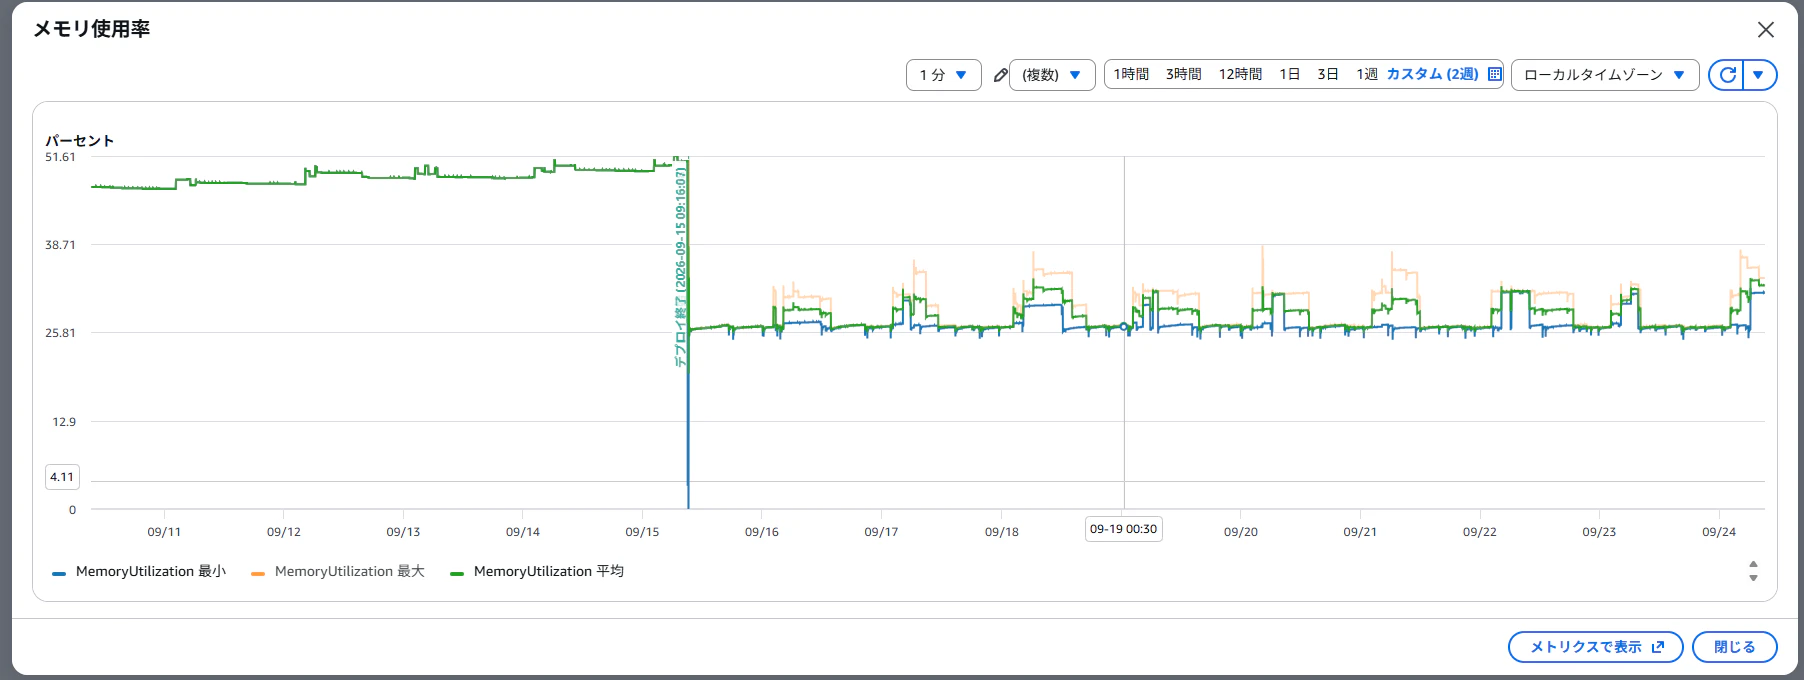
09-15 09:16 の縦線より左が対策2 適用前、右が適用後です。
- 適用前(左):47 〜 51% を階段状に上がり続けている
- 適用後(右):9 日間ずっと平均 26 〜 29%(日次最小は 22% 前後)で横ばい。 一括処理のたびに小さな山(〜34%)はできるが、翌朝には必ず元の高さに戻っている
- 青(最小)が細かくギザギザしているのは、
--limit-max-requestsでワーカーが入れ替わっている痕跡です
| 期間 | 床の傾き | 日次 min | 日次 max |
|---|---|---|---|
| 対策前(〜08/17) | +1.8 %/日(約 +36 MiB/日) | 32 → 80% | 80〜98.9% |
| 対策1 後(08/19〜09/14) | +1.4〜2.0 %/日(約 +29〜42 MiB/日) | 35 → 49% | 44〜52% |
| 対策2 後(09/16〜) | +0.02 %/日(約 +0.4 MiB/日) | 22.0〜22.6% | 34〜39% |
対策後 8 日間の床は 22.2 / 22.3 / 22.5 / 22.0 / 22.1 / 22.2 / 22.6 / 22.3 (%) で、完全に平坦です。
- ピーク最大:98.9%(2025 MiB)→ 39.2%(803 MiB)
- 床:+36 MiB/日 で単調増加 → 横ばい
- 手動再起動:2〜3 週間に 1 回 → 不要
アラーム閾値 80%(1638 MiB)に対して、2 倍以上の余裕ができました。
3 枚のグラフを時系列で並べる
| グラフの y 軸上限 | ピーク(ヒゲ) | 床(階段) | 手動再起動 | |
|---|---|---|---|---|
|
改修前 (〜2026/08/17) |
88.53% | 毎回、+20 pt | +36 MiB/日 で単調増加 | 2〜3 週間に 1 回 必要 |
|
対策1 適用後 (08/18〜09/14) |
51.61% | 消滅(最大 ≒ 平均) | +29〜42 MiB/日 で依然として単調増加 | いずれ必要 |
|
対策2 適用後 (09/15〜) |
51.61%(実測は 34% 止まり) | 消滅 | 横ばい(+0.4 MiB/日) | 不要 |
y 軸の上限が 88.53% → 51.61% に変わったのが対策1 の効果、その 51.61% のグラフの中で線が水平になったのが対策2 の効果です。片方だけでは足りませんでした。
振り返って分かったこと
1. 「床」と「ピーク」を分けて見る
日次 Average だけを見ていると「なんとなく増えている」で止まります。Minimum(床)と Maximum(ピーク)を分けた瞬間に、原因が 2 つあることが見えました。そして両者は原因も対策も別物でした。
- ピークだけ直しても、床が上がり続けていずれ鳴る
- 床だけ直しても、ピークで鳴り続ける
両方必要だった、というのが今回の一番の学びです。
2. 「メモリが増える = リーク」ではない
アプリのコードにオブジェクトを溜め込む箇所は 1 つもありませんでした。実際の原因は、
- DB ドライバのプリペアドステートメントキャッシュ(SQL 文が毎回変わるため積まれ続ける)
- アロケータが OS に返さない保持分(ヒープ断片化)
の 2 つで、どちらも「アプリのコードで参照を握っている」わけではありません。プロファイラでオブジェクトを追いかけても見つかりません。
3. 可変長の IN 句は 2 つの問題を同時に持ち込む
IN (:1, :2, ..., :n) は、
- SQL 文が件数で変わるのでキャッシュが効かない(むしろ積まれる)
- 束縛変数が件数分並ぶので PostgreSQL の 32,767 個上限に当たる
という 2 つの問題を同時に抱えます。PostgreSQL なら = ANY(:array) に統一するだけで両方解決します。
= ANY(配列) は PostgreSQL 固有の構文です。配列の要素型はカラムの型から決まるので、TEXT カラムなら TEXT[] になり結果は IN と一致します。ユニットテストで「要素数 0 / 1 / 3 / 1000 で SQL 文が変わらない」「束縛変数が 1 個である」ことを固定しておくと、リファクタで対策が無効化されるのを防げます。
4. アプリで解放できないメモリはワーカーごと入れ替える
アロケータの保持分は、アプリのコードからは解放できません。この場合は --limit-max-requests のようなワーカーの定期リサイクルが確実です。
Gunicorn なら --max-requests / --max-requests-jitter が同等の機能です。一度に全ワーカーが入れ替わるのを避けたい場合は jitter を付けます。
5. dev での A/B は「同一設定を 2 本ずつ」
Fargate はホスト個体差が大きく、1 本ずつの比較では設定の効果と個体差が分離できません。同一設定を 2 本ずつ並行させて、ペア内のばらつきとペア間の差を比べるのが有効でした。実際、応答時間の差は「設定の効果ではなくホスト差」だと結論できました。
まとめ
ECS Fargate 上の API でメモリ使用率が単調増加し、アラーム閾値 80% を恒常的に超えていた問題を、2 段階の対策で解消しました。
-
床とピークを分けて計測する。CloudWatch の
MemoryUtilizationを--statistics Minimum Maximumで日次・時次に取り、別の現象として扱う -
ピーク対策:全件一括処理をチャンク分割 + チャンクごとの
flushに変更(ピーク +20 pt → +1.6 pt) -
床対策その1:可変長
IN句を= ANY(配列)に変更し、SQL 文を一定にしてキャッシュの蓄積を止める(ついでに 32,767 件上限も解消) -
床対策その2:アプリで解放できないアロケータ保持分は、
--limit-max-requestsでワーカーごと定期的に捨てる(+36 MiB/日 → 横ばい)
結果として、ピーク最大 98.9% → 39.2%、床は単調増加 → 完全に平坦、手動再起動は不要になりました。
同じように「なぜか増え続けるメモリ」に悩んでいる方の参考になれば幸いです。
参考リンク
- Uvicorn — Settings(
--limit-max-requests) - Gunicorn — Settings(
max_requests/max_requests_jitter) - Amazon ECS CloudWatch metrics — MemoryUtilization
- Amazon ECS task definition parameters — task size
- PostgreSQL — Row and Array Comparisons(
ANY) - SQLAlchemy — Session Basics(
flushとcommit) - AWS CLI —
cloudwatch get-metric-statistics