
33万回攻撃を数えていたら、自分のアクセス数も本物ではなかった — 1,494 のうち人は 7 人
前回、個人サイトが1か月で33万回攻撃されていた話を書きました。その調査の副産物として、自分のサイトのアクセス数がまったく信用できないことが分かったので、その話を書きます。
同じ日の同じサイトのアクセスを、4通りの数え方で数えました。
| 数え方 | 今日の数字 |
|---|---|
| ① nginx の総リクエスト数 | 3,905 |
| ② HTML / PHP ページの表示だけ | 1,660 |
| ③ ②から「bot」と名乗るものを除外 | 1,494 |
| ④ 実際に見に来た人 | 7 |
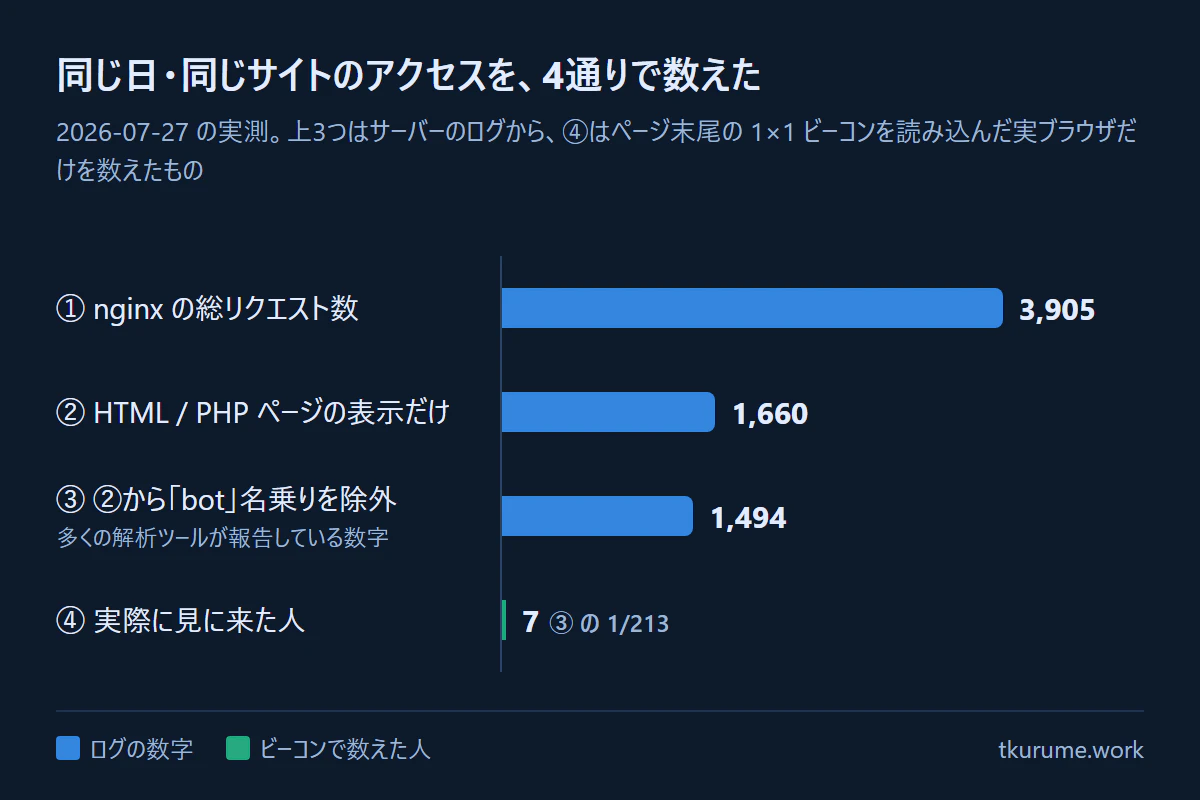
③ と ④ で 200 倍以上の開きがあります。
そして多くの解析ツールや自作カウンターが報告しているのは ③ です。
1. なぜログの数字はここまで膨らむのか
内訳を見れば一目瞭然でした。AI のクローラです。
直近のログから、名前で数えたものを挙げます。
| 名前 | 回数 | 正体 |
|---|---|---|
| Bytespider | 797 | ByteDance(TikTok) |
| Applebot | 472 | Apple |
| meta-externalagent | 359 | Meta |
| Googlebot | 337 | Google 検索 |
| GPTBot / ChatGPT-User / OAI-SearchBot | 727 | OpenAI |
| ClaudeBot / Claude-User / anthropic-ai | 687 | Anthropic |
| bingbot | 229 | Microsoft |
| Amazonbot | 197 | Amazon |
| PerplexityBot | 179 | Perplexity |
実訪問者が1日数人のサイトに、これだけの機械が毎日読みに来ています。
さらに厄介なのは、攻撃スキャンも .php や .html を叩くことです。/wp-login.php を探す 6,000 回の探索は、素朴に数えれば「PHPページへのアクセス」になります。
2. UA のブラックリストは追いつかない
最初は素直に User-Agent で弾こうとしました。これが茨の道でした。
// 最初はこれで足りると思っていた
if (preg_match('/(bot|crawl|spider|slurp)/i', $ua)) { return true; }
足りません。 AI クローラの名前は bot を含まないものが多く、しかも増え続けます。実際に運用しているものは、こうなりました。
$re = '/(bot|crawl|spider|slurp|scan|fetch|monitor|preview|probe|curl|wget|'
    . 'python|java\/|go-http|libwww|okhttp|axios|httpclient|headless|phantom|'
    . 'puppeteer|playwright|selenium|scrapy|'
    . 'facebookexternalhit|externalagent|external-agent|whatsapp|telegram|slackbot|discord|embedly|feed|'
    . 'cohere-ai|anthropic-ai|claude-web|chatgpt|oai-search|perplexity|youbot|googleother|google-extended|'
    . 'imagesift|diffbot|omgili|webzio|iaskspider|timpi|firecrawl|meta-ai|amazonbot|applebot|'
    . 'ahrefs|semrush|petal|yandex|baidu|sogou|bytespider|dataforseo|mj12|dotbot|zgrab|masscan)/i';
これでも追いつきません。 新しい AI サービスが増えるたびに追記が要ります。しかも一部はブラウザそっくりの UA で、CSS も画像も取りに来ます。名前で見分ける方針そのものに無理があります。
3. 発想を変える — 「読み込んだかどうか」で数える
名前を信じるのをやめて、行動で判定することにしました。
</body> の直前に 1×1 の透明 GIF を置き、これを読み込んだリクエストだけを人として数えます。
<img src="/counter/hit.php?k=ページ名" width="1" height="1" alt=""
     style="opacity:0;position:absolute;" />
素朴なクローラは HTML を取るだけで画像までは取りません。これだけで数字は劇的に減りました。
// hit.php
$gif = base64_decode('R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7');
header('Content-Type: image/gif');
header('Cache-Control: no-store, no-cache, must-revalidate');
header('Content-Length: ' . strlen($gif));   // ← ここでハマった
echo $gif;
Content-Length を決め打ちしてはいけません。
「1×1 GIF は 43 バイト」と覚えていて 43 と書いたところ、実際は 42 バイトでした。
1 バイト足りないまま返すので nginx が upstream prematurely closed connection を吐き続け、
原因究明に時間を溶かしました。strlen() で出しましょう。
4. それでもまだ多い — レンダリングするクローラ
ビーコン方式にしても、まだ人数が実感より多いままでした。調べると、画像まで読み込むクローラがいます。
- SNS のリンクカード生成(Facebook・X のプロキシ)
- AI のブラウジング機能(実際にページを描画する)
- レンダリング型のスクレイパ
これらは「本物のブラウザ」として振る舞うので、ビーコンでは弾けません。
そこで IP の逆引き(PTR)でデータセンターを判定しました。
$map = [
    'amazonaws'         => 'AWS',
    'googleusercontent' => 'Google Cloud',
    'cloudapp'          => 'Azure',
    'linode'            => 'Linode',
    'digitalocean'      => 'DigitalOcean',
    'hetzner'           => 'Hetzner',
    // SNS のカード生成プロキシ(人ではない)
    'fbsv.net'          => 'Facebook プロキシ',
    'fbcdn'             => 'Facebook プロキシ',
    'twttr'             => 'X プロキシ',
    // ...
];
個人宅の回線は ocn.ne.jp や au-net.ne.jp、データセンターは amazonaws.com のように、PTR を見れば素性がかなり分かります。逆引きは遅いので、結果は 30 日キャッシュしています。
これで「人」と「データセンター経由」を別々に表示するようにしました。消すのではなく分けて出すのが大事で、消してしまうと後から検証できません。
5. 「クリック数」も信用できない
ここからが本題かもしれません。メールや SNS の「クリック数」は、もっとひどいことになっていました。
メール: 16通送って「16クリック」、実際は3人
知人 16 名に更新のお知らせをメールしました。リンクには ?from=mail-xxxx を付けてあります。
16 回線からクリックがありました。100% です。
……そんなわけがないので中身を見ました。
16.146.95.x   ec2-...us-west-2.compute.amazonaws.com  26/Jul 17:32
34.208.100.x  ec2-...us-west-2.compute.amazonaws.com  26/Jul 17:32
34.209.68.x   ec2-...us-west-2.compute.amazonaws.com  26/Jul 17:32
34.219.25.x   ec2-...us-west-2.compute.amazonaws.com  26/Jul 17:32
...(13件、すべて 17:32 ちょうど)
13 件が AWS から、送信の数分後に一斉に来ています。 これは受信側のメールセキュリティが「危険なリンクでないか」を自動で開いた足跡です。
本物の人は 3 人(dion 2 件、docomo 1 件)でした。開封率 100% ではなく 19% です。
Facebook: 「88回線」のうち 82 が Facebook 自身
Facebook に投稿したあと ?from=fb を数えたら 88 回線ありました。PTR を引くと、
Facebook のインフラ : 82 回線
それ以外            :  6 回線(うち AWS 3・自サーバー1)
実際の人            :  2 人
カード画像を生成するために、Facebook は大量の IP から取りに来ます。 これを「リーチ」として数えたら大変なことになります。
LINE: 「3人」の内訳を見ると
- 7/17 NURO 光(固定回線)から 2時間半で 14 ページ ← 確実に別人。よく読んでいる
- 7/20 au モバイルから 5 ページ
- 7/14 au モバイルから 1 ページ
au の 2 件は同一人物かもしれません。 モバイル回線は日ごとに IP が変わるので判別できません。「3人」は上限であって、確実なのは 2 人です。
「20ページ読まれた」の 14 ページは 1 人の分でした。「LINE が最も読まれている」ではなく「LINE から来た 1 人が熱心だった」が正確です。
6. 数え方の設計で気をつけたこと
自分で数える以上、自分が汚染源になります。
| 課題 | 対処 |
|---|---|
| 自分の閲覧を除く | オプトアウト Cookie(10年)を主、IP 指定は補助。IP は変わるが Cookie は残る |
| プライバシー | 生 IP は保存しない。 ソルト付きハッシュのみ。逆引き結果もラベルだけ保持 |
| リロード連打 | 同一キーは 30分デデュープ |
| 自作の集計ページ | トークン認証。URL に付けたトークンは 302 で消す(履歴・ブックマークに残るため) |
| 集計データの置き場 |
公開ディレクトリの外(/var/lib/...)。設定は root:www-data 640
|
トークンを URL に付ける方式は、ブラウザ履歴・ブックマーク・スクリーンショットに残るという地味な事故があります。一度リセットする羽目になり、いまはアクセス時に Cookie へ移して URL から消しています。
7. 結論: 「数」ではなく「人」を数える
- ログの生の数字は、2026年現在ほぼ意味を持たない。AI クローラで桁が変わる
- UA のブラックリストは維持できない。名前ではなく行動(ビーコン)で判定する
- ビーコンでもレンダリング型は残る。PTR でデータセンターを分離する
- メール・SNS の「クリック数」はもっと汚染されている。セキュリティスキャナとカード生成プロキシが大半
- 消さずに分けて出す。あとから検証できなくなる
「1日1,494 アクセス」と「1日7人」は、同じ日の同じサイトです。どちらを報告するかで、伝わるものはまったく変わります。
そして 7 人と分かってからのほうが、次に何を書くべきかがはっきりしました。数字が小さくても、誰がどのページをどれだけ読んだかが見えるほうが、はるかに役に立ちます。
8. その後 — 3週間の実測(2026-08-16 追記)
ここから下は、公開後3週間の数字を追いかけた追記です。「人」で数え始めると、今度は流入元の性格の違いが見えてきました。
前記事は 18,875 views。サイトまで来たのは1%弱
前記事(33万回)は 18,875 views / LGTM 67 / ストック 47 になりました(8/16時点)。週間トレンドの5位にも入りました。個人サイトの運用記事としては望外の読まれ方です。
では、そこから当サイトへ実際に何人来たか。ビーコン(=実ブラウザ)で数えた Qiita 経由の訪問者の推移です。
| 時期 | Qiita 経由の実訪問者 |
|---|---|
| 公開当日(7/27) | ほぼ 0 |
| 翌日(7/28) | 8人 |
| 3日目(7/29・トレンド入り) | 40人前後 |
| ピーク(続編公開後の 8/5〜8/6) | 22人・32人/日 |
| 8/12 以降 | 0〜1人/日 |
3週間の累計はおおむね150人前後。18,875 views に対して1%弱です。
分かったことが2つあります。views の桁に意味はないというのが1つ。もう1つは、Qiita 流入は記事を出した瞬間だけ跳ねて、2週間で枯れること。日別に描くと打ち上げ花火そのものです。しかも公開当日はほぼゼロで、跳ねるのは翌日から。初日の数字で導線の成否を判断すると確実に誤ります。
検索流入ゼロの原因は、文章ではなくインデックスだった
7/27時点で「検索流入がほぼゼロ」と書きました。Search Console を開いて、理由が分かりました。
公開51ページのうち、Google に登録されていたのは28ページだけでした。残る39ページは「検出したがクロールしていない」が28、「クロールした上で登録しないと判断された」が11。つまり検索結果に出る資格自体がなかったのです。タイトルや説明文の出来以前の問題でした。
7/27 にインデックス登録をリクエストすると登録数は 0→28 に立ち上がり、そこから3週間後の今週、日1〜3人の検索流入が始まりました。直近では検索が Qiita を上回る日が出ています(8/15: 検索3人・Qiita 0人)。着地の最多は LED 調光トラブルの解説ページで、8/15 には Yahoo 検索からの流入も初めて出ました。
出した瞬間だけ跳ねて枯れる Qiita と、立ち上がりに3週間かかるが放っておいても入り続ける検索。同じ「流入」でも時定数がまるで違います。総数だけ見ていた頃は、この入れ替わりに気づけませんでした。
ログの「検索から来た」も、大半が攻撃側の偽装だった
追記するか迷った、いちばん嫌な発見です。保持ログ全体のリファラを集計すると「Google 318件・DuckDuckGo 146件・Bing 128件」の検索流入があることになっています。ところが着地先には /.env や /RDWeb といった攻撃プローブが並び、リファラに残っていた「検索語」はこうでした。
google.com/search?q=66r39z    duckduckgo.com/?q=m8756
bing.com/search?q=3tib7b      google.com/search?q=v31txt
ランダム英数字です。 攻撃ツールが、リファラでのフィルタを回避するために検索エンジン経由を装っています。ビーコンと突き合わせた実際の検索流入は、2週間で40〜50件でした。PV だけでなく、リファラの集計もログで数えてはいけない数字だったわけです。
ビーコンでも完全ではない、の続報
§4 で「レンダリング型のクローラはビーコンでは弾けない」と書きました。3週間で実例が2つ増えました。
- 1〜2分で103ページを読んでいく「PC・直接来訪」が2件。人間には不可能な速度です。画像まで読み込むスクレイパで、現行の判定をすり抜けて205ページ分を計上していきました
- 8/9 はユニーク20回線のうち、日本の一般 ISP は1回線だけ。残りは GCP、EC2 なのに UA が iPhone(=偽装)、逆引きなしの Linux。しかも25件中21件が深夜0〜3時に集中していました
クラウドからの巡回は毎日ほぼ一定数(15〜20回線)走っています。つまり実読者が少ない日ほど、ノイズが比率で支配します。にぎわった日の数字より、閑散とした日の数字のほうが汚染されている。直感と逆なので要注意です。
2か月後にも再発 — 画像 1 枚が「通行証」になっていた(2026-10-04 追記)
この節だけ日付が飛びます。上の「ビーコンでも完全ではない」を直したつもりで、別の形でもう 2 回すり抜けられたので続報です。
-
9/5: 突然「7 人 / 686 ページ」。全員が入口
/・リファラなし・同じ秒に十数ページを一括取得。whois は全件 Oracle Cloud で、登録していた帯が 1 本だけでした。帯を足すと当日は 0 人 / 0 ページに -
10/4: 解析画面に「全ページを舐めた誰か」。英国のデータセンターから約 3 秒で 132 リクエスト、リファラなし。UA は素朴な
Chrome/117で、逆引き(PTR)もなし
10/4 は帯の追加では済みませんでした。この巡回が読んだビーコンはトップの 1 本だけです。ところが私の集計は「その日ビーコンを読んだ IP」の集合を作り、その IP が取った全ページを人の閲覧に数えていました。トップの画像 1 枚が、他の全ページの通行証になっていたわけです。
直したのは判定の単位です。IP ではなく「そのページのビーコンを読んだか」で見ます(ビーコン要求の Referer からページを特定)。
// ビーコン要求: どのページのビーコンかを Referer から記録
if ($isBeacon) {
    $rp = parse_url($ref, PHP_URL_PATH);
    if (is_string($rp) && $rp !== '') { $humanPages[$date . '|' . $ip][$rp] = true; }
    continue;
}
// 集計: そのページのビーコンを読んでいない閲覧は人として数えない
if (!isset($humanPages[$date . '|' . $ip][$path])) { continue; }
保険に、帯の知識がいらない行動の検出も足しました。同じ秒に 5 ページ以上取る IP は人間から外す。9/5 の Oracle も 10/4 も、この特徴で見分けられます。帯の登録は毎回後手に回る追いかけっこですが、速度は事業者を知らなくても判定できます。
修正後、10/4 は 0 人 / 0 ページ(バーストで 58 件の閲覧記録を除外)。過去 14 日は 22 人 / 29 ページ、日別 0〜8 人でした。ただし修正前後の日別人数を並べて比較してはいません。「本物が消えていない」と言えるのは、残った数字が普段の規模に収まっているから、という程度の確認です。
限界もあります。しきい値(同一秒 5 ページ)は経験則で、間隔を空けてゆっくり回る巡回には効きません。ページ単位の判定は Referer に依存し、送らない環境では人も数えられなくなります。
教訓は 1 つです。小さい数字の日ほど、1 件の通行証で全体が決まります。 1 日数人のサイトでは、巡回 1 回が「全ページ閲覧」に見えます。
3週間後の対比表
| 数え方(直近14日) | 数字 |
|---|---|
| ログ全体の PV | 4,856 |
| うち実ブラウザ(ビーコン) | 251 (5%) |
| ユニーク IP | 1,537 |
| うち実訪問者 | 125 (8%) |
「1,494 と 7」の構図は、3週間経っても変わっていません。ログの数字の95%は人ではない。そして人で数え始めると、流入元ごとの時定数、インデックスの資格、偽装リファラと、次に直すべきものが具体的に見えてきます。数字が小さくなるのは、解像度が上がった証拠だと思うことにしています。
前記事もあわせてどうぞ。
🛡️ 1日数人の個人サイトが1か月で33万回攻撃されていた — ログを数えて塞ぐまで
普段は照明・舞台の制御装置(調光卓、DMX512 / Art-Net / DALI、LED調光)を個人で設計しています。
🔗 tkurume.work