
本記事は、前回記事 「当てる」だけでは足りない ― Numeraiに学ぶ、クオンツ戦略を評価する5つの原則 の続編である。
前回は、戦略を**評価する側(参加者・個人クオンツ)の目線で、「単体で当たるか」だけでなく「既存の予測に何を足すか」を見る5つの原則を整理した。今回は視点を反対側に移し、仕組みを設計する側(Numerai)**の目線から、「上位者でも相関スコアは0.01〜0.03程度」という小さな予測力で、なぜファンドが成り立ち得るのかを掘り下げる。前回を読んでいなくても読めるように書いている。
この記事の要点
- Numeraiの価値は、単一のAIモデルの優秀さではない。弱いが互いに異なる予測力を大量に集め、未来のデータで検証し、重複を抑えて統合する「研究・選別・統合システム」にある、と筆者は考えている。
- 「小さな予測力でも価値が出る」理由は、アクティブ運用の基本法則とアンサンブルの分散式で説明できる。2つをつなぐと「予測の多様性が、束ねた予測の腕前(IC)を押し上げる」ことがわかる。
- 実際の成績は、基本法則の3つの項(腕前・賭けの数・予測をポジションに移せる割合)に、それぞれ別の仕組みが効いていると分解すると、最も整合的に説明できる(第7章)。
- 2023年の大敗は、群衆が同じ方向に間違えたり、報酬やリスク管理の軸がずれたりすれば、この仕組みでも負けることを示している。Numeraiは結果を見て、評価制度そのものを作り直してきた。
本記事は、特定の金融商品や暗号資産(NMRを含む)の購入・投資を勧めるものではない。成績・制度・数値は 2026年10月1日時点 で確認したものである。Numeraiの制度は頻繁に変わるため、参加する場合は必ず公式ドキュメントを確認してほしい。
0. 冒頭の問い:「相関0.02」の予測は使えるのか?
予測と実際の結果の相関が0.02しかないモデルは、普通に考えれば「ほとんど当たっていない」。コイントスとほぼ見分けがつかない水準である。
ところがクオンツの世界では、その0.02を独立した多数の機会に使えるなら話が変わる。
Numeraiは、まさにこの「小さな予測力」を扱うヘッジファンドである。前回記事で書いたとおり、Numeraiのトーナメントでは上位の参加者でも相関スコアは0.01〜0.03程度にすぎない。それでもNumeraiの旗艦株式ファンドは、2024年にネット+25.45%(自社公表値)を記録した1。創業者によれば、ファンドの運用開始以来、負けた年は1年しかない2。
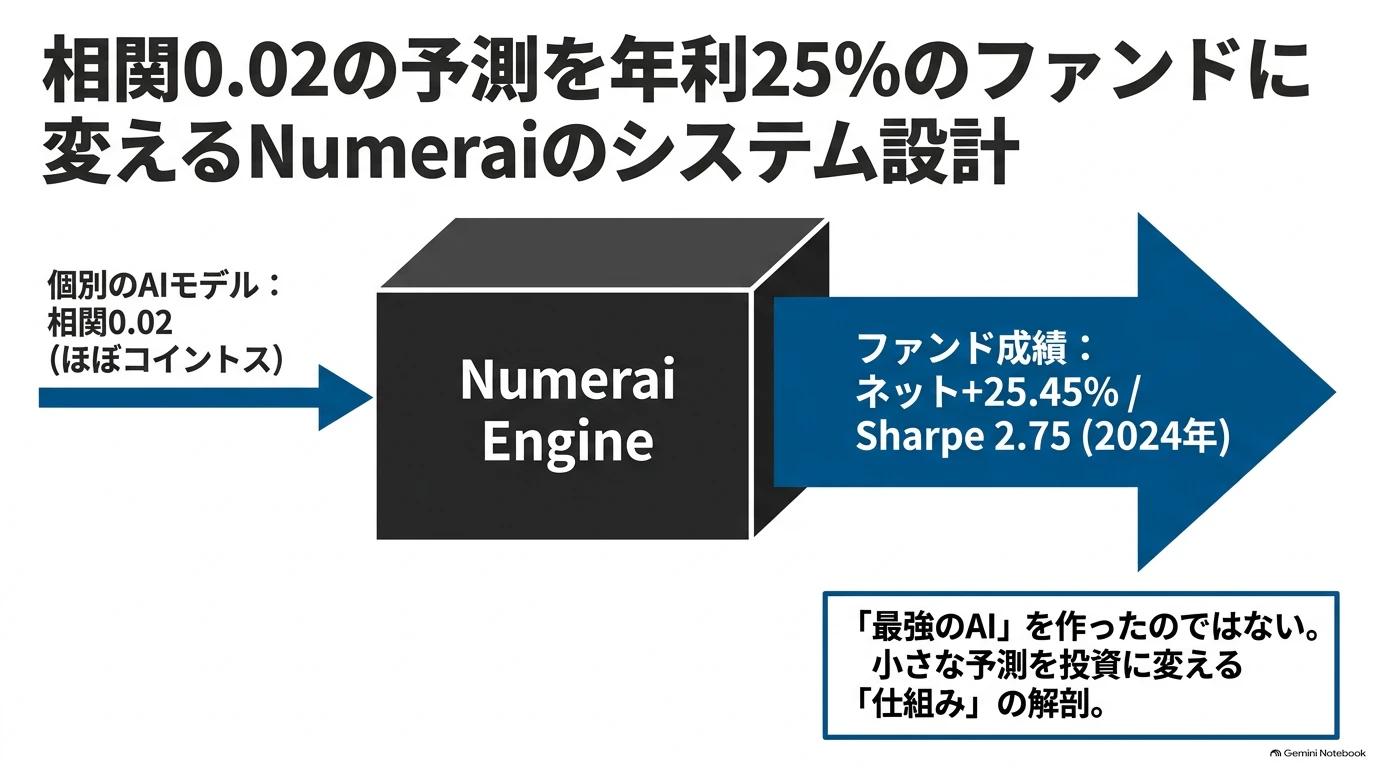
左から入ってくるのは、1本1本はコイントスに近い予測である。右から出てくるのは、2024年のファンド成績だ。この記事は、真ん中の黒い箱「Numerai Engine」を開けて、中で何が起きているのかを順に見ていく試みである。
前回は「だから参加者は、単体の当たり具合だけでなく既存の予測への追加貢献を見るべきだ」という評価する側の話をした。今回の問いはその裏返しで、**「そんな小さな予測力を、どうやって投資に変えているのか」**である。
先に結論を書いておく。Numeraiの強さの秘密は、とびきり優秀なAIモデルを持っていることではない。
Numeraiが作ったのは「最強のAI」ではなく、アルファを継続的に発見・検証・統合する仕組みである。
Numeraiは小さな予測力を、
- 多数の銘柄
- 多数のモデル
- 毎日続くラウンド
- ポートフォリオ最適化
の4つを通じて「投資可能なアルファ」に変えようとしている。
本記事の主張は「Numerai方式は永続的に市場に勝つ」ではない。**「小さく独立したアルファを集める設計には、クオンツ的な合理性がある」というものだ。以下、Numeraiの問題設計(第1〜3章)、小さなアルファの数学(第4章)、仕組みの中核(第5・6章)を順に見たうえで、第7章で本題である「では、なぜ実際に勝てているのか。そして2023年はなぜ負けたのか」**に、外から見える証拠で答える。
1. Numeraiとは何か ― 世界中の研究者を「外部クオンツ部門」にした会社
前回記事を読んだ方は、この章と3.2節は復習なので読み飛ばしてもよい。
Numeraiは2015年創業、サンフランシスコのクオンツ系企業である。Numerai Tournamentで世界中の参加者から株式リターンの予測を集め、それらを統合したMeta Modelを、実際のグローバル株式ヘッジファンドの運用に使っている3。
Kaggleのコンペと似て見えるが、決定的な違いがある。順位を競うこと自体が目的ではなく、提出された予測が実際の資金運用のシグナルにつながる点だ。
なお、旗艦ファンドの「Numerai One」は2026年に「Numerai Sigil」へ改称された4。ほかにSupremeや新設のSingularityといったファンドもあるが、本記事ではClassic Tournament(メインのトーナメント)とMeta Modelの仕組みに絞る。
参加者は実際に何をするのか
参加者の作業はシンプルで、データをダウンロードして機械学習モデルを学習させ、最新の特徴量で予測を作り、APIで提出する。特徴量は2,000を超え、勾配ブースティング木(LightGBMなど)を使う参加者が多い。前回記事で紹介した上位参加者の1人は、2,376個の特徴量を225個まで絞り込んでいた。
1回のラウンドの流れは次のとおりである(2026年10月時点)5。
| タイミング | 何が起こるか |
|---|---|
| 火〜土曜 12:00 UTC(日本時間21:00) | 新しいラウンドが開き、最新の特徴量(Liveデータ)が公開される |
| 平日は約1時間、土曜は翌日曜14:00 UTCまで | 提出の受付期間。期間内なら何度でも出し直せ、最後の有効な提出が採点対象になる |
| 受付期間を過ぎた提出 | 受け付けはされるが、Stakeできず、Meta Modelにも反映されない |
| 約3か月後 | ターゲット(約60営業日先のリターン)が確定し、相関スコアとMMCが確定する |
ポイントは2つある。
- 参加者が渡すのは予測値だけで、モデルのソースコードは渡さない。
- 評価の確定に約3か月かかり、その間も毎日新しいラウンドが始まる。そのため常に約64のラウンドが同時に採点中になっている。1つのモデルが、少しずつ期間のずれた「ほぼ同じ賭け」を60以上同時に抱えている状態であり、この性質は第4章と第8章の論点につながる。
用語ボックス(以降はこの意味で使う)
| 用語 | この記事での意味 |
|---|---|
| アルファ(Alpha) | 市場・国・セクター・一般的なファクターでは説明できない予測力/リターンの源泉 |
| ベータ(Beta) | 市場全体や既知のファクターの動きに連動する部分 |
| OOS | Out-of-Sample。モデル構築に使っていない未知のデータでの検証 |
| Sharpe | リターンを変動リスクで割った、代表的なリスク調整後指標 |
| era | Numeraiのデータにおける「1つの時点」。多くの指標はeraごとに計算される |
| 相関スコア(CORR) | 予測の順位とターゲットとの相関をベースにしたNumeraiのスコア。数式中ではCORRと書く |
| 中和(Neutralize) | 既存のシグナルやファクターと重なる成分を取り除き、独自の成分だけを残す操作 |
| MMC(メタモデル貢献度) | Meta Model Contribution。Meta Modelがまだ持っていない予測力の寄与 |
2. 成績を見る ― 「負けは1年だけ」と「その1年の大きさ」
Numeraiを「AIヘッジファンドの成功物語」として紹介する記事は多い。しかし、実際の成績は一直線ではない。旗艦ファンドについて、公表・報道されている数字を並べる。
| 時期 | 成績 | 出典の性格 |
|---|---|---|
| 2019年9月〜2021年12月 | AurumのクオンツQEMN指数を26.46%、AQRのマーケットニュートラルファンドを29.61%上回る | Numerai公式ブログ(自社公表)6 |
| 2022年 | +20%(株式市場が大きく下落した年) | Bloombergの報道をCoinDeskが引用7 |
| 2023年 | −17%(外部に転載された月次表では、旗艦−17.38%、Supreme−21.68%) | Bloombergの報道をHedgeweekが引用2。月次表は二次情報8 |
| 2024年 | +25.45%(ネット)、Sharpe 2.75、マイナスの月は1回のみ | Numerai公式ブログ(自社公表)1 |
| 2025年(8月頃まで) | 約+6%(手数料控除後)、15か月連続のプラス | Hedgeweek(2025年8月)2 |
運用資産(会社全体)は、約3年前の約6,000万ドルから2025年11月に約5.5億ドル9、2026年8月には約7億ドルへ増えた10。2025年8月には、JPMorgan Asset Managementが最大5億ドルの運用枠を確保している(**AUMそのものではなく「確保された運用枠」**である点に注意)1。
この表から読み取れることと、読み取ってはいけないことを分けておく。
- 読み取れること:6年あまりで負けた年は1年だけで、単年の偶然とは言いにくい。大手運用会社の審査を通るだけの実績もある。一方で、負けた年の損失は−17%と大きい。AI/機械学習を使うファンドでも、大きな損失は起こる。
- 読み取ってはいけないこと:数字の多くは自社公表値か報道ベースで、外部監査済みの全成績が公開されているわけではない。また、好成績から「永続的なアルファが証明された」とは言えない。
では、この成績を生んでいるのは何か。そして同じ仕組みで、なぜ2023年は負けたのか。第3〜6章で仕組みを見たうえで、第7章で正面から答える。
3. 問題の設計 ― 「何を当てさせるか」と「誰がそのアルファを使えるか」
Numeraiは「株価が上がるか下がるか」を当てるサービスではない。ここを最初に押さえておかないと、以降の話がすべてずれる。
3.1 匿名化された高品質データ
Numeraiはヘッジファンド向けの高価な金融データを購入し、特徴量の意味と銘柄名を伏せた(匿名化した)うえで無料で配布している。公式ドキュメントは、このデータで作ったモデルはNumerai Tournamentの外では使えない、と明記している3。
参加者はモデルのソースコードを渡さず、予測値だけを提出する。参加者は自分の実装ノウハウを手元に残したまま、Numeraiはシグナルだけを集められる。
その代償として、Classic Tournamentでは企業名やセクター、特徴量の意味といったドメイン知識を直接使えない。自前のデータを持ち込みたい人向けには、Numerai Signalsという別系統のトーナメントが用意されている。
3.2 当てるのは「方向」ではなく「相対順位」
データの各行は「ある時点の、ある銘柄」を表す。そしてスコアはera(時点)ごとに、その時点での銘柄の並び順で計算される11。
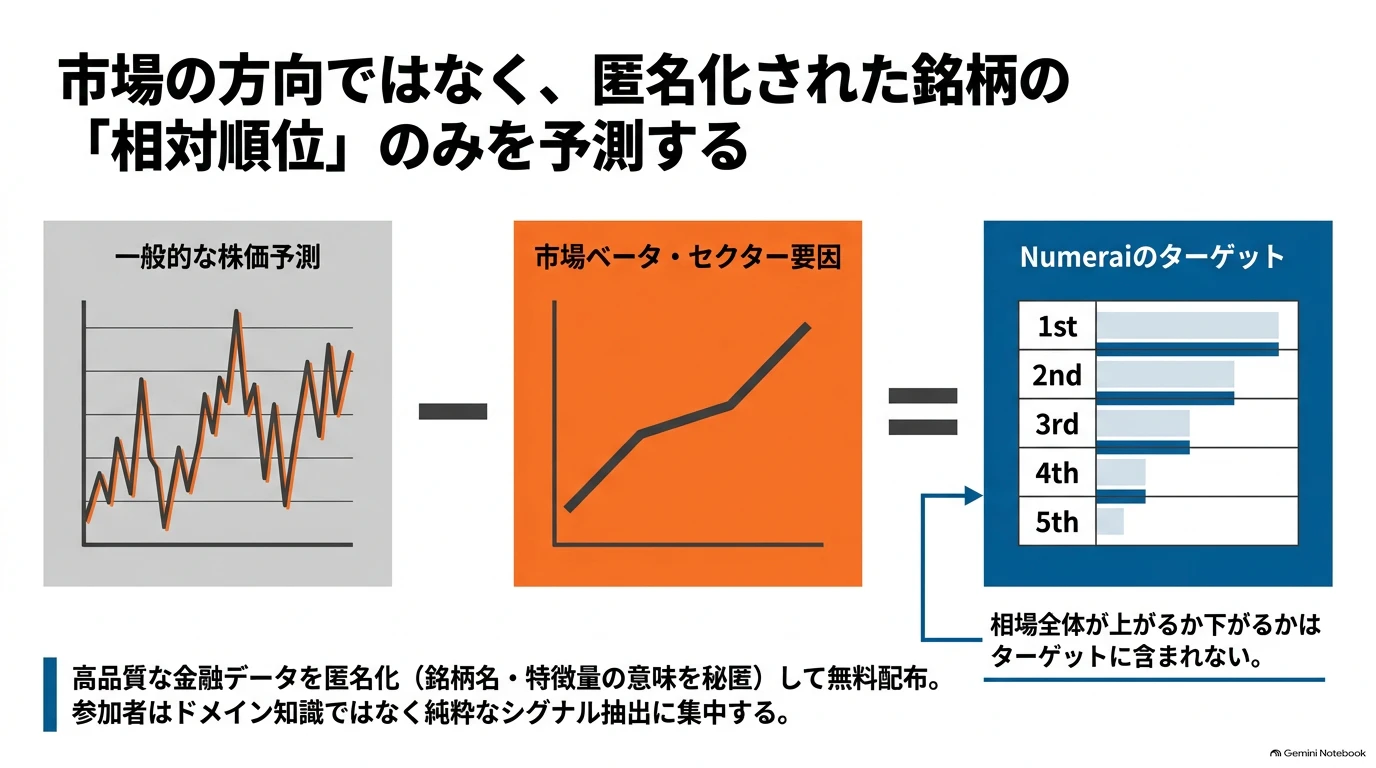
左の「一般的な株価の動き」から、中央の「市場全体やセクターに共通する動き(ベータ)」を引き算する。残ったその銘柄固有の動きの順位(右)だけが、Numeraiの参加者が当てる対象である。相場全体が上がるか下がるかは、最初から答えに含まれていない。
順位だけが評価されるとは、具体的には次のようなことだ。
| 銘柄 | あなたの予測 | 予測の順位 | 実際の(中和済み)リターンの順位 |
|---|---|---|---|
| A | 0.91 | 1位 | 2位 |
| B | 0.73 | 2位 | 1位 |
| C | 0.50 | 3位 | 4位 |
| D | 0.32 | 4位 | 3位 |
| E | 0.05 | 5位 | 5位 |
予測値が0.91か0.60かは関係なく、どの銘柄を上位・下位に置いたかだけが評価される。相関スコア(CORR)の計算では、予測を順位化して正規分布の形に揃えたうえで、予測とターゲットの両方を1.5乗して両端(極端な予想)を強調し、相関を取る12。両端を強調する理由について、公式ドキュメントは「ファンドは予測リターンが最も高い/低い銘柄を中心に売買する傾向があるため」と説明している。
スライドで見たとおり、ターゲット自体も、市場・国・セクター・共通ファクターといったさまざまなベータを取り除いた銘柄固有のリターンとして設計されている11。マーケットニュートラル運用(買いと売りを組み合わせて市場全体の動きを打ち消す運用)と一貫した問題設定になっている。
3.3 なぜ世界中の参加者が、Numeraiにアルファを差し出すのか
ここは入門者が最も疑問に思うところだと思う。「本当に予測力のあるモデルを作れたなら、自分で売買すればいいのでは?」
答えは、匿名化の設計にある。Classic Tournamentの予測は銘柄との対応が伏せられているため、参加者がそのまま自分の売買に転用できない。Numeraiと参加者の間で「アルファの奪い合い」が起きにくい構造になっている。
経済的に見ると、両者にとって次のような意味があると筆者は考えている(以下は公式の説明ではなく、筆者の解釈である)。
- Numerai側:世界中の研究者を社員として雇わなくても、成果に連動する報酬とStake(後述)の仕組みで研究能力にアクセスできる。固定費である人件費を、成果連動の変動費に近い形にしている。
- 参加者側:金融業界に所属していなくても、ヘッジファンド品質のデータでモデルを作り、実際の運用に使われる環境で評価され、報酬を得られる可能性がある。
良いモデルを作る前に、「何を当てさせるか」と「誰がそのアルファを使えるか」を設計している。
4. 小さなアルファの数学 ― 弱い予測でも価値が出る2つの理由
この章が本記事の理論的な芯である。基本となる数式は2つで、最後にそれをつなぐ式を1つ加える。
4.1 アクティブ運用の基本法則(Fundamental Law)
Grinold(1989)が示した「アクティブ運用の基本法則」は、次の近似式で表される13。
IR \approx IC \times \sqrt{BR}
- IR(情報比率):アクティブリターン ÷ アクティブリスク。運用の「質」を表す。
- IC(情報係数):予測と実現値の相関。1回の判断あたりの「腕前」。
- BR(ブレドス、Breadth):互いに独立な投資判断の数。
この式の意味は、腕前が小さくても、独立した判断の回数が多ければ全体の質は上がるということだ。
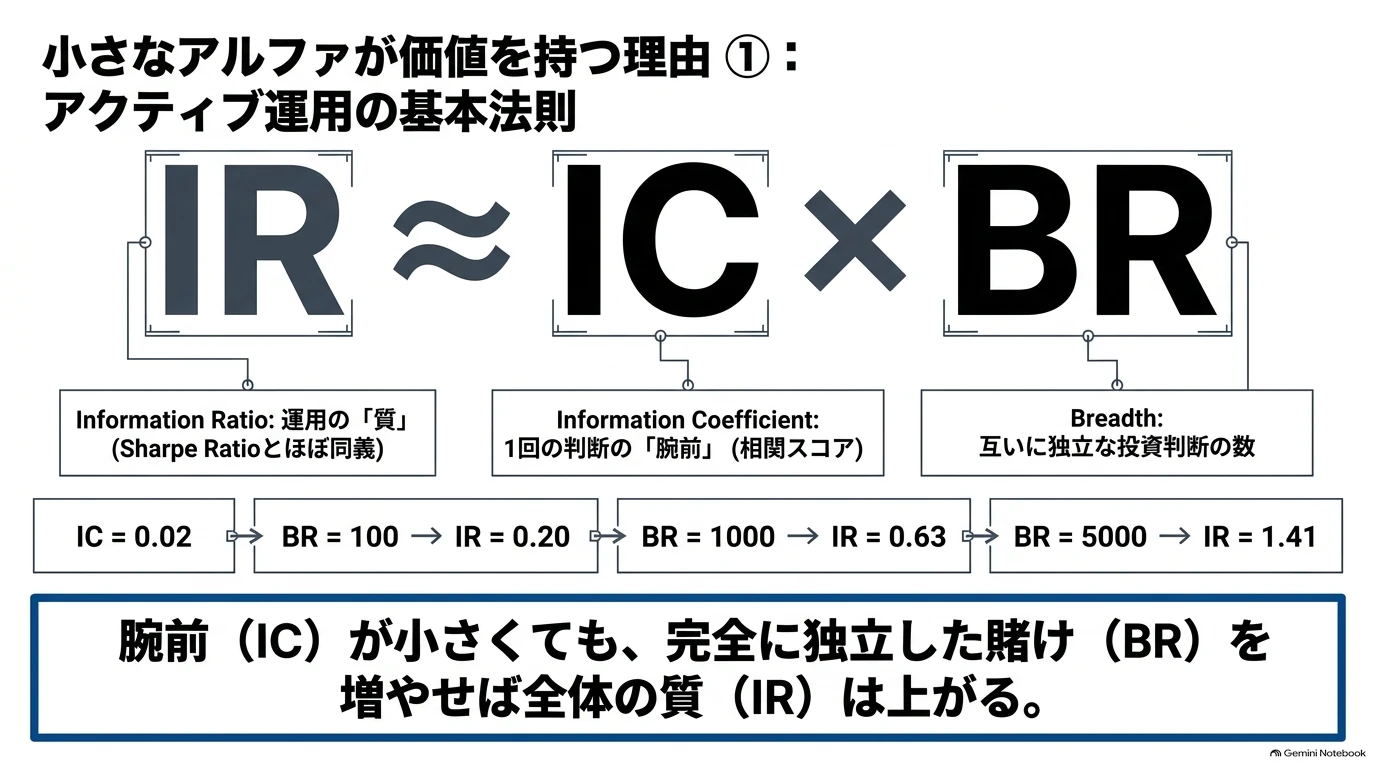
スライドの下段は、IC = 0.02のまま、BRだけを100、1,000、5,000と増やしたときのIRの変化である。腕前は同じでも、独立な賭けの数を増やせば、全体の質は0.20から1.41まで上がる。なお、マーケットニュートラル運用ではIRはSharpeとほぼ同じものと考えてよい(第7章で使う)。ICが0.05の場合も含めると、次のとおりだ。
| IC(腕前) | BR = 100 | BR = 1,000 | BR = 5,000 |
|---|---|---|---|
| 0.02 | 0.20 | 0.63 | 1.41 |
| 0.05 | 0.50 | 1.58 | 3.54 |
IC = 0.02でも、本当に独立な判断機会が1,000回あれば、教科書的な近似ではIR ≈ 0.63になる。冒頭の「相関0.02の予測は使えるのか?」への答えの半分はこれである。
この式を過信しないための注意
BRは単純な「銘柄数 × ラウンド数」ではない。Numeraiでは同じ銘柄が何度も登場し、約60営業日先のターゲットは期間が重なり、隣り合うラウンドはほぼ同じ賭けになっている。公式ドキュメントのQ&Aでも「連続するラウンドは、実質的に同じ賭けを何度も見ているようなもの」と注意されている14。
したがって考えるべきは実効的なBRであり、それは見かけよりずっと小さくなり得る。本記事ではこの式を「小さなICが価値を持ち得る理由を示す、教育用の近似」として使う。第7章では桁の感覚をつかむ思考実験にも使うが、Numeraiの実際の値を推定する道具ではない。
4.2 アンサンブルの分散 ― モデルの数より相関が効く
もう1つの式は、複数モデルの予測を平均したときの誤差の大きさである。
N個のモデルがあり、それぞれの誤差の分散が同じ $\sigma^2$、どの2つのモデルの誤差の相関も同じ $\rho$ だとする。このとき平均予測の誤差の分散は次のようになる。
\mathrm{Var}\left(\frac{1}{N}\sum_{i=1}^{N} e_i\right)
= \frac{1}{N^2}\Big[\,N\sigma^2 + N(N-1)\rho\sigma^2\,\Big]
= \sigma^2\left\{\rho + \frac{1-\rho}{N}\right\}
$N$ をどれだけ増やしても、分散は $\rho\sigma^2$ より小さくならない。モデル同士が似ている限り、1,000個集めてもノイズは消えないのである。
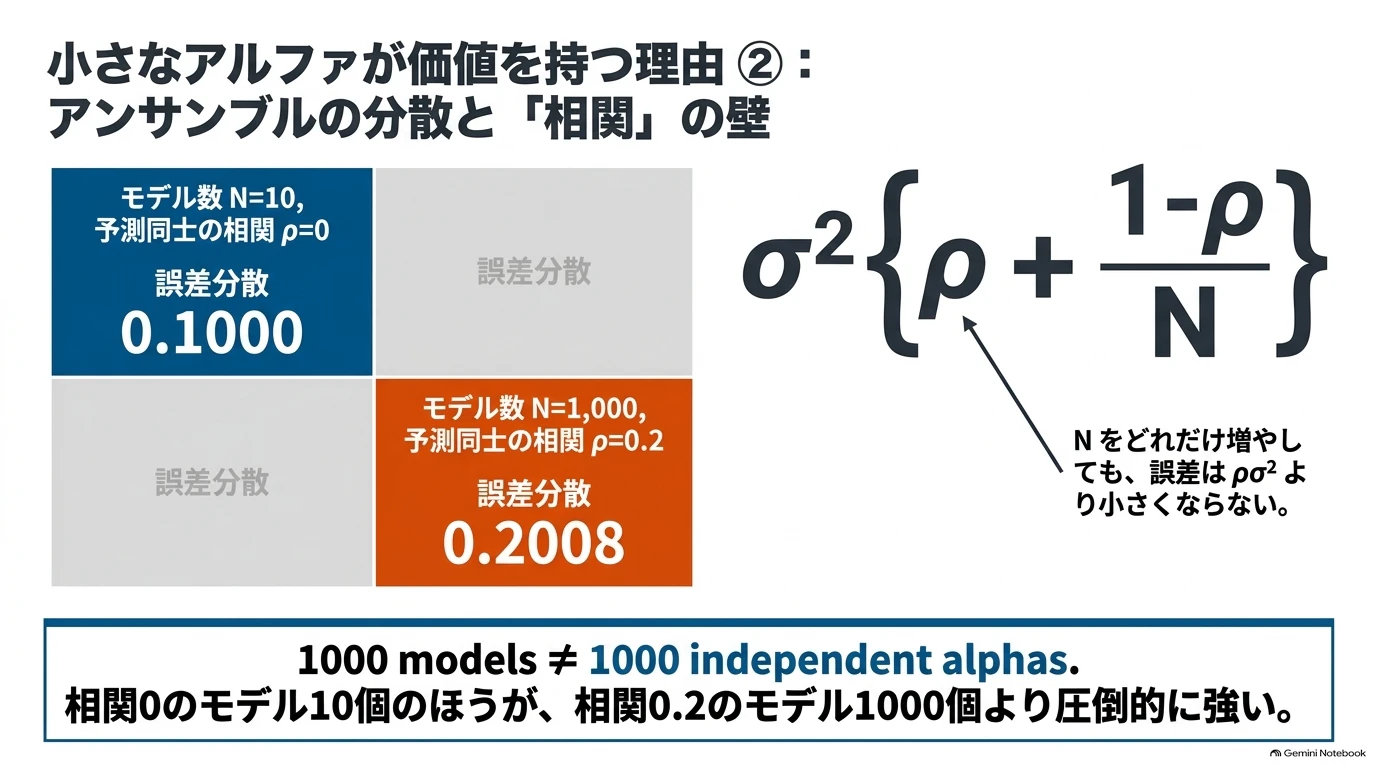
スライドの左上(青)は相関0のモデル10個、右下(オレンジ)は相関0.2のモデル1,000個を束ねたときの誤差である。モデルを100倍集めた右下のほうが、誤差は2倍も大きい。似たモデルばかりなら、いくら数を集めても勝てない。スライドでは簡単に「予測同士の相関」と書いているが、ここでの $\rho$ は正確には誤差(予測のはずれ方)の相関である。
ほかの組み合わせも含めると、次のようになる($\sigma^2 = 1$ とする)。
| モデル数 N | 相関 ρ = 0 | ρ = 0.2 | ρ = 0.5 |
|---|---|---|---|
| 10 | 0.1000 | 0.2800 | 0.5500 |
| 1,000 | 0.0010 | 0.2008 | 0.5005 |
1000 models ≠ 1000 independent alphas。価値を決めるのは数ではなく相関である。
4.3 2つの式をつなぐ ― 束ねた予測の「腕前」はどこまで上がるか
4.1は「腕前(IC)が小さくても、独立な機会が多ければよい」、4.2は「似たモデルを集めてもノイズは消えない」という話だった。この2つは、1つの式でつながる。
N個のモデルがあり、どの予測もターゲットとの相関(IC)が $c$、予測同士の相関が $\rho$ だとする。このとき、N個を平均した予測のICは次のようになる。
IC_{\text{avg}} = \frac{c}{\sqrt{\rho + \dfrac{1-\rho}{N}}}
\quad\longrightarrow\quad \frac{c}{\sqrt{\rho}} \quad (N \to \infty)
平均しても「当たる部分」(ターゲットとの共分散)は $c$ のまま変わらないが、予測の「ばらつき」は4.2の式どおり縮む。だから束ねるほどICは上がり、その上がり幅の上限を決めるのは $\rho$ である。
$c = 0.02$ として計算すると次のようになる。
| 予測同士の相関 ρ | N = 1(単体) | N = 10 | N = 1,000 |
|---|---|---|---|
| 0.9 | 0.020 | 0.021 | 0.021 |
| 0.5 | 0.020 | 0.027 | 0.028 |
| 0.2 | 0.020 | 0.038 | 0.045 |
| 0.05 | 0.020 | 0.053 | 0.089 |
相関0.9の似たモデルを1,000個集めても、ICは0.020から0.021にしか上がらない。相関0.2なら0.045と2倍以上になる。そして4.1の基本法則では、IRはICに比例する。つまり、
予測の多様性 → 束ねた予測のICが上がる → 同じBRでもIRが上がる
という連鎖が成り立つ。冒頭の問い「相関0.02の予測は使えるのか?」への答えの残り半分はこれである。1本では0.02でも、互いに似ていない0.02を束ねれば、束ねた予測はもっと強くなり得る。
これは「どのモデルも同じ腕前で、予測同士の相関もすべて同じ」という単純化した仮定の下での計算である。現実にはモデルごとに腕前も相関もばらばらで、多くのモデルが同じアルファを見つけるため、予測同士の相関は高くなりやすい。表の数字は改善幅の目安であり、伝えたいのは「上限を決めるのはモデル数ではなく相関だ」という方向性である。
4.4 相関 ρ はどこから生まれるのか
では、予測同士はなぜ似てしまうのか。原因と、それに対するNumerai側・参加者側の手当てを整理しておく。
| 似てしまう原因 | 具体例 | 主な手当て |
|---|---|---|
| 同じデータ | 全員が同じ匿名化データ・同じ特徴量を使う | 外部データを持ち込めるNumerai Signals |
| 同じ答え(ターゲット) | 全員が同じターゲットに合わせて学習する | Numeraiは種類の違う銘柄固有リターンのターゲットを多数配布しており、「別のターゲットで学習したモデルは、デフォルトのターゲットのモデルを上回ったり、うまくアンサンブルできたりする」と説明している11 |
| 同じ手法 | 勾配ブースティング木と、公式サンプルの改造が多い | MMCへの報酬(似ているほど稼げない)。Numerai自身のベンチマークモデルと重なる部分を除いて評価するBMC(Benchmark Model Contribution)という指標もある15 |
| 同じ失敗 | 市場の性質が変わると、多くのモデルで同じ特徴量が一斉に効かなくなる | 特定の特徴量への依存を抑える工夫(中和など)。ただし完全には防げない(7.4節・第8章) |
ここで重要なのは、ρは参加者が自然に下げてくれるものではないという点だ。同じデータ・同じ答え・同じ道具が与えられれば、合理的な参加者ほど同じようなモデルに行き着く。だからNumeraiは、ρを下げる方向に報酬や評価の仕組みを設計する必要がある。それが次の章である。
この章をまとめると、Numeraiが欲しいのは「とびきり当たる1つのモデル」ではなく、「少しだけ当たり、しかも互いに似ていない、たくさんのモデル」だということになる。
5. Numeraiの中核ループ ― 未来で評価し、束ね、独自性に報いる
では、「少しだけ当たり、互いに似ていない、たくさんのモデル」をどうやって集めるのか。Numeraiの仕組みは、4つのステップが循環するループとして理解するとわかりやすい。
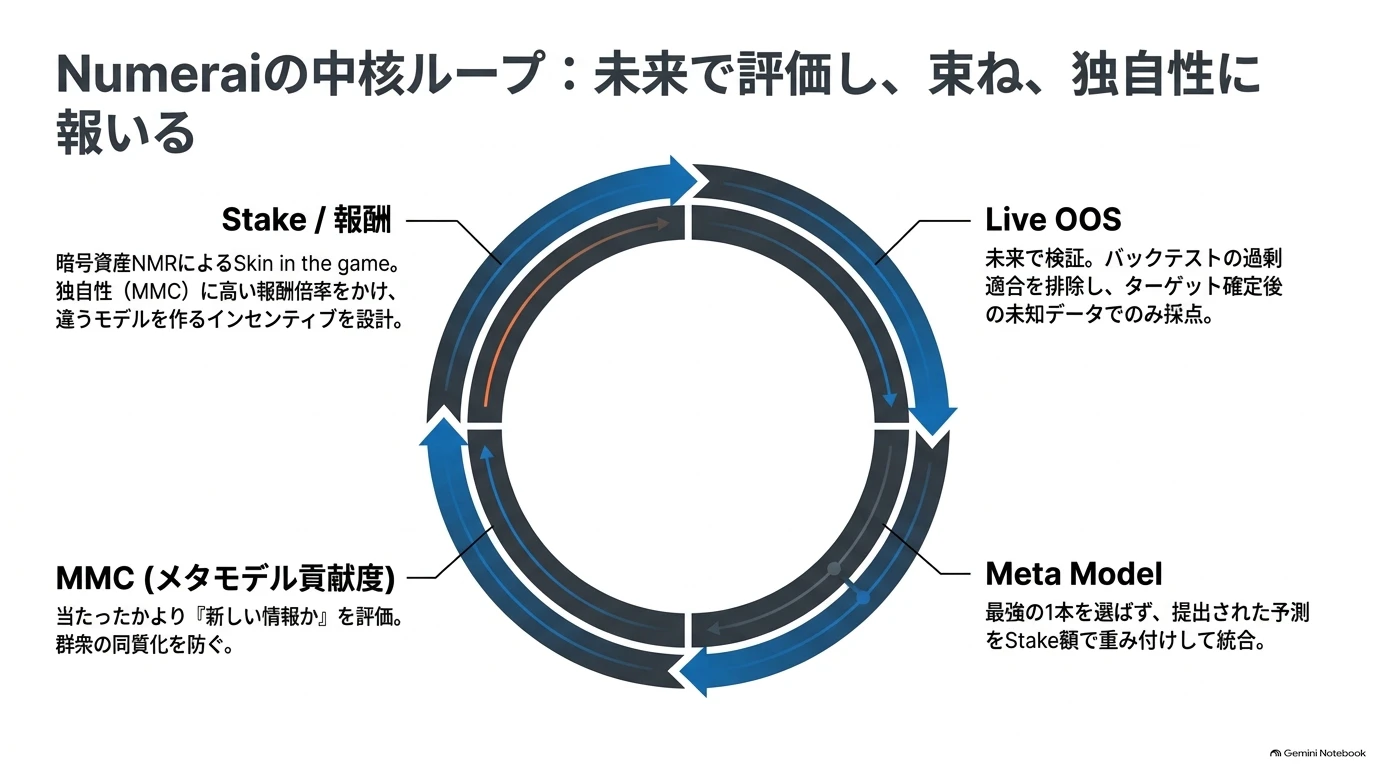
右上のLive OOSで、提出された予測を未来のデータで採点する。右下のMeta Modelで、予測をStakeの重みで束ねる。左下のMMCで、それぞれの予測がMeta Modelに何を新しく足したかを測る。そして左上のStake・報酬で、独自性に高い報酬を払う。その報酬が次の研究の方向を決め、ループは再びLive OOSへ戻る。以下、1つずつ見ていく。
5.1 Live OOS:バックテストではなく「未来で生き残るか」を見る
バックテストは、条件を何度も変えて試せば、偶然よい結果を作れてしまう。Numeraiでは、提出された予測をターゲットが実際に確定してから採点する。採点に使われるのは、提出時点ではまだ誰も知らない未来のデータだ3。
公式ドキュメントのQ&Aでは、モデルの良し悪しの判断には「数週間ではなく数か月」が必要で、経験者は最低3〜4か月を目安にしていると紹介されている14。検証データについても「何度も覗くたびに検定としての価値が下がる」と注意されている。
これは個人のクオンツがバックテストを扱うときの原則と同じである。
5.2 Meta Model:最強の1本を選ばず、予測を束ねる
Numeraiは提出された予測を標準化し、Stake(賭け金)で重み付けした平均を取ってMeta Model(Stake-Weighted Meta Model)を作る316。概念的には次の式である。
\text{MetaModel} = \sum_i w_i \, \tilde{p}_i, \qquad w_i \propto \text{Stake}_i
$\tilde{p}_i$ は標準化したモデル $i$ の予測である。Stakeされていない予測は採点はされるが、重みはゼロで、ファンドの運用には使われない。
これは「最強モデルの選抜」ではなく「モデルのポートフォリオ化」と捉えるとよい。株を分散して持つように、Numeraiはアルファそのものを分散して持っている。第4章の式のとおり、モデル同士が似ていなければ、束ねることで個々のノイズが打ち消し合う。
5.3 MMC:「当たったか」より「新しい情報か」
ここがNumeraiで最も特徴的な指標であり、前回記事で「核心」として扱った部分でもある。前回は「参加者は自分のモデルをこの目線で評価すべきだ」という話をしたが、ここではファンドがなぜこの指標を必要とするのかという目線で見直す。
MMC(メタモデル貢献度)は、提出予測からMeta Modelと重なる成分を取り除き、残った独自成分がターゲットとどれだけ連動したかを測る15。
p^{\perp} = p - \beta\, m, \qquad
\text{MMC} \approx \mathrm{Cov}\left(p^{\perp},\, y\right)
$p$ は提出予測、$m$ はMeta Model、$y$ はターゲット。$\beta m$ がMeta Modelと重なる成分で、それを除いた $p^{\perp}$ が独自成分である(実際の計算では予測とMeta Modelの標準化などが入る。上は考え方を示す概念式である)。
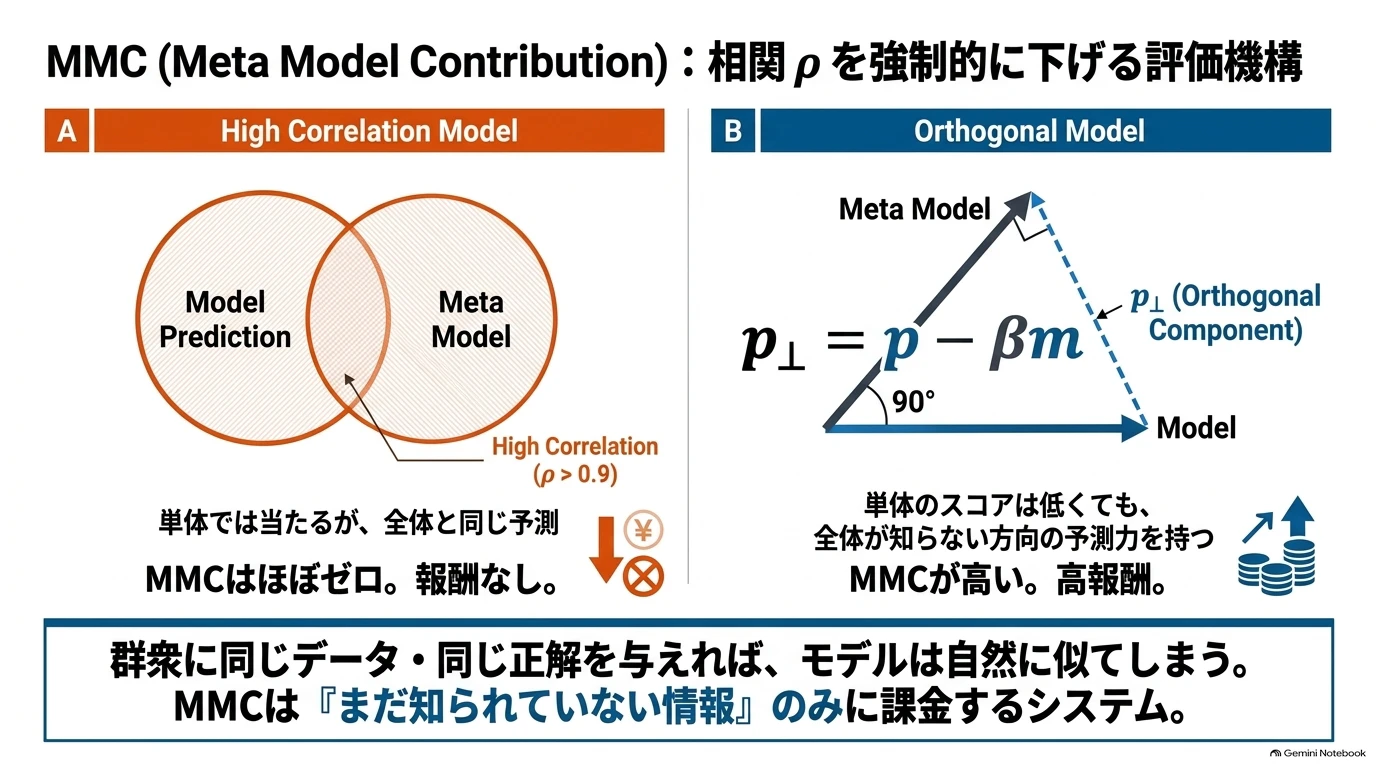
スライドの左(A)は、Meta Modelとほぼ同じ予測を出すモデルである。2つの円はほとんど重なっていて、単体では当たっていても、全体がすでに知っている情報しか持っていない。だからMMCはほぼゼロになる。
右(B)は、Meta Modelと直交する(重ならない)方向に予測力を持つモデルである。式の $p^{\perp}$ がその直交成分にあたる。単体のスコアは低くても、全体が知らない方向で当たっていれば、MMCは大きくなる。
「このモデルは当たるか」ではなく「このモデルを加えると、全体に何が増えるか」を測っているわけだ。株式ポートフォリオで、個別銘柄の期待リターンだけでなく既存の保有銘柄との相関を見るのと同じ発想である。
ファンドの側から見れば、理由は第4章の式そのものだ。Meta Modelと相関の高い予測をいくら足しても、平均予測の誤差は $\rho\sigma^2$ の壁より下がらない。Meta Modelの誤差を減らせるのは、Meta Modelと違う予測だけである。MMCは、その「違い」のうち実際に当たった部分だけを取り出して測る指標だといえる。
5.4 Stake・報酬:なぜ参加者は「違うモデル」を作るのか
第4章で「違うモデルが価値を持つ」と書いた。しかし、参加者が自発的に違うモデルを作る理由がなければ、全員が公式サンプルを少し改造した似たようなモデルに集まってしまう。そこで効いてくるのが報酬設計である。
参加者は任意で、暗号資産NMRを自分のモデルにStake(賭け金として預ける)できる(収益の仕組みの詳細は前回記事の付録Bにまとめた)。スコアがプラスならNMRの報酬を受け取り、マイナスならStakeの一部が**Burn(焼却)**される。予測に「Skin in the Game」(自分も損をし得る立場)を持たせる仕組みだ16。
そして2026年10月時点のClassic Tournamentでは、報酬の基準となるスコアが次のように定められている(round 1343以降)1718。
\text{SEASON} = 3 \times \text{CORR}_{60} + 15 \times \text{MMC}_{60}
MMCの倍率は相関スコアの5倍である。ただしMMCは値そのものが相関スコアより小さく出やすいので、倍率の比をそのまま「重要度の比」と読むのは早計だ。それでも、独自性に報酬の大きな比重を置く設計であることははっきり読み取れる。参加者にとっては「みんなと同じ予測」では稼ぎにくく、「Meta Modelが知らないことを当てる」ほど報われる。
報酬設計によって、群衆を「多様なまま」保とうとしているのである。
この報酬設計は最初からこの形だったわけではない。
- 2022年:Meta Modelへの寄与を実際のポートフォリオへの寄与に近づけようと、**TC(True Contribution)**という指標を報酬の軸に導入した19。TCはファンドの最適化器を通した寄与を測るため、参加者が手元で計算できなかった。
- 2023年11月:Numeraiは、2024年1月からMMCベースの報酬に戻すと発表した。理由として「MMCのほうがTCより安定している」「MMCは手元で計算できるがTCはできない」「MMCで報酬を払っていた時期に最も安定したパフォーマンスを得た」を挙げている20。
- 2026年8月28日以降:約60営業日先のターゲット(Ender-60)と新しいStake方式(Atomic Blockchain Staking)へ移行し、上の式になった18。それ以前の倍率は 0.75×CORR + 2.25×MMC だった17。
(旧方式には1ラウンドあたりの損益を±5%に制限する上限などもあったが、ここでは省略する21)
6. 予測と運用を分ける ― Good Prediction ≠ Good Portfolio
Meta Modelは最終的なポートフォリオではない。「どの銘柄が相対的に強そうか」という期待アルファを表すシグナルである。
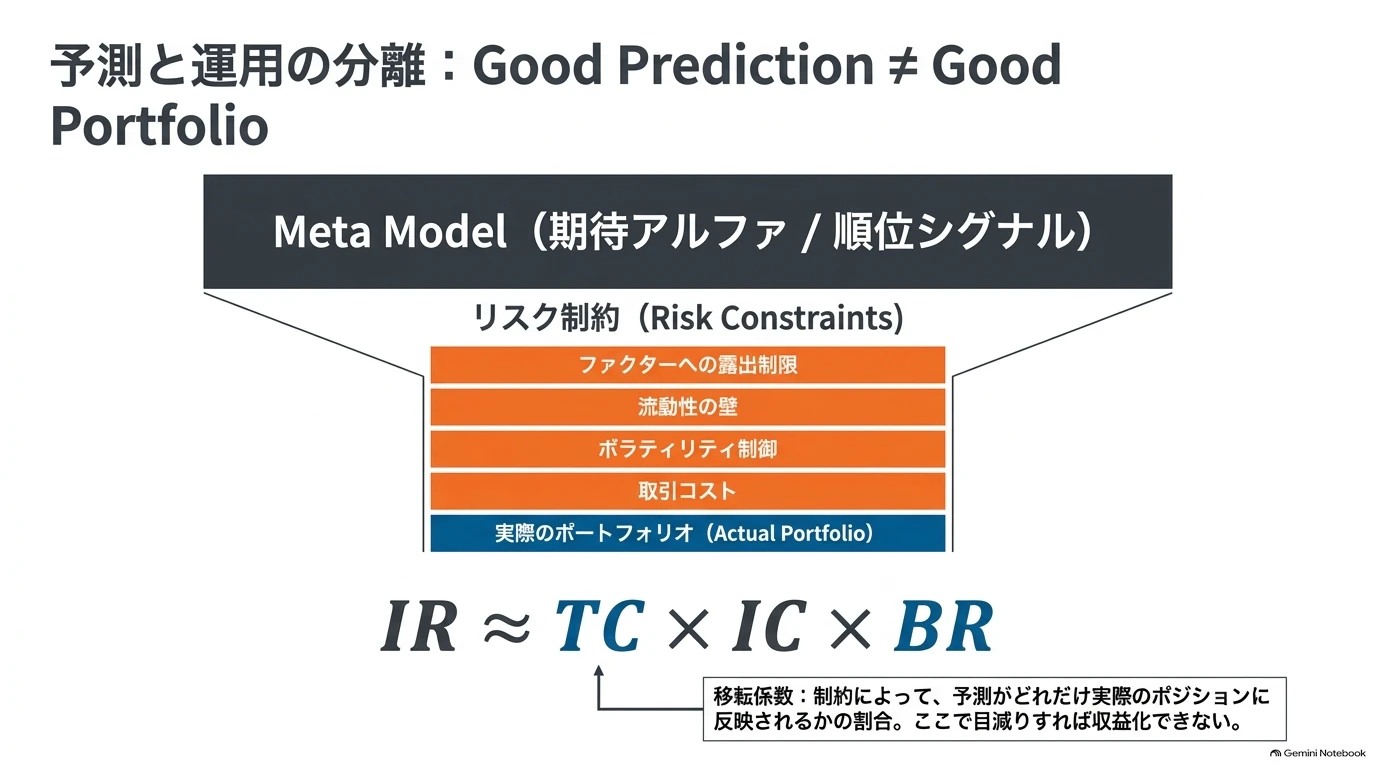
スライド上部の黒い帯がMeta Model(シグナル)である。これがオレンジの4層のリスク制約、つまりファクターへの露出制限、流動性の壁、ボラティリティ制御、取引コストを通り抜けて、はじめて一番下の青い「実際のポートフォリオ」になる。層を通るたびに、予測の一部は削られていく。
第4章の基本法則には、この現実を反映した拡張がある。Clarke・de Silva・Thorley(2002)は、制約によって予測がどれだけポートフォリオに反映されるかを表す**移転係数(Transfer Coefficient)**を加えた22。スライド下の式のTCがそれで、制約を通り抜けたあとに残る割合を表す。
IR \approx TC \times IC \times \sqrt{BR}
(ここでのTCはTransfer Coefficientで、第5章のTrue Contributionとは別物である)
小さなICを持っていても、それをポジションに移せなければ収益にはならない。Tournamentのリーダーボードとファンドの成績を同一視してはいけない理由がここにある。
Good Prediction ≠ Good Portfolio。予測はリスク制約の中で初めて投資になる。
7. 本題:では、なぜNumeraiは勝てているのか
ここまでの章で見てきたのは、Numeraiが「勝ち得る」構造だった。ここからが、だれもが知りたい本題である。実際の成績を、その構造で説明できるのか。そして、同じ構造でなぜ2023年は負けたのか。
先に、この章の答えを書いておく。
この章の答え
Numeraiの成績は、基本法則の3つの項、つまり**腕前(IC)・賭けの数(BR)・移せる割合(TC)**のそれぞれに、別々の仕組みが効いている結果だと考えるのが、外から見える証拠と最も整合的である。
- 腕前の土台:高品質なデータと、「銘柄固有のリターン」という問題設計
- 腕前の上乗せ:群衆の多様性と、それを保つMMCの報酬
- 賭けの数と移せる割合:数千銘柄への小さな賭けに分散し、予測の目標をファンドの売買に合わせる
- そしてこれを、社員を抱えるより安いコストで回している
ただし2023年が示すとおり、群衆が同じ方向に間違えたり、報酬やリスク管理の軸がずれたりすれば、この仕組みでも負ける。
7.1 まず「年25%」を正しく読む ― 強さの物差しはSharpe
入門者がつまずきやすい点から片付けておく。「相関0.02程度の予測で、なぜ年25%も稼げるのか」。
答えの一部はレバレッジにある。マーケットニュートラル運用は、買いと売りで市場全体の動きを打ち消すため、そのままでは値動き(リスク)も収益も小さい。そこで借入などによって建玉を数倍に膨らませる。Numeraiは2022年時点で、ファンドを5.5倍のレバレッジで運用していると公表している6。
レバレッジを2倍にすれば、収益率もリスクもほぼ2倍になる。しかし、収益をリスクで割ったSharpeは、レバレッジでは変わらない。だから「強さ」の物差しは、25.45%という収益率ではなくSharpe 2.75のほうである。4.1節で触れたとおり、マーケットニュートラル運用では、Sharpeは情報比率(IR)とほぼ同じものと考えてよい。
逆にいえば、レバレッジは損失も同じ倍率で膨らませる。2023年の−17%も、この増幅と無関係ではない。
7.2 Sharpe 2.75を、基本法則で分解する
では、Sharpe(≒IR)2.75はどこから来るのか。第6章で紹介した拡張版の基本法則を、「強さの分解図」として使う。
IR \approx TC \times IC \times \sqrt{BR}
(この章でTCと書くときは移転係数(Transfer Coefficient)を指す。5.4節の報酬指標True Contributionは、混同を避けるため略さずに書く)
まず、桁の感覚をつかむための思考実験をしておく。IR 2.75を出すには、1年間に何回分の「独立な賭け」が必要になるか。
| 腕前 IC | 移せる割合 TC | 必要な独立な賭けの数(年間) |
|---|---|---|
| 0.02(単体モデル程度) | 1.0(制約なし) | 約19,000回 |
| 0.02 | 0.5 | 約76,000回 |
| 0.045(4.3節の「束ねた」例) | 1.0 | 約3,700回 |
| 0.045 | 0.5 | 約15,000回 |
($BR = \left( IR / (TC \times IC) \right)^2$ で計算した。Numeraiの実際の値ではなく、桁の感覚をつかむための思考実験である)
数千銘柄を毎日入れ替えるファンドでも、銘柄同士や日々の賭けは独立ではない。実効的に年間数万回の独立な賭けを確保するのは難しく、単体0.02の腕前のままでは届きにくい。届かせるには、腕前を上げる(IC)、賭けを増やす(BR)、制約で目減りさせない(TC)の3つを同時に効かせる必要がある。
そして、Numeraiの仕組みはちょうどこの3つに対応している。
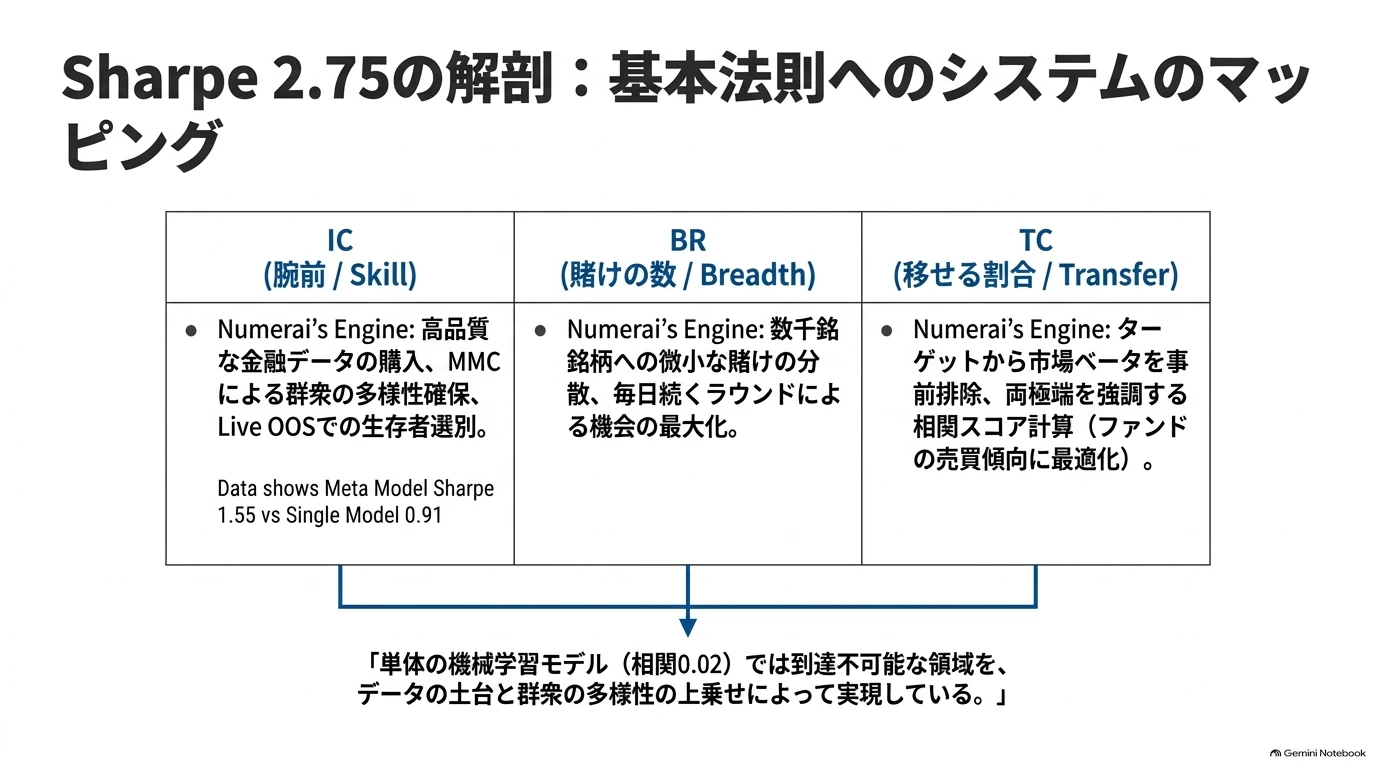
スライドは、3つの項それぞれにNumeraiのどの仕組みが効いているかを対応させたものだ。腕前(IC)には、高品質なデータ、MMCによる群衆の多様性、Live OOSでの選別が効いている。賭けの数(BR)には、数千銘柄への小さな賭けへの分散と、毎日続くラウンドが効いている。移せる割合(TC)には、ベータを除いたターゲットと、両端を強調する相関スコア、つまり予測の目標をファンドの売買に合わせる設計が効いている。
項ごとに、外から見える証拠を詳しく並べる。
| 項 | 効いているNumeraiの仕組み | 外から見える証拠 |
|---|---|---|
| IC:腕前の土台 | 購入した高品質データ、Numeraiが設計した特徴量、ベータを除いたターゲット(第3章) | Numeraiが2019年に公表したシミュレーションでは、同じデータで線形モデルのSharpeが0.13、機械学習モデルが0.91だった23。データ自体に、機械学習で拾える予測力がある |
| IC:腕前の上乗せ | 群衆の多様性、MMCの報酬、Live OOSでの選別、Stakeによる重み付け(第4・5章) | 同じシミュレーションで、Stakeされたモデルを束ねたMeta ModelのSharpeは1.55。単体の機械学習モデルの約1.7倍だった23 |
| BR:賭けの数 | 相場全体への1つの賭けではなく、数千銘柄への小さな賭けに分解する問題設計(第3章)、毎日のラウンド | 2019〜2021年、ファンドのリターンの80%超が銘柄選択によるもので、ファクター・国・セクターへの露出によるものは20%未満だった6 |
| TC:移せる割合 | 予測の目標をファンドの売買に合わせる設計。ベータを除いたターゲット、両端を強調する相関スコア(第3・6章) | 上の80%超という数字は、設計どおりの「銘柄固有の予測」が実際の収益に移っていたことを示す。2020年3月のコロナ・ショックでも、ファンドは−1.54%にとどまった6 |
とくに示唆的なのは、上の2行である。単体モデル0.91からMeta Model 1.55への上乗せは、4.3節の式でいえば、予測同士の相関が0.35程度のときに起こる大きさで、桁としては理論と整合する。「データが土台を作り、群衆が上乗せする」という分担が、数字の上でも見えている。
証拠の限界
- 2019年の数字はNumeraiが公表したシミュレーションで、記事を書いた創業者自身が「説明用であり、実運用を代表しない」「パラメータを少し変えると結果が大きく変わる」と明記している。同じ記事は、2014〜2016年の期間ではMeta Modelと単体の機械学習モデルの成績がほぼ同じだったとも書いている。
- 2019〜2021年の成績と要因分析も、Numeraiの自社公表値である。
- いずれも「この説明と矛盾しない」証拠であって、「この説明を証明する」証拠ではない。
7.3 なぜ他社ではなく、Numeraiなのか
「小さなアルファをたくさん集めて束ねる」こと自体は、Numeraiの専売特許ではない。ミレニアムのようなマルチマネージャー型のヘッジファンドは、多数の独立した運用チームの戦略を束ねている。WorldQuantのように、外部の研究者から大量のアルファを集める会社もある。
では、Numeraiは何が違うのか。創業者のRichard Craibは、Numeraiをミレニアムのようなマルチストラテジー型のプラットフォームと比べ、「よりコスト効率が高い」と述べている2。筆者は、この「コスト効率」を次の3つに分解できると考えている(以下は筆者の整理である)。
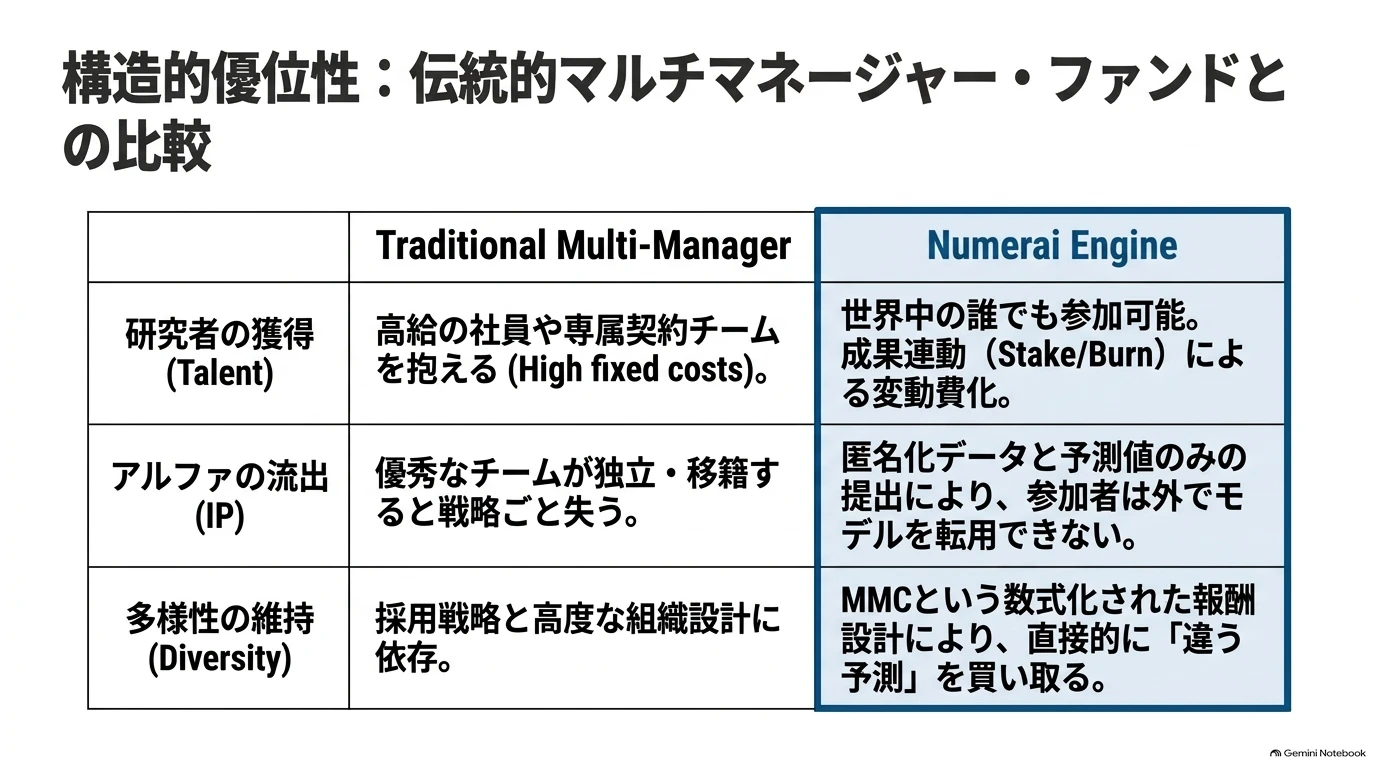
1行目の研究者の獲得では、高給の社員や専属チームを抱える固定費型に対し、Numeraiは世界中の誰でも参加でき、報酬は成果に連動する変動費型である。2行目のアルファの流出では、優秀なチームが独立・移籍すると戦略ごと失うリスクに対し、Numeraiは匿名化データと予測値だけの提出によって、参加者が外でモデルを転用しにくい構造にしている。3行目の多様性の維持では、採用と組織設計に頼る代わりに、MMCという数式化された報酬で「違う予測」を直接買い取っている。
ただし、クラウドソーシングにすれば成功するわけではない。個人のクオンツからアルゴリズムを募るプラットフォームとして注目されたQuantopianは、2020年に事業を終了した24。設計上の違いを1つ挙げるなら、Quantopianが参加者の売買戦略そのものを集めようとしたのに対し、Numeraiは同じ匿名化データ・同じターゲットの上での、標準化された予測値を集めている点だろう(Quantopianの事業終了の理由は単純ではなく、これだけでNumeraiの優位を断定するつもりはない)。
つまりNumeraiの強さは、「マルチアルファ」という発想そのものではない。それを安く、広く、持ち逃げされずに、多様なまま回す仕組みにある、と筆者は考えている。
7.4 では、2023年はなぜ負けたのか ― 世論調査の平均がはずれるとき
同じ仕組みがあったのに、2023年は−17%だった。この事実は、ここまでの説明と矛盾するのだろうか。
選挙の世論調査で考えるとわかりやすい。個々の世論調査には誤差があるが、たくさんの調査を平均すれば、ばらばらの誤差は打ち消し合って予測は安定する。ところが、すべての調査が同じ方向に偏っていたとしたらどうか。たとえば、ある層の有権者がどの調査にも答えていなかったら、いくら平均しても偏りは消えない。平均は「ばらばらの誤差」は消せても、「共通の誤差」は消せないのである。
これは4.2節の式そのものだ。平均した予測の誤差は、どれだけモデルを集めても $\rho\sigma^2$ の壁より下がらない。そして市場の性質が変わる局面では、多くのモデルが同じ特徴量に頼っているために、普段は抑えられているρが一斉に上がりやすい。群衆が同じ方向に間違えるとき、束ねる仕組みは守ってくれない。
2023年の損失について、Numeraiは詳しい原因を公表していない。外から見える手がかりから考えられる主な仮説を、1枚にまとめた。
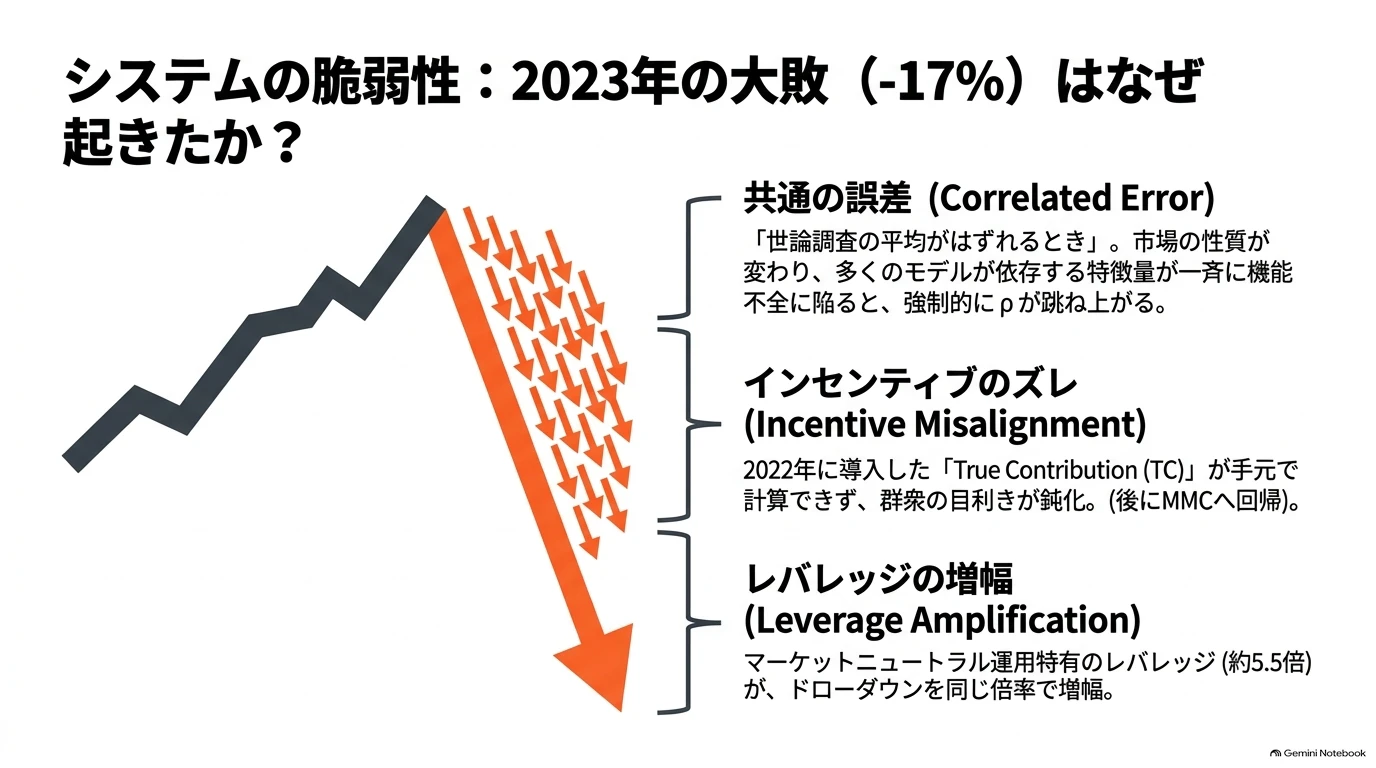
上から、共通の誤差(世論調査の平均がはずれるとき)、インセンティブのずれ(True Contribution期)、レバレッジによる増幅である。これにリスク管理・ポートフォリオ構築を加えた4つを、基本法則のどの項に効いたか、手がかりの強さとともに整理すると次のようになる。
| 仮説 | 崩れた項 | 手がかりと、その強さ |
|---|---|---|
| 群衆が同じ方向に間違えた(共通の誤差) | IC(上乗せが消える) | 理論的には自然。公式ドキュメントも、特徴量の予測力は時間とともに安定しないと認めている11。ただし2023年の具体的なデータは非公開 |
| 報酬の軸がずれていた(True Contribution期) | IC(群衆が何を最適化するか) | Numeraiの公式発表は「MMCで報酬を払っていた時期に、最も安定したパフォーマンスを得た」と述べ、2024年1月にMMCベースの報酬へ戻した(ファンドの成績を指すのかは明記されていない)20。一次情報としては最も直接的な手がかり |
| リスク管理・ポートフォリオ構築 | TC(予測を売買に移す層) | 創業者は2026年のポッドキャストで、「2023年のドローダウンからの学びと、リスクシステムの強化」を1つのテーマとして語っている25(詳しい内容は本記事では確認できていない) |
| レバレッジと市場環境 | 全体(損失の増幅) | レバレッジは損益を同じ倍率で増幅する(7.1節)。具体的な寄与は非公開 |
2番目の仮説には、筆者なりの解釈を加えておきたい(以下は公式の説明ではない)。True Contributionはファンドの最適化器を通した寄与を測る指標で、参加者が手元で計算できなかった(5.4節)。自分が何を最適化すれば報われるのかが見えにくく、スコアのぶれも大きければ、報酬とBurnを通じたStakeの移動もノイズに引きずられる。Stakeの重みで作られるMeta Modelにとって、これは「群衆の目利き」が鈍ることを意味する。手元で計算でき、安定しているMMCへ戻したことは、この目利きの精度を取り戻す変更だったと読める。
ただし、True Contributionを導入した2022年にファンドは+20%だった7。効果が遅れて表れた可能性はあるが、外からは検証できない。True Contributionだけで2023年を説明するのは無理があり、上の仮説のいくつかが重なったと考えるのが自然だろう。
時系列で並べると次のようになる。
| 時期 | 出来事 |
|---|---|
| 2022年 | 報酬の軸にTrue Contributionを導入19。ファンドは+20%(報道)7 |
| 2023年 | ファンドは−17%(報道)2 |
| 2023年11月 | True Contributionを見直し、2024年1月からMMCベースの報酬に戻すと発表20 |
| 2024年 | +25.45%(ネット)、Sharpe 2.75(自社公表)1 |
| 2025年 | 8月頃までで約+6%(手数料控除後)、15か月連続のプラス(報道)2 |
| 2026年8月 | 約60営業日先のターゲット(Ender-60)とAtomic Stakingへ移行18 |
ここから言えることは2つある。
- 仕組みは、勝つための必要条件ではあっても十分条件ではない。 共通の誤差、インセンティブのずれ、リスク管理の弱さのどれかが重なれば負ける。
- 2024年以降の回復は、Numeraiが報酬(MMCへの回帰)とリスクシステムの両方に手を入れた時期と重なる。 時期の一致は因果の証明ではないが、少なくともNumeraiは、負けた原因を仕組みの側で探し、作り直した。
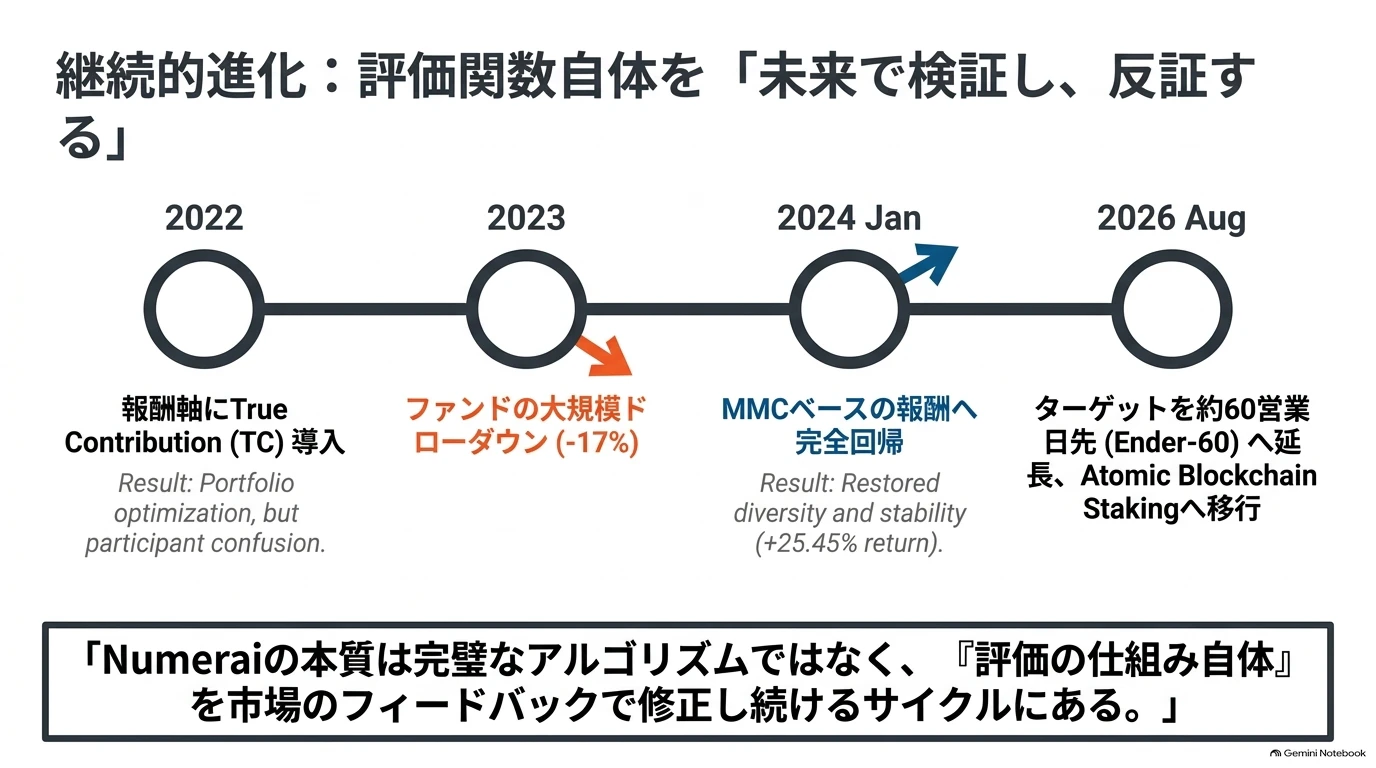
スライドは、この流れを1本の線にまとめたものだ。2022年の報酬設計の変更、2023年の大敗、2024年1月のMMCへの回帰、2026年8月のターゲット延長と新しいStake方式。それぞれの変更は、前の結果を見て評価の仕組みそのものを直したものである。
筆者は、ここにこそNumeraiの本質があると考えている。参加者のモデルを未来で検証するだけでなく、それを評価する仕組み自体も、未来で検証され、入れ替えられているのである。
7.5 外からは分からないこと
最後に、この章の説明の限界を明示しておく。外からは、次のことは分からない。
- ファンドの最適化器、リスクモデル、レバレッジ運用の中身(つまり移転係数TCの実際の値)
- 成績のうち、群衆の貢献と、Numerai自身のデータ・ターゲット設計の貢献の割合
- Classic Tournament以外のシグナル(Numerai Signalsなど)が、ファンドの売買にどう組み合わされているか
- 2023年の損失と2024年の回復の、具体的な要因の内訳
- 2025年通年の成績(本記事の執筆時点で確認できたのは、2025年8月頃までの報道ベースの数字のみ)
それでも、ここまでの材料を合わせると、冒頭の問いには次のように答えられる。
Numeraiの強さの秘密は、腕前の土台(データと問題設計)、腕前の上乗せ(群衆の多様性とMMC)、賭けの数と移せる割合(銘柄固有の小さな賭けへの分散と、売買に合わせた予測目標)を、低コストの仕組みで同時に回していることにある。ただしそれは勝つための必要条件であって、勝ちを保証するものではない。
8. 限界 ― Numerai自身も完成形ではない
第7章では2023年の損失を手がかりに仕組みの弱点を見たが、ほかにも構造的な限界がある。各論点は「欠点」と「それに対してどんな手当てがあるか」をセットで見ておきたい。
| 論点 | 内容 |
|---|---|
| Stakeの重み ≠ 実力 | Stakeの量には資金力・リスク許容度・NMRの保有量が反映される。大きくStakeできる人のモデルが優れているとは限らない。報酬とBurnを通じて、長期的には良いモデルにStakeが集まる設計ではあるが、短期的には資金量の影響を受ける。 |
| NMRの価格変動 | Meta Modelの重みはNMRの数量に基づくが、参加者が感じるリスクとリターンはNMRのドル建て価格に左右される。価格の上下が参加者のStake行動を変える可能性がある。 |
| フィードバックが遅い | 約60営業日先のターゲットと重なり合うラウンドのため、良し悪しの判断に数か月かかる14。短期のスコアを見て頻繁に改造すると、Liveデータへの過剰適合(オーバーフィッティング)になる危険がある。 |
| 非定常性 | 公式ドキュメント自身が「多くの特徴量は単独でも予測力を持ち得るが、その予測力は時間とともに安定しないことが知られている」と書いている11。市場の性質の変化は避けられない。 |
| 群衆の同質化 | 公式のサンプルモデルを改造したモデルが増えると、群衆全体が似通う。MMCはその重複に報酬を与えない方向の手当てだが、独立性を完全に保証するものではない。 |
| 制度そのものが変わる | ターゲット、相関スコアとMMCの倍率、Stake方式は何度も変わってきた。参加者には追随コストがかかる。一方でNumerai側から見れば「評価関数そのものを改善し続けられる」能力でもある。 |
どの論点も、Numeraiが「完成した仕組み」ではなく、弱点を抱えたまま改善を続けている仕組みであることを示している。
9. 前回の5原則を、仕組みの側から見直す
前回記事では、個人クオンツが戦略を評価するための5つの原則を挙げた。今回見てきたNumeraiの仕組みと並べると、それぞれの原則がなぜ必要なのかが設計の側から説明できる。
| 前回の原則(評価する側) | 対応する仕組み(設計する側) | 今回の章 |
|---|---|---|
| 原則1:何を当てれば評価されるのかを、最初に確認する | 匿名化データ、相対順位、ベータを取り除いたターゲットという問題設計 | 第3章 |
| 原則2:単体の予測力だけでなく、既存予測への追加貢献を見る | 相関の壁 $\rho\sigma^2$、束ねたICの上限 $c/\sqrt{\rho}$ と、追加貢献を測るMMC | 4.2〜4.3・5.3 |
| 原則3:予測力と追加貢献の劣化を、分けて監視する | 特徴量の非定常性、群衆の同質化によるMMCの目減り、2023年の共通の誤差 | 7.4節・第8章 |
| 原則4:モデル名ではなく、予測と損益の違いで分散を確かめる | モデル数より相関が効くというアンサンブルの分散式と、相関が生まれる原因 | 4.2〜4.4 |
| 原則5:検証と資金配分を分け、事前の基準で段階的に進める | Live OOSでの評価と、予測と運用を分けるポートフォリオ構築、レバレッジの扱い | 5.1・第6章・7.1節 |
そのうえで、今回の記事から付け加えたい「6つ目」がある。
原則6(今回の追加):評価の仕組みそのものも、仮説として反証する
Numeraiは参加者のモデルを未来で検証するだけでなく、True Contribution → MMC、約20営業日 → 約60営業日のターゲットのように、評価関数そのものを結果を見て作り直してきた(第5章・第7章)。
個人の研究でも同じことが言える。採否の基準、検証期間、使っている指標が本当に「未来で効く戦略」を選べているのかを、定期的に見直す。研究プロセス自体を、反証と改善の対象にするのである。
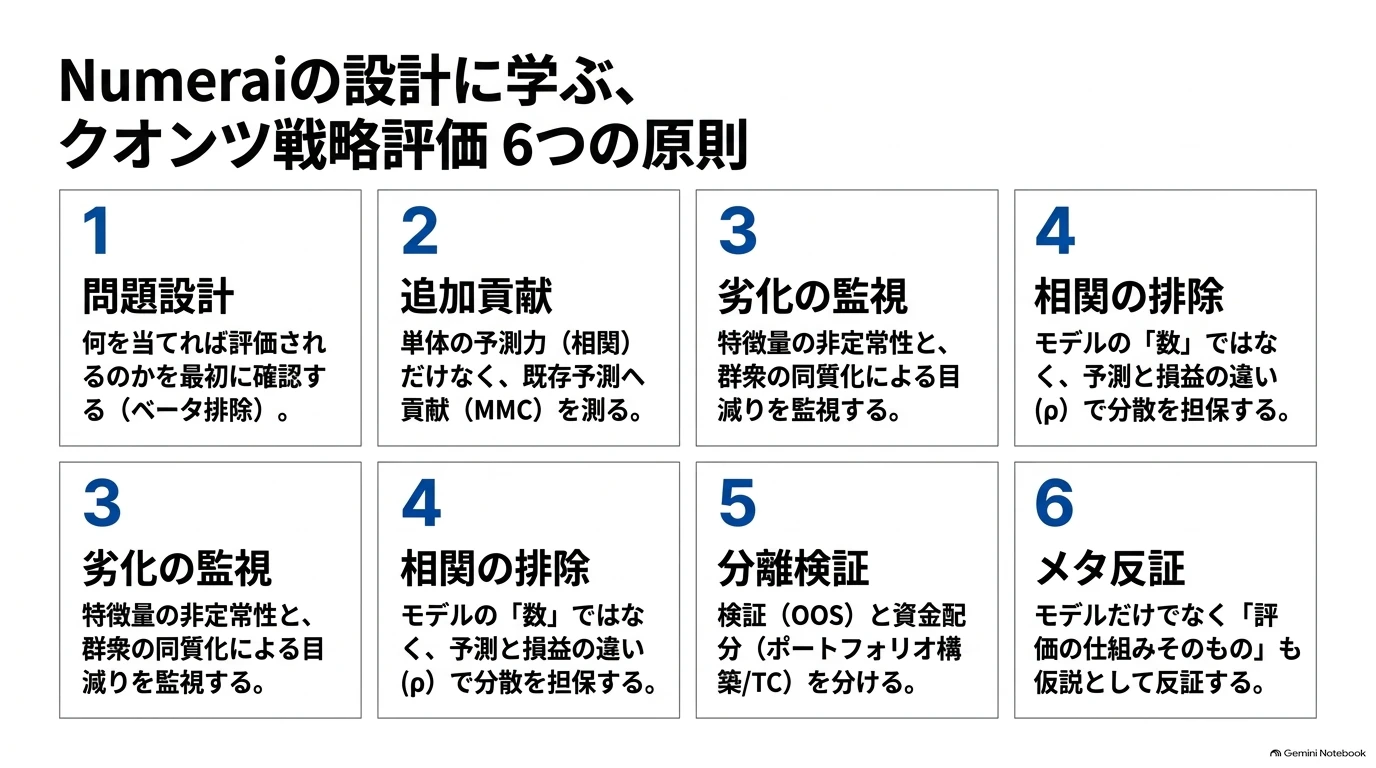
前回の5原則に原則6を加えた6つを、1枚にまとめた。新しい戦略を作ったとき、あるいは自分の研究プロセスを見直すときのチェックリストとして使ってほしい。
バックテストの過剰最適化をどう見抜くかについては、以前の記事で詳しく扱った。
最高の戦略を探すより、仮説を反証し続けられる研究プロセスを作る。
おわりに
最後に、この記事の結論を1枚にまとめる。
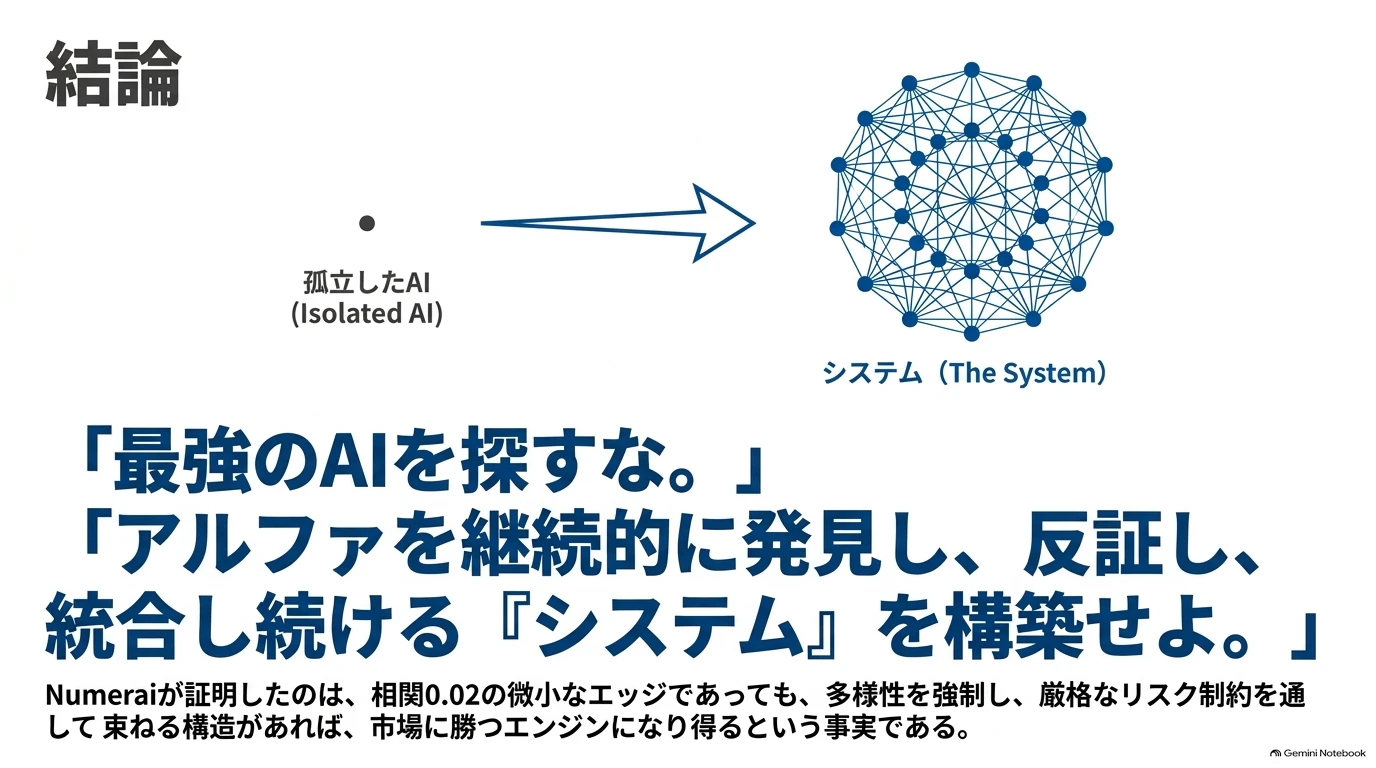
左の点は、1つの最強モデルに頼る「孤立したAI」。右の網は、たくさんの小さなアルファがつながり、検証され、束ねられる「システム」である。
前回は「当てる」だけでは足りない、という話をした。今回はその先にある、「当てたものをどう束ね、どう投資に変えるか」の話である。
Numeraiが示しているのは、「AIなら市場を予測できる」という単純な話ではない。一つひとつの予測力は小さく、不安定で、失敗もする。実際、Numeraiにも大きく負けた年があった。それでも、異なるアルファを大量に探し、未来のデータで検証し、重複を取り除き、ポートフォリオとして統合する仕組みを作れば、単一モデルより頑健な運用に近づける可能性がある。そしてNumeraiは、その仕組みの評価方法そのものも作り直し続けている。
クオンツにとって重要なのは、最高のモデルを一度見つけることではない。アルファを継続的に発見し、反証し、入れ替え続けられる研究システムを作ることなのだと、筆者は考えている。
本記事は情報提供を目的としたもので、投資助言ではない。NMRのステーキングやNumeraiへの参加は、各自の判断と責任で行っていただきたい。
参考文献
-
Numerai Blog – JPMorgan Secures $500m Capacity in Numerai Following Breakthrough Year. https://blog.numer.ai/jpmorgan-secures-500m-capacity/ ↩ ↩2 ↩3 ↩4
-
Hedgeweek (2025年8月). Quant hedge fund Numerai secures $500m JPMorgan allocation(2023年 −17%、2024年 +25%、2025年 約+6%、「運用開始以来、負けたのは1年だけ」、ミレニアムとの比較). https://www.hedgeweek.com/quant-hedge-fund-numerai-secures-500m-jpmorgan-allocation/ ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Numerai Docs – Getting Started. https://docs.numer.ai/ ↩ ↩2 ↩3 ↩4
-
Numerai Blog – NumerCon 2026: Genesis to Singularity. https://blog.numer.ai/numercon-2026-genesis-to-singularity/ ↩
-
Numerai Docs – Submissions(毎日のラウンド、約3か月の採点期間、重なり合うラウンド). https://docs.numer.ai/numerai-tournament/submissions ↩
-
Numerai (2022). Numerai Outperforms Market Neutral Hedge Funds by 26%, Raises Up To $150m(2021年12月末までの成績、リターンの80%超が銘柄選択、レバレッジ5.5倍、2020年3月 −1.54%). https://medium.com/numerai/numerai-outperforms-market-neutral-hedge-funds-by-29-raises-up-to-150m-9df9a0ce642 ↩ ↩2 ↩3 ↩4
-
CoinDesk (2023年3月1日). Quant Fund Manager Numerai's Token Rises 9% on Report of Impressive Return(2022年 +20%、Bloomberg報道の引用). https://www.coindesk.com/business/2023/03/01/crypto-fund-manager-numerais-token-rises-nearly-9-amid-reports-of-impressive-returns ↩ ↩2 ↩3
-
Portfolio123 Community – Numerai 2023 Performance(二次情報). https://community.portfolio123.com/t/numerai-2023-performance/65670 ↩
-
Numerai Blog – Numerai Raises $30M Series C At $500M Valuation(2025年11月20日). https://blog.numer.ai/numerai-raises-30m-series-c-at-500m-valuation/ ↩
-
Numerai Blog – Monthly Update(AUM約7億ドル). https://blog.numer.ai/numerai-monthly-nmr-buyback-quantum-dataset-atomic-blockchain-staking/ ↩
-
Numerai Docs – Data. https://docs.numer.ai/numerai-tournament/data ↩ ↩2 ↩3 ↩4 ↩5
-
Numerai Docs – Correlation (CORR). https://docs.numer.ai/numerai-tournament/scoring/correlation-corr ↩
-
Grinold, R. C. (1989). The Fundamental Law of Active Management. The Journal of Portfolio Management, 15(3), 30–37. https://doi.org/10.3905/jpm.1989.409211 ↩
-
Numerai Docs – Office Hours with Arbitrage(「数週間ではなく数か月」、連続ラウンドは実質同じ賭け). https://docs.numer.ai/community/office-hours-with-arbitrage ↩ ↩2 ↩3
-
Numerai Docs – Meta Model Contribution (MMC). https://docs.numer.ai/numerai-tournament/scoring/meta-model-contribution-mmc ↩ ↩2
-
Numerai Docs – Staking. https://docs.numer.ai/numerai-tournament/staking ↩ ↩2
-
Numerai Docs – Scoring Definitions(round 1343以降の SEASON = 3×CORR + 15×MMC、それ以前の 0.75×CORR + 2.25×MMC). https://docs.numer.ai/numerai-tournament/scoring/definitions ↩ ↩2
-
Numerai Blog – Monthly Update(2026年8月28日以降のラウンドから60日Enderターゲットと Atomic Blockchain Staking へ移行). https://blog.numer.ai/numerai-monthly-new-signals-dataset-atomic-blockchain-staking-deai-day-events/ ↩ ↩2 ↩3
-
Numerai Forum – True Contribution Details. https://forum.numer.ai/t/true-contribution-details/5128 ↩ ↩2
-
Numerai Forum – MMC staking starts Jan 2, 2024(2023年11月28日). https://forum.numer.ai/t/mmc-staking-starts-jan-2-2024/6827 ↩ ↩2 ↩3
-
旧方式では
payout = stake × clip(payout_factor × score, -0.05, 0.05)のように1ラウンドあたりの損益が±5%に制限され、総Stake量に応じてpayout_factorが調整されていた。Atomic Blockchain Stakingではこの上限やラウンド間の重複レバレッジの扱いが変わっている。詳細は Staking のドキュメントを参照。 ↩ -
Clarke, R., de Silva, H., & Thorley, S. (2002). Portfolio Constraints and the Fundamental Law of Active Management. Financial Analysts Journal, 58(5), 48–66. https://www.tandfonline.com/doi/abs/10.2469/faj.v58.n5.2468 ↩
-
Craib, R. (2019). Achieving Meta Model Supremacy At Numerai(シミュレーション。実運用を代表しないと明記されている). https://medium.com/numerai/achieving-meta-model-supremacy-at-numerai-9ca3abeef98a ↩ ↩2
-
Bloomberg – Quant Trading Platform Quantopian Closes Down (2020). https://www.bloomberg.com/news/articles/2020-12-16/quant-trading-platform-quantopian-closes-down ↩
-
Flirting with Models (2026年2月23日). Richard Craib – Crowd-Sourced Alpha with Numerai (S7E28)(章「Learning from the 2023 drawdown and risk system enhancements」). https://www.flirtingwithmodels.com/episodes/crHT0L3PMHT ↩