

はじめに
社内向け RAG を Amazon Bedrock ナレッジベースで作ると、ほぼ必ず「人事部の資料は人事部だけ、営業資料は営業部だけに見せたい」という要件が出てきます。社員の ID 基盤が Microsoft Entra ID なら、そこに登録された部署(department 属性)をキーに検索範囲を絞りたくなります。
この記事では、Entra ID の部署情報を使って Bedrock ナレッジベースの検索結果を部署ごとに絞り込む方法を、3つの実装パターンに分けて整理します。どのパターンにも共通する「部署情報をどこから、どう信頼して取るか」という前提と、運用でハマりやすい点もあわせて解説します。
結論:部署と文書の対応は3つのパターンから選ぶ
ナレッジベース自体は Entra ID を直接参照しません。アプリ側でユーザーの部署を確定し、それを検索リクエストに反映させる、という構造はどのパターンでも同じです。違いは「部署と文書の対応関係をどこで持つか」です。
| パターン | 部署と文書の対応をどこで持つか | 向いているケース | 主な注意点 |
|---|---|---|---|
| A. メタデータフィルタリング | 文書ごとの .metadata.json に部署名を書き、検索時にアプリがフィルタを強制 |
S3 に文書を置く一般的な構成。部署数が多すぎない | フィルタはアプリが付け忘れると全件検索になる |
| B. マネージド KB の ACL 対応検索 + SharePoint | SharePoint の権限(Entra のグループ)をそのまま使い、検索時はメールアドレスを渡すだけ | 文書がもともと SharePoint にあり、権限管理も SharePoint でやっている | ユーザーは常にメールで識別。S3/カスタムでは ACL が USER 単位のみ |
| C. 部署ごとにナレッジベースを分ける | ナレッジベース(とデータソース)を部署単位で分割し、アプリが呼び先を選ぶ | 部署数が少なく、混在を絶対に避けたい | 部署横断の検索や共通文書の扱いが面倒。コストと運用対象が増える |
迷ったら、文書が S3 にあるならパターン A、SharePoint にあるならパターン B から検討する感じ。
実際、SharePoint採用ならAzureに寄せると思うので、AWSならパターンAかパターンCですかね。
前提:部署情報はサーバー側で、検証済みのトークンから取る
どのパターンでも、部署はブラウザから送られてきた値ではなく、バックエンドが検証した Entra ID のトークン(または Graph API の応答)から取ります。Bedrock ナレッジベースのドキュメント自身が、ACL 機能は認可ではなくフィルタであり、渡されたユーザー情報が本物かどうかは検証しないと明記しています。つまり「誰として検索するか」をナレッジベースの外側で担保しないと、いずれのパターンも違う部署の情報にアクセスできてしまいます。
ユーザの部署情報を取る方法は3つ
-
ID トークンに
departmentクレームを載せる:Entra ID の department は標準ではトークンに入らないため、Entra 側でクレームを追加します。設定方法は2つあります。-
管理センターの画面から:Microsoft Entra 管理センターで「Entra ID」→「エンタープライズ アプリ」→ 対象アプリ →「シングル サインオン」→「属性とクレーム」を編集し、ソースが
user.departmentのクレームを追加します。作業には少なくとも「クラウド アプリケーション管理者」ロールが必要です。 -
クレームマッピングポリシーで:
New-MgPolicyClaimMappingPolicyでポリシーを作り、New-MgServicePrincipalClaimMappingPolicyByRefでサービスプリンシパルに割り当てます(アプリ登録ではない点に注意)。ポリシーを割り当てると、画面からはクレームを編集できなくなります。 -
アプリ側で「改変されたトークン」を受け入れる設定が必須:これをしないと AADSTS50146 エラーでサインインできません。シングルテナントのアプリはマニフェストの
acceptMappedClaimsをtrueにします(トークンの audience がアプリ自身の ID か検証済みドメインである必要あり)。マルチテナントのアプリはカスタム署名キーを設定し、トークン検証時はメタデータ URL に?appid={client-id}を付けて鍵を取得します。
-
管理センターの画面から:Microsoft Entra 管理センターで「Entra ID」→「エンタープライズ アプリ」→ 対象アプリ →「シングル サインオン」→「属性とクレーム」を編集し、ソースが
-
Microsoft Graph API で取る:サインイン後に
GET /me?$select=department,mailを呼びます。トークン設定をいじらずに済み、部署変更も次回呼び出しで反映されます。 -
IAM Identity Center の Identity Store から取る(SCIM 同期):Entra ID から IAM Identity Center に SCIM でユーザーを同期していれば、department も enterprise 拡張属性として同期されます。バックエンドは
identitystore:GetUserIdでメールアドレスからユーザー ID を引き、DescribeUserにExtensions: ["aws:identitystore:enterprise"]を付けて呼ぶと department が返ります。IAM 権限だけで呼べ、Microsoft 側のアプリ権限は不要です。
| 取り方 | 鮮度 | 必要な準備 | 向いているケース |
|---|---|---|---|
| ID トークンのクレーム | サインイン時点 | クレームマッピングポリシー | 最もシンプルにしたい |
| Graph API | 呼び出し時点 | Graph の User.Read など |
Entra 中心の構成。兼務などグループ情報も使いたい |
| Identity Store API(SCIM 同期) | 同期間隔ぶん遅れる | Identity Center + SCIM、IAM 権限 | Identity Center をすでに運用している。AWS 側の ID に揃えたい |
Entra ID でサインインする自前アプリでは、1 か 2 が一般的です。個人的には手を加える範囲がAWSに寄せられる3が良いのですが、3 を選ぶ場合は、SCIM の挙動に注意してください。Entra のプロビジョニングは定期実行のため、異動の反映が遅れます。また、Entra ID で department を空にしても Identity Center 側の値は削除されず、ネストしたグループのメンバーも同期されません。
部署名の表記ゆれ(「営業部」と「営業本部」など)は、そのままメタデータの不一致になります。Entra ID 側の値を正とし、文書側のメタデータもその値に揃える必要があります。
バックエンドの最小構成
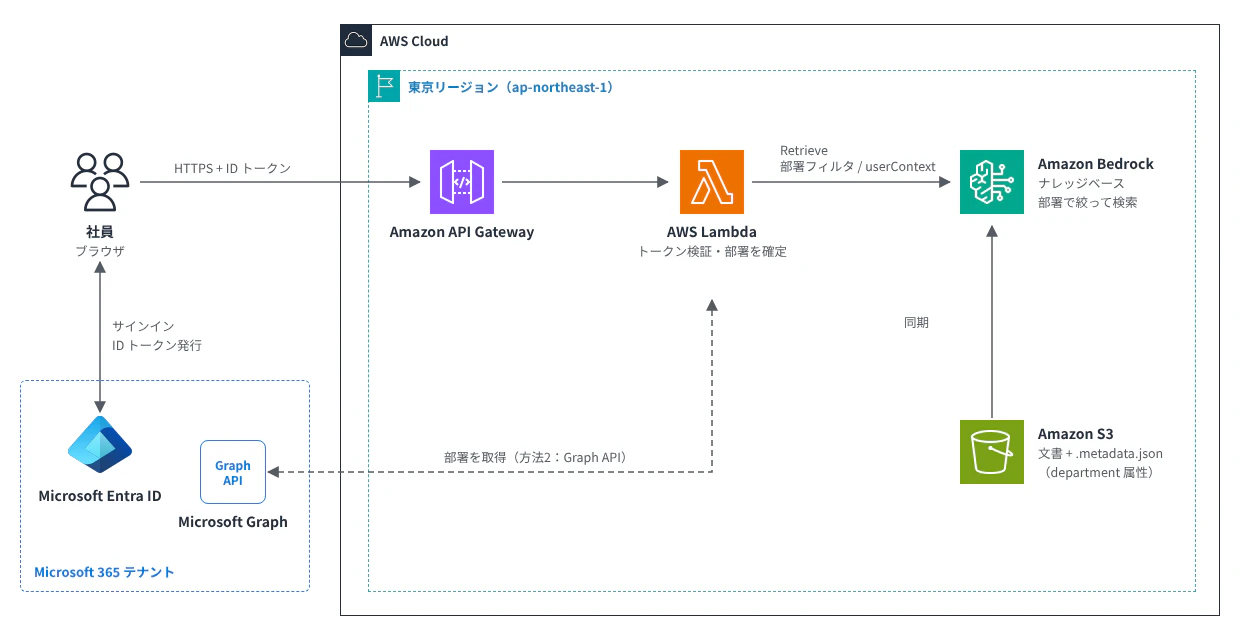
- フロントエンドは Bedrock を直接呼ばない。Retrieve 権限を持つ IAM ロールはバックエンドだけに付ける
- バックエンドはトークンの署名・発行者・audience を検証してから、部署やメールアドレスを取り出す
- 検索条件(フィルタや userContext)はバックエンドがコードで組み立て、クライアントからの値で上書きさせない
ブラウザが持ってくるのはトークンだけで、部署の確定と検索条件の組み立てはすべてバックエンド(図では API Gateway + Lambda)の中で完結させます。図はパターン A(S3 + メタデータ)の例です。
パターンA:メタデータフィルタリング
文書に部署名のメタデータを付け、検索のたびにバックエンドが「この部署の文書だけ」というフィルタを強制する方法です。AWS 公式ブログでも、メタデータフィルタをアクセス制御に使う構成が紹介されています(認証は Amazon Cognito の例)。
1. 文書にメタデータを付ける
S3 データソースでは、文書と同じ場所に ファイル名.拡張子.metadata.json を置きます。たとえば sales/price-list.pdf なら sales/price-list.pdf.metadata.json です。
{
  "metadataAttributes": {
    "department": "営業部"
  }
}
全社公開の文書には "department": "全社" のような共通値を付けておきます。メタデータを追加・変更したらデータソースの同期が必要です。
数万ファイル規模では metadata.json を自動生成する
文書が数万件になると、.metadata.json を手で書くのは現実的ではありません。部署ごとにプレフィックス(sales/、hr/ など)を分けて文書を置き、S3 のアップロードイベントで Lambda を動かして、パスから部署を判定した metadata.json を書き出します。人が管理するのはフォルダだけになります。
import json, urllib.parse, boto3

s3 = boto3.client("s3")
DEPT_BY_PREFIX = {"sales/": "営業部", "hr/": "人事部", "common/": "全社"}

def handler(event, context):
    for r in event["Records"]:
        bucket = r["s3"]["bucket"]["name"]
        key = urllib.parse.unquote_plus(r["s3"]["object"]["key"])
        if key.endswith(".metadata.json"):
            continue  # 自分が書いたファイルで再発火しないように
        dept = next((d for p, d in DEPT_BY_PREFIX.items() if key.startswith(p)), None)
        if dept is None:
            continue  # 部署不明の文書にはメタデータを付けない
        s3.put_object(
            Bucket=bucket,
            Key=f"{key}.metadata.json",
            Body=json.dumps({"metadataAttributes": {"department": dept}}, ensure_ascii=False),
            ContentType="application/json",
        )
- 部署不明の文書:metadata.json のない文書は、部署フィルタ付きの検索では誰にも返されません。安全側に倒れますが、定期的に「メタデータなし」の文書を洗い出してください
- 部署名の変更は重い:部署名やフォルダ構成を変えると、配下の metadata.json をすべて書き直して再同期する必要があります。値には表示名より変わりにくい部署コードを使うのがおすすめです
- サイズ上限:metadata.json は1ファイル 10 KB までです
文書を取り込むパイプラインを自前で持っているなら、カスタムデータソースの IngestKnowledgeBaseDocuments で、文書と一緒に部署をインライン属性として渡す方法もあります。サイドカーファイルが不要になり、部署は元の文書管理システムから引いて渡せます。
なお、1つのナレッジベースに部署ごとのデータソース(取り込み対象プレフィックスを部署ごとに指定)を作り、データソース ID で絞る方法も考えられます。ただしこのフィルタが効かなかったという報告が AWS re:Post にあり、公式ドキュメントでも動作を確認できなかったため、部署の分離に使うなら事前の検証が必須です。
2. 検索時にフィルタを強制する
バックエンドで、トークンから取った部署と「全社」の OR 条件を組み立てて Retrieve に渡します。
import boto3

client = boto3.client("bedrock-agent-runtime", region_name="ap-northeast-1")
KB_ID = "XXXXXXXXXX"

def retrieve_for_user(query: str, department: str):
    if not department:
        # 部署が取れないユーザーはフィルタなしで検索させない
        raise PermissionError("department is required")

    dept_filter = {
        "orAll": [
            {"equals": {"key": "department", "value": department}},
            {"equals": {"key": "department", "value": "全社"}},
        ]
    }

    return client.retrieve(
        knowledgeBaseId=KB_ID,
        retrievalQuery={"text": query},
        retrievalConfiguration={
            "vectorSearchConfiguration": {
                "numberOfResults": 5,
                "filter": dept_filter,
            }
        },
    )
RetrieveAndGenerate を使う場合も、retrieveAndGenerateConfiguration.knowledgeBaseConfiguration.retrievalConfiguration に同じフィルタを入れます。
3. 1つの文書を複数部署に見せたいとき
部署をリスト型の属性(例:"departments": ["営業部", "経営企画部"])で持ち、listContains で「ユーザーの部署を含む文書」を引く方法があります。ただし listContains や in は、ドキュメント上「Amazon OpenSearch Serverless で最もよくサポートされている」という扱いです。ベクトルストアに S3 Vectors や Aurora を使う場合は、事前に動作を確認してください。
このパターンの注意点
-
equals/orAllは多くのベクトルストアで使えますが、OpenSearch Serverless のインデックスがnmslibエンジンだとメタデータフィルタが使えません。faissで作り直す必要があります - マネージド KB では
startsWithとstringContainsは非対応です - 「暗黙的フィルタ(implicitFilterConfiguration)」はモデルが質問文からフィルタを生成する機能です。ユーザーの入力に左右されるため、アクセス制御には使わないでください
- 部署の異動はトークン/Graph 側で即時反映されますが、文書側の部署変更は同期が終わるまで反映されません
パターンB:マネージド KB の ACL 対応検索 + SharePoint
マネージド型のナレッジベース(ドキュメント上の名称は Bedrock Managed Knowledge Base)には、データソース側の権限を取り込んで検索結果を絞る「ACL 対応検索」があります。SharePoint コネクタは Entra ID のセキュリティグループも解決できるため、「部署 = Entra のグループ」にしてしまえば、部署単位の制御を SharePoint の権限設定に任せられます。
構成の流れ
-
部署ごとの動的グループを作る:Entra ID の動的メンバーシップルールで、
(user.department -eq "営業部")のように department 属性からグループを自動生成します。動的グループには Entra ID P1 以上のライセンスが必要です。 - SharePoint の権限をグループに付ける:部署サイトやライブラリのアクセス権を、手順1のグループに付与します。
-
データソースで ACL を有効化する:SharePoint データソースを作成し、ACL を有効にします。ACL を使うには認証方式を証明書ベースの
ENTRA_ID_APP_ONLYにする必要があります(ユーザー委任型のセットアップでは ACL 非対応)。 -
検索時にユーザーのメールアドレスを渡す:Retrieve リクエストに
userContextを付けます。
resp = client.retrieve(
    knowledgeBaseId=KB_ID,
    retrievalQuery={"text": query},
    userContext={"userId": user_email},  # 検証済みトークンから取ったメール
)
この方式で知っておくべき挙動
- 2段階で絞り込む:同期時に取り込んだ ACL で事前フィルタし、さらに返却候補ごとに SharePoint へ問い合わせて現在の権限をリアルタイムに確認します。異動直後でも、権限を外せば同期を待たずに見えなくなります
-
ユーザーは常にメールで識別:
userIdはデータソース側のメールアドレスと完全一致が必要で、別名の解決はされません。UPN とメールが異なるテナントでは要注意です -
フェイルクローズ:
userContextなしの検索、ACL のない文書、グループ解決の失敗などはすべて「返さない」側に倒れます。ACL のある文書が 0 件になったら、まずメールの不一致を疑ってください -
件数が減ることがある:リアルタイム確認で除外された分は補充されないため、
numberOfResultsより少ない結果が返ることがあります - 大きなグループは反映に時間がかかる:同期完了後もしばらく見えない場合があります
S3 やカスタムデータソースではどうか
S3 とカスタムデータソースにも ACL 機能はありますが、ACL のエントリは Type: USER(メールアドレス単位)しか指定できず、リアルタイム確認もありません。部署で制御するには、取り込み時に「部署 → 所属メンバーのメール一覧」へ展開して書き込み、異動のたびに再同期する必要があります。S3 の文書を部署単位で絞るなら、パターン A の方が素直です。
確認できなかった点
userContext について、公式ドキュメントで確認できたのは Retrieve API での使い方です。RetrieveAndGenerate で同じように使えるかは確認できていないため、確実にやるなら Retrieve で取得した結果を自前でモデルに渡す構成にしてください。SDK のバージョンが古いと userContext パラメータ自体が使えない可能性もあります。
パターンC:部署ごとにナレッジベースを分ける
最も単純で、混在事故が起きにくいのが「部署ごとに別のナレッジベースを作る」方法です。バックエンドはトークンの部署を見て、呼び出す knowledgeBaseId を切り替えるだけです。
KB_BY_DEPT = {
    "営業部": "KBSALES000",
    "人事部": "KBHR000000",
}

kb_id = KB_BY_DEPT.get(department)
if kb_id is None:
    raise PermissionError("no knowledge base for this department")
さらに IAM ポリシーで、部署ごとのアプリやロールが呼べるナレッジベースの ARN を限定すれば、アプリのバグがあっても他部署の KB は呼べなくなります。
一方で、部署が増えるたびに KB・データソース・ベクトルインデックスが増え、コストと運用対象も比例して増えます。全社共通文書は各 KB に重複して入れるか、共通 KB を別に作って2回検索して結果をまとめる必要があります。部署数が数個程度で、情報の分離を最優先する場合に向いた方法です。
ハマりどころとセキュリティ上の注意
- フィルタは「付け忘れ = 全件公開」:パターン A ではフィルタなしの Retrieve がそのまま全文書検索になります。Retrieve の呼び出しを1つの関数に集約し、”部署が空なら例外にする”をコードで強制してください
- クライアントの値を信じない:部署やメールをリクエストボディやヘッダーで受け取る実装は、改ざんで他部署の検索ができてしまいます。必ず検証済みトークンか Graph API から取ります
- 兼務・複数部署:Entra ID の department は単一の文字列です。兼務を表したい場合は、グループ所属(groups クレームや Graph の memberOf)を使う設計を検討してください
- 部署名の変更:組織改編で部署名が変わると、文書側のメタデータや動的グループのルールも直す必要があります。表示名ではなく変わりにくいコード値(部署コードなど)を Entra の拡張属性に持たせると楽になります
- 回答文にも注意:フィルタは検索結果を絞るだけです。会話履歴やエージェントのツール経由で別部署の情報が混ざらないよう、セッションをユーザー単位で分けてください
- テストは「見えないこと」を確認する:自部署の文書が出ることだけでなく、他部署ユーザーで同じ質問をして出ないことをテストケースに入れます
まとめ
Bedrock ナレッジベースで Entra ID の部署ごとに情報を絞るには、バックエンドが検証済みトークンから部署を確定し、それを検索リクエストに必ず反映させる仕組みが土台になります。そのうえで、文書が S3 ならメタデータフィルタ(パターン A)、SharePoint なら ACL 対応検索と部署の動的グループ(パターン B)、分離を最優先するなら KB の分割(パターン C)を選ぶ流れです。
個人的にはパターンAだと力技な感じが否めないので、メタデータフィルタでもっとスマートに管理する方法を模索したいのと、SCIM同期を活用する道も探りたいです。
参考資料
- Access Control Lists awareness enablement(Amazon Bedrock ユーザーガイド)
- ACL-aware retrieval on managed knowledge bases
- Document-level access controls(S3 データソース)
- Document-level access controls(カスタムデータソース)
- Document-level access controls(SharePoint)
- Configure and customize queries and response generation(メタデータフィルタ)
- Access control for vector stores using metadata filtering with Amazon Bedrock Knowledge Bases(AWS ブログ)
- Customize tokens(Microsoft Learn)
- department クレームをクレームマッピングポリシーで出す例(Microsoft Q&A)
- Configure SAML and SCIM with Microsoft Entra ID and IAM Identity Center
- DescribeUser(Identity Store API Reference)
- Attribute mappings(IAM Identity Center)
- Customize claims issued in the JSON web token (JWT) for enterprise applications(Microsoft Learn)
- Customize claims using PowerShell(Microsoft Learn)