
AIに質問すれば、いつでも同じように「調べて」答えてくれる。
そう見えることがありますが、実際には、外部検索を使わない応答、検索結果を参照する応答、調査を繰り返す仕組みでは、情報の集め方が異なります。
「AIの取扱説明書」シリーズの最終回では、答えの作り方ではなく、情報の調べ方に注目します。
今回扱うテーマは次の6つです。
- Single-Turn Generation(単発生成)
- ReAct(推論と行動の反復)
- Multi-hop Retrieval(マルチホップ検索)
- Context Management / Long-Horizon Memory(文脈管理と長期メモリ)
- Architecture Comparison(アーキテクチャ比較)
- RL Optimization(強化学習によるエージェント最適化)
これまでの記事はこちらです。
1. 「知っているだけ」では答えられない質問がある ― Single-Turn Generation
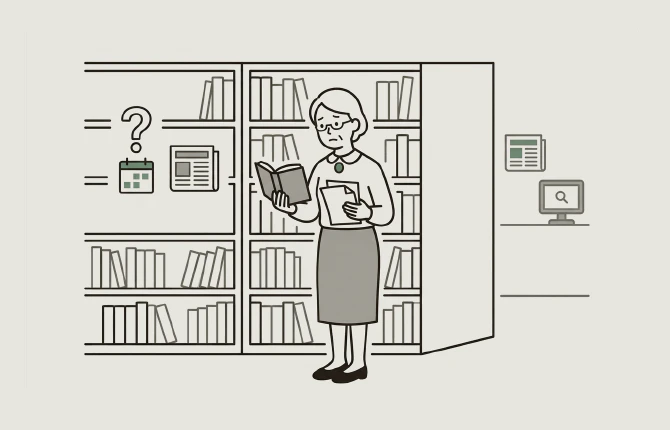
外部検索を使わない応答では、モデルが学習した情報と、その場で入力された文章や資料が主な手がかりになります。
書庫の奥にいる図書館員が、記憶と手元の本だけで質問に答えるようなものです。流暢に説明できても、新聞や新しい資料を確認しに行かなければ、古い情報や不足した情報をもとに答える可能性があります。
これは、外部検索を使わない応答が劣っているという意味ではありません。与えた文章の整理、下書き、言い換え、既知の内容を使ったアイデア出しなど、検索を必要としない作業には向いています。
実務での見方
- 最新情報、価格、制度、製品仕様、人物情報などは、外部情報を確認する
- 渡した資料だけを使わせたい場合は、その範囲を明示する
- 資料にない内容を補っていないか、回答の根拠を確認する
- 「知識として答えた部分」と「入力資料に基づく部分」を分けて示させる
入力にない最新情報が必要なら、生成の工夫だけではなく検索が必要です。
2. 「考えて、調べて、結果を読む」を繰り返す ― ReAct
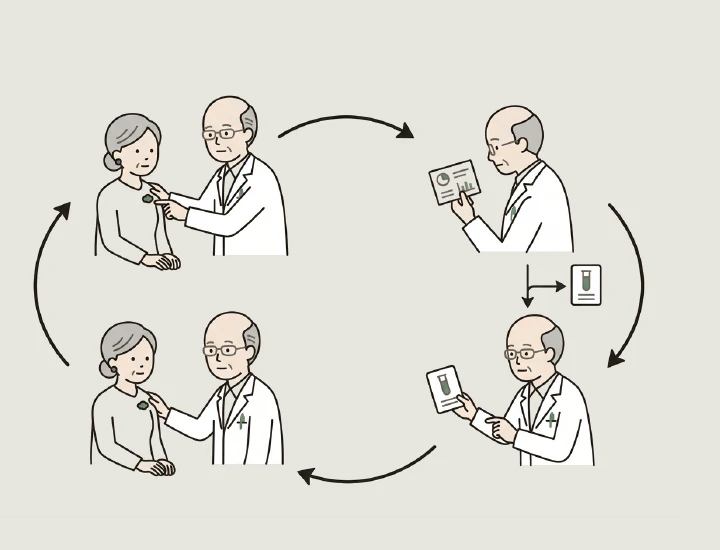
調査型AIには、状況を整理し、検索やツール操作を行い、その結果を見て次の行動を決める設計があります。
医師が患者を診察し、検査を行い、その結果を見て次の検査を決める流れに似ています。最初からすべての手順を固定するのではなく、途中で得られた情報によって進め方を変えます。
ReAct は、推論と行動を交互に進める代表的な考え方です。Yaoらの研究では、言語モデルが推論の記録と、外部環境に対する行動を組み合わせる方法が示されました。
ただし、すべての調査型AI製品がReActをそのまま実装しているわけではありません。製品の画面が似ていても、内部の計画方法、検索方法、利用できるツールは異なります。
実務での見方
- 途中経過を確認できる場合は、検索方針が依頼とずれていないかを見る
- 調査の目的、対象期間、地域、優先する情報源を最初に伝える
- 不要な方向へ進んだ場合は、完了を待たずに条件を修正する
- 最終回答だけでなく、どの資料をどう使ったかを確認する
調査型AIの価値は、検索回数の多さではなく、結果を読んで次の行動を変えられることにあります。
3. 調べながら「次に何を調べるか」を決める ― Multi-hop Retrieval
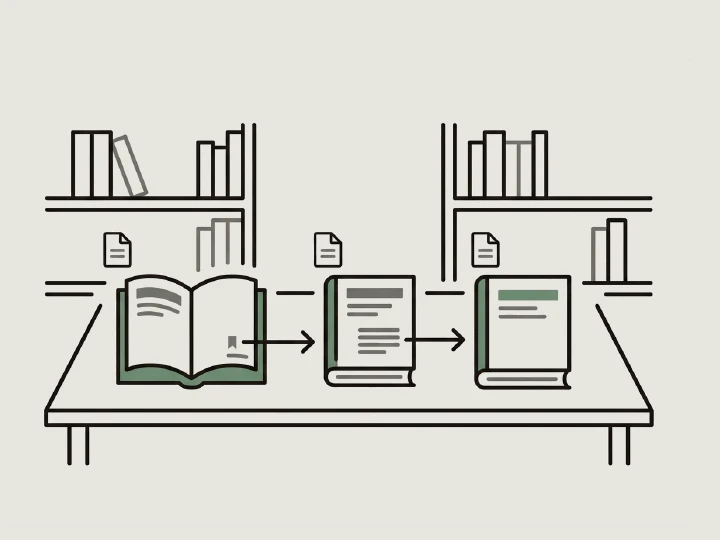
単純な検索付き応答では、取得した検索結果を使って回答を作ります。一方、反復型RAGや調査エージェントでは、見つかった手がかりをもとに、追加の検索を行う場合があります。
図書館で一冊の本の脚注から別の本を探し、その本の参考文献から元資料へたどるような調べ方です。最初の検索語では見つからなかった情報に、人物名、論文名、制度名などを手がかりにして近づけます。
ここで注意したいのは、検索結果の件数と、独立した裏づけの数は同じではないことです。複数のページが同じ発表や記事を書き写しているだけなら、根拠が増えたとは限りません。
実務での見方
- 二次情報から、可能な限り一次資料や原典へたどる
- 複数の記事が同じ出典に依存していないか確認する
- 検索結果にない反対意見や例外条件も探す
- 件数ではなく、出典の独立性と主張を支える範囲を見る
「たくさん見つかった」と「確かめられた」は別です。
4. 長い調査では「途中の記録」の管理が重要 ― Context Management / Long-Horizon Memory
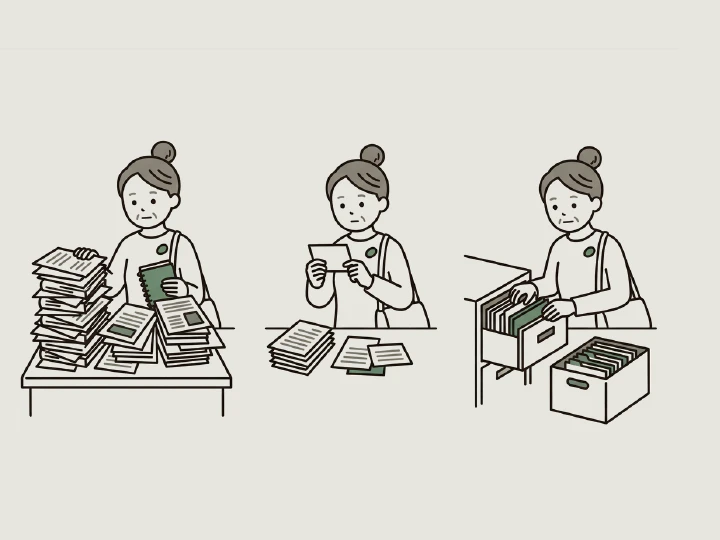
長い調査では、検索結果、読んだ資料、途中の判断、未解決の疑問が増え続けます。しかし、AIが一度に扱える情報量には、実装上の上限やコストがあります。
長期取材を続ける記者が、増えすぎたメモをすべて持ち歩けず、要点を書き写したり、資料庫へ預けたりするようなものです。
そのため、調査型AIでは、履歴を要約・圧縮する、外部へ保存する、必要な部分だけを再取得するといった文脈管理が使われます。
一方、圧縮しすぎると、例外条件、数値の前提、反対証拠などが落ちる可能性があります。要約や外部メモリを使えば、必ず完全に記憶できるわけではありません。
実務での見方
- 長い調査は論点ごとに区切り、途中成果を保存する
- 重要な数値、引用、URL、ページ番号は要約とは別に残す
- 最終報告で重要になった根拠を、元資料へ戻って再確認する
- 調査を再開するときは、前回の要約だけでなく未解決事項も渡す
長期メモリの有無だけでなく、何を残し、何を圧縮し、どう取り出すかが結果に影響します。
5. 処理方式による違い ― アーキテクチャ比較
宿題の調べ方に例えると、次の3つに整理できます。
- 教科書と手元の資料だけで書く
- 分からない語句を検索して書く
- テーマ全体について資料をたどり、比較しながらレポートをまとめる
| 観点 | 外部検索を使わない応答 | 単純な検索付き応答 | 反復的な調査 |
|---|---|---|---|
| 主な手がかり | 学習済みの情報と入力資料 | 検索した資料も参照 | 検索結果を見て追加調査 |
| 進め方 | 与えられた情報から回答を生成 | 検索結果から回答を生成 | 計画・検索・確認・整理を反復 |
| 向く場面 | 下書き、与えた文章の整理 | 限定した事実の確認 | 複数資料の比較、調査報告 |
| 気をつける点 | 必要な情報が入力にない | 検索漏れ、出典の誤読 | 誤りの連鎖、時間・費用、調査漏れ |
これは概念上の比較であり、製品のモード名と一対一に対応するものではありません。実際の製品は、検索、RAG、コード実行、ファイル処理、複数エージェントなどを組み合わせている場合があります。
また、複雑な仕組みほど常に優れているわけでもありません。Anthropicの技術解説でも、まず単純な方法から始め、性能上の改善が確認できる場合にだけ複雑さを増す考え方が示されています。
使い分けの目安
- 外部検索なし:文章の整理、下書き、形式変換、入力資料内の要約
- 検索付き応答:現在の仕様、限定した事実、公式情報の確認
- 反復的な調査:複数資料の比較、論点整理、長い調査報告
必要な正確さ、調査範囲、時間、費用に合わせて選ぶことが大切です。
6. 「どう調べるか」自体を学習する ― RL Optimization
検索するか、どの検索語を使うか、得られた結果を読んで推論を続けるか。このような行動の選び方自体を、最終回答の成否から強化学習で最適化する研究があります。
地図を持たずに慣れない街を歩き、行き止まりに当たるたびに戻りながら、目的地へ着きやすい道を学んでいくようなものです。
Search-R1では、モデルが推論の途中で複数回の検索クエリを生成し、検索結果を使いながら回答する方法を、結果に基づく報酬で学習させました。
ただし、最終回答が正解と一致したことは、「必要な資料をすべて調べた」「引用がすべて正しい」「重要な反対証拠を見落としていない」ことまでは保証しません。
実務での見方
- 正解率と、調査過程の完全性を分けて評価する
- 回答が正しくても、根拠と引用の対応を確認する
- 検索の停止条件が適切かを見る
- 時間や費用を増やしたとき、品質が実際に改善したか測る
調べ方を学習できても、調査の完全性や結論の妥当性には、人による確認が残ります。
調査型AIを使うときの確認ポイント
調査型AIは、短時間で多くの情報を集め、整理する強力な道具です。一方で、出典が多いことや、報告書が整っていることだけでは、結論の正しさは保証されません。
実務では、次の点を確認するとよいでしょう。
- 調査対象、期間、地域、除外条件を明確にしたか
- 一次資料や公式情報へ戻ったか
- 複数のページが同じ情報源を写していないか
- 引用先の本文が、直前の主張を本当に支えているか
- 重要な反対証拠や例外条件を探したか
- 長い調査の途中で、重要な根拠が要約から落ちていないか
- 検索回数や処理時間が、品質向上につながっているか
調査型AIは、調査を終わらせる道具というより、人が確認すべき範囲を効率よく絞り込む道具として捉えると扱いやすくなります。
シリーズのまとめ ― AIと上手に付き合う5つの心得
最後に、全5章を通じた要点を5つに整理します。
-
重要な結論は出典に戻る
数字、引用、固有名詞を確認し、参照先が実在するだけでなく、その結論を支えているかを確かめる。 -
自分の結論に誘導しない
まず中立的に尋ね、反対の証拠や不確かな点も求める。反論を求めても、正確さが保証されるわけではない。 -
長い資料は原文を残して確認する
論点ごとに調べ、重要な主張はページや引用箇所と照合する。要約だけで例外や留保を判断しない。 -
実際に使う条件で評価する
公開スコアだけでなく、自分の業務の例で確かめる。モデルや設定が変わったら、重要な作業を再確認する。 -
操作の権限と実行内容を確認する
送信、削除、投稿などは対象と内容を確認し、AIに与える接続先や権限を必要な範囲に絞る。
AIを過信せず、かといって必要以上に恐れず、特徴を理解して確認しながら使う。本シリーズが、そのための判断材料になれば幸いです。
参考文献
- Huang, Y. et al., Deep Research Agents: A Systematic Examination And Roadmap, 2025.
- Wong, M. Y. H. et al., Deep Research Agents: Major Breakthrough or Incremental Progress for Medical AI?, Journal of Medical Internet Research, 2026.
- Yao, S. et al., ReAct: Synergizing Reasoning and Acting in Language Models, ICLR, 2023.
- Wu, Y. et al., ContextBudget: Budget-Aware Context Management for Long-Horizon Search Agents, 2026.
- Anthropic, Building Effective AI Agents, 2024.
- Jin, B. et al., Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning, 2025.
※ 本記事は、調査型AIに関する研究や技術解説をもとに、仕組みの違いを実務上の観点から整理したものです。製品ごとの名称、内部実装、検索範囲、利用できるツールは異なります。また、出典付きの回答でも、資料の取り違え、引用と主張の不一致、重要文献の見落としが起こる可能性があります。重要な結論では、引用先の本文と条件を確認してください。