
Claude Code の公式マーケットプレイスから、この作業場に合いそうなプラグインを 4 本入れました。pyright-lsp・typescript-lsp・security-guidance(v2.0.8)・hookify。入れた日に「何を捕まえたか」と「何を払ったか」を測って、2 本を外しました。外したのは security-guidance と hookify、残したのは LSP の 2 本です。製品レビューではなく、検査器を入れたその日に採算を数えた記録として書きます。読者が自分のプラグインに当てられる表を最後に置きます。
先に結論
- 判定の軸は 2 つ。検出価値(実際の欠陥を捕まえたか/わざと入れた毒を赤にできるか)と運用コスト(トークン・遅延・メモリ・設定と誤検知の保守)。
-
security-guidance(v2.0.8): 3 層構成(①regex のパターン警告 ②Stop 時の LLM diff レビュー ③commit 時の agentic レビュー)。測ったのは①と②で、③は評価していない。②はレビュー 1 回あたり固定プロンプト約 37 KB ≒ 10K トークン相当の上乗せ。編集ターンの総トークン量が当方の実測比で +12〜30%、大きな diff を含むターンではその倍。得意な型(認可・テナント分離・SSRF)の対象が、この作業場の成果物(単一 HTML・Python の CLI)に無かった。→ 外した。ただし
ENABLE_STOP_REVIEW=0(②だけ止めて③は残す)やENABLE_CODE_SECURITY_REVIEW=0(①だけ残す)という調整の口があるので、判断は「残す/調整する/外す」の 3 択。 - hookify: フック先は 4 種で各 150〜175 ms。Tool Call 1 回で発火するのは Pre/Post の 2 つ=約 0.30〜0.35 秒の上乗せ。ルールを 1 本も書いていなければ効果はゼロで、往復だけ増える。→ 外した。
-
pyright-lsp/typescript-lsp: LSP のプロセス自身は LLM を呼ばない(追加のレビューを発火しない)。診断結果が後続のコンテキストに載る分は別で、今回は測っていない。自作 CLI の NameError(引数なしで呼ぶと落ちる)を捕まえ、
node --checkが素通りするimport/exportを含む.jsの構文崩れを、編集中に赤にした。払うのは node.exe の常駐 175 MB と、初期設定(pyright の規則を絞る 1 ファイル)。→ 残した。
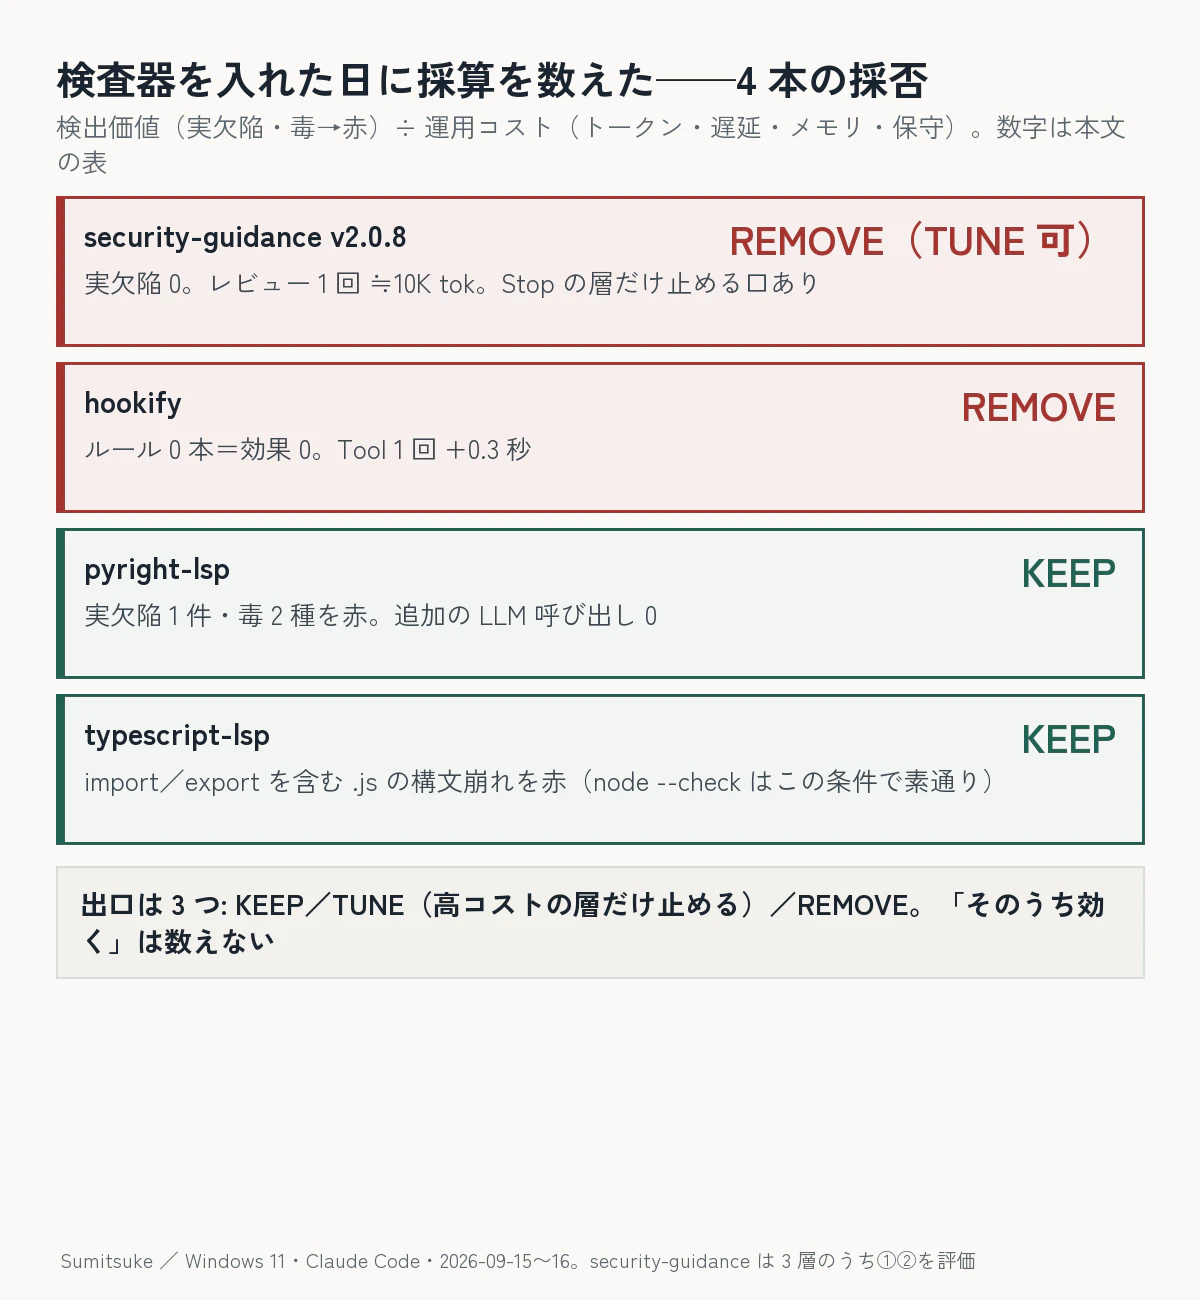
採算表(入れた日に数えた)
| 器 | 得たもの(検出価値) | 払ったもの(運用コスト) | 判断 |
|---|---|---|---|
| security-guidance v2.0.8(測ったのは層①②・層③の commit レビューは評価対象外) | ①regex が shell=True・pickle を鳴らした。②LLM diff レビューは得意型の対象が無く、実欠陥 0 |
②はレビュー 1 回 ≒10K tok 相当・編集ターンの総トークン +12〜30%(大きな diff で倍)・導入直後にホットロードで 10 回走った(1 回 1.6〜4.6 秒)・venv 284 MB |
外した(調整の口=ENABLE_STOP_REVIEW=0 で②だけ止める/ENABLE_CODE_SECURITY_REVIEW=0 で①だけ残す) |
| hookify | ルール 0 本のため 0(block 規則が deny を返すことは毒で確認) | 4 フック各 150〜175 ms=Tool 1 回 +0.30〜0.35 秒・常時 ≈218 tok(説明文)・Store 版 python3 で日本語ルールが化ける | 外した |
| pyright-lsp | 自作 CLI の NameError 1 件(実走で確認)・型誤りと未定義名を毒で赤に | 既定の規則で 326 エラー → 高信号の規則に絞って 2(設定ファイル 1 本)・メモリ | 残した |
| typescript-lsp |
import/export を含む .js の構文崩れを毒で赤に(node --check はこの条件で素通り)・編集中に即赤 |
node.exe 常駐 175 MB | 残した |
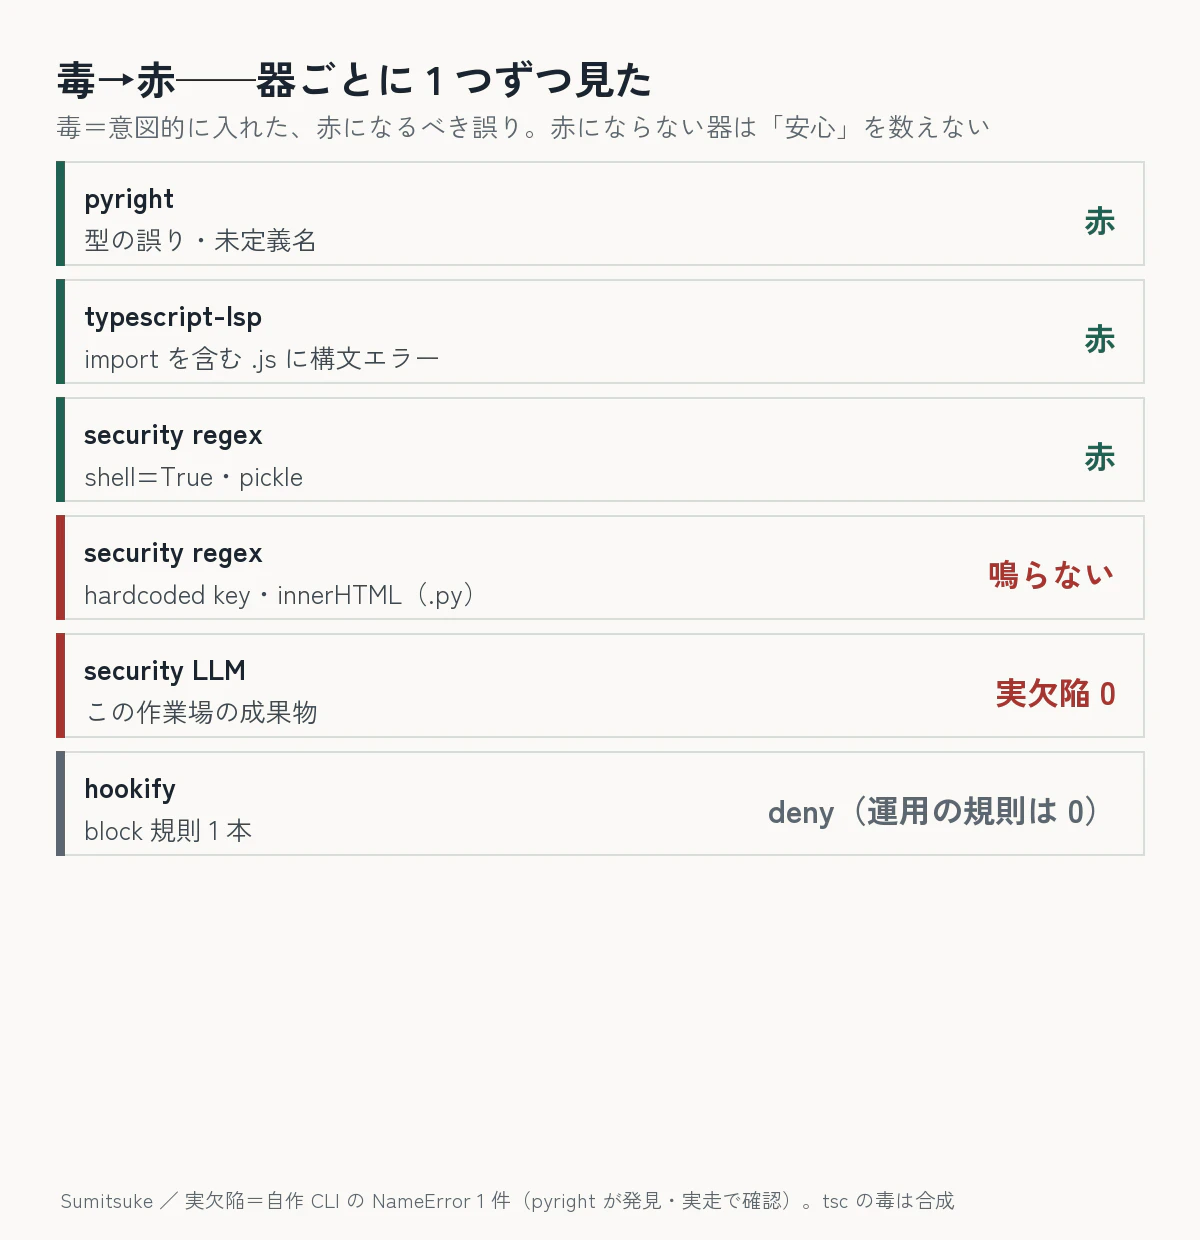
何を「得たもの」に数えたか——毒→赤
「入れて安心した」は数えません。数えたのは 2 つだけ。実際の欠陥を捕まえたかと、わざと入れた毒を赤にできるかです。
- pyright: 型の誤りと未定義名を 1 行ずつ入れて赤になることを確認。実欠陥として、自作の文書監査 CLI で
--sectionを引数なしで呼ぶと NameError になる箇所を拾った(実走して落ちることを確認してから直した)。 - tsc:
node --checkはimport/exportを含む.jsの構文エラーを exit 0・エラー出力なしで素通りする(Node v24.14.0。素の CJS の.jsは exit 1・同じ中身を.mjsにすれば exit 1=09-16 に条件を再現で確定)。その.jsに合成の毒function ((){を足すと、typescript-lsp は編集中に赤にした。
printf 'import fs from "node:fs";
function ((){
' > poison.js   # import を含む .js に構文エラー
node --check poison.js ; echo $?   # → 0(素通り・stderr なし)
cp poison.js poison.mjs && node --check poison.mjs ; echo $?   # → 1
# typescript-lsp は poison.js を診断で赤にする
- security-guidance の①regex 層:
subprocess.run(cmd, shell=True)とpickle.loadsは鳴った。hardcoded な API キーとinnerHTMLは.pyでは鳴らない(対象言語の規則が無い)。②Stop の LLM 層はこの作業場の成果物に得意型が無く、実欠陥 0。③commit 時の agentic レビューは今回評価していない(git commit を伴う作業が少なく、走ったかを記録していない)。 - hookify: block 規則を 1 本書いて、対象コマンドに deny が返ることは確認。ただし運用で書く規則が無かった。
何を「払ったもの」に数えたか
トークンはレビュー 1 回あたりで数えました(Stop ごとに走るので、1 ターン 1 回とは限らない)。固定プロンプトが約 37 KB=10K トークン相当で、キャッシュが効かない。編集の多いターンで測ると、総トークン量が +12〜30%、大きな diff を含むターンでは倍になりました。
遅延は clean 時の中央値。hookify はフック先が 4 種(PreToolUse/PostToolUse/UserPromptSubmit/Stop)で各 150〜175 ms。Tool Call 1 回で走るのは Pre と Post の 2 つなので、道具を 1 回呼ぶたびに約 0.30〜0.35 秒。自前のフック 3 本は各 50〜60 ms でした。
メモリは LSP の node.exe が 175 MB 常駐。トークンは、診断の実行では増えません(プラグインの説明文がコンテキストに入る分は別で、hookify の ≈218 tok と同じ種類)。
うまくいかなかったこと
- security-guidance は入れた直後から走っていた。 ホットロードで 10 回、1 回 1.6〜4.6 秒。「入れただけでまだ効いていない」と思っていた時間に、すでに払っていた。
-
hookify の日本語ルールが化けた。 Store 版の
python3(cp932)で走るので、規則ファイルの日本語本文が「縺ッ遨∽ュ「」になる。英数で書くかPYTHONUTF8=1を環境に置く。 - pyright は既定だと 326 エラー。 全部読む前に、高信号の規則(未定義名・型の不一致・到達不能)だけに絞って 2 にした。絞らないと赤に慣れる。
60 秒で採否する表——出口は KEEP/TUNE/REMOVE の 3 つ
| 問い | Yes なら |
|---|---|
| 今週、実際に起きた欠陥を捕まえたか | KEEP の方向 |
| 合成した毒を赤にできるか | KEEP の方向 |
| 毎回 LLM を呼ぶか | トークンを測る(1 回あたり・キャッシュの有無)。高い層だけ止める口があれば TUNE |
| Tool ごとにフックが走るか | 遅延を測る(発火するフックの数×1 回)。使わないフックを外せるなら TUNE |
| 誤検知の修正の方が、捕まえた欠陥より多いか | REMOVE の方向 |
| 人が実物を開いて見るほうが速いか | REMOVE の方向 |
入れた日に数える。「そのうち効く」は数えない。二択にしない——security-guidance のように層ごとの ON/OFF があるものは、高コストの層だけ止めて安い層を残すのが第 3 の出口。
AI の利用について
プラグインの導入・測定・この記事の下書きに AI(Claude Code)を使いました。数字(10K tok 相当・+12〜30%・150〜175 ms・326→2・175 MB)は当方の環境の実測と換算で、条件は本文に書いたとおりです。外した/残したの判断と公開の判断は人間が行いました。客先の案件のファイルは引用していません(tsc の例は合成の毒)。
本家(検証の記録つき)
この記事の本家(検証環境・判定・証拠)は Sumitsuke Lab → 検査器を入れた日に採算を数える(失敗パターン実測録 #05)。
受託でも同じ手順で読んでいます
「入れた検査が本当に効いているか分からない」——毒を 1 本入れて赤になるかと、1 回あたりのコストで見ます。テキストだけで受けています。
▶ Sumitsuke / 検証・テスト設計
次に読む: 外部の指摘も現物で照合する——AI レビュー 17 件を全部突き合わせたら何が残ったか
この記事は Zenn にも同じ内容を掲載しています。