
はじめに
このシリーズでは、AIアクセラレータの設計をHBM4という希少資源の観点から3本書いてきました。Vera Rubin の設計、MI455X との比較、そして OpenAI がなぜDRAMウェハを直接押さえるのか。
どの記事も、ある前提を暗黙に使っていました。「推論の decode フェーズはメモリ帯域律速である」という前提です。今回はその前提そのものを、正面から扱います。
先に、よくある誤解をひとつ潰しておきます。
decode がメモリ帯域律速なのは、KVキャッシュのせいだと思われがちです。実は違います。主因は重みです。そして decode の演算強度は、モデルの大きさにも、MoE か dense かにも依らず、FP8 の重みなら常に「2」です(単位は FLOP/byte)。
なぜ2なのか。なぜ prefill だと1万倍も違うのか。なぜ NVIDIA は prefill 専用チップ(Rubin CPX)を作り、そして消したのか。全部、1枚のルーフライン図の上で説明がつきます。
本記事の数値はすべて手計算で追えるようにしてあります。
本記事の数値ラベルについて
| ラベル | 意味 |
|---|---|
| 【公式】 | NVIDIA / AMD / Micron 等の公式発表 |
| 【報道】 | 一次報道 |
| 【推定】 | SemiAnalysis 等のアナリスト推定 |
| 【試算】 | 筆者の計算。前提をすべて明示します |
| 【未確認】 | 裏付けが取れず、断定を避ける箇所 |
前提: 本記事は FP8 を基準にしています
演算強度は重みの精度によって値が変わるので、先に基準を決めておきます。本記事は、断りのない限り重みを FP8 とします。
理由は3つあります。
理由1:FP8 は 1パラメータ = 1バイト です。この対応が素直なので、以降の計算をそのまま暗算で追えます。
| 重みの精度 | 1パラメータのサイズ |
|---|---|
| FP16 / BF16 | 2 byte |
| FP8 | 1 byte |
| FP4 / INT4 | 0.5 byte |
理由2:FP8 は2026年時点でも本番推論の標準的な精度です【報道・推定】。NVFP4 は Blackwell 世代で急速に普及していますが、Blackwell 専用のハードウェア形式であり、稼働中の Hopper 世代(H100 / H200)ではネイティブに使えません。エミュレーションすると FP8 より遅くなります。新規案件では NVFP4 を既定に、精度検証で必要なときだけ FP8 に戻す、という運用が主流になりつつある一方で、既存の膨大な H100 群は当面 FP8 のままです。
(NVFP4 の精度劣化はごくわずかです。16値ブロックごとの FP8 マイクロスケールと、グローバルな FP32 スケールを組み合わせた二段構成で、素朴な4bit丸めとは別物です。NVIDIA は DeepSeek-R1-0528 について、FP8 から NVFP4 への PTQ で主要な言語タスクの劣化は1%以下だと報告しています。MMLU では 90.8% → 90.7% です【公式】)
理由3:FP4 の公称値は、スパース性を含んだ数字であることが多く(VR200 の「NVFP4 推論 50 PFLOPS」がそれです)、機種間で条件を揃えるのが面倒です。FP8 dense なら比較的素直に揃います。チップ側のピーク性能も、FP8 dense を共通通貨として揃えます。
FP4 にした場合どうなるかは、PART 2-5 で別途扱います。結論を先に言えば、演算強度は 4 に上がりますが、律速は変わりません。精度の選択は表示の問題であって、物理の問題ではないからです。
先に結論
- 【試算】decode の不変量は「重み1個につき 2 FLOP」です。理由は行列ベクトル積だから。これをバイト数で割ると演算強度になり、FP8(重み1個=1バイト)なら 2 FLOP/byte。モデルサイズにも MoE/dense にも依りません。
- 【試算】prefill の演算強度は 2×B です(B はトークン数)。理由は行列行列積だから。1万トークンで 20,000。同じモデル・同じチップで、演算強度が1万倍違います。
- 【試算】VR200 の尾根(ridge point。ルーフラインの折れ点であり、その機械が「1バイトあたり何回計算できるか」を表す)は 795 FLOP/byte。decode は398倍下、prefill(10K) は25倍上にいます。
- 【試算】その結果、VR200 は decode 中に演算器の 99.75% を、prefill 中に HBM4 帯域の 96% を、それぞれ遊ばせています。完全な鏡像です。
- 【筆者の解釈】prefill を VR200 で回すと、HBM4 帯域の96%は使われません。Rubin CPX が GDDR7 を選んだのは、コスト削減であると同時に、逼迫した HBM4 を decode 側に回すためだったと読めます。
- 【試算】decode の脱出路はバッチングだけですが、KV が天井を作ります。100Kトークンコンテキストでは上限が 8.5 で、バッチをいくら積んでも尾根の93倍下から動けません。
- 【試算】Groq LPU の尾根は 8.2 FLOP/byte。これは長コンテキスト decode の天井(8.5)とほぼ一致します。偶然ではなく、decode がいる場所に機械のバランスを合わせた設計です。
- そして Rubin CPX は消えました。ルーフラインの外側にある制約が、ルーフラインに従って設計されたチップを殺したからです。
- なお、投機的デコーディングで、自分の未来のトークンとバッチを組む MTP という手法があります。くわしくは以下の記事を参照ください。
早見表
| prefill | decode | |
|---|---|---|
| 演算の形 | 行列 × 行列 | 行列 × ベクトル |
| 演算強度(FP8重み) | 2B(B=トークン数) | 2(常に) |
| 10Kトークンなら | 20,000 | 2 |
| 尾根(795)に対して | 25倍 上 | 398倍 下 |
| 律速 | 演算 | 帯域 |
| VR200 で余る資源 | HBM4 帯域(96%) | 演算器(99.75%) |
| ほしいメモリ | 安く・大容量(GDDR7) | 狭くていい・超高速(SRAM) |
| 専用チップ | Rubin CPX(尾根 5,000) | Groq LPU(尾根 8.2) |
PART 1:ルーフラインと「尾根(ridge point)」の位置
1-1. 演算強度とは何か
チップの性能を決める資源は、2つしかありません。
- 演算器 ── 計算する能力。単位は FLOPS(1秒あたり何回計算できるか)
- メモリ帯域 ── データを運んでくる能力。単位は byte/s(1秒あたり何バイト運べるか)
どちらも有限です。そして、どちらか一方が先に尽きた時点で、それ以上は速くなりません。どちらが先に尽きるのか。それを決めるのが演算強度です。
演算強度(arithmetic intensity)は、こう定義されます。
演算強度 AI = 実行するFLOP数 ÷ メモリから読むバイト数 [FLOP/byte]
日本語にすると、
「メモリから1バイト運んでくるごとに、何回の計算をするか」
です。単位が FLOP/byte なのは、そのままの意味です。
具体例を出します。
| ワークロード | 読むバイト数 | 演算量 | 演算強度 |
|---|---|---|---|
| A | 1 GB | 2 GFLOP | 2 FLOP/byte |
| B | 1 GB | 20 TFLOP | 20,000 FLOP/byte |
A は、データを運んでくるばかりで、ほとんど計算していません。運搬が仕事の大半を占めます。
B は、一度運んできたデータを、徹底的にしゃぶり尽くしています。計算が仕事の大半です。
ここで大事なのは、演算強度が「比」であることです。問題の規模には依りません。そのワークロードが、演算とメモリをどういう比率で欲しがっているか、だけを表します。
用語について ── B/F比との関係
「演算強度」は arithmetic intensity の訳語です。日本語の解説ではこの語を使いますが、現場では英語のまま arithmetic intensity と呼ぶことが多い様です。
そして、日本の HPC 分野では B/F比(バイト/フロップ比)という言い方が強く定着しています。ここに注意が要ります。両者は逆数です。
| 指標 | 定義 | 単位 | decode の値 | 大きいほど |
|---|---|---|---|---|
| 演算強度 (arithmetic intensity) |
FLOP ÷ byte | FLOP/byte | 2 | 演算律速に寄る |
| B/F比 | byte ÷ FLOP | byte/FLOP | 0.5 | 帯域律速に寄る |
B/F比で考える習慣のある方は、以降の「演算強度」を頭の中で逆数に読み替えてください。大小の向きも逆になります。
本記事が B/F比ではなく演算強度を使うのは、ルーフラインの尾根と直接くらべられるからです。尾根も FLOP/byte なので、同じ物差しの上で「どちらが大きいか」を見るだけで律速が決まります。
1-2. 機械の側にも、同じ比があります ── それが「尾根(ridge point)」
チップにも、まったく同じ次元の量を定義できます。ピーク性能を帯域で割るだけです。これを尾根(ridge point)と呼びます。
尾根(ridge point) = ピーク演算性能 ÷ ピークメモリ帯域 [FLOP/byte]
VR200 なら、
17.5 PFLOPS ÷ 22 TB/s = 795 FLOP/byte
これは「このチップは、1バイト運んでくる間に、795回も計算できてしまう」という意味です。チップの食欲、と言い換えてもいい。795 という数字は、VR200 がそれだけ演算に偏った機械であることを示しています。
英語では ridge point、または machine balance と呼びます。
1-3. 判定は、2つの比を較べるだけ
ワークロードが要求する比(演算強度)と、機械が供給できる比(尾根)を較べます。それだけで律速が決まります。
| 関係 | 律速 | 何が起きるか |
|---|---|---|
| 演算強度 < 尾根 | 帯域律速 | 運ぶのが追いつかない。演算器が遊ぶ |
| 演算強度 > 尾根 | 演算律速 | 計算が追いつかない。帯域が余る |
たとえば decode(演算強度 2)を VR200(尾根 795)で回すと、こうなります。
チップは 1バイトあたり 795回 計算できる
仕事は  1バイトあたり   2回 しか要求しない
          ─────────────────
        793回分の演算能力が、行き場を失う

演算器の利用率 = 2 ÷ 795 ≒ 0.25%
本記事で繰り返し出てくる「演算器の99.75%が遊ぶ」は、この引き算のことです。
1-4. なぜ「尾根(ridge point)」と呼ぶのか ── ルーフラインとの違い
図1を先に見ていただくと分かりやすいのですが、両対数のグラフに描くと、帯域律速の領域は右上がりの斜線に、演算律速の領域は水平線になります。この2本が作る形が屋根(roof)に見えるので、ルーフラインと呼びます。
そして2本が交わる折れ点が、屋根の尾根(ridge)です。ここより左に住むワークロードは帯域律速、右に住むワークロードは演算律速。それだけの話です。
日本語だと漢字も似ていて混同されやすいので、はっきり分けておきます。
| 用語 | 英語 | 正体 | 図1のどこか |
|---|---|---|---|
| ルーフライン (屋根) |
roofline | 折れ線 全体 斜線+水平線) |
オレンジ+緑の線そのもの |
| 尾根 | ridge point | その 折れ点1つ | X = 795 の縦の破線 |
屋根で言えば、ルーフラインが屋根の輪郭線、尾根がてっぺんの稜線です。尾根はルーフラインの一部であって、ルーフラインそのものではありません。
本記事のタイトルにある「roofline で理解する」は前者を指し、本文で繰り返し出てくる「尾根 = 795」は後者を指します。単位を見れば区別がつきます。尾根は FLOP/byte という X軸上の1点なので、線ではなく点です。
1-5. 主要チップの尾根
冒頭で決めた通り、FP8 dense を共通通貨として4つのチップの尾根を出します。
| チップ | ピーク FP8(dense) | 帯域 | 尾根 | メモリ |
|---|---|---|---|---|
| VR200(Rubin) | 17.5 PFLOPS | 22 TB/s | 795 | HBM4 288GB |
| MI455X | 20 PFLOPS | 19.6 TB/s | 1,020 | HBM4 432GB |
| Rubin CPX | 約10 PFLOPS | 約2 TB/s | 5,000 | GDDR7 128GB |
| Groq LPU(1基) | 約1.23 PFLOPS | 150 TB/s | 8.2 | SRAM 500MB |
出典と注記:
- VR200 の FP8 dense 17.5 PFLOPS、HBM4 288GB / 22 TB/s は【公式】(NVIDIA Vera Rubin NVL72 スペック表。FP8 値には「Dense specification」の脚注が付きます)。なお同表の「NVFP4 Inference 50 PFLOPS」には dense 脚注がなく、NVIDIA は sparse という語も使っていません。dense と明記されているのは「NVFP4 Training 35 PFLOPS」のほうです
- MI455X の FP8 20 PFLOPS、19.6 TB/s は【報道】
- CPX で【公式】なのは次の4点だけです。NVFP4 30 PFLOPS、GDDR7 128GB、モノリシックダイ、GB300 NVL72 比で attention 3倍。NVIDIA は 30 PFLOPS が dense か sparse かを明記していません
- CPX の帯域は NVIDIA が公表していません。SemiAnalysis が 512-bitバス × 32Gbps から約2 TB/s と推定し【推定】、FP4 dense を 20 PFLOPS としています【推定】。FP8 dense はその半分として約10 PFLOPS と置きました【試算】
- CPX の 192 SM、TSMC N3P、PCIe Gen6・NVLink なしは【報道・推定】であり、NVIDIA の公式明記はありません
- Groq LPU の SRAM 500MB と SRAM帯域 150 TB/s は【公式】(NVIDIA の LPX 製品ページ)。1基あたり FP8 性能は、LPX ラック(256基)の 315 PFLOPS【報道】を256で割った筆者の値です【試算】。NVIDIA は per-chip の FLOPS を公表していません
この表だけで、記事の半分は終わっています。LPU の尾根が VR200 の 1/90 であることに、すでに答えが出ています。
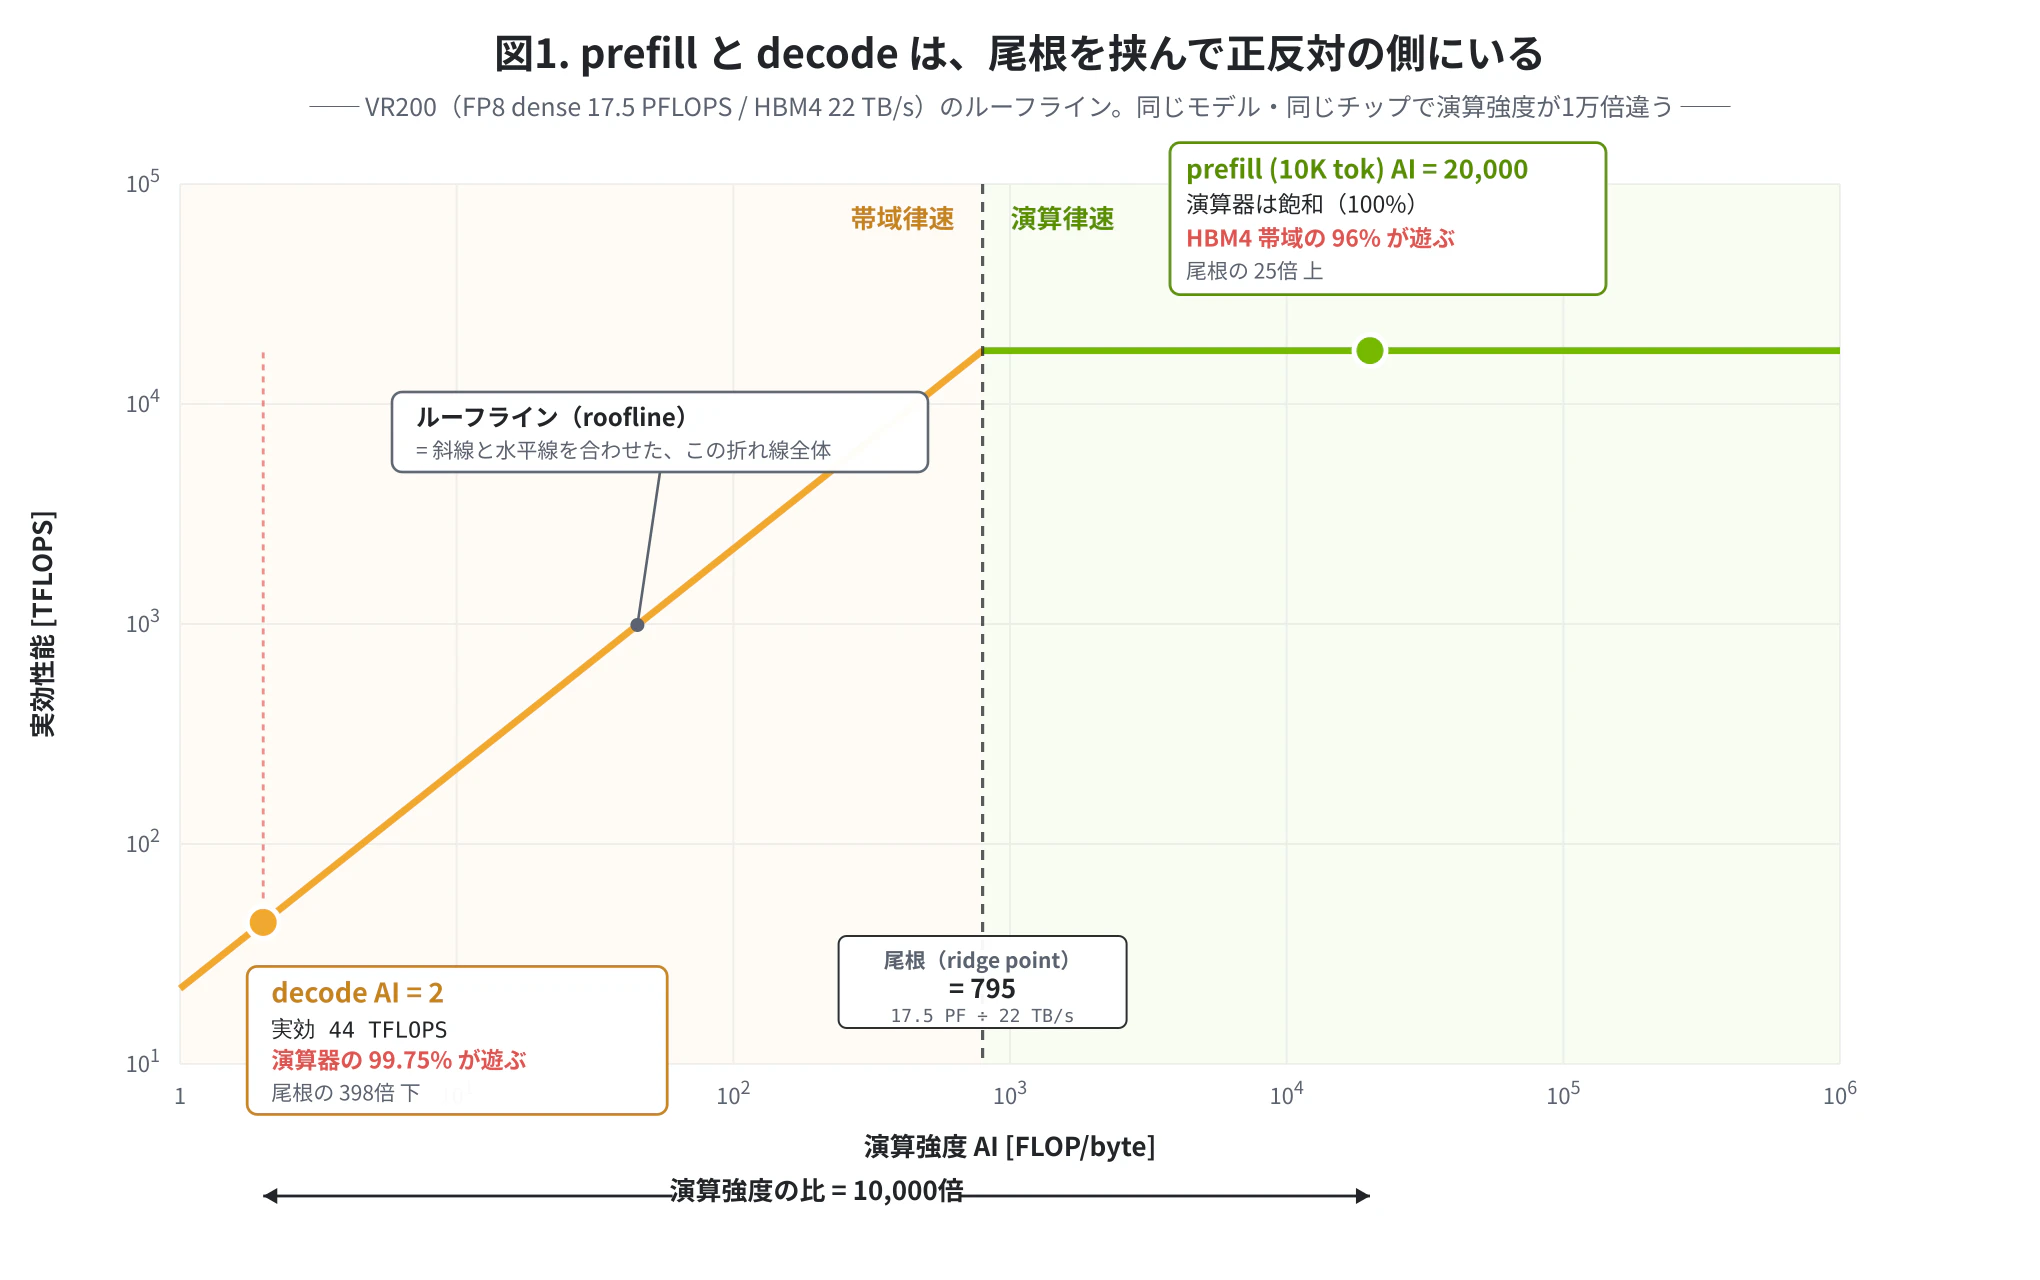
図1がこの記事の全体像です。オレンジの斜線が帯域律速、緑の水平線が演算律速。同じモデル・同じチップなのに、decode と prefill は尾根を挟んで正反対の側に立っています。
PART 2:decode の演算強度はなぜ「2」なのか
2-1. 不変量は「重み1個につき 2 FLOP」です
先に、精度に依らない不変量を1つ押さえます。
decode は、1トークンずつ生成します。つまり入力は1本のベクトルで、演算は行列ベクトル積になります。
y = W x        W は [n×m] の重み行列、x は [m×1] のベクトル

FLOP = 2nm     (n×m 個の積和。掛けて1回、足して1回で 2 FLOP)
重みは全部で nm 個。演算は 2nm FLOP。割り算すると、
重み 1個 あたり 2 FLOP
これが不変量です。 重みを1個読んできて、それに対してやる計算は積和1回、すなわち 2 FLOP。それだけ。読んできた重みは、その1回で使い捨てです。使い回しがききません。
この「2」は、モデルサイズにも、行列の形にも、量子化の精度にも依りません。行列ベクトル積である限り、常に成り立ちます。
2-2. 演算強度は、これをバイト数で割ったもの
演算強度の分母はバイト数です。そこで、不変量(2 FLOP)を、重み1個のバイト数で割ります。
演算強度 = 2 FLOP ÷ (重み1個のバイト数)
冒頭で宣言した通り、本記事の基準は FP8 です。FP8 では重み1個がちょうど 1バイト なので、
演算強度 = 2 FLOP ÷ 1 byte = 2 FLOP/byte
タイトルの「2」は、この数字のことです。単位は FLOP/byte で、byte は8ビットです。
他の精度なら、分母が変わるぶん値も変わります。
| 重みの精度 | 重み1個のサイズ | 演算強度 |
|---|---|---|
| FP16 / BF16 | 2 byte | 1 FLOP/byte |
| FP8 | 1 byte | 2 FLOP/byte |
| FP4 / INT4 | 0.5 byte | 4 FLOP/byte |
分子(2 FLOP)は動きません。動くのは分母だけです。
2-3. モデルサイズにも MoE にも依らない
不変量が「重み1個につき 2 FLOP」なので、当然こうなります。
| モデル | 1トークンで読む重み | FLOP | 演算強度 |
|---|---|---|---|
| dense 70B | 70 GB | 140 GFLOP | 2.0 |
| dense 671B | 671 GB | 1,342 GFLOP | 2.0 |
| DeepSeek-R1 671B(活性37B) | 37 GB | 74 GFLOP | 2.0 |
MoE は読むバイト数を減らします(671GB → 37GB)。同時に FLOP も同じ比率で減ります。分子と分母が揃って縮むので、演算強度は動きません。
MoE は decode を18倍速くしますが、帯域律速からは1ミリも逃げられません。ルーフラインの左端に張り付いたまま、対角線を上に滑るだけです。
2-4. 量子化は救わない
2-2 の表から予想がつきます。FP8 → FP4 にすれば分母が半分になるので、演算強度は 4 に上がります。
ところが、尾根も上がります。FP4 のピーク性能がちょうど2倍だからです(VR200 の公式値は FP8 dense 17.5 PFLOPS、FP4 dense 35 PFLOPS)。分子(機械の演算能力)と分母(機械の帯域)のうち、分子だけが2倍になる。
| 精度 | 演算強度 | VR200 の尾根 | 尾根との比 |
|---|---|---|---|
| FP8 | 2 | 795(17.5 PF ÷ 22 TB/s) | 398倍下 |
| FP4 | 4 | 1,591(35 PF ÷ 22 TB/s) | 398倍下 |
きれいに一致します。ワークロードの演算強度も、機械の尾根も、精度を半分にすると同じだけ2倍になる。だから相対位置は「ほぼ」ではなく、厳密に変わりません。
量子化は decode を2倍速くしますが、compute-bound には決してしません。
(NVFP4 の価値を否定する話ではありません。読むバイトが半分になるので、decode は素直に2倍速くなります。帯域律速の世界では「読むバイトを減らす」ことが直接そのまま速度になるので、実用上これは大きい。冒頭で触れた通り、精度劣化もごくわずかです。ただし律速の性質は変わらない、という話です)
言い換えると、量子化は「ルーフラインの左端で、対角線を上に登る」手段です。尾根を越えて右側へ行く手段ではありません。右へ行きたければ、次に見るバッチングしかありません。
PART 3:prefill の演算強度はなぜ「2B」なのか
3-1. 行列行列積だから
prefill では、プロンプト全体を一度に処理します。つまり入力は B 本のベクトル、すなわち行列です。
Y = W X        X は [m×B](B はプロンプトのトークン数)

FLOP  = 2nmB
bytes = nm      ← 重みは1回読むだけ。B 列すべてに使い回す

AI = 2nmB / nm = 2B
decode の裏返しです。
PART 2-1 の不変量を思い出してください。重み1個につき、積和1回で 2 FLOP。これは prefill でも変わりません。変わるのは、その重みを何トークン分に使い回せるかです。
| 重み1個あたりの FLOP | 使い回すトークン数 | 重み1個あたりの総 FLOP | |
|---|---|---|---|
| decode | 2 | 1 | 2 |
| prefill | 2 | B | 2B |
decode では、読んできた重みは1回の積和で使い捨てでした。prefill では、同じ重みを B 個のトークンすべてに使い回せます。読むバイト数は同じなのに、やる計算は B 倍になる。
あとは PART 2-2 と同じで、これをバイト数で割ります。FP8 なら重み1個 = 1バイトなので、
演算強度 = 2B FLOP ÷ 1 byte = 2B FLOP/byte
同じ「重み1個につき 2 FLOP」という不変量が、decode では 2×1 のまま、prefill では 2×B に化ける。両者を分けているのは、重みを使い回せるかどうか、その一点だけです。
3-2. 数字にすると
| プロンプト長 | AI | VR200 の尾根(795)との関係 |
|---|---|---|
| 1,000 tok | 2,000 | 2.5倍 上 |
| 10,000 tok | 20,000 | 25倍 上 |
| 100,000 tok | 200,000 | 252倍 上 |
3-3. 同じモデル・同じチップで、演算強度が1万倍違う
| フェーズ | AI | 尾根(795)に対して | 律速 |
|---|---|---|---|
| prefill(10K tok) | 20,000 | 25倍 上 | 演算 |
| decode | 2 | 398倍 下 | 帯域 |
比は 10,000倍。
これが「prefill と decode で別のチップが要る」ことの、数値的な正体です。
同じモデルの重みを使い、同じチップで走らせているのに、動作点はルーフラインの尾根を挟んで正反対の側にいます。
PART 4:VR200 は、フェーズごとに半分を捨てている
ここが本記事の核心です。
4-1. 鏡像
【試算】VR200(FP8 dense 17.5 PFLOPS、HBM4 22 TB/s)で、それぞれのフェーズを回したときの資源利用率を出します。
decode(AI = 2、帯域律速):
実効性能 = AI × 帯域 = 2 × 22 TB/s = 44 TFLOPS
演算器の利用率 = 44 ÷ 17,500 = 0.25%
prefill(10Kトークン、AI = 20,000、演算律速):
演算器は飽和(100%)
必要な帯域 = ピーク性能 ÷ AI = 17.5 PFLOPS ÷ 20,000 = 0.875 TB/s
HBM4帯域の利用率 = 0.875 ÷ 22 = 4.0%
並べます。
| 演算器(17.5 PFLOPS) | HBM4帯域(22 TB/s) | |
|---|---|---|
| prefill 中 | 100% 使用 | 4.0% しか使わない |
| decode 中 | 0.25% しか使わない | 100% 使用 |
完全な鏡像です。
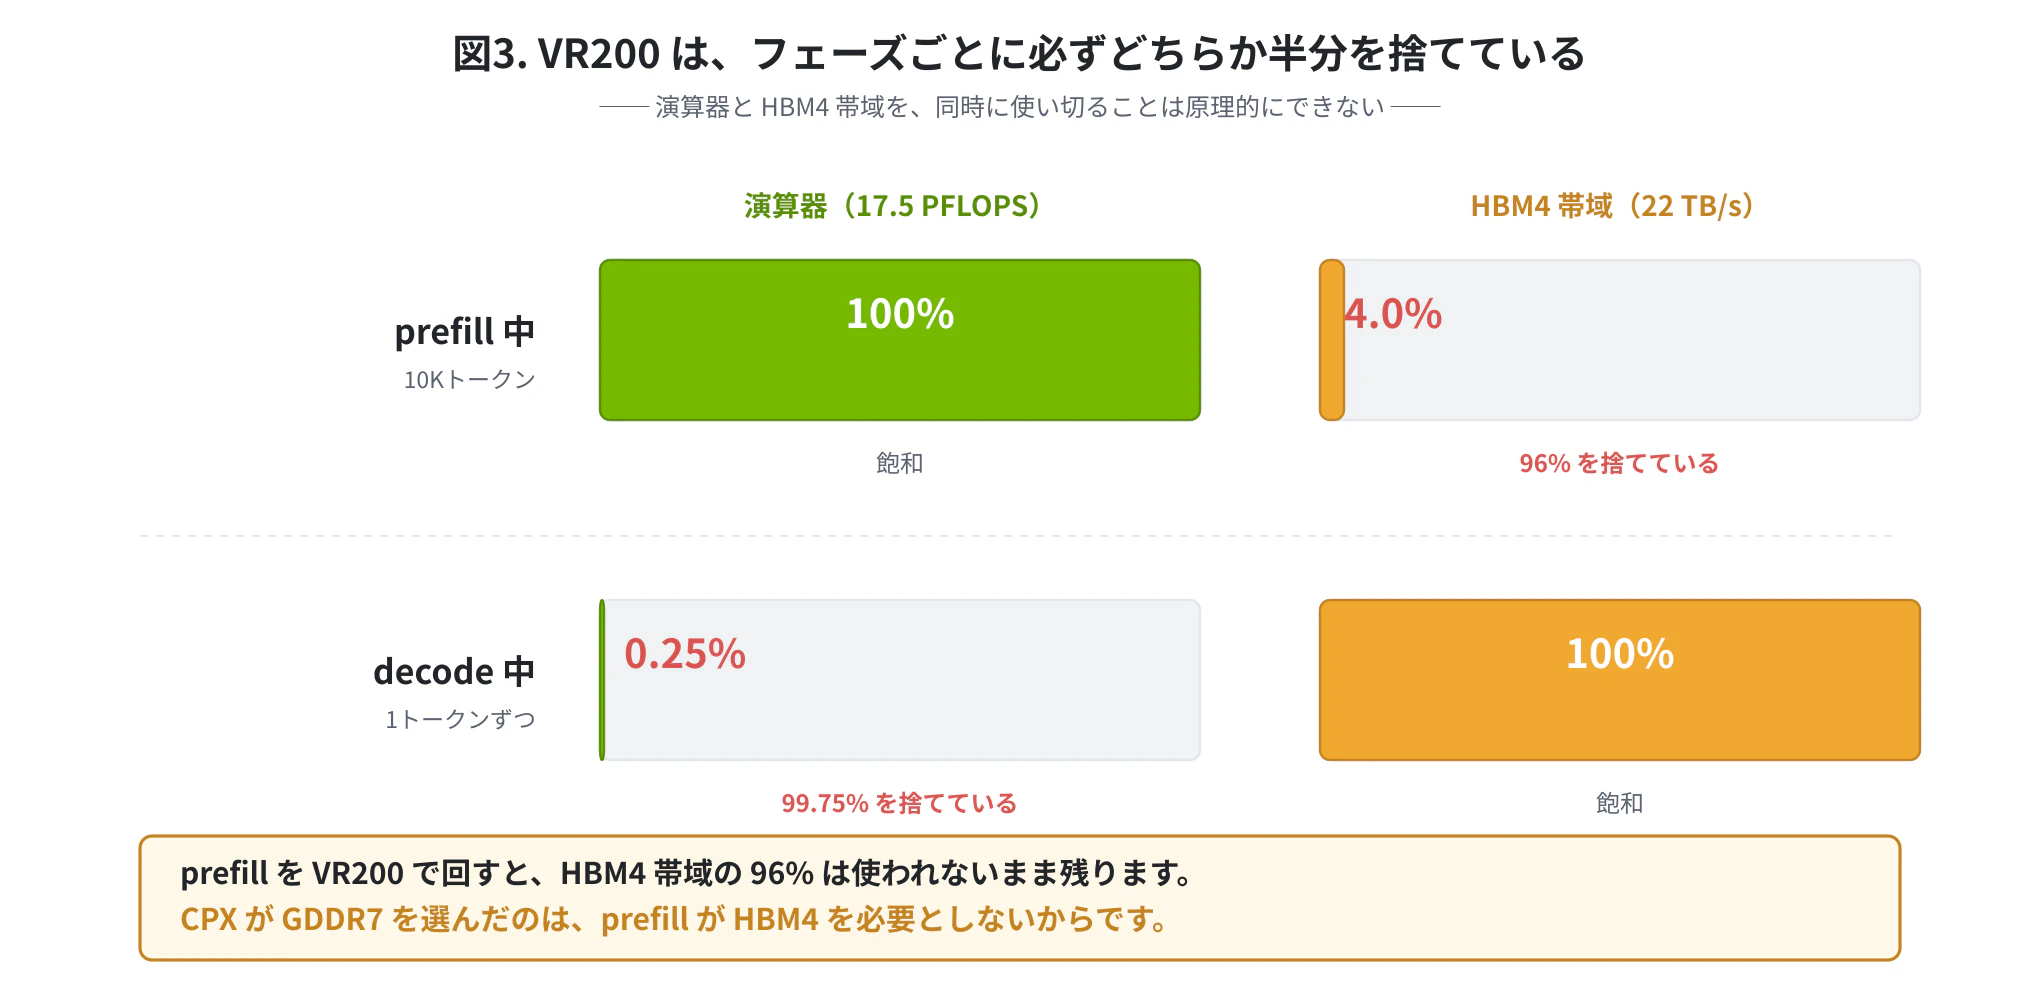
同じチップが、フェーズによって「演算器を捨てる」か「帯域を捨てる」かのどちらかを、必ずやっています。両方を同時に使い切ることはありません。
4-2. そして、使われずに残るのは HBM4
ここで前3本の記事と接続します。
このシリーズでずっと書いてきた通り、AIビルドアウトの律速は HBM4 です。HBM4 はビットあたり通常DRAMの3〜4倍のウェハを食い、fab のリードタイムは5年超で、金を積んでも増えません。
その HBM4 の帯域を、prefill 中は96%使わずに済ませている。
【筆者の解釈】これが、NVIDIA が prefill 専用チップを作った理由のひとつだと考えます。CPX の存在意義は「GDDR7 が安いから」だけではありません。
prefill は HBM4 を必要としない。ならば、使わせる必要もない。
CPX が GDDR7 を選んだのは、コスト削減であると同時に、逼迫した HBM4 を decode 側に回すためだった、と読めます。
4-3. CPX は、正しく設計されていた
【試算】CPX(約10 PFLOPS FP8、約2 TB/s GDDR7)で prefill(10K) を回すと:
必要な帯域 = 10 PFLOPS ÷ 20,000 = 0.50 TB/s
GDDR7帯域の利用率 = 0.50 ÷ 2.0 = 25%
| チップ | prefill(10K) での帯域利用率 |
|---|---|
| VR200 | 4.0% |
| Rubin CPX | 25% |
CPX は VR200 の7倍、メモリを使い切れています。そして何より、HBM4 を1バイトも使っていません。
ルーフラインの観点から見て、CPX は完全に正しい設計でした。
PART 5:脱出路はバッチングだけ ─ そして KV がそれを塞ぐ
decode 側に戻ります。演算器を99.75%遊ばせている状態から、どう脱出するか。
5-1. バッチングすれば、decode も行列行列積になる
複数の系列を同時に走らせれば、入力ベクトルが束ねられて行列になります。バッチ B なら、prefill と同じ理屈で AI = 2B です。
【試算】VR200 の尾根(795)に届くのに必要なバッチ:
2B = 795 → B = 398
398系列を同時に走らせて、ようやく演算器が飽和します。推論サービングが continuous batching に血道を上げる理由が、これです。
5-2. ところが、KV が天井を作る
バッチを増やすと、KVキャッシュの読み出しも比例して増えます。重みは全系列で共有できますが、KV は系列ごとに固有だからです。
AI(B) = 2BP / (P + B·K)

   P : 重みのバイト数
   K : 1系列あたりの KV のバイト数

B → ∞ のとき   AI → 2P / K      ← 天井
バッチをいくら増やしても、この天井を超えられません。
5-3. 長コンテキストでは、天井が崩落
【試算】dense 70B(GQA、8 KVヘッド × 128次元 × 80層、FP8)を仮定します。KV は1トークンあたり 164 KB です。
KV/トークン = 2(K,V) × 80層 × 8ヘッド × 128次元 × 1 byte = 163,840 byte
| コンテキスト長 | KV/系列 | AI の天井(2P/K) | 尾根(795)との比 |
|---|---|---|---|
| 4K | 0.66 GB | 214 | 3.7倍 下 |
| 32K | 5.2 GB | 27 | 30倍 下 |
| 100K | 16.4 GB | 8.5 | 93倍 下 |
| 1M | 163.8 GB | 0.85 | 931倍 下 |
コンテキストが伸びるほど天井が下がり、バッチングという唯一の脱出路が塞がれます。
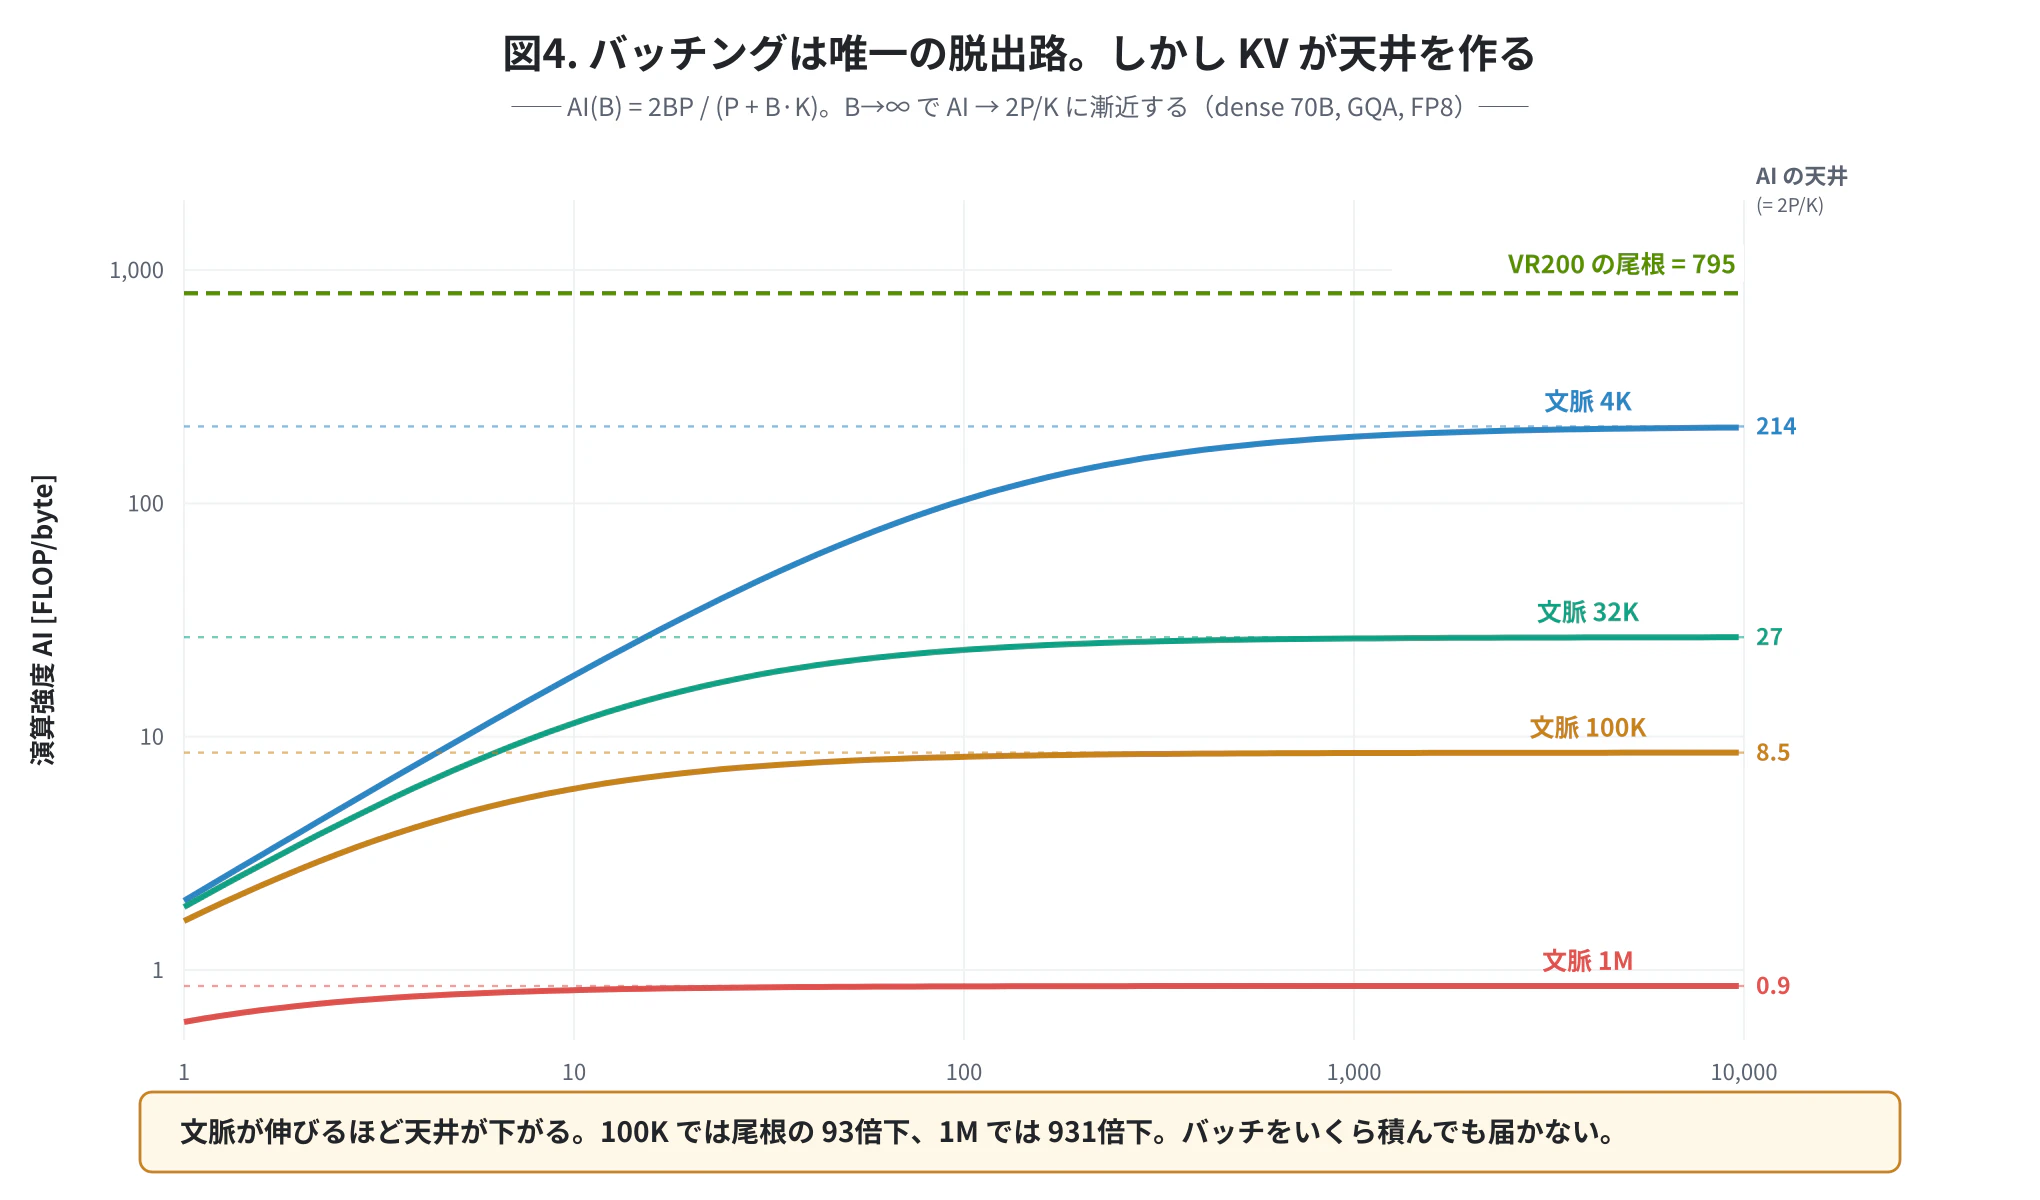
短いコンテキスト(4K)なら、バッチを積めば尾根の3.7倍下まで寄れます。しかし100Kトークンでは、バッチを無限に積んでも93倍下から動けません。
5-4. そして容量の壁が来る
1M トークンコンテキストでは、KV だけで系列あたり 163.8 GB です。VR200 の HBM4 は 288GB。
2系列も載りません。
帯域の前に、容量が壁になります。これが前回 Vera Rubin 記事で書いた、KVキャッシュを HBM4 → LPDDR5X → CMX(flash) の3階層に退避させる設計の理由です。
5-5. 3つの対抗手段は、式の別の場所を叩いている
| 手段 | 叩く場所 | 例 |
|---|---|---|
| KV圧縮 | K を小さくする | MLA(DeepSeek)、GQA、KVの量子化 |
| KV階層化 | 容量の壁を回避する | Vera Rubin の3階層退避 |
| プレフィックスキャッシング | prefill を再計算しない | 共通接頭辞の KV 再利用 |
いずれも「AI を上げる」のではなく、「天井を上げる」か「容量を確保する」かの手です。演算強度2という物理そのものは、誰も動かせません。
5-6. 補足:MoE はバッチで殴りにくい
MoE の利点はバッチ1でこそ効きます。バッチを積むと、異なるトークンが異なるエキスパートを叩くため、結局ほぼ全エキスパートを読むことになるからです。
これは実測されています。DeepSeek-R1(256エキスパート中8個を活性)で、バッチサイズごとに何個のエキスパートが起動するかを測った研究があります【論文】。
| バッチ | 活性化するエキスパート数(256中) |
|---|---|
| 8 | 約 57 |
| 32 | 約 163 |
| 100 | 約 246(96%)【試算】 |
バッチ100でほぼ全部が叩かれます。すると読むバイトは dense と同じ 671 GB。一方 FLOP は18分の1のままです。
高バッチ域の演算強度
  dense 671B : 2B
  MoE  671B  : 2B × (37/671) = 0.11B    ← dense の 1/18
つまり高バッチ域では、MoE の演算強度は dense の 1/18 になります。MoE は dense より「もっと帯域律速」です。
MoE が学習で効く(演算律速なので FLOP 削減が直撃する)のに、推論サービングで扱いにくいのは、この非対称のためです。
PART 6:尾根の両側に、別々のチップが立つ
ここまでの結論を、チップ設計の言葉に翻訳します。
6-1. 3つのチップの立ち位置
| Rubin CPX | VR200 | Groq LPU | |
|---|---|---|---|
| 担当 | prefill | 学習・prefill・attention | decode(FFN) |
| ワークロードの AI | 20,000〜200,000 | ─ | 2 |
| 機械の尾根 | 5,000 | 795 | 8.2 |
| メモリ | GDDR7 128GB | HBM4 288GB | SRAM 500MB |
| 帯域 | 2 TB/s | 22 TB/s | 150 TB/s |
| 捨てたもの | 帯域 | (汎用ゆえ、どちらか一方を常に捨てる) | 演算器 |
6-2. Groq は「尾根を decode の場所まで下げた機械」
これが本記事でいちばん美しい発見です。
【試算】decode(AI = 2)を各チップで走らせたときの演算器利用率:
| チップ | 実効性能 | ピーク | 利用率 |
|---|---|---|---|
| VR200 | 44 TFLOPS | 17,500 TFLOPS | 0.25% |
| MI455X | 39 TFLOPS | 20,000 TFLOPS | 0.20% |
| Rubin CPX | 4 TFLOPS | 10,000 TFLOPS | 0.04% |
| Groq LPU | 300 TFLOPS | 1,230 TFLOPS | 24.4% |
VR200 は演算器の99.75%を遊ばせ、LPU は24%を使います。約100倍の差です。
さらに面白いことがあります。LPU の尾根は 8.2 でした。そして PART 5-3 で計算した、100Kトークンコンテキストでの AI の天井は 8.5 でした。
ほぼ一致しています。 偶然ではありません。Groq は、長コンテキスト decode が実際にいる場所に、機械のバランスを合わせて設計したのです。

図5を見ると、もう一つ大事なことが分かります。VR200 の尾根(795)と MI455X の尾根(1,020)は、decode(2)と prefill(20,000)のどちらとも一致しない中間地帯にいます。
どのワークロードとも同居していない。これが、汎用GPUが両フェーズで必ず資源の半分を捨てる理由です。
(VR200 が「悪い設計」という話ではありません。VR200 は学習と prefill と attention を担当する、尾根の右側のチップです。そこでは17.5 PFLOPS が全部効きます。役割が違うだけです)
6-3. だから NVIDIA は Groq を買った
前回 Vera Rubin 記事で書いた通り、NVIDIA は2025年12月に Groq と契約を結び、GTC 2026 で Groq 3 LPU と LPX ラックを発表しました。契約額は200億ドルと報じられましたが【報道】、NVIDIA の 10-K での計上額は約170億ドル(クロージング時 130億ドル+1年以内支払い 40億ドル)です【公式・SEC】。
役割分担そのものは【公式】です。NVIDIA は Attention-FFN Disaggregation(AFD)と呼び、prefill と attention を Rubin GPU に、レイテンシに敏感な FFN / MoE の decode を LPU に振り分けると説明しています。
(1兆パラメータ級モデルで計算資源の25%を LPX・75%を Rubin に割り当てる、という比率が語られることがありますが、これは一次情報で確認できませんでした【未確認】)
ルーフラインで見れば、この分担は必然です。
- FFN の decode は重みのストリーミング読み出し(AI = 2) → 尾根8.2の LPU
- attention は KVキャッシュという大容量データの読み出し → HBM を持つ VR200
PART 7:そして Rubin CPX は消えた
ここが落としどころです。
CPX は、ルーフラインに従って正しく設計されたチップでした。prefill は演算律速だから、帯域は要らない。HBM4 を使わずに、安い GDDR7 で済ませる。論理は完璧です。
にもかかわらず、消えました。理由を4つ挙げます。
理由1:ワークロードの重心が、尾根の左へ滑った
CPX の発表は2025年9月。当時は100万トークンの長大コンテキスト取り込み(prefill)が課題の中心でした。
ところが reasoning モデルとエージェントが普及し、1クエリあたりの decode トークン数が2桁増えました。経済的なボトルネックは decode 側に移ります。
GTC 2026 の記者向け Q&A で、NVIDIA の Ian Buck 氏(VP of Hyperscale and HPC)はこう述べています。
we've pulled CPX. It's still a good idea, but in order to dedicate our focus on ... optimizing the decode with LPU this year. So we'll be thinking about CPX more in the next generation
「CPX は取り下げた。今でも良いアイデアではあるが、今年は LPU による decode の最適化に集中するためだ。CPX については次世代でまた考える」。
prefill 専用チップを作った直後に、業界の動作点が prefill から離れていった。
ルーフラインの図で言えば、業界全体の重心が、尾根の右から左へ移動したということです。
理由2:prefill の行き場は、別にあった
LPX 構成では、NVL72 側が prefill と KV構築を担当します。FFN decode を LPX に逃がせば HBM 搭載 GPU の手が空くので、prefill 専用チップを別に立てる限界的価値が下がりました。
理由3:Groq 買収で製品枠が埋まった
Groq との大型契約が、推論アクセラレータの席を LPX に持っていきました。1世代に立ち上げられる新シリコンの数は有限です。Buck 氏の発言も、まさにこれを言っています(「今年は LPU による decode の最適化に集中するため」)。
理由4【核心】:「安いメモリ」など存在しなかった
CPX の存在意義は、GDDR7 の安さでした。
ところが、この1年でメモリ価格は3倍超に高騰しました。そして GDDR7 は、HBM とまったく同じ DRAM ウェハから出てきます。
正確に言えば、GDDR7 は HBM よりウェハ効率が良い。TSV も積層も CoWoS も不要だからです。ただし差は3倍もありません。1GBあたりのウェハ消費は、標準DRAMを1とすると HBM が約3〜4倍、GDDR7 が約1.7倍【推定】。つまり GDDR7 は HBM の半分程度で、3分の1ではありません。それでも CPX は、本来なら「ウェハを節約する」設計だったはずです。
しかし現実には、逼迫の最中に新しい GDDR7 のデータセンター供給ラインを開く魅力が消えました。安いはずのメモリが、安くなくなったからです。GDDR7 を HBM に置き換える再設計の観測も報じられましたが、それをやれば CPX のコスト面での存在意義そのものが消えます【報道】。
ルーフラインの外側にある制約が、ルーフラインに従って設計されたチップを消しました。
ただし、コンセプトは生きている
Ian Buck 氏は「LPX は CPX の置換ではない」と明言し、Feynman 世代での復活余地に言及しています【報道】。NVIDIA の公式製品ページにも、現在なお Vera Rubin NVL144 CPX の記載は残っています【公式】。
傍証として、Intel が Computex 2026 で詳細を示した Crescent Island(LPDDR5X を最大480GB 搭載する安価メモリ志向のデータセンターGPU)が、CPX が空けたニッチを埋める製品と位置づけられています【報道】。
「演算律速の prefill を、安いメモリの容量で受ける」というニッチ自体は、実在します。 ルーフラインが間違っていたわけではありません。市況が変わっただけです。
補足:CPX は decode 用ではない
一部の解説記事が CPX を「decode 用」と書いていますが、これは誤りです。NVIDIA 公式技術ブログは、CPX が担当するのは「the compute-intensive context phase of inference(推論の演算集約的なコンテキスト・フェーズ)」だと明記しています【公式】。context phase = prefill です。
こうした取り違えが起きること自体が、prefill と decode の非対称性がいかに直感に反するかを示していると思います。だからこそ、ルーフラインで整理する価値があります。
まとめ
- decode の演算強度は 2。行列ベクトル積だからで、モデルサイズにも MoE にも依りません
- prefill の演算強度は 2B。行列行列積だからです。1万トークンなら 20,000
- 同じモデル・同じチップで、演算強度が1万倍違います
- その結果、VR200 は decode 中に演算器の99.75%を、prefill 中に HBM4 帯域の96%を遊ばせます。完全な鏡像です
- prefill を VR200 で回すと、HBM4 帯域の96%は使われません。CPX が GDDR7 を選んだのは、コスト削減であると同時に、逼迫した HBM4 を decode 側に回すためだったと読めます
- decode の脱出路はバッチングだけですが、KV が天井を作ります。長コンテキストでは天井が崩落し、バッチングでは救えません
- Groq LPU の尾根(8.2)は、長コンテキスト decode の天井(8.5)とほぼ一致します。decode がいる場所に機械を合わせた設計です
- そして CPX は消えました。ルーフラインの外側にある制約(ウェハ供給と市況)が、ルーフラインに従って設計されたチップを消したからです。
所感
ルーフラインは「どのチップが速いか」を教えてくれません。教えてくれるのは「どのチップが要るか」です。
VR200 と Groq LPU のどちらが優れているか、という問いは成立しません。尾根が795の機械と8.2の機械は、そもそも別の場所に住んでいます。同じ土俵に乗せた瞬間、比較が壊れる。前回 MI455X の記事で「何で正規化するかで勝者が入れ替わる」と書きましたが、それと同じ構図が、ここでは分母ではなく尾根の位置として現れます。
今回いちばん興味深かったのは、最後の顛末です。CPX はルーフラインに従って正しく設計され、正しい理由で作られ、そしてルーフライン以外の理由で消されました。(GDDR7 が安いという前提が、DRAMウェハの逼迫で崩れたこと。ルーフラインの2つの軸には、メモリの種類も価格も供給量も現れません。)
これは他人事に思えません。設計開始時には正しい軸で正しく最適化しても、遅れて出てきた別の軸で消される。製品開発ではよくあるパターンです。 CPX の話は、その典型例として読めます。
そして前3本と繋がります。律速資源がウェハである以上、メモリの種類を変えても逃げられない。電力を金で回避すればメモリが効き、メモリを fab増設で解いている間に電力の壁が近づく。制約は回転し、どこかを直すとやがて次の壁が見えてきます。
設計とはそういうもので、そのスケールが数桁大きくなった話を、いま世界中がやっているのだと思います。
参考リンク
公式
- NVIDIA Technical Blog「NVIDIA Rubin CPX Accelerates Inference Performance and Efficiency for 1M+ Token Context Workloads」 https://developer.nvidia.com/blog/nvidia-rubin-cpx-accelerates-inference-performance-and-efficiency-for-1m-token-context-workloads/ ── CPX が context phase(prefill)担当であることの一次出典
- NVIDIA「Vera Rubin NVL72」製品ページ
- NVIDIA「Groq 3 LPX」製品ページ
- Micron HBM4 製品ページ https://www.micron.com/products/memory/hbm/hbm4
精度・量子化(はじめに、PART 2-5)
- NVIDIA Technical Blog「Introducing NVFP4 for Efficient and Accurate Low-Precision Inference」── NVFP4 の二段スケール構成
- VRLA Tech「FP4 vs FP8 vs FP16 for LLM Inference: Which Precision Should You Use?」── FP8 が2026年の本番標準である旨
- Spheron「vLLM vs TensorRT-LLM vs SGLang: H100 Benchmarks (2026)」── 3フレームワークとも FP8 をネイティブ対応
アナリスト
- SemiAnalysis「Another Giant Leap: The Rubin CPX Specialized Accelerator & Rack」 https://newsletter.semianalysis.com/p/another-giant-leap-the-rubin-cpx-specialized-accelerator-rack ── CPX の帯域2 TB/s、FP4 dense 20 PFLOPS の推定出典
- SemiAnalysis「Vera Rubin – Extreme Co-Design」── FP4 の dense / sparse の使い分け
報道
- The Elec「Nvidia's 'Rubin CPX' Launch Becomes Uncertain」
- The Register「Intel's mysterious new datacenter GPU is what Nvidia's Rubin CPX nearly was」
- The Register「A closer look at Nvidia's Groq-powered LPX rack systems」
論文(PART 5-6)
- XShare: Collaborative in-Batch Expert Sharing for Faster MoE Inference(arXiv 2602.07265)── DeepSeek-R1 のバッチ別エキスパート活性化数の実測
- MoE-CAP: Benchmarking Cost, Accuracy and Performance of Sparse Mixture-of-Experts Systems(arXiv 2505.11415)
前回までの記事
- NVIDIA Vera Rubin のアーキテクチャを理解する ─ 希少なHBM4を使い倒す設計
- AMD Instinct MI455X と Helios を理解する ─ HBM4を「多く積む」設計は、「使い倒す」設計に勝てるのか
- HBM4を「使い倒す側」を理解する ─ OpenAIの90万枚/月は、何から逆算された数字なのか
前提と注記
本記事の試算は、以下の前提に立っています。ご自身の数字で検算される際の参考にしてください。
- 演算強度は、オフチップメモリ(HBM / GDDR / DDR)へのトラフィックのみを分母に取り、オンチップ SRAM のアクセスは無視しています
- 重みは FP8(1 param = 1 byte)を基本とし、FP4 の場合は別途明記しました。演算強度は重みの精度に依存します(不変なのは「重み1個につき 2 FLOP」のほうで、FP16 なら 1 FLOP/byte、FP4 なら 4 FLOP/byte になります)。本記事の「2」は、すべて FP8 基準です
- decode の AI = 2 は、FFN と projection の行列積が支配的であることを前提にしています。attention の演算と KV 読み出しは PART 5 で別途扱いました
- KV は 164 KB/トークン(GQA、8 KVヘッド × 128次元 × 80層、FP8)を仮定しています。MHA なら8倍、MLA(DeepSeek)なら大幅に小さくなります。アーキテクチャ依存が大きい点にご注意ください
- Rubin CPX の帯域(約2 TB/s)は NVIDIA が公表していません。SemiAnalysis の推定値です。FP8 dense 約10 PFLOPS は、FP4 dense 20 PFLOPS の半分として筆者が置いた値です
- Groq LPU 1基あたりの FP8 性能(約1.23 PFLOPS)は、LPX ラック(256基)の 315 PFLOPS を256で割った筆者の試算です。公式の per-chip 値ではありません
- LPU の 150 TB/s は1基あたりのオンチップ SRAM 帯域です【公式】。LPX ラック仕様に現れる 640 TB/s は、これとは別物で、チップ間のスケールアップ帯域(scale-up bandwidth)です【公式】。ラック全体の SRAM 集約帯域は別に 40 PB/s と公表されています【公式】。検算すると 256基 × 150 TB/s = 38.4 PB/s となり、公称の 40 PB/s と整合します
- MoE の高バッチ時のエキスパート活性率(PART 5-6)は定量的な裏付けが取れていないため、要検証としています
更新履歴・出典方針
2026-07-14 初版。
執筆後にファクトチェックを行い、以下を修正しました。読者が他所で同じ数字を目にした際の参考として明記しておきます。
| 項目 | 誤り | 訂正 |
|---|---|---|
| VR200 の FP8 dense | 約16 PFLOPS | 17.5 PFLOPS(NVIDIA公式スペック表、Dense specification 脚注付き)。これに伴い尾根が 727 → 795 に変わり、記事中の全数値を引き直しました |
| Groq LPX の 640 TB/s | SRAM 集約帯域と誤認 | チップ間のスケールアップ帯域。SRAM 集約帯域は別に 40 PB/s と公表されています |
| GDDR7 のウェハ効率 | HBM の3分の1 | 約2分の1(標準DRAM比で HBM 約3〜4倍、GDDR7 約1.7倍) |
なお、VR200 の FP8 dense が 17.5 PFLOPS であることには、思わぬ副産物がありました。NVFP4 dense の 35 PFLOPS がちょうどその2倍なので、量子化しても尾根と演算強度が厳密に同じ比率で動きます。PART 2-5 の「相対位置は変わらない」は、近似ではなく厳密な等式です。
また、以下は一次情報が存在しないため、推定・報道であることを本文で明示しています。
- Rubin CPX のメモリ帯域(約2 TB/s)、FP4 dense 20 PFLOPS、192 SM、TSMC N3P、PCIe Gen6・NVLink なし ── いずれも SemiAnalysis 等の推定・報道。NVIDIA 公式は NVFP4 30 PFLOPS、GDDR7 128GB、モノリシックダイ、attention 3倍のみ
- Groq LPU 1基あたりの FP8 性能 ── ラック値 315 PFLOPS(報道)を256で割った筆者の試算
- 「1兆パラメータ級で計算資源の25%を LPX・75%を Rubin」という配分比率 ── 一次情報で確認できず
Rubin / CPX / LPX の諸元は、いずれも NVIDIA が「Preliminary, subject to change」としている段階のものです(2026年後半の出荷前)。最終仕様は変わり得ます。